手把手教你:使用Ollama+Cherry Studio搭建DeepSeek本地知识库,必学收藏!

Deepseek R1 模型本地部署(ollama+cherry studio)详细指南! 个人知识库搭建与使用 对于想要在本地或自托管环境中运行 LLM 的用户而言,Ollama 提供了一个无需 GPU、在 CPU 环境也可高效完成推理的轻量化 “本地推理” 方案,接下来跟着笔者学习怎么一步步搭建自己的本地知识库吧 阅读详情

本文详细介绍了如何通过Ollama部署DeepSeek模型,结合Cherry Studio搭建本地知识库,实现企业私有数据的安全处理。从Ollama安装、模型下载到Cherry Studio配置,再到知识库搭建和对话测试,提供了完整的操作指南。这种方法确保数据无需离开本地环境,避免合规风险和泄露隐患,同时支持调用更大模型提升效果。对于需要处理敏感信息的企业和开发者而言,这是一份实用的技术参考。

1、Ollama下载

登录Ollama官网(https://ollama.com/)点击Downloa,进入模型下载页面。

在这里插入图片描述

根据自己的电脑选择合适的系统,按照提示步骤进行安装即可。

在这里插入图片描述

2、下载DeepSeek模型与嵌入模型

输入命令:

ollama run deepseek-r1:7b

其中,7b表示模型的大小,可以根据实际情况选择更大或更小的模型。

在这里插入图片描述

要实现本地知识库的搭建,还需要一个词嵌入(Embedding)模型,在搭建本地知识库的过程中,选择合适的Embedding模型至关重要,因为Embedding模型直接影响了检索的效果与生成的质量。

我们选取mxbai-embed-large作为嵌入模型。

输入指令:

ollama pull mxbai-embed-large

在这里插入图片描述

等待模型下载完成。

3、下载Cherry Studio

进入Cherry Studio官网(https://cherry-ai.com/),点击下载客户端。

在这里插入图片描述

点击“立即下载”,即可下载windows版本的安装包,也可以点击“其他版本或备用路线下载”,下载其它系统的安装包,支持macOS和Linux。

在这里插入图片描述

按照提示进行安装即可。安装后打开Cherry Studio。

Cherry的组织逻辑如下:

1.助手:助手即智能体。打开Cherry Studio后,将默认选中“默认助手”,默认助手是不带有任何提示词的智能体,等同于直接跟LLM对话(跟在网页中对话效果一样)。Cherry Studio中支持通过提示词自定义建智能体。

2.话题:每个智能体下有多个话题。话题也就是会话每个话题中会记录多轮对话(跟在网页中的不同聊天记录一样)。

3.知识库:知识库由用户上传的资料组成,支持txt、html、md、docx、pptx、xlsx、pdf,等常见的文本格式,DeepSeek模型不支持图片。每个助手中的每个话题都可以对知识库进行调用。

在这里插入图片描述

4、配置模型与知识库

点击页面左下角的设置,点击模型服务,选择Ollama,点击管理。

在这里插入图片描述

这里将会自动加载Ollama中已下载的DeepSeek模型与嵌入模型,我们选择刚刚下载的模型,点击加号。

在这里插入图片描述

在这里插入图片描述

模型配置结束。

现在开始配置知识库。点击左侧的知识库图标,点击添加。

在这里插入图片描述

知识库的名称可以自定义,这里定义为课程PPT,嵌入模型选择刚刚配置好的Ollama嵌入模型。点击确定。

在这里插入图片描述

选择想要上传的文件,等待所有文件向量化完成(出现绿色对勾)后,知识库配置完毕。我们在这里上传《PyTorch计算机视觉与深度学习实战》的课程PPT,让模型在PPT中查阅信息。

在这里插入图片描述

5、开始对话

点击左侧第一个图标,进入对话页面,在对话框中点击知识库图标。

在这里插入图片描述

在这里插入图片描述

选择刚刚配置的知识库,选择完成后,图标将会显示蓝色。

输入@或点击下方的@图标,选择配置好的Ollama模型

在这里插入图片描述

接下来,对模型提出需求“请介绍第7章的基本内容”。从结果中可以看出,模型成功地检索出了第7章的PPT,并且介绍了第7章的主要内容。

在这里插入图片描述

如果不涉及隐私和机密信息,还可以尝试通过硅基流动,调用更大的模型,更大的模型效果更好。

我们选择硅基流动的DeepSeek-R1模型(首先要在模型服务中配置硅基流动的API key)。

在这里插入图片描述

在这里插入图片描述

可以看到,更大的模型实现了更好的效果,模型的回复中给出了精确的引用,并且更加全面的介绍了第7章的内容。

如果想要实现更好的知识库检索效果,可以尝试本地部署更大的模型。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

在这里插入图片描述

为什么要学习大模型?

我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。

在这里插入图片描述

在这里插入图片描述

大模型入门到实战全套学习大礼包

1、大模型系统化学习路线

作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!

img


2、大模型学习书籍&文档

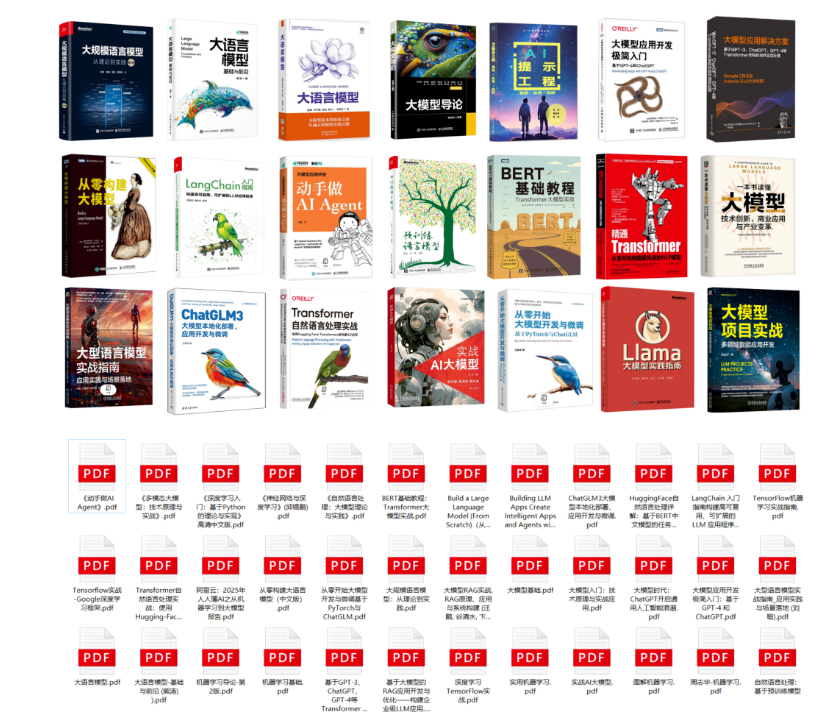
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。

在这里插入图片描述

3、AI大模型最新行业报告

2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

4、大模型项目实战&配套源码

学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

img

5、大模型大厂面试真题

面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

img

适用人群

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

5 分钟用满血 DeepSeek R1 搭建个人 AI 知识库(含本地部署) 备注:评论区回复“DeepSeek”,免费领取万字DeepSeek指南。看到这里,相信你已经找到最适合自己的 DeepSeek 个人知识库方案了。如果你和大多数人一样,选择使用官方 API ,那就不用再为性能和本地硬件资源发愁;如果你恰好有充足的算力和技术储备,本地部署也是个不错的选择。不过,在整个过程中,我想和你分享的不仅仅是这些技术细节。而是一个中国团队能做出世界级大模型,一个需要 +86 才能注册的大模型。很庆幸,我们能作为中国 AI 技术进步的见证人。当然,暂时的领先不是终点。 阅读详情

相关推荐

DeepSeek+Ollama+Cherry Studio 实现本地部署搭建知识库

本文介绍了如何通过DeepSeek+Ollama+Cherry Studio 实现本地部署搭建知识库。

weixin_43705315的博客 1298

Ollama+CherryStudio本地部署拯救deepseek官方不可用

这里检查失败了,因为本地安装模型是1.5b,这里输入模型的时候有写全:deepseek-r1:1.5b,这时候点击确定后显示连接成功。好在deepseek将模型开源,并且有已经量化到可以在我们本地电脑部署,本文我们介绍从PC端到手机端一站式部署deepseek。首先需要安装ollama,从官网https://ollama.com/下载对应系统的安装包安装即可。接下来下载cherry studio,官网下载地址:https://cherry-ai.com/。接下来可以在手机使用本地离线模型聊天了。

轻口味的专栏 9542

Ollama+Deepseek+Cherry/Dify构建本地知识库

是一款开源的大语言模型(LLM模型)应用开发平台,为开发者提供了快速搭建生产级生成式AI应用的能力,内置一个直观简洁的强大的Prompt编排工具,具备增强搜索生成功能(RAG)可高化构建提供一个可视化的画布,让开发者可以在画布上快速构建安出一个可执行的自动化任务的AI应用。支持监控和分析应用程序日志和性能,并提出了后端即服务,主要体现在所有产品都附带相应的API,方便开发者将Dify集成到自己的业务中,实现数据的解耦和业务快速扩展。

傲视苍穹 2972

学习Cherry Studio AI服务平台,主要是各种功能的实践(deepseek 1.5b和7b的模型+ChatGLM3模型)

Cherry Studio 是一个支持多模型服务的桌面客户端,为专业用户而打造,内置 30 多个行业的智能助手,帮助用户在多种场景下提升工作效率。CherryStudio内置众多服务商同时也支持其他兼容OpenAI/Anthropic等API格式的服务商接入。Cherry Studio支持多种场景应用,不过还是有一些限制,比如画图只能调用硅基流动的服务。特色功能:多模型对话,可以选中多个模型,对同一个问题就行回答。

skywalk8163的专栏 5745

DeepSeek+本地知识库

整个操作下来,AnythingLLM 的体验没有cherry好。AnythingLLM就像一个包壳的web应用(后来查了下,确实是)。AnythingLLM 得具备一定的程序思维,给技术人员用的。非技术人员还是使用cherry吧。作为喜欢折腾的开发人员,我们可以结合dify使用。个人知识库+本地大模型的优点隐私性很好,不用担心自己的资料外泄、离线可用在工作和学习过程中对自己整理的文档,能快速找到,并自动关联在代码开发上,能参考你的开发习惯,快速生成代码。

m0_45209551的博客 1243

使用cherry studio离线搭建私人知识库流程记录

本文介绍了如何在离线环境下搭建个人知识库,使用ollama管理本地大模型(如DeepSeek、千问7B)和bge-m3嵌入模型。通过魔塔社区下载GGUF格式模型文件,创建modelfile配置文件导入ollama,最后在CherryStudio中配置知识库实现离线检索。该方案具有数据隐私保护、高效知识管理等优势,适合需要自主掌控数据的用户。文末提供了相关工具的下载链接。

u010681011的专栏 1121

DeepSeek R1+Ollama+Cherry Studio实现本地知识库的搭建

创建知识库,点击左侧知识库-添加,输入知识库名称,选择嵌入模型,如果配置了硅基流动,可选择自带的BAAI/beg-m3,或者可以选择本ollama安装的nomic-embed-text。打开Cherry Studio,点击左下角设置-模型服务,选择Ollama,点击管理按钮,在列出的模型后面点击加号添加模型,本地模型不需要配置API密钥,添加完成即配置成功。打开Cherry Studio,点击左下角设置-模型服务,选择硅基流动,粘贴官网新建的API密钥,点击检查,出现绿色小勾则表示连接成功。

Bobby的网络日志 2861

【AI】CherryStudio + Ollama

下载地址:https://cherry-ai.com/download。在聊天时记住一定要选择你的知识库,选择了知识库的会是彩色的按钮。3.3.1添加知识库之前,请先去把模型设置为嵌入模型。3.3.3选择本地文件或者目录,添加网络文章地址。3.3.2☆☆配置本地部署的DeepSeek。即可实现本地DeepSeek模型对话。选择好安装目录 一直下一步安装就好。点击“Ollama”,点击“管理”点击本地添加的模型后面“+”回到聊天页面进行聊天。3.3.3本地知识库。3.3.2创建知识库。3.3.4使用知识库。

德仔 1750

Ollama下载安装+本地部署DeepSeek+UI可视化+搭建个人知识库——详解!(Windows版本)

①首先。

Future_yzx的博客 4万+

本地电脑大模型系列之 13 Cherry AI:ollama 的桌面应用程序

🍒 Cherry Studio 是一款支持多种人工智能大型语言模型的桌面客户端,支持快速模型切换,并针对问题提供不同的模型响应。它兼容 Windows 和 Mac 平台💻,开源且免费,可帮助您提高工作和学习效率。

iCloudEnd的博客 2305

『AI大模型』Ollama、DeepSeek 和 Cherry Studio 本地知识库搭建实战指南

深入探讨如何利用 Ollama、DeepSeek 和 Cherry Studio 搭建本地知识库,从技术原理到实践步骤,再到优化策略,全方位呈现知识库构建的精髓,助你在本地数据管理与检索领域实现技术突破,打造高效、智能的企业级知识管理解决方案。

老陈聊架构 2444

Ollama搭建DeepSeek本地大模型 + 聊天工具(ChatBox)+ 私有知识库(Cherry Studio)

如果要修改模型的保存地址,可以新建一个文件夹如 “D:\Model”的路径,然后在系统环境变量添加系统变量:“变量名:OLLAMA_MODELS,变量值:D:\Model”。step4:在确保Ollama 安装完成后,按下win+R键然后输入cmd 打开命令行窗口,在命令窗口输入大模型的命令ollama run deepseek-r1启动模型。ChatBox 是一个专注于聊天工具设计的开源平台,结合了高效的交互技术和丰富的功能,旨在为用户提供更流畅、更个性化的交流体验。

weixin_42009760的博客 9246

ADS软件操作(8)——负载牵引(Loadpull)

负载牵引:通过不断调节输入和输出端的阻抗,找到让有源器件输出功率最大的输入、输出匹配阻抗。这种方法可以准确地测量出器件在大信号条件下的最优性能,反映出器件输入、输出阻抗随频率喝输入功率变化的特性,为器件和电路的设计优化提供了坚实的基础。白话版:由于通信制式越来越复杂,对放大器的线性度和效率要求越来越高。由于放大器的效率和是个永恒的矛盾,所以如何平衡这样的矛盾达到系统设计的最优就是一个需要解决的难题。如何解决?调节输入和输出端的阻抗也就是负载牵引 (Load-Pull)原理來改善点,从而降低谐波的。

Zhuanzhuyan的博客 4954

DeepSeek + Cherry Studio 搭建本地私有知识库!

DeepSeek + Cherry Studio 搭建本地私有知识库!

Gblfy_Blog 3405

5分钟搞定!用OpenCV实现全景图像柱面展开的保姆级教程(附完整代码)

本文提供了一份使用OpenCV实现全景图像柱面展开的详细教程。通过清晰的数学原理讲解和分步代码演示,指导读者快速掌握从等距柱状投影全景图到平面展开图的核心转换方法,并涵盖性能优化、参数调整及透视视图扩展等实用技巧,适合图像处理爱好者和开发者实践。

sony5的博客 573

RK3588上跑通Zipformer语音识别的3个坑与填坑实录(附完整编译命令)

本文详细记录了在RK3588开发板上部署Zipformer语音识别模型时遇到的三个典型问题及其解决方案,包括静态库版本冲突、编译脚本配置错误以及模型转换精度调优。文章提供了完整的编译命令和实战步骤,帮助开发者快速在边缘设备上实现高效的语音识别应用。

l6m7n8的博客 715

手把手教你搭建本地AI知识库:Ollama+Deepseek+Cherry Studio

通过以上步骤,我们成功地利用 Ollama 部署了 Deepseek 模型,并借助 Cherry Studio 搭建了属于自己的本地 AI 知识库。在这个过程中,我们不仅实现了数据的本地化存储和管理,还能够根据自身需求对知识库进行个性化定制,享受到了快速、准确且私密的知识服务。从实际使用效果来看,本地 AI 知识库在处理特定领域的问题时表现出色。无论是专业的学术研究,还是日常的工作资料查询,它都能迅速给出准确的答案,大大提高了我们的工作和学习效率。

Ljugg的博客 3875

SAP交货单过账避坑指南:序列号处理、Buffer清理与BAPI提交回滚的那些事儿

本文深入解析SAP交货单过账中的序列号处理、Buffer清理与BAPI提交回滚等关键问题,提供WS_DELIVERY_UPDATE和BAPI_OUTB_DELIVERY_CONFIRM_DEC的实战优化方案。通过详细的技术分析和最佳实践,帮助开发者避免常见陷阱,提升交货单处理的稳定性和效率。

weixin_31155097的博客 431

DeepSeek+本地知识库实践:基于Cherry Studio和Ollama搭建

Cherry Studio 是一个支持多模型服务的桌面客户端,为专业用户而打造,内置 30 多个行业的智能助手,帮助用户在多种场景下提升工作效率。Cherry Studio支持多种场景应用,不过还是有一些限制,比如画图只能调用硅基流动的服务。特色功能:多模型对话,可以选中多个模型,对同一个问题就行回答。

skywalk8163的专栏 4333

点云结构面智能识别与裂隙网络分析系统

点云结构面智能识别系统摘要 本系统采用深度学习与传统几何算法融合的方法,实现岩石结构面的智能识别与分析。系统包含7个核心模块:点云预处理、结构面识别、分组分割、参数计算、粗糙度分析、裂隙网络生成和可视化。技术路线结合PointNet++深度学习架构与RANSAC、区域生长等传统算法,通过预处理→深度学习识别→几何精修→参数计算→网络构建的流程实现高精度分析。预处理模块实现点云降噪、下采样和法向量估计,深度学习模块基于改进的PointNet++架构进行特征提取和分类。系统支持多种点云格式输入,提供完整的结构面

huanghm88的专栏 345

MVDR算法: 自适应波束形成在信号处理领域中扮演着重要的角色。本文将介绍MVDR(最小方差无失真响应)算法,并提供相应的Matlab源代码实现。

MVDR算法是一种用于抑制干扰信号并增强感兴趣信号的自适应波束形成算法。它的基本思想是通过对干扰信号进行空间滤波,使其在感兴趣信号方向上的输出功率最小化。这种方法可以提高信号的质量和可辨识度,特别是在存在多个干扰源的复杂环境中。本文将介绍MVDR(最小方差无失真响应)算法,并提供相应的Matlab源代码实现。使用MVDR算法,我们可以通过对观测信号进行波束形成来抑制干扰信号并增强感兴趣信号。以上是MVDR算法的Matlab实现。的每一列代表一个阵列元素的观测信号。表示期望的波束指向,即感兴趣信号的方向。

HackWhisper的博客 1245

太香了!手把手教你搭建DeepSeek本地知识库(深度好文)

在之前的文章中,我分享过教程无需配件要求,笔记本联网也能用满血版deepseek的R1模型:我们每天一睁眼,手机通知栏就挤满了未读消息,订阅的20个专业号更新了深度长文。电脑浏览器同时开着十几个标签页。从论文PDF到行业报告,从代码仓库到产品文档,像无数个亟待填补的知识黑洞。这让我想起小时候陪妈妈逛超市,她总念叨就买瓶酱油,结果推车塞满零食日用品。回家却发现忘了买酱油,我们现在何尝不是每天在知识的货架间迷失?

bagell的博客 7784

OCR技术解析:用Tesseract和PaddleOCR识别文本

OCR技术解析:用Tesseract和PaddleOCR识别文本 ,人工智能,计算机视觉,大模型,AI,光学字符识别(Optical Character Recognition,简称 OCR)是一项将图片、扫描件等文档中的文字信息转换为可编辑文本的技术。在数字化时代,OCR 技术广泛应用于文档处理、车牌识别、身份证识别、古籍数字化等领域,极大地提高了文字信息处理的效率。Tesseract 和 PaddleOCR 是两款极具代表性的 OCR 工具。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 3万+

基于 DeepSeek LLM 本地知识库搭建开源方案(AnythingLLM、Cherry、Ragflow、Dify)认知

博文内容涉及 基于 Deepseek LLM 的本地知识库搭建使用 ollama 部署 Deepseek-R1 LLM知识库能力通过 Ragflow、Dify 、AnythingLLM、Cherry 提供理解不足小伙伴帮忙指正 😃,生活加油我站在人潮中央,思考这日日重复的生活。我突然想,如果有一天,垂老和年轻都难以惊起心中涟漪,一潭死水的沉闷,鲜花和蛋糕也撼动不了。如果人开始不能为微小事物而感动,那么地震山洪的噩耗想必也惊闻不了。如果活着和死亡的本质无异,那便没有了存在的意义。

山河已无恙 4399

从地方政府网站抓取政务公开数据:Python爬虫技术详解

在本文中,我们通过具体实例介绍了如何使用Python编写爬虫,从地方政府门户网站抓取政务公开数据。我们使用了requestsSelenium等最新技术,结合SQLite数据库存储抓取的数据,最后使用matplotlib进行数据可视化分析。通过本项目,您可以掌握如何抓取政府网站的公开数据,并将其进行清洗、存储和分析。这些技术对于进行政府政策分析、公共服务分析等方面具有重要的实际意义。希望通过本文的介绍,您能够更好地理解政务数据抓取的流程和方法,并能在实际工作中运用这些技术进行数据采集和分析。

2201_76125261的博客 1703

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

使用DeepSeek+Ollama+Cherry Studio搭建本地知识库

前面的文章我介绍过使用 Ollama 在家里的台式机上部署本地 DeepSeek-R1 模型,我分别下载了 7b、8b、14b、32b、70b、671b 这些模型。但是很不幸的是,台式机的 CPU 是 AMD 5600G,内存 32G,只有核显,没有独立显卡,7 b、8 b 速度还算可以,14b、32b 就需要十几分钟才能回答一个问题,70b 就直接提示内存不足了。这是因为输入框下面的知识库图标我没有选,点知识库图标,选择知识库的名字(前面我命名为我的知识库),选完后知识库图标变蓝色。

yyongwh的博客 1470

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

上一篇: 建议收藏:程序员必学!一文读懂RAG架构演进与5种类型区别
下一篇: 产品经理想拿 AI 高薪?先搞懂 3 大核心能力!附大模型 0 基础学习路径 + 免费资料包
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值