


本教程将聚焦于模型微调的实操过程,核心对象是DeepSeek-R1-Distill-Llama-8B模型——这款精简版模型并非凭空开发,而是以Llama 3.1 8B模型为基础,通过在DeepSeek-R1生成的高质量数据上进行微调优化所得。尽管参数规模更小巧,但它完美继承了原始DeepSeek-R1的核心推理能力,在各类任务中都能展现出与原版相近的出色表现,是进行垂直领域适配(如医疗方向)的理想选择。
我们的微调训练将依托Hugging Face平台上公开的医学思维链数据集,该数据集涵盖了从基础病症分析、诊断逻辑推导到治疗方案建议等全流程医疗知识,能让模型逐步掌握专业医生的思考模式,最终蜕变为专注医疗领域的“DeepDoctor”。
一、先搞懂:DeepSeek R1究竟是什么?
在着手微调前,我们首先需要清晰认识DeepSeek R1系列模型的核心特性——它之所以能成为医疗微调的优质基底,关键在于其在推理能力上的突破性表现。
DeepSeek-R1与同系列的DeepSeek-R1-Zero,在数学计算、代码编写、逻辑推理等核心任务上,性能已能与OpenAI的o1模型不相上下。而二者最核心的优势在于:它们均为完全开源的模型,开发者可自由获取模型权重、修改训练流程,这为医疗等垂直领域的深度适配提供了极大的灵活性。
1. DeepSeek-R1-Zero:开源领域的RL训练先驱
作为业内首个完全依靠大规模强化学习(RL,Reinforcement Learning)训练而成的开源模型,DeepSeek-R1-Zero打破了传统模型“先监督微调(SFT,Supervised Fine-Tuning)、再强化学习”的固定流程——它无需依赖人工标注的监督数据作为初始训练基础,而是通过自主探索的方式,逐步掌握思维链(CoT,Chain-of-Thought)推理逻辑。
这种训练方式赋予了模型强大的“自主解题能力”:面对复杂问题时,它能独立拆解任务步骤、迭代优化输出结果,尤其在需要多步推导的场景中表现突出。但与此同时,纯RL训练也带来了一些局限:例如推理过程中可能出现步骤重复、输出内容可读性较差,甚至偶尔会出现多语言混杂的情况,这些问题在对专业性和严谨性要求极高的医疗领域中,可能影响实际应用效果。
2. DeepSeek-R1:更均衡的多阶段训练优化版
为了弥补R1-Zero的不足,DeepSeek团队推出了DeepSeek-R1——它在训练流程上进行了关键改进:在强化学习(RL)阶段之前,新增了“冷启动数据训练”环节。这些冷启动数据涵盖了推理任务与非推理任务的多元场景,为模型构建了更扎实、更全面的知识与能力基础。
正是这种“冷启动数据预训练+RL优化”的多阶段训练模式,让DeepSeek-R1实现了性能的全面升级:不仅在数学、编程、逻辑推理等基准测试中持续保持与OpenAI-o1持平的领先水平,更重要的是,其输出内容的可读性与逻辑连贯性大幅提升——冗余信息减少、表述更清晰、步骤更规整,这恰好满足了医疗场景对“精准表达”和“逻辑严谨”的核心需求,也让它成为我们微调医疗助手的首选基底模型。
3. DeepSeek蒸馏模型(Distillation):小参数也有大能力
除了基础版的R1和R1-Zero,DeepSeek团队还推出了一系列蒸馏模型——通过模型蒸馏技术,将大参数模型(如DeepSeek-R1)的核心能力“浓缩”到更小参数的模型中,在降低计算成本、提升运行效率的同时,最大程度保留原模型的推理性能。
这些蒸馏模型的参数规模覆盖了1.5B到70B的广泛范围,可满足不同算力场景的需求:小到个人电脑、边缘设备,大到企业级服务器,都能找到适配的型号。其中,DeepSeek-R1-Distill-Qwen-32B更是表现亮眼,在多个权威推理基准测试中,性能直接超越了OpenAI-o1-mini,充分证明了蒸馏技术的有效性——小参数模型同样能拥有媲美大模型的推理能力,这也为我们在医疗场景中部署模型(兼顾性能与成本)提供了更多可能。
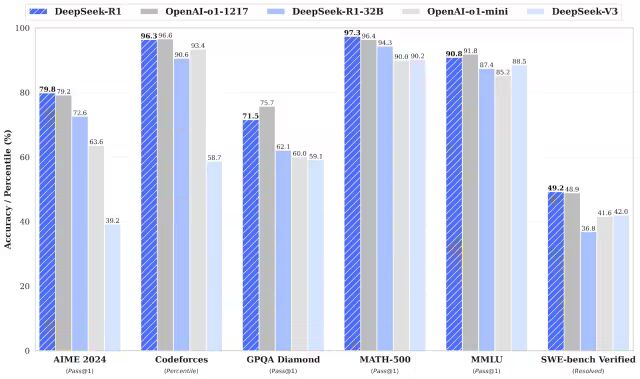
从上图的基准测试结果中可以清晰看到,无论是DeepSeek-R1原版还是其蒸馏模型,在与OpenAI-o1、R1-32B、V3等模型的对比中,均展现出强劲的竞争力,尤其在推理类任务上的优势更为突出——这也为我们后续将其微调成“DeepDoctor”,提供了坚实的性能保障。
二、逐步微调 DeepSeek R1
1. 环境设置
在本项目中,我们使用 Kaggle 作为云 IDE,因为它提供免费的 GPU 资源。我选择了两块 T4 GPU,但是看起来最终我只用了一块。如果你想用自己的电脑微调的话,那估计至少是要一块 16GB 显存的 RTX 3090 才行。
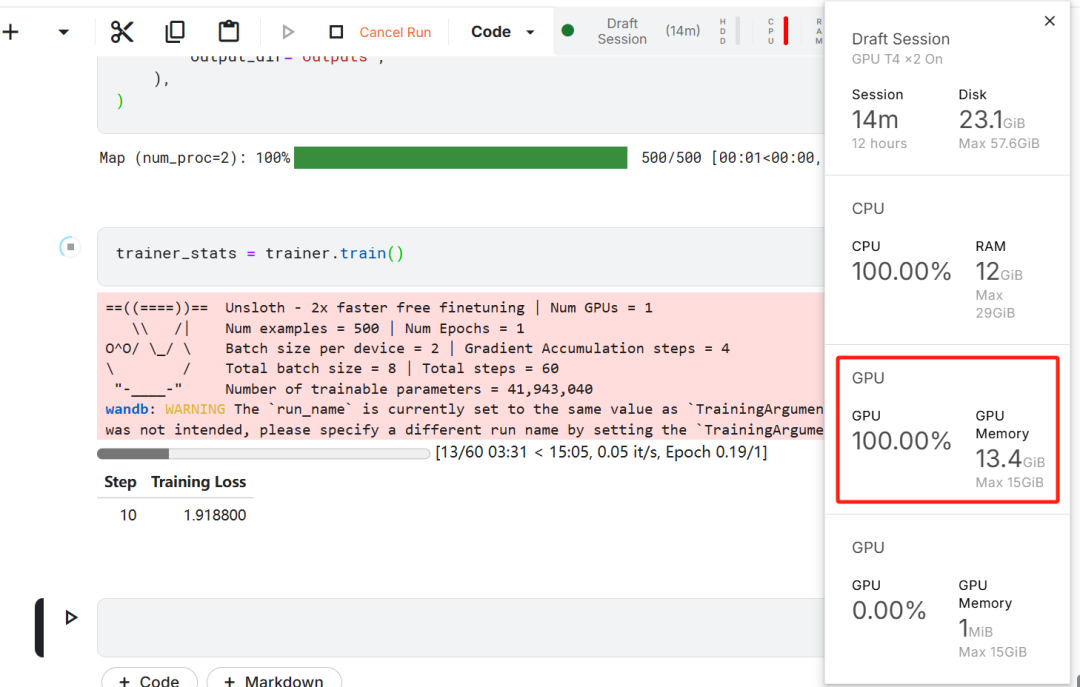
首先,启动一个新的 Kaggle notebook,并将你的 Hugging Face token 和 Weights & Biases token 添加为密钥。
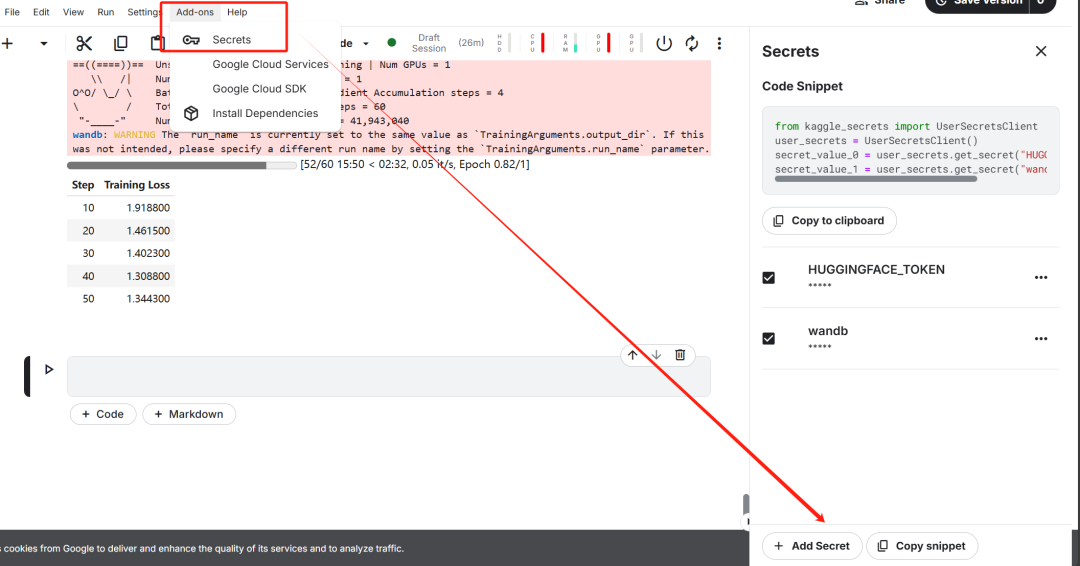
设置好密钥之后,安装 unsloth Python 包。Unsloth 是一个开源框架,旨在使大型语言模型(LLM)的微调速度提高一倍,并且更具内存效率。
%%capture
!pip install unsloth
!pip install --force-reinstall --no-cache-dir --no-deps git+https://github.com/unslothai/unsloth.git
登录 Hugging Face CLI,我们后续下载数据集和上传微调后的模型用得到。
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)
登录Weights & Biases (wandb),并创建一个新项目,以跟踪实验和微调进展。
import wandb

wb_token = user_secrets.get_secret("wandb")

wandb.login(key=wb_token)
run = wandb.init(
    project='Fine-tune-DeepSeek-R1-Distill-Llama-8B on Medical COT Dataset',
    job_type="training",
    anonymous="allow"
)
2. 加载模型和 tokenizer
在本项目中,我们将加载 Unsloth 版本的 DeepSeek-R1-Distill-Llama-8B。
https://huggingface.co/unsloth/DeepSeek-R1-Distill-Llama-8B
此外,为了优化内存使用和性能,我们将以 4-bit 量化的方式加载该模型。
from unsloth import FastLanguageModel

max_seq_length = 2048
dtype = None
load_in_4bit = True


model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/DeepSeek-R1-Distill-Llama-8B",
    max_seq_length = max_seq_length,
    dtype = dtype,
    load_in_4bit = load_in_4bit,
    token = hf_token,
)
3. 微调前的模型推理
为了为模型创建提示模板,我们将定义一个系统提示,并在其中包含问题和回答生成的占位符。该提示将引导模型逐步思考,并提供一个逻辑严谨、准确的回答。
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Instruction:
You are a medical expert with advanced knowledge in clinical reasoning, diagnostics, and treatment planning.
Please answer the following medical question.

### Question:
{}

### Response:
<think>{}"""
在这个示例中,我们将向 prompt_style 提供一个医学问题,将其转换为 token,然后将这些 token 传递给模型以生成回答。
question = "A 61-year-old woman with a long history of involuntary urine loss during activities like coughing or sneezing but no leakage at night undergoes a gynecological exam and Q-tip test. Based on these findings, what would cystometry most likely reveal about her residual volume and detrusor contractions?"


FastLanguageModel.for_inference(model)
inputs = tokenizer([prompt_style.format(question, "")], return_tensors="pt").to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
print(response[0].split("### Response:")[1])
这个医学问题的大致含义是:
一名 61 岁的女性长期在咳嗽或打喷嚏等活动中不自觉地漏尿,但夜间没有漏尿,她接受了妇科检查和 Q-tip 测试。根据这些发现,膀胱测压最有可能揭示她的残余量和逼尿肌收缩情况?
即使在没有微调的情况下,我们的模型也成功地生成了思维链,并在给出最终答案之前进行了推理。推理过程被封装在 标签内。
那么,为什么我们仍然需要微调呢?尽管推理过程详细,但它显得冗长且不简洁。此外,最终答案以项目符号格式呈现,这与我们希望微调的数据集的结构和风格有所偏离。
4. 加载和处理数据集
我们将稍微调整提示模板,以处理数据集,方法是为复杂的思维链列添加第三个占位符。
train_prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Instruction:
You are a medical expert with advanced knowledge in clinical reasoning, diagnostics, and treatment planning.
Please answer the following medical question.

### Question:
{}

### Response:
<think>
{}
</think>
{}"""
编写一个 Python 函数,在数据集中创建一个 “text” 列,该列由训练提示模板组成。将占位符填充为问题、思维链和答案。
EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN


def formatting_prompts_func(examples):
    inputs = examples["Question"]
    cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for input, cot, output in zip(inputs, cots, outputs):
        text = train_prompt_style.format(input, cot, output) + EOS_TOKEN
        texts.append(text)
    return {
        "text": texts,
    }
我们将从 Hugging Face Hub 加载 FreedomIntelligence/medical-o1-reasoning-SFT 数据集的前 500个 样本。
https://huggingface.co/datasets/FreedomIntelligence/medical-o1-reasoning-SFT?row=46
之后,我们将使用 formatting_prompts_func 函数对 “text” 列进行映射。
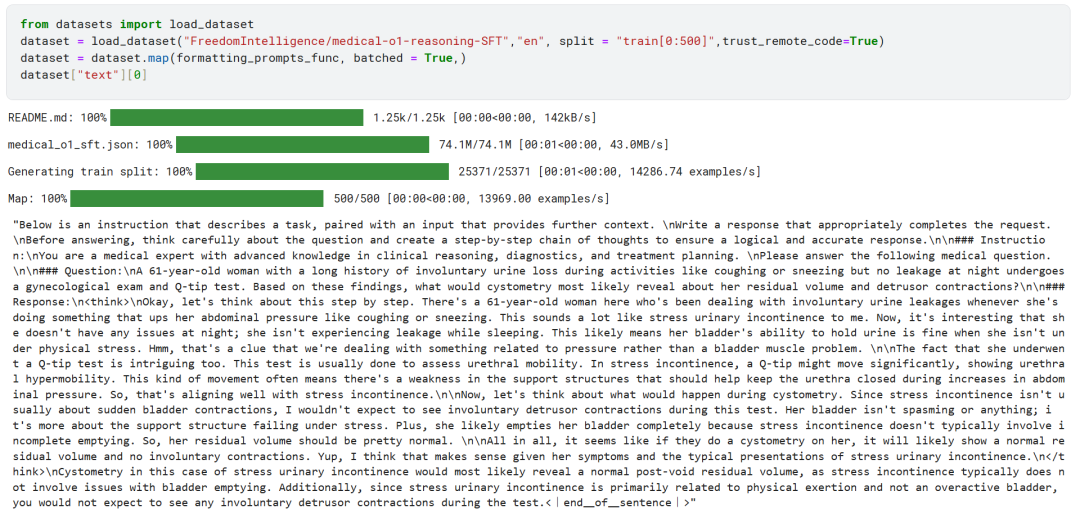
如我们所见,“text” 列包含了系统提示、指令、思维链和答案。
5. 设置模型
通过使用目标模块,我们将通过向模型中添加低秩适配器(low-rank adopter)来设置模型。
model = FastLanguageModel.get_peft_model(
    model,
    r=16,
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],
    lora_alpha=16,
    lora_dropout=0,
    bias="none",
    use_gradient_checkpointing="unsloth",  # True or "unsloth" for very long context
    random_state=3407,
    use_rslora=False,
    loftq_config=None,
)
接下来,我们将设置训练参数和训练器,通过提供模型、tokenizer、数据集以及其他重要的训练参数,来优化我们的微调过程。
from trl import SFTTrainer
from transformers import TrainingArguments
from unsloth import is_bfloat16_supported

trainer = SFTTrainer(
    model=model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=max_seq_length,
    dataset_num_proc=2,
    args=TrainingArguments(
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        # Use num_train_epochs = 1, warmup_ratio for full training runs!
        warmup_steps=5,
        max_steps=60,
        learning_rate=2e-4,
        fp16=not is_bfloat16_supported(),
        bf16=is_bfloat16_supported(),
        logging_steps=10,
        optim="adamw_8bit",
        weight_decay=0.01,
        lr_scheduler_type="linear",
        seed=3407,
        output_dir="outputs",
    ),
)
6. 训练模型
trainer_stats = trainer.train()
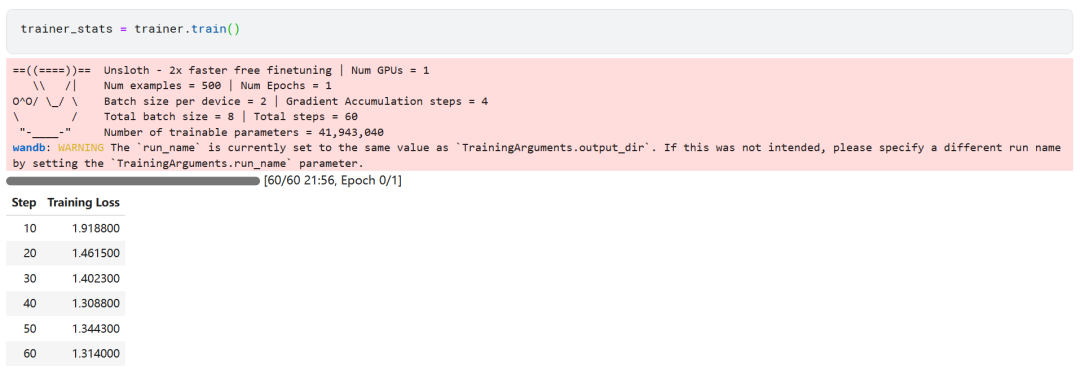
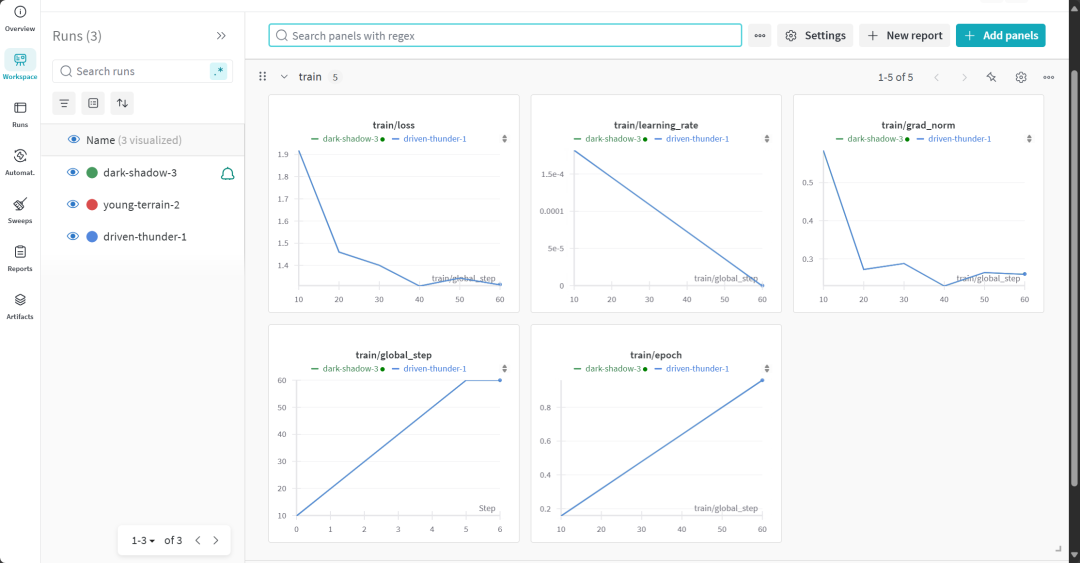
训练过程花费了 22 分钟完成。训练损失逐渐降低,这表明模型性能有所提升,这是一个积极的信号。
通过登录 Weights & Biases 网站并查看完整的模型评估报告。
7. 微调后的模型推理
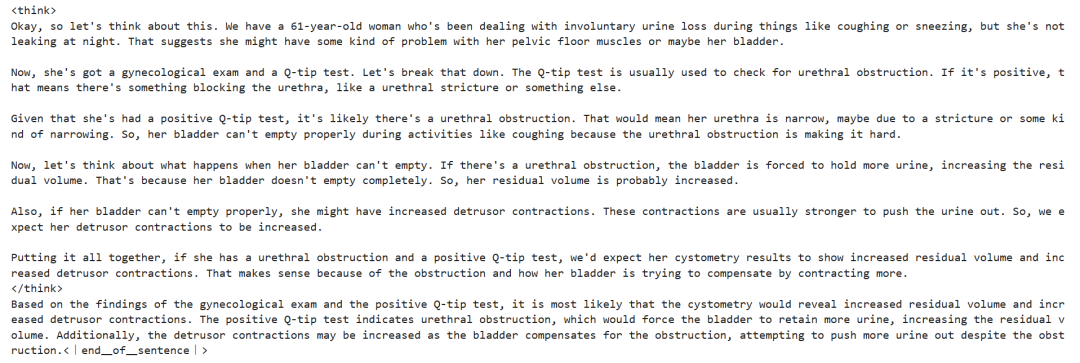
为了对比结果,我们将向微调后的模型提出与之前相同的问题,看看有什么变化。
question = "A 61-year-old woman with a long history of involuntary urine loss during activities like coughing or sneezing but no leakage at night undergoes a gynecological exam and Q-tip test. Based on these findings, what would cystometry most likely reveal about her residual volume and detrusor contractions?"


FastLanguageModel.for_inference(model)  # Unsloth has 2x faster inference!
inputs = tokenizer([prompt_style.format(question, "")], return_tensors="pt").to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
print(response[0].split("### Response:")[1])
结果明显更好且更准确。思维链条简洁明了,答案直接且只用了一段话。微调成功。
8. 本地保存模型
现在,让我们将适配器、完整模型和 tokenizer 保存在本地,以便在其他项目中使用。
new_model_local = "DeepSeek-R1-Medical-COT"
model.save_pretrained(new_model_local)
tokenizer.save_pretrained(new_model_local)

model.save_pretrained_merged(new_model_local, tokenizer, save_method = "merged_16bit",)
9. 将模型推送到 Hugging Face Hub
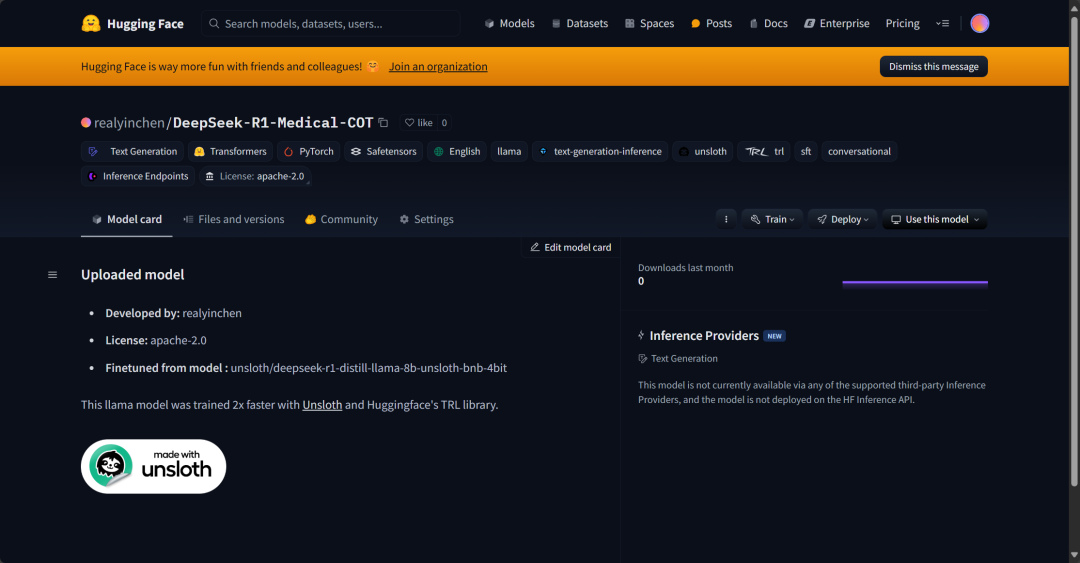
我们还将把适配器、tokenizer 和模型推送到 Hugging Face Hub,以便 AI 社区能够通过将其集成到他们的系统中,充分利用这个模型。
new_model_online = "realyinchen/DeepSeek-R1-Medical-COT"
model.push_to_hub(new_model_online)
tokenizer.push_to_hub(new_model_online)

model.push_to_hub_merged(new_model_online, tokenizer, save_method = "merged_16bit")
三、总结
AI 领域正在快速变化。开源社区正在崛起,挑战过去三年主导 AI 领域的专有模型。
开源的 LLM 正在变得更加优秀、更快速、更高效,使得在较低的计算和内存资源下微调它们变得比以往更加容易。
在本教程中,我们探讨了 DeepSeek R1 推理模型,并学习了如何对其精简版进行微调,以应用于医学问答任务。微调后的推理模型不仅提升了性能,还使其能够应用于医学、急救服务和医疗等关键领域。
为了应对 DeepSeek R1 的发布,OpenAI 推出了两个强大的工具:一个更先进的推理模型:o3,以及 Operator AI Agent,依托全新的计算机使用 Agent(CUA,Computer Use Agent)模型,能够自主浏览网站并执行任务。
源代码:
https://www.kaggle.com/code/realyinchen/deepseek-r1-medical-cot
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】


为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


大模型入门到实战全套学习大礼包
1、大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!

2、大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
3、AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

4、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

5、大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

适用人群

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 473


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


