


不久前,OpenAI 新推出了一项名叫 Deep Research(深度研究) 的功能,迅速风靡全球。
我们可以将其理解为大模型+超级搜索+研究助理的三合一。在这项功能里,用户输入查询问题后,只需要选择 Deep Research 选项,OpenAI o3 就能自动查找分析数百优质在线资源,并对其进行综合整理并加工,为用户生成一份具备专业分析师水准的综合报告。不仅内容生成更加详实,而且也更加精确可靠,足以替代普通人几小时甚至几十天的工作量。
01
Deep Research 因何风靡?
与普通搜索引擎相比,Deep Research优势一在于更专业,降低搜寻与内容评估成本。
它可以同时链接互联网、企业知识库、数据库等多种信息来源,并对其进行内容质量评估,优先展示那些相对高质量、高可靠性的内容,极大降低后续内容筛选付出的时间与精力。在这背后,Deep Research 可能在专有数据上进行了训练,并使用了端到端的强化学习等多种微调方法。
优势二则在于更精准的理解与生成内容的能力。
传统搜索主要依赖关键词匹配进行检索,无法理解用户查询以及召回内容的语义。Deep Research可以精准理解用户提问之外,并精准理解查询的网页内容,并帮助用户对要点、亮点进行提炼。在这背后,主要是由于Deep Research 迭代了基础模型,即基于即将发布的 OpenAI o3 推理模型,可以基于推理来搜索、解释和分析大量文本。
优势三则是更加的专业,结果一步到位。
基于规划、反思和记忆,Deep Research能执行多步骤任务,且会根据实时信息调整已有输出,生成结果结构清晰,省去了用户做drity work的时间。此外, Deep Research不仅能生成回答,还会根据我们自定义的输出格式、风格以及结构,生成专业报告。比如,其官方给出的案例中,通过Deep Research功能,OpenAI o3 可以自动查询过去十年GDP排名前十的发达国家以及发展中国家不同手机系统的普及率,并将其完整呈现在一张表格之中。
相应的, Deep Research在完成一些金融、科学、工程复杂任务过程中,具备绝对优势,不过,内容生成时间也会更久(大约数十分钟)。
02
为什么Deep Research 不是针对中国用户及企业的最优解?
Deep Research很好,但美中不足的是,OpenAI 不向中国大陆提供服务之外,Deep Research目前仅向订阅了 OpenAI 每月 200 美元 ChatGPT Pro 计划的用户提供,成本不低。
更重要的是,Deep Research 要想降低幻觉,依旧依赖本地知识库,然而对于大部分企业级用户来说,数据安全是条红线。
那么要如何解这个问题?本地部署是最佳解决方案。
对于国内用户,我们比较推荐DeepSeek R1 + LangChain+Milvus这个方案替代 Deep Research。
这个方案的优势有三:
1、相比OpenAI ,DeepSeek R1在使用 成本上更低, 与此同时,DeepSeek R1在中文任务上的表现更加符合国内用户的需求。
2、更高的灵活性,更低的门槛, 这是一个松耦合的结构设计,我们可以根据需求轻松切换不同的大语言模型等底层配置。
3、更安全,通过本地部署支持亿级数据的高性能检索的Milvus,提升效率的同时,避免了企业隐私数据泄露的问题。
03
DeepSeek R1 + LangChain+Milvus部署方案
备注:为了降低部署难度,本篇文章仅做思路展示,并采用一些相对低门槛的“低配版”选型,比如:
- 开源的DeepSeek R1,我们会使用经过蒸馏并量化为 4 bit的版本,以方便我们在本地运行。
- 为方便展示,我们不再对推理模型进行额外微调,Agent 也不会回溯或调整方向。
- 囿于本地资源,查询范围,我们框定在 Wikipedia 页面,只执行单独的 RAG 查询(暂时不对全网数据进行搜寻)。
- 查找范围上,本篇只限定文本数据,不将图像、PDF 等数据纳入考量。
如果您对详细过程或部署质量有更高要求,欢迎关注我们后续的系列解读文章,并扫描文末二维码交流。
以下是详细的部署思路与流程:
第一步:定义/优化问题
首先,我们需要基于用户给出的问题,让推理模型对其进行优化,从而让问题表达得更具体、清晰。
也就是说,我们的第一步是重写提示并将其分拆成若干子查询或子问题,这一方面,可以发挥我们基础模型Deepseek R1在推理方面的专长,将其拆解为简单的 JSON 结构化输出。
以下是 DeepSeek 优化问题“演员阵容如何随时间变化?”的推理过程:
<think>
Alright, so I need to break down the question "How has the cast changed over time?" related to the evolution of The Simpsons. Let me think about what aspects are involved here.

First, I know that the cast has changed a lot, but I need to figure out the intermediate questions to approach this. The main question is about changes in the cast over time, so I should consider different areas that contribute to this change.

I guess the first sub-question would be about the original cast members. Who were the main voices and how did they evolve? Then, there might be new cast additions over the years, so another sub-question about that.

Also, some original voice actors have left, so I should include a sub-question about departures. Then, new voice actors joining would be another point.

The show has been popular for a long time, so recurring roles changing might be another aspect. Additionally, the role of the show in society might have influenced casting choices, so a sub-question about that.

Lastly, the overall impact on the cast's careers could be another angle. So, I should list these as sub-questions to cover all aspects.
</think>
第二步 搜索
接下来,我们对 Wikipedia 文章进行“文献综述”,将搜索到的文章进行解析,并将数据存储到向量数据库 Milvus 中(目前,我们只阅读一篇文章,因为如果每个链接都调用推理模型,本地的推理成本会非常高)。
以下是如何使用 Milvus 的 LangChain 集成,将 Wikipedia 页面存储到 Milvus 中的代码示例:
wiki_wiki = wikipediaapi.Wikipedia(user_agent='MilvusDeepResearchBot (<insert your email>)', language='en')
page_py = wiki_wiki.page(page_title)

text_splitter = RecursiveCharacterTextSplitter(chunk_size=2000, chunk_overlap=200)
docs = text_splitter.create_documents([page_py.text])

vectorstore = Milvus.from_documents(  # or Zilliz.from_documents
    documents=docs,
    embedding=embeddings,
    connection_args={
        "uri": "./milvus_demo.db",
    },
    drop_old=True,
    index_params={
        "metric_type": "COSINE",
        "index_type": "FLAT",
        "params": {},
    },
)
第三步 分析
基于搜索结果,Agent 会对相关信息进行加工,并产生问题分析过程(多步骤分析/反思工作流程,以及信息来源可信度与权重判定,我们会在后续的系列文章中,进行详细展示)
以下是如何使用 LangChain 构建RAG,并回答问题的代码示例:
# Define the RAG chain for response generation
rag_chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)

# Prompt the RAG for each question
answers = {}
total = len(leaves(breakdown))

pbar = tqdm(total=total)
for k, v in breakdown.items():
    if v == []:
        print(k)
        answers[k] = rag_chain.invoke(k).split('</think>')[-1].strip()
        pbar.update(1)
    else:
        for q in v:
            print(q)
            answers[q] = rag_chain.invoke(q).split('</think>')[-1].strip()
            pbar.update(1)
第四步 生成
Agent 完成研究后会输出一个报告,并在报告中对研究结果进行总结,比如创建一个结构化的大纲。随后,它会完善每个部分,添加上章节标题和相应内容。(如果需要反思、重排和改写这些更复杂工作,我们则需要构建额外的规划、使用工具和记忆模块。)
完整代码请见文末随附的 notebook,示例输出可查看保存的报告文件。
04
结果展示
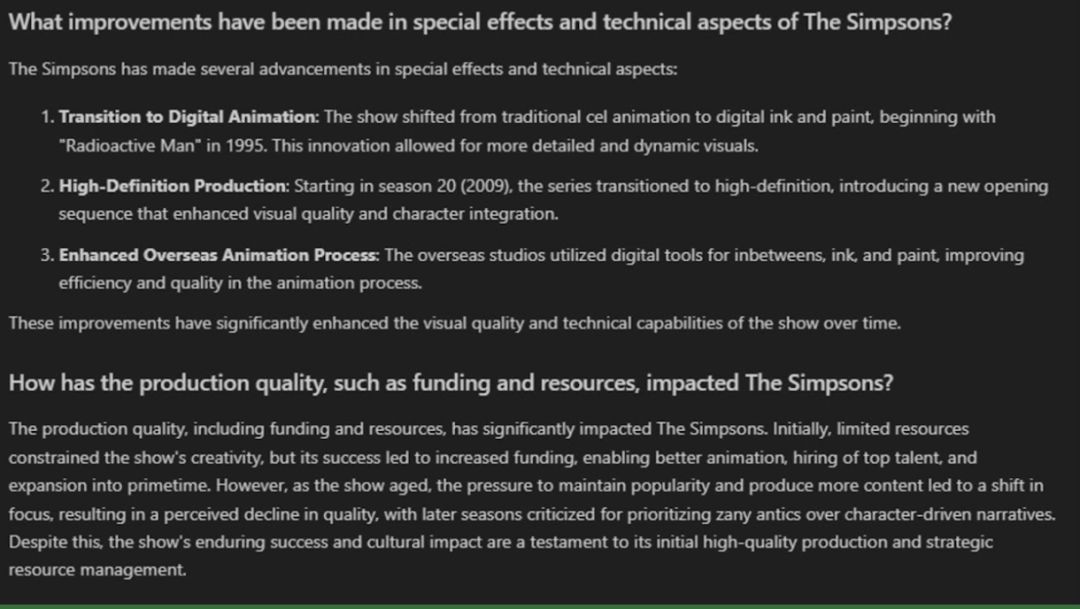
我们用于测试的查询是 “《辛普森一家》随时间发生了怎样的变化?”,数据源是 Wikipedia 上关于《辛普森一家》的文章。以下是生成报告的其中一个章节:
05
总结:从给出回答,到给出完整报告,大模型+向量数据库前景无限
短短数小时,我们设计出了一个基础的 Agent ,它能够进行推理、规划,并从 wikipedia 检索信息,最后生成结构化的研究报告。
尽管这个 demo 只是 Deep Research 的丐版,但其中 Milvus、DeepSeek 和 LangChain 等开源工具的选型思路,以及过程中的部署思路,依旧是每位想要复现Deep Research 的朋友的入门第一课。
此外,本篇文章,我们主要采用了市面上使用最多的多个开源产品,这相比闭源头的OpenAI,给了我们更多的灵活性和对部署成果的掌控力,此外,本地部署,也让我们企业数据的安全性多了更多保证,非常适合那些希望将此用于学术研究、内容生成等方向的用户来说。
如果对升级版复现方案感兴趣,欢迎移步github抢先尝鲜:https://github.com/zilliztech/deep-searcher
如对具体实现细节有更多的意见或建议,请关注Zilliz公众号,或者扫描文末二维码互动交流。
接下来的系列文章中,我们还将展示以下细节过程:
-
内容源突破 Wikipedia 的局限,动态搜索多个信息源;
-
引入回溯和反思机制,优化回复内容;
-
根据 Agent 自身的推理,优化执行流程。
-
对比deepseek与open AI方案部署效果的区别
-
Graph RAG与simple RAG的效果对比
DeepSeek无疑是2025开年AI圈的一匹黑马,在一众AI大模型中,DeepSeek以低价高性能的优势脱颖而出。DeepSeek的上线实现了AI界的又一大突破,各大科技巨头都火速出手,争先抢占DeepSeek大模型的流量风口。
DeepSeek的爆火,远不止于此。它是一场属于每个人的科技革命,一次打破界限的机会,一次让普通人也能逆袭契机。
DeepSeek的优点

掌握DeepSeek对于转行大模型领域的人来说是一个很大的优势,目前懂得大模型技术方面的人才很稀缺,而DeepSeek就是一个突破口。现在越来越多的人才都想往大模型方向转行,对于想要转行创业,提升自我的人来说是一个不可多得的机会。
那么应该如何学习大模型
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
大模型岗位需求越来越大,但是相关岗位人才难求,薪资持续走高,AI运营薪资平均值约18457元,AI工程师薪资平均值约37336元,大模型算法薪资平均值约39607元。

掌握大模型技术你还能拥有更多可能性:
• 成为一名全栈大模型工程师,包括Prompt,LangChain,LoRA等技术开发、运营、产品等方向全栈工程;
• 能够拥有模型二次训练和微调能力,带领大家完成智能对话、文生图等热门应用;
• 薪资上浮10%-20%,覆盖更多高薪岗位,这是一个高需求、高待遇的热门方向和领域;
• 更优质的项目可以为未来创新创业提供基石。
可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。为了让大家少走弯路,少碰壁,这里我直接把都打包整理好,希望能够真正帮助到大家。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【
保证100%免费】
👉AI大模型学习路线汇总👈
大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)

第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 1572


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


