基于金融新闻数据的BERT模型微调和降维

Python金融数据分析可能用到的55个数据集,财富密码可能埋藏于此 金融数据集汇总 阅读详情

Bert模型自2018年问世至今,在自然语言处理、多模态技术上显示出强大的实力,在金融领域中的文本理解、知识图谱等领域也显示出强大的应用前景。本文介绍如何在金融文本中微调自己的Bert模型,并进行精简,进而自动生成新闻因子,供下游预测任务使用。相关模型、数据集以及代码见文末分享。

金融新闻数据采集

推特、WSJ、联合早报、财联社等新闻具有较高的利用价值,这里主要介绍财联社的新闻数据获取方法。

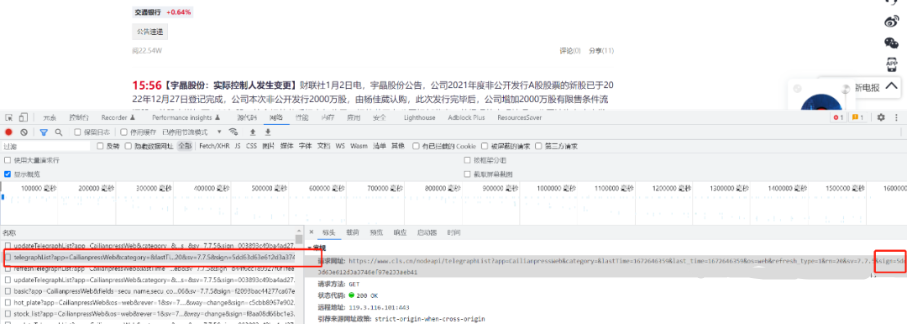
打开网址:https://www.cls.cn/telegraph, 在chrome浏览器中按下F12键,点击Network,然后刷新一下网页,便能找到后端请求的资源:
在这里插入图片描述

这里比较重要的是请求资源实际进行了简单加密,导致修改了时间参数后无法正常访问。以截图中的为例,需要使用hashlib进行sign签名的编码,具体代码如下:

import hashlib
def _md5(data):
    return hashlib.md5(data.encode()).hexdigest()
 
def _sha1(data):
    return hashlib.sha1(data.encode()).hexdigest()
 
def get_sign(data):
    data = _sha1(data)
    data = _md5(data)
    return data
 
data = 'app=CailianpressWeb&category=&lastTime=1672646359&last_time=1672646359&os=web&refresh_type=1&rn=20&sv=7.7.5'
url = 'https://www.cls.cn/nodeapi/telegraphList?' + data + "&sign=" + get_sign(data)
assert(get_sign(data) == "5dd63d63e612d3a3746ef97e233aeb41")

解决上面的签名问题后,便可以按照普通爬虫的方式,填充header等字段,获取任意时间段内的20条新闻数据了,并传入时间参数补齐历史数据:

import requests, time, datetime
def get_cls_data(timestamp=None):
    if timestamp is None:
        timestamp = int(time.time())
    else:
        timestamp = int(timestamp)
    headers = {"Content-Type": "application/json;charset=utf-8", "Referer": "https://www.cls.cn/telegraph", "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36"}
    data = 'app=CailianpressWeb&category=&lastTime={}&last_time={}&os=web&refresh_type=1&rn=20&sv=7.7.5'.format(timestamp, timestamp)
    url = 'https://www.cls.cn/nodeapi/telegraphList?' + data + "&sign=" + get_sign(data)
    resp = requests.get(url, headers=headers)
    return resp.json()
 
print(get_cls_data(timestamp=datetime.datetime.fromisoformat('2023-01-01 00:00:00').timestamp()))

Bert模型微调

目前开源出来的中文金融领域预训练模型有:

•熵简科技FinBERT: https://github.com/valuesimplex/FinBERT, 国内首个在金融领域大规模语料上训练的开源中文BERT预训练模型•澜舟科技Mengzi: https://github.com/Langboat/Mengzi, 金融领域的自然语言理解类任务

这里我们在Mengzi模型上进行进一步的微调:

•下载模型至本地:https://huggingface.co/Langboat/mengzi-bert-base-fin/tree/main ,加载到SentenceTransformer框架中,见代码load_model模块•载入金融文本数据集:每行一个新闻文本,见代码load_sentence模块•训练BERT模型:见代码train模块,TSDAE相比MLM、SimCSE等无监督任务效果更优(https://www.sbert.net/examples/unsupervised_learning/README.html)

# 载入预训练好的模型
def load_model(model_name='Langboat/mengzi-bert-base-fin', max_seq_length=128):
    word_embedding_model = models.Transformer(model_name, max_seq_length=max_seq_length)
    pooling_model = models.Pooling(word_embedding_model.get_word_embedding_dimension(), 'mean') 
    model = SentenceTransformer(modules=[word_embedding_model, pooling_model])
    return model
 
# 载入我们自己的数据集,每行一个文本
def load_sentence(filepath=''):
    sentences = []
    with open(filepath, encoding='utf8') as fIn:
        for line in tqdm(fIn, desc='Read file'):
            line = line.strip()
            if len(line) >= 8:
                sentences.append(line)
    return sentences
 
# 训练TSDAE模型
def train(news_txt="news.txt", model_location="Langboat/mengzi-bert-base-fin", model_output_path= 'tsdae'):
    model = load_model(model_name=model_location)
    sentences = load_sentence(filepath=news_txt)
    
    train_dataset = datasets.DenoisingAutoEncoderDataset(sentences)
    train_dataloader = DataLoader(train_dataset, batch_size=128, shuffle=True, drop_last=True, num_workers=16)
    
    train_loss = losses.DenoisingAutoEncoderLoss(model, decoder_name_or_path=model_location, tie_encoder_decoder=True)
 
    model.fit(
        train_objectives=[(train_dataloader, train_loss)],
        epochs=10,
        weight_decay=0,
        scheduler='constantlr',
        optimizer_params={'lr': 4e-5},
        show_progress_bar=True,
        checkpoint_path=model_output_path,
        use_amp=True,
        checkpoint_save_steps=5000
    )

Bert模型降维

Bert原生的输出维度为768,复杂度略高,最新的研究表明,借助Bert-whitening思路,可以在少量精度损失的情况下,使用降维技术获得更精简的句向量表达。基本的思路是,对所要编码的句子文本,首先编码成bert句向量,然后使用PCA进行降维,获取转换权重,然后把这权重嫁接到原始Bert的输出层上,这样我们就能直接获取简化后的Bert输出了,代码如下:

def pca(file="cls.txt", new_dimension = 128):
    sentences = load_sentence(filepath=file)
    random.shuffle(sentences)
    
    model = SentenceTransformer('./tsdae')
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model = model.to(device)
 
    embeddings = model.encode(sentences, convert_to_numpy=True, show_progress_bar=True)
 
    pca = PCA(n_components=new_dimension)
    pca.fit(embeddings)
    pca_comp = np.asarray(pca.components_)
 
    dense = models.Dense(in_features=model.get_sentence_embedding_dimension(), out_features=new_dimension, bias=False, activation_function=torch.nn.Identity())
    dense.linear.weight = torch.nn.Parameter(torch.tensor(pca_comp))
    model.add_module('dense', dense)
 
    model.save('tsdae-pca-128')

下游任务应用

微调和降维后,我们便可以利用其理解能力对任意一段文本进行编码,输出固定维度的向量:

bert_encoder = SentenceTransformer(bert_dir, device=device)
titles = ['中国银行黑龙江省分行原党委委员、副行长陈枫接受纪律审查和监察调查', '银河电子:签署储能业务战略合作协议']
embeddings = bert_encoder.encode(titles, convert_to_numpy=True, show_progress_bar=True)
print(embeddings.shape)

进一步的,如果我们想对一批新闻建模,那么可以把这些句向量当做一个个单词,利用长序列transformer技术进行进一步的编码,然后取pooling层输出作为新闻因子。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

BloombergGPT—金融领域大模型 在金融领域任务上,BloombergGPT综合表现最好;在通用任务上,BloombergGPT的综合得分优于相同参数量级的其他模型,并且在某些任务上的得分要高于参数量更大的模型。这都说明,开发金融专用的大语言模型在金融领域取得好效果的同时,并没有以牺牲模型通用能力为代价。 阅读详情

相关推荐

基于金融新闻微调大语言模型,进行股票回报预测

本文研究了利用金融新闻流对大型语言模型(LLMs)进行微调,以用于预测股票回报的效果,并突出了回报预测在量化投资中的关键作用。文中描述的模型由文本表示和预测组件构成,并对比了编码器与解码器模型的不同效果。

AI16947的博客 1949

金融领域首个开源中文BERT预训练模型,熵简科技推出FinBERT 1.0

出品|AI科技大本营头图 | 优快云付费下载于东方IC为了促进自然语言处理技术在金融科技领域的应用和发展,熵简科技 AI Lab 近期开源了基于 BERT 架构的金融领域预训练语言...

AI科技大本营 3385

BERT 微调

BERT 微调对数据量的需求需结合任务类型、模型规模及微调策略等综合判断,不能简单用 “大量” 或 “少量” 概括。以下从不同维度具体分析:BERT 微调对数据量的需求并非绝对 “大量”,而是取决于任务复杂度、模型规模和优化策略:

mayaohao的博客 1274

BERT embedding 降维--BERT whitening

利用BERT whitening可以将embedding 比如768维降到256维 def compute_kernel_bias(vecs, n_components=256): """计算kernel和bias vecs.shape = [num_samples, embedding_size], 最后的变换:y = (x + bias).dot(kernel) """ mu = vecs.mean(axis=0, keepdims=True) cov =

zephyr_wang的博客 3038

bert微调和大模型微调区别

当任务是 **“理解文本并输出固定结果”**,且对成本和效率敏感时,选 BERT 微调,性价比更高;当任务需要 **“理解 + 生成 + 推理 + 交互”**,且场景复杂、开放度高时,选大模型微调,借助其通用能力实现更灵活的适配。两者本质都是 “迁移学习” 的体现,但 BERT 迁移的是 “文本理解能力”,大模型迁移的是 “通用智能基础”,这也决定了它们在场景中的不同分工。

mayaohao的博客 713

BERT 模型中 768 维词向量是否足够的问题

总之,768 维是 BERT-base 在 “性价比” 上的经典设计,足以应对大多数中文 NLP 场景,但复杂任务中仍需结合实际需求升级模型配置。关于 BERT 模型中 768 维词向量是否足够的问题,需要结合模型设计目标、任务复杂度和实际应用场景来综合分析。② 采用更高维度的模型(如 BERT-large)或集成模型;② 需要强推理或常识知识的任务(如复杂问答、逻辑判断);① 常规中文 NLP 任务(分类、分词、简单问答);① 超长篇文本理解(如法律文书、学术论文);② 数据充足且任务逻辑不复杂;

mayaohao的博客 760

BERT模型实战:金融新闻去重系统全解析

通过今天的实战,我们实现了:✅理解BERT的核心原理✅掌握文本向量化的完整流程✅实现智能的相似度判定系统✅学会调参优化技巧BERT模型就像是一位不知疲倦的语言专家,它能理解文字的"言外之意",发现表面不同但本质相同的信息。过滤冗余信息,提升阅读效率发现潜在关联,辅助决策分析自动化内容管理,降低人力成本记住:技术最终服务于人。从今天开始,尝试用BERT解决你身边的文本处理问题吧!每一步实践,都会让你离AI应用高手更近一步。

qq_51553749的博客 717

Bert-whitening 向量降维及使用

参考:https://kexue.fm/archives/8069 https://kexue.fm/archives/9079 https://zhuanlan.zhihu.com/p/531476789输入:vv是多个向量组成的三维矩阵 结果:v_data1 256维度 ***线上单个向量就把上面整体计算出的kernel,bias用上,直接transform_and_normalize(v_data, kernel=kernel, bias=bias)就行 线上单个向量降维......

weixin_42357472的博客 1752

【AI大模型微调】使用大模型预测股市收益,通过金融新闻数据对大模型进行微调

量化投资通过提取市场价格、经济指标和金融文本等数据源的量化特征来构建投资组合。本文聚焦于利用金融新闻进行股票回报预测,以帮助构建投资组合。

Gaga246的博客 1158

使用预训练的BERT进行金融领域问答

FinBERT的定制化使用:该项目使用了经过特定金融文本领域预训练的FinBERT模型,进一步针对金融领域微调,这使得它能够处理特定领域的复杂问题。相比传统的BERT模型,FinBERT对金融术语、金融报告、市场分析等领域的文本理解更加精准,从而显著提高了问答任务的表现。LSTM模型的集成:在项目中,除了BERT模型外,还引入了LSTM(长短期记忆网络)来处理特定类型的金融问答任务。

1577

金融新闻情感分析数据集_Financial-News-Sentiment-Classification-Data

金融新闻情绪分析数据集合_Financial-News-Sentiment-Analysis-Dataset 该数据集系统收录了专业财经媒体发布的新闻报道文本,并依据金融市场的情绪影响维度进行多层级标注。数据来源涵盖主流财经报刊、权威证券分析报告及上市公司公告等专业渠道,所有文本均经过金融领域专家的双重交叉验证,确保情绪标签与市场实际反应的对应准确性。 标注体系采用五级分类标准:强烈看涨、温和看涨、中性、温和看跌、强烈看跌,每个类别均附有基于历史行情数据的量化验证指标。数据时间跨度涵盖2015至2022年完整市场周期,包含牛熊市转换、政策调整期、黑天鹅事件等典型市场环境下的情绪样本,共计12.8万条标注记录。 除基础情绪标签外,数据集还提供行业板块关联、市值规模匹配、波动率区间等辅助维度,支持研究者在控制变量条件下进行情绪传导机制分析。所有文本均已完成去标识化处理,剔除广告内容及重复条目,并建立专业金融术语标准化词表以确保分析一致性。 该资源适用于构建基于深度学习的金融市场情绪监测模型,亦可作为量化投资策略的因子验证基础,相关技术文档详细说明了数据采集流程、标注质量控制方法及统计特征描述。 资源来源于网络分享,仅用于学习交流使用,请勿用于商业,如有侵权请联系我删除!

使用大模型预测股市收益,通过金融新闻数据对大模型进行微调

本文探讨了通过金融新闻流对大型语言模型(LLMs)进行微调以预测股票回报,强调回报预测在量化投资中的重要性。模型包括文本表示和预测模块,比较了编码器和解码器模型的表现。实验结果显示:LLM的token级嵌入聚合表示能提升长短仓组合的回报预测性能。在较大投资宇宙中,解码器模型表现更强;在小宇宙中无明显优劣。LLM的文本表示在组合构建中优于传统情感评分。研究表明LLM微调在回报预测和组合构建中具有潜力。

m0_59235699的博客 1636

MT6768平台Sensor Bring Up全流程实战:从驱动添加到问题排查(附避坑指南)

本文详细介绍了联发科MT6768平台Sensor Bring Up的全流程实战指南,从驱动添加、硬件配置到问题排查,提供了全面的避坑建议。内容涵盖环境准备、驱动文件集成、硬件接口配置、编译系统适配以及常见问题解决方案,帮助开发者高效完成传感器集成与调试工作。

weixin_30374009的博客 416

bert-base-chinese模型微调:领域适配实战

本文介绍了基于星图GPU平台自动化部署bert-base-chinese预训练模型镜像的实践方法,并以金融新闻情感分类任务为例,展示如何通过领域自适应微调提升模型在垂直场景下的文本分类性能,助力AI应用高效开发与落地。

weixin_36296444的博客 824

V-REP(Cooprliesim EDU)自学笔记 实现UR5机械臂末端按轨迹移动

V-REP(Cooprliesim EDU)自学笔记 实现UR5机械臂末端按轨迹移动

xu_white的博客 7583

告别偏移地址!用C# S7PLUS驱动读写西门子S7-1500符号地址(TIA Portal V17+环境配置)

本文详细介绍了如何在TIA Portal V17+环境中使用C# S7PLUS驱动读写西门子S7-1500 PLC的符号地址,告别传统的偏移地址方式。通过配置OpenSSL、集成S7PLUS驱动库,以及实战案例展示符号地址的读写方法,显著提升代码可读性和维护效率。文章还涵盖了环境准备、高级配置及常见问题解决方案,助力工业自动化开发者实现更高效的PLC通讯。

weixin_28720767的博客 317

BERT模型在金融新闻去重中的应用与实践

自然语言处理(NLP)中的语义理解技术正在深刻改变金融信息处理方式。基于Transformer架构的BERT模型通过双向注意力机制,实现了上下文感知的动态编码,有效解决了传统关键词匹配方法在金融文本处理中的局限性。在金融科技领域,这种深度学习技术特别适用于新闻去重、事件抽取等高价值场景。通过领域自适应(Domain Adaptation)和预训练微调,BERT可以精准识别金融术语的语义差异,如同义词替换和事件演进关系。实际应用中,结合SimHash快速过滤和BERT精筛的两级机制,在保证查全率的同时显著提升

weixin_30753873的博客 389

环境仿真软件:MIKE 21_(9).MIKE21水生植物模块介绍

MIKE21支持多种水生植物的模拟,用户需要在配置文件中定义植物种类及其特性。</</</</</</</</</假设我们需要定义一种新的水生植物“水葫芦”(Water Hyacinth),并将其特性写入配置文件。# 创建XML根元素# 定义新的植物种类# 生成XML文件假设我们需要分析仿真的水流速度变化,并绘制水流速度随时间变化的图。# 读取NetCDF文件# 获取水流速度数据# 获取时间数据# 绘制水流速度随时间变化的图plt.xlabel('时间 (天)')

kkchenjj的博客 727

构建基于大模型的金融新闻分析引擎

在金融领域,新闻信息的及时、准确分析对于投资者、金融机构等具有至关重要的意义。金融市场瞬息万变,大量的金融新闻不断涌现,传统的人工分析方法效率低下且难以全面覆盖。构建基于大模型的金融新闻分析引擎的目的在于利用先进的自然语言处理技术和大模型的强大能力,自动、快速且准确地对金融新闻进行分析,提取有价值的信息,如事件、情感倾向等,为金融决策提供有力支持。

AI天才研究院 1108

使用 MATLAB/Simulink 构建一个基于FOC控制的PMSM矢量控制仿真模型

本教程详细介绍了基于Simulink的永磁同步电机(PMSM)磁场定向控制(FOC)仿真建模过程。主要内容包括:PMSM电机参数设置、Clarke/Park变换模块设计、电流环PID控制器构建、SVPWM调制实现等关键步骤。教程提供了完整的建模流程、参数配置建议和仿真调试方法,并给出了PID整定技巧和进阶优化方向。通过该模型,可深入理解PMSM矢量控制原理,掌握高性能电机控制系统的建模技术,为伺服系统、电动汽车驱动等应用领域提供仿真基础。教程还推荐了使用PIDTuner工具进行参数优化,并提出了加入负载扰动

amy_mhd的博客 644

第八章 GPU Scheduler 分析:8.3 drm_sched_entity — 调度实体

本文介绍了DRM GPU调度器中的drm_sched_entity结构,它作为用户提交命令进入调度器的提交通道,解决了归属、排序和公平性问题。文章首先分析了命令提交的归属需求,然后详细阐述了entity的核心模型,包括其职责、进程映射关系和核心字段。接着说明了用户态提交进入内核后的关键节点路径,以及entity内部的FIFO语义和激活机制。entity通过组织同一context的命令提交包为FIFO队列,使调度器能够在多个entity之间进行优先级和公平性调度,同时保证同一提交通道的顺序执行。

图形/计算GPU的驱动与虚拟化技术分享园地 655

利用大模型与金融新闻数据微调,精准预测股市收益,我直呼好家伙!

本文探讨了通过金融新闻流对大型语言模型(LLMs)进行微调以预测股票回报,强调回报预测在量化投资中的重要性。模型包括文本表示和预测模块,比较了编码器和解码器模型的表现。实验结果显示:LLM的token级嵌入聚合表示能提升长短仓组合的回报预测性能。在较大投资宇宙中,解码器模型表现更强;在小宇宙中无明显优劣。LLM的文本表示在组合构建中优于传统情感评分。研究表明LLM微调在回报预测和组合构建中具有潜力。

2401_85390073的博客 1116

裂缝二维检测:裂缝的长度和宽度检测

这一节,我们需要去整合一下前面的代码,在进行长度和宽度的测量时,需要裂缝的类型、个数、面积的帮助。这一章是本专栏的核心部分。以上代码我均试过,由于本人能力有限,看不懂代码,最终还是没有采用,使用的是最普通检测宽度的方法,即求得骨架总长度后,用总面积求取平均宽度。

m0_62919535的博客 4241

如何让BERT更懂行业术语?金融文本填空微调部署

本文介绍了基于星图GPU平台自动化部署BERT智能语义填空服务镜像的完整方案,重点实现金融领域术语理解的精准填空。通过在金融新闻、研报等专业语料上进行模型微调,显著提升Top-1预测准确率,并支持WebUI交互与API集成,适用于智能写作、文档校验等AI应用开发场景。

weixin_35903223的博客 328

7.5华为OD机试真题 新系统 - 省超足球比赛获胜队伍计算 (Java/Py/C/C++/Js/Go)

7.5华为OD机试真题 新系统 - 省超足球比赛获胜队伍计算 (Java/Py/C/C++/Js/Go)

算法大师! 822

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

上一篇: 大模型RAG入门到实战基础教程(非常详细),大模型RAG入门到精通,收藏这一篇就够了!
下一篇: 为什么预训练大模型要使用无监督学习的方式?
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


