AI模型训练和评估的最佳实践:Transformers Trainer与Evaluate库详解

transformers 的Trainer的用法 Trainer 自动处理以下任务: ​​训练循环​​:自动实现 epoch 迭代、批次加载 ​​优化器&学习率调度​​:内置 AdamW 并支持自定义 ​​分布式训练​​:自动支持单机多卡(DataParallel/DistributedDataParallel) ​​混合精度训练​​:通过 fp16=True 启用 日志记录​​:集成 TensorBoard、Weights & Biases 等 ​​模型保存​​:定期保存检查点 + 最佳模型保存 ​​评估指标计算​​:自动计算验证集指标 阅读详情

AI模型训练和评估的最佳实践:Transformers Trainer与Evaluate库详解

在机器学习中,微调模型和评估其性能是确保模型有效性的重要步骤。Hugging Face 提供了强大的工具——Transformers Trainer 和 Hugging Face Evaluate,以简化这些过程。本文将详细介绍这两个模块的功能,并通过实际代码示例帮助您理解它们的使用方法。

一、Transformers 微调训练模块 Trainer

1. 简化模型的微调训练

Transformers Trainer 模块旨在简化模型的微调训练过程。假设我们已经有了一个预训练的模型,并且希望在自定义数据集上进行微调。Trainer 模块通过封装复杂的训练流程,使得微调变得更为直观和高效。

示例代码:

from transformers import Trainer, TrainingArguments, BertForSequenceClassification, BertTokenizer
from datasets import load_dataset

# 加载数据集
dataset = load_dataset('imdb')

# 加载预训练模型和分词器
model = BertForSequenceClassification.from_pretrained('bert-base-uncased')
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')

# 数据预处理
def preprocess_function(examples):
    return tokenizer(examples['text'], truncation=True, padding='max_length')

encoded_dataset = dataset.map(preprocess_function, batched=True)

# 定义训练参数
training_args = TrainingArguments(
    output_dir='./results',          # 输出目录    
    evaluation_strategy="epoch",     # 评估策略    
    learning_rate=2e-5,              # 学习率    
    per_device_train_batch_size=8,   # 训练批次大小    
    per_device_eval_batch_size=8,    # 评估批次大小    
    num_train_epochs=3,              # 训练轮次    
    weight_decay=0.01,               # 权重衰减
)

# 初始化 Trainer
trainer = Trainer(
    model=model,                         # 预训练模型    
    args=training_args,                  # 训练参数    
    train_dataset=encoded_dataset['train'],  # 训练数据集    
    eval_dataset=encoded_dataset['test']     # 评估数据集
)
# 开始训练trainer.train()

在上述代码中,我们首先加载了一个预训练的 BERT 模型和 IMDB 数据集。然后,我们定义了训练参数,并使用 Trainer 类来执行模型微调。在 Trainer 中,我们指定了模型、训练参数以及训练和评估数据集,最后调用 train() 方法开始训练。

2. 统一的训练参数配置

Transformers TrainingArguments 提供了一种统一配置训练参数的方式,简化了训练过程中的配置任务。所有的训练参数都可以在 TrainingArguments 中进行集中设置。

示例代码:
在这里插入图片描述

在这个配置中,我们设置了输出目录、训练轮次、批次大小、预热步数等参数。这样的集中配置使得管理训练参数变得更加方便和一致。

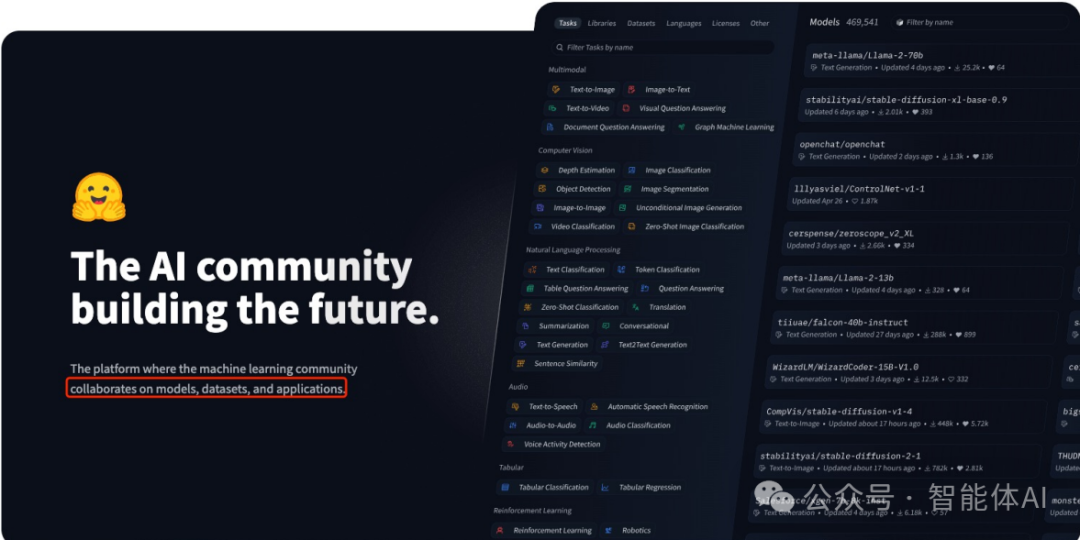
3. 丰富的数据集和模型支持
图片

Hugging Face Hub 提供了大量的预训练模型和数据集,用户可以方便地从中加载所需的资源。以下是如何从 Hub 中加载数据集和模型的示例:

示例代码:

在这里插入图片描述

这里,我们通过 load_dataset 加载了 IMDB 数据集,并使用 from_pretrained 方法加载了预训练的 BERT 模型和分词器。Hugging Face Hub 使得获取数据和模型变得非常简单。

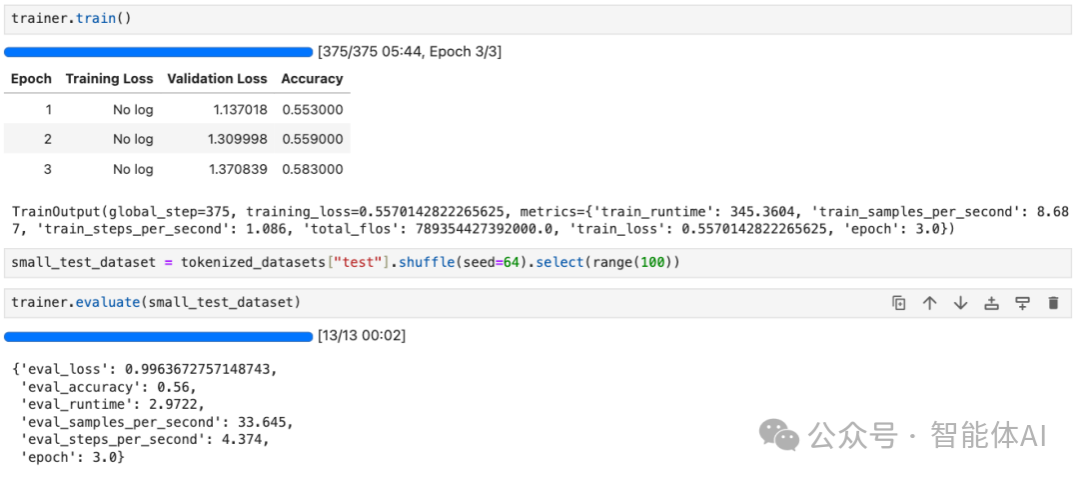
二、Transformers 模型评估库 Evaluate
图片

1. 轻松评估模型和数据集

在训练模型之后,评估其性能是验证模型有效性的关键步骤。Hugging Face Evaluate 库提供了简单易用的接口来进行模型评估。以下是一个使用 Evaluate 库进行评估的示例:

示例代码:

在这里插入图片描述

在这个示例中,我们加载了准确率评估指标,并计算了模型预测与真实标签之间的准确率。只需几行代码,Evaluate 库便可以轻松实现模型评估。

2. 一致且可重复的评估方式

Evaluate 库确保了无论是在本地还是分布式环境中,评估过程都能够保持一致性。以下是如何在分布式环境中进行评估的示例:

示例代码:

在这里插入图片描述

Evaluate 库提供了在不同计算环境下都能保持一致的评估结果,使得模型评估更加可靠。

三、总结

Transformers Trainer 和 Hugging Face Evaluate 是机器学习工作流中的两个重要工具。Trainer 模块通过简化微调训练过程和统一配置参数,帮助用户高效地进行模型训练;Evaluate 库则通过简便的一致性评估方法,确保模型性能的准确评估。掌握这些工具,将使您的机器学习实验更加高效和可靠。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

用Transformers的Trainer做Text-CNN文本分类 Transformers的Trainer这个类做Bert Fine-tuning时比较方便,近期用Text-CNN做文本分类实验提升推理速度时,就直接引用了Trainer的训练流程来训练text-CNN,简化训练步骤 import os import torch import numpy as np import torch.nn as nn import torch.optim as optim import torch.nn.functional as F from sklearn import met 阅读详情

相关推荐

基于BERT与HuggingFace Transformers的文本分类实战:从原理到工程部署

文本分类是自然语言处理(NLP)的基础任务,广泛应用于情感分析、新闻主题分类等场景。其核心原理是通过机器学习模型学习文本特征与类别标签的映射关系。随着预训练语言模型的发展,以BERT为代表的Transformer架构通过双向编码和自注意力机制,显著提升了模型对上下文语义的理解能力,为文本分类带来了突破性进展。这种技术价值在于能够高效捕捉文本中的复杂模式,尤其在处理网络新词和复杂句式时表现优异。在实际工程应用中,结合HuggingFace Transformers库可以快速实现模型微调与部署,大幅降低开发门槛

weixin_33978044的博客 430

如何使用transformers的trainer.train()函数如何训练自定义Bert的下游模型,并进行评估

训练模型:使用 Trainer.train() 函数训练模型。准备数据集:将原始数据集转换为适合 BERT 模型训练的格式,例如使用 tokenizer 对文本进行编码,将标签转换为数字等。定义数据加载器:使用 Dataset 和 DataLoader 对数据集进行加载和处理,以便在训练期间以批量的方式输入模型。创建 Trainer 对象:使用自定义的模型、数据加载器、训练参数和评估指标创建 Trainer 对象。定义模型:定义一个自定义的 BERT 模型,并根据任务类型添加相应的输出层。

weixin_44002458的博客 6149

4.5 Transformers模型训练入门:手把手教你用Hugging Face打造企业级BERT模型(附代码实战)

显存优化技巧梯度检查点():牺牲20%速度换取显存节省使用优化器:8-bit AdamW 可减少75%显存占用训练稳定性保障学习率预热():防止初始阶段梯度爆炸梯度裁剪():限制梯度范数(图:BERT模型训练全流程示意图,包含数据加载、模型前向、损失计算、反向传播等模块)下节预告:在第五章《大模型高效微调技术揭秘》中,我们将深入解析LoRA、QLoRA等参数高效微调技术,帮助企业节省90%以上的训练成本!

yonggeit的博客 3035

Transformers实战——使用Trainer类训练和评估自己的数据和模型

使用Transformers中的Trainer类训练自己的模型

HMT的博客 3万+

射频工程师笔记---射频通信基础

回顾一下移动通信技术的发展,其实是互联网和通信技术的融合过程。在这个过程中,很多应用都在不断加入其中。比如计算机跟通信的融合产生了互联网、互联网跟手机的融合带来了移动互联网。手机可以看杂志、看视频、听音乐,于是又出现了内容服务产业;再后来,电视音箱等设备也能联网,于是网络跟家电又产生了融合。所以应用的出现总是在融合其他产业。在1995年,比尔·盖茨在《未来之路》一书中首次提出:在未来...

多年硬件从业经历,热爱学习,记录生活! 2万+

特斯拉数字孪生4.0体系解析:从“数字镜像“到“持续进化“的造车革命

当每一辆汽车都拥有自己的“数字分身”,我们正见证的不仅是技术革新,更是整个制造业文明形态的跃迁。其数字孪生体已超越“数字镜像”的被动属性,成为。特斯拉年服务收入超1200美元/车的业绩表明,数字孪生正在将汽车从“交通工具”转变为“持续增值的智能终端”。构建起覆盖设计、制造、使用、服务全链条的虚拟镜像体系,将物理世界与数字世界的融合推向新高度。:特斯拉的实践证明,数字孪生已从“技术选项”升级为“战略必选项”。不仅重塑了汽车产品的价值创造逻辑,更预示着整个制造业向“元宇宙工业”演进的新范式。

beige888的博客 1608

AI模型训练和评估的最佳实践:Transformers Trainer与Evaluate库详解!

Transformers Trainer 和 Hugging Face Evaluate 是机器学习工作流中的两个重要工具。Trainer 模块通过简化微调训练过程和统一配置参数,帮助用户高效地进行模型训练;Evaluate 库则通过简便的一致性评估方法,确保模型性能的准确评估。掌握这些工具,将使您的机器学习实验更加高效和可靠。

Androiddddd的博客 1470

别再模拟IIC了!用STM32F103C8T6的硬件IIC驱动AT24C64,CubeMX配置+避坑指南

本文详细介绍了如何使用STM32F103C8T6的硬件IIC驱动AT24C64 EEPROM,通过CubeMX配置和HAL库函数解析,提供从模拟IIC到硬件IIC的完整解决方案。内容包括硬件IIC与模拟IIC的核心差异、CubeMX工程配置详解、HAL库驱动实战以及典型问题诊断与优化,帮助开发者构建更稳定高效的存储系统。

weixin_27038245的博客 188

Transformers基本组件(二)快速入门Datasets、Evaluate、Trainer

Transformers基本组件(二)快速入门Datasets、Evaluate、Trainer

qq_44665283的博客 4149

基于GPU的GEMM矩阵相乘运算优化

从上图中我们可以看到三种处理方法。第一种是将A和B矩阵分块,第二种方法是将C和B矩阵分块,第三种方法是将C和A矩阵分块。GEMM的子任务是GEPP或GEMP;最小粒度的任务是GEBP或GEPB或点乘。

weixin_55035144的博客 2155

利用按键精灵实现批量截图与智能命名的高效工作流

本文详细介绍了如何利用按键精灵软件构建高效的批量截图与智能命名自动化工作流。通过基础脚本编写、循环逻辑实现及高级命名策略,解决手动操作耗时易错的问题,帮助用户实现一键自动截图、智能保存与文件重命名,大幅提升软件测试、教程制作及数据报告等场景的工作效率。

weixin_29268267的博客 569

hugging face transformers 库使用手册(三):精调预训练模型操作指南(API: Trainer)

使用 huggingface transformers 库进行模型精调

Cleo_Gao的博客 1465

分布式系统中的“无状态”和“有状态”详解

有状态服务,即服务端需要记录每次会话的客户端信息,从而识别客户端身份,根据用户身份进行请求的处理,典型的设计如 tomcat 中的 session。例如登录:用户登录后,我们把登录者的信息保存在服务端 session 中,并且给用户一个 cookie 值,记录对应的 session。然后下次请求,用户携带 cookie 值来,我们就能识别到对应 session,从而找到用户的信息。

AI天才研究院 2万+

【AI大模型】Transformers大模型库(十二):Evaluate模型评估

Transformers库中的evaluate API主要用于评估模型在特定数据集上的性能。虽然Transformers库本身没有直接提供一个名为evaluate的独立API函数,但通常通过Trainer类的evaluate方法来实现模型评估。

人工智能领域博客 1375

猿创征文|Qt 文件和目录应用讲解【QCoreApplication】【QFile、QFileInfo】【QTemporaryDir和QTemporaryFile】【QDir】【QFileSyste】

Qt 文件和目录精准讲解【QCoreApplication】【QFile、QFileInfo】【QTemporaryDir和QTemporaryFile】【QDir】【QFileSyste】【QFileDialog】 第一章 QCoreApplication类 第一节 QCoreApplication常用函数方法 第二节 QCoreApplication举例 第二章 QFile类 第一节 静态函数方法 第二节 成员函数方法 第三章 QFileInfo类 第一节 常用函数方法 第四章 QDir类

Qt历险记,专注Qt技术,三年医疗设备研发经验,1年机器视觉研发经验,半年柔性传感研发经验。 942

【AI智能体】Hermes Agent 从部署到项目实战操作详解

Hermes Agent 桌面版从安装到实战操作详解

congge 5136

FlexGen 仓库 transformers 图像分类微调实战:Trainer 与 Accelerate 双方案详解

本文基于 FlexGen 仓库中随附的 HuggingFace Transformers 图像分类微调示例([benchmark/third_party/transformers/examples/pytorch/image-classification](https://link.gitcode.com/i/44ca1bd1f3edb397d1f08d9bb63be77f)),系统讲解两套可运行

gitblog_01007的博客 955

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Sentence Transformers 训练完全指南:从模型架构、数据格式到 Trainer 微调实战

本文基于 sentence-transformers 仓库的官方训练概览文档([docs/sentence_transformer/training_overview.md](https://link.gitcode.com/i/5e6487f055be80eb116b714f9a39d4b5)),系统讲解如何微调(Finetune)Embedding 模型:从"为什么需要微调"出发,逐步拆解训练

gitblog_00389的博客 482

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

预训练 Transformer 模型的简介

原文:towardsdatascience.com/an-introduction-to-fine-tuning-pre-trained-transformers-models-9ea546611664Image fromby是众多流行开源 NLP 模型的家园。其中许多模型本身就很有效,但通常需要某种形式的训练或微调来提高特定用例的性能。随着大型语言模型(LLM)的崩溃继续,本文将回顾 HuggingFace 提供的一些核心构建块,这些构建块简化了 NLP 模型的训练。

龙哥盟 1066

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

HEVC还是H.264?micam视频编码、流通道选择与性能调优完整指南

在 micam 视频编码选择上纠结 HEVC 还是 H.264?这是部署小米摄像头 RTSP 桥接时最容易踩的坑。micam 是一款专为小米摄像头打造的 RTSP 桥接服务(非官方),它基于小米官方 Miloco 获取摄像头实时画面,再通过 FFmpeg 免转码推流到 RTSP 服务器,让你把小米摄像头接入 Home Assistant、Frigate、Scrypted、HomeKit 等主流 N

gitblog_00580的博客 382

python transformers笔记(Trainer类)

Trainer是Hugging Face Transformers库中用于简化模型训练和评估的核心工具类。它封装了标准的训练循环(如批次处理、反向传播、优化器更新等),支持分布式训练、混合精度计算和自动日志记录,极大减少了重复代码。

夏末蝉未鸣的博客 801

聊聊预训练模型的微调

`Transformers` 提供了一个 `Trainer` 类,处理微调在数据集上提供的任何预训练模型。 完成所有数据预处理工作后,只需执行几个步骤即可定义 Trainer。 最困难的部分可能是准备运行 `Trainer.train()` 的环境,因为它在 CPU 上运行速度非常慢。 如果没有设置 GPU,可以在 Google Colab 上访问免费的 GPU 或 TPU。

2401_85327249的博客 823

LLM·transformers库

最常见的用法:,直接将原始输入处理为token后的id,还包括掩码和一些其他东西。 注意:这个参数表示返回pytorch类型的tensor,最好勾选上,不然就会返回一个列表!其他用法: 加载时划分数据集 查看数据集 DatasetDict支持使用键的方式查询对应的数据,类似pandas :包括title和content的列表 数据集手动划分 调用函数指定划分。 选择数据作为新数据集 选择特定数据作为新数据集 过滤数据: 用于清洗异常值或者缺失值 数据映射:将数据打包为 映射

2301_80132162的博客 405

HuggingFace Transformers 翻译任务微调实战指南:基于 run_translation.py 与 run_translation_no_trainer.py

本文聚焦 HuggingFace Transformers 官方示例中针对**机器翻译(Translation)任务**的微调与评估方案,对应仓库内的 [翻译示例目录](https://link.gitcode.com/i/529b51689aa82e440927dc70fcc35c76)。你将学会使用 `run_translation.py`(基于 `Trainer` 的高层封装)和 `run_

gitblog_01064的博客 383

Transformers模型微调

若果想向数据集添加额外的属性,例如标签。

cancer_s的博客 631
上一篇: 我机械的,转行 AI 竟然成功了!
下一篇: 端侧Agent系列 | 端侧AI Agent任务拆解大师如何助力AI手机?(详解版)
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


