大模型实战教程:使用Langchain与ChatGLM实现本地知识库

Langchain-ChatGLM:基于本地知识库问答 ChatGLM-6B 是⼀个开源的、⽀持中英双语的对话语⾔模型,基于 General LanguageModel (GLM) 架构,具有 62 亿参数。结合模型量化技术,用户可以在消费级的显卡上进行本地部署(INT4 量化级别下最低只需 6GB 显存)。ChatGLM-6B 使用了和 ChatGPT 相似的技术,针对中文问答和对话进行了优化。 阅读详情

大语言模型也只是将用户提供的大规模数据集训练而来,也并非万能的什么都知道,特别是一些小众知识、内部数据或私密的个人数据等,此时ChatGLM3肯定会胡乱回答就是ChatGPT4也不一定能给出满意回答;不少公司、个人都有自己的知识库或日志等此时如有可将这些数据以某种方式挂在大模型上此时在知识库存在的知识可从中作答,不属于知识库中的内容还是按照大模型原来方式生成,精准度会高不少;知识库的内容包括文本、PDF、图片、视频、网页等等;
  基于LLM的本地私有化知识库实现主要分为两种:
  1、模型训练微调: 将知识库的内容整理成训练数据集,拿这些整理好的数据集来训练该模型,最终让模型“学会”该知识库的内容,至于效果如何很大程度取决于该数据集的质量和训练的调参,这种方式较复杂、门槛高;
  2、外挂知识库: 在向模型提问时提供一些知识库中的内容让它在其中找到正确的答案,外挂的形式门槛相对低一点大部分的工作主要是文档的处理:加载、切分、向量化、持久化、相识度对比等以及Prompt编写,本文所使用的方式也是此种;

文档处理

这里只涉及到文本的处理,比较好的做法是从知识库中挑选出问题以及相关的内容,这样准确的相对比较高,本文只是简单粗暴的把所有数据都丢给它让它去学习处理;

知识库预处理相关概念

加载文件: 加载知识库中的文本
  文本分割(TextSplitter): 按一定规则将文本分割,具体参数有:separator:分隔符、chunk_size: 文本块长度、chunk_overlap: 文本块之间重叠的长度、length_function:计算长度的方法;文本块长度选择可能会对文本分割效果右较大的影响;

文本向量化: 将文本转换为向量,文本向量化后用于后续存储、计算相识度、检索相关文本等;

文本内嵌(Embedding): 将离散的符号或对象表示为连续的向量空间中的点;文本嵌入可用于以下功能:搜索、聚类、推荐、异常检测、多样本测量、分类;此处主要是用于查询的嵌入向量(问题向量化后)与每个文档的嵌入向量之间的余弦相似度,并返回得分最高的文档。Embedding开源模型模型有:Text2vec、Ernie-3.0、M3E等

持久化: 将向量化的数值存储到向量数据库方便后续直接使用,向量数据库有Chroma、Qdrant等;

代码实现

下面通过使用LangChain与ChatGLM实现本地知识库外挂,主要分为如下几步:启动ChatGLM ApiServer服务、加载文档与文本分割、文本向量化与文本内嵌、通过LangChain将LLM与向量库Retriever(检索器)关联、绑定gradio;
  由于网络原因在此过程中会下载nltk_data数据集 与Embedding模型 ,自动下载可能不会成功,可手动下载放到相关目录即可;

导入模块
from langchain.document_loaders import DirectoryLoader
from langchain.text_splitter import CharacterTextSplitter
from langchain.vectorstores.chroma import Chroma
from langchain.embeddings.huggingface import HuggingFaceBgeEmbeddings
import os
from langchain.chains import RetrievalQA
from langchain.llms.chatglm import ChatGLM
from langchain.prompts import PromptTemplate

embedding_model_dict={
    'ernie-tiny':"nghuyong/ernie-3.0-nano-zh",
    'ernie-base':"nghuyong/ernie-3.0-base-zh",
    'text2vec':"GanymedeNil/text2vec-large-chinese",
    'text2vec2':"ver/sbert-base-chinese-nil",
    'text2vec3':"shibing624/text2vec-base-chinese",
}

安装依赖

pip install unstructured 
pip install sentence_transformers 
pip install chromadb
pip install gradio

加载文档与文本分割: 通过LangChain目录加载器加载指定目录中的所有文档,使用字符文本分割器对所有文档进行分割,文本块大小为265、块重叠长度为0;其他分割器还有:MarkdownHeaderTextSplitter、HTMLHeaderTextSplitter、RecursiveCharacterTextSplitter等;

def load_documents(dir="books"):
    loader = DirectoryLoader(dir)
    documents= loader.load()
    text_spliter = CharacterTextSplitter(chunk_size=265,chunk_overlap=0)
    split_docs = text_spliter.split_documents(documents)
    return split_docs

文本向量化与文本内嵌: 将文档存储向量库Chroma,并指定文档的Embedding模型;

def store_chroma(docs,embeddings,dir="VectorStore"):
   db = Chroma.from_documents(docs,embeddings,persist_directory=dir)
   db.persist()
   return db

载入embedding模型: 加载HuggingFaceBge托管的Embedding模型;

def load_embedding_mode(model_name='tiny'):
    encode_kwargs = {'normalize_embeddings': False}
    # model_kwargs = {'device':'cuda:0'}
    return HuggingFaceBgeEmbeddings(
        # model_name=embedding_model_dict[model_name],
        model_name="./ernie-3.0-nano-zh",
        encode_kwargs=encode_kwargs
    )

加载向量库: 如本地存在持久化的向量库则加载否则加载文档并存储向量库;

def load_db():
  embeddings =  load_embedding_mode('ernie-tiny')
  if not os.path.exists('VectorStore'):
     documents = load_documents()
     db = store_chroma(documents,embeddings)
  else:
     db = Chroma(persist_directory='VectorStore',embedding_function=embeddings)
  return db

定义LLM关联检索问答链:定义ChatGLM模型调用客户端、获取向量库检索器retriever 、定义LangChain问答链RetrievalQA对象,链类型为:stuff、LLM模型为ChatGLM;
   token: 最大8000
   top_p: 影响文本多样性,越大多样性越强取值范围:[0,1.0]
   chain_type_kwargs: 使用prompt可让QA给出格式化的答案,如典型prompt为:

 """已知信息:{context} 根据上述已知信息,简洁和专业的来回答用户的问题。如果无法从中得到答案,请说 “根据已知信息无法回答该问题” 或 “没有提供足够的相关信息”,不允许在答案中添加编造成分,答案请使用中文。问题是:{question}"""  

chain_type: 参数包括如下几种:
   stuff: 适用小文本,速度较快将所有相关文档块拼接起来给LLM,可能会超过上下文大小
   map_reduce:LLM对每个相关文档块做一次总结,LLM把后总结汇总再做最终总结
   refine:LLM对每一个文档块进行总结,后逐步汇总成一个总结
   map_rerank: 对文档块总结进行打分,答案取选取分数高

PROMPT_TEMPLATE = """已知信息:{context} 
根据上述已知信息,简洁和专业的来回答用户的问题。如果无法从中得到答案,请说 “根据已知信息无法回答该问题” 或 “没有提供足够的相关信息”,不允许在答案中添加编造成分,答案请使用中文。问题是:{question}
"""
PROMPT = PromptTemplate(
    template=PROMPT_TEMPLATE, input_variables=["context", "question"]
)
def retrieverQa():
    db=load_db()
    retriever = db.as_retriever()
    llm = ChatGLM(
    endpoint_url="http://127.0.0.1:8000",
    max_token=8000,
    top_p=0.9)
    qa = RetrievalQA.from_chain_type(
        llm=llm,
        chain_type='stuff', 
        retriever=retriever,
        chain_type_kwargs={"prompt": PROMPT}
    )
    return qa

关联gradio: 将RetrievalQA对象与gradio关联,把页面输入的内容传入问答器;

def chatQA(quetion,history):
    qa = retrieverQa()
    resp = qa.run(quetion)
    return resp

demo = gr.ChatInterface(chatQA)
demo.launch(inbrowser=True)

最终效果

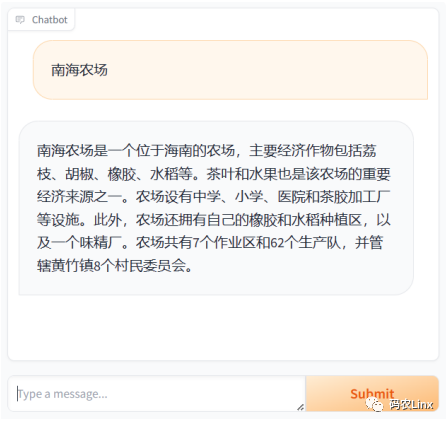
通过问答对比可以看到外挂知识库后效果比较明显,并不会无中生有,根据知识库选取了相关内容总结回答;

未接入本地知识库时,ChatGLM3模型输出的内容:
南海农场位于中国海南省三亚市,是一个重要的热带农业基地。这里种植着各种热带作物,如水稻、蔬菜、水果等,满足三亚市及附近地区的居民和游客的需求。南海农场还具备较高的生态价值,为当地的生态环境保护和可持续发展做出了贡献。
使用了本地知识库后:
南海农场是一个位于海南的农场,主要经济作物包括荔枝、胡椒、橡胶、水稻等。茶叶和水果也是该农场的重要经济来源之一。农场设有中学、小学、医院和茶胶加工厂等设施。此外,农场还拥有自己的橡胶和水稻种植区,以及一个味精厂。农场共有7个作业区和62个生产队,并管辖黄竹镇8个村民委员会。
图片

这仅仅是一个Demo外挂知识库的最终效果如何取决于:文本分割、Embedding模型、向量库、LLM模型、知识库的预处理、调参等等;

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

基于ChatGLM2和langchain的本地知识库问答的实战方案 本文主要介绍了基于ChatGLM2和langchain的本地知识库问答的实战方案,希望对学习大语言模型的同学们有所帮助。 文章目录 1. 介绍 2. 配置环境 2.1 ChatGLM2环境搭建 2.2 进一步环境搭建 3. 修改配置文件 4. 运行代码 阅读详情

相关推荐

【ChatGLM】基于 ChatGLM-6B + langchain 实现本地化知识库检索与智能答案生成: 中文 LangChain 项目的实现开源工作

陈光剑简介:著有《ClickHouse入门、实战与进阶》(即将上架)《Kotlin 极简教程》《Spring Boot开发实战》《Kotlin从入门到进阶实战》等技术书籍。资深程序员、大数据与后端技术专家、架构师,拥有超过10年的技术研发和管理经验。现就职于字节跳动,曾就职于阿里巴巴,主要从事企业智能数字化经营管理、电商智能数字化运营等系统架构设计和研发工作。在大数据和企业级系统架构领域有非常深厚的积累,擅长大数据系统架构和分布式系统架构设计开发。

AI天才研究院 7万+

大语言模型langchain+ChatGLM3-6B+本地知识库实战

在aliyun选择硬件资源,选择镜像版本时格外注意pytorch、cuda的版本:pytorch=2.1.2、cuda=12.1、python=3.10,还有modelscope=1.11.0与Tensorflow=2.14.0。其中,model_copy.py里的默认内容不需要删除(有些教程建议删除),将embedding\model相关路径改成绝对路径即可。微调、本地知识库和 prompt 是LMM模型调整和优化中的重要概念,它们之间有一定的关系和区别。处理完成后,再次上传,成功。问题解决,可以上传。

North_D的博客 5240

化学科学催化反应产率预测之Transformer建模SMILES(Datawhale AI 夏令营)

循环神经网络:由于所有的前文信息都蕴含在一个隐向量中,随着序列长度的增加,早期的上下文信息会逐渐被遗忘。卷积神经网络:受限的上下文窗口在建模长文本时存在天然不足。需要多层卷积操作才能处理长文本。在本篇文章中,我们学习了Transformer的基本架构及其在化学反应产率预测中的应用。通过利用Transformer的Encoder部分对SMILES进行建模,我们能够更有效地捕捉序列数据的特征,从而提高模型的预测性能。

不想宅的冷同学 1095

开发者实战 | 基于 OpenVINO™ 和 LangChain 构建 RAG 问答系统

点击蓝字关注我们,让开发变得更有趣作者| 杨亦诚排版| 李擎基于 OpenVINO™ 和LangChain 构建RAG问答系统背景随着生成式AI的兴起,和大语言模型对话聊天的应用变得非常热门,但这类应用往往只能简单地和你“聊聊家常”,并不能针对某些特定的行业,给出非常专业和精准的答案。这也是由于大语言模型(以下简称LLM)在时效性和专业性上的局限所导致,现在市面上大部分开源的LLM几乎都只是使用...

OpenVINO的博客 938

Windows 11下WSL2安装CUDA避坑指南:从驱动版本匹配到环境变量配置

本文详细解析了在Windows 11的WSL2中搭建CUDA开发环境的完整流程与核心避坑要点。关键在于理解“驱动在Windows,工具链在Linux”的独特架构,并确保显卡驱动与CUDA Toolkit版本严格匹配。指南涵盖了从驱动验证、WSL-Ubuntu专用仓库安装、环境变量配置到GCC版本冲突、GPU算力不匹配等常见问题的解决方案,帮助开发者高效构建稳定的深度学习与高性能计算环境。

smartcontract5的博客 467

天地图Api4.0.怎么根据geojson的数据。把一个省的所有市区标记色块和文字

天地图

肖肖肖丽珠的博客 1513

chatglm6b和闻达的功能扩展

最近大火的chatgpt,老板说让我看看能不能用自己的数据,回答专业一些,所以做了一些调研,最近用这个倒是成功推理了自己的数据,模型也开源了,之后有机会也训练一下自己的数据。

weixin_38226321的博客 4091

紫光同创PGL50H开发板PCIE通信保姆级教程:从IP核安装到Windows设备管理器识别

本文详细介绍了紫光同创PGL50H开发板PCIE通信的全流程,从IP核安装到Windows设备管理器识别。通过环境搭建、工程配置、管脚约束、固件烧录等步骤,帮助开发者快速掌握FPGA与PCIE通信技术,解决实际开发中的常见问题,提升开发效率。

weixin_30500473的博客 433

LangChain + Embedding + Chromdb,关联使用ChatGLM的本地搭建训练平台教程

OpenAI 在国内用户注册会遇到各种阻力,目前可行的方法是使用本地数据集的功能实现联网搜索并给出回答,提炼出TXT、WORD 文档里的内容。LangChain。​ 这个库目前非常活跃,每天都在迭代,已经有 22k 的 star,更新速度飞快。LangChain 是一个用于开发由语言模型驱动的应用程序的框架。他主要拥有 2 个能力:可以将 LLM 模型与外部数据源进行连接允许与 LLM 模型进行交互LLM 模型:Large Language Model,大型语言模型。

查理王的博客 1万+

问题解决:打开VMware创建的虚拟机,电脑立刻蓝屏并重启

VMware Workstation 与 Device/Credential Guard 不兼容。在禁用 Device/Credenti

weixin_55118477的博客 3万+

Vivado ILA抓不到低频信号?试试Capture Control模式,保姆级配置教程(附PWM调试实例)

本文详细解析了Vivado ILA的Capture Control模式在低频信号捕获中的应用,特别针对PWM调试等场景提供保姆级配置教程。通过条件采样和时间拉伸技术,有效解决传统ILA采样在低频信号调试中的存储深度不足、关键信号丢失等问题,并附赠呼吸灯PWM的完整调试实例,帮助FPGA开发者提升调试效率。

weixin_42549451的博客 350

基于langchain+chatGLM搭建部署本地私有化知识库系统

基于langchain+chatGLM搭建部署本地私有化知识库系统

Together_CZ的博客 1万+

YOLOv11改进策略【小目标改进】| Shape-NWD:融合改进,结合Shape-IoU和NWD 更好地适应小目标特性

Bw−wgt2h−hgt2weight2Bweight2w−wgt​2h−hgt​2​其中weight2weight = 2weight2。

Limiiiing的博客 3052

大模型实战教程,使用Langchain与ChatGLM实现本地知识库!

定义ChatGLM模型调用客户端、获取向量库检索器retriever 、定义LangChain问答链RetrievalQA对象,链类型为:stuff、LLM模型为ChatGLM;token: 最大8000top_p: 影响文本多样性,越大多样性越强取值范围:[0,1.0]

2301_82275412的博客 1489

Claude Code 分布式并行开发最佳实践:1中枢+10Worker跨多Git仓库全流程落地

本文介绍了一套基于Claude Code和Git Worktree的分布式并行开发方案,解决多仓库、微服务开发中的核心痛点。方案采用"1个决策中枢+10个并行Worker"架构,中枢负责任务拆解和调度,每个Worker绑定独立仓库实现完全隔离开发。关键优势包括:任务并行效率提升10倍、跨仓库依赖自动编排、版本统一管理、零第三方依赖。文章详细提供了环境准备、架构设计、中枢搭建和初始化脚本等全流程落地指南,特别适合多仓库协同的全栈开发场景。

AI天才研究院 244

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

基于langchain-chatchat-chatglm构建本地离线知识库大模型

本地部署离线大模型,并且支持创建本地知识库迭代更新

Darlight的博客 2971

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

基于Langchain-Chatchat + chatGLM3 轻松在本地部署一个知识库

一种利用 langchain 思想实现的基于本地知识库的问答应用,目标期望建立一套对中文场景与开源模型支持友好、可离线运行的知识库问答解决方案。该项目是一个可以实现 __完全本地化__推理的知识库增强方案, 重点解决数据安全保护,私域化部署的企业痛点。本开源方案采用Apache License,可以免费商用,无需付费。目前支持市面上主流的本地大语言模型和Embedding模型,支持开源的本地向量数据库。本项目实现原理如下图所示,过程包括加载文件->读取文本->文本分割->文本向量化->问句向量化->

最美dee时光的博客 1万+

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

【LLM大模型】使用Langchain与ChatGLM实现本地知识库

大语言模型也只是将用户提供的大规模数据集训练而来,也并非万能的什么都知道,特别是一些小众知识、内部数据或私密的个人数据等,此时ChatGLM3肯定会胡乱回答就是ChatGPT4也不一定能给出满意回答

pythonhy的博客 1803

使用Langchain与ChatGLM实现本地知识库(附教程)

大语言模型也只是将用户提供的大规模数据集训练而来,也并非万能的什么都知道,特别是一些小众知识、内部数据或私密的个人数据等,此时ChatGLM3肯定会胡乱回答就是ChatGPT4也不一定能给出满意回答;不少公司、个人都有自己的知识库或日志等此时如有可将这些数据以某种方式挂在大模型上此时在知识库存在的知识可从中作答,不属于知识库中的内容还是按照大模型原来方式生成,精准度会高不少;知识库的内容包括文本、PDF、图片、视频、网页等等;

DEVELOPERAA的博客 1005

一文教你基于LangChain和ChatGLM3搭建本地知识库问答

借助ModelArts提供的AI开发能力,实现基于LangChain+ChatGLM3的本地知识库问答,通过具体案例让开发者更加清晰的了解大模型AI应用开发过程。

华为云官方博客 3101

LangChain + ChatGLM 实现本地知识库问答

本文使用LangChain+ChatGLM来实现一个简单的基于本地知识库的问答系统,可以在完全不使用openai提供的api来完成本地知识库问答系统的搭建,如果有需要做本地私有化知识库问答系统的,可以参考此方案。

python12345_的博客 1780

chatglm实现基于知识库问答的应用

本文旨在通过介绍ChatGLM的使用来讲述如何将一个开源的语言模型应用于智能问答,知识库问答的场景中,通过一系列实操例子来理解整个应用思路。本文章仅仅介绍了最简单的通过向量索引库加AI模型加提示工程来实现知识库问答的方案,其中向量索引和文档的处理非常原始与粗糙,想要实现更加精准的匹配还需要根据实际文档内容和场景来进行修改。相关代码已上传github感兴趣的同学可以 clone 下来跑一跑。

爱吃回锅肉的胖子 1万+

基于Langchain-Chatchat + ChatGLM 本地部署知识库

基于Langchain - Chatchat 与 ChatGLM的本地部署知识库来啦!保障数据隐私,定制知识体系,重塑知识交互体验 。快跟着小编快速搭建吧~

SJJS_1的博客 1521

LangChain + ChatGLM2-6B 搭建个人专属知识库

之前教过大家利用 langchain + ChatGLM-6B 实现个人专属知识库,非常简单易上手。最近,智谱 AI 研发团队又推出了 ChatGLM 系列的新模型 ChatGLM2-6B,是开源中英双语对话模型 ChatGLM-6B 的第二代版本,性能更强悍。 树先生之所以现在才更新 ChatGLM2-6B 知识库教程,是想等模型本身再多迭代几个版本,不至于刚出的教程很快不适配,或者项目本身一堆 bug,那样大家使用体验也不好。

程序员树先生的博客 7584

本地知识库部署:使用Langchain与ChatGLM实现本地知识库(附教程)

本地知识库部署:使用Langchain与ChatGLM实现本地知识库(附教程)

pythonhy的博客 1161

使用Langchain与ChatGLM实现本地知识库

大语言模型也只是将用户提供的大规模数据集训练而来,也并非万能的什么都知道,特别是一些小众知识、内部数据或私密的个人数据等,此时ChatGLM3肯定会胡乱回答就是ChatGPT4也不一定能给出满意回答

瓦罗兰特顶级C位的博客 1015
上一篇: 零基础转行自学大模型路线规划(附快速学习路线图)
下一篇: 新手0基础AI产品经理必看:如何用LLM技术优化你的产品?——以自营电商的产品描述生成器为例
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值