9行代码开发一个基于ollama的私有化RAG

私有化部署 Dify+Ollama并使用qwen2快速搭建 AI 应用 Dify 是一款开源的大语言模型(LLM) 应用开发平台。它融合了后端即服务(Backend as Service)和 LLMOps 的理念,使开发者可以快速搭建生产级的生成式 AI 应用。即使你是非技术人员,也能参与到 AI 应用的定义和数据运营过程中。 阅读详情

前言

OpenAI(LLM + Embedding)是使用LiteLLM + ollama模拟,具体做法如下,

Llamaindex OpenAI LLM 模型默认使用的是gpt-3.5-turbo, embedding 模型默认使用的是text-embedding-ada-002, 所以这里使用litellm 配合config来模拟,

一句话介绍LiteLLM

使用OpenAI格式调用所有LLM API。使用Bedrock,Azure,OpenAI,Cohere,Anthropic,Ollama,Sagemaker,HuggingFace,Replicate(100+ LLM)。

安装LiteLLM

pip install 'litellm[proxy]'

模型映射

创建litellm.yaml
在这里插入图片描述

运行litellm

litellm --config litellm.yaml

💡,这样模拟的OpenAI不支持function call,所以index.as_chat_engine(chat_mode="condense_question") 不能使用默认的chat_mode。

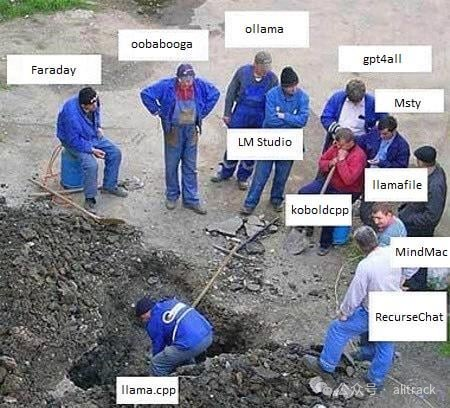
如果想部署并使用开源模型,不需要这么麻烦,我们可以根据需要选择合适的方案,这里我介绍下ollama的实现。
图片

llama.cpp

Ollama

Ollama 提供了多种LLM模型和embedding模型(如all-minilm,mxbai-embed-large,nomic-embed-text,snowflake-arctic-embed 等), 如果没有你想用的,也可以自己导入gguf格式模型。

关于ollama,这里就不展开了,有兴趣的可以看看我的另外一篇文章:[ollama 使用技巧集锦](https://mp.weixin.qq.com/s?__biz=MzU1NTg2ODQ5Nw==&mid=2247489345&idx=1&sn=342eea6917c3 ba45e3da9146dcb4ec45&chksm=fbcc9f7fccbb16691c5a43ca5b454af2a59d4387d206024ae61f046a12431469bfe16e2d7c05&token=964566570&lang=zh_CN&scene=21#wechat_redirect)

安装包

pip install llama-index-embeddings-ollama
pip install llama-index-llms-ollama

代码

from llama_index.core import VectorStoreIndex, Document, SimpleDirectoryReader,Settings
from llama_index.llms.ollama import Ollama
from llama_index.embeddings.ollama import OllamaEmbedding
# 指定LLM
Settings.llm = Ollama(model="wizardlm2:7b-q5_K_M", request_timeout=60.0)
# 指定 embedding model
Settings.embed_model = OllamaEmbedding(model_name="snowflake-arctic-embed:latest")
## 剩下代码一样
documents = SimpleDirectoryReader("./data").load_data()
index = VectorStoreIndex.from_documents(documents)
chat_engine = index.as_chat_engine(chat_mode="condense_question", verbose=True)
print(chat_engine.chat("DuckDB的VSS扩展主要功能, reply in Chinese"))

结论

至此,一个基于ollama的rag就有雏形了。

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

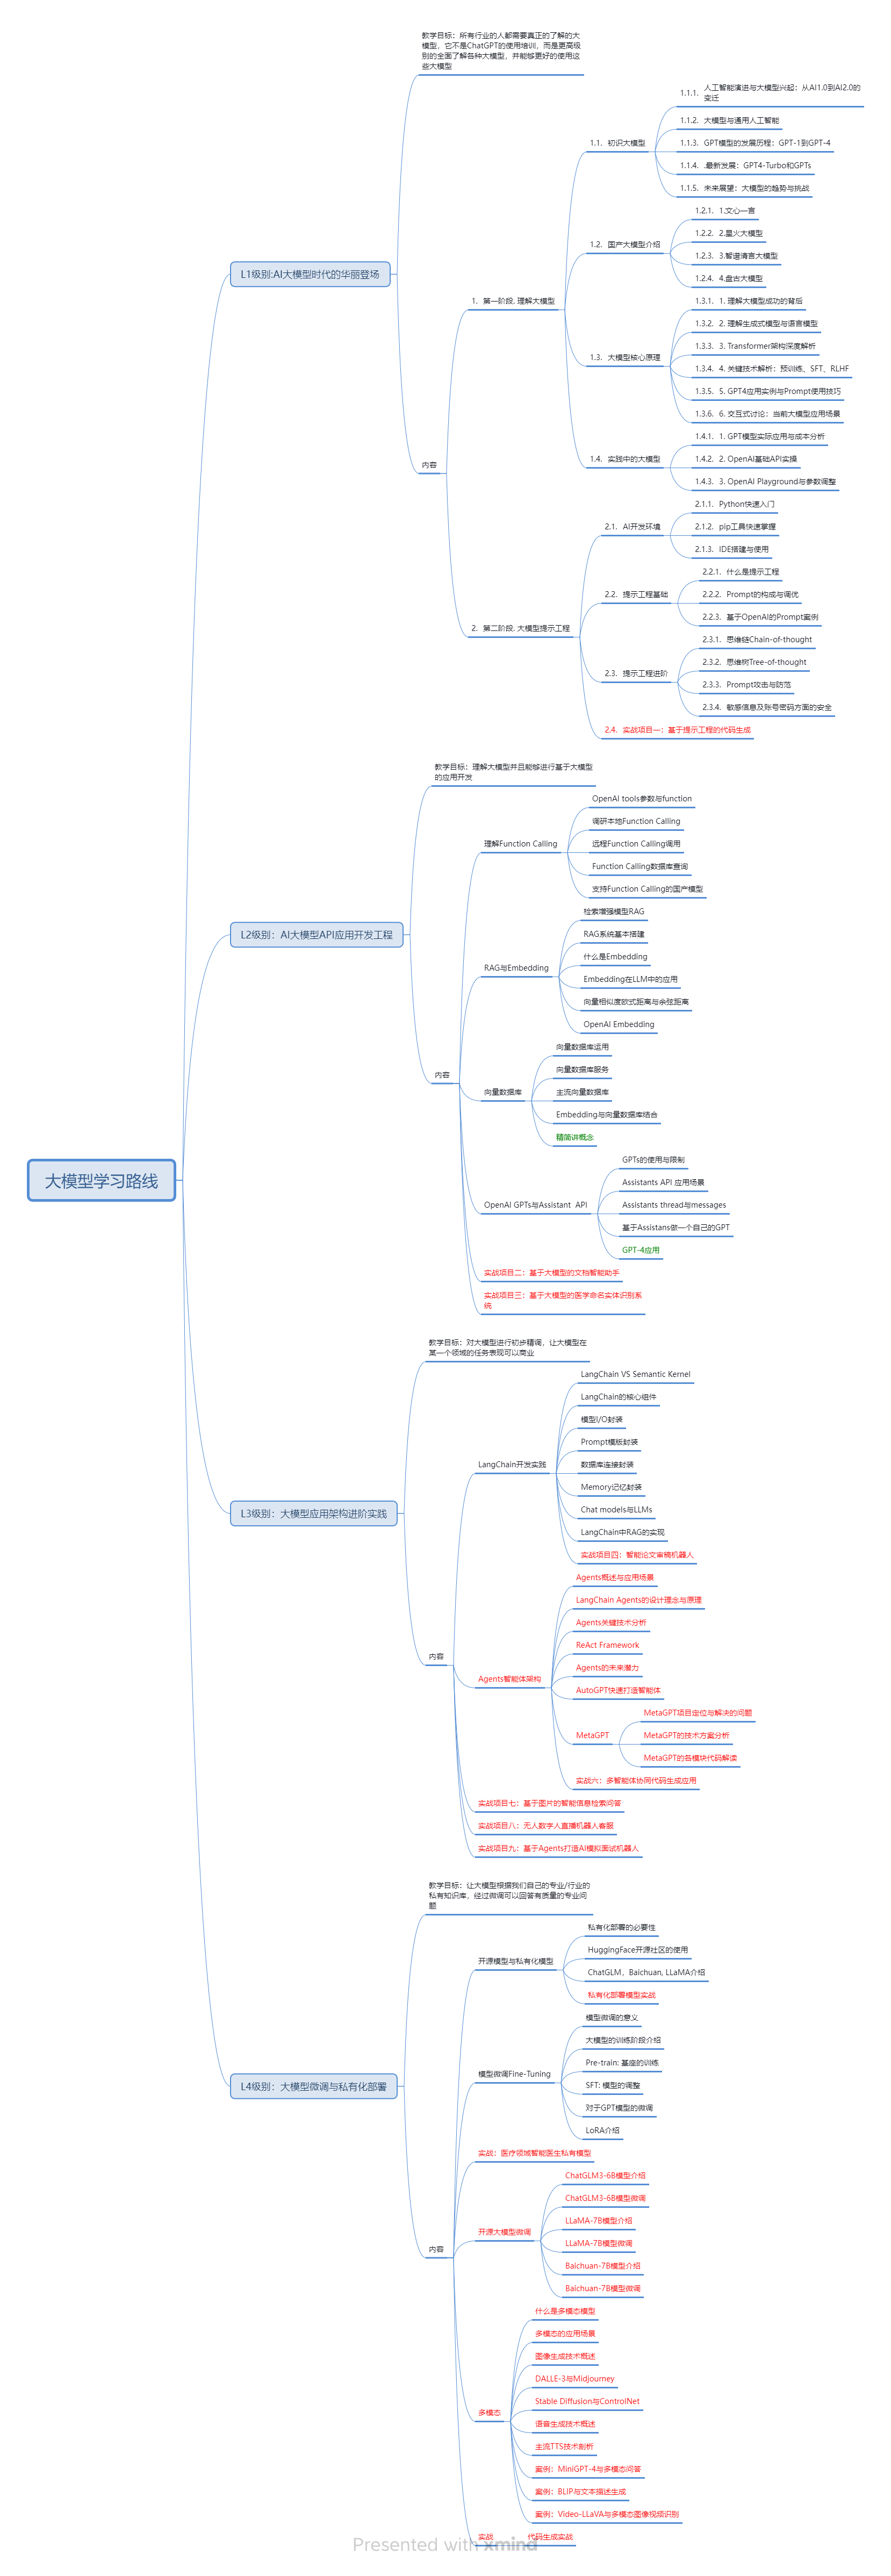
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

RAG架构实战:从LangChain到FastGPT的私有化知识库落地指南 检索增强生成(RAG)作为当前企业级AI应用的主流架构,通过将检索与生成两个阶段解耦,有效解决了知识更新成本、回答可控性和数据隐私安全等核心问题。其技术原理基于向量化检索与大模型生成的有机结合,在知识库系统、文档问答等场景中展现出显著优势。从工程实践角度,LangChain提供了标准化的组件连接框架,而Ollama则降低了本地大模型部署的门槛。对于需要快速落地的团队,FastGPT提供了开箱即用的低代码方案,但需根据具体业务需求权衡灵活性与开发效率。本文基于实际项目经验,详细拆解了从架构设计到生产部署的完整 阅读详情

相关推荐

LangChain+RAG+Ollama+FastGPT:构建私有化AI知识助手完整指南

检索增强生成(RAG)是一种通过外部知识库增强大模型能力的技术架构,其核心原理是将用户查询与向量化文档进行相似度匹配,再结合生成模型产生准确回答。这种技术能有效解决大模型的幻觉问题,提升专业领域问答的准确性。在工程实践中,结合LangChain框架的模块化设计和Ollama的本地模型部署能力,开发者可以快速构建具备专业知识库的智能应用。特别是在企业知识管理、客服系统升级等私有化部署场景中,RAG技术栈能确保数据安全的同时提供可靠的AI服务。本文以LangChain、RAG、Ollama和FastGPT的技术

dengwan3818的博客 368

Ollama源代码解析

Ollama是一个用于在本地运行大语言模型(LLM)的开源工具,它让开发者和用户能够轻松地在自己的设备上部署和使用大语言模型。项目地址:https://github.com/ollama/ollama Star数目:129k。

u010190967的博客 2177

Ollama+AnythingLLM本地知识库实战:私有化RAG落地指南

RAG(检索增强生成)是构建可信AI问答系统的核心范式,其本质是将外部知识与大模型推理动态结合,解决幻觉与信息滞后问题。原理上依赖文档切分、向量嵌入、相似性检索与上下文注入四步闭环;技术价值在于平衡准确性、响应速度与数据主权——尤其适合对隐私敏感、网络受限或需结果可追溯的场景。典型应用包括企业内部文档智能检索、技术手册即时问答、合同与合规材料精准定位等。本文聚焦Ollama与AnythingLLM组合,以轻量架构实现开箱即用的本地RAG能力,覆盖ollama国内镜像源配置、anythingllm离线部署、C

weixin_30689307的博客 387

Llama开源代码详细解读(1):工具包

logging,utf-8是用于表示unicode字符的编码方式,是互联网标准编码之一。utf-8用1-4个字节表示每个字符。单字节的字符,第一位设为0,后面7位为该符号的Unicode码,对于英文字母,unicode与ASCII编码相同。对于n字节的字符,第一个字节的前n位均设为1,第n+1位设为0,后面字节的前两位均设置为10,剩下的没有提及的,就是该字符的Unicode码。math工具包提供了对于数学函数的访问,具体在接下来用到再说。

m0_75077001的博客 1180

本地AI构建:Qwen 3与Ollama实现私有化RAG系统

随着大模型技术的快速发展,本地AI部署成为保护数据隐私和实现定制化需求的重要方案。通过开源模型如Qwen 3(通义千问第三代)和轻量化部署工具Ollama,开发者可以在消费级硬件上构建高效的RAG(检索增强生成)系统和AI智能体。RAG技术结合了检索与生成模型的优势,通过向量数据库(如ChromaDB或Milvus)和嵌入模型(如bge-small-zh-v1.5)实现知识库的高效检索与内容生成。本地部署不仅解决了数据隐私问题,还提供了零延迟的响应体验,适用于企业知识管理、教育助手等场景。Qwen 3支持从

weixin_30764883的博客 309

512分辨率万能遮罩模型实战指南:从下载到高精度应用

本文提供了512分辨率万能遮罩模型的完整实战指南。该模型经过超过540万次迭代,专门优化了对头发、手、眼睛等复杂区域的识别。文章详细介绍了从可靠渠道下载、环境部署、使用DF_ICE工具批量应用遮罩,到利用XSeg Editor进行高精度精修的全流程,旨在帮助用户显著提升AI换脸合成视频的质量与效率。

y2z3a4b5c的博客 1167

深入讲解 Ollama 的源码

Ollama 的源码是一个分层清晰、职责明确的优秀范例。它用Go 语言处理所有高层逻辑:API 服务、模型管理、用户交互,充分利用了 Go 在网络编程和并发方面的优势。它将性能敏感的计算密集型任务完全委托给 C++(llama.cpp),并巧妙地通过 CGo 作为胶水层,这是整个项目高性能的关键。类 Docker 的设计思想(Modelfile, pull, run) 极大地降低了用户的使用门槛,是其大获成功的核心原因之一。

u011091936的博客 1714

DeepSeek高阶应用:DeepSeek+Coze构建智能文献综述与趋势分析自动化系统

本文详细介绍了如何利用DeepSeek与Coze构建智能文献综述与趋势分析自动化系统。通过DeepSeek的深度语义理解和结构化信息提取能力,结合Coze的可视化工作流编排,实现学术论文的自动解析、分类整理与知识入库。该系统能7x24小时自动追踪领域前沿,将研究人员从繁琐的文献处理中解放出来,专注于更高层次的思考与创新。

weixin_29050271的博客 180

Ollama的底层实现原理分析

知其然也要知其所以然, Ollama第一次使用我就很疑惑是不是底层套了一层docker容器化技术,然后再结合大模型做的包装。后来经过分析,确实和容器没太大关系,就是思想做了一些借鉴。并且从分析过程中知道了,GGUF大模型文件的运行依靠的是llama.cpp底层进行支撑运行,那就意味着性能其实不差,毕竟是c++底层来支撑的,之前以为是使用python sdk之类的来运行的...

分享不一样的技术,与你一起共同成长! 2906

Python XML 转 JSON,XML 转字典

今天我们将学习如何在 Python 中将 XML 转换为 JSON 和 XML 转换为字典。我们可以使用 Python 的xmltodict模块来读取 XML 文件并将其转换为字典或 JSON 数据。我们还可以在大型 XML 文件上进行流式处理,并将其转换为字典。在进入编码部分之前,让我们首先了解为什么需要进行 XML 转换。

rubys_的专栏 2504

音视频从入门到精通——指数哥伦布码原理

在计算机中,一般数字的编码都为二进制,但是由于以相等长度来记录不同数字,因此会出现很多的。

mirana的专栏 1385

【亲测免费】 Ollama 开源项目教程

在开始之前,需要注意的是提供的链接指向了一个不存在的仓库 `jmorganca/ollama.git`。为了提供一个通用的答案,假设Ollama项目的目录结构如下: ``` . ├── README.md # 项目的说明文件 ├── bin # 可执行脚本目录 │ └── start_ollama # 项目启动脚本 ├── config ...

gitblog_00645的博客 908

【CVPR 2025】低光增强HVI论文精读与源码复现---part1 论文网络精读

【CVPR 2025】本文参考论文HVI: A New Color Space for Low-light Image Enhancement part1 在文章中对论文核心网络与原理展开详细解释 part2 对论文公开代码的arch网络与其他核心部分展开详细解释

BOB_BOB_BOB_的博客 3272

240911-基于Ollama的22行代码实现极简交互式RAG问答

【代码】240901-基于Ollama的22行代码实现极简交互式RAG问答。

专注机器学习之路 595

VMware如何安装img镜像,VMware如何安装openwrt软路由(含相关工具镜像)

VMware如何安装img镜像,VMware如何安装openwrt软路由(含相关工具镜像)

XiaoqiangClub的博客 4011

借助AI搞定国社科“研究内容”部分!用Gemini 3 Pro轻松撰写6大模块,让基金本子效率质量更上一层楼

所谓研究整体框架,是对课题研究逻辑结构与技术路径的系统阐述,其核心在于通过研究目标分解、研究内容模块化与研究方法整合,构建一个层次清晰、逻辑严密、科学可行的研究体系。撰写要求:1)分要点、分层次列出主要研究内容,保持各部分之间的逻辑性、层次性与系统性;研究可行性可理解为开展本课题在理论基础、研究方法、研究条件、人员结构、平台支撑及外部协作等方面的可实施程度,可从内部条件与外部条件两个维度进行系统论证。研究背景为:我正在申报xxx年xxx(项目名称),课题名称为:xxx,拟采用的主要研究方法包括:xxx等;

智能AI让学术科研更容易 968

RagFlow+Ollama 构建RAG私有化知识库

官网RAGFlow是一个基于对文档深入理解的开源 RAG(检索增强生成)引擎。它的作用是可以让用户创建自有知识库,根据设定的参数对知识库中的文件进行切块处理,用户向大模型提问时,RAGFlow先查找自有知识库中的切块内容,接着把查找到的知识库数据输入到对话大模型中再生成答案输出。它能凭借引用知识库中各种复杂格式的数据为后盾,为用户提供真实可信,少幻觉的答案。RAGFlow的技术原理涵盖了文档理解、检索增强、生成模型、注意力机制等,特别强调了深度文档理解技术,能够从复杂格式的非结构化数据中提取关键信息。

技术宅男改变世界 3074

最新Python爬虫实战(入门爬虫篇)——案例15:微博热搜数据采集(详细爬虫思路截图+抓包动图演示+完整爬虫代码+详细注释)

本次案例通过 Python 爬虫技术,成功实现了对微博热搜 API 接口数据的批量爬取与 Excel 保存。代码采用模块化设计,包含接口请求、JSON 解析、数据提取、Excel 持久化等完整流程;通过模拟真实浏览器的请求头和 cookies,有效规避基础反爬策略,保证请求的稳定性。整个爬虫逻辑遵循“API请求 → JSON解析 → 数据提取 → 保存到Excel”的标准流程,与异步加载类网站的爬取范式高度一致。AJAX 接口抓包与分析。

努力让自己发光,对的人才能迎着光而来 7万+

基于Dify+Ollama+Xinference构建企业级私有化RAG与Agent大模型应用实操(上)

基于 Dify 实现 RAG、Agent “大模型应用落地”是目前企业落地 AI 场景最简单也是必须的路径,我将分两篇文章,从“原理->Dify 部署->模型私有化部署->Agent 搭建案例”完整演示一下实操过程。

AI全栈 和 IT 编程相关分享 1322

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

基于Dify+Ollama+Xinference构建企业私有化RAG与Agent大模型应用实操(上)

基于 Dify 实现 RAG、Agent “大模型应用落地”是目前企业落地 AI 场景最简单也是必须的路径,我将分两篇文章,从“原理->Dify 部署->模型私有化部署->Agent 搭建案例”完整演示一下实操过程。

2401_82469710的博客 929

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

CloudCanal RAG x Ollama 构建全栈私有 AI 服务

企业级 RAG 服务强调端到端的集成能力、安全可控以及对业务系统的适配性。它不仅能实现基于知识的智能问答,还能提供高可靠、高安全、高扩展的服务。在保护企业数据的前提下,真正服务于业务流程的自动化与智能化。技术栈全私有,部署可控服务能够完全运行在本地数据中心或私有云环境中,避免数据外泄风险,满足对数据合规性要求较高的行业需求。数据来源多样,格式丰富不局限于文本文件类型,还支持数据库等多种数据来源,实现真正的“全域知识接入”。支持增量数据同步,确保时效性与一致性。

Kami‘s home 1435

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

私有化搭建、本地知识库、可联网查询、具备RAG能力的私人DeepSeek

对私有化部署的DeepSeek进行设置,搭建本地知识库、联网搜索、RAG(检索增强生成),以实现私人专属AI大模型。

云计算课代表 2052

基于Ollama和AnythingLLM搭建本地化知识库RAG

先看效果,我上传了一个pdf如下:上传之后做向量化处理,处理完成之后,就可以开始问答了。

scj0725的博客 8137

Ollama本地私有化大模型完整工程实战

频繁调用云端LLM API存在数据隐私泄露、长期计费成本高两大痛点,Ollama作为跨平台开源本地大模型管理工具,支持一键拉取量化开源模型,提供兼容OpenAI标准接口。本文基于Windows/macOS/Linux三平台半年落地实测,补齐国内网络镜像永久配置方案;完整覆盖命令行交互、Python流式调用、Modelfile自定义专属模型、Docker可视化WebUI、本地私有RAG知识库五大模块;

分享日常学习生活 711

LangChain+RAG+Ollama+FastGPT:后端程序员AI应用开发实战指南

检索增强生成(RAG)技术通过将外部知识库与大语言模型结合,解决了传统AI模型知识更新滞后的问题。其核心原理是将文档向量化存储,在用户提问时先检索相关文档片段,再让模型基于上下文生成精准答案。这种技术架构显著提升了AI应用的准确性和实用性,特别适合企业内部知识管理、智能客服等场景。结合LangChain标准化开发框架和Ollama本地模型部署,开发者可以快速构建私有化AI应用。本文以RAG向量库和Ollama本地部署为例,详细解析从环境准备到生产部署的全流程,帮助后端程序员高效转型AI开发。

掬水月在手,弄花香满衣 453

基于 Ollama 私有化部署 DeepSeek 并集成智能体平台 Dify 知识库

节前,我们邀请了一些互联网大厂朋友、今年参加社招和校招面试的同学。针对新人如何快速入门算法岗、如何准备面试攻略、面试常考点、大模型项目落地经验分享等热门话题进行了深入的讨论。

m0_59596937的博客 3769
上一篇: 为什么RAG应用很难落地?细说RAG系统开发关键痛点和解决方案
下一篇: 多模态模型‘遗忘’原有的语言能力,回答不详细、理解力下降!这个痛点你遇到过吗?
冻感糕人~
博客等级 码龄3年 8926粉丝 2399原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值