


受 Barnett 等人所著的《Seven Failure Points When Engineering a Retrieval Augmented Generation System》一文启发,本文将探讨其中提到的几个关键问题。更重要的是,我们将深入探讨如何应对这些 RAG 系统中的挑战,以便在日常开发中更好地解决这些问题。
格式错误
当我们告诉计算机以某种特定格式(比如表格或JSON)来整理信息,但大型语言模型(LLM)没能按照预期输出。为了更好地引导计算机理解我们的需求,我们可以通过以下方法来确保得到想要的格式:
更精准的prompt
- 让指令更加明确。
- 简化问题并突出关键词。
- 提供示例。
- 循环提问,不断细化问题
解析输出
- 为任何查询提供格式化指南。
- 对计算机的回答进行“解析”。
LlamaIndex 支持与其他框架如 Guardrails 和 LangChain 提供的输出解析模块集成。
- Guardrails:https://docs.llamaindex.ai/en/stable/module_guides/querying/structured_outputs/output_parser.html#guardrails
- LangChain:https://docs.llamaindex.ai/en/stable/module_guides/querying/structured_outputs/output_parser.html#langchain
具体使用方法,可参考:https://docs.llamaindex.ai/en/stable/module_guides/querying/structured_outputs/output_parser.html

pydantic
Pydantic 程序是一个多用途框架,它可以把输入的文字串转换成结构化的 Pydantic 对象。LlamaIndex 提供了多种 Pydantic 程序:
- LLM 文本完成 Pydantic 程序(LLM Text Completion Pydantic Programs):这些程序处理输入文本,并将其变成用户定义的结构化对象,它结合了文本完成 API 和输出解析功能。
- LLM 函数调用 Pydantic 程序(LLM Function Calling Pydantic Programs):这些程序根据用户的需求,将输入文本转换成特定的结构化对象,这一过程依赖于 LLM 函数调用 API。
- 预设的 Pydantic 程序(Prepackaged Pydantic Programs):这些程序被设计用来将输入文本转换成预先定义好的结构化对象。
具体使用方法,请参考 OpenAI 的 Pydantic 程序示例代码 https://docs.llamaindex.ai/en/stable/examples/output_parsing/openai_pydantic_program.html 更多信息请查阅 LlamaIndex 的 Pydantic 程序文档,并可以访问不同程序的笔记本/指南链接 https://docs.llamaindex.ai/en/stable/module_guides/querying/structured_outputs/pydantic_program.html

OpenAI JSON模式
OpenAI 的 JSON 模式允许我们设置 response_format 为 { “type”: “json_object” },以此激活响应的 JSON 模式。一旦启用了 JSON 模式,计算机就只会生成能够被解析为有效 JSON 对象的字符 串。尽管 JSON 模式规定了输出的格式,但它并不确保输出内容符合特定的规范。想了解更多, 请查看 LlamaIndex 关于 OpenAI JSON 模式与数据提取功能调用的文档。
内容缺失问题
当实际答案不在知识库中时,RAG 系统往往给出一个貌似合理却错误的答案,而不是承认无法给出答案。这导致用户接收到误导性信息,造成错误的引导。如何解决内容缺失问题?
1. 优化数据源
“输入什么,输出什么。”如果源数据质量差,比如充斥着冲突信息,那么无论你如何构建 RAG 流程,都不可能从杂乱无章的数据中得到有价值的结果。
2. 改进提示方式
在知识库缺乏信息,系统可能给出错误答案的情况下,改进提示方式可以起到显著帮助。例如,通过设置提示“如果你无法确定答案,请表明你不知道”, 可以鼓励模型认识到自己的局限并更透明地表达不确定性。虽然无法保证百分百准确,但在优化数据源之后,改进提示方式是我们能做的最好努力之一。
错过排名靠前的文档
有时候系统在检索资料时,最关键的文件可能并没有出现在返回结果的最前面。这就导致了正确答案被忽略,系统因此无法给出精准的回答。
即:“问题的答案其实在某个文档里面,只是它没有获得足够高的排名以致于没能呈现给用户”
为了解决这个问题,我们有两种解决思路:
1 .重新排名检索结果
在将检索到的结果发送给大型语言模型(LLM)之前,对结果进行重新排名可以显著提升RAG的性能。LlamaIndex的一个笔记本展示了两种不同方法的效果对比:
- 直接检索前两个节点,不进行重新排名,这可能导致不准确的检索结果
- 先检索前十个节点,然后使用CohereRerank进行重新排名,最后返回前两个节点,这种方法可以提高检索的准确性
2. 调整chunk_size和相似度排名similarity_top_k
chunk_size和similarity_top_k都是用来调控 RAG(检索增强型生成)模型数据检索过程中效率和 效果的参数。改动这些参数能够影响计算效率与信息检索质量之间的平衡。
脱离上下文 — 整合策略的限制
论文中提到了这样一个问题:“虽然数据库检索到了含有答案的文档,但这些文档并没有被用来生成答案。这种情况往往出现在数据库返回大量文档后,需要通过一个整合过程来找出答案” 。那么我们的解决方案有哪些呢?
1. 优化检索策略
以 LlamaIndex 为例,LlamaIndex 提供了一系列从基础到高级的检索策略,以帮助我们在 RAG 流程中实现精准检索。欲了解所有检索策略的详细分类,可以查阅 retrievers 模块的指南
- 从每个索引进行基础检索
- 进行高级检索和搜索
- 自动检索
- 知识图谱检索器
- 组合/分层检索器
- 更多其他选项!
2. 微调embedding模型
如果你使用的是开源嵌入模型,对其进行微调是提高检索准确性的有效方法。LlamaIndex 提供了 一份详尽的指南,指导如何一步步微调开源嵌入模型,并证明了微调可以在各项评估指标上持续改进性能。(https://docs.llamaindex.ai/en/stable/examples/finetuning/embeddings/finetune_embedding.html ) 下面是一个示例代码片段,展示了如何创建微调引擎、执行微调以及获取微调后的模型:

未能提取答案
当系统需要从提供的上下文中提取正确答案时,尤其是在信息量巨大时,系统往往会遇到困难。关键信息被遗漏,从而影响了回答的质量。论文中提到:“这种情况通常是由于上下文中存在太多干扰信息或相互矛盾的信息” 。如何解决未能提取答案问题呢?
1 .清理数据
这一痛点再次凸显了数据质量的重要性。我们必须再次强调,干净整洁的数据至关重要!在质疑RAG 流程之前,务必先要清理数据。
2 .上下文压缩
LongLLMLingua 研究项目/论文中提出了 长上下文设置中的提示压缩技术 。通过将其集成到 LlamaIndex 中,我们现在可以将 LongLLMLingua 作为节点后处理步骤,在检索步骤之后压缩上 下文,然后再将其输入大语言模型。以下是一个设置 LongLLMLinguaPostprocessor 的示例代码片段,它利用 longllmlingua 包来执行提示压缩。更多详细信息,请查阅 LongLLMLingua 的完整文档:https://docs.llamaindex.ai/en/stable/examples/node_postprocessor/LongLLMLingua.html#longllmlingua。

3. LongContextReorder重排
一项研究(https://arxiv.org/abs/2307.03172)发现,当关键信息位于输入上下文的开始或结尾 时,通常能得到最好的性能。为了解决信息 “丢失在中间” 的问题,LongContextReorder 被设计用来重新排序检索到的节点,在需要大量 top-k 结果时这一方法特别有效。以下是如何定义 LongContextReorder 作为您查询引擎构建时节点后处理器的示例代码。

回答过于宽泛
有时候,我们得到的回答可能缺少必要的细节或特定性,这通常需要我们进一步提问来获取清晰的信息。有些答案可能过于含糊或泛泛,不能有效地满足用户的实际需求。为此,我们需要采用更高级的检索技巧。
当答案没有达到你所期待的详细程度时,你可以通过提升检索技巧来改善这一状况。以下是一些有助于解决这个问题的先进检索方法:
- 从细节到全局的检索:https://docs.llamaindex.ai/en/stable/examples/retrievers/auto_merging_retriever.html
- 围绕特定句子进行的检索:https://docs.llamaindex.ai/en/stable/examples/node_postprocessor/MetadataReplacementDemo.html
- 逐步深入的检索:https://docs.llamaindex.ai/en/stable/examples/query_engine/pdf_tables/recursive_retriever.html
回答不全面
有时候我们得到的是部分答案,并不是说它们是错误的,但它们并没有提供所有必要的细节,即便这些信息实际上是存在并且可以获取的。比如,如果有人问:“文档A、B和C中都讨论了哪些主要内容?”针对每份文档分别提问可能会得到更为全面的答案。那么如何解决回答不全面问题呢?
在简单的RAG模型中,比较性问题往往处理得不够好。一个提升RAG推理能力的有效方法是加入一个查询理解层——也就是在实际进行向量存储查询之前进行查询优化。以下是四种不同的查询优化方式:
- 路由优化:保留原始查询内容,并明确它所涉及的特定工具子集。然后,将这些工具指定为合适的选择。
- 查询改写:保持选定工具不变,但重新构思多种查询方式,以适应同一组工具。
- 细分问题:将大问题拆分成几个小问题,每个小问题都针对根据元数据确定的不同工具
- ReAct Agent 工具选择:根据原始查询内容,确定使用哪个工具,并构造针对该工具的特定查 询。
关于如何使用假设性文档嵌入(HyDE)这一查询改写技术,您可以参考下方示例代码。在这种方 法中,我们首先根据自然语言查询生成一个假设性文档或答案。之后,我们使用这个假设性文档来进行嵌入式查找,而不是直接使用原始查询。具体可以参考:https://python.langchain.com.cn/docs/modules/chains/additional/hyde
数据处理能力的挑战
在 RAG 技术流程中,处理大量数据时常会遇到一个难题:系统若无法高效地管理和加工这些数据,就可能导致性能瓶颈甚至系统崩溃。这种处理能力上的挑战可能会让数据处理的时间大幅拉长,系统超负荷运转,数据质量下降,以及服务的可用性降低。
LlamaIndex 推出了一种数据处理的并行技术,能够使文档处理速度最多提升 15 倍。下面的代码示例展示了如何创建数据处理流程并设置num_workers,以实现并行处理。

总结
在开发RAG应用时,我遇到了许多痛点。由于篇幅有限,我之前只提到了其中的八个问题。然而,实际上这些仅仅是冰山一角,RAG领域的挑战还远远不止这些。每一个痛点都值得深入探讨和解决。例如,如何有效地处理结构化数据查询,如何选取最适合的备选模型,以及如何确保大语言模型的安全性等。这些都是我在团队开发过程中曾经遇到并努力解决过的问题。未来,我会抽出时间分享更多我在这个领域的经验和踩过的坑,希望能为大家在实践中提供参考。
如何学习大模型
现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
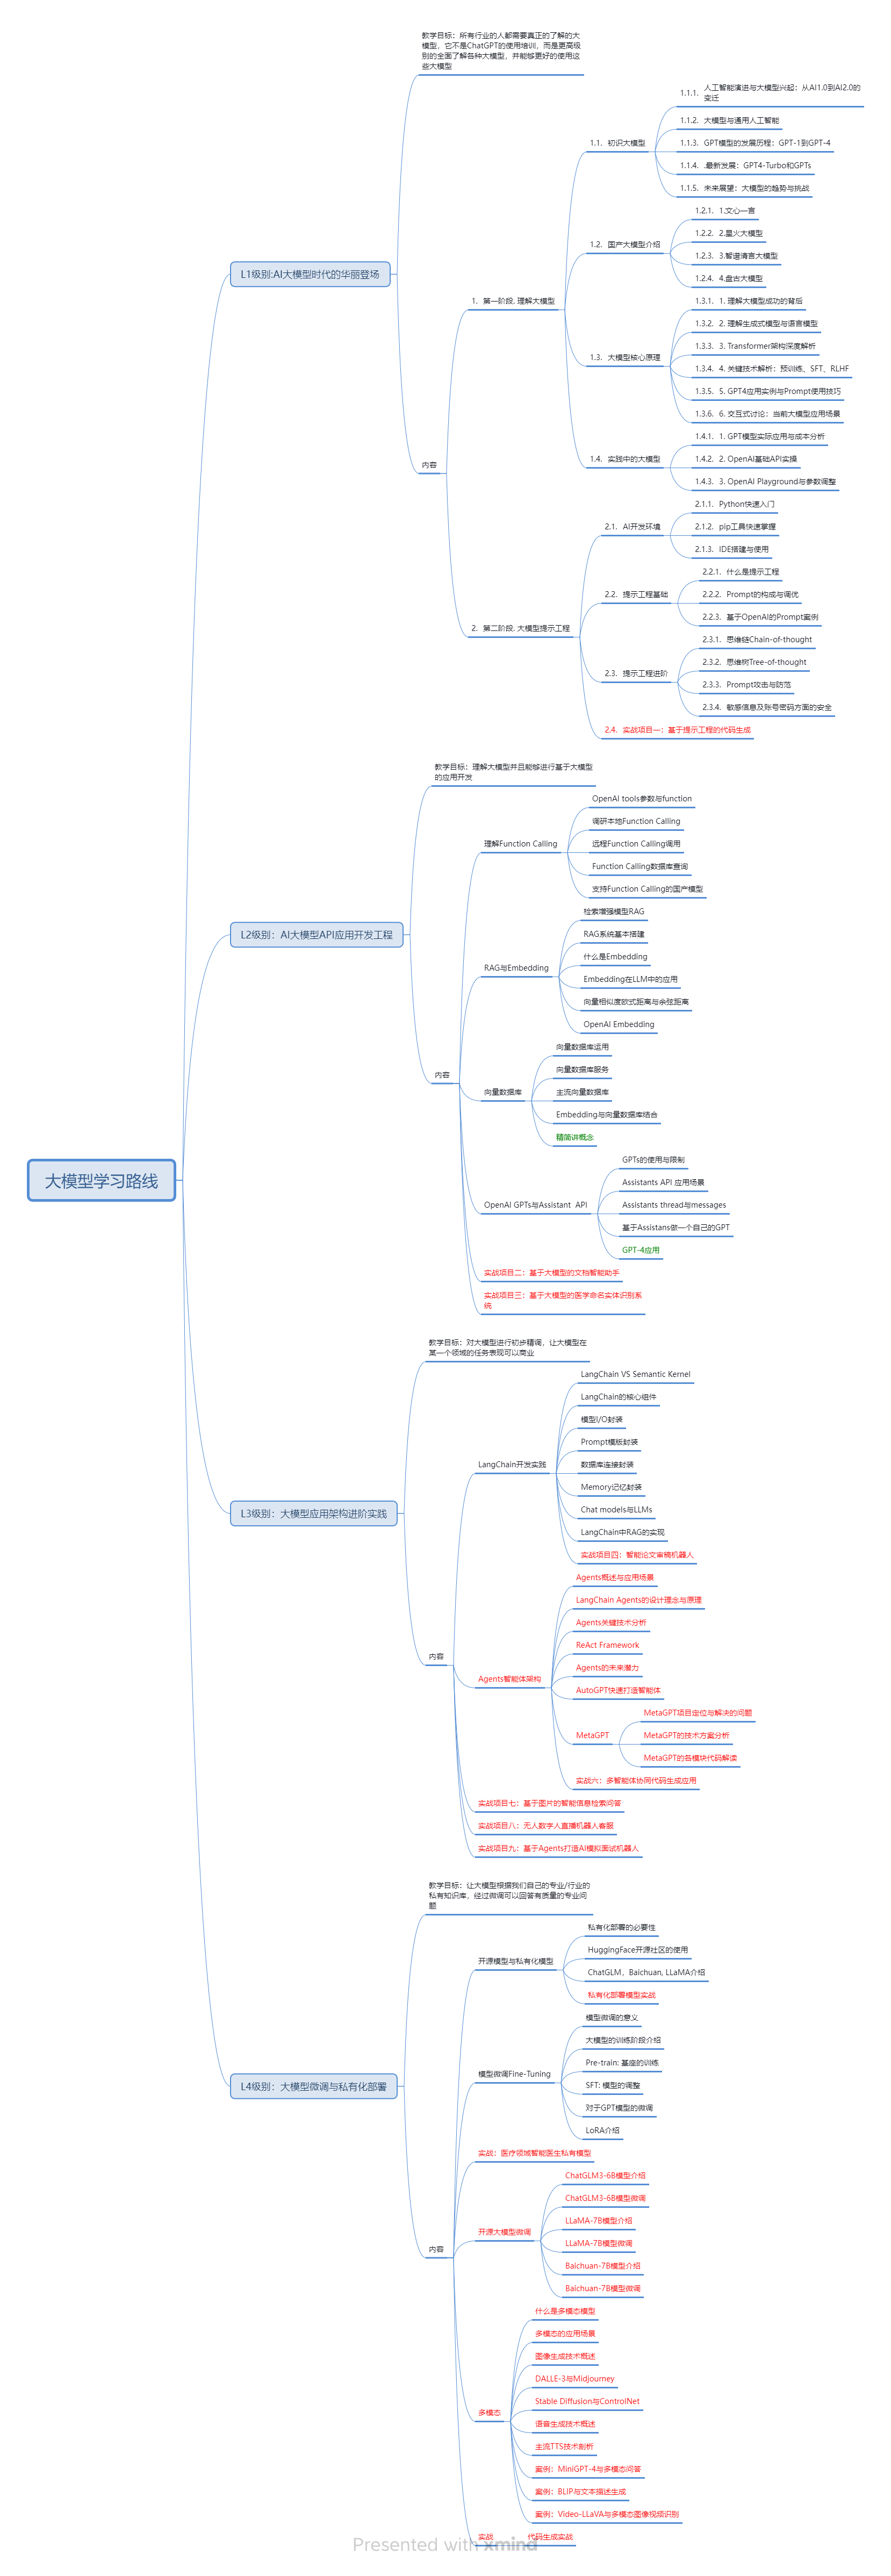
一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
二、AI大模型视频教程
三、AI大模型各大学习书籍
四、AI大模型各大场景实战案例
五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 356


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


