


在自然语言处理(NLP)领域,Embedding模型是将文本数据转化为数值向量的核心技术,从而让计算机能够便捷地衡量文本间的语义关联,这种表示法已成为多种基础NLP任务的核心,如文本相似度判定、语义搜索、信息检索、文本重新排序、聚类以及作为下游任务的特征输入。
最近,随着大语言模型的升温,Embedding技术在检索增强生成(RAG)应用中的文档检索环节中也得到了广泛应用,开源社区也涌现出了众多高效的Embedding模型,选择合适的文本Embedding模型对于检索阶段的效果至关重要,本文将为你梳理2023年AI和NLP应用开发中,值得关注的7种Embedding模型。
1.BGE
BGE,即BAAI General Embedding,是由智源研究院(BAAI)团队开发的一款文本Embedding模型。该模型可以将任何文本映射到低维密集向量,这些向量可用于检索、分类、聚类或语义搜索等任务。此外,它还可以用于LLMs的向量数据库。
BGE模型在2023年有多次更新,包括发布论文和数据集、发布新的reranker模型以及更新Embedding模型。BGE模型已经集成到Langchain中,用户可以方便地使用它。此外,BGE模型在MTEB和C-MTEB基准测试中都取得了第一名的成绩。
BGE模型的主要特点如下:
- 多语言支持:BGE模型支持中英文。
- 多版本:BGE模型有多个版本,包括bge-large-en、bge-base-en、bge-small-en等,以满足不同的需求。
- 高效的reranker:BGE提供了reranker模型,该模型比Embedding模型更准确,但比Embedding模型更耗时。因此,它可以用于重新排名Embedding模型返回的前k个文档。
- 开源和许可:BGE模型是开源的,并在MIT许可下发布。这意味着用户可以免费用于商业目的。
- 丰富集成:用户可以使用FlagEmbedding、Sentence-Transformers、Langchain或Huggingface Transformers等工具来使用BGE模型。
总的来说,BGE是一个强大的文本Embedding模型,适用于多种NLP任务。它的多语言支持、多版本选择和高效的reranker使其成为文本Embedding领域的领先模型。
2.GTE
GTE模型,也称为General Text Embeddings,是阿里巴巴达摩院推出的文本Embedding技术。它基于BERT框架构建,并分为三个版本:GTE-large、GTE-base和GTE-small。
该模型在大规模的多领域文本对语料库上进行训练,确保其广泛适用于各种场景。因此,GTE可以应用于信息检索、语义文本相似性、文本重新排序等任务。
尽管GTE模型的参数规模为110M,但其性能卓越。它不仅超越了OpenAI的Embedding API,在大型文本Embedding基准测试中,其表现甚至超过了参数规模是其10倍的其他模型。更值得一提的是,GTE模型可以直接处理代码,无需为每种编程语言单独微调,从而实现优越的代码检索效果。
3.E5 Embedding
E5-embedding是由intfloat团队研发的一款先进的Embedding模型。E5的设计初衷是为各种需要单一向量表示的任务提供高效且即用的文本Embedding,与其他Embedding模型相比,E5在需要高质量、多功能和高效的文本Embedding的场景中表现尤为出色。
以下是E5-embedding的一些特点:
- 新的训练方法:E5采用了“EmbEddings from bidirEctional Encoder rEpresentations”这一创新方法进行训练,这意味着它不仅仅依赖传统的有标记数据,也不依赖低质量的合成文本对。
- 高质量的文本表示:E5能为文本提供高质量的向量表示,这使得它在多种任务上都能表现出色,尤其是在需要句子或段落级别表示的任务中。
- 多场景:无论是在Zero-shot场景还是微调应用中,E5都能提供强大的现成文本Embedding,这使得它在多种NLP任务中都有很好的应用前景。
4.Jina Embedding
jina-embedding-s-en-v1是Jina AI的Finetuner团队精心打造的文本Embedding模型。它基于Jina AI的Linnaeus-Clean数据集进行训练,这是一个包含了3.8亿对句子的大型数据集,涵盖了查询与文档之间的配对。这些句子对涉及多个领域,并已经经过严格的筛选和清洗。值得注意的是,Linnaeus-Clean数据集是从更大的Linnaeus-Full数据集中提炼而来,后者包含了高达16亿的句子对。
Jina Embedding有这些亮点:
- 广泛应用:jina-embedding-s-en-v1适合多种场景,如信息检索、语义文本相似性判断和文本重新排序等。
- 卓越性能:虽然该模型参数量仅为35M,但其性能出众,而且能够快速进行推理。
- 多样化版本:除了标准版本,用户还可以根据需求选择其他大小的模型,包括14M、110M、330M、
5.Instructor
Instructor是由香港大学自然语言处理实验室团队推出的一种指导微调的文本Embedding模型。该模型可以生成针对任何任务(例如分类、检索、聚类、文本评估等)和领域(例如科学、金融等)的文本Embedding,只需提供任务指导,无需任何微调。Instructor在70个不同的Embedding任务(MTEB排行榜)上都达到了最先进的性能。该模型可以轻松地与定制的sentence-transformer库一起使用。
Instructor 模型主要特点如下:
- 多任务适应性:只需提供任务指导,即可生成针对任何任务的文本Embedding。
- 高性能:在MTEB排行榜上的70个不同的Embedding任务上都达到了最先进的性能。
- 易于使用:与定制的sentence-transformer库结合使用,使得模型的使用变得非常简单。
此外,模型还提供了其他使用案例,如计算句子相似性、信息检索和聚类等。
6.XLM-Roberta
XLM-Roberta(简称XLM-R)是Facebook AI推出的一种多语言版本的Roberta模型。它是在大量的多语言数据上进行预训练的,目的是为了提供一个能够处理多种语言的强大的文本表示模型。XLM-Roberta模型在多种跨语言自然语言处理任务上都表现出色,包括机器翻译、文本分类和命名实体识别等。
模型主要特点如下:
- 多语言支持:XLM-Roberta支持多种语言,可以处理来自不同语言的文本数据。
- 高性能:在多种跨语言自然语言处理任务上,XLM-Roberta都表现出了最先进的性能。
- 预训练模型:XLM-Roberta是在大量的多语言数据上进行预训练的,这使得它能够捕获跨语言的文本表示。
7.text-embedding-ada-002
text-embedding-ada-002是一个由Xenova团队开发的文本Embedding模型。该模型提供了一个与Hugging Face库兼容的版本的text-embedding-ada-002分词器,该分词器是从openai/tiktoken适应而来的。这意味着它可以与Hugging Face的各种库一起使用,包括Transformers、Tokenizers和Transformers.js。
模型主要特点如下:
- 兼容性:该模型与Hugging Face的各种库兼容,包括Transformers、Tokenizers和Transformers.js。
- 基于openai/tiktoken:该模型的分词器是从openai/tiktoken适应而来的。
轻松部署Embedding模型的新纪元
在深入了解了这些先进的Embedding模型后,你可能会思考如何轻松地部署和使用这些模型。这时,Xinference成为了你的完美选择。Xinference是一个开源AI模型推理引擎(https://github.com/xorbitsai/inference),专为轻松部署大语言模型、Embedding模型和多模态模型而设计,预置了BGE、GTE和E5 Embedding等在内的最热门的Embedding模型。
例如,要在Xinference中运行和部署GTE模型,你只需要执行以下简单的命令:
xinference launch --model-name "gte-base" --model-type "embedding" --endpoint http://127.0.0.1:9997
一旦启动,就可以轻松地使用HTTP与模型进行交互,如下所示:

返回如下:

Xinference不仅简化了模型部署的过程,还为你提供了与模型的无缝交互方式。如果你正在寻找一个轻松、高效地部署和运行AI模型的解决方案,那么Xinference绝对值得你的关注和探索。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

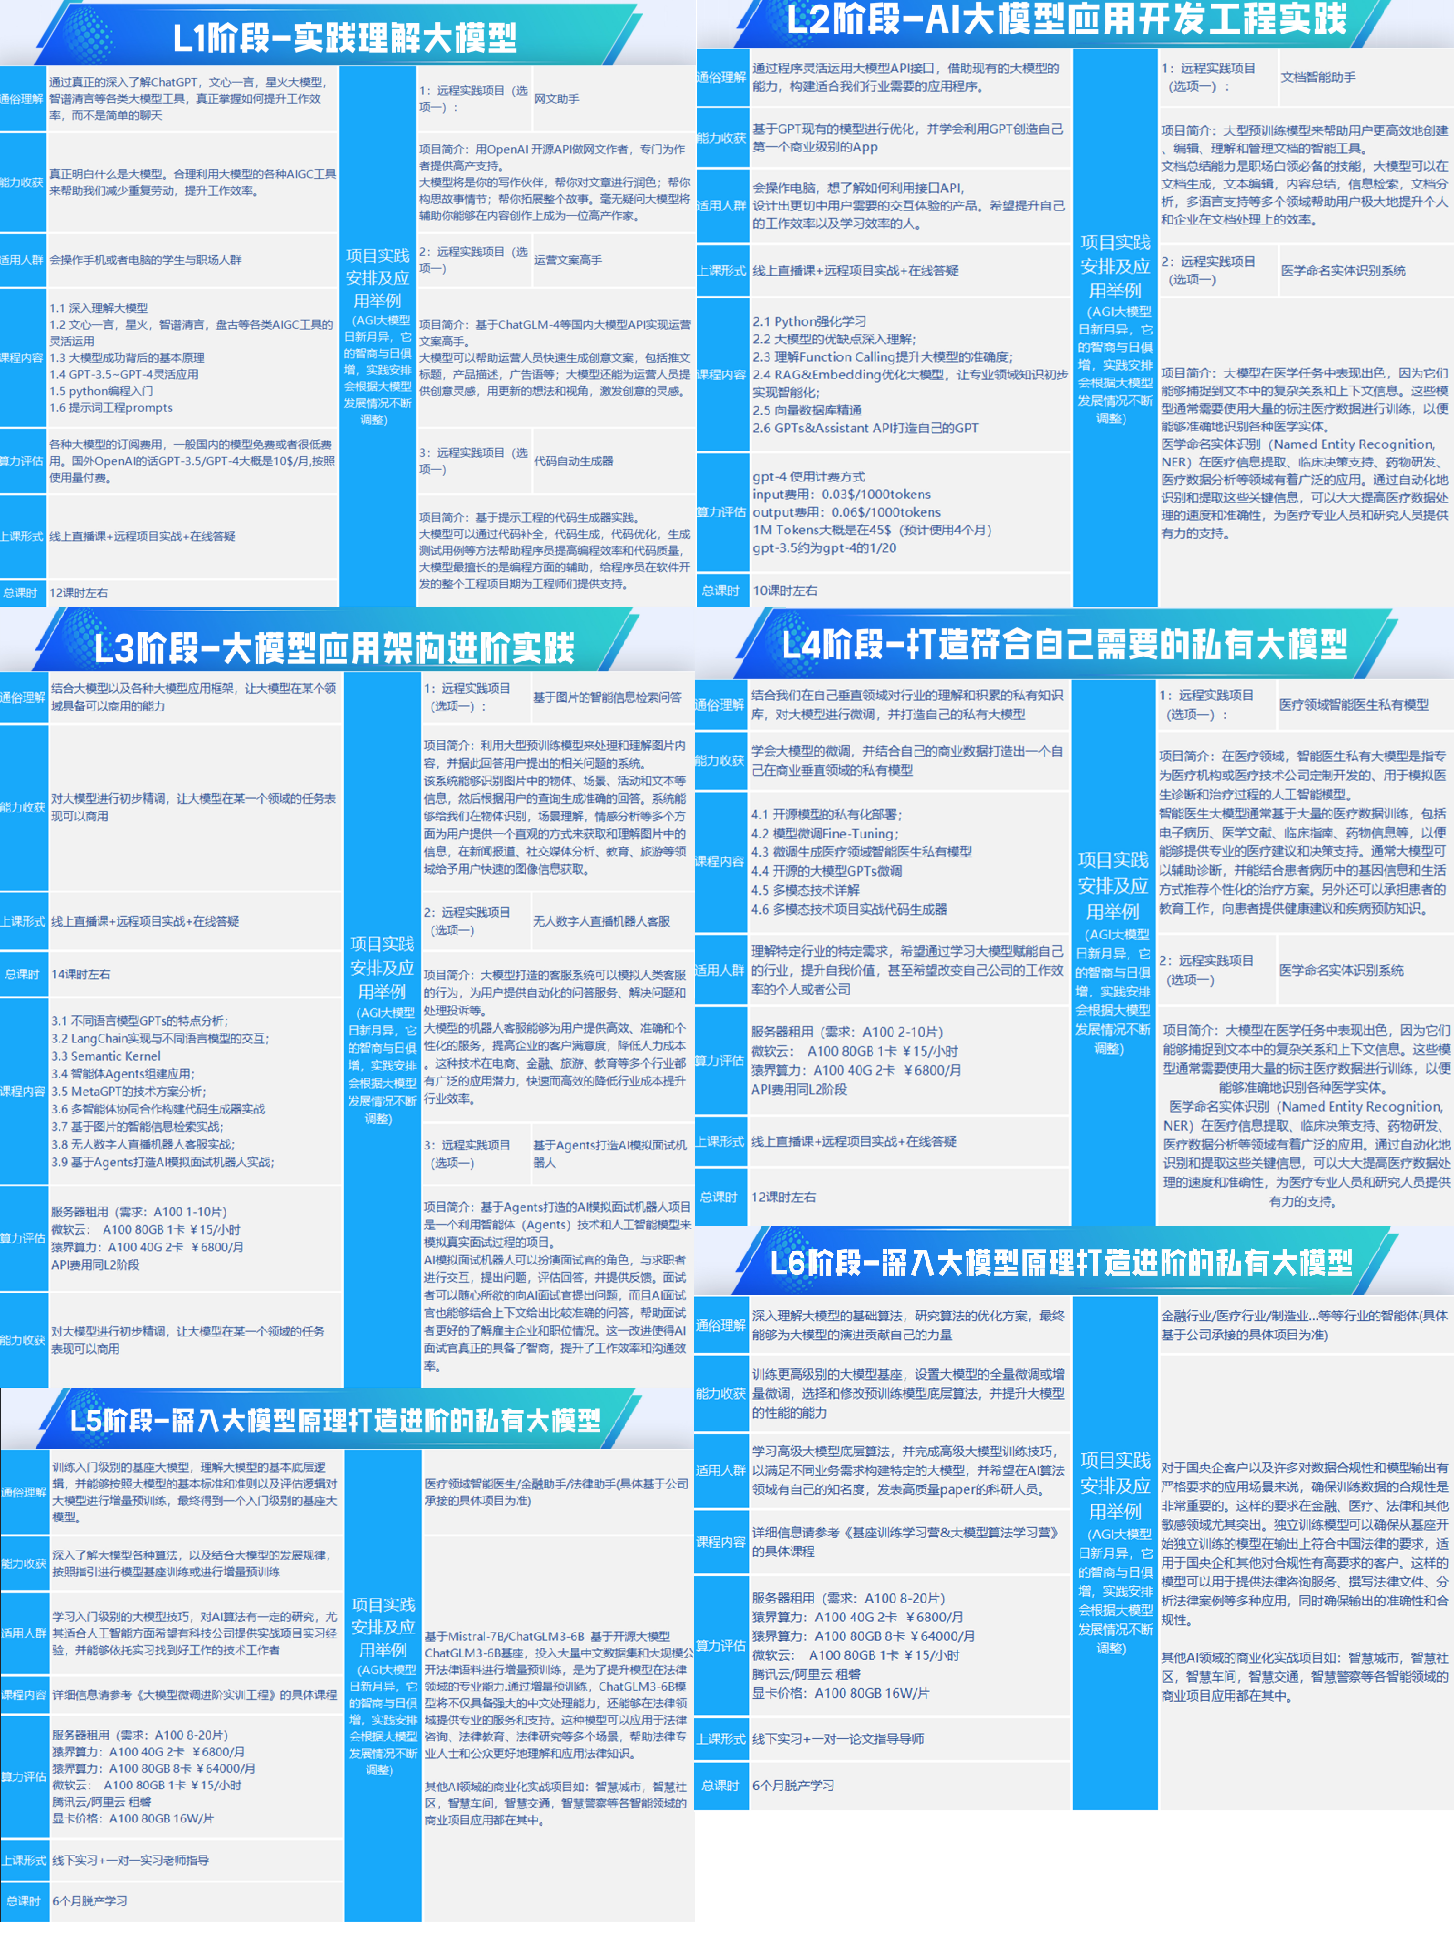
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
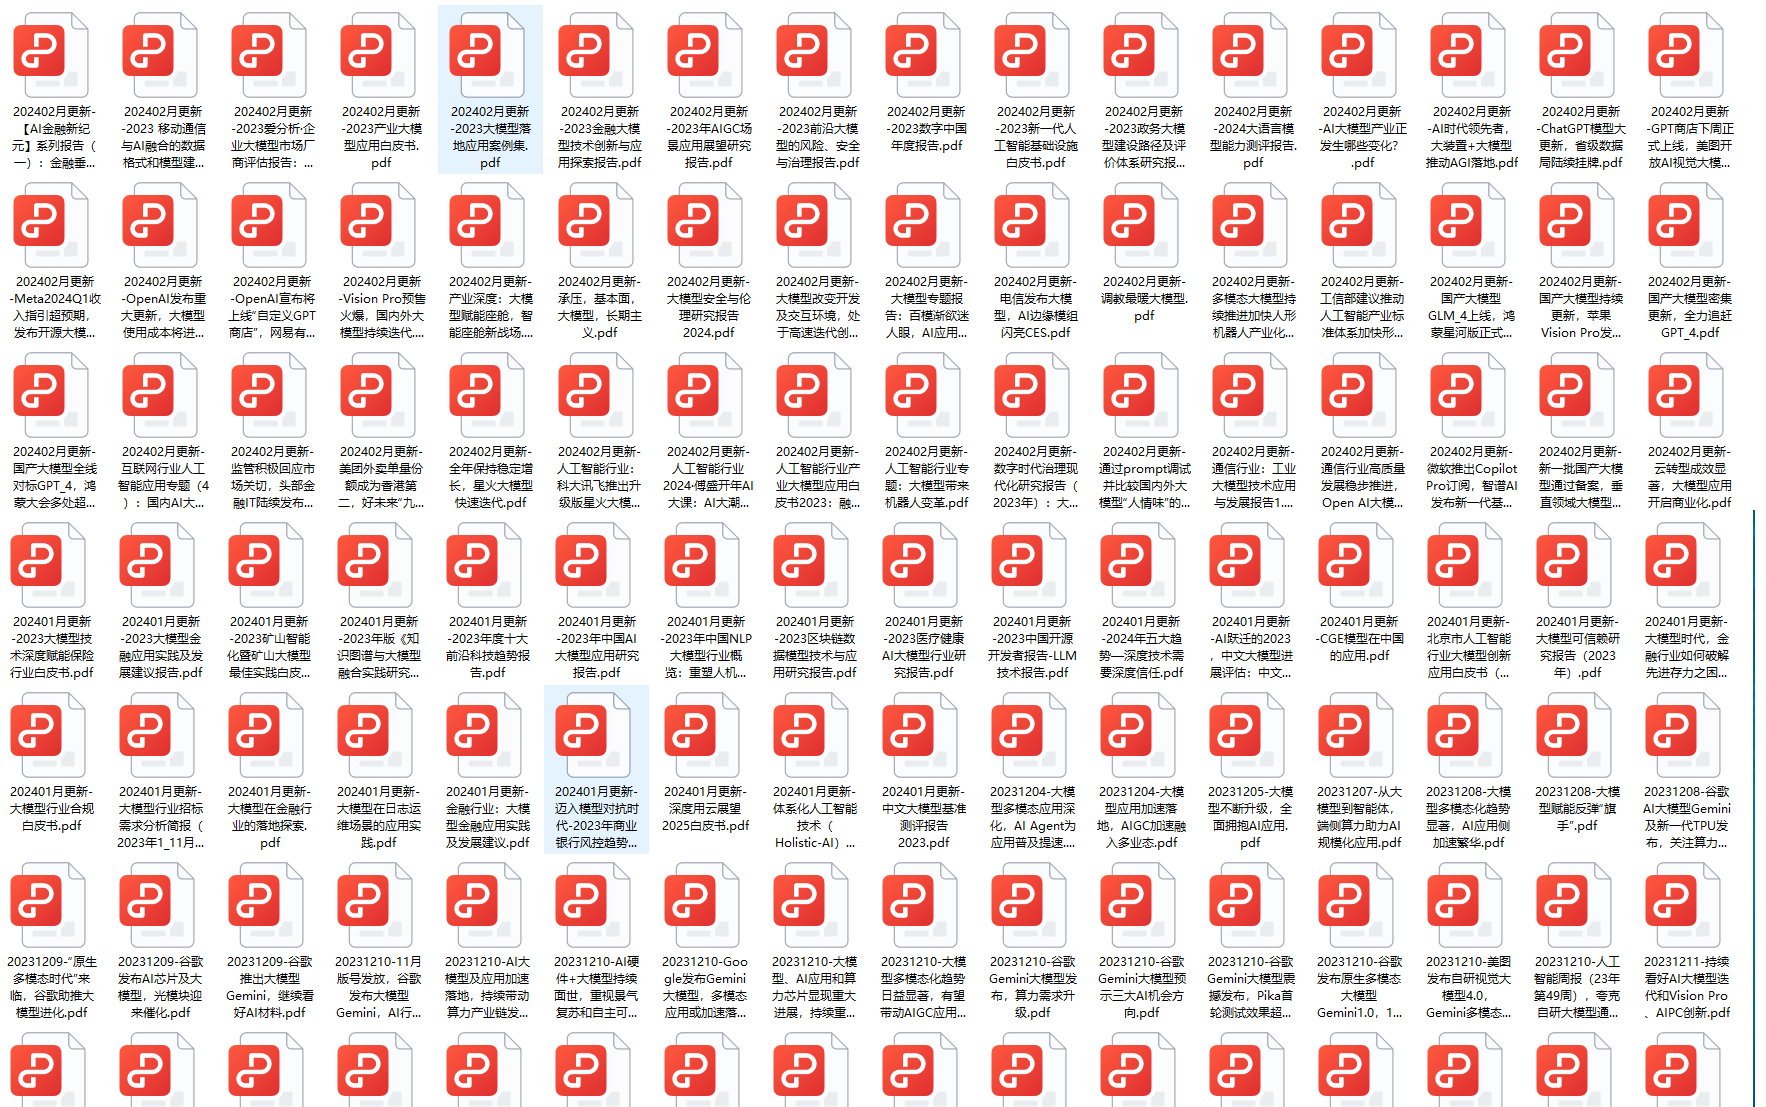
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
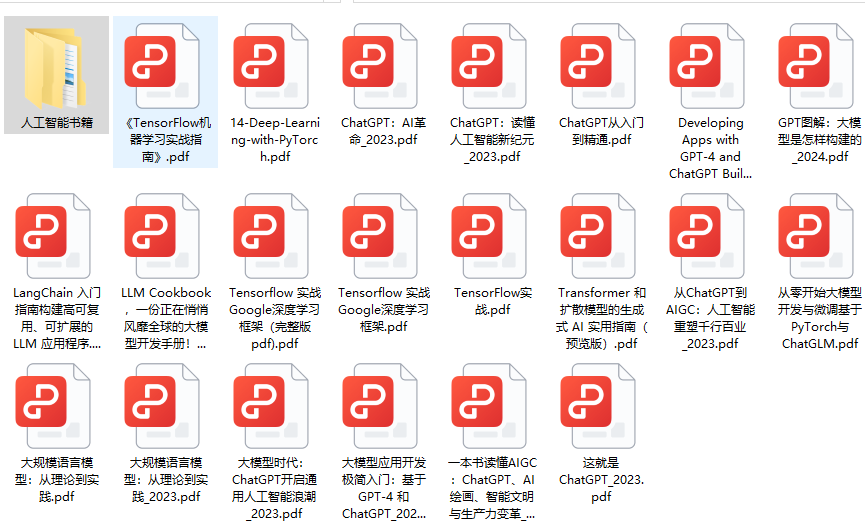
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
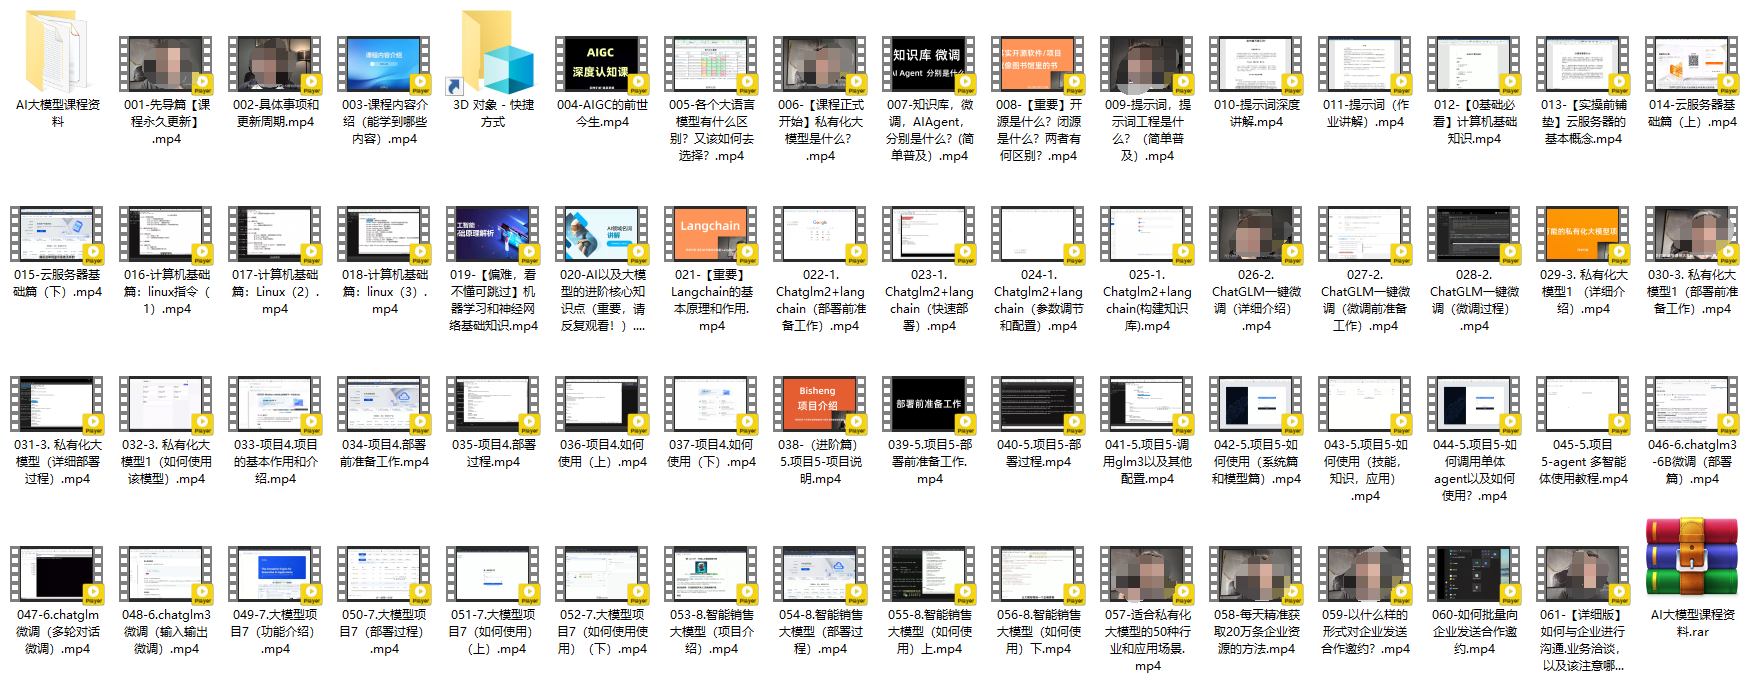
四、AI大模型商业化落地方案
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 3254


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


