多模态RAG技术总结及知识图谱构建分割+抽取+验证三阶段思路

论文导读 | 多模态知识图谱的构建 本文将介绍四篇多模态知识图谱构建的相关论文,涉及到的方法主要分为两类,即根据多模态文档构建(GAIA、RESIN)和根据搜索引擎获取的图像构建(MMKG、Richpedia)。 阅读详情

文章介绍了组合式多模态RAG技术演进与知识图谱构建方法。多模态RAG涵盖预检索、检索、增强和生成四个阶段,包含多种模态组合与实现策略;OntoMetric框架通过结构感知分割、本体引导抽取和两阶段验证,将ESG政策文档转化为结构化知识图谱,解决实体不一致与关系幻觉问题。


继续看技术进展,看RAG进展,看一个组合式多模态RAG总结性梳理,看看这块有哪些思路。

另一个是知识图谱构建进展,看看一个分割+抽取+验证做知识图谱构建思路-OntoMetric

多总结,多归纳,**多从底层实现分析逻辑,**会有收获。

一、组合式多模态RAG总结性梳理

RAG作为一种范式,可以灵活扩展,可以来个暴力组合,写综述。变成从文本RAG到多模态输入-文本输出,再到多模态输入-多模态输出的一个演进。

这块,看一个技术总结,如《A Comprehensive Survey on Multimodal RAG: All Combinations of Modalities as Input and Output》,https://doi.org/10.36227/techrxiv.176341513.38473003/v2,https://github.com/INTREBID/Awesome-MM-RAG,所有可能使用的模态组合作为输入和输出,包括文本、图像、音频、视频、代码、表格、知识图谱、3D 对象等。一共54个。
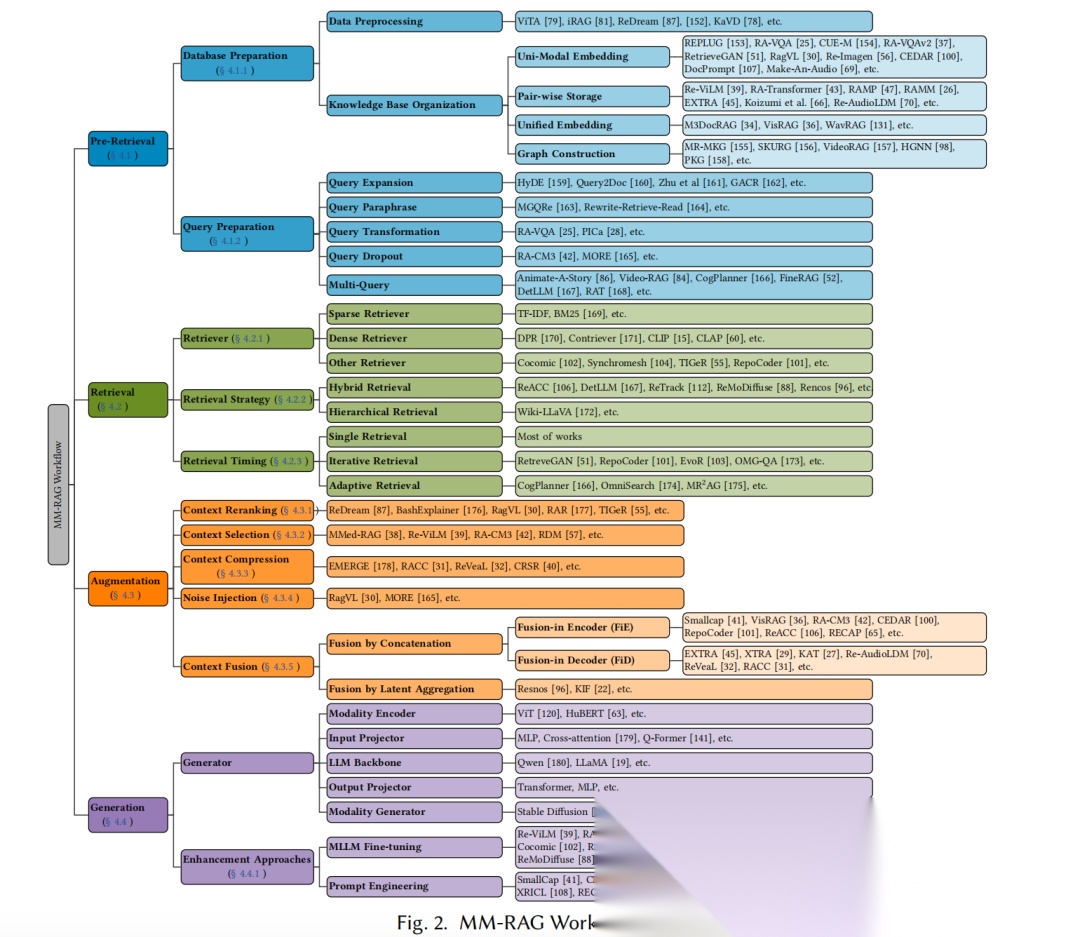
看几个点。

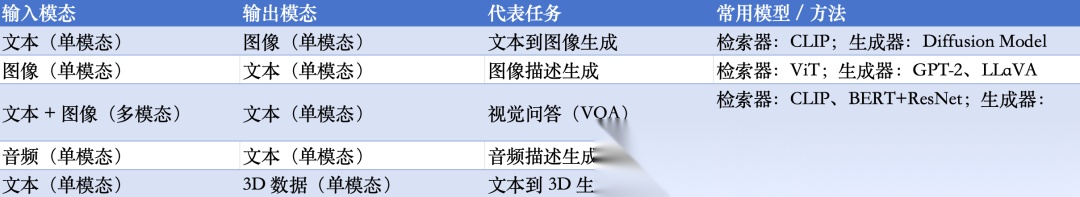
1、看不同输入输出组合的代表方案
2、看核心流程

如下所示,看看几个核心流程:
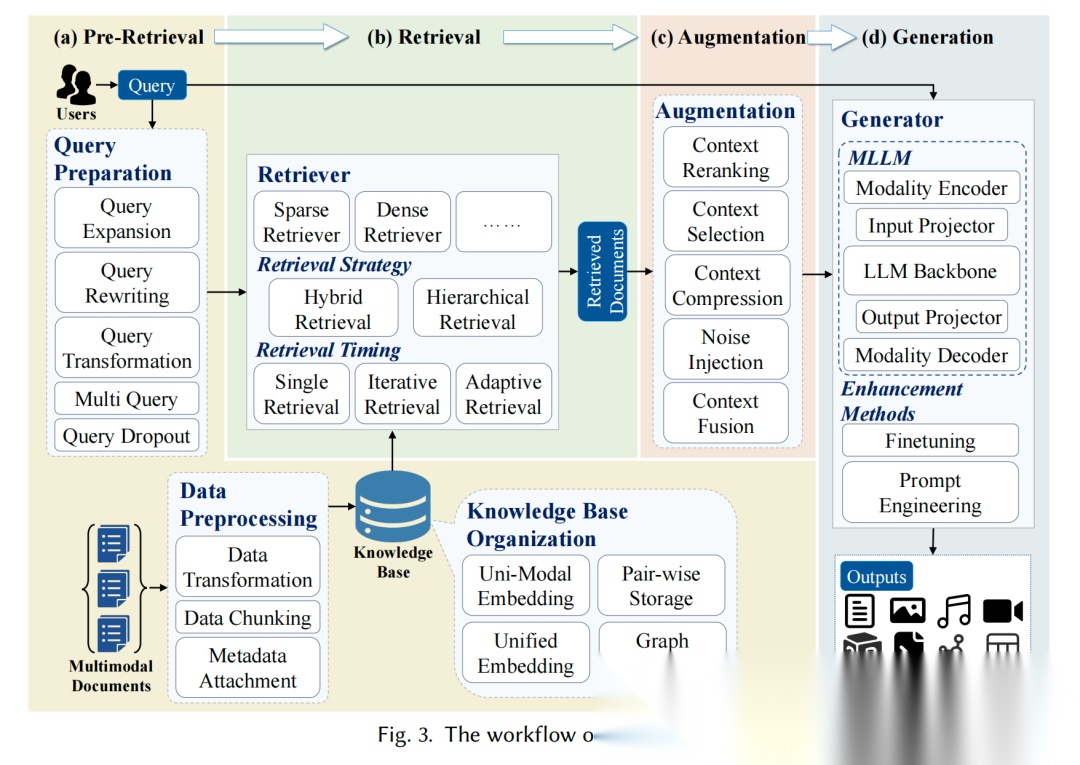
预检索阶段,关键操作是知识库准备(4种组织方式:单模态嵌入、成对存储、统一嵌入、图构建)和查询准备(5种优化技术:扩展、改写、转换、dropout、多查询);

检索阶段,关键操作是检索器选择(稀疏、密集、其他3类)、策略制定(混合、分层等)和时机控制(单次、迭代、自适应3种),常用方法包括BM25、CLIP、混合检索;

增强阶段,关键操作是上下文处理(重排序、选择、压缩)和优化(噪声注入、融合),常用方法有FiE(编码器内融合)、FiD(解码器内融合);

生成阶段,关键操作是生成器构建(5大组件)和增强(提示工程、MLLM微调),常用方法包括StableDiffusion(图像生成)、LoRA微调。

3、看训练策略

训练策略分为两类。
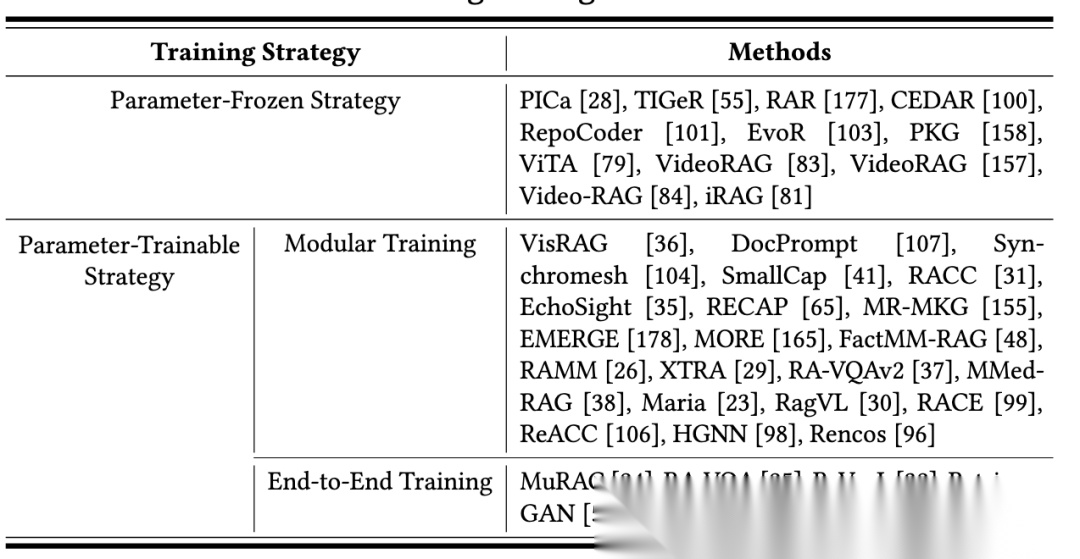
一类是参数冻结策略:直接复用现成模块,无参数更新,适用场景为快速部署、数据标注不足或低计算资源环境,代表研究有PICa、VideoRAG,优势是训练成本低、组件复用性强,劣势是任务适配性有限;

一类是参数可训练策略:包含模块化训练(独立优化各组件,适用场景为需针对性提升特定组件性能的场景,代表研究有VisRAG、RACC,优势是灵活度高、易维护,劣势是组件协同性不足)和端到端训练(联合优化检索器与生成器,适用场景为追求最优系统性能的场景,代表研究有RA-VQA、ReVeaL,优势是性能最优,劣势是计算成本高、部署灵活度差)。

二、分割+抽取+验证做知识图谱构建思路-OntoMetric

继续看一个知识图谱构建的思路,背景是SASB、TCFD、IFRSS2等框架要求企业报告大量ESG指标,相关规则嵌入长文本、非结构化PDF,包含定义、公式、单位等复杂信息,但是人工提取耗时、易错、难以应对框架更新。传统自动化关键词匹配/手工规则缺乏语义覆盖,无法处理复杂依赖。

无约束LLM提取容易出现实体不一致、关系幻觉、缺失溯源,验证失败率高,现有ESG本体又仅含形式化schema,缺乏自然语言描述。

所以,可以细分下实现,拆成多步。

具体的看这个工作《OntoMetric: An Ontology-Guided Framework for Automated ESG Knowledge Graph Construction》(https://arxiv.org/pdf/2512.01289),搞了一套“自动把ESG政策文档变成规整可用的知识图谱”的流程,核心是用“先拆分、再提取、后校验”的思路解决“文档乱、提取不准、没法审计”的问题。
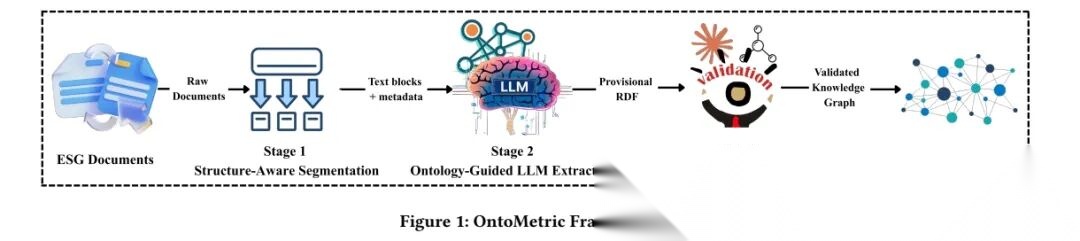
1、结构感知分割,基于目录(TOC)边界划分文档

ESG政策文档(比如SASB、TCFD)都是几百页的PDF,直接扔给AI提取容易乱。
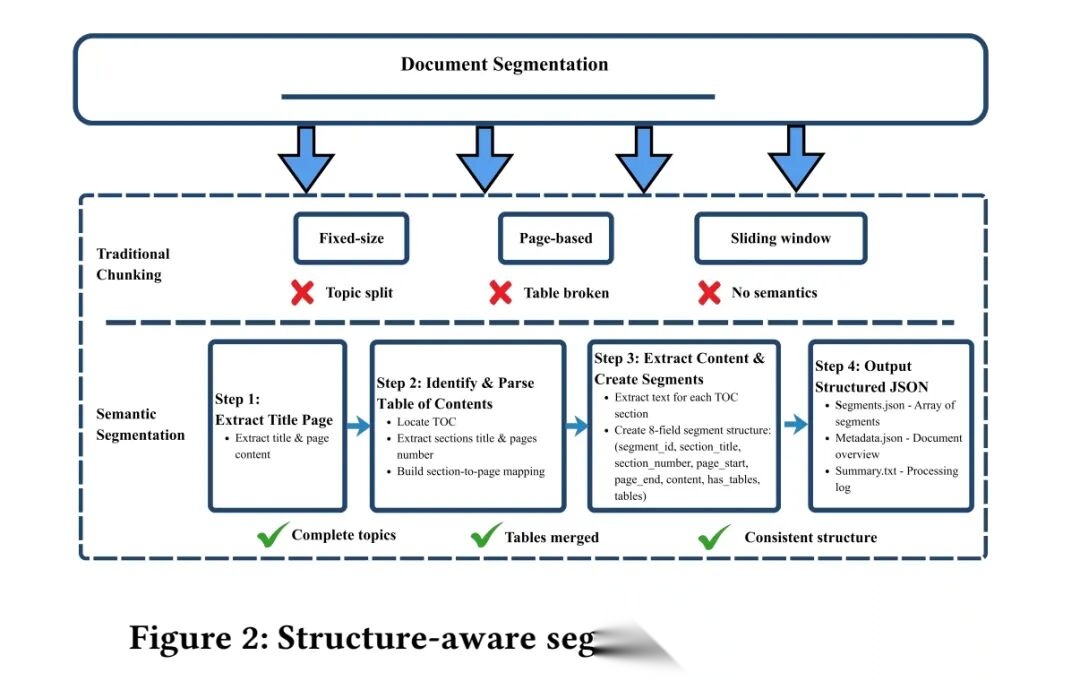
所以先按文档自带的“目录”拆分,比如“绿色气体排放”“数据安全”这些章节,each章节作为一个“小块”。每个小块都记着自己来自文档的哪几页、原来的标题,方便后续追溯来源。
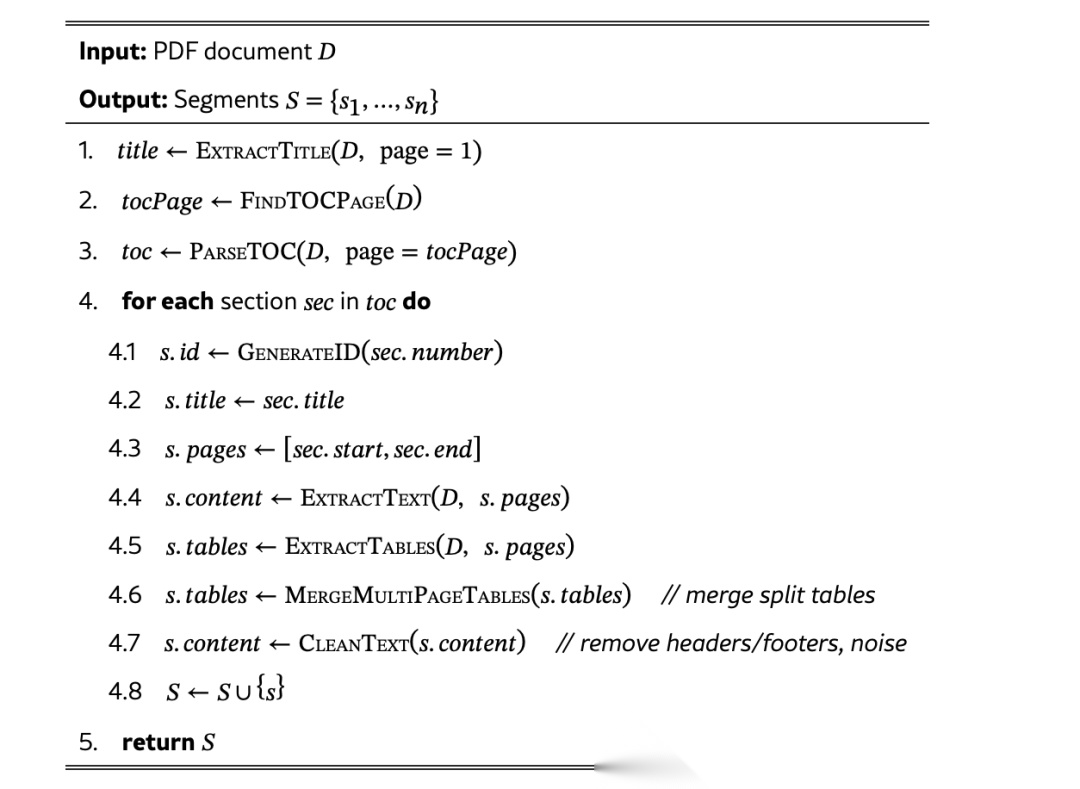
具体实现上,步骤为:step1.识别目录页面与标题,确定自然分割边界;->step2.合并跨页表格,清理布局冗余;->step3.保留片段标题、页面范围、sectionID等元数据;->step4.确保片段为完整概念单元(如指标定义、公式)

2、本体引导LLM提取

抽取上,如下:
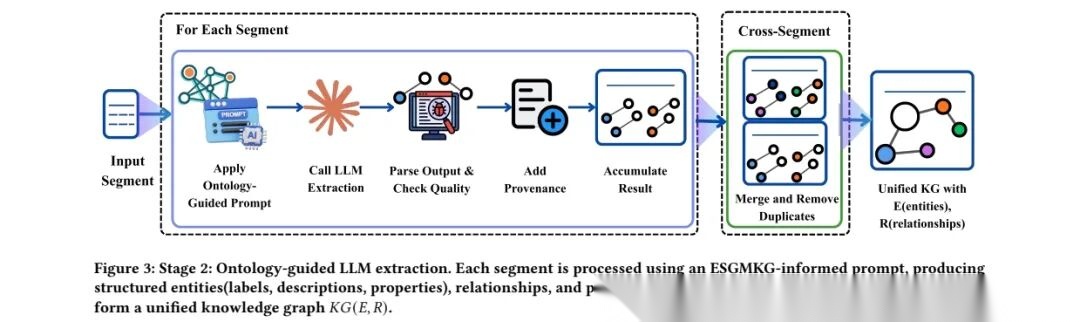
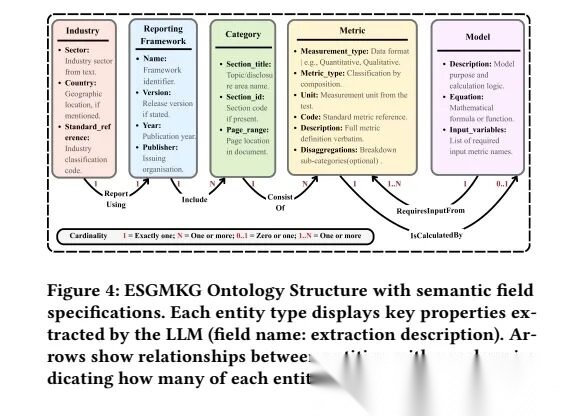
先告诉AI要提取5类信息(实体):行业(比如银行业)、披露框架(比如SASB)、分类(比如环境类指标)、具体指标(比如碳排放强度)、计算模型(比如碳排放怎么算);也就是一个是ESGMKGschema,包括5类实体(Industry、ReportingFramework、Category、Metric、Model)、5类关系谓词、7条结构规则;再定好这些信息之间的关系(比如“银行业”用“SASB框架”,“SASB框架”包含“环境类指标”);
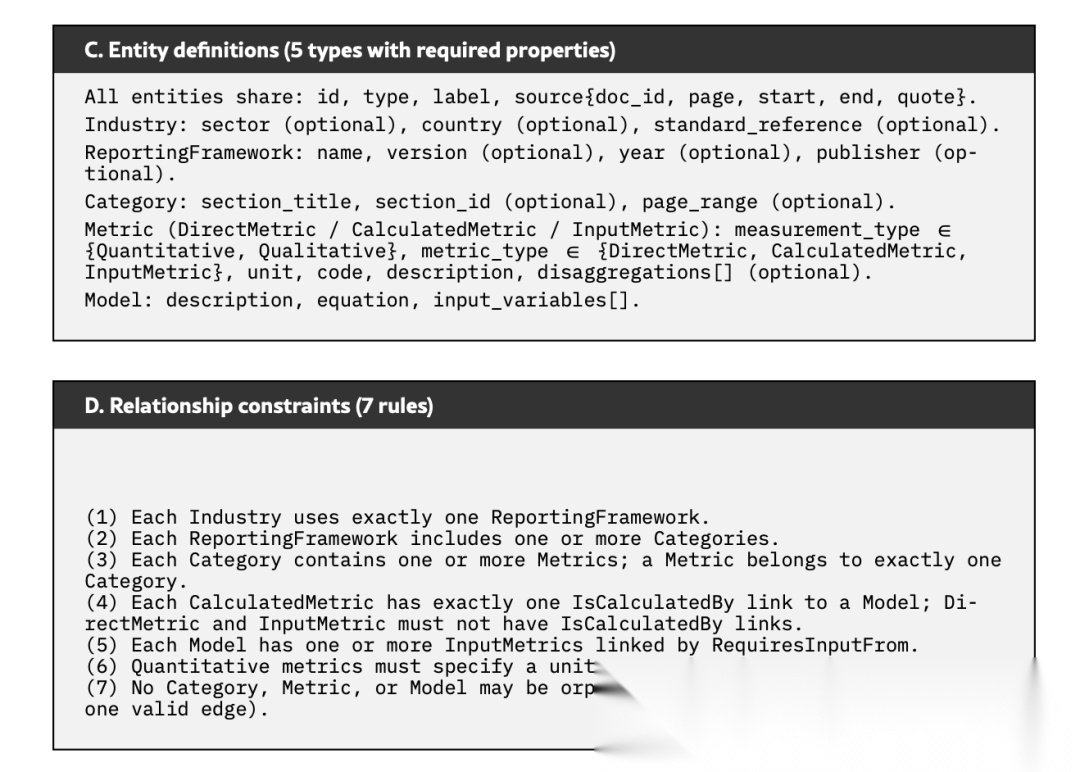
给一个固定模板,让它把提取的信息填成结构化的JSON(比如指标名称、单位、描述都按固定字段填),一个是提示词设计,含系统上下文、本体连接图、实体定义等9个组件;

提取时记着每个信息来自哪个小块、哪一页,避免后续找不到源头。

最后把所有小块的提取结果合并,去掉重复的信息,解析JSON、添加溯源元数据、跨片段整合(ID解析+实体/关系去重)。

3、两阶段验证

为了解决实体不一致、关系幻觉、缺失溯源、验证失败率高的问题,缓解思路是语义验证+规则化schema验证来实现。
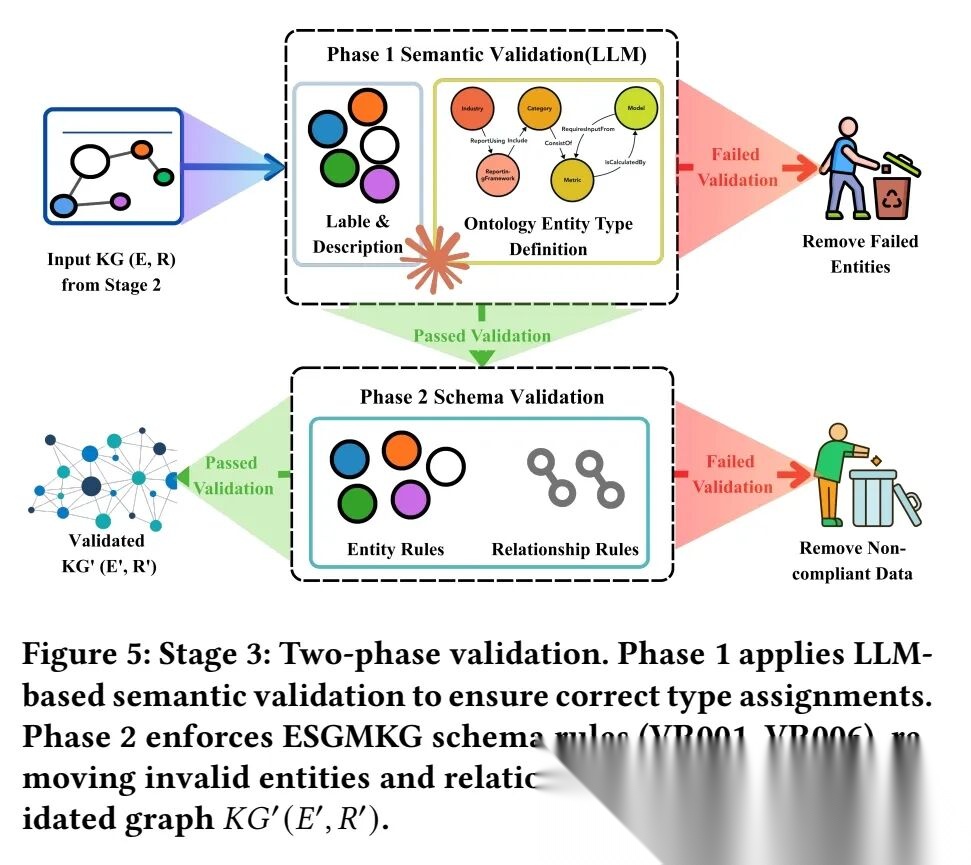
两阶段验证层:先通过LLM校验实体类型匹配度,再用6条规则检查结构合规性,剔除幻觉内容;同时全程保留片段/页面级溯源,解决溯源缺失问题。

拆开来看这个验证问题:

两阶段验证分为语义验证(Phase1)和schema验证(Phase2),两阶段结合使验证后的知识图谱同时满足语义正确性与结构有效性。

一个是语义验证,由LLM执行,核心作用是校验每个实体的标签和描述是否与其分配的ESGMKG类型匹配,直接剔除类型错误的实体及依赖关系,解决“实体类型幻觉”问题,减少后续无效校验,例如确认提取的“碳排放强度”确实是ESG指标,而不是财务指标(比如净利润),防止类型认错;

一个是schema验证,基于6条预定义规则执行,核心作用是保障结构合规性,具体包括:
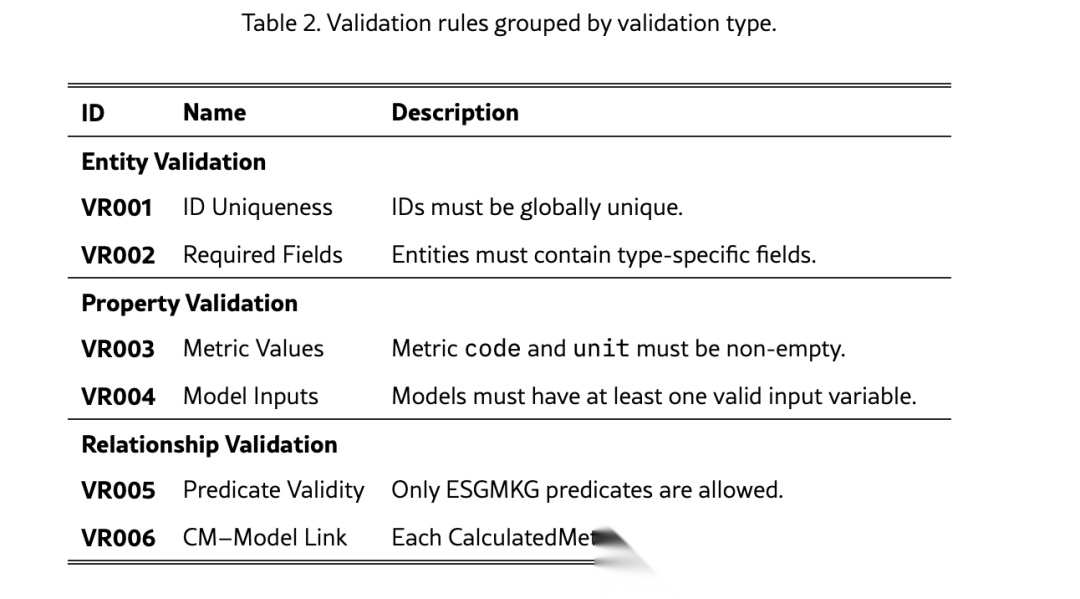
1)实体验证,实体ID必须全局唯一;

2)实体验证,实体需包含类型特定的必填字段;

3)属性验证,指标的代码(code)和单位(unit)不可为空;

4)属性验证,模型(Model)需至少包含一个有效输入变量;

5)关系验证,仅允许ESGMKG定义的5类关系谓词

6)关系验证,每个计算型指标(CalculatedMetric)需精确关联一个模型(Model)

如下:
在大模型时代,我们如何有效的去学习大模型?

现如今大模型岗位需求越来越大,但是相关岗位人才难求,薪资持续走高,AI运营薪资平均值约18457元,AI工程师薪资平均值约37336元,大模型算法薪资平均值约39607元。
在这里插入图片描述

掌握大模型技术你还能拥有更多可能性:

• 成为一名全栈大模型工程师,包括Prompt,LangChain,LoRA等技术开发、运营、产品等方向全栈工程;

• 能够拥有模型二次训练和微调能力,带领大家完成智能对话、文生图等热门应用;

• 薪资上浮10%-20%,覆盖更多高薪岗位,这是一个高需求、高待遇的热门方向和领域;

• 更优质的项目可以为未来创新创业提供基石。
图片

图片

《AI大模型从0到精通全套学习包》

图片

图片

如果你想要提升自己的能力却又没有方向?

想学大模型技术去帮助就业和转行又不知道怎么开始?

那么这一套**《AI大模型零基础入门到实战全套学习大礼包》以及《大模型应用开发视频教程》**一定可以帮助到你!

限免0元!👇👇
在这里插入图片描述

1

全套AI大模型应用开发视频教程

(包含深度学习、提示工程、RAG、LangChain、Agent、模型微调与部署、DeepSeek等技术点)
img

2

大模型入门到实战全套学习大礼包

01

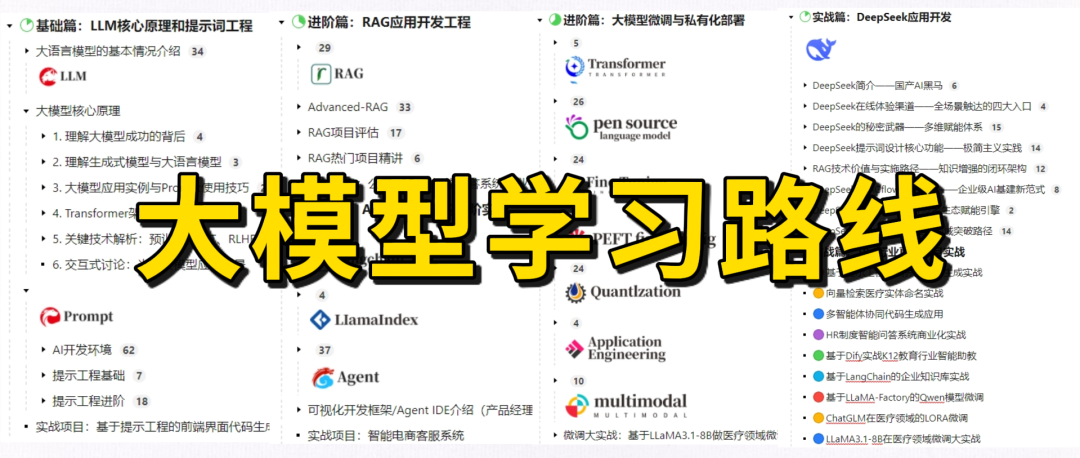
大模型系统化学习路线

作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
img

02

大模型学习书籍&文档

学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
img

03

AI大模型最新行业报告

2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
img

04

大模型项目实战&配套源码

学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
img

05

大模型大厂面试真题

面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
img

*这些资料真的有用吗?*

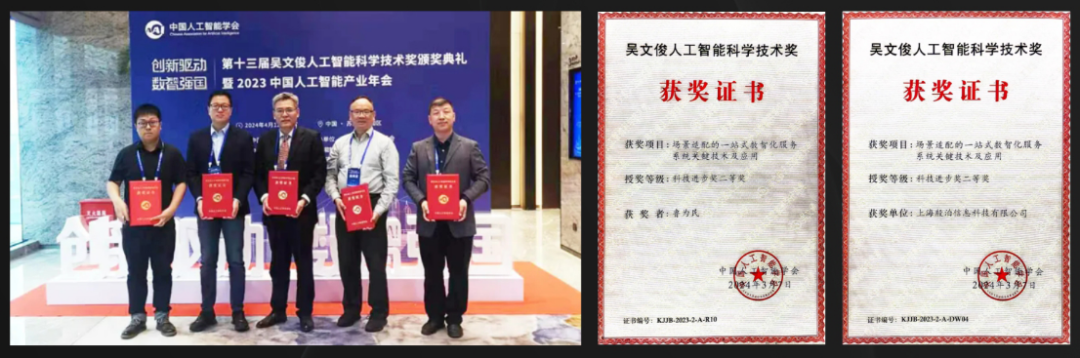
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
img

img

06

以上全套大模型资料如何领取?

在这里插入图片描述

👆🏻用微信加上就会给你发

无偿分享

遇到扫码问题可以私信或评论区找我

Multi-Modal Knowledge Graph(多模态知识图谱) 本篇博文梳理一篇knowledge-based方向的文章,结合了多模态知识的多模态知识图谱。来自复旦大学。知识图谱本质上是一个以实体、概念为节点、以概念之间的各种语义关系为边的大规模语义网络。知识图谱在现实生活中广泛应用,包括文本理解、推荐系. 阅读详情

相关推荐

基于Apache Doris一站式构建知识图谱增强RAG系统

如果你正在构建一个企业级的 AI 应用,比如一个智能客服或文档问答系统,你很可能已经接触过 RAG(检索增强生成)技术。它能解决大模型“幻觉”和知识陈旧的问题,但你是否也遇到了这些瓶颈:当用户问“我们公司产品A和产品B在技术架构上的主要区别是什么?”时,基础 RAG 返回的答案往往只是几个相关文档片段的拼接,缺乏逻辑关联,甚至可能遗漏关键对比信息。问题的根源在于,传统 RAG 将知识“打碎”成孤立的片段,丢失了实体间的深层联系。 这正是知识图谱的价值所在。它能将非结构化文档转化为结构化的“实体-关系”网络,

闲谈 427

多模态知识图谱:感知与认知的交汇

在当今信息时代,多模态数据的快速增长推动了人工智能领域的发展。多模态知识图谱作为感知系统与认知系统之间的桥梁,通过融合语言、视觉、听觉等多种信息形式,为人工智能系统提供了更为丰富、深入的理解。本文将深入探讨多模态知识图谱的发展历史、作用以及相关研究领域。

cooldream2009的博客 3225

基于Apache Doris构建知识图谱增强RAG系统:从文档处理到智能问答

1. 先搞清楚这个方案到底解决了什么问题 如果你正在搭建一个基于大模型的问答系统,尤其是需要处理企业文档、技术手册这类内部知识,那你肯定遇到过两个核心痛点:一是传统的RAG(检索增强生成)方案,面对复杂的、涉及多个实体和关系的查询时,回答容易变得零散、不准确;二是技术栈太杂,向量库、关系型数据库、图数据库各管一摊,开发和运维成本高。 这篇文章要讲的,就是如何用 Apache Doris (或它的云托管版 SelectDB )作为统一的数据底座,从零搭建一个完整的RAG系统,并且更进一步,引入 知识图谱 来增

weixin_30263277的博客 420

阿里小蜜多模态知识图谱的构建及应用

分享嘉宾:徐国海 阿里巴巴编辑整理:monk 国家管网出品平台:DataFunTalk导读:本文由阿里巴巴达摩院阿里小蜜团队带来,介绍其在知识图谱方面一年多以来的一些工作进展。主要内容包括...

Kaiyuan_sjtu的博客 4496

基于Apache Doris与SelectDB构建RAG及知识图谱增强的智能问答系统实战

这次我们来看一个基于 Apache Doris 和 SelectDB 构建的 AI 应用实战项目。它不是一个单一的模型或工具,而是一套完整的、可落地的技术方案,核心目标是解决大模型在回答复杂、专业问题时面临的“知识幻觉”和“信息碎片化”难题。简单说,就是教你如何用 Doris 这个高性能数据库,搭建一个从基础检索增强生成(RAG)到知识图谱增强的智能问答系统。 这个方案最值得关注的点在于,它没有停留在概念层面,而是提供了从环境准备、数据处理、向量入库、知识图谱构建到最终问答生成的完整代码流程。对于开发者而言

culuo8053的博客 415

多模态学习在知识图谱构建和推理中的进展

1.背景介绍 知识图谱(Knowledge Graph, KG)是一种描述实体(如人、组织、地点等)及其关系的数据结构。知识图谱可以用于各种应用,如问答系统、推荐系统、语义搜索等。多模态学习是一种机器学习方法,它可以处理不同类型的数据,如文本、图像、音频等。在过去的几年里,多模态学习在知识图谱构建和推理中取得了显著的进展。 本文将介绍多模

AI天才研究院 957

RAG与知识图谱技术深度解析:从多模态应用到ESG知识图谱构建

文章介绍两大技术主题:一是组合式多模态RAG技术的全面梳理,涵盖不同输入输出组合、核心流程和训练策略;二是OntoMetric方法,采用"结构感知分割+本体引导抽取+两阶段验证"思路,解决ESG知识图谱构建中的实体不一致、关系幻觉等问题。

2301_82275412的博客 739

电子病历编辑器源码(Springboot+原生HTML)

应用场景包括:电子病历书写、体温单录入、全平台信息采集、检验检查报告、不良事件上报等。 此外,电子病历编辑器软件还适用于医生工作站的病历编辑、护士工作站的护理记录输入、PASC/LIS/RIS报告编辑打印、病案首页、出院小结、病程记录、手术记录、各种知情书、康复及精神学科用的量表、临床路径用表单界面等等。 这些应用场景都涉及到了医疗文书编辑的需求,因此电子病历编辑器软件在这些场景中具有广泛的应用价值。

xingchen优快云的博客 3894

【绝对通俗易懂】知识图谱增强 RAG 思路 和 实现方案

举例:在处理"类风湿性关节炎"和"骨关节炎"这两种常见的关节疾病时,Graph RAG 能准确识别它们在病因、发病机制和治疗方法上的本质区别,避免因表面症状相似而导致的误诊。在传统的语义搜索中,"心肌梗塞"与"胃溃疡"这两个看似风马牛不相及的疾病,可能因为都与"胸痛"这一症状相关而被错误地联系在一起。当你问"我最近头疼、肚子疼、还有点晕,这是怎么回事"时,管理员会从每个症状出发,分别去找可能的原因,给你一个全面的解释。如果能让AI理解医学信息就像经验丰富的医生一样全面和深入,那会是多么令人振奋的突破!

Debroon 3626

Ubuntu 20.04 环境下Autoware.universe 与 Carla 0.9.13 联合仿真

安装内容: ROS Galactic Autoware.universe based on ROS Galactic Carla 0.9.13 UnrealEngine 4.26 Openplanner (additional files: op-bridge/op-agent/scenariorunner/map data)

mhl1107的博客 1798

保姆级教程:用COMSOL LiveLink™ for MATLAB 玩转自定义PDE,从理论到仿真一条龙

本文详细介绍了如何利用COMSOL LiveLink™ for MATLAB实现自定义PDE的从理论到仿真的完整流程。通过PDE模块与MATLAB的无缝集成,用户可以灵活处理非标准偏微分方程,适用于材料建模、传热传质验证等多物理场耦合研究。教程涵盖环境配置、方程标准化、界面操作及高级应用技巧,为工程仿真研究者提供原子级控制方案。

weixin_34098209的博客 354

【深度好文】2025年必收藏:多模态RAG与OntoMetric知识图谱构建全解析

前沿技术研究聚焦两大方向:一是组合式多模态RAG技术,系统梳理54种模态组合方案,提出包含预检索、检索、增强、生成四阶段的完整流程,并对比参数冻结与可训练两种优化策略;二是OntoMetric知识图谱构建方法,针对ESG政策文档处理难题,创新采用"结构感知分割-本体引导LLM提取-双重验证"的三步构建流程,通过目录划分文档、本体约束抽取、语义与规则双重校验,实现复杂信息的精准提取与结构化。两项研究均体现出"模块化分解+智能化处理+验证优化"的技术实现逻辑,为多模态信息

ytt0523_com的博客 837

微信支付开发之平台给用户转账到零钱的功能

请求消息中应包含商家批次单号、转账名称、appid、转账总金额、转账总笔数、转账openid、收款用户姓名等信息。批次已受理成功,若发起批量转账的30分钟后,转账批次单仍处于该状态,可能原因是商户账户余额不足等。【转账场景ID】 该批次转账使用的转账场景,如不填写则使用商家的默认场景,如无默认场景可为空,可前往“商家转账到零钱-前往功能”中申请。【转账总笔数】 一个转账批次单最多发起一千笔转账。【商家批次单号】 商户系统内部的商家批次单号,要求此参数只能由数字、大小写字母组成,在商户系统内部唯一。

程序员weixin_sodomany的博客 3450

【绝对通俗易懂】知识图谱增强 RAG 思路 和 实现方案_为什么需要知识图谱增强rag

利用 KG 关系网络,构建问题子图促精准解答。我感觉是最实用的,而且效果也不错。但如果还想优化,你得结合方式二了。直接将检索到的子图转化为自然语言描述。通常是对子图中的实体和关系进行一对一的转换,生成类似"实体A与实体B有关系C"的描述。这种方法的优点是保留了子图的直接信息,缺点是可能缺乏更高层次的概括。生成社区(实体群组)报告和摘要,这是一个更复杂的过程。不仅包含子图的直接信息,还包括更高层次的概括和分析。社区报告可能包含:a) 社区的整体描述b) 关键实体和关系的总结。

Z4400840的博客 1965

腾讯文档API逆向分析:不用Selenium也能批量导出的黑科技

本文揭秘了如何通过Python逆向分析腾讯文档的隐藏API,实现无需Selenium即可批量导出在线表格的高效方法。详细解析了API调用流程、Cookie维护及异常处理技巧,相比传统方案性能提升显著,适用于大量文档导出的自动化场景。

h9j8k7l6m5n的博客 1201

半车(前后、左右)、整车悬架详细推导建模和simulink仿真分析

用达朗贝尔定理依据悬架数学模型,得到悬架模型微分方程,分别用simulink建立前后半车、左右半车悬架;结合转向2自由度模型与半车侧倾模型,对模型考虑相干性、延时性的C级随机路面下,仿真分析给定角阶跃输入下的侧倾稳定性。

Mr.邹的博客 1万+

【RAG实战】基于知识图谱增强RAG应用和构建RAG知识库(附教程)_基于rag、知识图谱的知识库系统

【摘要】 本文探讨了RAG(检索增强生成)技术在知识库与知识图谱中的实践应用。面对大模型存在的幻觉问题、时效性不足等挑战,RAG通过检索外部知识提升生成内容的准确性与专业性。文章系统梳理了RAG技术的发展脉络(朴素RAG、进阶RAG、模块化RAG),并指出知识图谱的结构化特性可有效增强大模型的解释推理能力。作为当前工程化最成熟的大模型解决方案,RAG技术为AI落地提供了知识更新、专业问答等场景的实践路径,实现了检索式与生成式模型的优势互补。

2401_85373396的博客 1526

SAP 未清PO数量 = 采购订单数量 - 已收货数量

本文介绍了SAP系统中查询未清PO数量的6种方法:1.标准采购报表(ME2L/ME2M/ME2N)适合业务用户快速查询;2.物料需求报表(MD04)可查看单个物料的供需情况;3.SQVI快速查询器提供自定义字段的灵活性;4.ABAP报表适合开发人员处理复杂逻辑;5.SAPQuery经配置后可供业务用户使用;6.BI/HANA方案适合大数据量分析。每种方法各有优缺点,用户可根据自身技术水平和具体需求选择,日常查询推荐使用标准采购报表ME2L/ME2M。

金牌架构师 1854

【值得收藏】2025最新:知识图谱缓解RAG冲突+多模态文档表格处理技术详解

本文深入解析了知识图谱如何有效缓解大模型RAG系统中的内外部知识冲突,以及多模态文档处理中表格识别的前沿技术。通过结构化知识图谱筛选可靠信息和创新的表格处理方法,帮助开发者提升大模型应用的准确性和可靠性。无论您是RAG系统开发者还是文档处理研究者,这些技术思路都将为您的项目提供实用参考。本文来源于网络,由于如有侵权,请联系删除。今天是2025年11月14日,星期五,北京,天气晴继续回到RAG和文档智能方向。来看基于知识图谱缓解大模型RAG内外部冲突思路,

python12345678_的博客 1612

【ArcGIS微课1000例】0145:如何按照自定义形状裁剪数据框?

使用绘图 工具条上的新建圆工具 可创建一个椭圆,使其包含要在该数据框中显示的数据范围。. 在基础工具工具条上单击选择元素工具 ,然后选择圆形。. 在内容列表中右键单击要裁剪的数据框,然后单击属性。. 单击裁剪选项下拉菜单,然后选择裁剪至形状。. 单击数据框属性 对话框中的数据框选项卡。还可以更改裁剪形状轮廓的边框选项。打开软件,添加配套实验数据包中。修改椭圆的属性,使其透明。. 单击所选图形的轮廓。. 单击指定形状按钮。

智慧空间实验室 953

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

知识图谱引导的检索增强生成(KG²RAG):提升大模型响应质量与检索效能的创新框架

近年来,大型语言模型(LLMs)在问答系统、写作辅助、代码生成等众多现实任务中取得了显著成就,成为人工智能领域的核心技术之一。然而,大模型生成响应时存在的“幻觉”问题(即生成包含过时信息或领域特定知识缺失的内容),严重制约了其在高可靠性要求场景中的应用。检索增强生成(RAG)技术通过从外部文档中检索相关知识并融入大模型提示词,为缓解幻觉问题提供了可行解决方案,已成为连接大模型与外部知识的关键桥梁。

m0_59163425的博客 452

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

超越传统RAG:港大RAG-Anything如何用知识图谱处理科研论文图表?

本文深入解析了香港大学开源的RAG-Anything框架如何革新传统RAG系统。它通过构建统一的多模态知识图谱,不仅能理解文本,更能深度处理科研论文中的图表、表格和公式等非文本信息,实现精准的多模态检索与问答,为学术研究带来效率跃迁。

weixin_29094979的博客 302

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

技术动态 | 多模态GraphRAG的图谱构建及文档OCR多模态大模型可用合成数据集

基于IDEFICS3 架构,VIT采用siglip2-base-patch16-512(https://huggingface.co/google/siglip2-base-patch16-512)与 Granite 165M LLM,https://huggingface.co/ibm-granite/granite-docling-258M,https://docling-project.github.io/docling/3,实例层KG(InstanceKG)构建。转载公众号 | 老刘说NLP。

开放知识图谱 269
上一篇: 中国大模型行业2025全景解读:讯飞、字节、腾讯、阿里的差异
下一篇: 解构多智能体系统,一篇就够了。
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值