2025时序数据库选型,从架构基因到AI赋能来解析

什么是时序数据库 TSDB(Time Series Database) 时序数据库,时序数据库全称为时间序列数据库。 阅读详情

文章对比了IoTDB、InfluxDB和QuestDB三种时序数据库在架构、数据管理、性能和AI生态四个维度的差异。IoTDB在工业物联网场景表现优异,具备原生架构、端云协同、高压缩比和AI原生集成;QuestDB适合极致写入性能场景;InfluxDB是中小型监控项目的稳健选择。理解不同产品设计哲学,才能找到最匹配业务需求的数据库。


> 💡 原创经验总结,禁止AI洗稿!转载需授权

**> 声明:**本文所有观点均基于多个领域的真实项目落地经验总结,数据说话,拒绝空谈!

目录

引言:你的数据库,能应对时序数据的“四重考验”吗?

一、维度一:架构基因 —— 从根源看懂谁是“天选之子”

二、维度二:数据全生命周期管理 —— 从边缘到云端,成本与效率的博弈

2.1 端云协同:IoTDB的“杀手锏”

2.2 数据模型:树状结构 vs 关系表

三、维度三:性能剖析 —— 成本敏感型场景下的终极对决

四、维度四:AI与开发者生态 —— 决胜未来的软实力

4.1 AI 原生集成:从“被动调用”到“主动赋能”

4.2 大数据生态与查询语言

结论:2025年,你的场景该如何选型?


引言:你的数据库,能应对时序数据的“四重考验”吗?

    智慧工厂里,上万个传感器每秒并发写入;新能源车队中,PB级的电池数据需存储数年备查;金融市场上,高频交易数据要求微秒级延迟响应。**这些场景的背后,是时序数据的四大典型特征,也是对所有TSDB的“灵魂拷问”:**
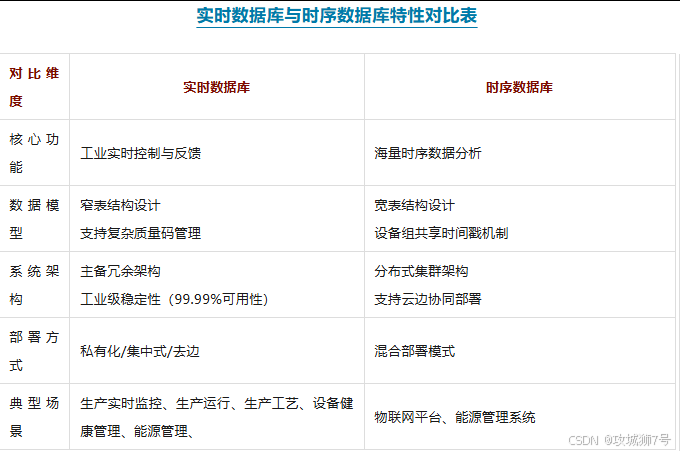
**(1)极高的写入并发:**能否撑住百万测点持续不断的数据轰炸?

**(2)强时间关联性查询:**能否在毫秒内完成对任意时间范围的聚合分析?

**(3)海量数据的生命周期管理:**能否用最低成本存储数年的“冷”数据,同时保证“热”数据的高效访问?

**(4)乱序与高基数挑战:**能否从容应对工业场景中常见的网络延迟(数据乱序)和爆炸式增长的设备标签(高基数)?

    无法完美回答这四个问题的TSDB,终将在未来的数据浪潮中掉队。**带着这些问题,我们来审视三位主流选手:**

(1)Apache IoTDB:为工业物联网(IIoT)海量数据而生的国产原生分布式架构。

(2)InfluxDB:市场领先的通用型监控与时序应用标杆。

(3)QuestDB:以SQL为核心并兼容PostgreSQL协议的高性能时序架构。

一、维度一:架构基因 —— 从根源看懂谁是“天选之子”

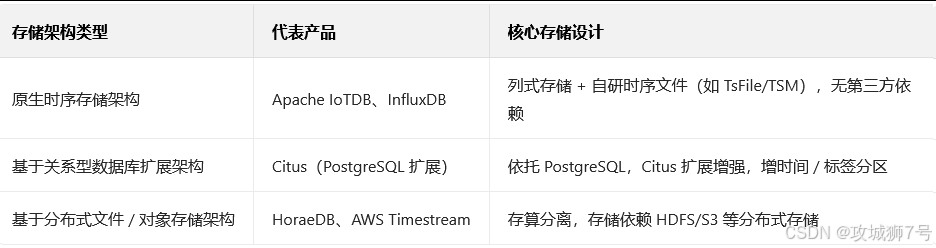
    数据库的底层架构,是其能力的上限。**我们可以将TSDB分为三类**,其基因决定了它们各自的命运。
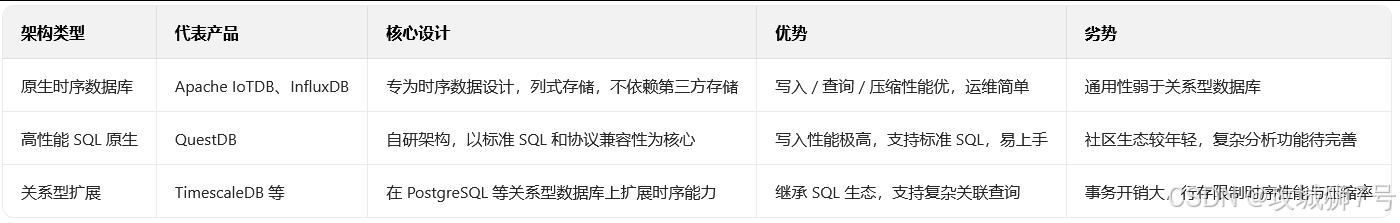
深度分析:

(1)原生时序,为何是工业场景的首选? 以 Apache IoTDB 为代表的原生架构,是真正为解决上述“四重考验”而生的。它采用列式存储和自研的时序文件格式(TsFile),天然适合做时间范围的聚合查询和高倍率压缩。更重要的是,它摒弃了传统数据库沉重的事务管理,通过顺乱序数据分离引擎(IoTLSM) 等设计,从根源上解决了工业场景中常见的乱序数据写入难题。这种“专病专治”的设计,使其在处理海量工业数据时,展现出体系化的优势。

(2)InfluxDB 同样属于原生阵营,其 TSM存储引擎 非常高效,但在开源版本的分布式能力和对工业数据模型的亲和度上,与IoTDB的设计思路有所不同。

(3)QuestDB 的“SQL原生”路线,通过兼容PostgreSQL线协议,极大地降低了开发者的学习成本,其性能表现令人印象深刻。但这种设计也意味着它必须在SQL的框架内进行优化,对于工业领域一些特有的数据模型(如层级结构),表达能力会受到一定限制。

**结论:**对于需要管理大规模、长周期、且数据特性复杂的工业物联网场景,原生时序架构无疑是根正苗红的“天选之子”。

二、维度二:数据全生命周期管理 —— 从边缘到云端,成本与效率的博弈

    现代物联网应用,数据链路横跨“端-边-云”,高效管理整个链路是降本增效的关键。

2.1 端云协同:IoTDB的“杀手锏”

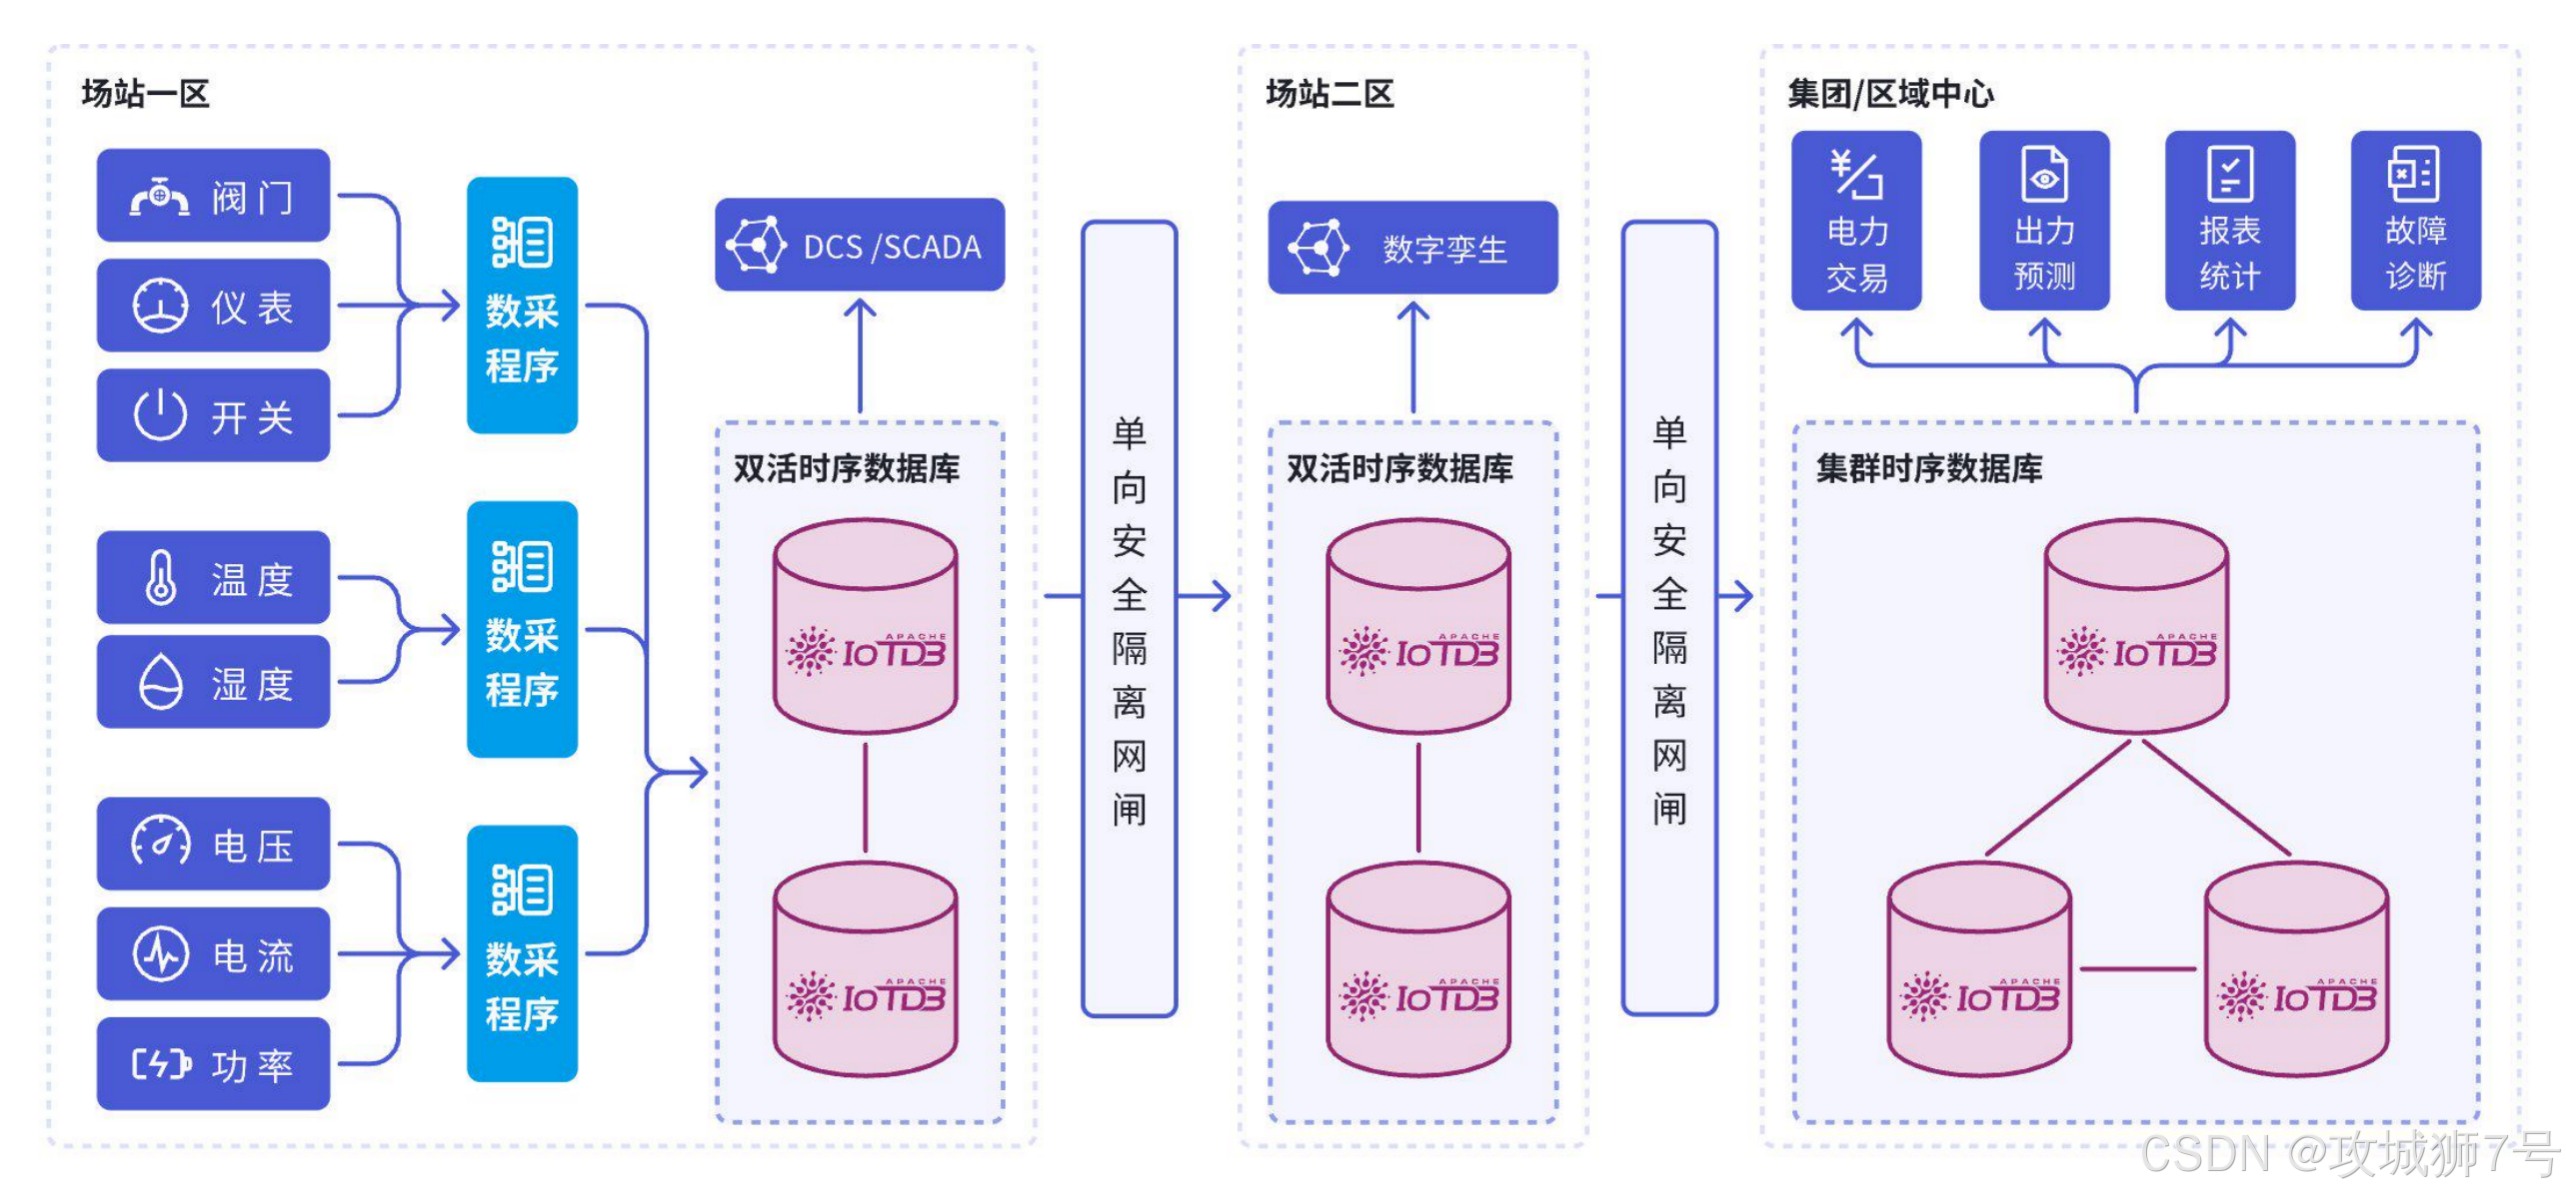
    这是 **Apache IoTDB** 的绝对主场。它原生提供了轻量级的边缘端版本和强大的**端云同步(Data Sync)工具**。你可以在边缘网关上部署一个IoTDB实例(仅需几十MB内存)进行本地数据缓存和预聚合,再通过内置工具,将压缩后的 `TsFile` 文件高效、断点续传地同步至云端。这套机制是为弱网络、高延迟的工业环境“量身定制”的,能极大降低带宽成本和云端写入压力。
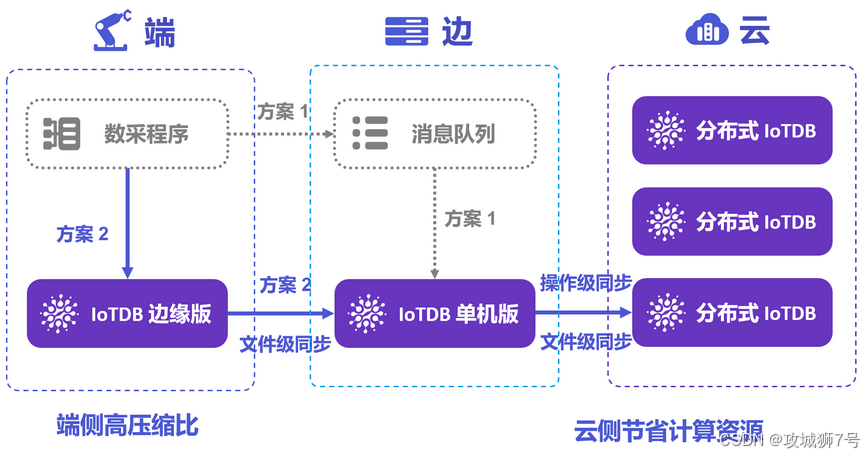
    相比之下,InfluxDB 依赖 Telegraf,QuestDB 则更侧重于云端部署,它们在端侧的原生数据管理和复杂同步策略上,都不如 IoTDB 体系化。

2.2 数据模型:树状结构 vs 关系表

(1)IoTDB 的树状模型 (root.group.device.sensor) 与工业设备的物理层级结构天然同构。你可以像管理文件目录一样管理设备测点,例如root.发电集团.风电场A.风机01.温度。这种模型让数据组织非常直观,查询(如select \* from root.发电集团.风电场A.\*)也极为便利。

(2)InfluxDB 的 Tag-Value模型 在处理多维度的监控指标时极为灵活。

(3)QuestDB 采用标准的关系模型,数据存储在表中。这对于习惯SQL的开发者非常友好,但在表达复杂的设备层级关系时,可能需要设计额外的关联表,增加了复杂性。

三、维度三:性能剖析 —— 成本敏感型场景下的终极对决

    我们来看一组更贴近真实业务的对比,特别是关注**存储成本**,这往往是长期运营中最敏感的部分。
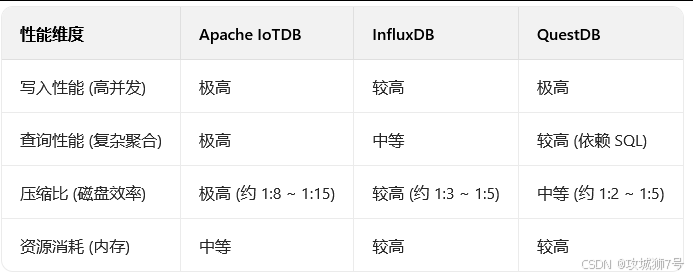
深度分析与案例:

**(1)写入与查询:**三者在高并发写入上都表现优异。但在复杂聚合查询(如计算一个集团下所有风场每小时的平均发电量)方面,IoTDB 凭借其专为时序设计的存储格式和查询引擎,通常表现更佳。

**(2)压缩比(成本关键):**这是 IoTDB 的“断层式”优势。其自研的 TsFile 格式,结合了Delta编码、RLE、GORILLA等多种针对不同数据类型的最优压缩算法,实现了极致的压缩比。其中一个真实案例:某智能电网项目中,1TB的原始数据,在使用IoTDB压缩后仅需80GB,节省了超过90%的磁盘成本!对于需要按法规长期保存数据(如3-5年)的工业场景,这每年可以节省数十万甚至上百万的存储费用。

代码示例:IoTDB原生的极致性能体验 (Java)

    为了追求极致性能,许多工业级应用会选择Java。下面的代码展示了IoTDB如何通过`Tablet`实现超高性能的批量写入。
// 生产环境推荐使用连接池高效管理会话

SessionPool pool = new SessionPool.Builder().host("127.0.0.1").port(6667).user("root").password("root").maxSize(3).build();


// 1. 定义设备与测点结构 (Schema),甚至可以为每个测点指定最高效的压缩编码

List<MeasurementSchema> schemaList = new ArrayList<>();

schemaList.add(new MeasurementSchema("temperature", TSDataType.DOUBLE, TSEncoding.GORILLA));

schemaList.add(new MeasurementSchema("status", TSDataType.BOOLEAN, TSEncoding.PLAIN));


// 2. 创建Tablet,一个内存中的高效数据块,用于批量操作

Tablet tablet = new Tablet("root.factory.workshop1.device01", schemaList, 100);


// 3. 在客户端内存中高效填充数据

long timestamp = System.currentTimeMillis();

for (long row = 0; row < 100; row++) {

    int rowIndex = tablet.rowSize++;

    tablet.addTimestamp(rowIndex, timestamp + row);

    tablet.addValue("temperature", rowIndex, ThreadLocalRandom.current().nextDouble(20, 30));

    tablet.addValue("status", rowIndex, row % 2 == 0);

}


// 4. 一次网络请求,将整个Tablet写入数据库,性能远超逐条写入

pool.insertTablet(tablet);

System.out.println("Tablet 写入成功!");


pool.close();

**代码解读:**这种“客户端缓存、一次批量写入”的模式,正是IoTDB针对物联网“高并发、高吞吐”特性设计的精髓,也是其实现超高性能写入的核心秘密。

四、维度四:AI与开发者生态 —— 决胜未来的软实力

4.1 AI 原生集成:从“被动调用”到“主动赋能”

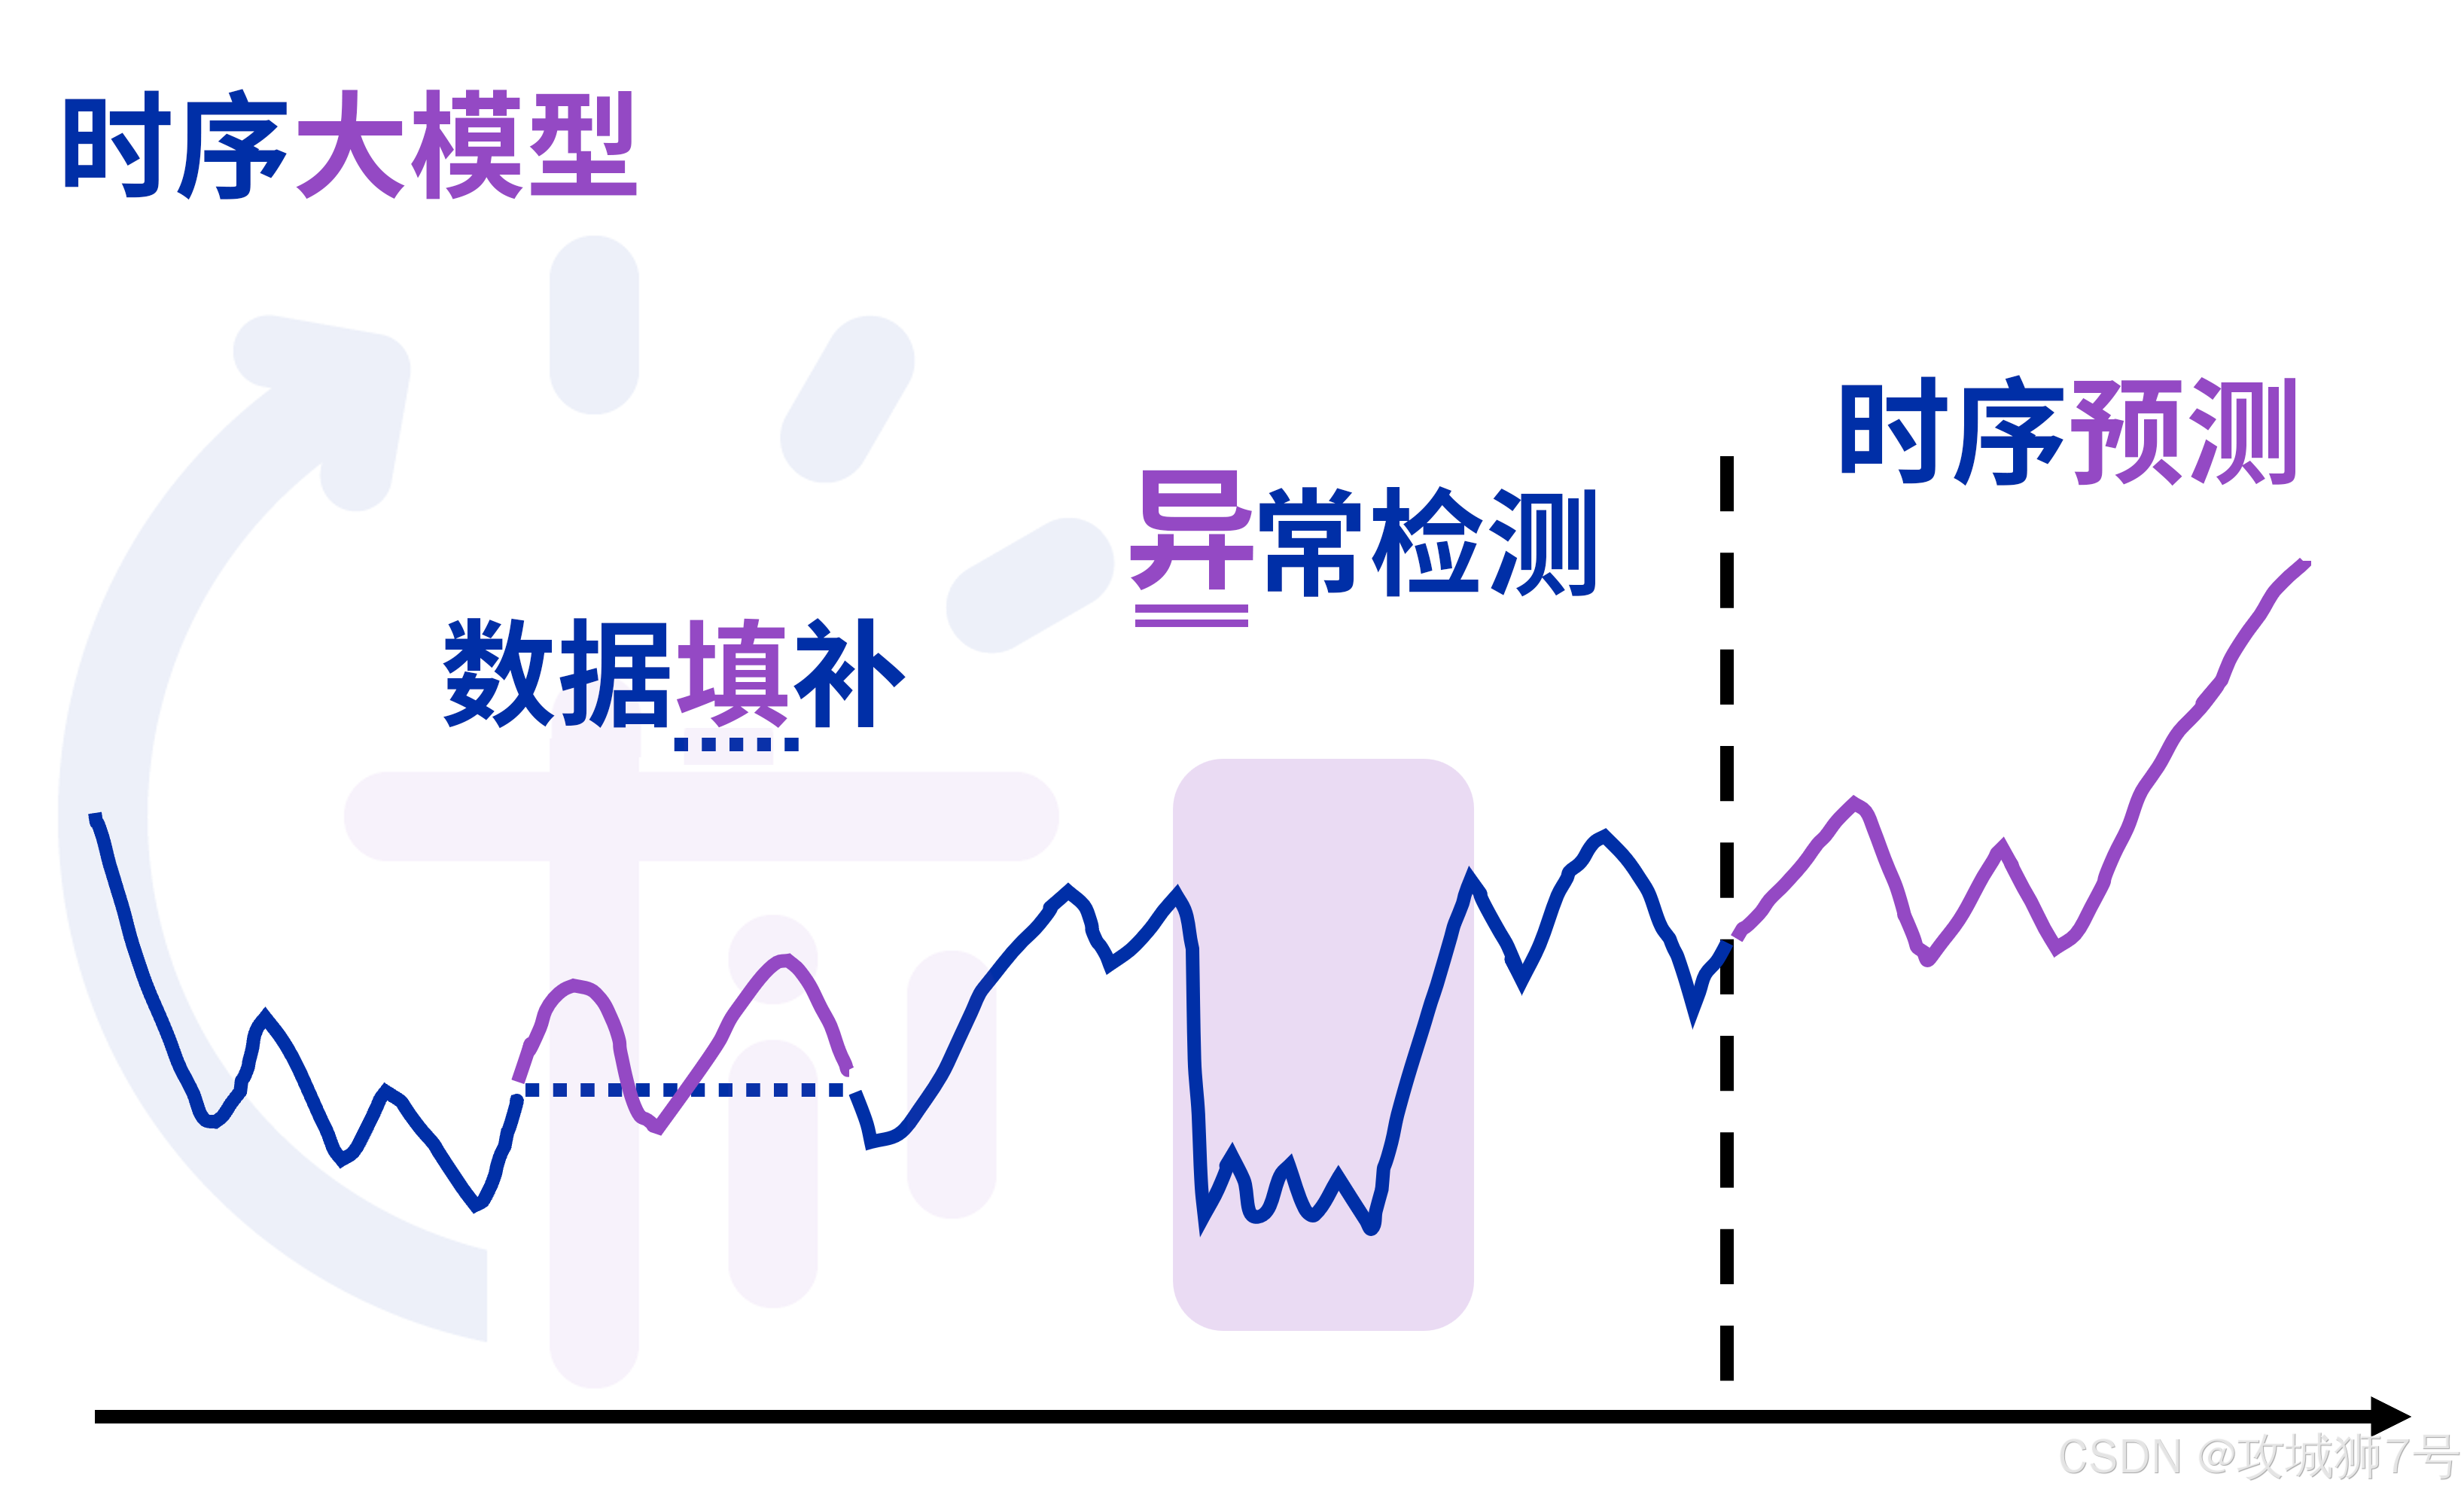
    当其他数据库还在讨论如何被AI调用时,IoTDB已经通过 **AINode 和 时序大模型**,将AI能力内嵌到了数据库内核中。
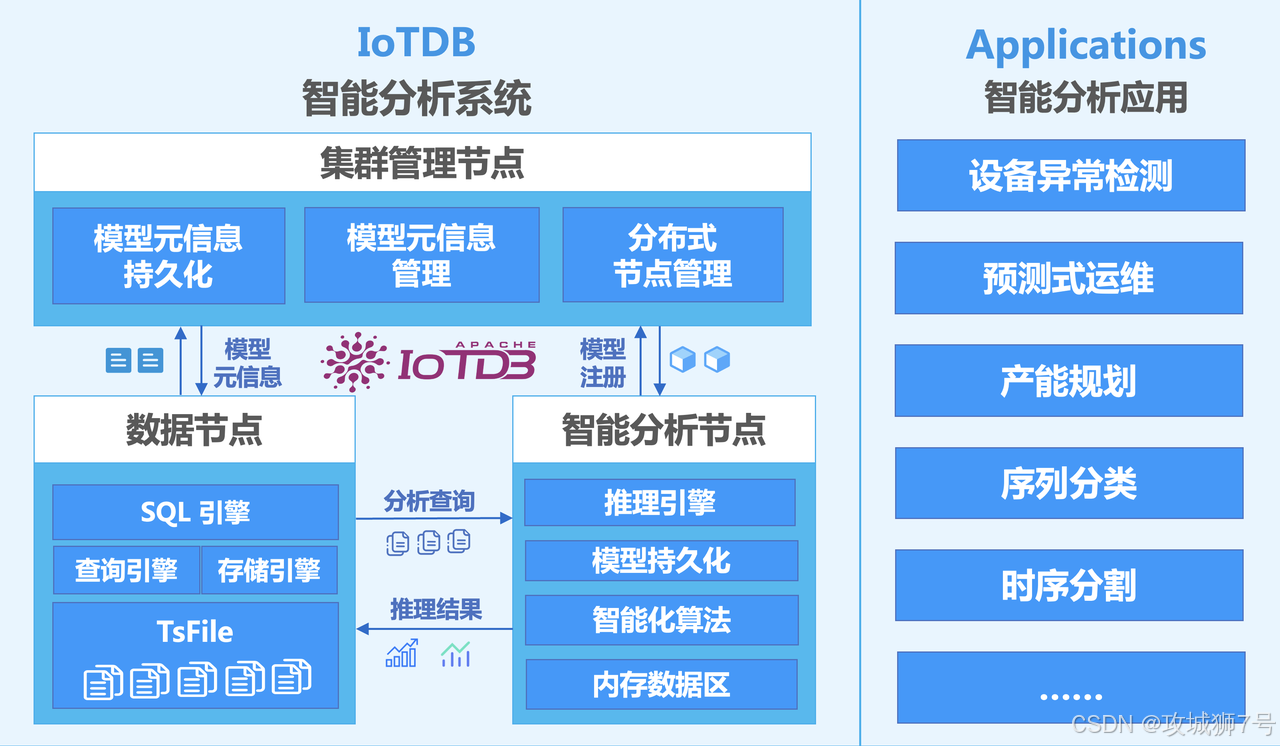
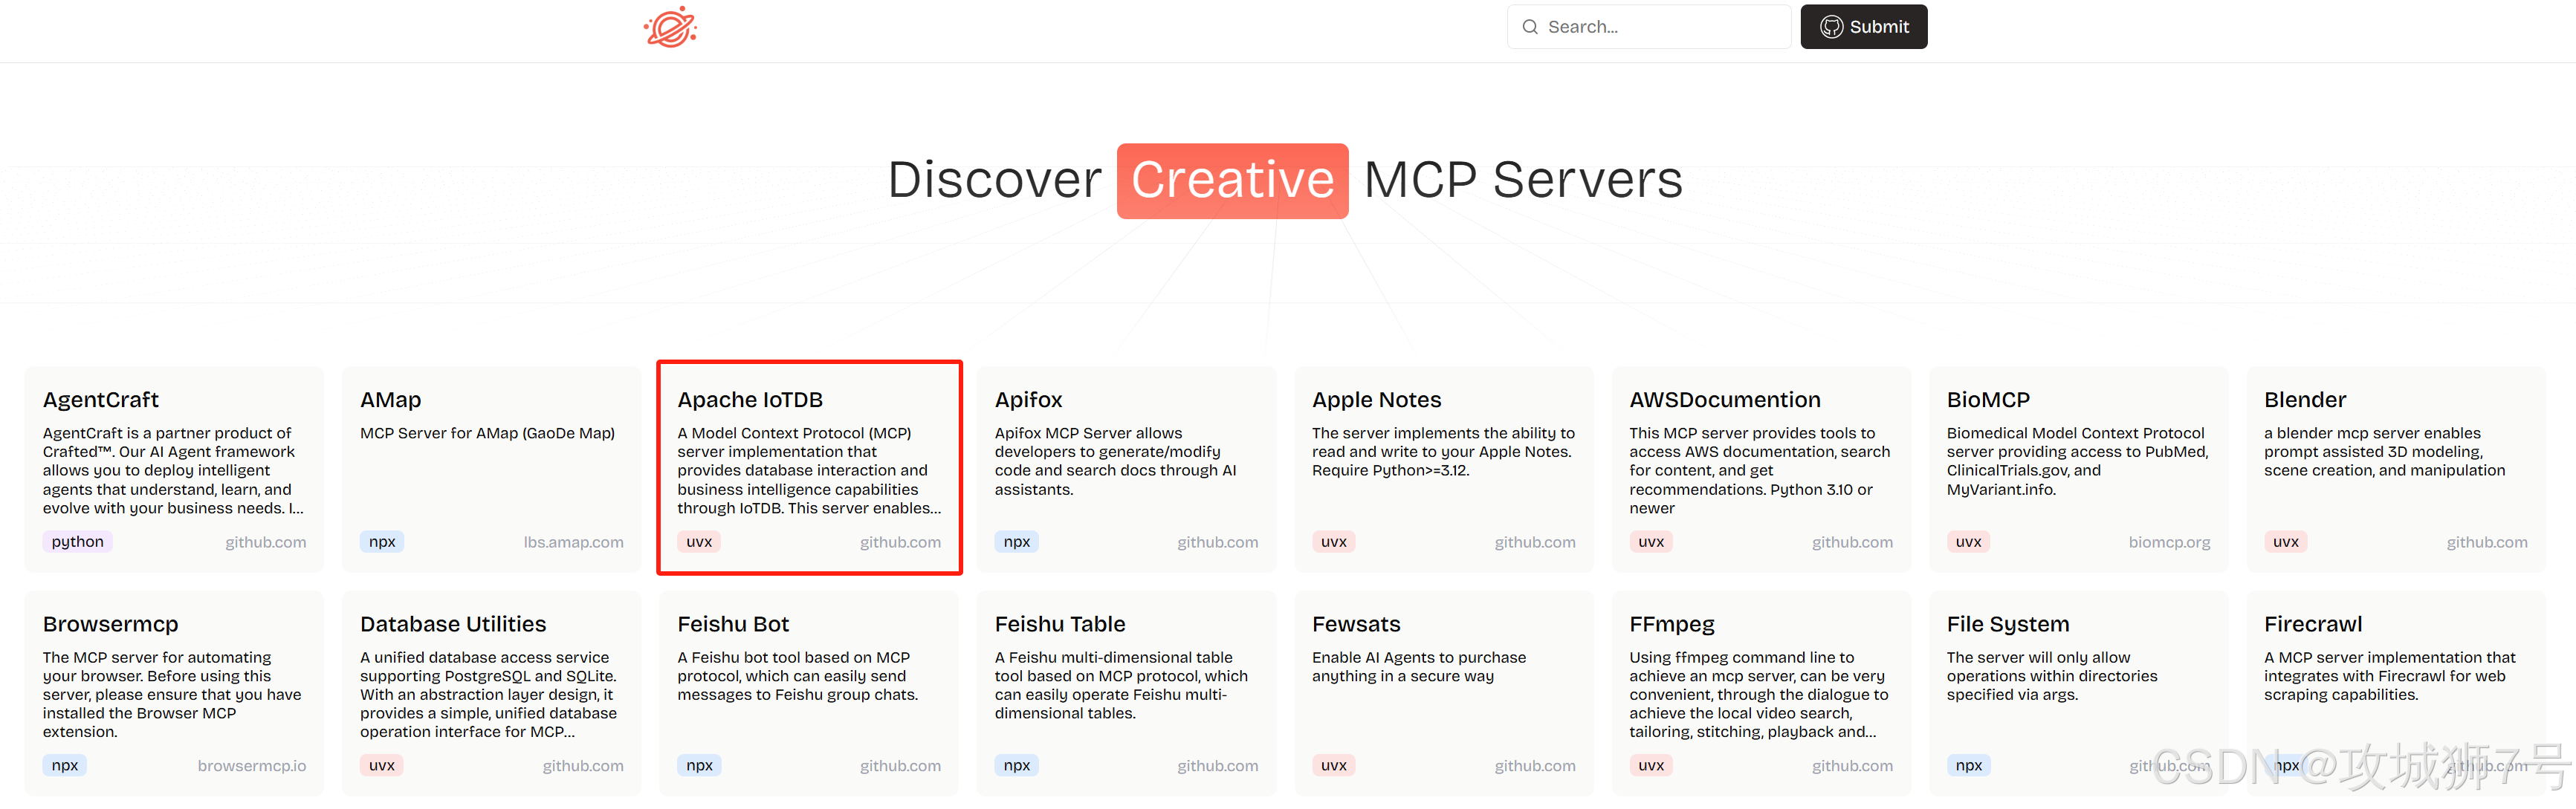
**(1)超越MCP:**除了支持MCP协议让LLM能用自然语言查询数据,IoTDB更进一步。
**(2)内置AINode:**你可以将训练好的时序模型(如清华自研的Timer-XL)部署在AINode中。

**(3)SQL调用AI:**最酷的是,你可以直接用SQL来调用这些模型进行预测或异常检测!

-- 使用内置的时序大模型,预测未来24个点的温度

SELECT PREDICT(temperature, 24) FROM root.factory.workshop1.device01
    这种设计,让AI从一个外部工具,变成了数据库的原生能力,极大地简化了AI应用的开发和部署。

4.2 大数据生态与查询语言

(1)作为Apache基金会的顶级项目,IoTDB 与 Spark、Flink、Hadoop 等大数据生态无缝集成,提供了原生Connector,方便构建“采-存-算-用”一体化的数据平台。

(2)IoTDB 和 QuestDB 都提供了对开发者最友好的类 SQL 查询语言,学习成本极低。而 InfluxDB 的 Flux 语言功能强大,但也需要专门的学习过程。

结论:2025年,你的场景该如何选型?

如果你的战场在工业互联网、车联网、智慧能源等领域,面临着海量设备、长期存储、边云协同和高昂成本的挑战,那么 Apache IoTDB 无疑是你的首选。它在架构、成本、生态和AI集成上的体系化优势,是专门为应对这些挑战而设计的。
如果你的核心诉-求是极致的写入性能和数据导入速度,并且业务以标准SQL查询为主,特别是在金融高频交易或日志分析场景,那么 QuestDB 的性能优势会非常突出。

如果你需要快速启动一个中小型监控或通用IoT项目,希望拥有成熟的社区和丰富的第三方工具支持,InfluxDB 依然是一个强大而稳健的“万金油”选项。

时序数据库的选型没有“银弹”,但通过理解不同产品背后的设计哲学,我们可以找到最匹配自己业务需求的那一把“钥匙”。

零基础如何高效学习大模型?

为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

在这里插入图片描述

【大模型全套视频教程】

教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。

从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。

同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
在这里插入图片描述

深耕 AI 领域技术专家带你快速入门大模型

跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

在这里插入图片描述

【精选AI大模型权威PDF书籍/教程】

精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
在这里插入图片描述

【AI 大模型面试题 】

除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。

【大厂 AI 岗位面经分享(92份)】
图片

【AI 大模型面试真题(102 道)】

图片

【LLMs 面试真题(97 道)】

图片

【640套 AI 大模型行业研究报告】

在这里插入图片描述

【AI大模型完整版学习路线图(2025版)】

明确学习方向,2025年 AI 要学什么,这一张图就够了!
img

👇👇点击下方卡片链接免费领取全部内容👇👇

在这里插入图片描述

抓住AI浪潮,重塑职业未来!

科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。

行业趋势洞察:

  • 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
  • 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
  • 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。

与其观望,不如行动!

面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
在这里插入图片描述

01 为什么分享这份学习资料?

当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。

因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!

我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。

*02 这份资料的价值在哪里?*

专业背书,系统构建:

  • 本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:

    • 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
    • 拥有多项中美发明专利。
    • 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
  • 目前,我有幸与鲁博士共同进行人工智能相关研究。

在这里插入图片描述

内容实用,循序渐进:

  • 资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。

  • 包含丰富的视频教程与实战项目案例,强调动手实践能力。

  • 无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
    在这里插入图片描述在这里插入图片描述在这里插入图片描述

抓住机遇,开启你的AI学习之旅!

在这里插入图片描述
💌

【技术选型】时序数据库选型 时序数据治理是数据治理领域核心、打通IT与OT域数据链路,是工业物联网基石、大数据价值创造的关键、企业管理提升的发动机、是数字化转型的重要支撑。工业企业在生产经营过程中,会运用物联网技术,采集大量的数据并进行实时处理,这些数据都是时序的,而且具有显著的特点,比如带有时间戳、结构化、没有更新、数据源唯一等。时序数据处理应用于智慧城市、物联网、车联网、工业互联网领域的过程数据采集、过程控制,并与过程管理建立一个数据链路,属于工业数据治理的新兴领域。公共安全:上网记录、通话记录、个体追踪、区间筛选; 阅读详情

相关推荐

高效时间序列分析的开源利器:QuestDB

QuestDB:探索数据的深度,加速决策的速度- 精选真开源,释放新价值。

2401_83063795的博客 2338

时序数据库

时序数据是随时间不断产生的一系列数据,简单来说,就是带时间戳的数据。虽然其他数据库也可以在数据规模较小时一定程度上处理时间序列数据,但 TSDB可以更有效地处理随时间推移的数据摄取、压缩和聚合。以车联网场景为例,20000辆车,每个车60个指标,假设每秒采集一次,那么每秒将上报20000 * 60 = 1200000指标值,即120W数据指标值每秒,每个指标值为16字节(假设仅包括8字节时间戳和8字节的浮点数),则每小时将产生64G左右的数据。而实际上每个指标值还会附带标签等额外数据,实际需要存储空间会更大

棉花泡泡糖的博客 2万+

2025时序数据库选型:深入解析IoTDB从主从架构基因到AI赋能的创新之路

在智慧工厂、新能源车、金融市场等场景中,每秒百万级的数据点如潮水般涌来。,以及。面对这些挑战,传统数据库显得力不从心。正是在这样的背景下,Apache IoTDB作为一款原生时序数据库,凭借其独特的架构设计和AI原生能力,在2025年的时序数据库选型中脱颖而出。本文将带你深入解析IoTDB的主从架构基因及其AI赋能创新,通过实际代码示例和架构分析,帮助你在技术选型中做出明智决策。

QQ_778132974的博客 220

主流时序数据库分析及选型

对比了当前主流的时序数据库的优缺点,以供选型时参考。

谬也的博客 2万+

深入解析SPLL单相软件锁相环:从SOGI原理到PI系数调优实践

本文深入解析SPLL单相软件锁相环技术,从SOGI原理到PI系数调优实践,详细介绍了其在数字电源设计中的应用。通过数学推导和实际调试经验,帮助工程师快速掌握锁相环的核心参数计算和优化方法,提升电网相位追踪的精确度和响应速度。

weixin_30316097的博客 384

CXL技术入门:从PCIe到高性能计算的桥梁(附最新2.0协议解析)

本文深入解析CXL技术如何作为PCIe的进化版,成为高性能计算的关键桥梁,特别聚焦CXL 2.0协议的关键升级。从技术架构、三大子协议到典型应用场景,全面介绍CXL在缓存一致性、内存共享等方面的优势,帮助开发者快速掌握这一前沿技术。

wdx012345的博客 730

2025时序数据库选型,从架构基因到AI赋能来解析。

分布式架构成为主流选择,通过分片和复制机制实现水平扩展,满足海量数据写入和查询需求。数据分区策略是时序数据库的关键设计点,常见方式包括按时间范围分区和按标签哈希分区。存储计算分离架构成为标准方案,允许独立扩展计算资源和存储容量,降低总体拥有成本。查询优化器持续进化,能够自动识别最佳执行路径,对混合工作负载做出更智能的响应。存储计算分离架构成为标准方案,允许独立扩展计算资源和存储容量,降低总体拥有成本。查询优化器持续进化,能够自动识别最佳执行路径,对混合工作负载做出更智能的响应。

xUO_kw8w的博客 400

Flowable多数据源实战:从配置到指定Schema的避坑指南

本文详细介绍了Flowable多数据源配置的实战指南,包括基础配置、数据源Bean创建、指定Schema的进阶配置以及常见问题排查。通过具体代码示例和避坑建议,帮助开发者高效实现多租户系统中的工作流引擎集成,特别强调了schema设置和事务管理的注意事项。

weixin_30824599的博客 486

2025时序数据库选型指南从架构基因到AI赋能的深度解析

本文深入探讨2025年时序数据库的选型策略,从核心架构基因(如LSM树与B+树对比、分布式设计)出发,分析其对性能的影响,并扩展到AI赋能场景(如实时预测、智能压缩)。通过实际案例和性能指标,帮助读者在数据爆炸时代做出明智选择,确保系统可扩展性、低延迟和高效率。

ztt123654的博客 922

电磁兼容(EMC):一文读懂过电应力(EOS)

过电应力(EOS)是指元器件承受的电流或电压应力超过其允许的最大范围。产品的电磁兼容(EMC)失效的一种常见模型为过电应力(EOS),也是电子产品失效的最常见的情况之一。过电应力基本与半导体器件相关,EOS事件包括有:静电放电(ESD)、雷击、系统瞬态、电磁脉冲、充电等。本文将详细讨论一下产品设计中如何关注EOS设计。

linkking27的博客 6486

【OpenClaw】Edict 三省六部制部署与启动

文章摘要 本文聚焦Edict系统的本地部署与启动,提供三种安装方式:Docker快速体验、macOS/Linux原生安装和Windows生产仿真。核心目标是让用户能够独立完成系统启动和基础问题排查,确保看板、后端服务、同步脚本和网关正常运行。文章强调环境检查的重要性,并给出具体验收标准:浏览器能访问看板页面(http://127.0.0.1:7891)和接口返回JSON数据。同时提供一键启动/停止脚本和常见问题处理建议,帮助用户快速验证部署结果。配套系列教程涵盖部署启动、使用实战、二次开发和封装版本使用等内

Mr数据杨 2904

跨端边云时序数据管理新范式:Apache IoTDB 的 DB+AI 融合之道

《时序数据管理的范式革命:IoTDB在端边云架构中的创新实践》 随着物联网设备激增,时序数据呈现高吞吐、高维度、高时效特征,传统时序数据库面临架构割裂、资源错配和智能断层的痛点。Apache IoTDB作为全球唯一端到云全覆盖的时序数据库,通过三层统一架构(端侧200KB轻量引擎、边缘流式计算、云端分布式扩展)和DB+AI深度融合,实现从数据采集到智能决策的无缝衔接。

枫叶丹4的博客 1万+

YOLO26涨点改进 | 检测头Head创新改进篇 | 利用RFAConv感受野注意力卷积改进YOLO26检测头,RFAHead感受野注意力检测头,助力小目标检测高效涨点

YOLO26作为轻量化目标检测模型的新一代标杆,凭借高效的Backbone与Neck结构,在实时检测场景中表现突出,但原生检测头仍存在核心痛点——感受野固定、小目标特征感知薄弱、多尺度目标适配不足,导致在小目标密集、复杂背景遮挡等场景中漏检率偏高、定位精度不足。

qq_36130719的博客 170

【数据库】时序数据库科学选型,以IoTDB构筑大数据时代的时序数据底座

摘要: 时序数据管理在工业物联网等场景需求激增,Apache IoTDB凭借物联网原生架构成为理想选择。其核心优势包括:高吞吐写入、高效压缩存储(TSFile格式)、低延迟查询及灵活部署,显著降低TCO。IoTDB产品体系涵盖时序数据库、TsFile存储格式及AINode智能分析引擎,支持端边云协同。应用场景覆盖能源电力、航空航天等,通过实时数据同步、边缘计算等特性满足工业需求,助力企业数字化转型。 (98字)

杰西笔记 2万+

高空抛物监控系统:基于YOLOv8的轨迹追踪与可视化系统

本文详细介绍了一种基于YOLOv8深度学习模型的高空抛物监控系统,该系统能够实时检测并追踪高层建筑抛掷物的运动轨迹。文章包含完整的系统设计思路、算法实现细节、数据集构建方法以及基于PyQt5的可视化界面开发过程。我们提供了完整的Python实现代码,并讨论了系统的性能优化策略和实际部署考量。此外,我们还推荐了几个公开可用的高空抛物数据集,并详细分析了系统的应用前景和技术挑战。

YOLO 447

QCM2290 PM-3 如何让mirco-usb支持关机充电

PM4125-3插入type-C触发开机进入关机充电的CC脚中断条件是否可以软件上屏蔽, 做到只通过VBUS中断即可触发进入关机充电模式,达到和PM4125-2的效果一样只要插入micro USB 就可以触发进入关机充电模式。硬件团队提议修改寄存器 SCHG_L_MISC_SYSOK_CFG 0x164A bit[4] 目前修改如下 — a/BOOT.XF.4.1/boot_images/QcomPkg/Library/PmicLib/target/Agatti_pmCocos/psi/pm_confi

墨染天玑的博客 444

【数据库】时序数据库选型指南:从大数据视角看IoTDB的核心优势

摘要 时序数据库是工业物联网和智能制造领域的关键技术,面对海量时序数据的高频采集、多维度管理和高效存储需求,传统数据库面临性能瓶颈。Apache IoTDB及其商业版TimechoDB通过创新的数据模型、高效的存储压缩(15-20倍压缩比)和卓越的读写性能(单机150万点/秒写入),成为理想解决方案。其端-边-云协同架构支持全场景部署,并与工业协议和大数据生态无缝集成,显著降低存储与运维成本。在实际应用中,IoTDB已在能源电力和智能制造等领域验证其价值,相比InfluxDB和TimescaleDB等方案更

杰西笔记 6万+

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

2025时序数据库:AI赋能与选型指南,CSS中的伪类和伪元素。

时序数据的高吞吐写入和压缩效率是关键。LSM-Tree(如InfluxDB)和列式存储(如TimescaleDB)是主流方案,2025年可能出现混合存储引擎,结合冷热数据分层优化成本。SQL兼容(如PromQL转SQL)降低迁移成本,但原生时序查询语法(如Flux)更贴近业务。物联网高频写入场景侧重压缩比(如InfluxDB的TZST压缩算法),金融场景需兼容SQL审计(TimescaleDB的PostgreSQL生态)。评估预置模型丰富度(如是否支持多变量协同分析)和模型再训练接口,避免被厂商锁定。

vjzb1xfm的博客 465

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

时序数据库架构解析与2025趋势,Node.js 常用工具。

采用LSM-Tree(Log-Structured Merge-Tree)结构的数据库如InfluxDB、TimescaleDB,通过追加写入和定期合并优化写性能。分片策略通常基于时间范围(如Prometheus的TSDB分块)或哈希分区(如VictoriaMetrics),结合一致性哈希实现动态扩缩容。选型决策需结合具体场景的写入负载模式(突发性/平稳性)、查询复杂度(点查/全盘扫描)及长期运维成本(存储增长率)。要求亚毫秒级延迟,可测试DolphinDB的内存引擎或kdb+的列式存储。

rh3shizs的博客 331

主流数据库技术全景解析:从架构特性到业务实践(2025版)

数据管理技术正经历前所未有的变革。从1970年代关系型数据库的诞生,到2010年代NoSQL的爆发,再到近年向量数据库的兴起,每一次技术突破都源于业务场景的深度驱动。2025年的数据库市场呈现出明显的专业化分工:关系型数据库坚守核心事务场景,NoSQL主导非结构化数据,时序数据库垄断物联网领域,而向量数据库则成为AI时代的基础设施。据Gartner预测,到2025年,70%的企业将采用至少三种以上数据库类型构建混合架构,单一数据库"一统天下"的时代已彻底终结。

qq_61112764的博客 3174

时序数据库选型指南:从大数据视角看IoTDB的核心优势

在数据主权与技术自主可控成为国家战略的背景下,Apache IoTDB凭借其开源生态、工业场景深度适配和持续创新的能力,已成为企业时序数据管理的首选方案。其不仅解决了存储成本、查询性能等现实问题,更为企业构建了面向未来的数据基础设施。立即行动:访问IoTDB官网下载最新版本,或通过Timecho企业版获取专业支持,开启您的时序数据管理新篇章。下载链接企业版官网链接。

可涵的博客 2万+

时序数据库选型指南:Apache IoTDB为何成为工业物联网首选?

时序数据库选型是数字化转型的关键决策。通过本文分析可见,IoTDB凭借其原生物联网设计、卓越的存储效率、完整的生态体系,已成为工业场景的理想选择。特别是其商业版TimechoDB提供的企业级特性,如双活部署、多级存储、可视化工具等,能够进一步降低运维复杂度,保障生产系统稳定运行。建议企业在实际选型中。

可涵的博客 2万+

2025时序数据库:架构与AI技术前瞻,精读C++20设计模式:结构型设计模式:装饰器模式。

面向时序的查询语言(如InfluxQL、PromQL)需支持降采样(Downsampling)、时间窗口聚合(Tumbling/Hopping Window)。内存化计算(如Apache Druid的实时节点)和预聚合(如TimescaleDB的连续聚合)是性能加速的核心手段。基于机器学习的压缩算法(如Facebook的Zstandard改进版)可针对不同时序模式(周期型、稀疏型)动态调整压缩率,存储空间节省可达50%以上。强化学习(RL)驱动的查询计划选择,根据历史查询模式自动调整索引策略。

2501_93989269的博客 305
上一篇: 为什么人工智能用Python?
下一篇: 飞算JavaAI开发在线图书借阅平台全记录:从0到1的实践指南
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值