深入理解RAG中的嵌入模型Embedding Model

2、embedding模型 NLP 阅读详情
AI摘要

本文深入探讨了RAG引擎中嵌入模型(Embedding Model)。先介绍Embedding是将离散非结构化数据转为连续向量的技术,接着说明Embedding Model可将词语等转换成数字向量,用于语义搜索等NLP任务。还阐述其在RAG引擎中的作用及工作流,最后分享了AI大模型学习资料。

在当前流行的RAG引擎(例如RAGFlow、Qanything、Dify、FastGPT等)中,嵌入模型(Embedding Model)是必不可少的关键组件。在RAG引擎中究竟扮演着怎样的角色呢?本文笔者进行了总结,与大家分享~

什么是Embedding?

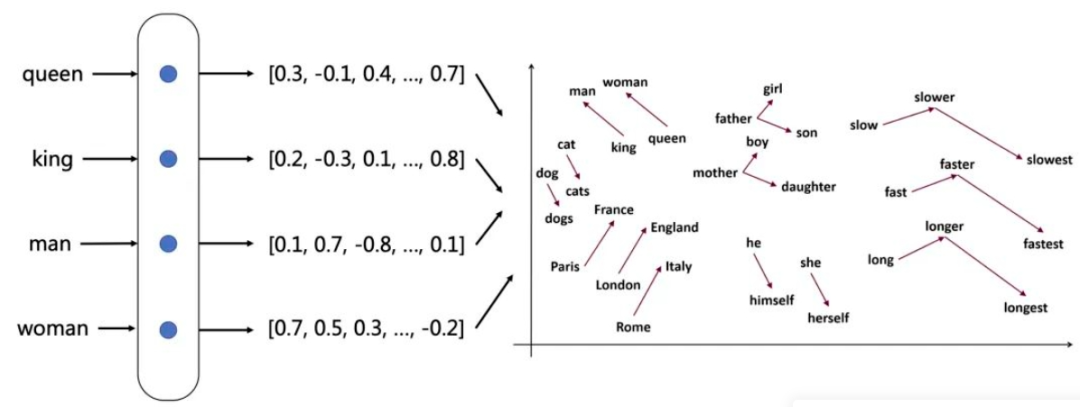
在学习嵌入模型之前,我们需要先了解什么是Embedding。简单来说,Embedding是一种将离散的非结构化数据(如文本中的单词、句子或文档)转换为连续向量的技术。

在自然语言处理(NLP)领域,Embedding通常用于将文本映射为固定长度的实数向量,以便计算机能够更好地处理和理解这些数据。每个单词或句子都可以用一个包含其语义信息的向量来表示。

Embedding常用于将文本数据映射为固定长度的实数向量,从而使计算机能够更好地处理和理解这些数据。每个单词或句子都可以用一个包含其语义信息的实数向量来表示。
img

以“人骑自动车”为例,在计算机中,单词是以文字形式存在的,但计算机无法直接理解这些内容。Embedding的作用就是将每个单词转化为向量,例如:

  • “人”可以表示为 [0.2, 0.3, 0.4]
  • “骑”可以表示为 [0.5, 0.6, 0.7]
  • “自行车”可以表示为 [0.8, 0.9, 1.0]

通过这些向量,计算机可以执行各种计算,比如分析“人”和“自行车”之间的关系,或者判断“骑”这个动作与两者之间的关联性。

此外,Embedding还可以帮助计算机更好地处理和理解自然语言中的复杂关系。例如:

  • 相似的词(如“人”和“骑手”)在向量空间中会比较接近。
  • 不相似的词(如“人”和“汽车”)则会比较远。

「那么为什么需要向量呢?」

因为计算机只能处理数字,无法直接理解文字。通过将文本转换为向量,相当于为数据分配了一个数学空间中的“地址”,使计算机能够更高效地理解和分析数据。

什么是Embedding Model?

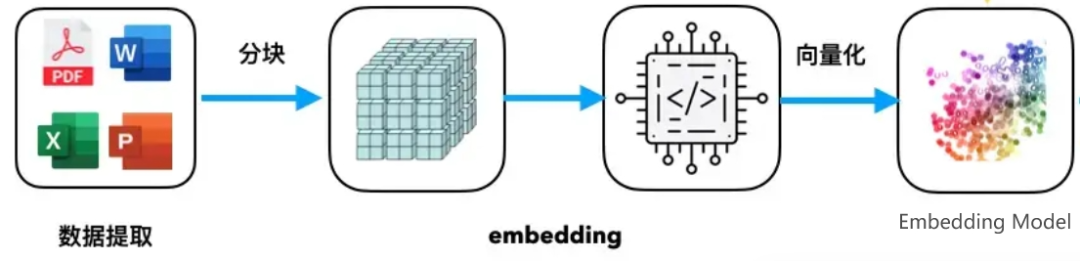
在自然语言处理(NLP)中,嵌入模型(Embedding Model) 是一种将词语、句子或文档转换成数字向量的技术。它通过将高维、离散的输入数据(如文本、图像、声音等)映射到低维、连续的向量空间中,使得计算机能够更好地理解和处理这些数据。
img

Embedding Model就像是给每个词或句子分配一个独特的“指纹”,这个“指纹”能够在数学空间中表示这个词或句子的含义。具体来说,这种模型将每个词语或句子转换成一个固定长度的数字向量。通过这种方式,计算机可以对文本进行各种数学计算,例如:

  • 比较词语的相似性:通过计算两个词语向量之间的距离(如余弦相似度),可以判断它们在语义上的相似程度。
  • 分析句子的意义:通过对句子中的所有词语向量进行聚合(如平均值或加权和),可以得到整个句子的向量表示,并进一步分析其语义信息。

这种技术在许多NLP任务中具有重要意义,以下是几个典型的应用示例:

  • 语义搜索:通过计算查询向量与文档库中各文档向量的相似度,找到与查询最相关的文档或段落。例如,用户输入“如何制作披萨?”,系统会返回最相关的烹饪指南。
  • 情感分析:判断一段文本的情感倾向(如正面、负面或中性)。例如,对于一篇产品评论“这款手机性能出色,但电池续航一般”,系统可以分析出该评论整体上是正面的,但也存在一些负面因素。
  • 机器翻译:将一种语言的文本转换为另一种语言。例如,用户输入“我喜欢猫”,系统将其转换为对应的英文翻译“I like cats”。
  • 问答系统:根据用户的问题,从知识库中检索相关信息并生成回答。例如,用户提问“太阳有多大?”,系统通过嵌入模型找到相关天文学文档,并生成详细的回答。
  • 文本分类:将文本归类到预定义的类别中。例如,新闻文章可以被自动分类为政治、体育、科技等不同类别,基于其内容的向量表示。
  • 命名实体识别(NER):识别文本中的特定实体(如人名、地名、组织名等)。例如,在一段文字“李华在北京大学学习”中,系统可以识别出“李华”是人名,“北京大学”是组织名。

Embedding Model的作用

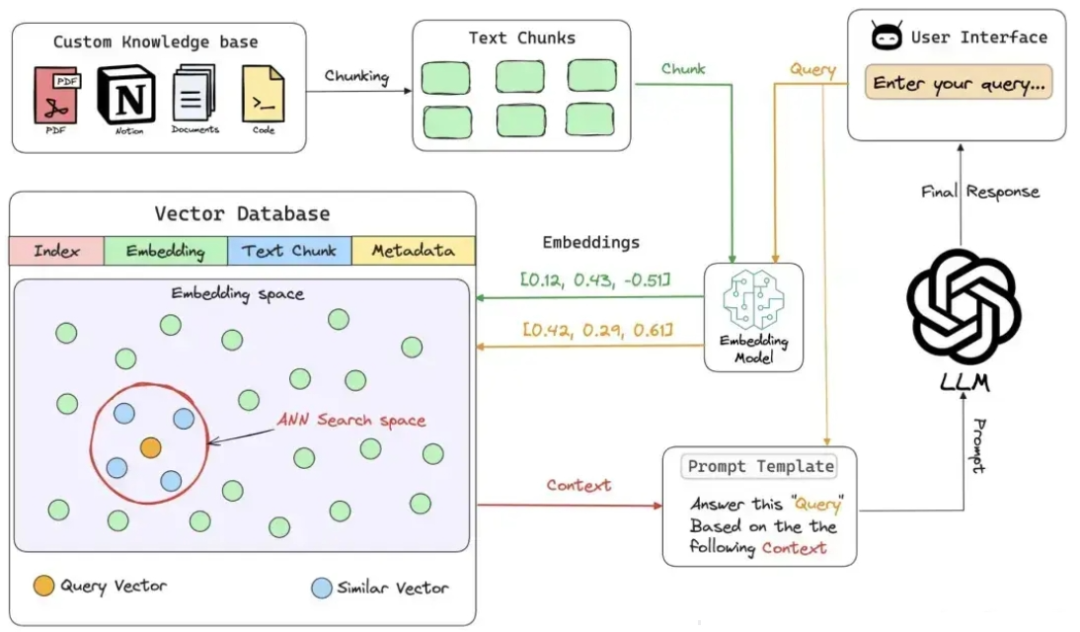
在RAG引擎中,嵌入模型(Embedding Model) 扮演着至关重要的角色。它用于将文本转换为向量表示,以便进行高效的信息检索和文本生成。以下是Embedding Model在RAG引擎中的具体作用和示例:

  1. 文本向量化

    • 作用:将用户的问题和大规模文档库中的文本转换为向量表示。
    • 举例:在RAG引擎中,用户输入一个问题,如“如何制作意大利面?”,Embedding Model会将这个问题转换为一个高维向量。
  2. 信息检索

    • 作用:使用用户的查询向量在文档库的向量表示中检索最相似的文档。
    • 举例:RAG引擎会计算用户问题向量与文档库中每个文档向量的相似度,然后返回最相关的文档,这些文档可能包含制作意大利面的步骤。
  3. 上下文融合

    • 作用:将检索到的文档与用户的问题结合,形成一个新的上下文,用于生成回答。
    • 举例:检索到的关于意大利面的文档会被Embedding Model转换为向量,并与问题向量一起作为上下文输入到生成模型中。
  4. 生成回答

    • 作用:利用融合了检索文档的上下文,生成模型生成一个连贯、准确的回答。
    • 举例:RAG引擎结合用户的问题和检索到的文档,生成一个详细的意大利面制作指南作为回答。
  5. 优化检索质量

    • 作用:通过微调Embedding Model,提高检索的相关性和准确性。
    • 举例:如果RAG引擎在特定领域(如医学或法律)中使用,可以通过领域特定的数据对Embedding模型进行微调,以提高检索的质量。
  6. 多语言支持

    • 作用:在多语言环境中,Embedding Model可以处理和理解不同语言的文本。
    • 举例:如果用户用中文提问,而文档库包含英语内容,Embedding Model需要能够处理两种语言的文本,并将它们转换为统一的向量空间,以便进行有效的检索。
  7. 处理长文本

    • 作用:将长文本分割成多个片段,并为每个片段生成Embedding,以便在RAG引擎中进行检索。
    • 举例:对于长篇文章或报告,Embedding Model可以将其分割成多个部分,每个部分都生成一个向量,这样可以在不损失太多语义信息的情况下提高检索效率。

通过以上几点,Embedding Model在RAG引擎中提供了一个桥梁,连接了用户查询和大量文本数据,使得信息检索和文本生成成为可能。如下图所示,Embedding Model正处于整个RAG系统的中心位置。
img

RAG引擎中的工作流

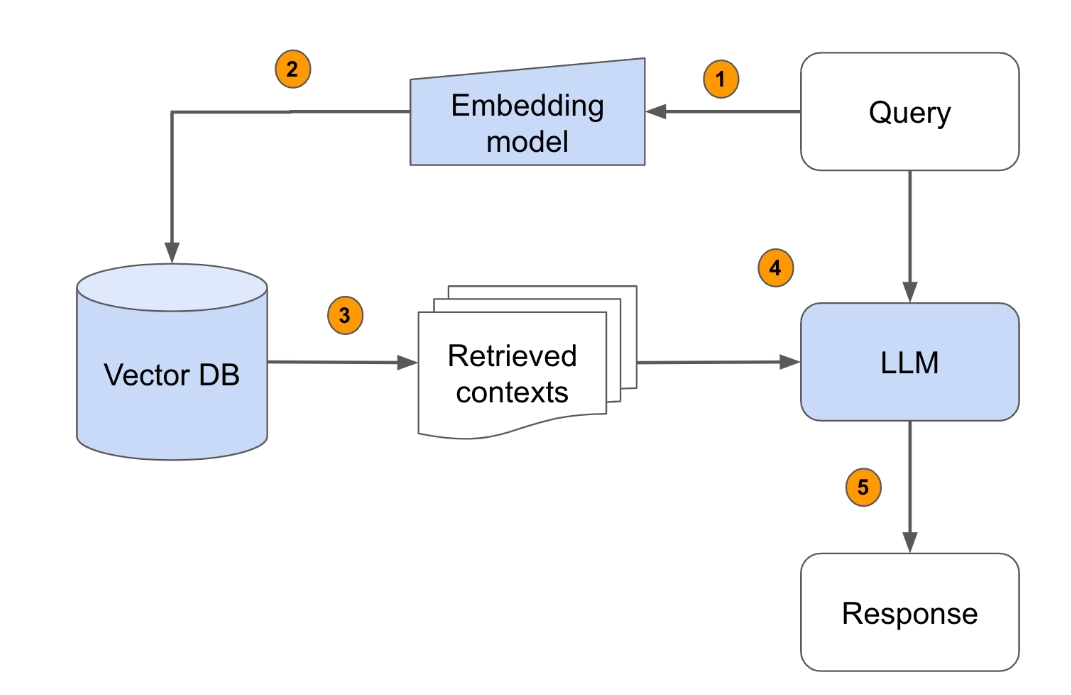
以下是一个RAG引擎中工作流的示意图,此流程基本与各大RAG引擎相匹配。虽然各个不同的RAG引擎内部算法可能有所区别,但整体工作流程大同小异。
img

「流程说明」

  1. 查询嵌入化:将用户输入的查询传递给嵌入模型,并在语义上将查询内容表示为嵌入的查询向量。
  2. 向量数据库查询:将嵌入式查询向量传递给向量数据库。
  3. 检索相关上下文:检索前k个相关上下文——通过计算查询嵌入和知识库中所有嵌入块之间的距离(如余弦相似度)来衡量检索结果。
  4. 上下文融合:将查询文本和检索到的上下文文本传递给对话大模型(LLM)。
  5. 生成回答:LLM 将使用提供的内容生成回答内容。

如何零基础入门 / 学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

read-normal-img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

Embedding 模型的选择和微调 评估机器生成摘要的质量。 阅读详情

相关推荐

【AI学习】二、 嵌入模型(Embedding Models)和 向量数据库(Vector Databases)

嵌入模型是将高维数据(如文本、图像、音频等)映射为低维稠密向量(嵌入向量)的算法,用于捕捉数据的语义或特征关联,便于计算机理解和处理。向量数据库是专门存储和检索高维向量数据的数据库,支持基于向量相似度(如余弦距离、欧氏距离)的快速查询,广泛应用于推荐系统、语义搜索、图像识别等场景。

qq_21202769的博客 2344

Spring AI Embedding模型概念、源码分析和使用示例

Embedding模型是指将高维度的数据(例如文字、图片、视频)映射到低维度空间的过程。简单来说,embedding向量就是一个N维的实值向量,它将输入的数据表示成一个连续的数值空间中的点。嵌入就相当于给文本穿上了“数字化”的外衣,目的是让机器更好的理解和处理。

2401_85378759的博客 2592

深入理解Embedding与Transformer:从原理到RAG系统优化实践

Embedding技术作为自然语言处理的核心基础,通过将文本映射为高维向量,实现了对语义信息的数学化表示。其底层原理依赖于Transformer架构中的自注意力机制,该机制能够动态计算词元间的关联权重,从而捕获复杂的上下文依赖关系。这种技术价值在于为语义相似度计算、信息检索等任务提供了高效、可度量的解决方案,广泛应用于搜索、推荐、问答等场景。在检索增强生成(RAG)系统中,Embedding模型的质量直接决定了检索精度,而Transformer架构同时承担了编码(理解)与生成(创作)的双重角色。理解Embe

weixin_33843409的博客 446

大模型 | 一文读懂 RAG 中的 Embedding Model

在当今人工智能的浪潮中,RAG(检索增强生成)技术大放异彩,像是 RAGFlow、Qanything、Dify、FastGPT 等 RAG 引擎,逐渐走进大家的视野。在这些强大的 RAG 引擎背后,有一个关键组件起着不可或缺的作用,它就是嵌入模型(Embedding Model)。

star_nwe的博客 1800

从原理到实战:Embedding模型如何驱动RAG系统实现精准语义检索

在人工智能与自然语言处理领域,将非结构化的文本数据转化为机器可理解的数值表示,是实现语义理解的基础。其核心原理在于通过深度神经网络(如Transformer的Encoder部分)对文本进行上下文编码,将高维、稀疏的词语映射为低维、稠密的语义向量。这一过程,即encoder得到embedding,使得语义相近的文本在向量空间中距离更近。该技术的核心价值在于为海量文本信息建立了可计算、可比较的数学基础,从而支撑起智能搜索、推荐系统、文本分类等上层应用。尤其在当前热门的检索增强生成(RAG)架构中,高质量的文本向

weixin_33919950的博客 320

【AI应用开发】RAG系列(2)——嵌入模型(Embedding Model)

嵌入模型(Embedding Model)是一种将离散的、高维的数据(如单词、句子、整个文档)转换为连续的、低维的向量表示(即嵌入向量,Embedding Vector)的数学模型。

赶紧的博客 429

深入理解RAG中的嵌入模型Embedding Model,收藏这一篇就够了!!

在学习嵌入模型之前,我们需要先了解什么是Embedding。简单来说,Embedding是一种将离散的非结构化数据(如文本中的单词、句子或文档)转换为连续向量的技术。 在自然语言处理(NLP)领域,Embedding通常用于将文本映射为固定长度的实数向量,以便计算机能够更好地处理和理解这些数据。每个单词或句子都可以用一个包含其语义信息的向量来表示。

bugyinyin的博客 2098

基于openEuler配置LAMP,部署WordPress

openEuler 基于OpenEular操作系统部署WordPress,必须包含以下内容: OpenEular的安装与基本配置。 基于SSH远程管理方式开展操作。 部署LAMP环境。 部署WordPress软件。 提供个人网站服务,并通过浏览器测试应用。 简要讲授相关知识与原理。 cd /etc/yum.repos.d 欧拉系统安装后,没有配置yum源,我们需要重新配置。 [root@localhost yum.repos.d]# ls -l 总用量 4 -rw-r--r--

Axiayouqiaomu的博客 6082

深入理解RAG中的嵌入模型Embedding Model,看完这一篇你就懂了!!

在当前流行的RAG引擎(例如RAGFlow、Qanything、Dify、FastGPT等)中,嵌入模型(Embedding Model)是必不可少的关键组件。在RAG引擎中究竟扮演着怎样的角色呢?

2401_85325557的博客 1452

飞牛Docker部署Zerotier后无法访问?三步搞定SSH权限配置!

本文详细解析了在飞牛NAS上通过Docker部署Zerotier后无法访问的常见问题及解决方案。重点介绍了SSH权限配置、tun模块加载和Docker容器权限设置等关键步骤,帮助用户快速解决虚拟网络接口的权限问题,确保Zerotier节点间的正常通信。

qq_27496129的博客 801

光伏逆变器在环测试解决方案

光伏行业是利用太阳能光辐射将其转化为可用电能的行业。近年来,为应对气候变化和能源安全等挑战,全球对清洁能源的需求不断增长。太阳能作为最具潜力和可再生的能源之一,被视为替代传统化石能源的重要选择,光伏行业因此得到了迅猛发展,并在全球范围内得到了广泛应用。许多国家和地区都将光伏技术作为关键的能源发展方向。尤其是在新兴和发展中国家,光伏发电具有巨大的增长潜力,将成为未来市场竞争的重点。随着规模化生产的推进,光伏组件的制造成本不断降低。

shiwei0813的博客 962

深入理解RAG:什么是Embedding Model?Embedding Model的作用,RAG引擎中的工作流

在学习嵌入模型之前,我们需要先了解什么是Embedding。简单来说,Embedding是一种将离散的非结构化数据(如文本中的单词、句子或文档)转换为连续向量的技术。在自然语言处理(NLP)领域,Embedding通常用于将文本映射为固定长度的实数向量,以便计算机能够更好地处理和理解这些数据。每个单词或句子都可以用一个包含其语义信息的向量来表示。Embedding常用于将文本数据映射为固定长度的实数向量,从而使计算机能够更好地处理和理解这些数据。每个单词或句子都可以用一个包含其语义信息的实数向量来表示。

老皮的博客 997

修复ASUS in WinRE教程

暑假入手了天选三,发现是win11家庭版,本来想着家庭版将就一下无所谓,结果在使用的过程中发现相较于专业版真的是不能比,于是自己就重装了系统,发现ASUS in WinRE入口不见了,折腾半天最后成功修复。

weixin_46202629的博客 1万+

深入理解嵌入模型(Embedding Model):AI 语义世界的基石

在早期的搜索引擎中,系统只能根据关键词匹配查找结果。例如输入“数据库安装”,它会检索所有包含“数据库”和“安装”的页面,但无法理解你真正的意图。如今的智能问答系统(如 ChatGPT、Claude、Gemini 等)却能明白:“数据库安装” 可能与 “MySQL 部署”、“集群初始化”、“Kubernetes 挂载” 意义相关。这种“理解语义而非字面”的能力,正是由一种关键技术——嵌入模型(Embedding Model)——提供的。简单来说,

爱死亡机器人 2183

工程创新训练大赛智能网联车辆赛道LKA+自动驾驶9000+分数分案例

/获取主车在主车路径上的ST坐标。if (status == AVPStatus::eForwarding) // approaching the parking space接近阶段。if (status == AVPStatus::eForwarding) // approaching the parking space接近阶段。if (status == AVPStatus::eForwarding) // approaching the parking space接近阶段。

handsomeboyou的博客 1134

ROS2与Gazebo协同实现多机器人避障仿真

本文详细介绍了如何利用ROS2与Gazebo协同搭建多机器人避障仿真环境。通过创建SDF机器人模型、编写多机器人启动文件以及集成基础避障算法,构建了一个低成本、高效率的虚拟测试平台,为AGV编队、机器人集群等项目的算法验证与迭代提供了完整解决方案。

weixin_29065659的博客 299

深入理解 Text Embedding Models 在智能检索与语义理解中的作用

在当今的人工智能时代,文本嵌入(Text Embedding)已成为自然语言处理(NLP)和知识增强生成(RAG, Retrieval-Augmented Generation)系统的关键技术之一。无论是搜索引擎的语义检索、问答系统的上下文匹配,还是推荐系统中的文本相似度计算,背后几乎都离不开文档向量化(Document Vectorization)这一过程。本文将系统讲解文本嵌入模型的概念、原理、分类、实际应用及主流实现方式,并结合工程实践探讨如何在现代 AI 应用中高效地构建和利用嵌入模型。

cooldream2009的博客 1347

YOLOv11改进 | Neck篇 | 独创HFPN利用分层特征融合块HFFB模块融合多层次特征改进yolov11(全网独家创新)

本文给大家带来的最新改进是利用分层特征融合块HFFB创新yolov11的neck部分我称之为HFPN,这个模块可以融合局部特征、全局特征、中间特征将三种特征融合在一起辅助yolov11进行检测,经过我的设计分为三种可以针对大目标、小目标、标准目标的检测方式均不同,大家可以根据自己的数据集进行不同的选择,本文的内容为我独家创新。YOLOv11改进系列专栏——本专栏持续复习各种顶会内容——科研必备目录一、本文介绍二、原理介绍三、核心代码四、添加方法4.1 修改一4.2 修改二4.3 修改三4.4 修改四。

Snu77的博客 5219
上一篇: “套壳”的 Manus,告诉我们什么是真正的 AI Agent?
下一篇: AI Agent 的「GPT 时刻」,Manus 炸醒整个 AI 圈!
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值