手把手教你喂养 DeepSeek 本地模型

本地部署DeepSeek大模型+数据投喂教程 在D盘新建一个文件夹命名为Ollama,然后打开系统环境变量,新建变量名:OLLAMA_MODELS 变量值:D:\Ollama,设置完成后重启电脑。deepseek-r1模型下载完成后(提示success即是下载完成),在CMD新窗口中输入命令ollama pull nomic-embed-text回车下载nomic-embed-text嵌入式模型(后面做数据投喂步骤会用到)。本地安装到D盘,点击下一步,安装中…,安装到提示下载ollama_lib.zip可点击取消,不然要等很久时间才能下载完成。 阅读详情
AI摘要

本文详细介绍了如何下载、配置和喂养DeepSeek本地模型,包括基本概念科普、软件下载、模型配置、个人数据喂养演示以及喂养效果对比和缺陷分析。通过实际操作,展示了在个人电脑上部署和优化大模型的过程,并讨论了学习大模型技术的必要性和学习路线。

下面就开始!

  • 1.基本概念科普
  • 2.下载 AnythingLLM 软件
  • 3.配置 nomic-embed-text 模型
  • 4.演示如何正确喂养个人数据
  • 5.喂养前后效果对比和缺陷

1.基本概念科普

这里先给AI小白简单科普一下基本概念,便于更好地理解本文中的动手操作。

为什么我这里叫“喂养”DeepSeek 本地模型,是因为大模型再强大也有它天然的局限性,比如训练数据不可能包含你的私域数据,而打造自己的本地私域知识库,就需要检索这些数据,具体采用的是RAG(检索增强生成)方法。

RAG,英文全称是Retrieval-Augmented Generation。简单来讲,采用RAG就需要把你的私域数据向量化,然后存储到向量数据库中,支持向量检索配合LLM大模型一起提供更专业的回复。

2.下载 AnythingLLM 软件

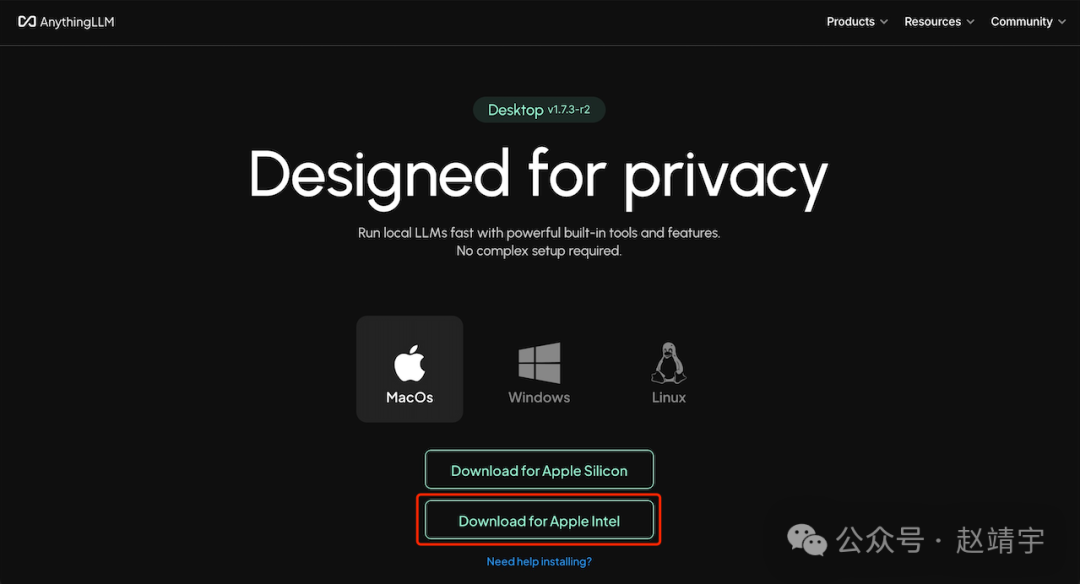
官方网站:

  • https://anythingllm.com/desktop

下载符合你系统平台的软件,我这里是Apple Intel:
img

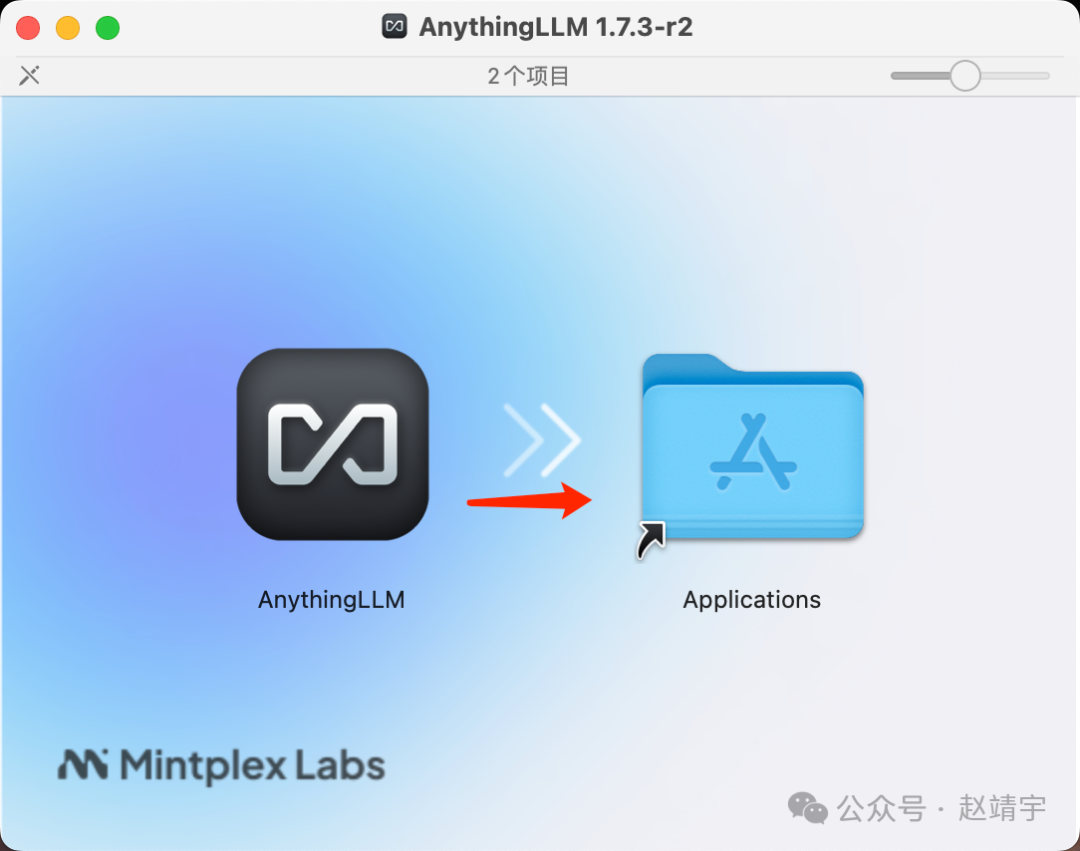
下载好的AnythingLLMDesktop.dmg,dmg文件约300M多点,双击安装并拖至应用程序中:
img

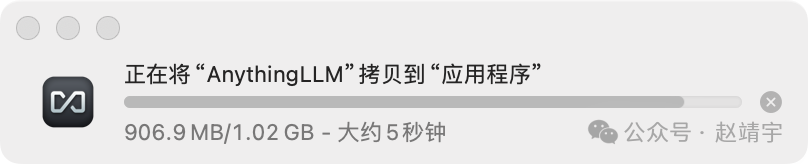
拖动时可以看到AnythingLLM安装程序有1G大小:

img

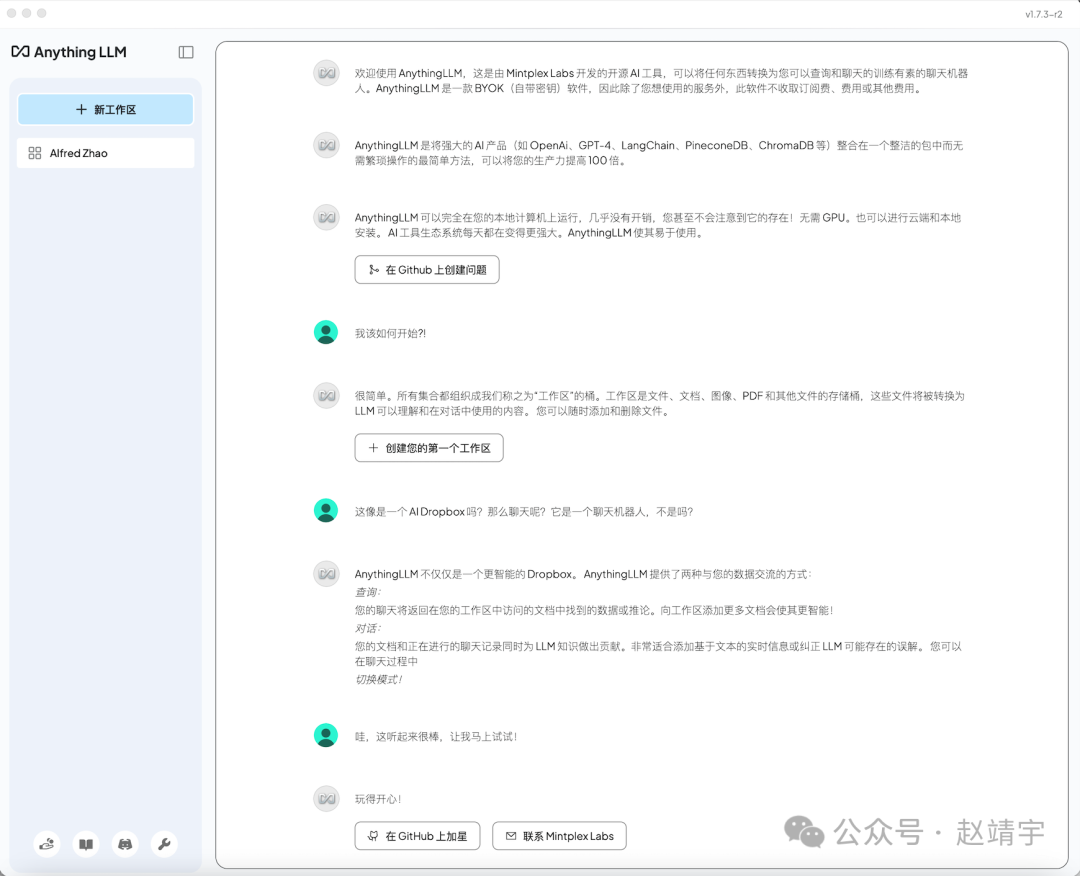
然后打开AnythingLLM,欢迎界面如下:

img

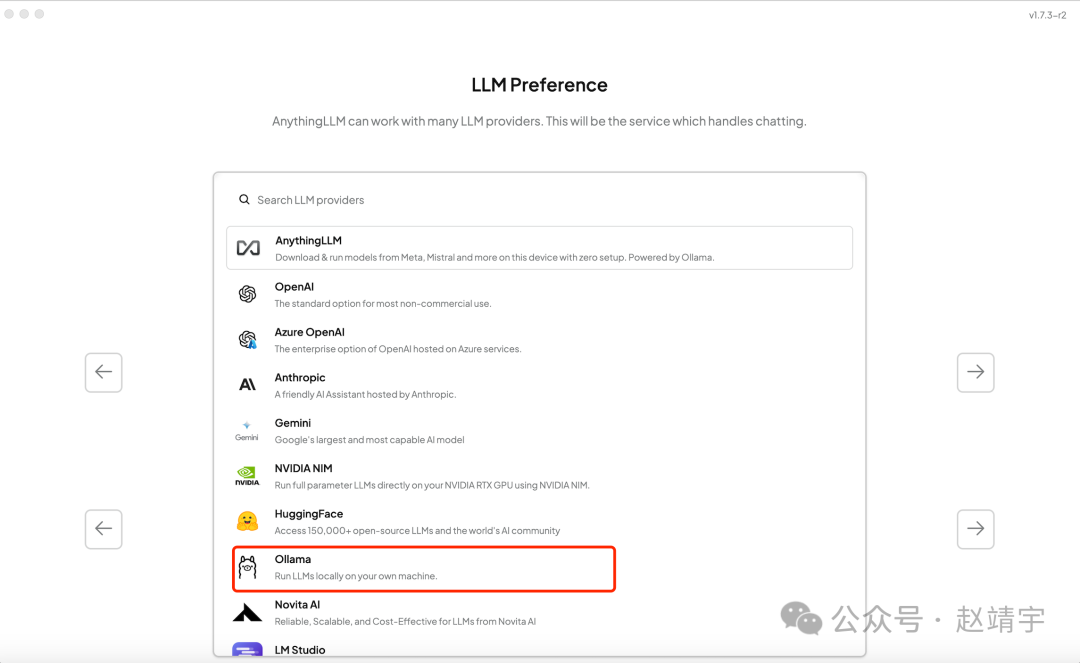
点击Get Started配置首选LLM,这里我们选择上一篇文章已经教大家配置好的Ollama:
img

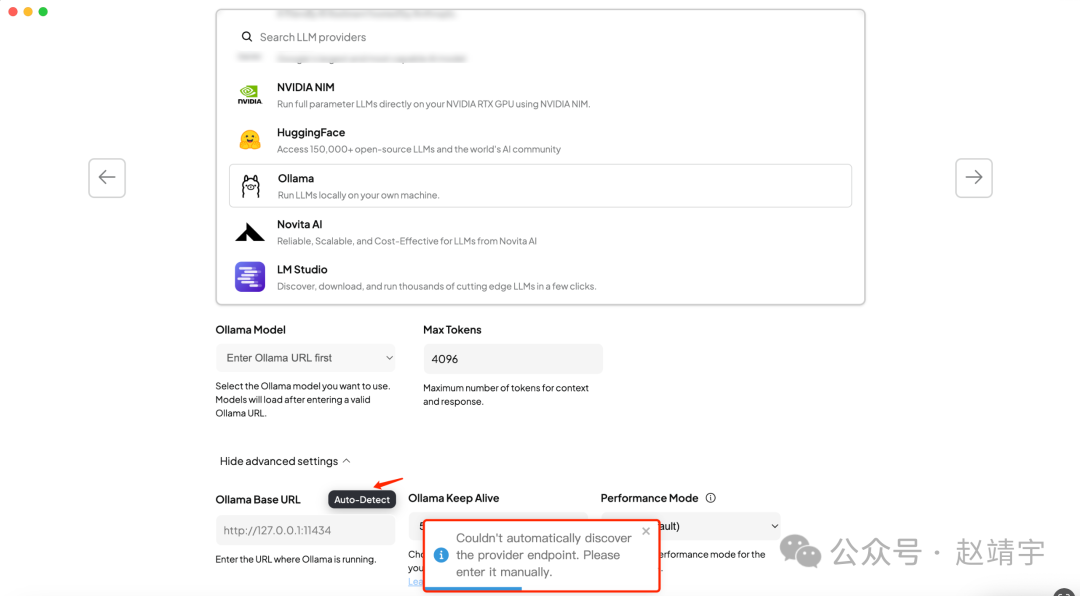
这里注意,需要确保你的Ollama正常运行,否则会报错找不到provider endpoint,如下图:
img

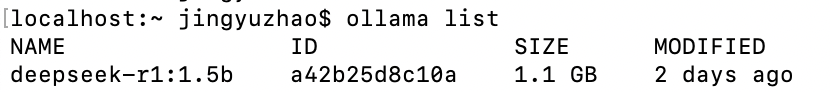
此时就需要检查你的ollama以及可用的本地模型:

img

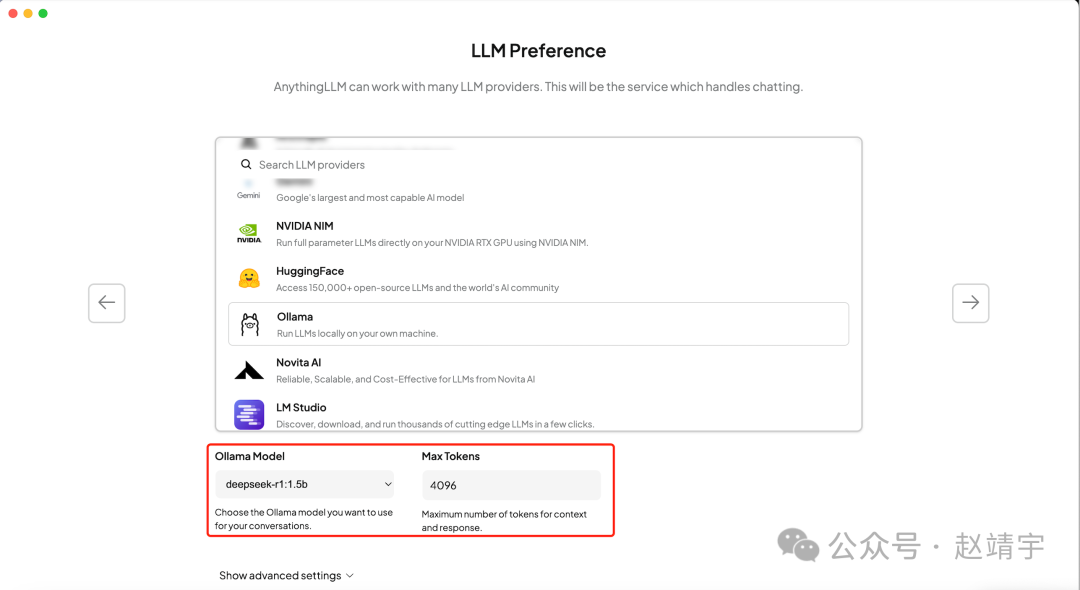
修复好之后就可以看到AnythingLLM已经可以正确识别到本地部署的模型:
img

之后可以看到LLM模型选择了Ollama,Embedding默认是AnythingLLM的Embedder,Vector Database默认是LanceDB:
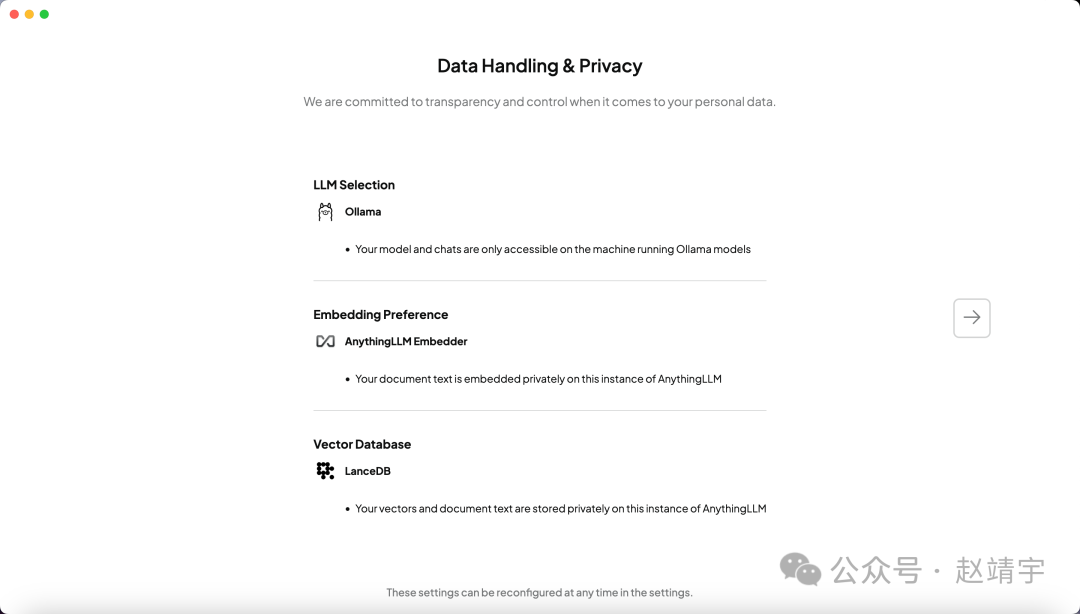
img

为了不给新手加难度,Embedding和Vector Database我这里都没有进行修改,直接先进入到下一步,是一个survey,笔者是个i人,实在没啥可说的,这里直接跳过了:
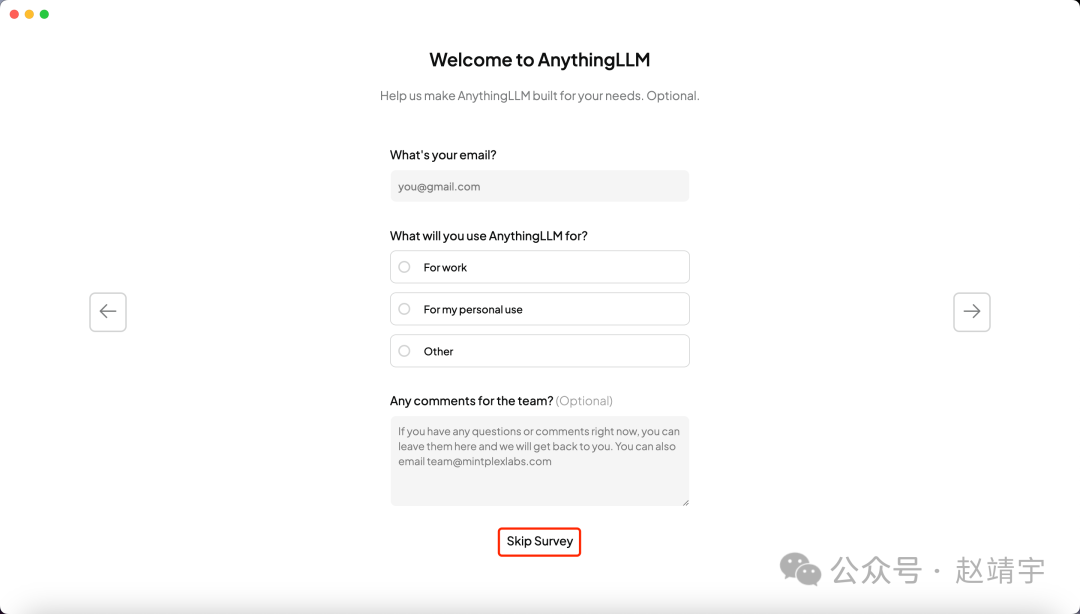
img

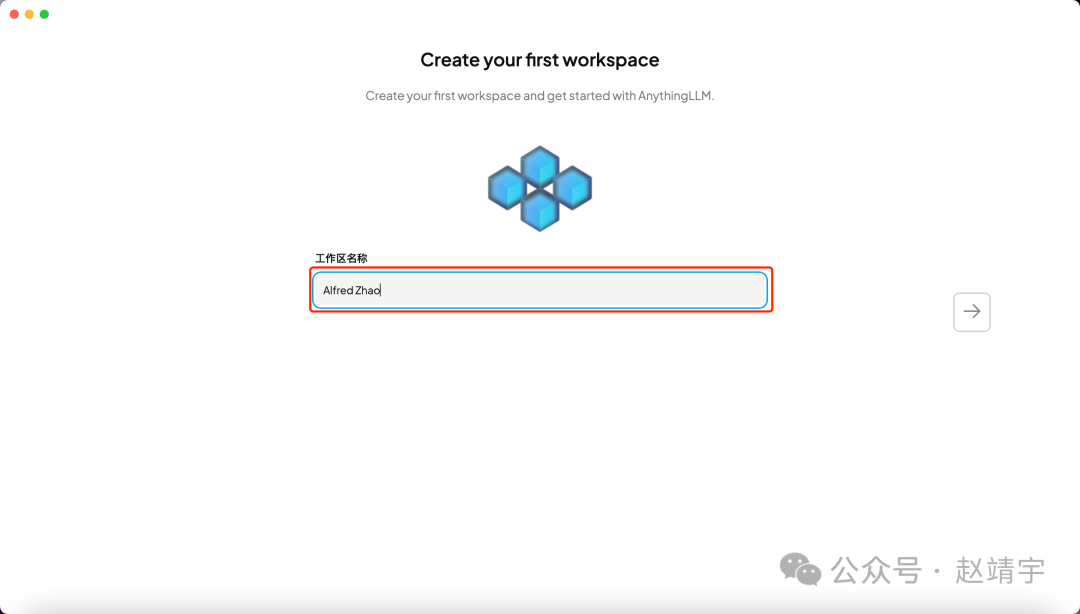
下一步选择工作区名称,你可以随便起名字,我这里就用自己的英文名演示了:

img

然后就终于进入了主界面:

img

呼呼,迫不及待的开始测试。
我这里直接设计了一个大模型不可能知道的问题,就是拿我的中文名字去做测试,直接问他“赵靖宇是谁?”
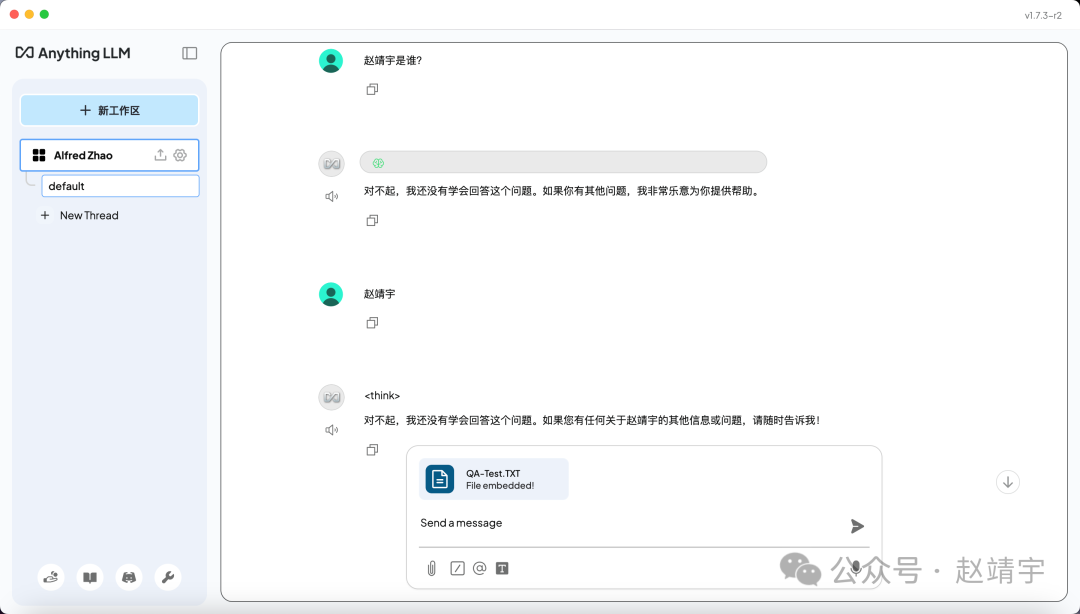
img

果然,它不知道!

马上开始上传一段TXT文本QA-Test.TXT,其实就是简单包含了我之前在讲公开课时的一段个人介绍,全文也没几句话。开始期待它的表现,上传方式如下,可以看到上传后文件就会自动Embedded!
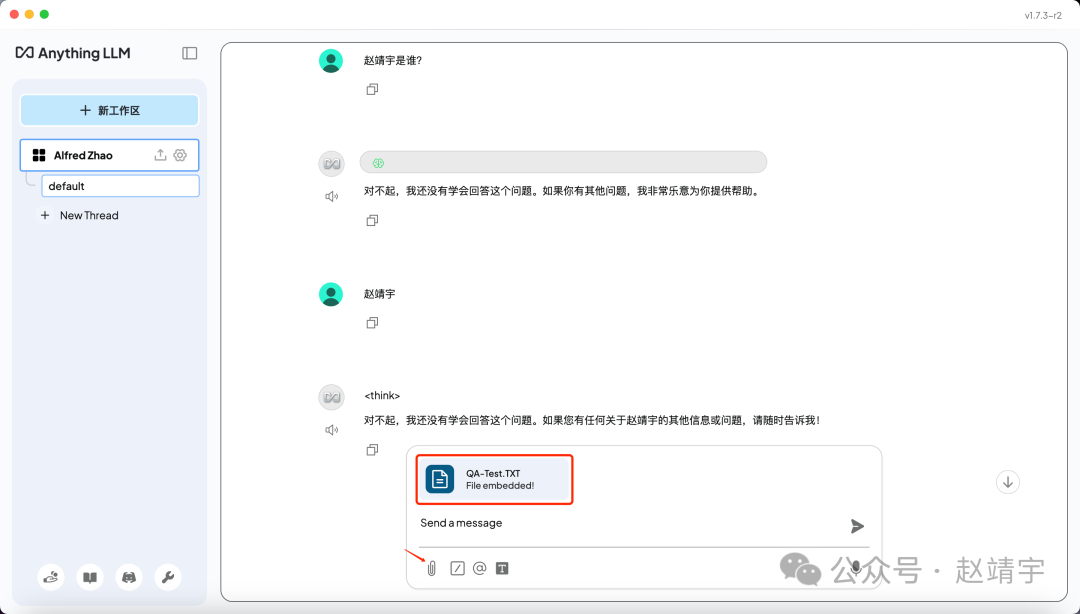
img

可是…… 这里不太顺利,它居然还是不知道!呜呜呜,我都把小抄给你了你还说不知道,笔者已哭晕……
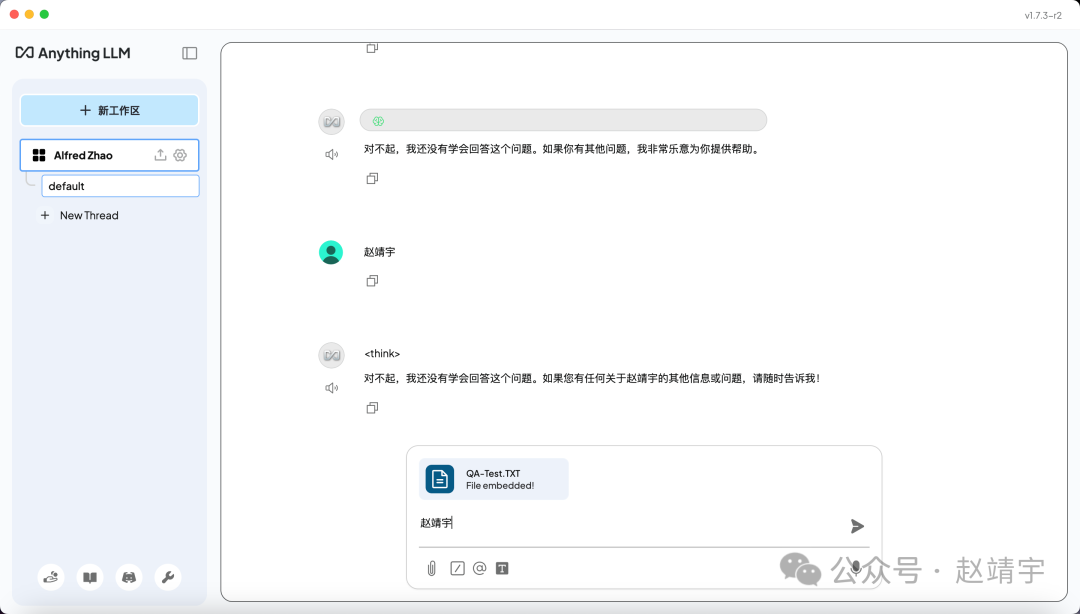
img

此时只能转而troubleshooting,检索发现不少人都有遇到类似问题,有人甚至直接发结论说本地大模型的模式下,AnythingLLM根本无法识别上传的个人文件,甚至力劝大家别折腾了。。

3.配置 nomic-embed-text 模型

笔者属于不撞南墙不回头的类型,想深挖下问题到底出在哪里?开始逐一检查可能的配置:
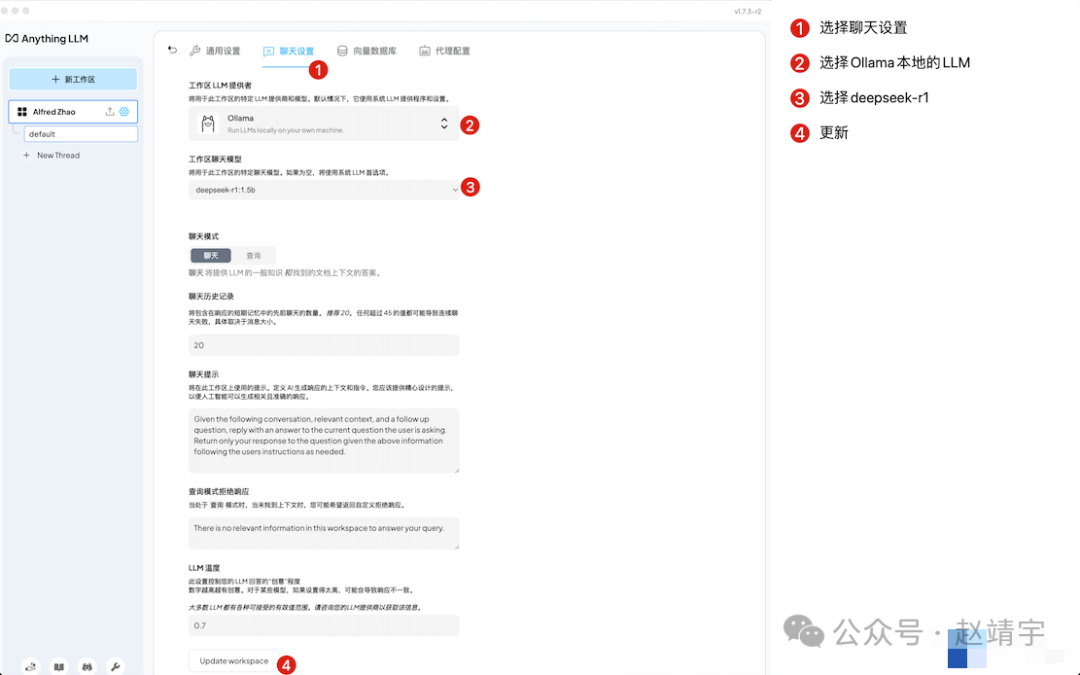
1)聊天设置模型选择肯定是没问题,本地大模型 DeepSeek:
img

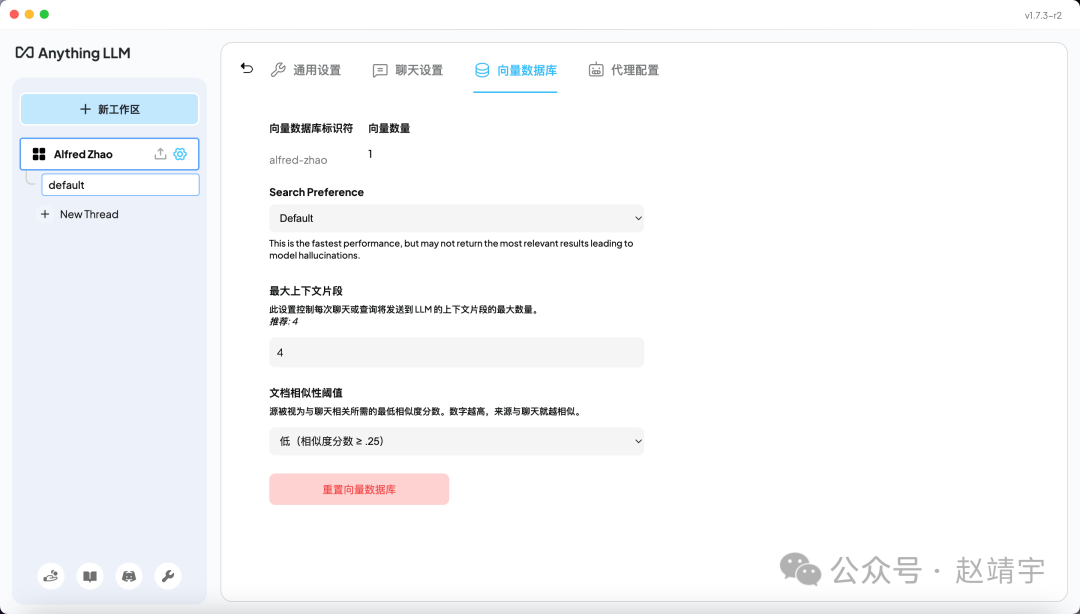
2)向量数据库默认的,向量数量为1:

img

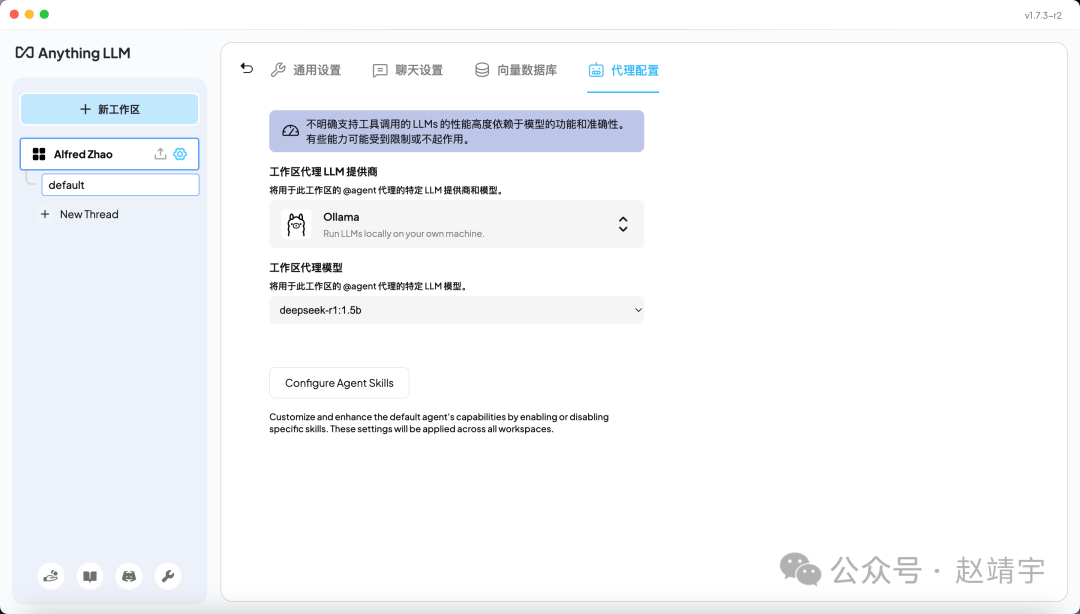
3)代理配置依然选择了本地大模型 DeepSeek:

img

笔者初步判断:

  • 1)本地大模型肯定没问题,因为上篇使用Chatbox调用都OK,AnythingLLM对应配置也再次确认了,均正确。
  • 2)向量数据库虽然我有更好的选择,笔者就是从事数据库行业,但这里显然还没到那个阶段,默认的即便再拉跨也不至于一个这么简单的文本向量化都搞不定。
  • 3)那就剩下 Embedding 用的模型,虽然开始也没怀疑过,但是这样排除下来就这个可能性最大了。要不,换一个试试?

目前 Embedding 采用的是默认的 AnythingLLM Embedder:
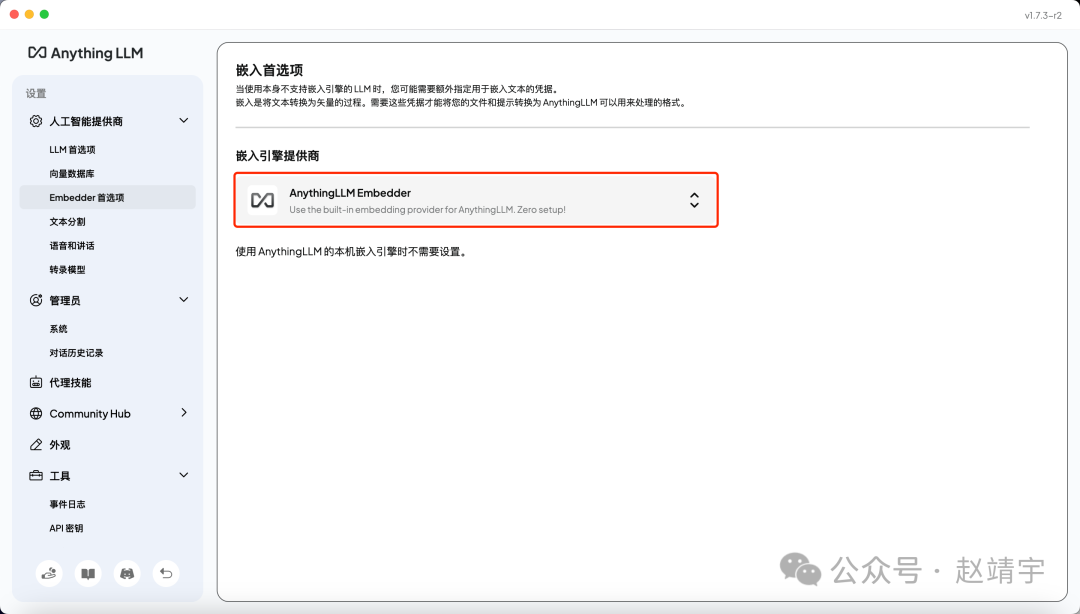
img

简单research了下,选了另一个Ollama下的nomic-embed-textEmbedding 模型,官方网站:

  • https://ollama.com/library/nomic-embed-text

我们可以在terminal下使用ollama直接拉取ollama pull nomic-embed-text:
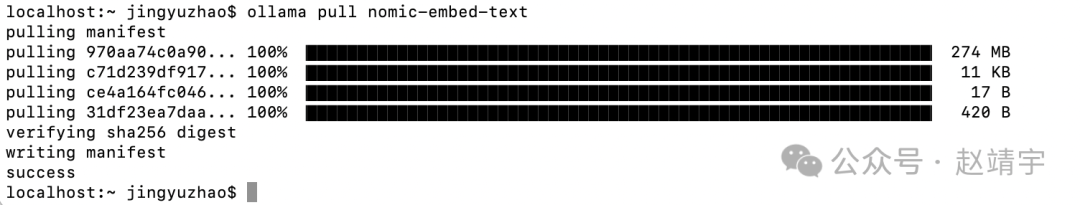
img

然后再回到Embedder首选项,在嵌入引擎提供商,选择Ollama,然后在下面的Ollama Embedding Model选择刚刚下载的最新nomic-embed-text:8192,如下图:
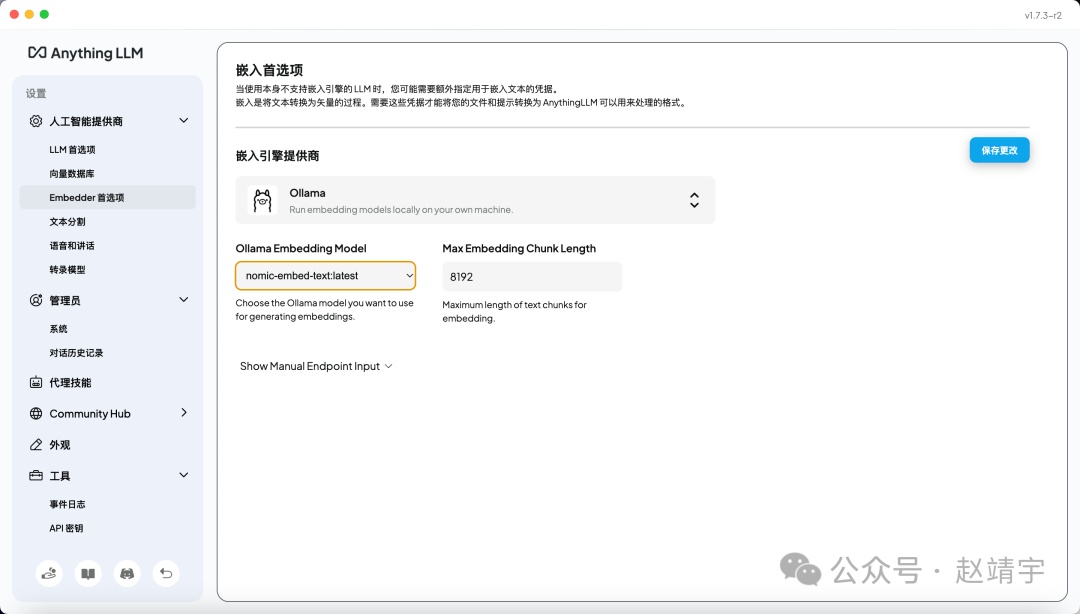
img

选择好之后点击蓝色的按钮保存更改,会弹出一个比较醒目的Warning,如下图:
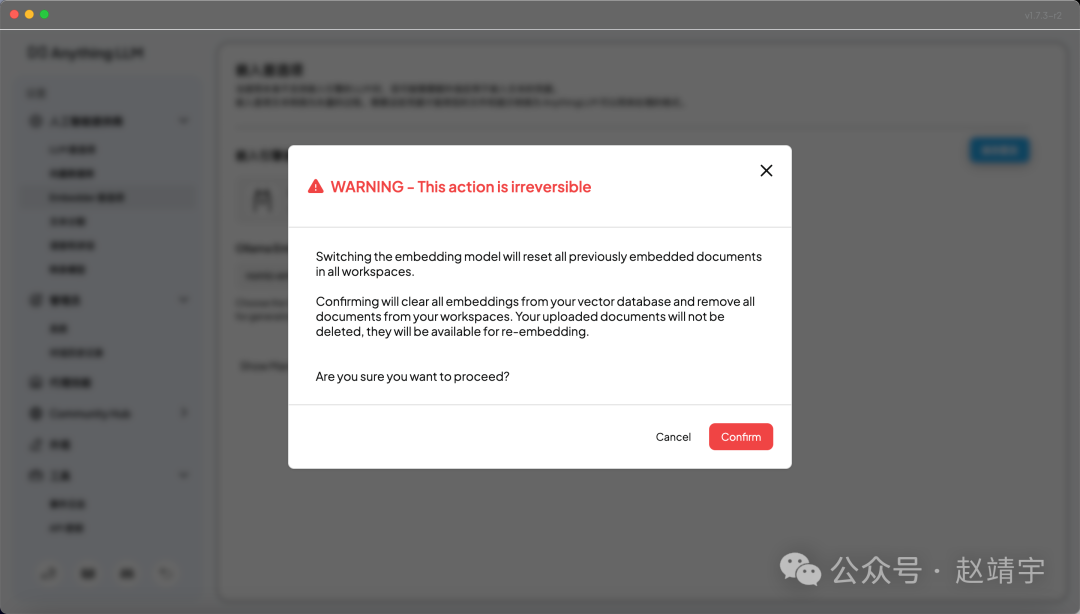
img

主要是警告你要做的这个更改Embedding模型的操作会重置先前所有embedded的文档,且不可逆转。我这之前的根本没效果,重置就重置,赶紧点击Confirm,迫不及待想看下这个新的Embedder是否有用?

4.演示如何正确喂养个人数据

使用跟之前同样的操作方法,同样的问题赵靖宇是谁?,喂养文本QA-Test.TXT,终于起作用了!
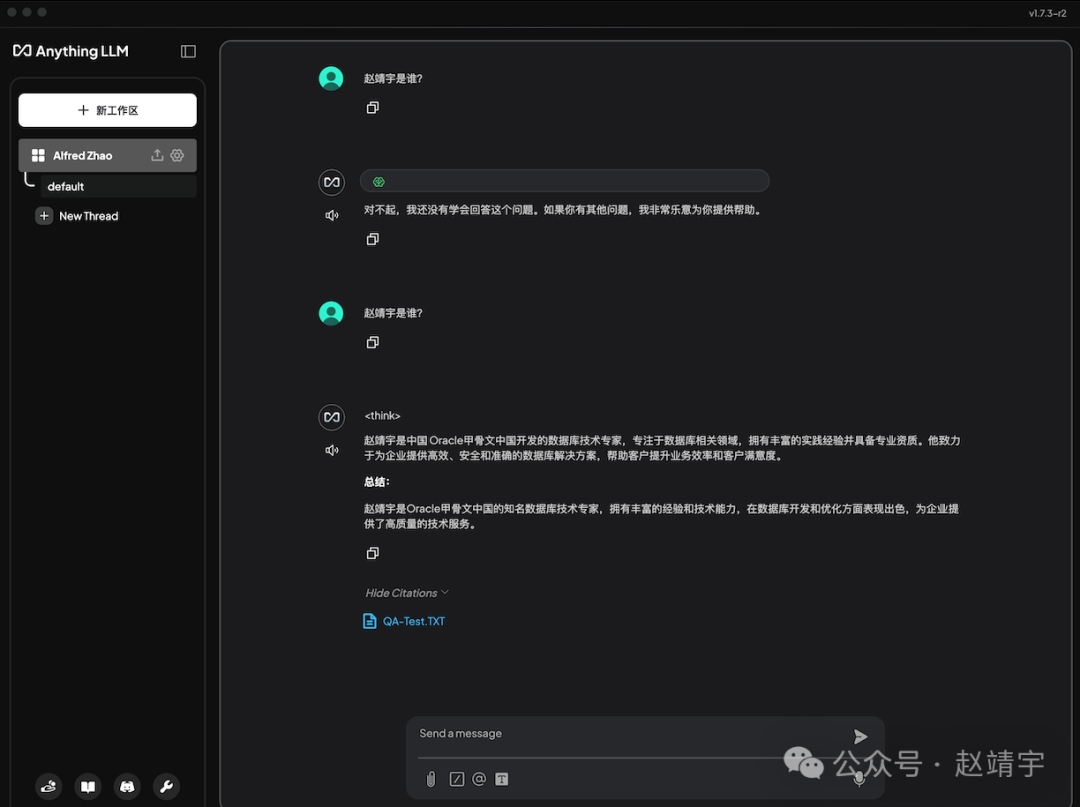
img

于是兴奋地继续追问:他有几年的工作经验?,又不知道了,当然这个正常,因为我提供的信息里就没有明确提到,可以继续上传其他个人数据,比如说来份PDF格式的个人简历:
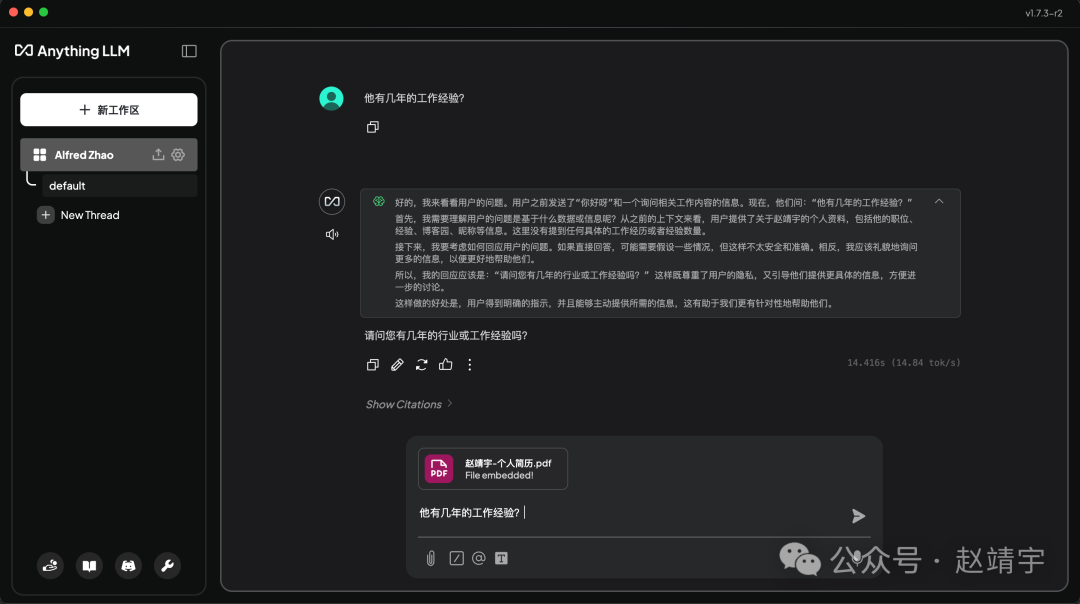
img

然后继续问些更细节的问题:你知道他的博客地址是什么吗?、赵靖宇有公众号吗?
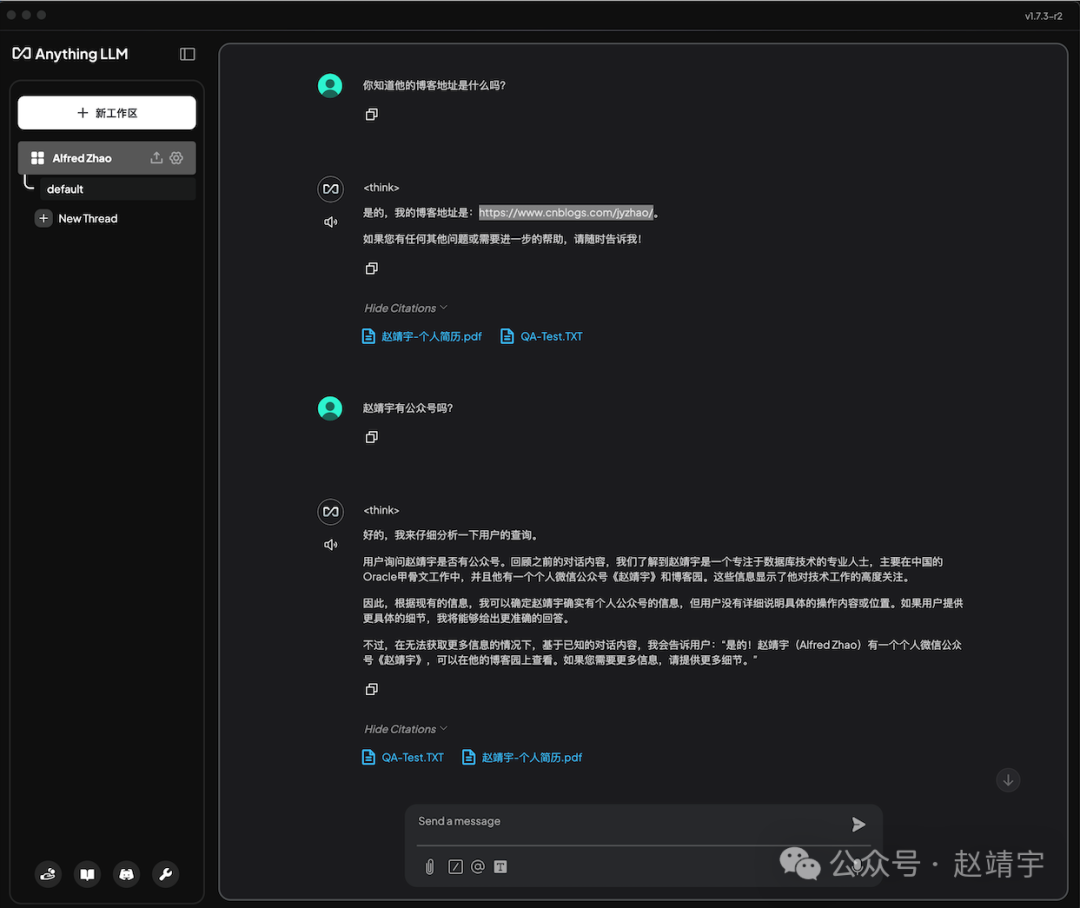
img

效果还是比较给力的,均给出了正确答案。明确说出我的公众号名称赵靖宇,以及Blog的url地址:https://www.cnblogs.com/jyzhao/,尤其是网址能准确给出还是比较惊喜的。

5.喂养前后效果对比和缺陷

上面已经看到了喂养后的效果显著,但这是否就高枕无忧了呢?

其实不是的,比如我继续测试时发现,当让它帮我总结下简历信息,就看到了较明显的缺陷:
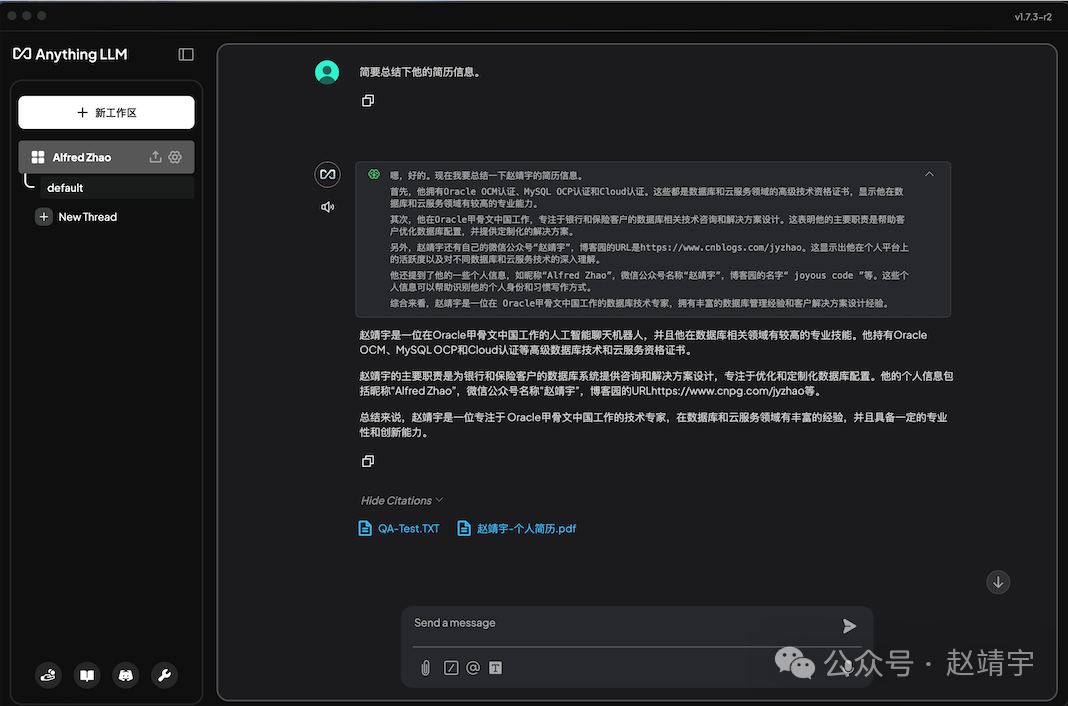
img

这里有两处明显的错误:而且有一个错误,还是之前单独问它时,回答正确的,具体如下图:
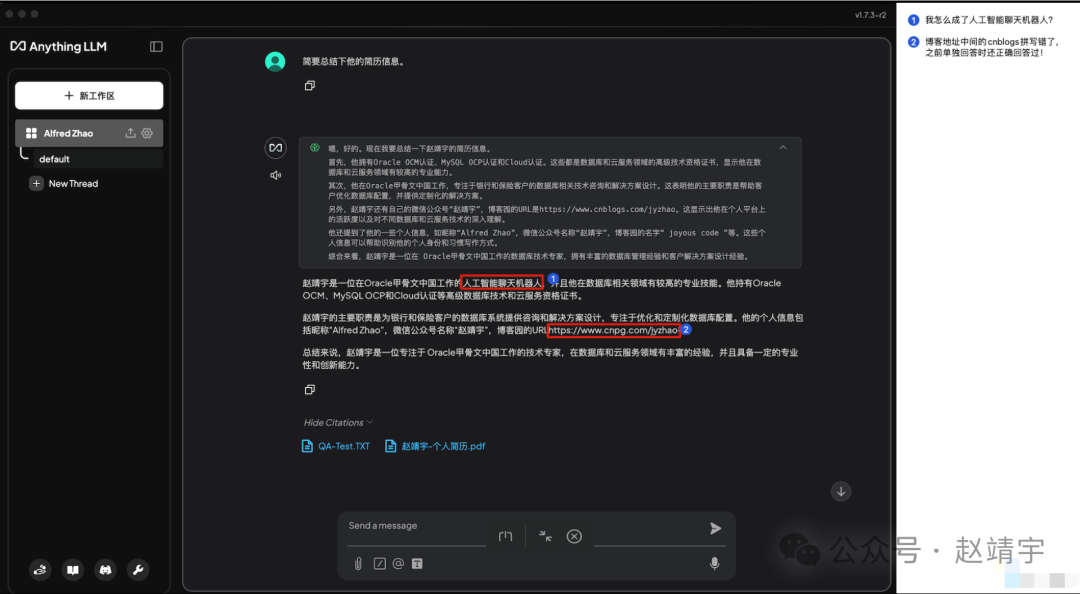
img

其实这个回复中大部分信息都还OK,可瑕疵也是极为明显的,比如它居然说我是人工智能聊天机器人,然后把之前曾正确回答出的博客网址又给答错了。
这些讹误和不稳定性,原因可能是受限于我本地部署的模型太小,本身能力不足,也可能是Embedding向量化的工作做的还不够好,但总体来说,对于我这台个人电脑能达到这样的效果,已经很是知足了。

DeepSeek无疑是2025开年AI圈的一匹黑马,在一众AI大模型中,DeepSeek以低价高性能的优势脱颖而出。DeepSeek的上线实现了AI界的又一大突破,各大科技巨头都火速出手,争先抢占DeepSeek大模型的流量风口。

DeepSeek的爆火,远不止于此。它是一场属于每个人的科技革命,一次打破界限的机会,一次让普通人也能逆袭契机。

DeepSeek的优点

read-normal-img

掌握DeepSeek对于转行大模型领域的人来说是一个很大的优势,目前懂得大模型技术方面的人才很稀缺,而DeepSeek就是一个突破口。现在越来越多的人才都想往大模型方向转行,对于想要转行创业,提升自我的人来说是一个不可多得的机会。

那么应该如何学习大模型

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

大模型岗位需求越来越大,但是相关岗位人才难求,薪资持续走高,AI运营薪资平均值约18457元,AI工程师薪资平均值约37336元,大模型算法薪资平均值约39607元。

read-normal-img

掌握大模型技术你还能拥有更多可能性:

• 成为一名全栈大模型工程师,包括Prompt,LangChain,LoRA等技术开发、运营、产品等方向全栈工程;

• 能够拥有模型二次训练和微调能力,带领大家完成智能对话、文生图等热门应用;

• 薪资上浮10%-20%,覆盖更多高薪岗位,这是一个高需求、高待遇的热门方向和领域;

• 更优质的项目可以为未来创新创业提供基石。

可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。为了让大家少走弯路,少碰壁,这里我直接把都打包整理好,希望能够真正帮助到大家。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】在这里插入图片描述

👉AI大模型学习路线汇总👈

大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)

read-normal-img

第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;

第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;

第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

read-normal-img

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

read-normal-img

read-normal-img

👉学会后的收获:👈

• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

read-normal-img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】在这里插入图片描述

操作最简单的 DeepSeek 本地化部署后数据投喂方法,搭建你自己的专属 AI 知识库及注意事项 , AnythingLLM 下载分享 手把手教你如何本地化部署 DeepSeek 并投喂数据完成个性化专业定制,小白也能操作,不用命令行进行设置,完全可视化操作。并且发现 1.5b 的资料总结能力相当糟糕,基本看不懂资料,资料中明确提示的内容它都不定归纳出来,相比之下,32b 基本工作正常,归纳资料逻辑清晰准确。 阅读详情

相关推荐

全流程解析:DeepSeek 部署与数据投喂操作实战全记录

随着人工智能与深度学习技术的迅速发展,针对多种应用场景的深度学习模型逐步成为行业标准之一。DeepSeek作为一种创新的框架,已经在众多应用中展现出了其强大的能力。本文将从技术部署、数据投喂、模型优化等多方面,深入分析DeepSeek在实际应用中的具体操作流程,并提供经典及前沿代码示例,旨在帮助研究者与开发者更好地理解并高效应用该技术。

s13596191285的博客 400

DeepSeek本地部署+投喂数据训练AI教程!!

DeepSeek-R1,是深度求索(DeepSeek)研发的推理模型,本地部署后完全免费,无使用次数限制。DeepSeek-R1采用的大规模强化学习技术,尤其擅长数学、代码和自然语言推理等复杂任务。DeepSeek-R1系列模型(1.5b~671b)开源且免费,进一步降低了AI应用门槛,赋能开源社区发展。使用教程❶Win版安装教程(Ollama+AnythingLLM安装、DeepSeek模型下载)❷Mac版安装教程(Ollama+AnythingLLM安装、DeepSeek模型下载)

2301_76168381的博客 15万+

从零开始部署DeepSeek,用它赚取第一桶金?

——一个连代码都不用写的“AI使用”全流程指南DeepSeek这玩意儿最近火得一塌糊涂,全球AI圈都在聊它。它有多牛?简单说,就是“国产版ChatGPT”,但比OpenAI便宜了97%!百万次调用只要16块,而同样性能的OpenAI要438块,直接省出一顿火锅钱。更绝的是,它开源免费,支持本地部署,不用联网也能用,数据全锁在你电脑里。划重点:省钱:一杯奶茶钱就能跑一个月模型,适合散户。安全:本地部署不联网,你的交易策略不会被偷。灵活:能自己调教模型,比如让它专攻“北交所妖gu”或“港gu科技龙头”。别被“部

skyksksksksks的博客 1813

如何给本地部署的DeepSeek投喂数据,让他更懂你

在上一篇文章中,我们说了怎么在本地部署DeepSeek。对本地部署DeepSeek感兴趣的小伙伴看过来。本地部署 DeepSeek:小白也能轻松搞定!话说回来了,为啥要本地部署呢?① 在使用DeepSeek中,经常会出现服务器繁忙,请稍后再试。② 不想让个人隐私数据暴露出去③ 可以将各种格式的文件,如pdf、csv、txt、md 格式的数据投喂给它。比如你想让DeepSeek了解你的公司业务,就把相关的文档上传给它。DeepSeek就能吃下你给它的各种“知识大餐”,然后变得更聪明,更懂你。

再小的帆也能远航,把分享变成一种习惯 4432

字节跳动程序媛教你如何刷算法题:面试手撕代码我就没怕过

本人上一次刷题还是大一的C语言期末考试……但是面试中算法考核截止上岸前一直保持着100%正确率的光辉记录。 本文将给你指明一条刷题的决胜指南。并从算法的重要性、题库的选择以及刷题的三大步骤分别进行讲解,彻底解决你所有关于面试算法所有的困扰。

Stay Hungry Stay Foolish 求知若饥 虚心若愚 2万+

飞书+扣子+DeepSeek三件套:5分钟搞定公众号文章批量改写(附完整配置截图)

本文详细介绍了如何利用飞书、扣子和DeepSeek三款工具,无需编程即可搭建一个高效的公众号文章批量改写自动化工作流。通过飞书多维表格管理链接与成果,扣子平台串联整个流程,并调用DeepSeek智能体进行内容润色与改写,实现从内容抓取到智能处理的完整自动化,大幅提升新媒体运营效率。

python9snake的博客 211

DeepSeek本地模型喂养指南:手把手教你轻松上手

下面就开始!

2401_84495872的博客 1974

【SoloPi】SoloPi使用2-功能使用,录制回放

Soloπ是什么 Soloπ是一个无线化、非侵入式的Android自动化工具,公测版拥有录制回放、性能测试、一机多控三项主要功能,能为测试开发人员节省宝贵时间。 录制回放功能 Soloπ拥有录制操作的能力,用户只需要通过Soloπ执行用例步骤,Soloπ就能够将用户的操作记录下来,并且支持在各个设备上进行回放,这一切都能够在手机上独立完成。 ...

q_Catherine的博客 5829

手把手教你喂养 DeepSeek 本地模型(附下载)

扫码下载:推荐阅读:ChatGPT 4o 国内直接用 (新)!!! 世界的真实格局分析,地球人类社会底层运行原理 不是你需要中台,而是一名合格的架构师(附各大厂中台建设PPT) 长沙最大(中国领先)的创业俱乐部成立 腾讯XX集团数据湖项目建设方案(附下载)论数字化转型——转什么,如何转? 华为干部与人才发展手册(附PPT) 华为的数字化转型方法论 华为如何实施数字化转型(附PPT) 华为大数据解决...

weixin_45727359的博客 137

为什么桥式传感器(Bridge Sensor)需要用到仪表放大器?

仪表放大器在桥式传感器的应用里起到关键作用,本文介绍桥式传感器的原理、特性,以及信号调理过程,并附上了一个 TINA - TI 的仿真电路。

疯狂的运放 1528

MATLAB 控制 E4438C 信号源的研究

通过 MATLAB,我们可以实现对 E4438C 的远程控制,从而实现更高的自动化和可编程性。总结起来,通过使用 MATLAB 和 Instrument Control Toolbox,我们可以轻松地控制 E4438C 信号源并生成各种类型的信号。需要注意的是,以上代码仅为示例,实际应用中可能需要根据具体情况进行更详细的配置和错误处理。此外,MATLAB 还提供了一系列函数和命令,可用于控制 E4438C 信号源的其他功能,如频率调谐、功率设置、调制设置等。您可以根据自己的需求进行相应的配置和控制。

RswtPerl的博客 1015

手把手教学,训练模型(喂养数据) deepseek-R1 1.5b 大模型

为什么这里叫“喂养”DeepSeek 本地模型,因为大模型再强大也有它天然的局限性,比如:训练数据不可能包含你的私域数据,而打造自己的本地私域知识库,就需要检索这些数据,具体采用的是RAG(检索增强生成)方法。英文全称是Retrieval-Augmented Generation,采用RAG就需要把你的私域数据向量化,然后存储到向量数据库中,支持向量检索配合LLM大模型一起提供更专业的回复。简单概述,就是利用已有的文档、内部知识(例如飞书文档)生成。

u013302168的博客 5991

损失函数大汇总(三十八)(AUCPR Loss附公式推导与代码)

本文系统介绍了AUCPR Loss的原理与应用。针对不平衡分类任务中AUC指标不够敏感的问题,提出通过优化PR曲线面积(AUCPR)来提升模型性能。文章详细推导了AUCPR的可微近似实现:首先用sigmoid函数软化阈值判断,构造可微的TP/FP/FN计数;然后基于软Precision和Recall计算近似PR曲线面积;最后通过数值积分得到可优化的损失函数。特别讨论了温度参数τ对训练稳定性的影响,并比较了AUCPR与AUC、AP等指标的异同。该方法适用于医学筛查、欺诈检测等极端不平衡场景,能更准确反映模型对

悦学共鸣,温柔以待,汇聚光芒,共同成长 442

喂养deepseek

喂养deepseek,让它成为独一无二的大脑

投投的博客 544

基于ESP32的室内空气质量检测系统开发

随着环境污染问题的日益严重,室内空气质量的监测变得越来越重要。室内空气质量的好坏直接影响到人们的健康,尤其是对于在封闭空间长时间待着的人群。为此,基于ESP32的室内空气质量检测系统应运而生。ESP32作为一款集成了Wi-Fi和蓝牙的高性能微控制器,为嵌入式开发提供了良好的平台,适用于构建各种智能硬件设备。本博客将详细介绍如何基于ESP32开发一个室内空气质量检测系统。系统可以实时监测空气中的温度、湿度、二氧化碳浓度、甲醛浓度等指标,并通过Wi-Fi将数据传输到云端或移动设备,方便用户随时查看空气质量情况。

2201_76125393的博客 833

ST03N 里看不到 SE38 / SA38?别急,这不是没记录,而是被换了名字

摘要:SAP系统中SE38/SA38事务码在ST03N统计中可能"隐身",因其对话步骤被归集到对应的程序名(如SE38→RSABAPPROGRAM)。ST03N侧重工作负载聚合统计,而STAD提供短期明细记录。正确排查方法是:在ST03N中搜索程序名而非事务码,再通过STAD验证具体使用情况。这一现象在权限整改和审计中易造成误判,建议将程序名纳入常规监控,并区分ST03N(趋势分析)与STAD(事实校验)的不同用途。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 956

喂奶级手把手教你本地部署DeepSeek-R1(震撼提供Ollma加速下载包)

DeepSeek R1 是2025年1月20日发布的,中国公司的伟大成就。分离式训练推理代码,仅开源推理代码,可以本地部署进行模型推理,使用DeepSeek-R1,却不可以训练,参观源码。

向往有那么一天梦幻的步态识别落地,开花❀! 1148

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

本地部署DeepSeek并使用AnythingLLM建立本地知识库全流程,DeepSeek-R1:7b本地安装部署,DeepSeek-R1本地部署硬件要求

1.下载安装了ollama2.通过ollama下载安装DeepSeek-R1:7b模型(可按照电脑配置选个合适的)3.下载安装AnythingLLM4.在AnythingLLM中创建deepseek工作区并喂养文件一切均严格参照开源策略,没有任何侵权意图,完全免费。

猪神-PIGGOD 1527

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

DeepSeek无视电脑配置本地部署私人知识库,复刻自己解决问题的思维

上篇给大家介绍如何在自己电脑本地,免费快速安全地部署DeepSeek。详情请仔细回看[《DeepSeek被围攻,3分钟教你免费快速安全地部署本地DeepSeek》],绕过服务器限制,免费、快速、安全地使用DeepSeek的强大功能。这一方法不仅能让你在DeepSeek官网陷入混乱时依然能正常使用,还能让你在本地设备上体验更快、更加私密的AI服务。简单来说,如果你上传的所有内容,都是你自己脑子中的知识以及自己写出来的文字,那么DeepSeek就能深度学习你的思维,最后并把这种思维用来解决你接下来问的问题。

2401_84495872的博客 4327

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

萌宝喂养日志-我用AI做喂养记录小程序1-原型设计

硅基流动的接口。使用起来很方便。

学习、思考、总结 601

deepseek本地部署

环境变量OLLAMA_MODELS C:\soft\ollama\models。环境变量OLLAMA_HOST为0.0.0.0:11434。环境变量OLLAMA_ORIGINS 设置为 *1、配置ollama环境变量。2、下载ollama,并安装。4、下载安装Chatbox。

ding43930053的专栏 409
上一篇: AI大模型·白皮书 | 112页!DeepSeek 7大场景+50大案例+全套提示词 从入门到精通干货
下一篇: 使用LLaMA-Factory快速训练自己的专用大模型
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值