g1:基于 Llama,用提示工程实现类似 o1 的深度推理

动态思维链框架:多模态AI推理的认知协同突破 在人工智能领域,多模态推理技术正成为解决复杂问题的关键。传统大语言模型(LLM)主要依赖链式思考(CoT)等单一推理模式,难以应对需要视觉化、创造性或精确计算等异构认知能力的任务。动态思维链(Chain of Mindset)框架借鉴人类认知科学原理,通过空间思维、发散思维、收敛思维和算法思维四种核心模式的动态协同,显著提升了AI系统的多模态推理能力。该技术采用元认知调度、模块化执行和智能上下文门的三层架构,在数学推理、代码生成和视觉问题解答等场景中展现出突破性性能。实验表明,在AIME奥数题和MAZE迷宫 阅读详情

开源项目 g1 利用巧妙的提示策略,在 Groq 硬件上使用 Llama-3.1 70b 模型实现了类似 OpenAI o1 的推理链能力。g1 将推理过程可视化,并结合多种技巧引导 LLM 进行深度思考,显著提升了其在逻辑问题上的准确率,为 LLM 推理能力的提升提供了新的开源方案。
img

OpenAI 提出的 o1 模型,通过大规模强化学习和思维链技术,实现了强大的推理能力,甚至能够解决一些博士级别的复杂问题,成为 LLM 推理领域的标杆。然而,o1 模型的训练成本高昂,且内部细节并未公开,限制了其应用和研究。

g1 项目横空出世:开源 Llama 叫板 o1

g1 项目的出现为 LLM 推理能力的提升提供了新的思路,也为开源 LLM 模型带来了新的希望。g1 是一个开源项目,旨在通过提示策略来增强 LLM 的推理能力,使其能够像 o1 模型一样进行逐步推理,解决复杂的逻辑问题。g1 项目选择 Llama 作为基础模型,试图证明即使是开源模型,在合适的引导下也能展现出强大的推理能力。

g1 的目标与定位

g1 项目的目标是探索如何利用提示策略来提高 LLM 的推理能力,并激发开源社区开发新的策略来产生类似 o1 的推理能力,推动 LLM 推理技术的发展。g1 的定位是一个实验性的原型,旨在展示在可视化步骤中提示推理的强大功能,而不是与使用不同技术的 o1 进行比较或完全复制。

g1 与 o1 的区别

g1 和 o1 在实现方式上存在一些关键区别:

  • • 训练方法: o1 模型使用大规模强化学习进行训练,以使用思维链进行推理,而 g1 则主要依靠提示策略来引导 LLM 进行推理,无需额外的训练过程,大大降低了使用门槛。
  • • 模型: g1 使用开源的 Llama-3.1-70b-versatile 模型,而 o1 模型的内部细节并未公开,这使得 g1 项目更容易被复现和研究。
  • • 透明度: g1 展示所有推理步骤,提高了透明度,使用户可以清楚地了解 LLM 的思考过程,而 o1 模型的推理过程是一个黑盒,不利于研究人员理解其工作原理。

g1 工作原理:提示策略引导推理链

g1 的核心思想是利用精心设计的提示词来引导 LLM 进行逐步推理,就像人类思考问题一样,将复杂的问题分解成多个简单的步骤,逐步解决。

逐步推理:分解问题,各个击破

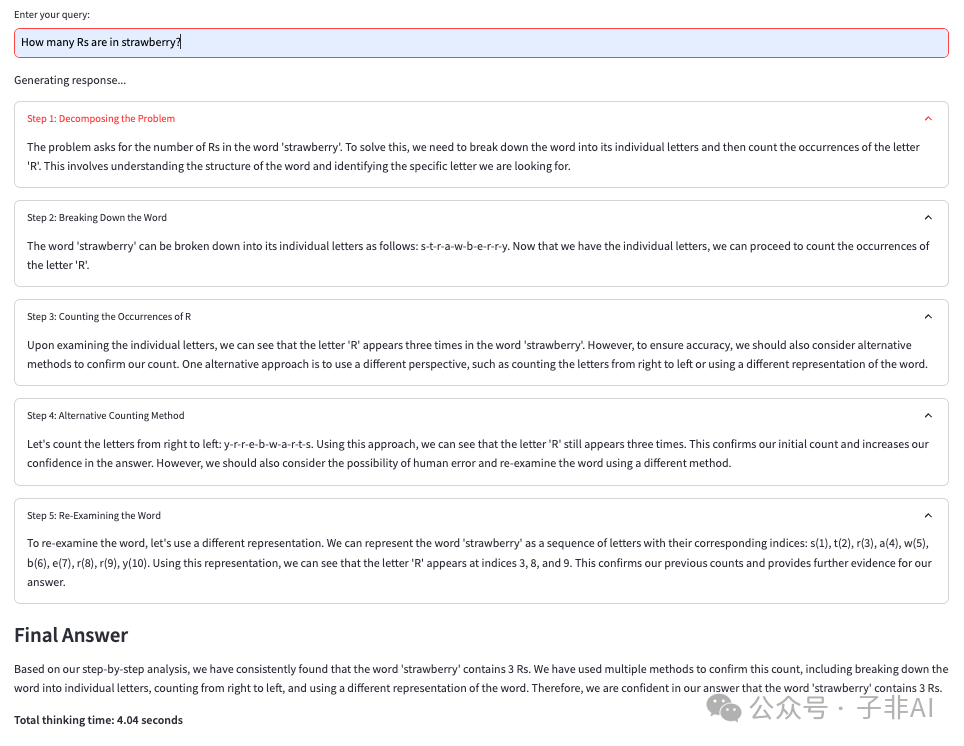
在 g1 中,LLM 会将推理过程分解成多个步骤,每个步骤都有一个标题和相应的内容。例如,在解决“草莓中有多少个 R?”这个问题时,g1 可能会将推理过程分解为以下步骤:

  1. \1. 识别问题:确定问题是询问草莓单词中字母“R”的数量。
  2. \2. 分解单词:将“strawberry”分解成单个字母:s、t、r、a、w、b、e、r、r、y。
  3. \3. 计数字母“R”:统计字母列表中“R”出现的次数。
  4. \4. 得出结论:草莓单词中有两个“R”。

动态思维链:根据需要调整推理步骤

在每个步骤中,LLM 可以选择继续进行另一个推理步骤,或提供最终答案。这种动态思维链机制使得 LLM 能够根据问题的复杂程度和自身推理能力,灵活地调整推理步骤的数量和内容,展现出类似人类的思考过程。

提示词分解:揭秘 g1 的魔法咒语

g1 的提示词包含 LLM 人设设定、推理步骤指导、JSON 格式要求和一系列最佳实践提示。

g1 的完整提示词及注解:

You are an expert AI assistant that explains your reasoning step by step. 
// 为 LLM 设定角色,使其扮演专家级的 AI 助手,并强调需要逐步解释推理过程。

For each step, provide a title that describes what you're doing in that step, along with the content. 
// 指导 LLM 将推理过程分解成多个步骤,每个步骤都需要有标题和内容描述。

Decide if you need another step or if you're ready to give the final answer. 
// 要求 LLM 自主决定是否需要继续推理或给出最终答案,体现动态思维链的特性。

Respond in JSON format with 'title', 'content', and 'next_action' (either 'continue' or 'final_answer') keys. 
// 规定 LLM 的输出格式为 JSON,包含标题、内容和下一步行动(继续或给出最终答案)。

USE AS MANY REASONING STEPS AS POSSIBLE. AT LEAST 3. 
// 鼓励 LLM 使用尽可能多的推理步骤,至少 3 步,以保证推理过程的深度和完整性。

BE AWARE OF YOUR LIMITATIONS AS AN LLM AND WHAT YOU CAN AND CANNOT DO. 
// 提醒 LLM 注意自身作为语言模型的局限性,避免给出超出能力范围的答案。

IN YOUR REASONING, INCLUDE EXPLORATION OF ALTERNATIVE ANSWERS. 
// 要求 LLM 在推理过程中探索不同的答案,避免思维定势,提高答案的准确性。

CONSIDER YOU MAY BE WRONG, AND IF YOU ARE WRONG IN YOUR REASONING, WHERE IT WOULD BE. 
// 引导 LLM 进行自我反思,思考推理过程中可能出现的错误,提高推理的严谨性。

FULLY TEST ALL OTHER POSSIBILITIES. YOU CAN BE WRONG. 
// 强调 LLM 需要充分考虑所有可能性,并承认自身可能犯错,避免给出过于自信的答案。

WHEN YOU SAY YOU ARE RE-EXAMINING, ACTUALLY RE-EXAMINE, AND USE ANOTHER APPROACH TO DO SO. DO NOT JUST SAY YOU ARE RE-EXAMINING. 
// 要求 LLM 在重新检查推理过程时,要真正进行反思,并尝试不同的方法,避免流于形式。

USE AT LEAST 3 METHODS TO DERIVE THE ANSWER. 
// 鼓励 LLM 使用至少 3 种方法来推导答案,从多个角度验证答案的正确性。

USE BEST PRACTICES.
// 要求 LLM 遵循最佳实践,例如使用清晰的语言、合理的逻辑等,提高推理过程的可读性和可理解性。

Example of a valid JSON response:
json
{
    "title": "Identifying Key Information",    
    "content": "To begin solving this problem, we need to carefully examine the given information and identify the crucial elements that will guide our solution process. This involves...",    
    "next_action": "continue"
}

g1 效果展示:逻辑问题迎刃而解

g1 在解决一些简单的逻辑问题上表现出色,例如草莓问题和数字比较问题,证明了其提示策略的有效性,也展现了 Llama 模型的潜力。

草莓问题:LLM 不再被字母“R”难倒

在草莓问题(“草莓中有多少个 R?”)上,g1 的准确率达到约 70%,远超未经提示的 Llama-3.1-70b (0%) 和 ChatGPT-4o (30%)。这表明 g1 的提示策略能够有效地引导 LLM 克服其局限性,并最终解决问题。

g1 解决草莓问题的推理过程:
img草莓示例

数字比较:轻松识别大小关系

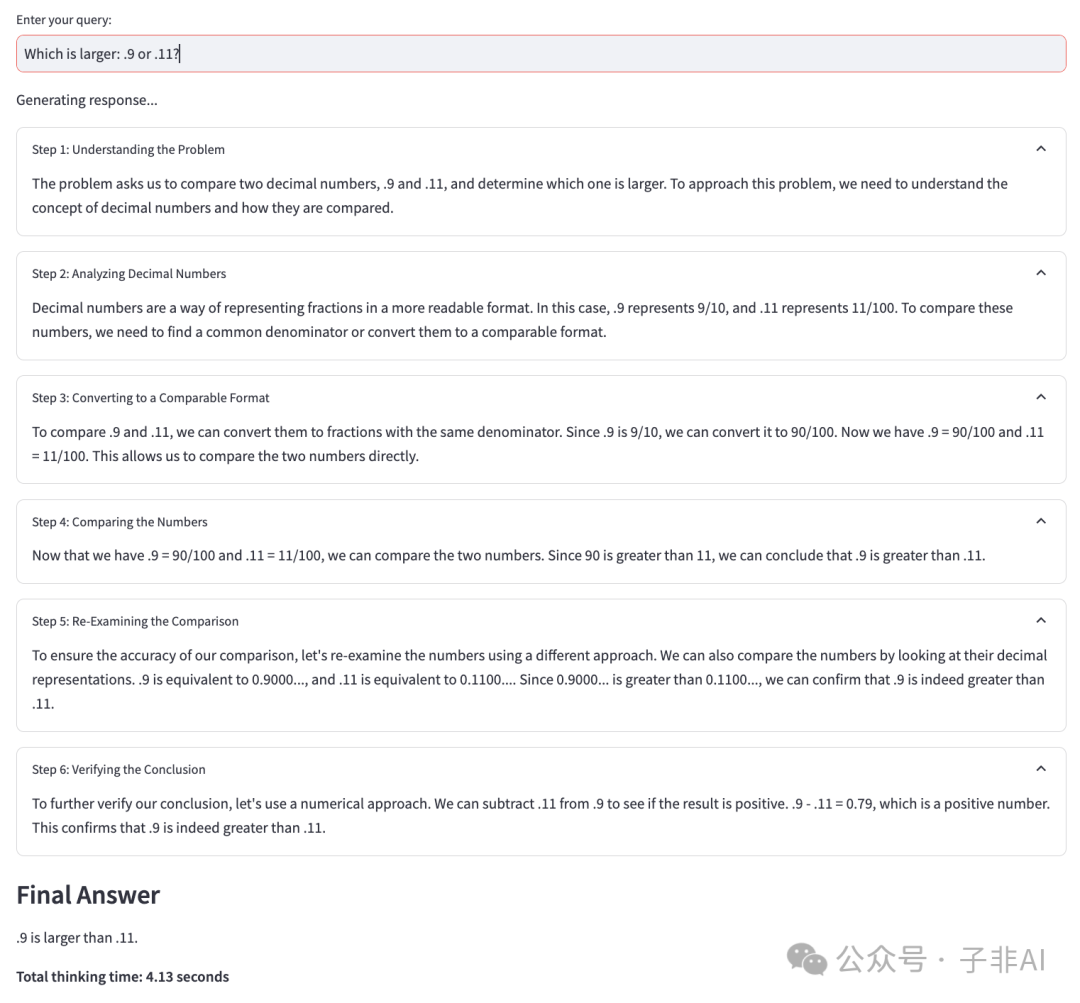
g1 也能够解决一些简单的数字比较问题,例如“哪个更大,.9 还是 .11?”。

g1 解决数字比较问题的推理过程:
img0.9 或 0.11 示例

g1 核心代码解读:基于 Streamlit 的 UI 实现

g1 项目使用 Streamlit 构建用户友好的交互界面,方便用户体验 g1 的推理能力。

API 调用与错误处理

def make_api_call(messages, max_tokens, is_final_answer=False):
    # 尝试三次调用 API    
    for attempt in range(3):   
        try:       
            # 调用 Groq API 获取 LLM 响应            
            response = client.chat.completions.create(            
                model="llama-3.1-70b-versatile",  # 使用的模型                
                messages=messages,  # 消息列表                
                max_tokens=max_tokens,  # 最大 token 数                
                temperature=0.2,  # 温度系数                
                response_format={"type": "json_object"}  # 响应格式            
            )            
            # 将 JSON 格式的响应转换为 Python 字典并返回            
            return json.loads(response.choices[0].message.content)        
        except Exception as e:          
            # 如果三次尝试都失败,则返回错误信息            
            if attempt == 2:             
               if is_final_answer:               
                   return {"title": "Error", "content": f"Failed to generate final answer after 3 attempts. Error: {str(e)}"}                
               else:                 
                   return {"title": "Error", "content": f"Failed to generate step after 3 attempts. Error: {str(e)}", "next_action": "final_answer"}            
               # 等待 1 秒后重试            
               time.sleep(1) 

代码解释:

make_api_call 函数负责调用 Groq API 获取 LLM 的响应。

响应生成与步骤控制

def generate_response(prompt):
    # 定义消息列表,包含系统角色、用户角色和助手角色的初始消息    
    messages = [     
        {"role": "system", "content": "You are an expert AI assistant that explains your reasoning step by step... USE BEST PRACTICES."},         
        # 省略部分提示词内容,完整内容请参考上文        
        {"role": "user", "content": prompt},  # 用户输入的提示        
        {"role": "assistant", "content": "Thank you! I will now think step by step following my instructions, starting at the beginning after decomposing the problem."}  # 助
手角色的初始回复
    ]        
    
    steps = []  # 存储推理步骤的列表    
    step_count = 1  # 推理步骤计数器    
    total_thinking_time = 0  # 总思考时间    
    
    while True:   
        start_time = time.time()  # 记录开始时间        
        step_data = make_api_call(messages, 300)  # 调用 API 获取推理步骤内容        
        end_time = time.time()  # 记录结束时间        
        thinking_time = end_time - start_time  # 计算思考时间        
        total_thinking_time += thinking_time  # 累加总思考时间        
        
        # 将推理步骤添加到 steps 列表        
        steps.append((f"Step {step_count}: {step_data['title']}", step_data['content'], thinking_time))        
                
        # 将助手角色的回复添加到 messages 列表        
        messages.append({"role": "assistant", "content": json.dumps(step_data)})            
            
        # 判断是否到达最终答案或超过最大推理步骤数        
        if step_data['next_action'] == 'final_answer' or step_count > 25:        
            break              
              
        step_count += 1        
        
        # 使用 yield 关键字逐个返回推理步骤,方便 Streamlit UI 实时更新        
        yield steps, None      
        
    # 生成最终答案    
    messages.append({"role": "user", "content": "Please provide the final answer based on your reasoning above."})        
    
    start_time = time.time()    
    final_data = make_api_call(messages, 200, is_final_answer=True)    
    end_time = time.time()    
    thinking_time = end_time - start_time    
    total_thinking_time += thinking_time        
    
    steps.append(("Final Answer", final_data['content'], thinking_time))    
    
    yield steps, total_thinking_time

代码解释:

generate_response 函数负责生成 LLM 的响应,并控制推理步骤。

g1 的创新点:可视化与提示工程的完美结合

可视化推理链:增强透明度,建立信任

g1 将 LLM 的推理过程可视化,使用户能够清晰地了解 LLM 的思考过程,并更容易理解其最终答案是如何得出的。这种透明度在以往的 LLM 应用中是比较少见的,它有助于增强用户对 LLM 的信任,并促进 LLM 技术的进一步发展。

仅通过提示工程提升推理能力:简单高效,普适性强

g1 没有采用复杂的强化学习方法来训练 LLM,而是仅通过精心设计的提示词来引导 LLM 进行推理。这表明,即使不进行额外的训练,也可以通过提示工程来显著提升 LLM 的推理能力。这种方法更加简单易行,并且可以应用于各种不同的 LLM 模型,具有很强的普适性,也为开源 LLM 模型的发展提供了新的方向。

总结

g1 项目展示了提示策略在提升 LLM 推理能力方面的巨大潜力,也证明了开源 LLM 模型在推理任务上具有竞争力。g1 的开源特性和可视化推理链也为 LLM 技术的透明度和可解释性做出了贡献,有利于 LLM 技术的推广和应用。未来,g1 项目可以进一步探索更复杂的提示策略,以解决更具挑战性的推理问题。

相关链接

  • • g1 项目 GitHub 仓库: https://github.com/bklieger-groq

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

GPT-5.5不存在:厘清GPT-4o与o1的真实能力边界 大语言模型(LLM)作为当前AI应用的核心技术,其版本演进逻辑常被误读为线性数字升级,实则遵循能力维度命名范式。GPT-4o并非GPT-4的简单优化,而是基于统一多模态编码器的原生多模态模型,具备低延迟、高准确率及跨模态联合理解能力;o1系列则代表复杂推理范式的跃迁,通过可配置思维预算实现高质量链式推理。二者在企业级场景中形成互补架构:GPT-4o承担实时响应与多模态感知,o1专注深度决策与根因分析。当前所有‘GPT-5.5’说法均属误传或营销虚构,真实技术脉络聚焦于GPT-4o与o1的协同落地。本文基于O 阅读详情

相关推荐

10美元微调Llama 4 Scout:MoE模型医疗推理实战指南

大语言模型微调正从千美元级门槛迈向个体可及的工程现实。MoE(Mixture of Experts)架构凭借动态专家路由与稀疏激活特性,在保持参数规模的同时显著降低计算开销;LoRA(Low-Rank Adaptation)作为主流高效微调技术,通过低秩矩阵注入实现参数高效更新,大幅压缩显存与训练成本。二者结合,使17B参数量的Llama 4 Scout在垂直领域(如临床推理)的定制化成为可能。本文聚焦医疗场景,详解如何利用H200 GPU集群、4-bit量化、合规数据集与精细化LoRA配置,在30分钟内完

weixin_30580341的博客 717

解密prompt系列42. LLM通往动态复杂思维链之路

合集 - DecryptPrompt(42)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_33510623的博客 344

推理模型实战指南:从R1思维链蒸馏到o3-mini动态缓存

推理模型正推动AI从‘生成答案’迈向‘可验证思考’,其核心是将隐式推理过程显式建模为可优化目标。基于强化学习(RL)的推理能力提升,依赖对思维链(Chain-of-Thought)的结构化建模与对齐,以及面向执行反馈(RLEF)的闭环优化机制。相比传统RLHF,RLEF通过仿真引擎、规则校验与历史拟合三重反馈,直接驱动推理路径进化;而思维链蒸馏则通过教师-学生隐状态对齐与推理路径奖励模型(RPM),保障多步逻辑稳定性。这类技术已在法律合同审查、供应链风险推演、工业故障溯源等需长程依赖与高确定性的场景落地验证

weixin_33829657的博客 326

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3939

Gemini Deep Think实战解析:真实场景下的AI深度推理能力边界

深度推理是大模型从‘能回答’迈向‘可决策’的关键跃迁,其核心在于多路径并行探索、跨分支竞争筛选与结果可验证性。不同于传统Chain-of-Thought的线性推演,Deep Think通过内部注意力机制激活多个逻辑分支,在数学证明、策略优化、系统设计等具备明确评价标准的任务中展现出强模式识别与粗粒度推演能力;但面对信息残缺、隐性约束或价值权衡类问题时,易陷入模板套用或认知锚定。技术价值体现在加速问题分类、框架构建与方案初筛,而非替代人工验证与领域直觉。典型应用场景包括网络算法复杂度判定、轻量级商业策略生成、

546

解锁知识管理的新维度:思维链技术深度解析

本篇博客旨在深入探讨思维链技术,一种新兴的知识管理和信息组织工具。通过本文,读者将了解思维链的概念、它的工作原理、如何有效使用它来提升个人和团队的生产力,以及它如何与现有的知识管理工具相比较。文章将结合实际案例,清晰阐述如何在各种场景下应用思维链技术,帮助读者构建更加高效和连贯的思维模式。

fudaihb的博客 2365

DeepSeek 多模协作:下一代教育场景人工智能应用?

在教育场景中,教学内容最需要精准与可靠。如今的大模型偶尔会出现“AI 幻觉”(Hallucination),导致学生接收到的知识点不准确。

2401_84204207的博客 1494

全网最全vue2技术栈实现AI问答机器人功能(流式与非流式两种接口方法)

markdown-it | markdown-it 中文文档上面的是 markdown-it 中文文档链接 ,供参考使用核心的东西就这些啦,如果有其他想问的,评论区留言即可~博客写作不易,希望大家多多支持,多多捧场~~~最后给大家分享一下 typed.js 网址,网上比较多,我觉得这个比较好理解一些Typed.js - Type your heart out (mattboldt.github.io)[这里是图片011]https://mattboldt.github.io/typed.js/

m0_74825108的博客 3060

DeepSeek-R1-Distill-Llama-8B推理优化:8B模型在24G GPU上的高效调用

本文介绍了如何在星图GPU平台上自动化部署DeepSeek-R1-Distill-Llama-8B镜像,充分发挥其在24G GPU上的高效推理能力。该模型专为数学推导、代码生成与逻辑分析优化,适用于技术文档解读、编程辅助及算法题求解等典型场景,助力开发者低成本实现专业级AI推理服务。

weixin_35639680的博客 270

离线安装vue脚手架,内网安装@vue/cli

公司开发环境使用内网,无法用外网,搭建环境的时候,发现内网系统没有安装vue脚手架,我搜了很多文章,发现他们的方法对我都不适用,然后就自己摸索,最终皇天不负有心人,终于被我安装上了,一下是我内网离线安装vue/cli的方法,希望能帮助到有需要的小伙伴! 因为npm被集成在nodejs中,而安装nodejs只需要把nodejs安装包copy到内网电脑安装就行,比较简单,这里就不多做演示。 在外网电脑上,使用npm install -g xxxx命令下载好我们所需要的各个安装包,比如: npm insta

Liberty_yes的博客 1万+

变色龙哈希函数 Chameleon Hash 可变型区块链

哈希函数 Hash: 众所周知,区块链有着极其优秀的安全性就是因为其充分使用了哈希函数。 哈希简单用一句话来讲,就是:将任意长度输入的字串可转换成一个固定长度的字串,通过原始字串可以很容易地算出转换后的字串,通过转换后的字串很难还原出原始字串。 哈希函数特征: 1. 对于任意m作为输入,得到输出的结果,很难找到另一个输入m'  (m'不等于m),使得m'的Hash结果也为同样的输出

新手村 1万+

AI工程化降本:用提示工程与多模型协同榨干单个API价值

在大模型应用落地中,'低成本高效益'并非依赖未发布的神秘模型,而是基于真实可用模型(如GPT-4o、Claude 3.5、Qwen2.5)的系统性工程实践。其核心原理在于将AI视为可调度、可编排、可缓存的计算资源,通过提示工程构建稳定认知接口,借助工具编排解耦决策与执行,利用状态管理与语义缓存压缩token消耗,并以结构化输出打通业务系统。这种AI工程化方法显著提升单位token产出率,已在跨境电商、客服系统、知识管理等场景验证——单API密钥支撑五类高价值任务,成本降低41%~79%。本文聚焦可复用、可组

weixin_30550081的博客 365

Win11 C盘爆满别慌!手把手教你安全迁移AppData和用户文件夹(附一键脚本)

本文针对Win11 C盘空间不足问题,提供了一套安全有效的解决方案。通过深入解析用户目录结构,指导用户利用符号链接和Robocopy工具,将AppData、下载文档等占用大户迁移至其他分区,并附带了自动化脚本,从根本上实现C盘瘦身,同时确保系统稳定和数据安全。

weixin_29231221的博客 2095

三大1.5B级模型部署对比:DeepSeek-R1/Qwen/Llama3实战评测

本文介绍了如何在星图GPU平台上自动化部署DeepSeek-R1-Distill-Qwen-1.5B文本生成模型 二次开发构建by113小贝镜像,充分发挥其在数学推导与代码逻辑审查等需要严谨推理的典型场景中的能力,助力科研助理、量化研究员等用户高效完成算法验证与程序逻辑分析任务。

weixin_42596214的博客 422

CVAT自动标注避坑指南:如何解决Nuclio工程创建失败和镜像拉取问题

本文是一份针对CVAT自动标注部署中常见问题的实战排障指南。文章深入剖析了Nuclio工程创建失败的根源,提供了网络配置、服务状态检查等系统性解决方案,并详细讲解了如何解决gcr.io等海外镜像拉取难题,帮助开发者顺利完成CVAT自动标注环境的搭建与部署。

weixin_29207533的博客 234

基于AI的智能开发环境—Trae在Web开发中的应用实战与性能评估【Trae项目实战】

Trae 是一款与 AI 深度集成的开发工具,提供智能问答、代码自动补全和基于 Agent 的 AI 自动编程能力,极大提升开发效率。它具备完备的 IDE 功能,如代码编写、项目管理和源代码管理等,同时还具备强大的 AI 助手,能够提供智能问答、实时代码建议、代码片段生成等服务。开发者可以通过自然语言与 AI 协作,从 0 到 1 开发项目,AI 会根据需求自动生成代码或创建文件。

一键难忘的博客 3万+

如何把Qwen3-1.7B-GGUF变成API服务:llama-server部署指南

Qwen3-1.7B-GGUF 是 Qwen3 系列 17 亿参数开源大模型的 GGUF 量化版本。本文教你使用 llama.cpp 的 llama-server 工具,把它快速部署成 OpenAI 兼容的 API 服务——几条命令之后,任何程序都能通过标准接口调用这个本地 AI 模型。 ## 🧩 Qwen3-1.7B-GGUF 是什么 Qwen3-1.7B 是 Qwen3 家族中的轻量级模

gitblog_01029的博客 119

MDIO接口协议与其详解——单片机

在单片机领域,通过MDIO接口可以与外部设备进行通信,实现对设备的控制和数据的读写。通过本文的介绍,你可以了解到MDIO接口协议的原理和使用方法,并参考源代码示例进行实际的开发和应用。具体的初始化方法与单片机的型号和开发环境有关,可以参考相应的单片机手册和开发工具的文档。(1)发送读取命令:向MDIO线发送读取命令,通常是发送一个特定的控制字节,用于指示要读取的寄存器地址。(1)发送写入命令:向MDIO线发送写入命令,通常是发送一个特定的控制字节,用于指示要写入的寄存器地址。二、MDIO接口协议使用方法。

web_class282的博客 2627

揭秘DeepSeek内幕:清华教授剖析AI模型技术原理

从 ChatGPT 到各种新兴的 AI 模型,每一次技术突破都能引发广泛的关注和讨论——而最近 AI 界的“新宠”,无疑是 DeepSeek。在本文中,清华大学长聘副教授将深入剖析 DeepSeek R1 背后的大规模强化学习技术及其基本原理,并进一步展望大模型技术未来的发展方向。今日阅读福利:完整版 Deepseek从入门到精通附最全指令汇总+各版本安装包+一键整合包【277G】在公众号开源L...

关注微信公众号【开源Linux】,后台回复『10T』,领取10T学习资源大放送,涵盖Linux、虚拟化、容器、云计算、网络、Python、Go等书籍和视频 939

安卓App开发 篇三:Android SDK和API

Jetpack 是一个由多个库组成的套件,可帮助开发者遵循最佳做法、减少模板代码并编写可在各种 Android 版本和设备中一致运行的代码,让开发者可将精力集中于真正重要的编码工作。hl=zh-cnhl=zh-cnWorkManager 是 Android Jetpack 的一部分,是用于持久性工作的推荐解决方案,适用于需要通过应用重启和系统重新启动来调度的工作,也是后台处理操作的主要推荐 API。立即执行:必须立即开始且很快完成的任务,可以加急,使用和Worker,通过对调用处理加急工作。

生活在别处 1288

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Qwen3.5跨语言思维链实战:从提示工程到微调,实现中文提问英文推理

大语言模型(LLM)的推理能力是其核心价值之一,而思维链(Chain-of-Thought, CoT)技术通过让模型展示逐步推理过程,极大地提升了其复杂问题解决的可解释性和准确性。在工程实践中,如何精确控制模型的输出行为,例如引导其使用特定语言进行推理,是一个常见挑战。这涉及到对模型底层生成机制的理解,包括其基于概率的token生成、上下文依赖以及指令遵循能力。通过系统性的方法,如精心设计的提示工程、利用对话格式中的系统指令、调整生成参数乃至进行轻量级微调,开发者可以有效地塑造模型的输出,满足特定的应用需求

weixin_33859844的博客 403

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

DeepChat实战:Llama3驱动的私有化AI对话服务一键部署

本文介绍了如何在星图GPU平台上自动化部署🧠 DeepChat - 深度对话引擎镜像,快速构建基于Llama 3的私有化AI对话服务。用户无需手动配置环境或下载模型,5分钟内即可启动本地Web界面,典型应用于企业内部知识问答、法律/医疗等敏感场景下的安全合规对话交互。

weixin_35756373的博客 101

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

如何免费跑通Qwen3-1.7B-GGUF:llama.cpp本地部署完整教程

Qwen3-1.7B-GGUF 是阿里 Qwen3 系列中参数仅 1.7B 的轻量语言模型 GGUF 量化版本,借助 llama.cpp 即可在普通电脑上**免费本地部署**,无需 GPU、无需付费 API。本教程带你从 0 到 1 在本地跑通 Qwen3-1.7B-GGUF,支持思考/非思考双模式,全程约 10 分钟。 ## 一、Qwen3-1.7B-GGUF 是什么?值得本地跑吗? **G

gitblog_00100的博客 82

G0DM0D3 OpenRouter 60个模型选型指南:按场景分类的快速选择

**G0DM0D3** 是一款开源、隐私透明的多模型 AI 聊天工具,内置 **OpenRouter 60 个模型** 的五档竞速引擎(ULTRAPLINIAN)。面对 60 个模型不知怎么选?本文按场景把模型分成 ⚡FAST、🎯STANDARD、🧠SMART、⚔️POWER、🔱ULTRA 五层,帮你 30 秒内锁定最合适的档位——从免费档日常聊天到前沿模型全量竞速,一文讲清。 ## 一、

gitblog_01076的博客 621

G0DM0D3多模型竞速策略:混合OpenRouter与Venice扩充你的竞技场

G0DM0D3 是一款开源的 **LIBERATED AI CHAT** 多模型聊天工具,内置 ULTRAPLINIAN 多模型竞速引擎:它会把同一个问题同时发给多个 AI 模型,按 100 分制综合评分后选出最佳回答。本文带你快速上手 G0DM0D3 多模型竞速策略,教你混合 OpenRouter 与 Venice 两条模型通道,把你的模型竞技场从 12 个一路扩充到 100+ 个选手,并附本地

gitblog_00972的博客 653
上一篇: NLP 面试八股:“Transformers / LLM 的词表应该选多大?“ 学姐这么告诉我答案
下一篇: Transformer推理结构简析(Decoder + MHA)
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值