NLP 面试八股:“Transformers / LLM 的词表应该选多大?“ 学姐这么告诉我答案

智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs 这是在智谱AI开发者大会上推出的新一代基座大语言模型,GLM4相比较此前最大的特点是三个变化:性能全面提升、上下文长度更长、支持更强的多模态能力。GLM4(GLM4)详细信息 | 名称、简介、使用方法,开源情况,商用授权信息 | 数据学习 (DataLearner) 阅读详情

题目:

Transformers/大模型的 token vocabulary 应该选多大?

答案

先说一下结论:

  1. 数据量够大的情况下,vocabulary 越大,压缩率越高,模型效果越好。
  2. 太大的 vocabulary 需要做一些训练和推理的优化,所以要平衡计算和效果。
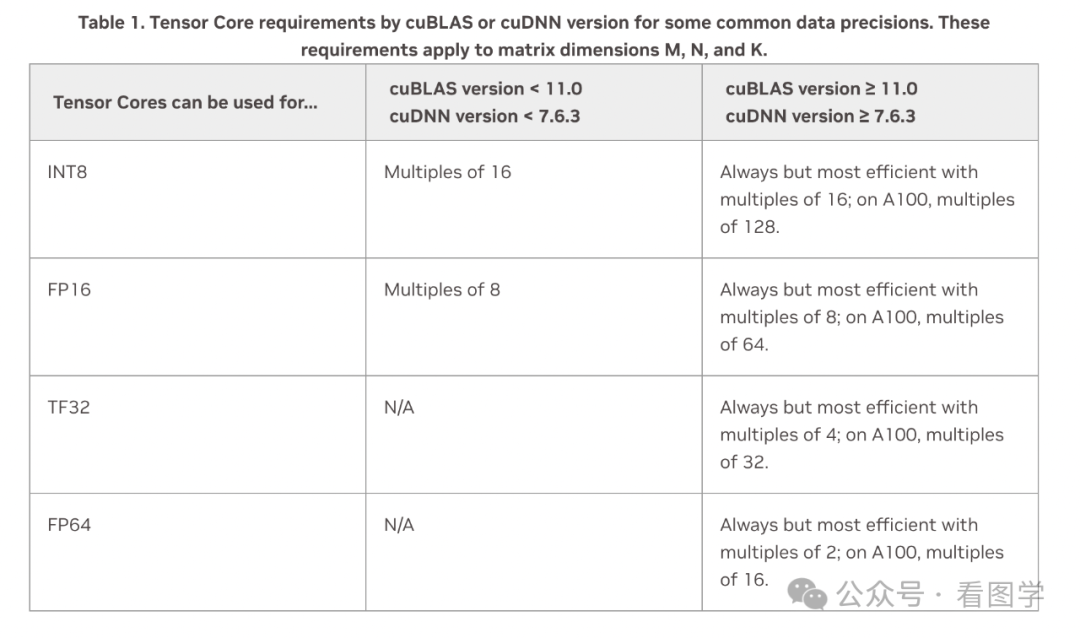
  3. 要考虑内存对齐。vocabulary 的大小设置要是 8 的倍数,在 A100 上则是 64 的倍数。(不同的GPU可能不一样)

下面分别说一下这三点.

越大越好

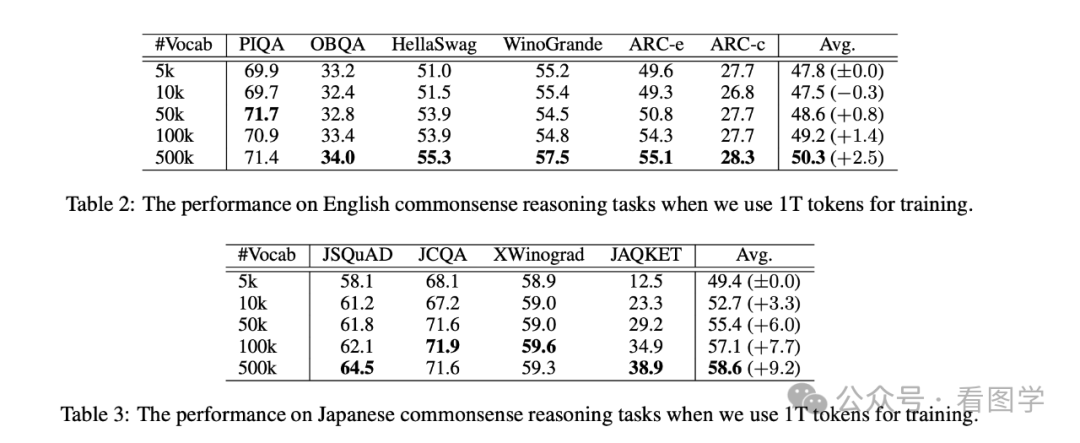
目前已经有很多研究表明,词表越大模型效果会更好。 比如最近刚发的一篇《Large Vocabulary Size Improves Large Language Models》,里面就详细对比了词表大小分别为:5k, 10k, 50k, 100k and 500k 的效果。如下图所示
img

注意这里是完全从头训练的 GPT-3 Large 模型,模型的参数量为 760M。

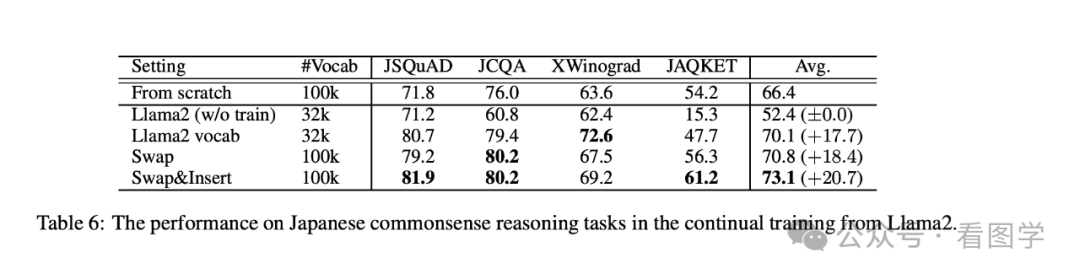
然后作者还尝试了在 llama 的基础上扩大词表继续训练,扩大了词表后效果依然有提升。如下表所示:
img

为什么词表变大会更好?个人觉得有如下几个原因:

计算效率的提升

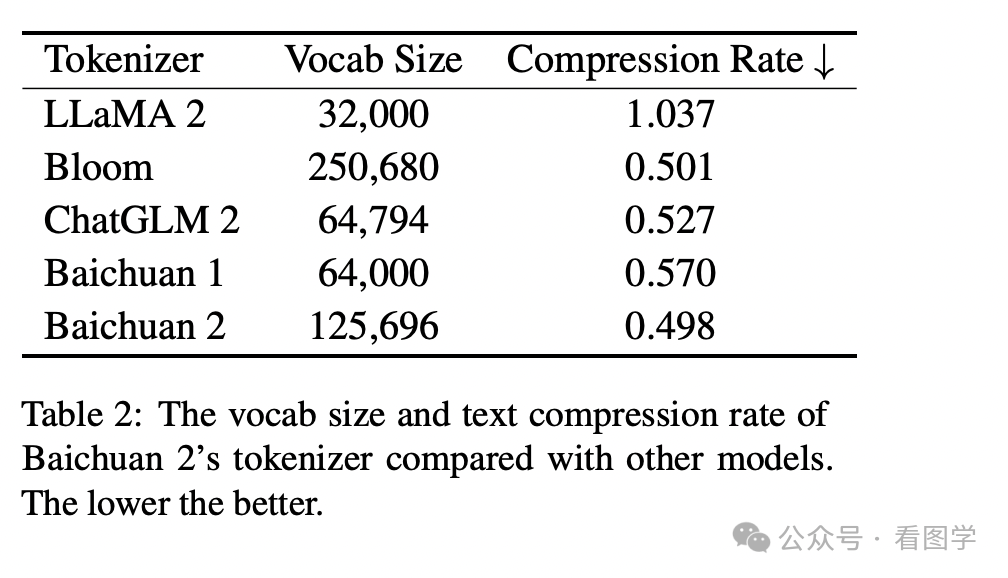
相同的文本,转换为token后越短越好。通常用压缩率来衡量文本转换为token后的压缩比例。

更高的压缩率代表了相同数量的token能够表达更多的信息,相同的信息 token 越短则训练效率更高。

Baichuan 在技术报告里给出的一些模型的压缩率如下
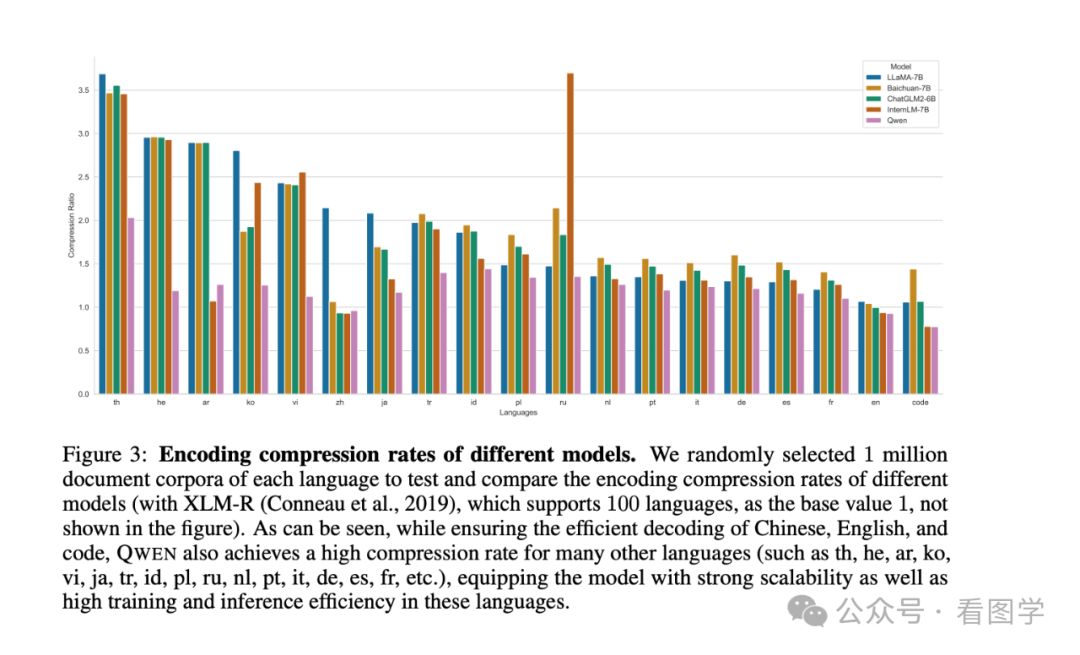
img然后千问在技术报告里也提到自家模型的压缩率比其他家更好。

img

有助于理解文本

更多的词汇能够减少 OOV (Out of Vocabulary)的影响, 训练的信息不会丢失,推理的时候泛化能力也更强。

同时更多的词汇可以减少词汇分解后的歧义,从而更好地理解和生成文本。

更长的上下文

预训练阶段往往都有最大序列长度的限制,压缩率更高代表着能看到更多的上下文,就能 attention 到更多的信息。

还有一些论文比如《Impact of Tokenization on Language Models: An Analysis for Turkish》等也有类似的结论。

计算效率的考虑

虽然 vocabulary 越大越好,但是也不能无限扩大。因为 vocabulary 变大后,Embedding 层变大,最后输出的 Head layer 也会变大。比如 Llama3 将 vocabulary 从 llama2 的 32000 扩展到 128256,参数量就变大了。llama2 还不到7B,但是 Llama3 有 8B了(当然这里面还有其他参数的改动)。

参数更大,更占内存,而且输出的时候 softmax 也更大,计算就更慢。虽然大多数情况下 token 量的减少,整体上是算得更快的。

所以也不能设置得过大,目前业界普遍设置在 10万 到 20万左右。比如 Qwen 的 词表大小为 152064,baichuan2为125696,llama3 为128256,deepseek 为 102400。

多模态的会更大一些。

当然 softmax 过大的问题目前也有解法,可以用 Adaptive softmax,参考论文《Efficient softmax approximation for GPUs》。

内存对齐

之前就有人看到 qwen 的readme 和 训练代码中 vocabulary 的数量不一样, readme 中为 151643,但是实际上代码里写的是 152064。

这就是为了内存对齐。所以很多时候模型上的一些设置其实跟硬件息息相关。

因为最终Embedding 矩阵和输出时候的 Head Layer 最终都会转换成矩阵放到 GPU 的 Tensor Core 中计算。而根据英伟达的开发手册,矩阵运算最好根据 GPU 和计算类型满足如下的条件:
img

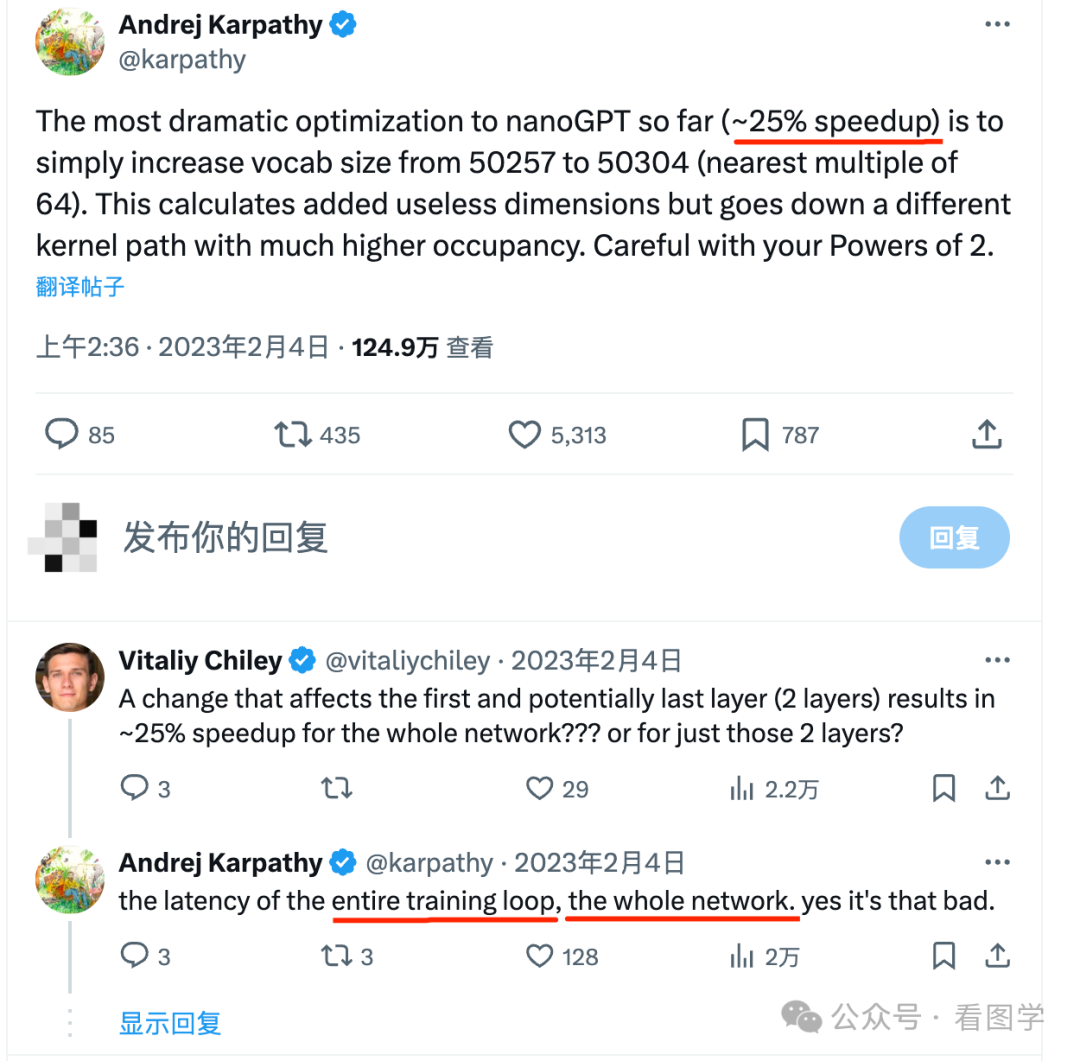
Karpathy 也曾经证实了这一点,他当时写了个 nanoGPT,提升最大的点就是把词表从 50257 改成了 50304,后一个是64的倍数。然后带来了25%的速度上的提升。
img

所以目前大多数训练都在 A100 上训练,所以基本上都是64的倍数。如果某个模型的词表不是 64的倍数,那可能不知不觉浪费了很多计算资源。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

用ollama本地部署Lamma3.1 ollama create 自定义模型名字 -f Modelfile。让lamma3.1写一个贪吃蛇小游戏,一次run成功。例如:ollama run llama3.1。例如:ollama run llama3.1。 阅读详情

相关推荐

Windows 中 利用 ollama 来搭建 deepseek R1

近年来,大模型凭借其强大的语言理解和生成能力,在自然语言处理、计算机视觉等领域取得了突破性进展。从GPT系列到国内的,文心一言、[Qwen]、,大模型已成为推动人工智能发展的核心力量。ollama作为新兴的大模型搭建工具,以其开源、高效、易于部署的特点,在人工智能开发者社区中崭露头角,为大模型的搭建和应用提供了新的解决方案。在当今数字化浪潮中,人工智能的发展可谓日新月异,而大模型作为其核心驱动力,正重塑着各个行业的格局。

一个专注于机器学习基础与实战的技术博客,内容涵盖算法推导、模型实现、数学原理与代码实践。用通俗的语言解析复杂概念,记录学习过程中的思考与总结,适合机器学习爱好者和从业者参考。 2554

使用 Ollama 本地运行各种 LLM

今天看看另外一个产品Ollama。Ollama 的安装非常简单,只需从官网(https://ollama.com/download)下载后解压缩,并在 Terminal 中运行脚本即可完成环境设置。我尝试运行 Llama3,虽然在运行时占用了大量电脑资源,使得其他应用运行变慢,但整体体验尚可。Ollama 支持多种大型语言模型(https://ollama.com/library)。

python123456_的博客 1736

2024最新最全【大模型学习路线规划】零基础入门到精通!

数学基础:学习线性代数、微积分、概率论与数理统计等基础知识。这些数学基础对于理解大模型的原理和算法至关重要。编程语言:熟练掌握Python编程,这是大模型开发的首选语言。同时,了解常用的深度学习框架,如TensorFlow和PyTorch。深度学习基础:学习深度学习的基本原理和常用算法,如神经网络、卷积神经网络、循环神经网络等。Transformer模型:深入理解Transformer的原理、结构及其变种。

yXIAOyu_的博客 2973

AI大模型探索之路-基础篇5:GLM-4解锁国产大模型的全能智慧与创新应用

随着人工智能技术的飞速发展,大型预训练语言模型已成为推动行业进步的重要力量。它们在理解自然语言、生成文本、执行复杂任务等方面展现出惊人的能力。在此背景下,国产大模型GLM-4的问世,不仅展现了中国在AI领域的实力,也为国内外研究者和开发者提供了新的研究与应用平台。

寻道AI,探索AI无限可能! 8685

YOLOv8缺陷检测可视化界面实战:PyQt5布局设计与代码实现

本文详细介绍了如何利用PyQt5为YOLOv8缺陷检测模型构建一个专业、易用的可视化界面。通过实战讲解PyQt5的布局管理器设计、信号槽机制与YOLOv8核心的集成,帮助开发者快速将AI模型部署为直观的桌面应用,提升工业质检等场景的落地效率。

redis7keeper的博客 758

基于EKF的UWB-IMU融合定位系统在农业机器人中的抗干扰优化与Matlab仿真

本文探讨了基于扩展卡尔曼滤波(EKF)的UWB-IMU传感器融合定位系统在农业机器人中的应用。通过Matlab仿真验证,该系统有效解决了农业环境中UWB信号遮挡和IMU累积误差问题,实现了厘米级高精度定位,显著提升了机器人在复杂场景下的抗干扰能力和导航可靠性。

numpy6sculptor的博客 625

智谱AI GLM4开源!快速上手体验

GLM-4-9B 是智谱 AI 推出的最新一代预训练模型 GLM-4 系列中的开源版本。在语义、数学、推理、代码和知识等多方面的数据集测评中,GLM-4-9B 及其人类偏好对齐的版本 GLM-4-9B-Chat 均表现出较高的性能。GLM-4-9B 模型具备了更强大的推理性能、更长的上下文处理能力、多语言、多模态和 All Tools 等突出能力。

IT大头的博客 4359

计量经济学(因果关系探究-空间双重差分模型: 破解空间溢出效应的因果分析工具)

本文介绍了传统双重差分(DID)模型及其局限性,重点阐述了空间DID模型的必要性。传统DID通过组间差分分离干预效应,但无法处理空间溢出效应。空间DID模型引入空间计量方法,包括三种类型:空间自回归模型(SDID-SAR)捕捉因变量溢出,空间误差模型(SDID-SEM)处理残差相关性,空间杜宾模型(SDID-SDM)同时考虑因变量和自变量的空间滞后。模型选择需结合空间相关性检验,适用于环境政策、房地产限购等存在空间交互效应的研究场景。

YBAdvanceFu的博客 2033

大模型学习路线(2025最新)从零基础入门到精通,看完这一篇就够了

以下为你详细介绍 2025 年从零基础入门到精通大模型的学习路线。

优快云_224022的博客 6023

DeepSeek网页版和DeepSeek Harness

DeepSeek网页版是开箱即用的对话工具,适合快速问答与日常任务;而DeepSeekHarness(dsh)是基于Node.js的开源智能体框架,支持文件操作、命令执行、多工具协同,实现“对话即执行”。二者定位不同:网页版为“大脑”,Harness为“躯体”。前者封闭易用,后者开放可扩展,具备可追溯的执行日志与插件化架构。未来,网页版将聚焦轻量化普及,Harness则致力于构建生态平台。对开发者而言,应将AI作为执行层,守住决策层,深耕垂直领域,并掌握AI工作流设计能力,以构建不可替代的技术优势。

几十年资深高级架构师,技术专家的技术笔记。专注C、Java、Python、微服务、云原生、AI工程化及高并发系统分布式架构实战,分享源码剖析、性能调优与架构治理经验。 939

5G无人机安全研究综述

国内多所高校提出混合信任模型,南京航空航天大学于2020年提出了起源信息感知的无人机网络信任模型[26],模型基于报文的完整性对报文创建和操作节点的行为评判并生成观测证据,收集证据进行信任评估,识别网络中的恶意节点并进行路由隔离,实现准确的对等信任评估。同时,5G技术的高速率、高可靠性、低时延等特点,能够为无人机提供实时高清图像回传,保证通信网络的稳定,拓展无人机飞控距离限制,丰富了5G无人机的应用场景。5G和无人机技术的融合,丰富了传统无人机的应用服务场景,然而5G无人机仍存在安全隐患。

weixin_70923796的博客 767

ChatGLM4重磅开源! 连忙实操测试一波,效果惊艳,真的好用!

GLM-4-9B是智谱AI在24年6月5日推出的开源预训练模型,属于GLM-4系列。之前已开源chatglm1~chatglm3等多个版本。GLM4在语义理解、数学、推理、编程和知识等领域的测试中表现优异。GLM-4-9B-Chat是其人类偏好对齐版本,支持多轮对话、网页浏览、代码执行、自定义工具调用(function call)以及长文本推理(最大128K上下文)。该系列模型还支持26种语言,包括日语、韩语和德语,并推出了支持1M上下文长度(约200万中文字符)的版本。GLM-4-9B 系列模型主要包含:

2401_84206094的博客 2020

华为OD机试真题2026双机位C卷 Python&JS 实现【明日之星选举】

给定一组选票votes。votes[i]代表第 i 张选票的内容,包含一个字符串"zhangsan,hanmei",表示推荐zhangsan为明日之星,反对 hanmei 称为明日之星。赞成或反对使用逗号(,)分割。 给定一个数组n,表示最后将筛选出赞成票最多的n个人,如果赞成票相同,则反对票越少,排序越靠前;如果赞成票和反对票都相同,则按照姓名字典序升序排序。

MISAYAONE的博客 322

2024最新最全【大模型学习路线规划】零基础入门到精通

目标:了解大模型的基本概念和背景。内容:人工智能演进与大模型兴起。大模型定义及通用人工智能定义。GPT模型的发展历程。目标:深入学习大模型的关键技术和工作原理。内容:算法的创新、计算能力的提升。数据的可用性与规模性、软件与工具的进步。生成式模型与大语言模型。Transformer架构解析。预训练、SFT、RLHF。目标:掌握大模型开发所需的编程基础和工具。内容:Python编程基础。Python常用库和工具。提示工程基础。目标:通过实战项目深化理论知识和提升应用能力。

m0_70486148的博客 2130

【数据集7】全球人类住区层GHSL数据详解

全球人类住区层GHSL数据详解

WW、forever的博客 2255

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

大模型学习路径(非常详细)零基础入门到精通,收藏这篇就够了_大模型语言的学习路径

在掌握机器学习之前,理解支撑这些算法的基本数学概念非常重要。:这是理解许多算法(特别是深度学习算法)的关键。主要概念包括向量、矩阵、行列式、特征值和特征向量、向量空间以及线性变换。:许多机器学习算法涉及到连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分以及梯度的概念也很重要。:这些知识对于理解模型如何从数据中学习并进行预测至关重要。主要概念包括概率理论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。

HUANGXIN9898的博客 2459

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

大模型学习路线入门到精通,非常详细收藏我这一篇就够了!

理论其实就是一套描述和解决问题的方法论,只不过不同的技术有不同的方法,也就是理论。‍‍‍‍‍‍‍‍‍‍理论的发展有两种方式,一种是基于实践检验结果总结出来的经验;二种是以严谨的科学理论推导出逻辑自洽的解决某个问题的方法。‍‍‍‍‍‍‍比如说,火是人类生存和进化的重要条件之一,而在远古时期人类对于火的认知还比较浅显,因此那时关于火的理论也比较基础,比如它可以取暖,可以烤熟食物等;这就是基于经验的理论基础。‍‍‍‍。

jennycisp的博客 2513

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

打破小模型极限:Phi-4如何在推理任务中超越GPT-4 | Command R7B:小模型,大用途,企业AI的高效新选择

大模型领域的发展日新月异,每天都有许多有趣的论文值得深入品读。下面是本期的论文:1、打破小模型极限:Phi-4如何在推理任务中超越GPT-42、Command R7B:小模型,大用途,企业AI的高效新选择1、打破小模型极限:Phi-4如何在推理任务中超越GPT-4Phi-4:用高质量合成数据重新定义小模型能力Phi-4 是微软推出的最新14亿参数语言模型,专为推理任务设计。与传统模型依赖网络数据预训练不同,Phi-4 创新性地将高质量合成数据贯穿训练过程,并在关键阶段优化数据混合。

m0_59164304的博客 944

[大模型]GLM4-9B-chat Lora 微调

LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。task_type:模型类型:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。rlora的秩,具体可以看Lora原理lora_alphaLora alaph,具体作用参见Lora原理Lora的缩放是啥嘞?当然不是r(秩),这个缩放就是, 在这个LoraConfig中缩放就是 4 倍。

FL1623863129的博客 4440

【大模型部署】MAC OS 本地搭建部署 dify

Dify 是一个开源的大语言模型(LLM)应用开发平台,融合了后端即服务(Backend as Service, BaaS)和 LLMOps 理念,旨在简化和加速生成式AI应用的创建和部署。

DEVELOPERAA的博客 6038

一文读懂大模型中的token

学习大模型的朋友肯定听说过大模型接口按token,自己编写代码的时候也经常看到token这个词,那它究竟是什么呢,我们一起来探究一下在大模型中,token不一定是一个完整的词。它可以是一个词、一部分词、字符甚至是标点符号。这取决于所使用的分词方法。子词分词方法(如 BPE 和 WordPiece)在现代 NLP 模型中非常常见,因为它们能够高效地处理各种语言现象,同时保持词汇表的紧凑性。带有空格前缀(如Ġworld)和不带空格前缀(如world。

2401_85378759的博客 8317

据说逼近GPT-4?国内大模型 ChatGLM4 尝鲜体验

本人从一开始ChatGLM-6B时,就一直关注这个模型。今天,智谱AI在DevDay技术开放日活动上发布了全新升级的ChatGLM4模型,这必须得体验一波。

白天安全建设,晚上全栈开发,大模型爱好者。公众号:飞羽技术工坊。 6160

GLM4模型详解 - 智谱AI开源大模型全面解析

智谱AI开源协议发布时间: 2024年6月5日开源版本: GLM-4-9B系列支持语言: 26种语言在超长上下文处理方面有突出优势提供了丰富的工具调用能力多模态能力设计优雅部署要求相对合理新手建议从Chat版本开始需要处理长文本选择1M版本图像处理任务使用V版本重视提示词设计优化效果希望这篇文章能帮助你更好地了解和使用GLM4模型!

携梦问道的博客 6130

【GLM-4部署实战】GLM-4-9B-Chat模型本地部署实践指南

在人工智能的浪潮中,深度学习模型的部署已成为技术研究和实践的热点。自然语言处理(NLP)领域,尤其是对话系统,正迅速成为智能应用的核心。GLM-4-9B-Chat模型以其卓越的语言理解与生成能力,为构建智能对话系统提供了坚实的基础。然而,模型的部署并非易事,它涉及到环境配置、依赖管理、代码编写等多个环节。本文将通过本地模型推理和OpenAI API风格服务发布测试,带你一步步完成GLM-4-9B-Chat模型的部署实践,让你对深度学习模型的部署有一个全面而深入的理解。

寻道AI,探索AI无限可能! 1万+
上一篇: 2024外网传疯了的LLM大模型书籍:从零构建大型语言模型,标星20.6K,还没出版就爆火的神作
下一篇: g1:基于 Llama,用提示工程实现类似 o1 的深度推理
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值