基于细颗粒度注意力的层次Transformer在表格类时序中的应用

2024表格数据深度学习模型综述 论文地址:https://arxiv.org/abs/2410.12034表格数据在医疗、金融和交通等行业广泛使用,由于其异质性和缺乏空间结构,给深度学习带来了独特的挑战。本调查回顾了针对表格数据的深度学习模型的发展,从早期的全连接网络(FCNs)到先进的架构如TabNet、SAINT、TabTranSELU和MambaNet。这些模型结合了注意力机制、特征嵌入和混合架构,以应对表格数据的复杂性。 阅读详情
AI摘要

本文提出新型细粒度层次化模型Fieldy,用于处理表格时间序列数据。它通过两阶段架构,结合行和列变换器,能捕获字段间复杂关系。与现有模型对比,在回归和分类任务中性能有提升。此外,还分享了AI大模型学习资料和商业化落地方案。

Content

本文介绍了表格时间序列数据在多个实际应用中的重要性,并提出了一种名为 Fieldy 的新型细粒度层次化模型,该模型通过在行和列级别上对字段进行上下文化,以捕捉字段间的复杂关系。通过与现有最先进模型在回归和分类任务上的比较,展示了 Fieldy 在性能上的提升。

1. 引言 (Introduction)

顺序表格数据在工业中应用广泛,如银行数据库中的金融交易记录、医院存储的医疗记录或 CRM 系统中的客户购买历史。表格时间序列数据与传统多变量时间序列数据存在不同之处,特别是表格时间序列数据中记录跨越多行且包含时间相关字段。此外,文章还涉及了变换器架构在表格数据处理中的应用,以及这些架构如何通过注意力机制学习时间步骤之间的关系模式,从而在表格数据建模中提取有意义的模式。

2. 相关工作 (Related Work)

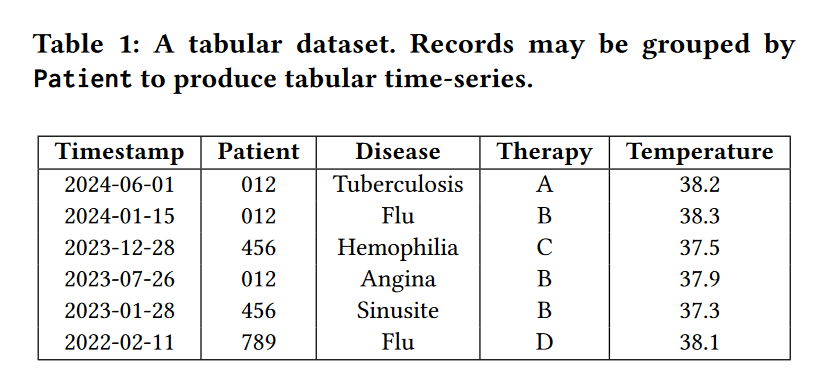
文章首先关注标准表格数据的深度学习方法,然后转向表格时间序列的特殊案例。以表格1为例,展示了如何将表格时间序列视为具有时间依赖性的记录集合,这些记录可以被机器学习模型作为输入。
图片

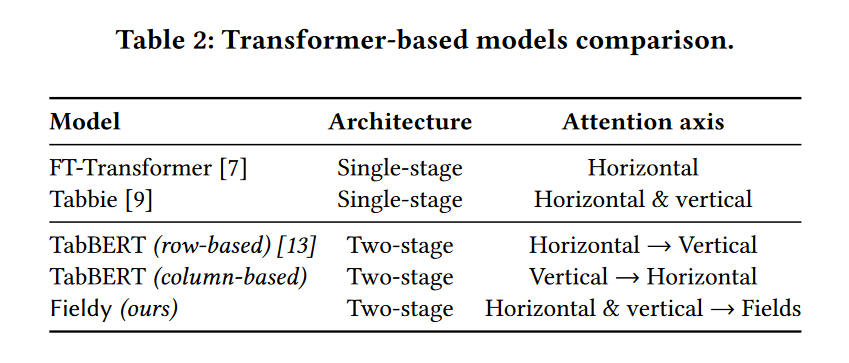
文章中提到了变换器模型在表格时间序列建模中的应用。FT-Transformer 模型通过计算行内字段间的注意力来对每行进行编码。Tabbie 模型则通过平均行和列的表示来编码每个表格字段,形成上下文化的字段表示。TabBERT 模型采用两阶段变换器架构,首先分别编码行或列,然后处理这些编码来生成整个表格时间序列的表示。
图片

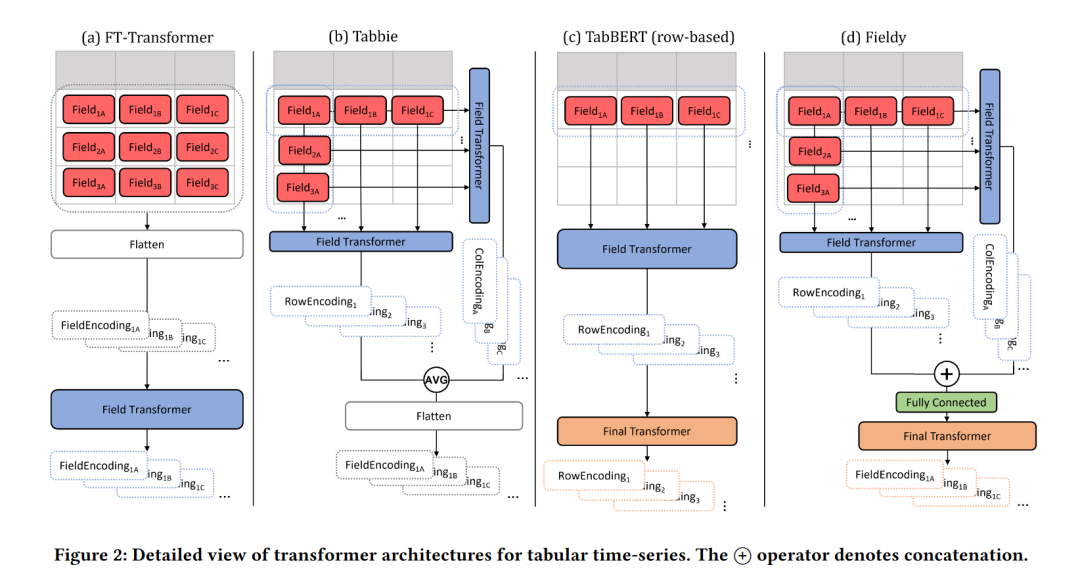
FT-Transformer 模型是单阶段架构,设计用于传统表格数据。它通过计算单个行内所有字段间的注意力来捕获字段间的关系。Tabbie 模型也是单阶段架构,但它通过行和列的上下文来编码每个字段,然后通过最终的全连接层处理每行。TabBERT 模型是两阶段架构,可以是行基或列基,分别在第一阶段编码行或列,然后在第二阶段处理编码后的行或列以生成整个序列的表示。

文章还指出了现有层次化方法的局限性,即它们无法同时捕获行和列的维度信息。Fieldy 模型通过在第一阶段结合行和列变换器来学习字段表示,旨在解决这一问题。Fieldy 模型在第二阶段通过最终变换器处理整个表格时间序列,以捕获跨行和列的字段间关系。

此外,文章还讨论了如何将 Fieldy 模型与现有文献中的行基和列基层次化变换器进行比较,以及如何通过引入位置嵌入来编码表格结构,以便在模型中保留行和列的顺序信息。这些位置嵌入对于 Fieldy 模型尤为重要,因为它不像行基或列基模型那样默认包含表格结构。
图片

3. 方法论 (Methodology)

本章深入探讨了现有表格时间序列建模方法的局限性,并提出了一种新的层次化方法,即 Fieldy 模型,以解决这些限制。

首先,分析了现有层次化模型,如 FT-Transformer 和 Tabbie,以及它们在处理表格时间序列时的不足。FT-Transformer 通过将输入序列展平为一行,然后计算所有字段间的注意力,忽略了表格结构。Tabbie 则通过行和列的上下文来编码每个字段,但缺乏第二阶段来关联所有字段。

Fieldy 模型采用两阶段架构。在第一阶段,使用两个并行的 Field 变换器,一个负责按行上下文化每个字段,另一个负责按列上下文化每个字段。这样,可以同时捕获行内和列内的交互。编码后的行和列被连接起来,形成字段表示,然后通过一个全连接层,为第二阶段生成丰富的表示。

第二阶段的最终变换器处理所有字段表示,以生成整个表格时间序列的最终编码。这样,Fieldy 能够在不同行和列之间捕获细粒度的字段关系。

为了使 Fieldy 模型能够理解表格结构,引入了行位置和列索引的位置嵌入。在将上下文化的字段传递给最终变换器之前,将这些位置嵌入添加到每个字段中。这使得最终变换器能够了解每个字段在原始行和列中的位置。

此外,为了确保与其他模型的公平比较,还在所有其他模型中引入了行位置和列索引嵌入。通过这种方式,Fieldy 模型能够在不增加模型大小的情况下,通过细粒度的注意力机制捕获跨行和列的字段关系。

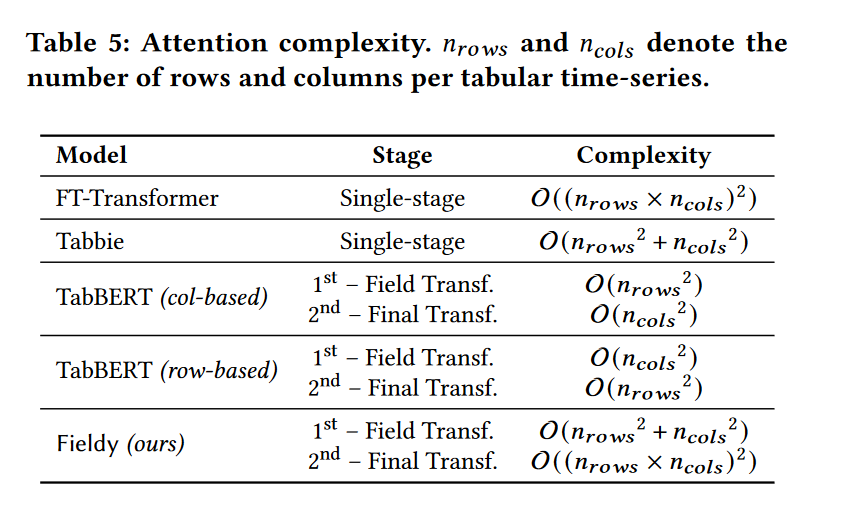
最后,第3章还讨论了 Fieldy 模型相对于其他层次化模型的计算复杂性。虽然 Fieldy 模型在训练和推理时需要更多的计算资源,但可以通过采用近线性时间注意力技术来提高效率。

4. 评估 (Evaluation)

本章聚焦于对提出的 Fieldy 模型及其他变换器架构在表格时间序列数据上的性能评估。

4.1 数据集 (Datasets)
  • 污染数据集 (Pollution): 用于回归任务,基于北京的空气污染数据,预测基于小时级测量的 PM2.5 和 PM10 浓度。数据集包括温度、压力等10个特征,经过量化处理,并添加了测量站点名称、小时、日期等额外特征。
  • 贷款违约数据集 (Loan default): 用于分类任务,包含捷克银行的交易记录,目标是预测客户是否会违约。数据集经过预处理,包括特征量化和时间戳分割,并引入了工作日特征。
4.2 模型 (Models)
  • 架构 (Architectures): 比较了三种层次化变换器模型:基于行的 TabBERT、基于列的 TabBERT 和提出的 Fieldy 模型。为了公平比较,所有模型的参数数量保持一致,Fieldy 模型通过减少其第一阶段的层数来匹配参数量。
  • 基线模型 (Baselines): 包括单阶段的 FT-Transformer 和 Tabbie,以及传统的机器学习模型 XGBoost 和线性模型,作为深度学习模型的对比。
  • 比较性 (Comparability): 实现了统一的预训练和微调策略,使用了一个简单的字段掩蔽预训练任务,并在微调阶段采用了标准技术,确保所有模型在相同条件下进行评估。
4.3 结果 (Results)
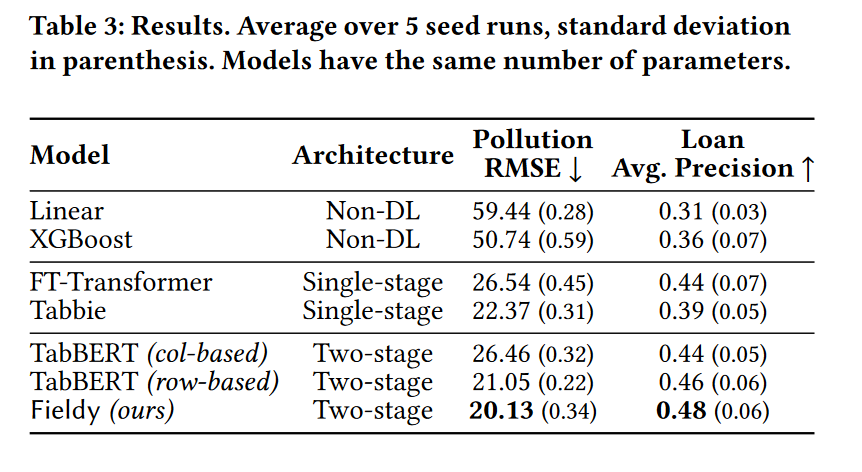
  • 在污染数据集上,Fieldy 模型显著降低了均方根误差(RMSE),显示出其方法的有效性。
  • 在贷款违约预测任务上,虽然性能提升不明显,但所有变换器模型均优于传统基线模型。
图片

4.4 消融研究 (Ablation Study)
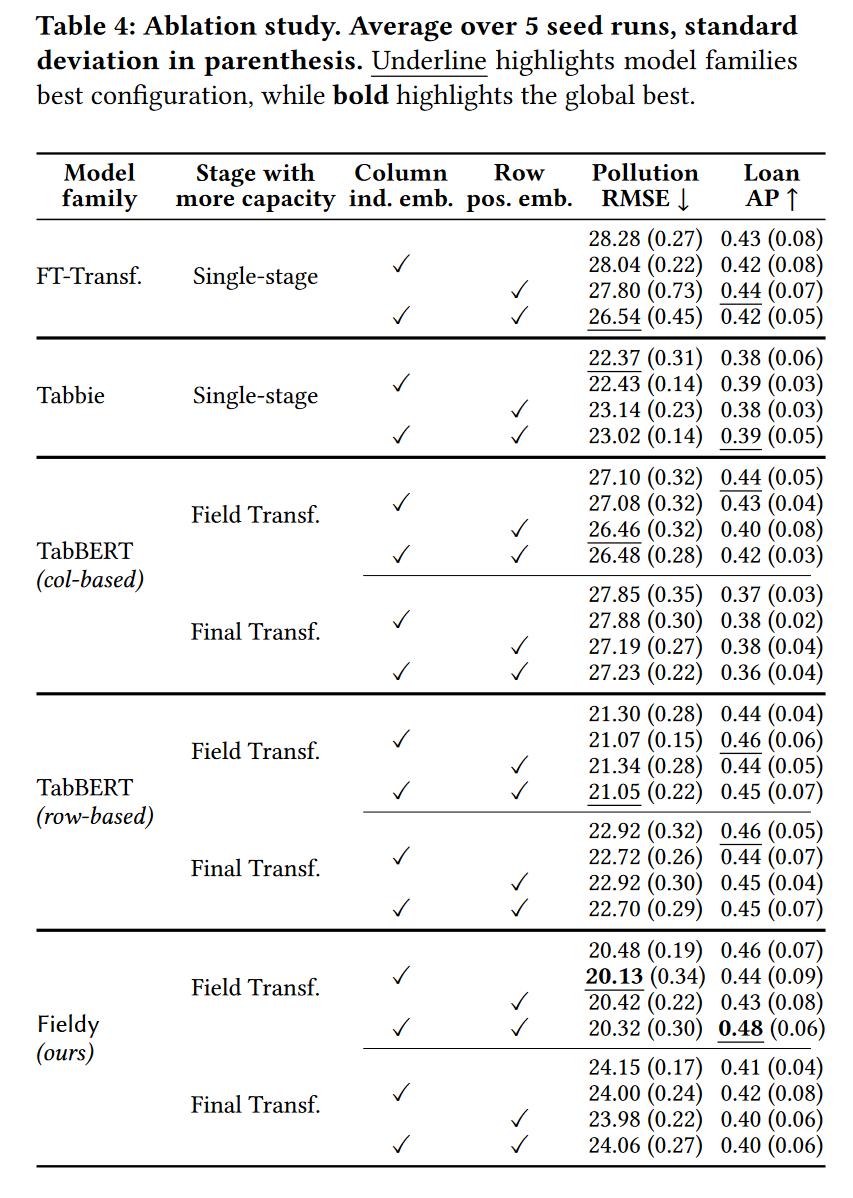
  • 分析了模型不同阶段的容量分配对性能的影响,发现当第一阶段(字段变换器)具有更多容量时,模型性能更佳。
  • 探讨了位置嵌入对模型性能的影响,发现对于大多数模型来说,明确提供表格结构信息(如行位置和列索引)是有益的。
图片

5. 结论和讨论 (Conclusion and Discussion)

本文指出 Fieldy 模型在表格时间序列任务中通过细粒度的注意力机制捕获跨行和列的字段关系,从而实现了性能上的提升。同时,章节提出了未来工作的方向,包括考虑计算成本、在更多样化的数据集上评估模型以及探索与传统时间序列预处理技术结合的可能性,为后续研究提供了新的思路和改进空间。
图片

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

AI Studio vLoong能源AI挑战赛——异常检测赛A榜第三名方案 异常检测赛 阅读详情

相关推荐

FTTransformer:让Transformer在表格数据上也能‘拳拳到肉’

本文深入探讨了FTTransformer模型如何将Transformer架构成功应用于表格数据,通过特征令牌化等创新设计,解决了传统方法在处理复杂特征交互时的局限性。文章详细介绍了FTTransformer的核心思想、架构调整及实战应用,展示了其在植被覆盖预测等任务中超越LightGBM的性能表现,为表格数据分析提供了新的深度学习解决方案。

weixin_29174385的博客 553

FTTransformer,一个很能打的模型

FTTransformer,是一个BERT模型架构在结构化数据集上的迁移变体。和BERT一样,它非常能打。它可能是少数能够在大多数结构化数据集上取得超过或者匹配LightGBM结果的深度模型。本范例我们将应用它在来对Covertype植被覆盖数据集进行一个多分类任务。我们在测试集取得了91%的准确率,相比之下LightGBM只有83%的准确率。公众号算法美食屋后台回复关键词:torchkeras,...

Python_Ai_Road的博客 5364

基于细颗粒度注意力,层次 Transformer 在表格时序的应用

本文介绍了表格时间序列数据在多个实际应用中的重要性,并提出了一种名为 Fieldy 的新型细粒度层次化模型,该模型通过在行和列级别上对字段进行上下文化,以捕捉字段间的复杂关系。通过与现有最先进模型在回归和分类任务上的比较,展示了 Fieldy 在性能上的提升。

weixin_70955880的博客 1453

论文代码阅读及部分复现:Revisiting Deep Learning Models for Tabular Data

现有的关于表格数据做深度学习的模型层出不穷,但是作者认为,由于在真实使用模型时有着不同的基准以及实验场合,这些提出的模型没有被很好地比较。因此,论文作者在论文中对各类模型进行了综述,并且自身提出了一个对Transformer作简单改进的模型:FT-Transformer,最终将ResNet-like类模型、Transformer-like类模型以及其他MLP模型在不同的数据集上训练、对比效果,最终确定了一个较好的衡量针对表格数据的深度学习模型的标准(bennchmark)。

thorn_r的博客 3704

3.18双通道、粗细颗粒(MG-ResNet&MG-Transformer。科、属)

数值示例。

m0_53850135的博客 926

PETR:Transformer不甘落后,也能端到端地估计姿态,达到SOTA性能#CVPR2022 Oral#

流行的人体估计算法主要有两种分类:自下而上(先检测关节点,再把关节点关联合成人体)或自上而下(先检测人体再估计他的关节点)。继YOLO框架(实时的流行的目标检测器)内含端到端地检测Pose后,Transformer框架也能端到端地实现姿态估计。......

wqthaha的专栏 3934

一文详解Vision Transformer(附代码)

©PaperWeekly 原创 ·作者 | 孙裕道单位 | 北京邮电大学博士生研究方向 | GAN图像生成、情绪对抗样本生成引言Transformer 在 NLP 中大获成功,Visio...

Paper weekly 2520

HiLoAttention:从频率角度结合深度网络学习(一)

CNN局部建模能力强大,Transformer全局建模能力强大。从频率的角度来看,高频信息对应着细节信息如纹理、边缘,低频信息对应着整体结构。本文将标注的多头注意力分成两个路径来分别建立高低频的信息,具有启发性。并且还有干货(涨点的Trick)…...............

wqthaha的专栏 3734

CNN、Transformer、GAN与胶囊网络核心原理对比

神经网络架构演进中,CNN以局部感受野实现层次化特征提取,Transformer通过自注意力建模全局依赖关系,GAN基于博弈论框架完成无监督生成,胶囊网络则用向量神经元编码空间姿态信息。四类模型在张量流动、梯度传播与归纳偏置上存在本质差异:CNN依赖权值共享与平移不变性,Transformer强调序列建模与位置编码,GAN需平衡生成器与判别器的对抗稳定性,胶囊网络则依靠动态路由和Squash非线性维持方向敏感性。理解这些底层机制,是解决图像分类、生成、缺陷检测等实际任务的关键基础。

weixin_29058331的博客 203

可解释需求预测:特征驱动的供应链AI决策系统

需求预测是供应链智能决策的基础能力,其本质是将业务动态转化为可计算的时序信号。传统方法依赖简单统计或黑箱深度学习,难以应对中国市场的促销脉冲、气候突变与政策窗口等非平稳因子。本文聚焦‘特征工程驱动的时序建模能力’与‘面向7–90天多维细颗粒度预测’两大核心,揭示如何通过业务规则引擎、动态特征工厂和轻量化集成模型,构建可解释、可干预、可落地的预测系统。技术价值在于弥合数据科学与一线运营之间的语义鸿沟,使预测结果直接触发采购指令、仓配调度与销售策略。适用于零售、快消、制造及电商等高波动性行业的真实场景。

weixin_33701294的博客 323

iFormer:从频率角度结合深度网络学习(二)

当研究者在设计新的Transformer结构时,多数会考虑Transformer全局建模时与局部细节捕捉相结合的思路。例如,CNN和Transformer混合结构很多,要么串联要么并联构成local-global model。本篇中,作者将CNN和自注意力集成到一个模块内,也是多路径去分开学习高低频信息,但论文motivation强,突出解决问题,论据充分,颜老师作品值得品尝。............

wqthaha的专栏 2235

图像分割unet系列------TransUnet详解

transformer简介与实际应用中的思考

gz7seven 8679

TGRS 2025 | CTCNet:用于沙丘图像分割的CNN - Transformer双分支网络

沙丘图像通常展现出复杂的细节和相对均匀的光谱特征,这使其成为图像分割任务中的独特挑战。由于传统卷积运算的局限性,基于卷积神经网络(CNN)的方法在捕捉长距离依赖关系方面存在困难。基于Transformer的方法在长期依赖关系上表现良好,但缺乏对局部上下文的建模。结合这两种方法的优势以及双分支架构的概念,为了更好地实现沙漠地区沙丘图像的分割,作者提出了一种结合CNN和Transformer的双分支网络(CTCNet),并在自制的中国沙漠沙丘形态数据集和雷吉斯坦-哈兰沙漠沙丘形态数据集上进行了对比实验。

小白学视觉 191

机器臂抓取学习笔记(1)——DSNet: Double Strand Robotic Grasp Detection Network Based on Cross Attention

本文是发布在IEEE ROBOTICS AND AUTOMATION LETTERS(二区)的一篇文章,其主要思想是在处理机器臂抓取问题时,将transformer和CNN结合起来,因为transformer对于全局特征有着更好的处理效果,而CNN网络结构对于局部特征有更好的效果,二者结合有着不错的效果。网络的结构大概如上所示,个人认为创新点有如下两点:(1),将tansformer结构和CNN结构融合起来,能够同时将全局特征和局部特征敏锐地检测到;(2)

m0_63113025的博客 1358

【推理优化】为什么大模型推理需要优化?——一张全景图

大模型推理面临三大核心挑战:高成本、高延迟和GPU资源利用率低。每个Token生成都需要完整前向传播计算,导致推理成本与输出长度线性增长;访存带宽限制造成GPU算力闲置,使首Token延迟和输出速度受限;动态请求与静态资源分配的矛盾导致GPU利用率不足20%。优化方向包括减少访存量(量化、剪枝)、压缩计算量(批处理、投机采样)和优化实时调度系统。这些挑战相互关联,需要从算法到系统的整体优化来平衡成本和用户体验。

ruiqideng的博客 349

疾病负担研究(GBD)介绍

今天我们来聊一聊第一个公共数据库——GBD数据库,全称叫做global burden of disease(全球疾病负担),该数据库每年都会更新,目前已经更新到GBD2019。 这里直接给大家贴出网址:Global Burden of Disease Study 2019 (GBD 2019) Data Resources | GHDx 上图中红色圈圈标识的就是数据库的数据获取界面的链接,大家直接点击即可. 数据的检索十分方便: Context下拉菜单中可以选择不同的选项,默认是caus

weixin_44240228的博客 1万+

AI 社交和AI情绪价值的思考 -延申思考1 - 如何实现记忆功能?

你想想,你为什么和你闺蜜成为好朋友?首先你俩一起长大,你知道她是什么学校毕业,什么地方长大,身边有爸爸妈妈,有什么朋友,什么性格,在哪里生活,家住在哪片,基于这些人物背景信息,如何再加上你们的相处聊天,你们才是好朋友。讲注意力计算简化为线性复杂度计算,让模型不仅仅只处理一个token,而是处理更长的序列,这样降低计算依赖关系的复杂度,这样的成本就是丢失了一些上下文关联度的细节,在精确表达上功能受限。人脑的工作记忆,负责处理当前的信息流,这个模块用有限窗口大小的注意力机制,可以高效处理即时输入的数据。

qq_24550639的博客 708

SAP CEWB 高效批量调整工艺路线与BOM的实战指南

本文详细介绍了SAP CEWB工具在批量调整工艺路线与BOM中的高效应用。通过实战案例和操作指南,帮助制造业企业快速掌握批量修改技巧,显著提升工作效率,避免手工操作带来的错误和耗时。特别适合需要频繁更新工艺路线和BOM的企业用户。

weixin_42524708的博客 399

Apollo-Vision-Net 相对 BEVFormer-tiny 的配置改动:DLA / SECONDFPNV2 / Group-DETR(含动机与验证)

本文面向工程复现与消融,系统比较 Apollo 的 bev_tiny_det_occ_apollo 与 BEVFormer-tiny:将单尺度 ResNet50 替换为多尺度且经几何/深度预训练的 DLA;以 SECONDFPNV2 对 level3/4/5 重采样并融合为单尺度输出,保持 _num_levels_=1;引入 Group-DETR,在训练期放大 queries 并通过分组 self-attn 将自注意力复杂度按组数降约 G 倍,推理时切回基数以节省开销。

649

手把手教你低成本复刻大疆C板缓启动电路(附原理图与选型清单)

本文详细介绍了如何低成本复刻大疆C板缓启动电路,包括核心器件选型、电路搭建与调试实战、参数优化方法论及进阶改进思路。通过替代型号和优化设计,实现功能相近的缓启动电路,成本不到原方案的1/3,适合电子爱好者、在校学生和预算紧张的硬件工程师。

weixin_29197051的博客 397

Codesys电子凸轮从入门到应用:手把手教你用MC_CamIn/MC_CamOut实现主从轴同步

本文详细介绍了如何在Codesys平台上使用MC_CamIn和MC_CamOut功能块实现电子凸轮的主从轴同步控制。从环境配置、轴使能到凸轮表创建与动态切换,提供了完整的程序编写指南和调试技巧,帮助工程师快速掌握工业自动化中的高精度运动控制技术。

weixin_26878995的博客 277
上一篇: 万字长文解密Apple Intelligence基础模型:打造高效、个性化、安全的端侧大模型
下一篇: 用于图像分割的协 SMA Transformer:同多注意力转换器 !
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值