如何通过Chatgpt+Embedding搭建私有数据FAQ

Embedding技术原理与RAG实战优化指南 Embedding是将自然语言转化为可计算向量的核心技术,其本质是通过语义空间建模实现词与上下文的几何映射。从Word2Vec的静态词向量,到BERT的动态上下文感知,再到ChatGPT背后紧耦合的语义对齐机制,Embedding的演进始终围绕‘如何让向量距离真实反映语义关系’这一核心原理展开。它支撑着语义搜索、RAG检索、智能问答等关键应用,技术价值在于 bridging human language and machine computation。在实际落地中,开源模型如bge-small-zh、tex 阅读详情

背景

最近Chatgpt很火,在自然语言聊天和问答方面的能力非常的强劲,但不足是Chatgpt的训练数据都是基于2021年之前的网上数据,没法让他帮我回答基于时间较近的网页内容的问题或者基于私人或公司的私有数据进行聊天问答,即Chatgpt没有插上实时搜索网页的能力。虽然当前有new bing,以及chatgpt-retrieve-plugin即将上线,还需要在waiting list里面耐心等待。

最近我们产品想要把我们搜集的财务会计相关知识的网址汇集成一个知识库,能够服务于我们的客户,帮助他们解决财务方面的问题,那么这些专业的私有数据如何当做一个数据源让chatgpt接入集成,并通过聊天QA的方式来获取信息呢?

本文要叙述的方案即通过chatgpt接入私有数据集合,通过聊天的交互方式进行FAQ。

效果

首先我们来看下效果,假使我们的私有数据来自如下网址:kruzeconsulting.com/cash-burn-r… 该网址内容是有关财务相关知识,那么我需要将网站中的内容爬取下来,然后让chatgpt能够理解网站中的内容,用户通过问答的方式获取到对应的知识内容。当然你可以把知识库相关的所有网址都一股脑的往里扔。
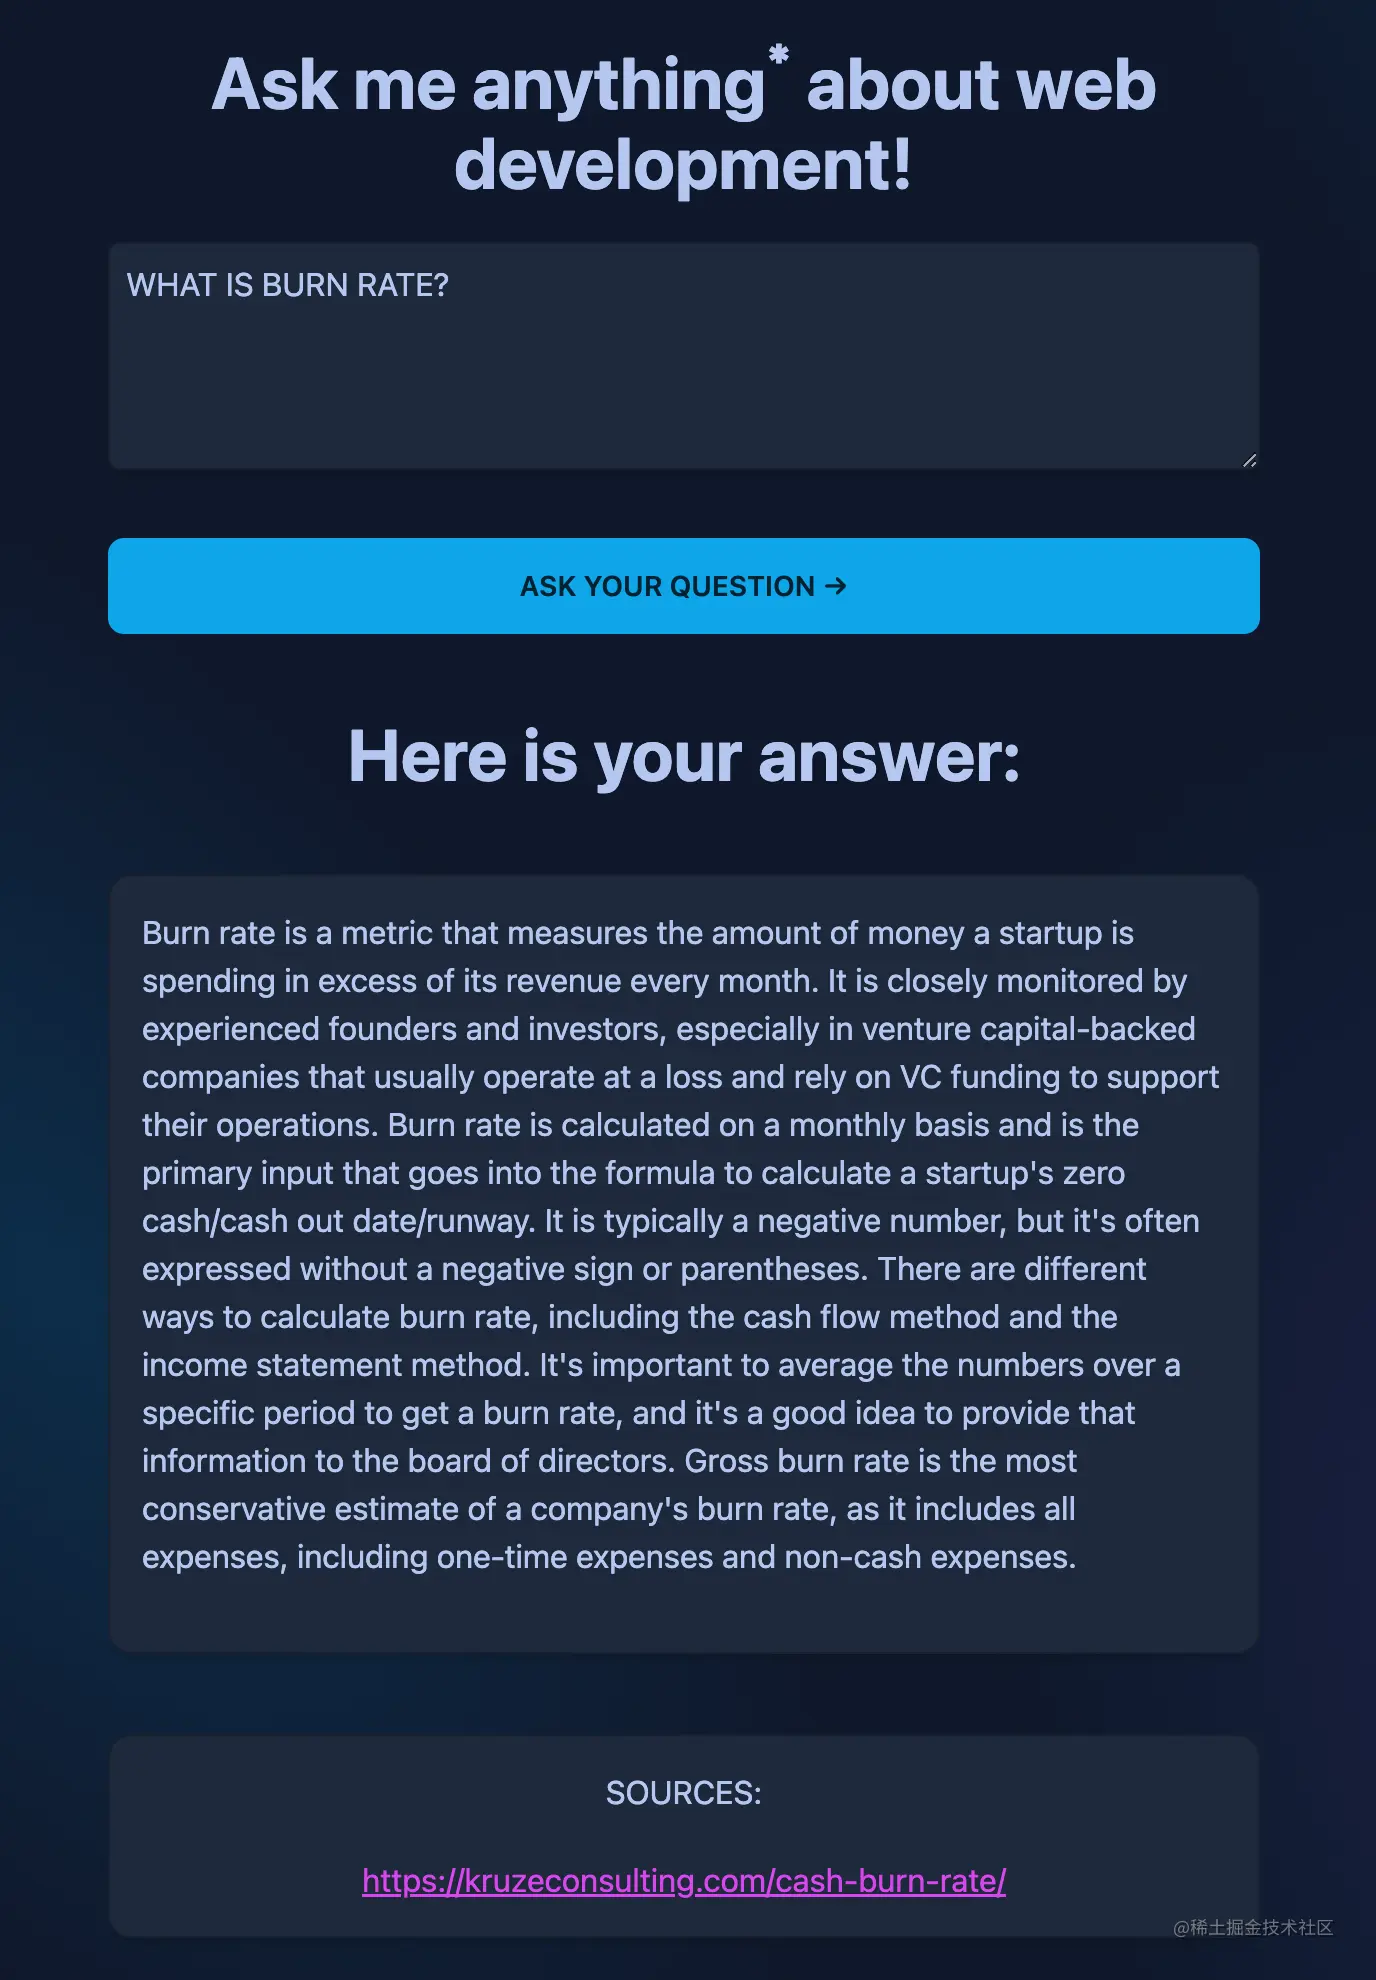
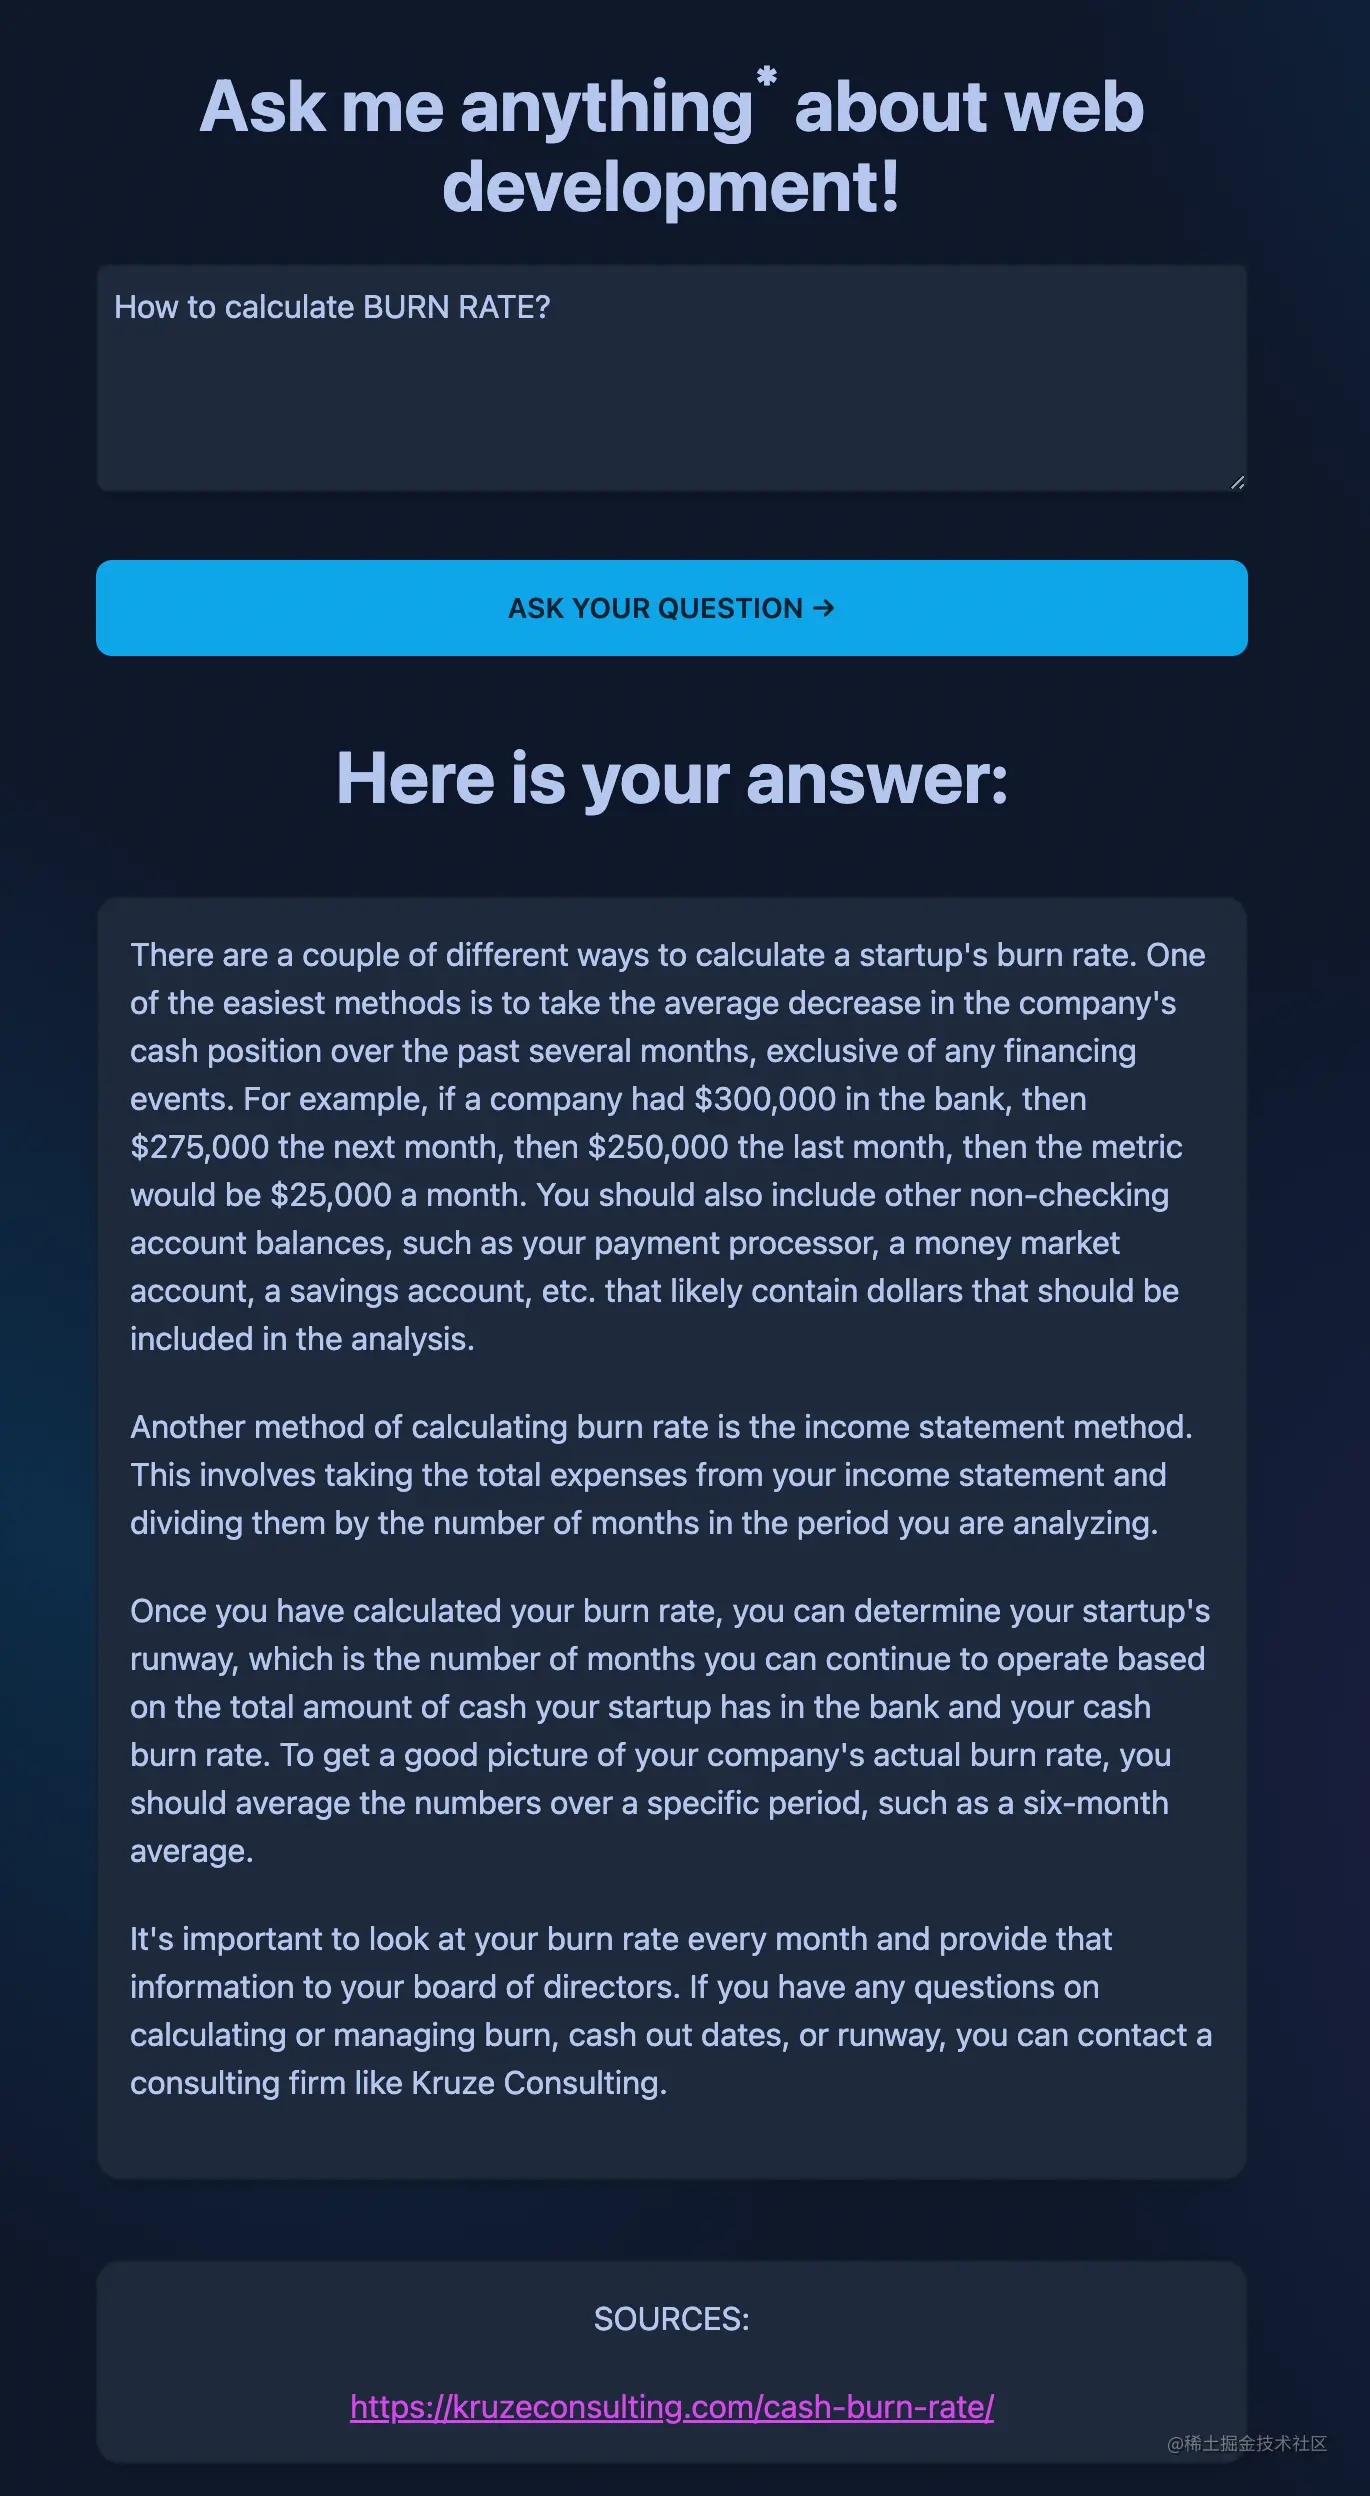
image.png

image.png

由上面两张图可以看到,自然语言的提问均获得了不错的答案(答案也都来自于我们给定的网址),并且将答案相关的URL也展示了出来,完成了一次自然语言的搜索任务。

原理

要解决私有数据的自然语言查询,我觉得要先解决以下几个问题

  • 私有数据的存储

    私有数据需要解决大数据量存储和查询的问题,由于chatgpt是个大语言模型,1750亿个参数,不可能将自己的数据喂给他微调做对应的子任务模型,成本太高。

    那么必然我们需要将自己的私有数据存储在自己的私有数据库中,这个时候向量数据库(vector database)就出现了

  • 如何通过自然语言进行问答

    自然语言的问答,自然需要借助chatgpt的能力,但是chatgpt的一次Prompt是有字数限制的,我不可能把私有数据所有的数据都一起组装成Prompt来问chatgpt,如何能够突破Prompt的字数限制呢?一个可行的想法就是将私有数据库中相关的内容抽取出来,当做Prompt来问,这是个行之有效的方式。那么如何提取和问答相关性比较大的内容呢,这个时候Embeddings技术就出现了

什么是Embeddings?

OpenAI的官方文档给出了相关的解释:Text Embeddings用于测量文本字符串之间的相关性大小,一段文字你可以看成是有限字符的有序排列,一次Embedding操作就是将一段文本转化为一个vector向量,即浮点数组。通过计算两个向量之间的距离来测量两段文字的相关性。小距离表示高相关,大距离表示低相关。

比如说一下几个短语:

  1. “狗咬耗子”
  2. “犬类捕食啮齿动物”
  3. “我家养了只狗”

那很明显1和2是类似的,即使它们之间没有任何相同的文字。那么怎么让计算机知道1和2很相似呢?

如果我们把之前的短语对应的向量能画在坐标轴上,它看起来像图中那样。短句1和短句2会离得很近,而短句3和他们离得比较远。这样我们就可以通过向量之间距离的计算来判断短语之间的相似度大小。
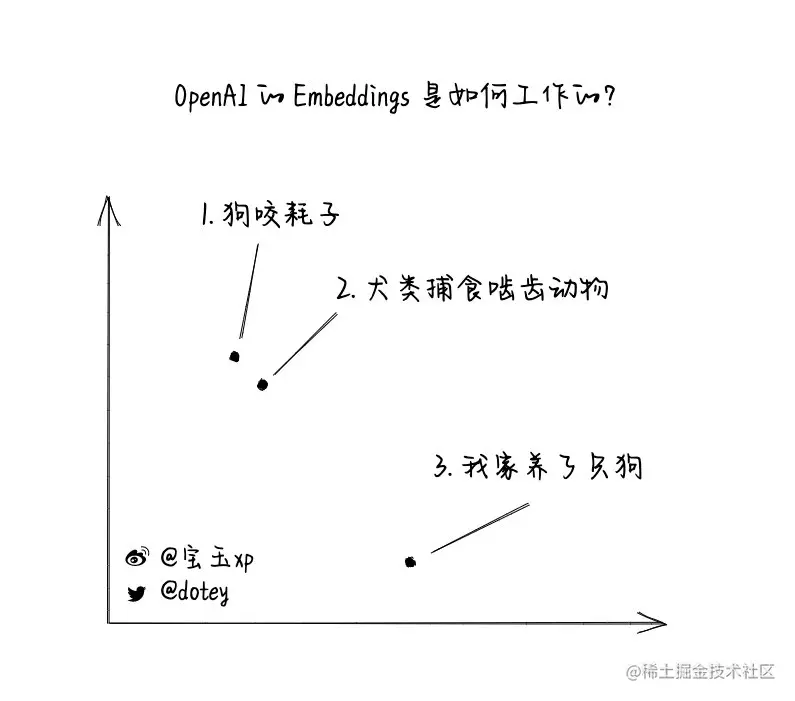
image.png

总结下来Embeddings 可以用于如下场景:

Search (where results are ranked by relevance to a query string)

Clustering (where text strings are grouped by similarity)

Recommendations (where items with related text strings are recommended)

Anomaly detection (where outliers with little relatedness are identified)

Diversity measurement (where similarity distributions are analyzed)

Classification (where text strings are classified by their most similar label)

整体流程

下图是我直接截取@宝玉xp画的流程图,基本上可以很容易得理解整个流程

整个流程可以分为两大部分: 第一大部分:私有数据切片&存储

第二大部分:筛选和提问相关性高的内容整合一齐向Openai提问
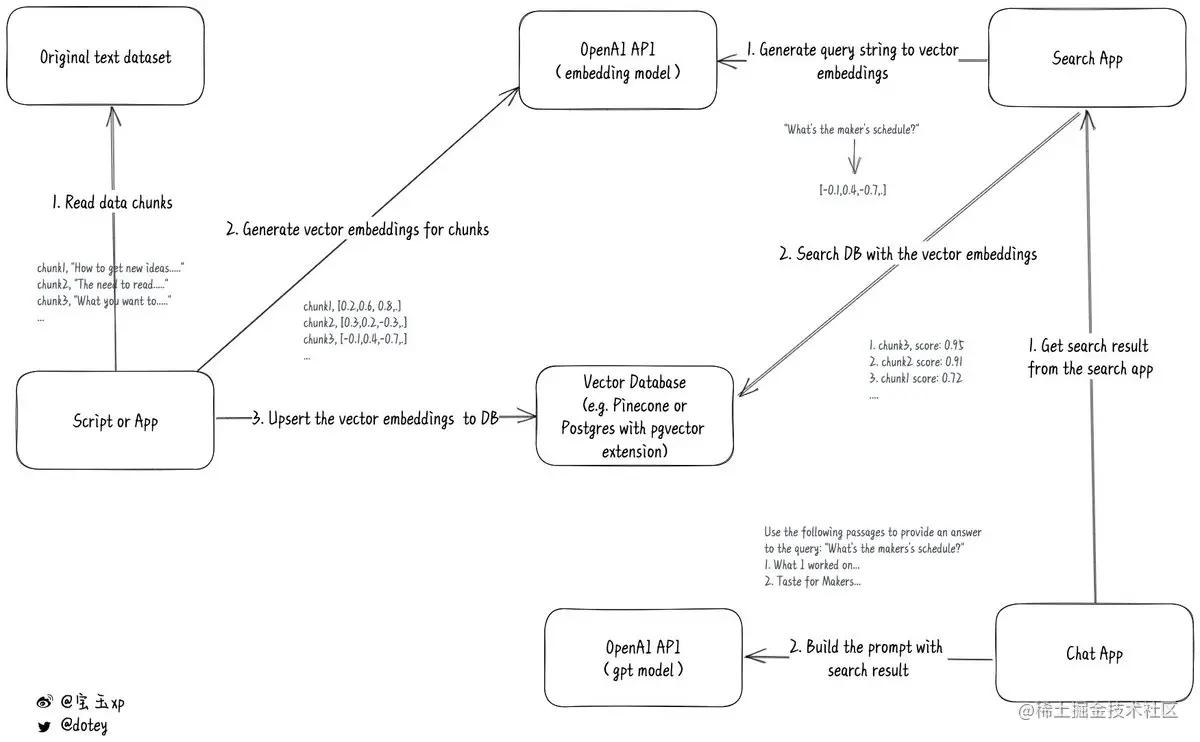
image.png

第一大部分:私有数据切片&存储:

1、首先需要将原始文本按照固定长度截取为一段一段文本,原因是希望通过openai的Embedding能力生成对应阶段文本的向量数据集合,由于openai对于输入有文本长度的限制,所以需要截取到固定长度。

2、调用openai的Embeddings接口,将一段段文本转成向量,这样每段文本就有一个向量与之对应。

3、将原始文本和对应的向量存储到之前提到的向量数据库中

第二大部分:筛选和提问相关性高的内容整合一齐向Openai提问:

1、将用户输入的问题字符串当做输入,调用openai的Embeddings能力换取对应的vector向量

2、将用户输入文本对应的向量去向量数据库中查询高相似度的向量集合,即对应的相关性文本列表就都查了出来。

3、将从向量数据库中查出来的相关性文本和原始的问题组成一个Prompt直接问chatgpt,既可以得出来结果。

对应的Prompt的结构如下:

You are a helpful assistant. When given CONTEXT you answer questions using only that information, and you always format your output in markdown. You include code snippets if relevant. If you are unsure and the answer is not explicitly written in the CONTEXT provided, you say "Sorry, I don't know how to help with that."  If the CONTEXT includes  source URLs include them under a SOURCES heading at the end of your response. Always include all of the relevant source urls from the CONTEXT, but never list a URL more than once (ignore trailing forward slashes when comparing for uniqueness). Never include URLs that are not in the CONTEXT sections. Never make up URLs`;

CONTEXT:
There are a couple of different ways to calculate a startup's burn rate. One of the easiest methods is to take the average decrease in the company's cash position over the past several months, exclusive of any financing events. For example, if a company had $300,000 in the bank, then $275,000 the next month, then $250,000 the last month, then the metric would be $25,000 a month. You should also include other non-checking account balances, such as your payment processor, a money market account, a savings account, etc. that likely contain dollars that should be included in the analysis...

Q:
How to calculate BURN RATE?

A:

实践

可以基于github.com/gannonh/gpt… Readme的方式搭建,本文就不在赘述,实践中选用的向量数据库为Supabase,最终存储在Supabase里面数据形式大概如下:

image.png

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
从零手写RAG:Chunking、Embedding与检索架构的工程实践 RAG(检索增强生成)是一种将信息检索与大语言模型生成解耦的混合架构,其核心原理在于通过语义向量空间对齐实现精准上下文注入。技术价值体现在降低幻觉、提升事实一致性与领域适配性,广泛应用于企业知识库、技术文档问答和客服系统等需强可信度的场景。实践中,chunking策略决定语义完整性,embedding模型选择影响跨术语召回能力,而索引与检索协同设计则关乎性能与精度平衡。本文聚焦‘从零手写’过程中的关键决策点,涵盖结构化文本切分、领域感知向量编码及元数据增强检索等真实工程细节。 阅读详情

相关推荐

用ChatGPT精读VALL-E:神经编解码器与零样本语音合成实战指南

语音合成中的神经编解码器(Neural Codec)是实现高质量零样本语音合成(Zero-Shot TTS)的核心技术,其本质是将连续声学特征映射为离散声学token,并交由大语言模型建模时序依赖。该技术融合了向量量化(VQ)、自回归建模与跨模态对齐等关键原理,显著降低TTS系统对大规模标注语音数据的依赖,提升跨说话人、跨语言的泛化能力。典型应用场景包括AIGC语音生成、低资源语音克隆及实时对话式TTS服务。本文聚焦VALL-E这一代表性工作,结合ChatGPT辅助精读方法,系统拆解其神经编解码器设计逻辑、

weixin_30245867的博客 411

最新ChatGPT GPT-4 相似匹配Embedding技术详解(附ipynb与python源码及视频讲解)——开源DataWhale发布入门ChatGPT技术新手从0到1必备使用指南手册(一)

如果您想提高文本处理的效率和精度,那么Embedding技术就是您必须掌握的最重要利器。在本文中,不仅将详细介绍Embedding的基本概念,还将通过实际代码演示如何使用相关API,其中包括LMAS Embedding API和ChatGPT API等。同时还深入剖析Embedding在QA应用、聚类应用和推荐应用方面的具体应用场景。

小胡说人工智能的博客 8544

AI模型框架实战:从ChatGPT架构到生产部署优化

Transformer架构作为现代大语言模型的核心基础,通过自注意力机制实现了高效的序列建模。其关键技术原理包括多头注意力计算、位置编码和逐位置前馈网络,这些机制共同支撑了模型对长距离依赖关系的捕捉能力。在工程实践中,基于Transformer的模型(如ChatGPT)通过稀疏注意力、旋转位置编码等优化,显著提升了处理长文本的效率。这类技术在智能客服、内容生成等场景展现巨大价值,特别是在处理多轮对话和复杂语义理解任务时。实际部署时需要平衡模型规模与推理成本,6B-13B参数量的模型通常能提供最佳性价比。结合

weixin_34146805的博客 357

chatGPT的Embedding最佳实践:拥有自己的AI客服

点击左下角菜单中的【自定义AI角色】,新建一个属于自己的AI。头像:在发布到渠道后,用户聊天窗口中AI的头像角色名称:发布到渠道后,用户聊天窗口的标题Prompt:为自己的机器人预设身份发布后欢迎语:发布到渠道后,当用户于AI发起聊天时,AI说的欢迎语(第一句话)

python1222_的博客 1176

ChatGPT企业级落地全指南:API接入、知识库问答与安全管控

在数字化转型加速的背景下,大语言模型正从技术概念走向企业级生产力工具。API作为连接业务系统与模型能力的核心桥梁,是组织集成ChatGPT等LLM的基础路径。通过理解对话补全、流式输出与Token计费机制,开发者可以快速构建可复用的人工智能应用。而检索增强生成(RAG)技术则进一步解决了模型幻觉问题,让知识库问答具备准确性与可追溯性,真正落地于客服、办公效率、代码辅助等高频场景。与此同时,企业还需关注数据脱敏、权限审计、成本治理等工程环节,确保AI系统在合规边界内稳定运行。本文从工程实践角度出发,梳理组织采

weixin_33910759的博客 323

ChatGPT API接入实战:从基础调用到生产部署的完整指南

大语言模型(LLM)API已成为现代应用开发的基础设施,它通过提供强大的文本理解与生成能力,赋能客服、内容创作、代码生成等多样化场景。其核心原理在于将自然语言指令转化为结构化请求,调用云端模型进行计算并返回结果。对于开发者而言,掌握API的稳定接入与高效调用,是释放其技术价值、构建智能应用的关键。本文聚焦于ChatGPT API的工程实践,详细解析了从API Key管理、多轮对话上下文维护,到流式输出、函数调用等高级功能,并深入探讨了生产环境中必须面对的**错误处理**与**成本控制**策略,旨在帮助开发者

weixin_30721077的博客 422

从零开始构建基于ChatGPT的嵌入式(Embedding)本地医疗客服问答机器人模型,手把手教学!看完就会,看到最后有惊喜)

可以被应用于以下几种情况- 搜索(根据查询字符串的相关性对结果进行排名)- 聚类(根据相似性对文本字符串进行分组)- 推荐(具有相关文本字符串的项目被推荐)- 异常检测(识别关联度小的异常值)- 多样性测量(对相似性分布进行分析)- 分类(文本串按其最相似的标签进行分类)本文将主要学习第一种情况:搜索,根据相关性进行排名。也可以理解成搜索完一定会有结果,但是相关性有可能很低,有可能需要用户加以甄别。出来的信息可能不是用户需要的答案。比如我下面使用的模型输出的向量维度便是1536,这个在。

python123456_的博客 1666

实战:用ChatGPT API搭建一个私人知识库问答机器人

从零搭建基于ChatGPT API的私人知识库问答机器人,涵盖向量数据库选型、文档切片、Embedding接入和微信/Webhook对接的完整实战流程。

Johnny2004的专栏 30

【手把手教你】搭建私有大模型+私有知识库

就是把目前最流行的开源大模型部署到自己的电脑上,无需联网、也不用买会员,隐私可不会泄露,直接可以和AI聊天。就是你可以把你喜欢的资料统统喂给大模型,然后让AI查询你指定的材料,再来回复你的问题。若是在公司搭建这套组合,可以把公司的介绍、产品数据、销售数据等等都发给私有大模型,回复用户的信息就更有针对性。大模型搭建已经分享过了,就不在此赘述,直接进入主题,知识库搭建。AnthingLLM可以直接在其界面上对话,导入各种形式的资料。也可以把本地AI大模型和知识库做成接口API,在企业的其他应用里面去调用。

2301_76168381的博客 4828

VisualSFM+MeshLab 三维重建全过程记录

VisualSFM+MeshLab 三维重建全过程记录,从下载到运行出结果,以及其中一些可能出现的小问题。通过这两个软件熟悉一下多目立体视觉重建的流程。

何似莫相逢 3万+

13.5元低成本模拟乘法器AD633JN实测:手把手教你避开那些坑

本文以13.5元低成本模拟乘法器AD633JN为核心,通过实测搭建混沌电路的全过程,手把手教你避开电源灌流、芯片发烫、输入偏置等常见陷阱。文章详细剖析了AD633JN的比例因子、输入阻抗等关键特性,并提供了正确的电源去耦、信号耦合及稳定性布线方案,旨在帮助硬件爱好者与工程师高效利用这款高性价比芯片,节省调试时间与成本。

weixin_28432777的博客 519

chatGPT的Embedding最佳实践:创建自己的知识库,实现类似AI客服功能

随着OpenAI将切换到这个版本,也就是token价格和之前一样,但是长度成了16K,足足是之前的四倍,那么embedding这种方式才有可能派上用场。之前的4k,还不够塞牙缝!当然如果你是很差钱,直接使用(也就是) 这个模型更爽,长度可达128K,尽管返回最长是4096,对于大部分场景已经足够。

xxue345678的博客 1263

光伏系统选型指南:5种主流MPPT算法优缺点对比(附选型流程图)

本文深入剖析了光伏系统中五种主流MPPT算法的核心原理与性能差异。通过对比扰动观察法、电导增量法、恒定电压法、模糊逻辑控制及人工智能算法在追踪精度、响应速度、实现成本与稳定性等方面的表现,为不同应用场景(如户用、工商业及大型电站)提供了清晰的选型决策流程图和实战指南,帮助工程师优化系统效率与投资回报。

weixin_29294597的博客 106

如何用ChatGPT 1小时内生成2000+条高质量FAQ?——一线AI工程师压箱底的5个Prompt工程技巧

1小时内用ChatGPT FAQ自动生成2000+条高质量问答,解决客服知识库建设效率瓶颈。适用于电商、SaaS、教育等多行业,依托5个经实战验证的Prompt工程技巧,兼顾准确性、多样性与业务适配性。值得收藏

PixelStream的博客 188

RPA实战-UiPath自动化处理Outlook邮件附件全流程解析

本文详细解析了如何使用UiPath实现Outlook邮件附件的自动化处理全流程,涵盖环境配置、核心流程实现、高级功能扩展及性能优化技巧。通过RPA技术,企业可大幅提升邮件附件处理效率,减少人工操作错误,适用于财务、物流等多个场景。

weixin_33701251的博客 427

Python 3.13.7 (64-bit)安装弹窗提示:Setup failed:0x80070643 - 安装时发生严重错误...如何解决?

🏆本文收录于 《全栈Bug调优(实战版)》 专栏,该专栏专注于分享我在真实项目开发中遇到的各类疑难Bug及其深层成因,并系统提供高效、可复现的解决思路和实操方案。无论你是刚入行的新手开发者,还是拥有多年项目经验的资深工程师,本专栏都将为你提供一条系统化、高质量的问题排查与优化路径,助力你加速成长,攻克技术壁垒,迈向技术价值最大化与职业发展的更高峰🚀!

**My Coding Family** 2117

基于RAG与LLM的智能客服FAQ自动化:从语义理解到工程实践

在人工智能技术驱动下,客户服务领域正经历从传统规则匹配到深度语义理解的范式转变。其核心原理在于利用大语言模型(LLM)强大的自然语言理解与生成能力,结合检索增强生成(RAG)架构,实现对非结构化知识库的智能查询与答案合成。这项技术的核心价值在于,它能将企业内部文档、产品手册等知识源转化为可动态检索和推理的智能资产,从而构建出能真正理解用户意图、提供精准答案的对话系统。在应用场景上,它尤其适用于处理海量、重复的在线客服咨询,能显著提升响应效率与用户体验。本文聚焦于如何将这一前沿技术工程化落地,详细探讨了基于语

angzhan5306的博客 383

simulink的Sine Wave 模块详解

模块是 Simulink 中的一个信号源模块,用于生成正弦波信号。该模块可以根据设定的幅值、频率、相位和偏移量,在仿真过程中产生周期性的正弦波形。模块都能提供强有力的支持。通过深入了解其参数的影响及结合 MATLAB 脚本的应用,读者可以更加有效地利用这一模块进行仿真和研究。此外,通过实际应用场景的扩展以及常见问题解答部分的帮助,能够更好地掌握。模块是一个非常实用的工具,适用于需要生成正弦波信号的各种场景。模块的参数,可以进一步增强学习体验。模块参数的影响,下面我们将详细探讨每个参数如何影响仿真结果。

xiaoheshang_123的博客 1052

ChatGPT+向量数据库搭建私有化知识库

我们在用图片搜索图片,或者语音搜索语音的时候,在数据库中存储和对比的并不是图片和语音片段,而是通过深度学习等算法提取出来的“特征”,一般是256/512个float数组,可以用数学中的向量来表示。向量数据库就是用来存储,检索,分析向量的数据库。只所以称之为数据库,是因为它有下面几个特征:a) 提供标准的访问接口,降低用户的使用门槛b)提供高效的数据组织,检索和分析的能力。一般用户在存储和检索向量的同时,还需要管理结构化的数据,即支持传统数据库对结构化数据的管理能力。

weixin_59191169的博客 1604

13、混合系统的离散与连续交互

本文详细探讨了混合系统中离散事件与连续动态的交互机制,涵盖了建模方法、分析技术、设计挑战以及多种控制策略。通过具体案例研究和操作语义的定义,展示了混合系统在制造业、交通系统、机器人技术和过程控制等领域的广泛应用。文章还介绍了实验仿真、稳定性研究及优化方法,旨在帮助读者全面理解混合系统的设计与控制要点,并为未来智能化和自适应混合系统的发展提供了展望。

5f4d3s2a1q的博客 127

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

ChatGPT自动生成FAQ页面:从零部署到上线仅需17分钟,附可运行Prompt工程清单

快速实现ChatGPT FAQ页面生成,解决企业知识库更新慢、人工维护成本高的痛点。基于Prompt工程自动化构建FAQ页面,支持多源文档解析与语义问答对提取,17分钟完成部署上线。适用于客服系统、产品帮助中心等场景,值得收藏。

DevPath的博客 320

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

【收藏】RAGFlow完全指南:手把手教你搭建大模型知识库

RAGFlow是一种融合了数据检索与生成式模型的新型系统架构,其核心思想在于将大规模检索系统与先进的生成式模型(如Transformer、GPT系列)相结合,从而在回答查询时既能利用海量数据的知识库,又能生成符合上下文语义的自然语言回复。该系统主要包含两个关键模块:数据检索模块和生成模块。数据检索模块负责在海量数据中快速定位相关信息,而生成模块则基于检索结果生成高质量的回答或文本内容。

大模型研究中心 3600

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

ChatGPT知识库构建实战:从数据预处理到智能问答系统搭建

整套流程跑通后,我把同样思路迁移到火山引擎的豆包语音模型,发现官方已经封装好 ASR→LLM→TTS 的实时通话闭环,半小时就能在网页里跟“数字同事”聊天气。从0打造个人豆包实时通话AI我跟着文档跑了一遍,从注册到第一次语音通话大概 20 分钟,UI 也开源,改两行 JS 就能换上自己的知识库。对中级 Pythoner 来说,算是一次“语音交互”低成本入门。祝你玩得开心,早日让 AI 开口说话!

2600_94959870的博客 268

ChatGPT Custom Instructions:用户侧提示工程的系统级前置化

Custom Instructions 是大语言模型交互范式的一次底层演进,它将原本隐藏在 system prompt 中、仅面向开发者的系统级控制能力,首次开放给终端用户。其核心原理是通过身份上下文注入(About you)与响应约束执行(How ChatGPT should respond)双阶段干预模型推理链,在 embedding 与 decoding 层分别施加语义锚点与格式过滤。这种用户可控的提示工程前置化,显著降低多轮纠偏成本,提升输出稳定性与专业一致性,广泛适用于内容运营、技术文档撰写、合规

weixin_30258901的博客 328

实战指南:如何将ChromaDB与ChatGPT Plugin无缝集成到FastChat和NextChat

在构建基于大语言模型的对话系统时,我们常常需要让模型能“记住”并快速“回想”起大量的非结构化数据,比如历史对话、产品文档、FAQ知识库。传统的基于关键词的数据库检索(如 MySQL 全文索引)在理解用户问题的真实意图(语义)时表现不佳。核心痛点语义鸿沟:用户问“怎么退款”,知识库里只有“退货流程说明”,关键词匹配不上。效率瓶颈:当需要从百万级文档中实时检索最相关的几条时,关系型数据库的查询会成为性能瓶颈。架构复杂:需要单独维护一套复杂的向量化(Embedding)和检索服务,增加了开发和运维成本。

2600_94960061的博客 666
上一篇: 从零开始构建基于ChatGPT的嵌入式(Embedding)本地医疗客服问答机器人模型,手把手教学!看完就会,看到最后有惊喜)
下一篇: 程序员转行为什么这么难_建议程序员转行大模型试试
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值