从 RAG 到 Agent:向量数据湖驱动的上下文工程

RAG技术演进与智能Agent实践指南 检索增强生成(RAG)技术通过结合信息检索与文本生成,显著提升了AI系统的知识利用能力。其核心原理是先用检索模块获取相关知识片段,再交由生成模型进行上下文感知的内容创作。这种架构在降低大模型幻觉风险的同时,大幅提升了专业领域输出的准确性。当前主流实现方案通常包含向量数据库、混合检索策略和结果重排序等关键技术组件。在企业级应用中,RAG系统已从简单的问答场景扩展到智能客服、数据分析报告生成等复杂业务场景。特别是随着Agentic RAG架构的成熟,系统开始具备动态环境感知、多工具协作等高级认知能力。本文以股票 阅读详情

这是基于2025 AICon大会的Milvus负责人刘力《RAG+不止是检索:Milvus在Context Engineering中的湖仓一体实践》整理出的核心观点与关键技术要点总结。我认为接收一些会议/演讲类材料可用快速了解行业动态和趋势。

从 RAG 到 Agent:向量数据湖驱动下一代 Context Engineering

随着大模型应用从单轮问答(Chatbot)迈向多轮、有状态的智能体(Agent),上下文工程(Context Engineering) 成为提升 AI 应用能力的关键基础设施。传统 RAG(Retrieval-Augmented Generation)仅聚焦于“检索”,而现代 Agent 需要长期记忆、环境感知和动态上下文管理——这催生了对统一、可扩展、高性能的非结构化数据底座的需求。

向量数据湖

如上,向量数据湖(Vector Data Lake) 被提出作为新一代 Context 存储与处理平台,其核心目标是:以湖仓一体架构,统一管理多模态、海量、异构的上下文数据,并支持高效搜索、灵活演进与低成本治理。

一、Context Engineering 的三大支柱

    1. 上下文的搜索
  • • 不再依赖单一稠密向量检索,而是融合 Dense + Sparse(如 BM25)+ Graph + 标量(时间、地理、JSON 等) 的混合搜索。
  • • 引入 Rerank、Time Decay、Highlight 等后处理机制,提升召回质量,避免“上下文污染”(Context Poisoning/Clash)。
    1. 上下文的处理
  • • 支持多模态数据(文本、图像、表格、图谱)的统一建模,通过 语义宽表(Semantic Wide Table) 将一个业务实体(如一篇文档)完整表达为一行,避免多表 JOIN。
  • • 原生支持 Struct、JSON、Array、Geo、Time 等复合类型,并提供列式索引与自动 Schema 演进(Schema Evolution)。
    1. 上下文的管理
  • • 构建 向量数据湖 作为非结构化数据的统一底座,兼容 Parquet、Lance、Vortex 等格式,通过 宽窄列分离、外部 Blob 存储、RowGroup 优化 解决传统 OLAP 格式在点查与向量场景下的性能瓶颈。
  • • 索引即数据:每种字段类型均可构建 SOTA 索引,支持百万级批量检索与低延迟在线查询。

二、湖仓一体架构的关键创新

  • • 存算完全分离:基于 S3 + Kubernetes + etcd 构建云原生架构,计算(查询、索引、Compaction)微服务化,弹性伸缩。
  • • 一份数据,多引擎协同:通过 Apache Arrow 生态对接 Spark、Flink 等计算引擎,支持离线批处理与在线查询共用同一份存储。
  • • 增量同步与外表支持:无需数据冗余,外置向量处理能力可直接作用于湖中数据,实现“移动计算而非移动数据”。

三、面向生产的大规模治理能力

  • • 多租户隔离:支持三种策略(Collection-per-Tenant、Partition Key、共享 Collection + 过滤),平衡隔离性与性能,可支撑百万级租户。
  • • 智能冷热分层:数据在 RAM / NVMe / S3 间自动流动,按时间或容量驱逐,小租户按租户粒度、大租户按聚类粒度管理,实现毫秒级热数据响应与低成本冷存储。
  • • 内置治理原语:原生支持 KMeans 聚类、去重、特征提取等,降低运维复杂度。


三大核心要点总结

    1. RAG 正在进化为 Context Engineering:AI 应用从无状态问答走向有状态 Agent,要求上下文具备长期记忆、环境感知与动态管理能力,推动基础设施从“检索工具”升级为“上下文操作系统”。
    1. 向量数据湖 = 统一底座 + 湖仓一体 + 多模态索引:通过兼容开放格式、存算分离、多引擎协同和 SOTA 索引体系,构建高性价比、高灵活性的非结构化数据管理平台,解决 RAG 中的数据孤岛与扩展瓶颈。
    1. 生产级能力 = 多租户 + 冷热分层 + Schema 演进:面向企业级落地,必须支持细粒度隔离、智能存储分层、零停机字段变更与自动 JSON 结构优化,确保系统在规模、成本与敏捷性之间取得平衡。

从 RAG 到 Agent 时代的技术演进路径,可用看到出:未来的 AI 应用竞争力,不仅在于模型本身,更在于上下文基础设施的深度与效率。而 Milvus 所代表的向量数据湖确实在AI时代必不可少。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇
​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

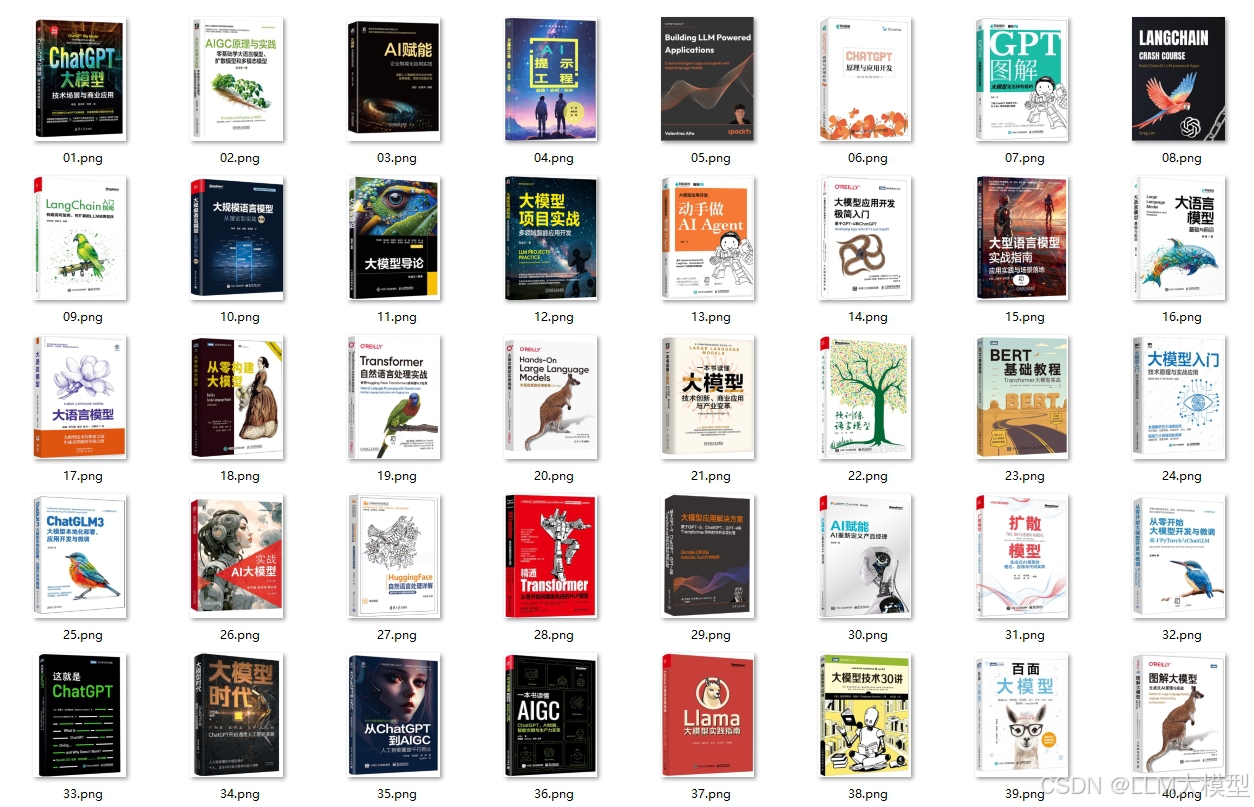
1. 100+本大模型方向电子书
在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
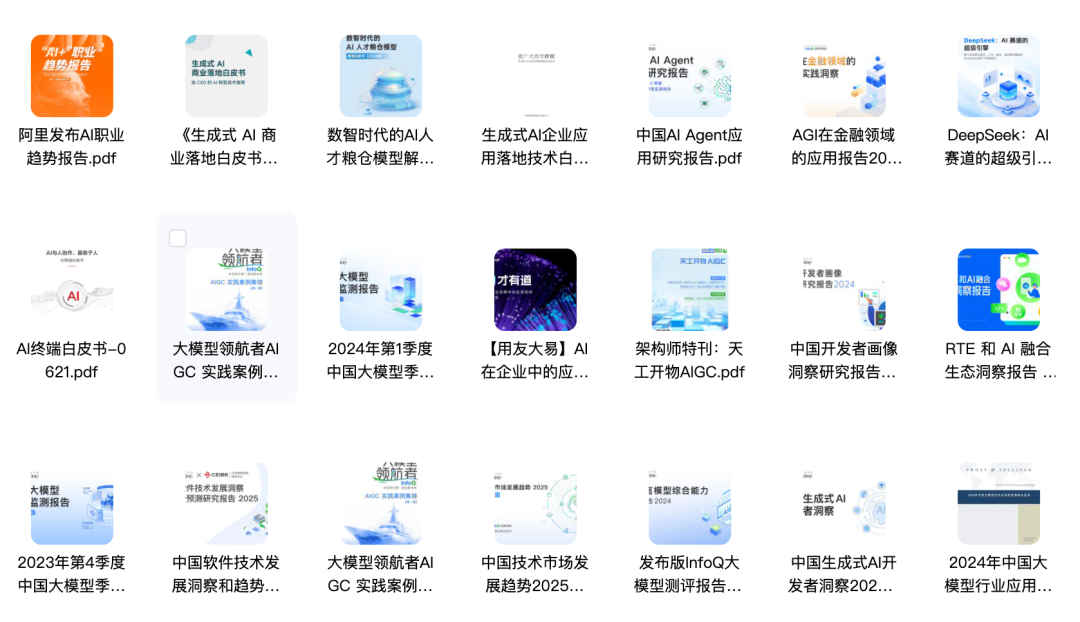
  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

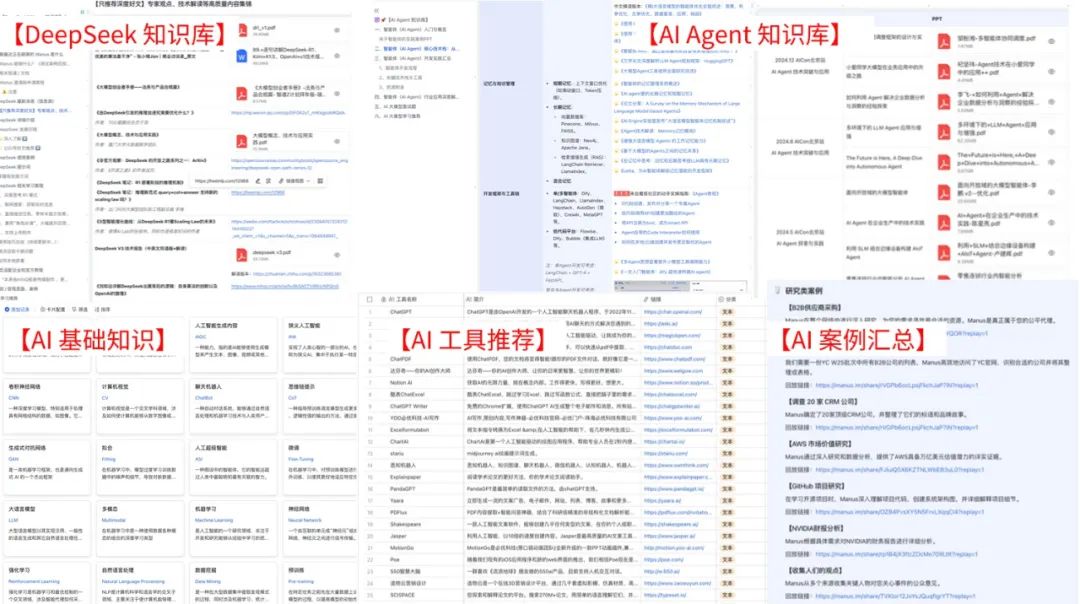
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
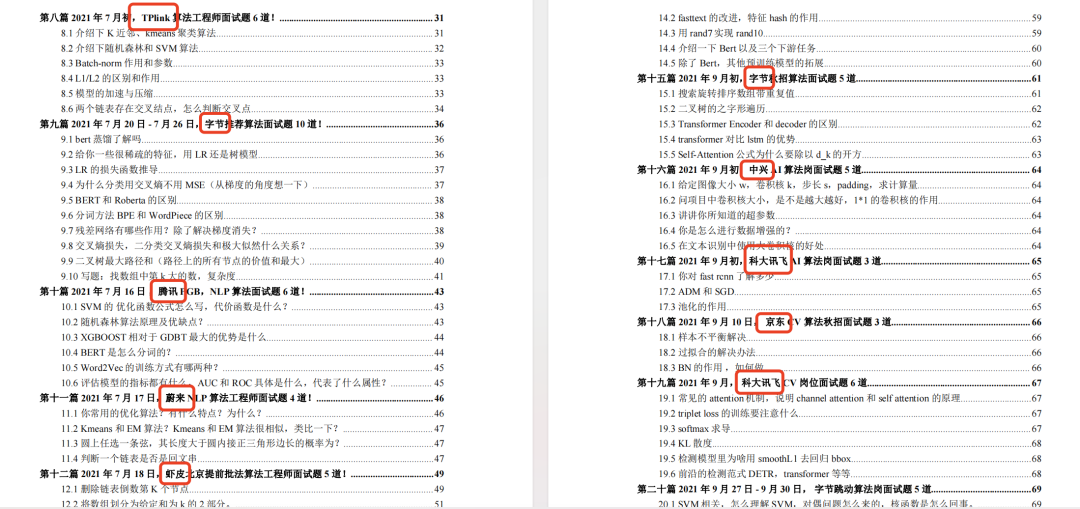
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
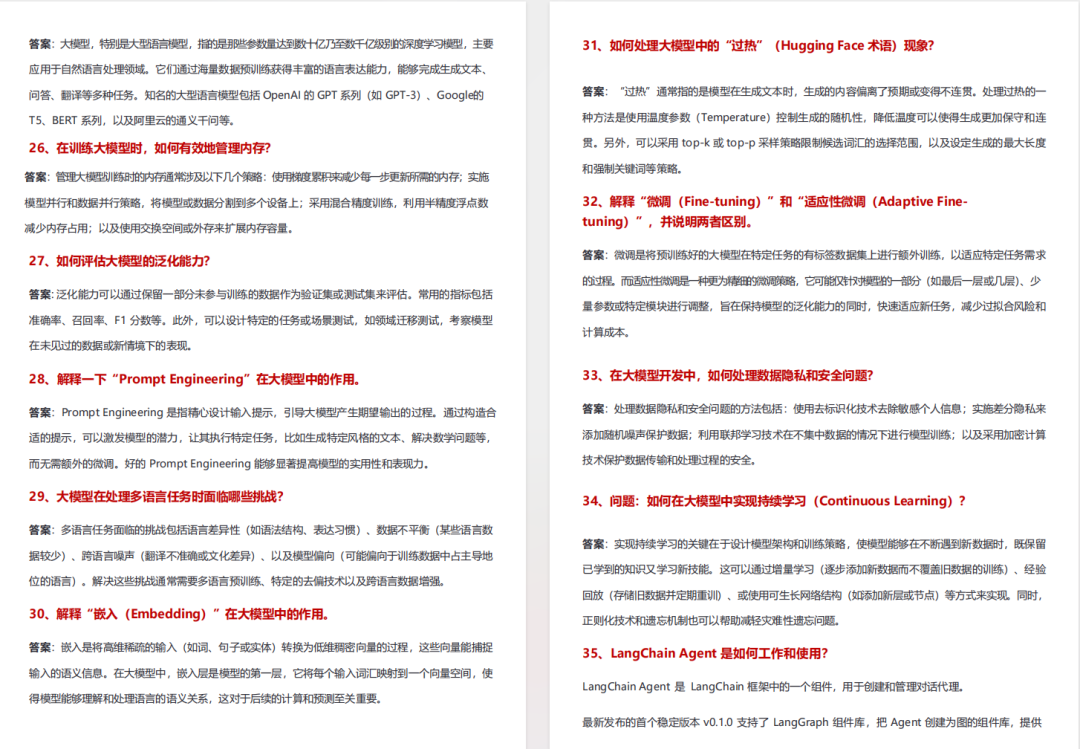
2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
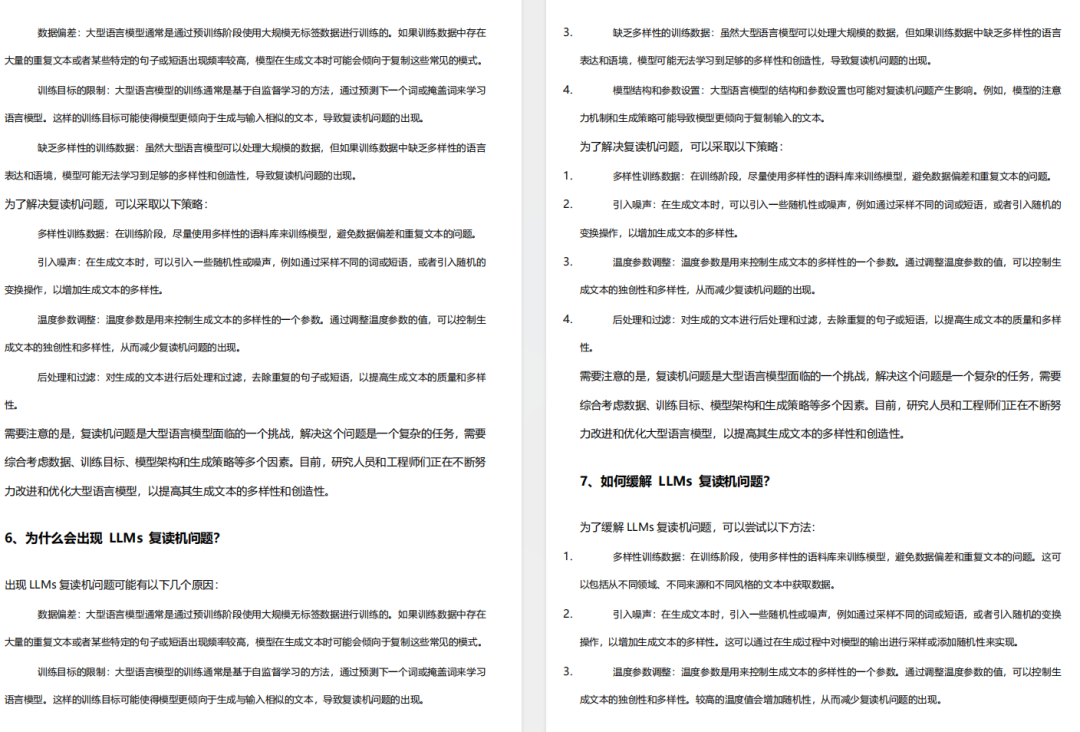
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

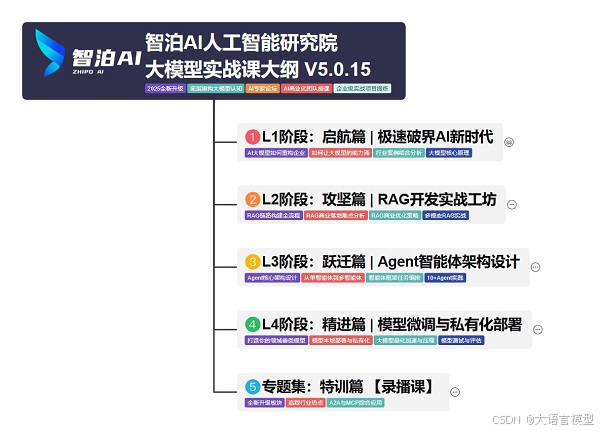
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
img

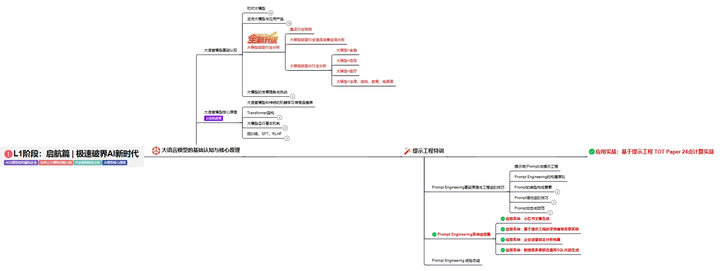
L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
img

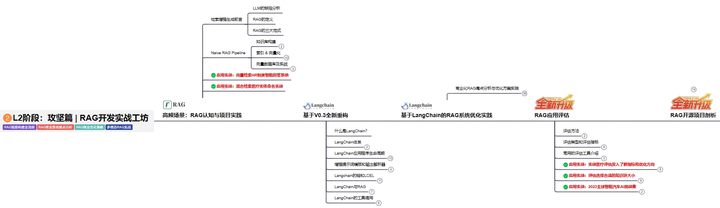
L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
img

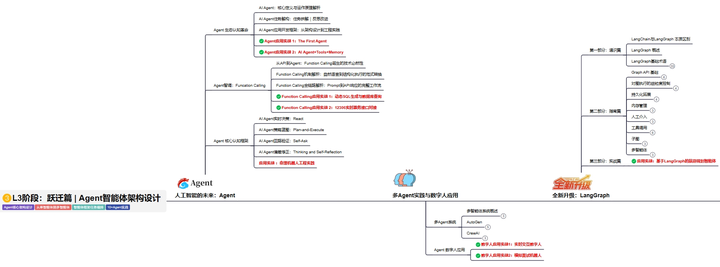
L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
img

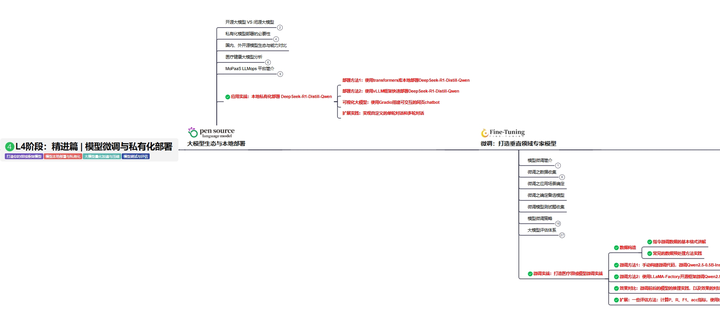
L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
img

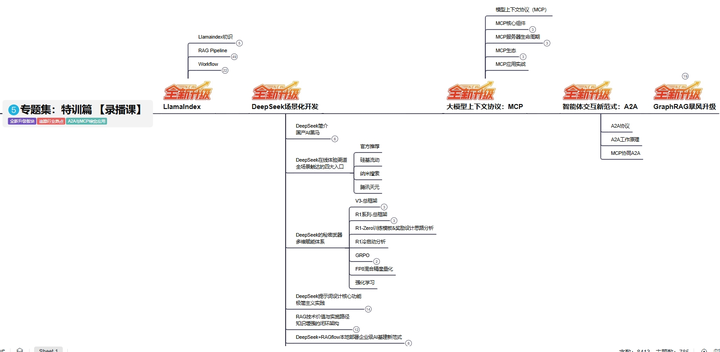
L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

构建AI原生数据湖:Paimon与Milvus的流批一体向量化实践 在数据架构领域,数据湖作为统一存储与分析平台,旨在打破数据孤岛,整合多源异构数据。其核心原理在于通过流批一体架构,实现数据的实时与批量处理统一。这一技术价值在于为上层应用提供一致、新鲜的数据视图,尤其适用于需要实时响应的AI应用场景。随着多模态数据处理和智能体(Agent)工作流的普及,传统数据湖在向量检索与实时感知方面面临挑战。本文聚焦于结合Apache Paimon的流批一体存储能力与Milvus的高性能向量检索,探讨如何构建支持实时向量化与智能体驱动的AI原生数据基础设施,以应对多模态数据管理和Age 阅读详情

相关推荐

AI OS整合Agent/RAG框架

摘要: AI OS通过整合Agent与RAG框架构建三层智能架构(资源调度、智能服务、应用交互),实现动态知识驱动决策。关键技术包括分层检索、轻量化部署及五层安全防护,已在企业中枢(华为MetaERP)、工业物联网(三一重工)等场景落地,提升效率200%、降低运维成本45%。未来将向数字孪生、脑机接口等方向演进,核心价值在于从工具升级为生态级“生产力网络”。开源框架如Dify.AI、LangChain OS助力开发者快速构建垂直场景闭环。

技术引领业务创新 981

【收藏】一文读懂:从RAG到Agent,向量数据湖如何驱动下一代Context Engineering

RAG 正在进化为 Context Engineering:AI 应用从无状态问答走向有状态 Agent,要求上下文具备长期记忆、环境感知与动态管理能力,推动基础设施从“检索工具”升级为“上下文操作系统”。向量数据湖 = 统一底座 + 湖仓一体 + 多模态索引:通过兼容开放格式、存算分离、多引擎协同和 SOTA 索引体系,构建高性价比、高灵活性的非结构化数据管理平台,解决 RAG 中的数据孤岛与扩展瓶颈。生产级能力 = 多租户 + 冷热分层 + Schema 演进。

EnjoyEDU的博客 1148

企业AI Agent工程化落地:基于Spring Boot的实战架构与性能优化

AI Agent作为智能系统的核心组件,其本质是将大模型的推理能力与具体业务逻辑相结合的技术架构。其工作原理是通过意图识别、知识检索增强生成(RAG)和工具调用等模块,将非结构化的自然语言请求转化为结构化的系统操作。这项技术的核心价值在于能够安全、可靠地将前沿AI能力集成到企业现有的复杂IT系统中,实现业务流程的自动化与智能化。在实际应用场景中,企业级AI Agent面临确定性输出、私有数据融合、长链条业务集成以及成本与稳定性等多重挑战。本文聚焦于如何利用成熟的Java与Spring Boot技术栈,构建一

weixin_30682415的博客 367

大模型必学:从RAG到Agent的演进,向量数据湖如何重构上下文工程?【收藏】

文章介绍了从传统RAG到Agent时代的技术演进,强调Context Engineering成为AI应用关键基础设施。向量数据湖通过湖仓一体架构统一管理多模态数据,支持混合搜索、多模态处理和高效管理。Milvus通过存算分离、多引擎协同和智能冷热分层等技术,构建高性价比的非结构化数据管理平台,解决了RAG中的数据孤岛与扩展瓶颈,为AI应用提供深度与效率并重的上下文基础设施。

m0_71746299的博客 679

Java开发者如何通过AI工程化突破同质化困境

在Java生态高度成熟的今天,开发者常面临技术栈同质化的挑战。AI工程化技术如RAG(检索增强生成)和Agent(智能体)为Java应用带来智能化升级路径。RAG通过结合信息检索与文本生成,使系统具备智能问答能力;Agent技术则能实现自主决策的业务流程自动化。这些技术可与Spring生态无缝集成,例如使用Apache Cassandra作为向量数据库,通过Spring AI对接大模型。对于企业级应用,建议采用混合检索策略和本地化部署方案,既提升响应速度又保障数据安全。掌握这些AI工程化能力,Java开发者

weixin_30425949的博客 299

AI Agent自动迭代编程驱动的医疗算法闭环改造路径研究

AI Agent 自动迭代编程驱动的医疗算法 PDCA 闭环改造路径研究

AllenLV的博客 1330

【收藏学习】向量数据湖赋能Context Engineering:RAG到Agent的技术演进

文章探讨了从传统RAG到Context Engineering的技术演进,指出AI应用正从单轮问答向多轮Agent发展。Milvus提出的向量数据湖通过湖仓一体架构,统一管理多模态上下文数据,支持混合搜索、多模态处理和动态管理。其创新包括存算分离、多引擎协同和智能冷热分层,解决了数据孤岛与扩展瓶颈,为下一代AI应用提供高效、灵活、可扩展的上下文基础设施。

Gaga246的博客 812

海量数据 / Vastbase 深度研究笔记 v3.1

v3.1 重点修订:在 v3.0 审慎版基础上,新增“2026 新变量”章节,纳入 7 亿级定增、HTAP / 多模态时序数据库、G100 V3.0 Build 8 的 3CM+2DN 高可用补强、pgvector / V100 / AI 多模叙事,以及集成服务基因与标准软件 ARR 的拉扯。核心关注点是:Vastbase 能否把 openGauss 生态红利、数据库产品矩阵和行业交付能力,转化为可持续、可复购、低边际成本的标准软件收入。海量不是没有业务基本盘,也不是马上失血致死;客户越多,服务债越大。

喝醉酒的小白 580

收藏!从RAG到Agent:向量数据湖解锁大模型上下文工程核心(小白&程序员必看)

RAG 正在进化为 Context Engineering:AI 应用从无状态问答走向有状态 Agent,要求上下文具备长期记忆、环境感知与动态管理能力,推动基础设施从“检索工具”升级为“上下文操作系统”。向量数据湖 = 统一底座 + 湖仓一体 + 多模态索引:通过兼容开放格式、存算分离、多引擎协同和 SOTA 索引体系,构建高性价比、高灵活性的非结构化数据管理平台,解决 RAG 中的数据孤岛与扩展瓶颈。生产级能力 = 多租户 + 冷热分层 + Schema 演进。

优快云_224022的博客 798

H3C VRF实验

POP-vpn-instance-RT1]route-distinguisher 11:11 # VPN实例-RT1的路由区分器值11:11。配置路由泄露,其实就是在一个VPN示例中添加另一个VPN实例的下一跳,比如在VPN实例RT1中添加去往SRV的默认路由。但是也有了一个新的问题,那就是RT1、RT2和RT3也能互访了,这让VPN实例变得没有意义了。[POP]ip vpn-instance RT1 #配置vpn实例-RT1。绑定了VPN实例,所以要把路由添加到VPN实例POP中。

m0_68698993的博客 4039

九齐NY8A051F低功耗模式全解析:从待机到休眠的省电实战

本文全面解析台湾九齐NY8A051F MCU的低功耗模式,从待机到休眠的省电实战技巧。通过实测数据展示四种工作模式的电流消耗差异,提供模式切换的标准流程和唤醒时序优化策略,并分享外围电路省电设计和低电压检测的实战应用,帮助开发者实现物联网设备的超长续航。

weixin_30839881的博客 413

从RAG到Agent:一文读懂向量数据湖在Context Engineering中的核心实践!

文章讲述了从RAG到Agent的技术演进,强调Context Engineering成为提升AI应用能力的关键基础设施。介绍了向量数据湖作为新一代Context存储与处理平台,通过湖仓一体架构统一管理多模态、海量、异构的上下文数据。文章详细阐述了Context Engineering的三大支柱、湖仓一体架构的创新以及生产级治理能力,指出未来的AI应用竞争力不仅在于模型本身,更在于上下文基础设施的深度与效率。

2401_85325557的博客 577

DSP TMS320F280049之CCS工程的建立(库函数版)

TMS320F280049 DSP是TI最新出的一款C2000系列的DSP,主频为100MHZ,功能较为强大,具有较多的片上模拟外设。这一节主要讲述如何新建F280049的CCS工程。 Step1.下载文件: 下载C2000Ware软件并安装。下载地址如下: http://www.ti.com.cn/tool/cn/C2000WARE?keyMatch=C2000Ware%2...

fanxianyan1993的博客 1万+

企业级大模型落地:从RAG、微调到Agent的实战挑战与解决方案

大语言模型作为新一代人工智能基础设施,其核心原理是基于海量数据预训练生成的通用能力。然而,将这种强大的生成式AI技术转化为企业级生产应用,面临着可靠性、准确性、安全性与经济性等多维挑战。从技术价值看,它旨在将模型的通用智能安全、高效地集成到现有业务流程中,实现知识问答、内容生成与自动化决策等场景的智能化升级。在应用实践中,**RAG**技术通过检索增强生成有效缓解模型幻觉问题,为模型提供精准的事实依据;而**微调**则能让模型深度掌握特定领域的专业知识与任务格式。最终,通过构建以Agent为核心的智能体框架

weixin_33937499的博客 466

NVIDIA Orin AGX开发环境搭建避坑指南:从Ubuntu 22.04到ROS2完整配置流程

本文详细介绍了NVIDIA Orin AGX开发环境搭建的全流程,从Ubuntu 22.04系统安装到ROS2深度优化,涵盖驱动部署、CUDA环境配置、散热与功耗管理等关键步骤。特别针对Orin AGX的特性提供了实用避坑指南和性能优化技巧,帮助开发者高效完成开发环境配置。

weixin_28340315的博客 451

CUDA&PCL 点云体素下采样

CUDA&PCL 点云体素下采样

dayuhaitang1的博客 1271

数据湖多模态向量化与RAG实践:让沉睡数据被AI理解

数据湖中存放着海量的图片、视频、音频和文本等多模态数据,但传统SQL只能按字段过滤,难以进行语义级别的检索和问答。要释放这些数据的价值,关键在于多模态向量化——将不同模态的数据统一映射到同一向量空间,使AI能够执行跨模态的语义匹配。结合向量数据库的近似检索与大模型的RAG能力,企业可以构建从数据接入、向量化入库到智能问答的完整链路。这种方案广泛应用于企业知识库、音视频内容平台、智能交通数据集等场景,让原本不可搜索的内容变成真正的知识资产。本文聚焦一套可落地的工程路径,涵盖多模态数据融合、siglip2等新型

weixin_33946605的博客 547

半导体材料仿真:二维材料仿真_(1).二维材料的基本概念

在半导体材料仿真领域,二维材料因其独特的物理和化学性质而受到广泛关注。二维材料,也称为二维纳米材料,是指在二维空间(通常是平面)上具有原子级厚度的材料。这些材料的厚度通常在几个纳米甚至单个原子层的范围内,使得它们在电子、光学、热学和机械性能上表现出与传统三维材料显著不同的特性。本节将详细介绍二维材料的基本概念,包括它们的分类、结构、性质以及在半导体材料仿真中的应用。

2401_87715305的博客 1546

数据契约:AI时代RAG与Agent系统的数据可信基石

在数据驱动的AI工程实践中,数据质量与一致性是决定应用成败的关键。数据契约作为一种核心的数据治理理念,本质上是数据生产者与消费者之间的一份标准化协议,它通过定义数据的结构、语义、质量与演化规则,确保数据在流动过程中的可信与可靠。其技术价值在于将不可控的‘数据原材料’转化为可预测、可依赖的‘标准件’,从而大幅降低系统间的耦合复杂度。在RAG(检索增强生成)场景中,数据契约能为文档切片提供精准的元数据和时效性保障,直接提升检索的相关性与准确性;对于AI Agent,契约则定义了其感知与决策所依赖的数据格式、语义

weixin_33892359的博客 448

学Simulink--基础微电网场景实例:基于Simulink的微电网并网/孤岛无缝切换控制仿真

本文完成了基于 Simulink 的微电网并网/孤岛无缝切换控制仿真,实现了:✅ 构建含双模式逆变器的微电网模型✅ 实现预同步 + Stateflow 逻辑的智能切换✅ 验证计划与非计划切换的性能边界✅ 证明“无缝”在工程上是可实现的。

amy_mhd的博客 104

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

RAG 进阶 Context Engineering:Milvus 向量数据湖仓一体架构实践全解析

大模型应用正在经历从对话工具到智能体的本质跃迁,核心差异在于状态的连续性:

weixin_58753619的博客 259

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

全栈AI应用架构实战:从RAG、智能体到向量数据库的融合设计

在数字化转型浪潮中,人工智能(AI)与软件工程的结合正催生新一代应用架构。其核心原理在于,通过大语言模型(LLM)等基础AI能力,赋予系统理解、推理和生成自然语言等认知功能。这一融合的技术价值在于,能够将非结构化数据转化为可操作的智能,从而驱动业务流程自动化与决策智能化。典型的应用场景包括智能问答、文档分析与自动报告生成等。本文聚焦于实现此类智能系统的关键技术路径,深入探讨了检索增强生成(RAG)技术如何结合向量数据库构建专属知识库,以及如何利用智能体(Agent)框架进行复杂任务编排,为构建可靠、高效的生

angou6476的博客 319

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

AI Agent 如何重构下一代数据栈、多模态数据湖的演进以及元数据治理的创新实践

哈喽大家好,我是「老周聊架构」主理人老周,周末参加了Data For AI的活动,本来那天有龙虾的活动,想了几秒:我毅然还是选择了Data For AI的活动。为啥呢?“AI的燃料是数据,数据的燃料是元数据。” 如何?这个理由充分不,哈哈哈哈,我们话不多说直接进入正题。一个下午的分享,老周也说说自己的一些想法。活动举办是在龙华,这也是我第一次去龙华参加活动,之前都是在南山,也是不一样的活动体验吧。多模态数据的深度整合能力。

riemann_的博客 677

Agent数据工程实战:构建高质量意图-动作-约束三维数据集

大语言模型Agent并非简单文本生成器,而是面向真实业务的多步决策系统。其核心能力不取决于模型参数规模,而在于能否获取并理解具备明确意图、可执行动作与刚性业务约束的结构化数据。这类数据需覆盖用户深层目标、工具调用序列及实时规则边界,是连接LLM推理与业务落地的关键契约。在金融、医疗、工业等高可靠性场景中,数据质量直接决定Agent决策鲁棒性与长期稳定性。本文聚焦LLM Agent数据工程的本质挑战——如何从混沌业务中提炼最小可行数据集(MVDS)、构建决策-动作-反馈闭环、注入对抗性样本,并实现数据-模型-

diyu8056的博客 319

【必收藏】2025年大模型工程化全景指南:从Chatbot到Agent的范式转变

在深入探讨技术细节之前,必须厘清“智能体(Agent)”这一概念的工程定义。在市场营销话术中,任何接入了API的聊天机器人都可能被称为Agent,但在严谨的系统架构中,智能体与传统的工具或助手有着本质的区别。根据行业共识,智能体是一个利用大语言模型决定应用程序控制流的系统 [9]。其核心特征在于自主性(Autonomy)。特征维度工具 (AI Tools)助手 (AI Assistants)智能体 (AI Agents)触发机制被动:由人类明确调用响应式:响应用户查询。

大模型研究中心 1015

企业级AI Agent生产实践:从Demo到可靠系统的工程化之路

如果你正在尝试将AI Agent从实验室Demo推向企业生产环境,那么这篇文章就是为你准备的。你可能已经用LangChain或AutoGPT跑通了几个惊艳的示例,但当你想把它集成到公司的CRM、ERP或客服系统时,却发现处处是坑:成本失控、响应不稳定、逻辑不可控、安全审计无从谈起。这感觉就像造了一辆能在赛道上飞驰的F1赛车,却无法让它安全、可靠地行驶在城市的早高峰。 Databricks,这家以数据湖仓和Spark闻名的大数据巨头,其工程团队在构建企业级AI Agent方面积累了大量的实战经验。他们的观点非

weixin_30847865的博客 382
上一篇: 从零搭建智能体!LangGraph构建第一个Agent
下一篇: 构建Agents框架|LlamaIndex使用概览
AI_小站
博客等级 码龄3年 6255粉丝 1156原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值