LLaMA Factory大模型微调框架—从“技术活“变成“业务可操作的落地活“

Windows密码忘了怎么办?一分钟看懂Windows密码底层机制:无需重装系统也能无痕找回登录密码 忘记Windows开机密码,不一定非得重装系统!本文手把手教你通过提取NTLM Hash值实现“无痕找回密码”,无需PE、无需清除密码,对系统零修改 🛡️ 搭配mimikatz与在线解密平台,小白也能快速上手,了解Windows密码底层机制 🔐 阅读详情

很多人第一次用LLaMA Factory时,会觉得"不就是加载数据集、调几个参数吗?",但一上手就卡壳

📍 准备好的客服对话CSV数据,框架始终报"字段缺失"

📍 想同时微调"产品问答+故障排查"两个任务,结果模型越训越偏

📍 好不容易训完7B模型,部署到企业API时,又卡在"PyTorch模型转ONNX格式报错"

明明是轻量型微调框架,却没发挥出"快落地、低门槛"的优势。

其实LLaMA Factory的核心不是"简单调参",而是"全流程数据适配+轻量多任务调度+部署生态兼容"这三大真实落地能力。

🤔 为什么选LLaMA Factory?

其他微调框架(如Transformers Trainer)能做“模型训练”,但LLaMA Factory的优势是“贴合中小规模业务的落地效率”,这是通用框架没法比的:

优势具体表现业务价值
全流程低代码数据适配原生支持CSV/JSON/JSONL等主流格式,内置数据划分、格式校验工具不用写数百行数据处理脚本,一键生成训练集+验证集
轻量多任务训练支持8G显存可跑7B模型QLoRA微调,支持多任务权重配置适合企业"小数据、多场景"的微调需求,避免模型偏科
部署生态高度兼容直接对接PyTorch、ONNX Runtime、FastAPI等工具微调后模型快速封装成HTTP接口,不用重构业务逻辑

一、先搞懂LLaMA Factory的"特有模块"

LLaMA Factory的核心模块围绕"业务微调全流程"设计,每个模块都有区别于通用框架的"落地向"用法。


二、实战:搭"企业客服问答大模型"

全程聚焦LLaMA Factory能落地、通用框架难高效实现的事:客服数据规范处理→轻量多任务微调→企业API部署

1. 需求定义(只抓LLaMA Factory能落地的点)

  • 输入

    企业客服历史对话数据(1000条,JSONL格式)、产品售后政策文档

  • 核心任务

    数据噪声过滤 + 双任务微调 + HTTP接口部署

  • 输出

    客服问答微调模型(7B参数) + FastAPI接口服务(并发100+)

  • 关键

    全程不用写复杂脚本,8G显存GPU,3天内落地

2. 数据准备(LLaMA Factory独家步骤)

第一步:数据格式规范

按框架要求整理JSONL数据,每条数据需包含3个核心字段:

🛑 误区提醒:不要遗漏"instruction"字段,否则模型会缺乏任务导向,回复泛化无边界

🛠️ 工具使用:用框架自带的"data_check.py"脚本校验数据,批量补充缺失字段

第二步:数据划分与噪声处理

(1)在LLaMA Factory界面选择"数据预处理"→"自动划分",按8:2比例拆分训练集/验证集

(2)手动标记噪声数据:将"用户无意义提问"、“客服错误回复"标记为"无效数据”

3. 微调参数配置(LLaMA Factory特有操作)

(1)基础模型选择

在"模型管理"中选择"Llama 2-7B-Chat"(开源可商用,适合对话场景)

(2)微调策略与参数设置
  • 策略选择

    QLoRA(8G显存首选)

  • 多任务权重配置

    根据数据量调整权重,避免模型偏向数据多的任务

(3)训练参数设置
参数推荐值说明
学习率2e-4对话场景最优值
训练轮次3中小数据量避免过拟合
批大小28G显存最大支持
早停机制patience=2验证集损失2轮不下降则停止

4. 训练监控与效果验证

📊 实时监控

在"训练监控"界面查看损失值曲线:

  • ✅ 训练集Loss持续下降、验证集Loss趋于平稳 → 训练正常
  • ❌ 验证集Loss上升 → 立即停止,降低学习率重试
🧪 人工抽样测试
测试场景输入问题预期输出
退款咨询“拆封的耳机能退吗?”“您好,拆封后不满足7天无理由退款条件…”
物流查询“订单3天没发货,在哪查物流?”“您好,可在订单详情页点击’物流跟踪’查看…”
🔧 优化策略

若模型对特定关键词响应不准确,补充相关数据,启动增量微调(1小时内完成)

5. 部署对接(LLaMA Factory专属操作)

(1)模型格式转换

用官方"export_onnx.py"脚本将PyTorch模型转为ONNX格式:

🎯 优势:ONNX格式支持多框架部署,推理速度比原生PyTorch快30%

(2)FastAPI接口封装

使用框架自带的"api_template.py"模板:

(3)业务系统对接
  • 部署到企业云服务器(如阿里云ECS)
  • 客服系统通过HTTP请求调用"/chat"接口
  • 响应时间控制在1-2秒(通过限制max_new_tokens=100优化)

三、LLaMA Factory高阶技巧

1. 增量微调:避免全量重训,节省时间

适用场景:企业每月新增客服数据(如200条)

操作步骤:

  1. 加载历史训练的LoRA权重(路径./saved_model/lora)
  2. 新增数据 + 10%历史核心数据混合作为新训练集
  3. 设置训练轮次为1,学习率降至1e-4

🎯 优势:训练时间从8小时缩短至2小时,保留原有知识

2. 多任务权重优化:解决"偏科"问题

问题识别:某类问题准确率低(如"物流查询"准确率仅70%)

解决方案:

(1)分析数据量

检查数据分布是否均衡

(2)补充数据

针对性补充50条同类数据

(3)调整权重

重新分配任务权重(如从0.3提升至0.5)

(4)验证效果

重新训练1轮,检查准确率提升

3. 部署性能优化:适配企业硬件

硬件场景优化方案效果
小显存GPU(4G-8G)INT4量化(quantization_bit=4)推理显存占用降至4G以下
高并发场景ONNX Runtime + 多线程推理并发量从100+提升至300+
边缘设备转为TensorFlow Lite格式体积压缩至1/3,加载速度提升50%

四、LLaMA Factory常见坑

  • 学以致用场景:

    产品知识库问答模型微调

  1. 触发

    企业上传产品手册(提取500条"功能问答")

  2. 处理

    数据预处理→选择模型+微调策略→设置instruction

  3. 输出

    知识库问答模型→部署为企业OA接口

🎯 核心价值:全程不用算法工程师写复杂代码,业务人员按流程操作即可落地

这就是LLaMA Factory的核心——把"大模型微调"从"技术活"变成"业务可操作的落地活"

  • 结语:LLaMA Factory不是"另一个通用微调工具",而是"中小规模业务的微调连接器"。

给新手的建议:

  1. 先找一个企业小需求(客服问答、知识库适配)
  2. 从"1000条数据、8G显存"入手
  3. 逐步扩展多任务场景

当你发现"不用重构业务系统,就能让模型适配实际需求"时,就真正用透了LLaMA Factory的特色——毕竟,能解决企业真实痛点的微调框架,才是有价值的工具。

小编最近正聚焦研发领域的实际应用,从实验数据AI智能分析到研发流程自动化工具的适配测试,都在逐一拆解验证。想获取这些工具的优质操作指南、避开研发中AI应用的常见误区?

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇
​

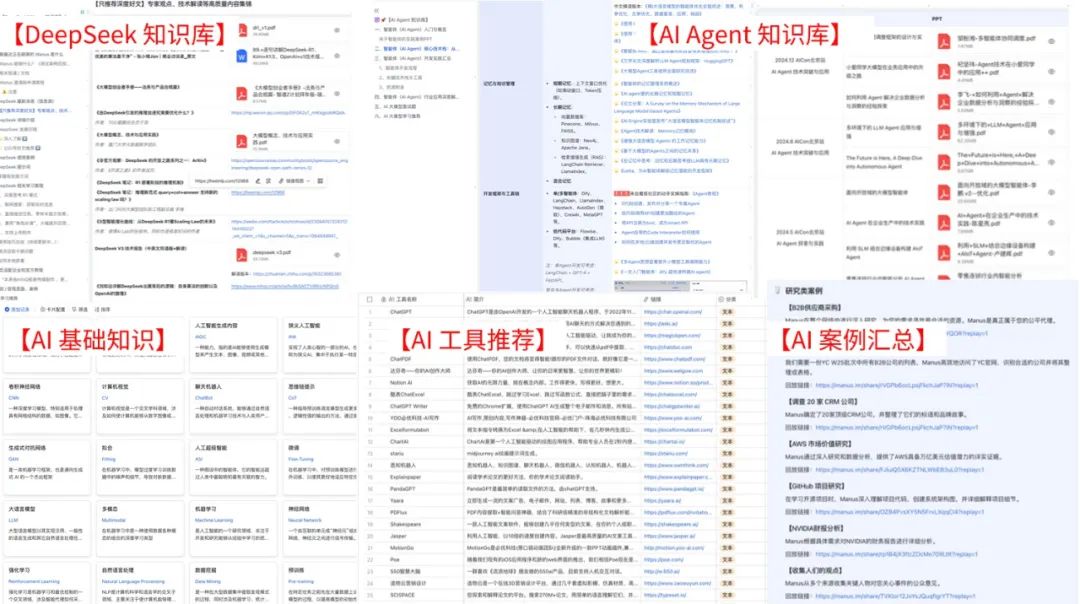
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

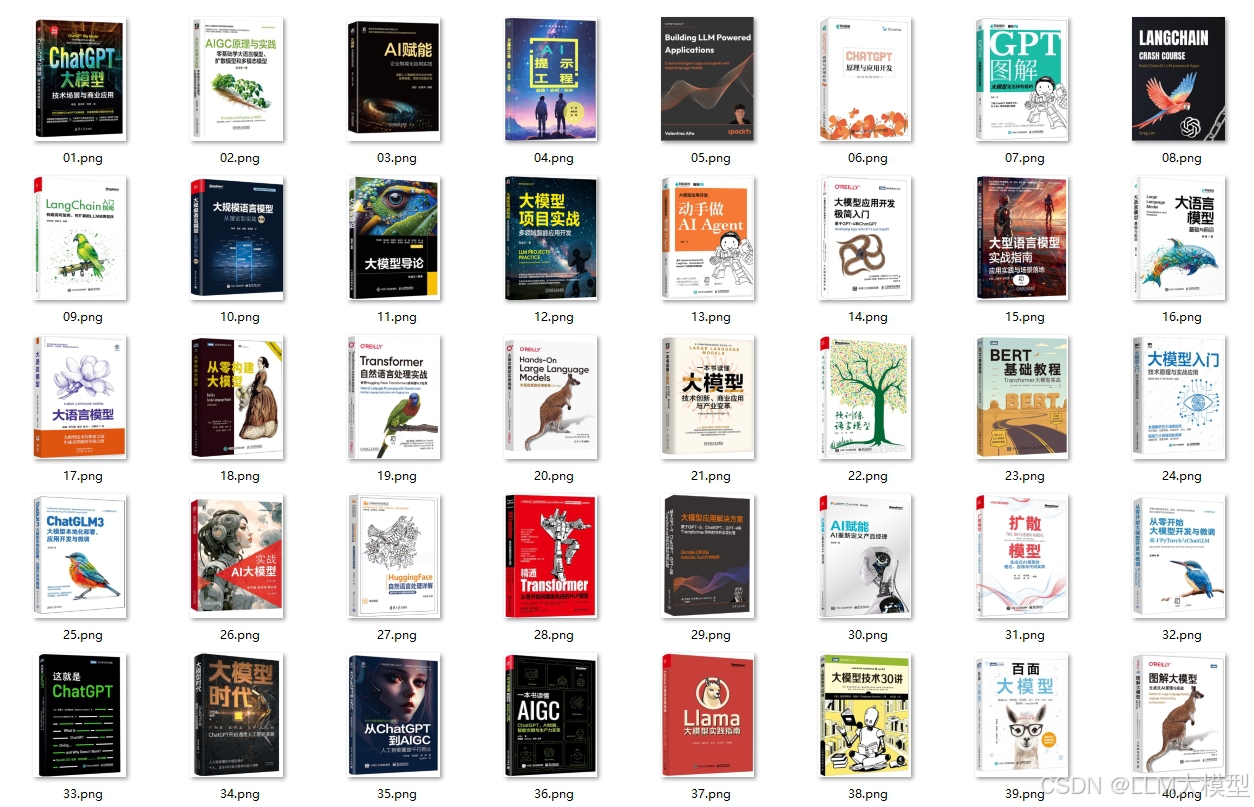
1. 100+本大模型方向电子书
在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
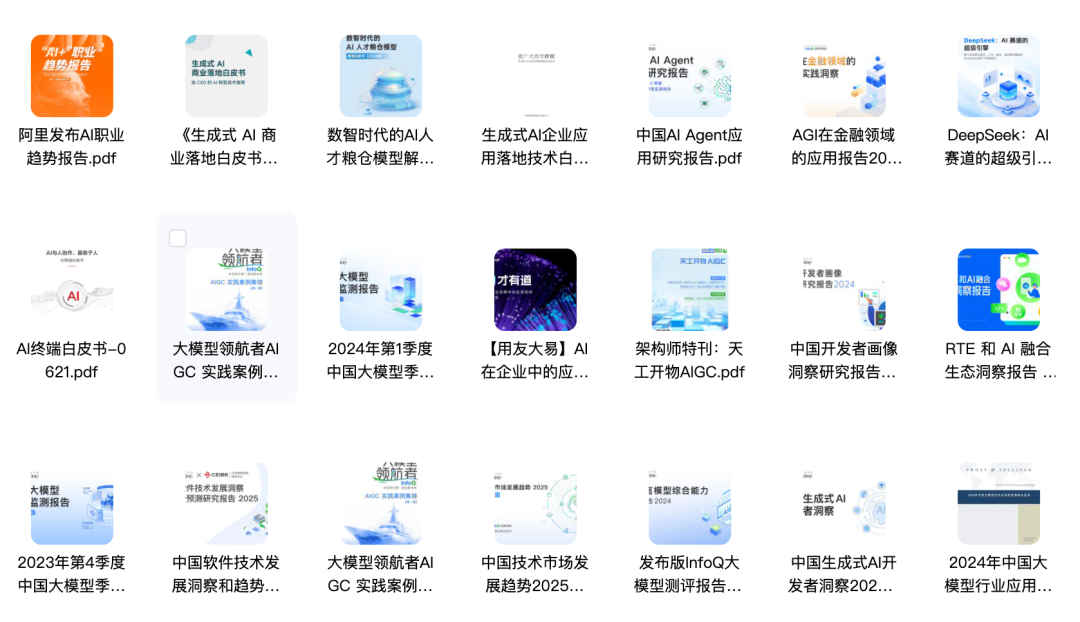
  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
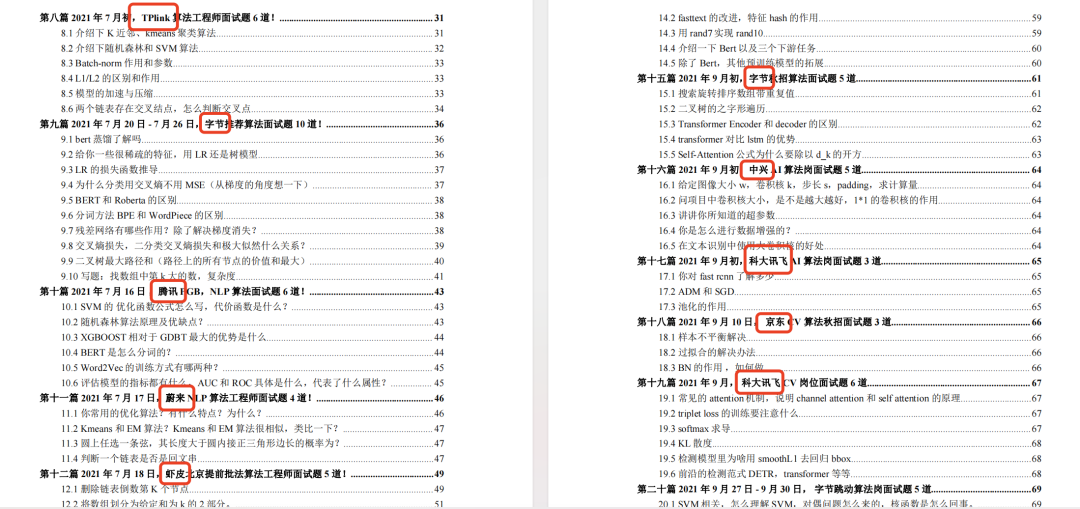
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
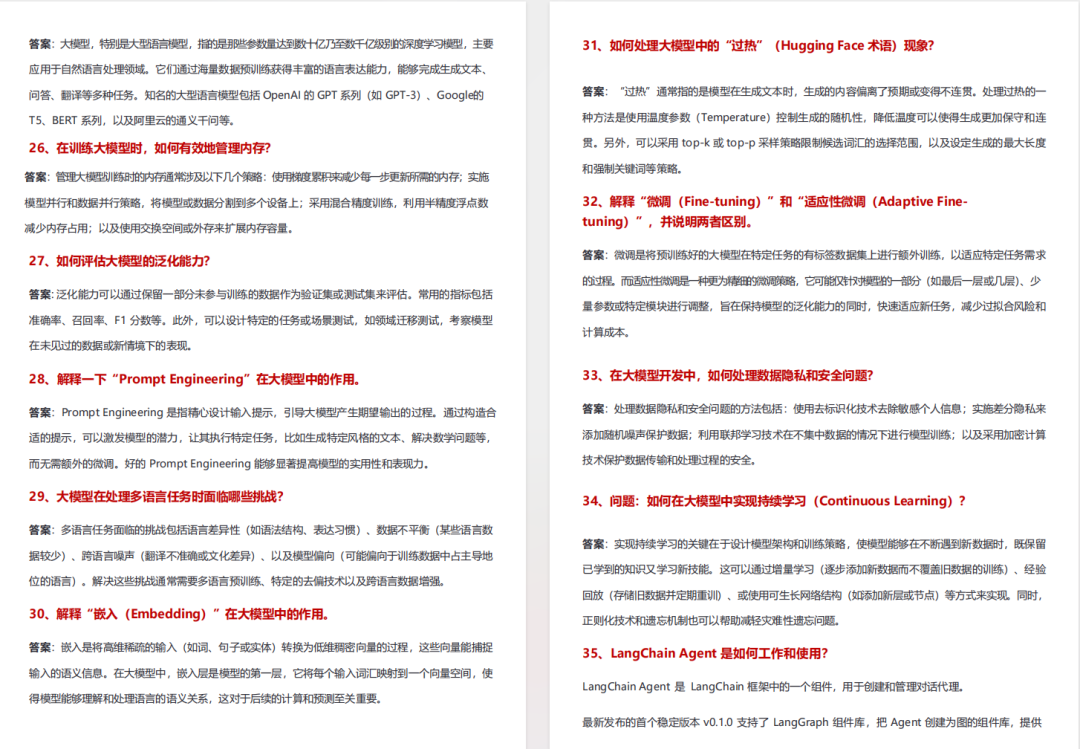
2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
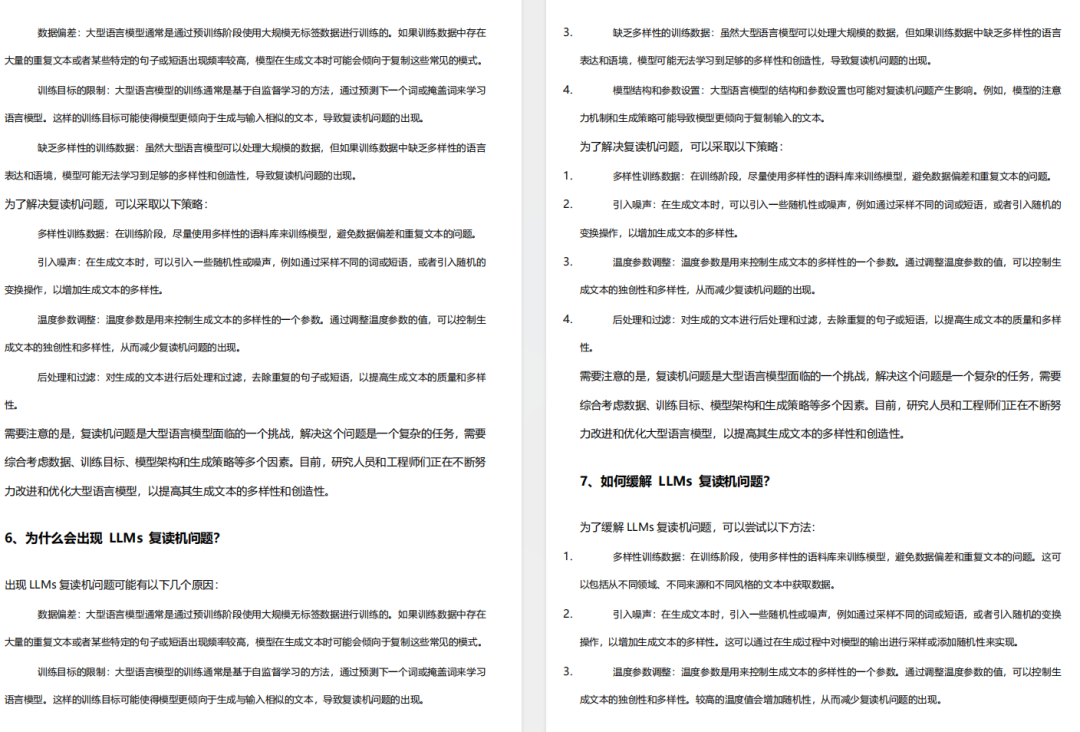
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
在这里插入图片描述

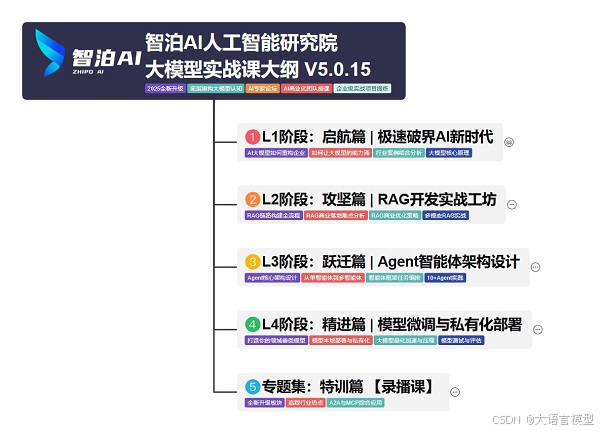
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
img

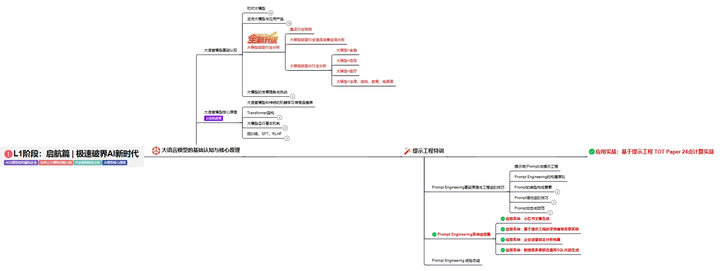
L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
img

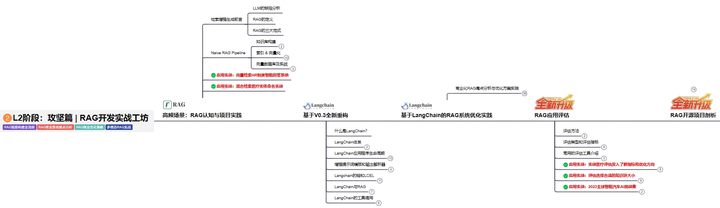
L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
img

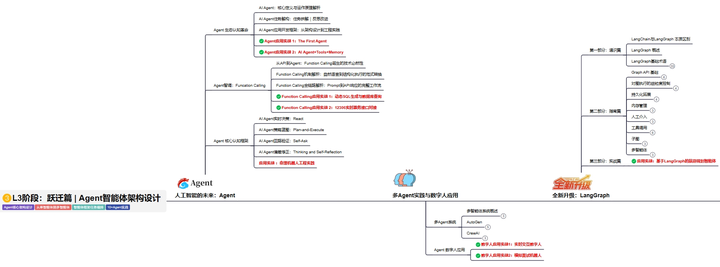
L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
img

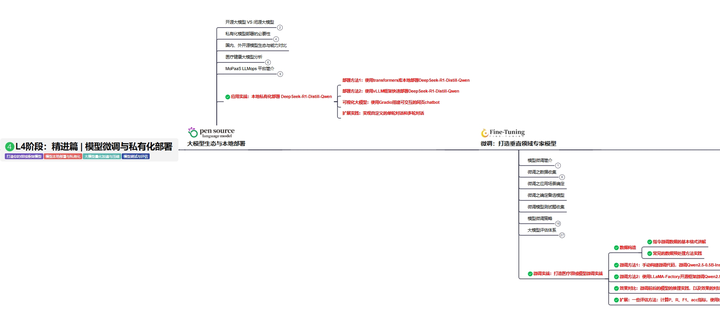
L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
img

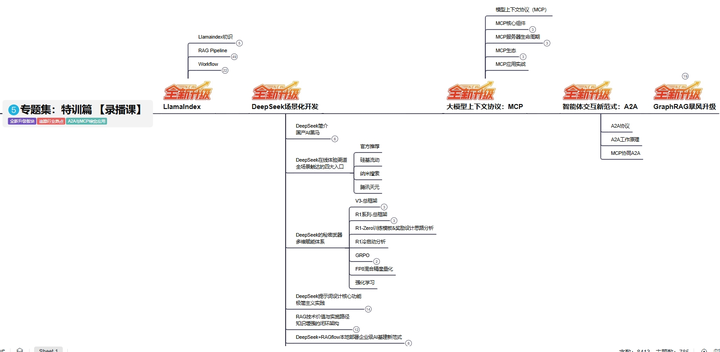
L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

CAPL学习之路-关键字 在capl中,关键字具有特殊的含义和用途,因此,不得将关键字用作变量或函数的名称 声明数据类型的关键字 可以用不同的关键字,声明或引用不同类型的数据 byte 声明一个字节的变量 word 声明两个字节的变量 dword 声明四个字节的变量 int 声明两个字节的整数 long 声明四个字节的变量 qword 声明八个字节的变量 char 声明一个字符串 float 声明一个浮点数,8个字节 double 声明一个浮点数,8个字节 定义一个结构体或枚举类型 struct struct Data { . 阅读详情

相关推荐

Halcon实战:5分钟搞定自定义直线卡尺工具(附完整代码下载)

本文详细介绍了如何使用Halcon快速开发自定义直线卡尺工具,通过交互式ROI绘制、边缘检测和直线拟合三个核心函数,实现高效工业视觉检测。文章包含完整代码下载,帮助开发者在5分钟内掌握这一实用工具的开发技巧,提升直线检测的精度和效率。

perl8的博客 252

LLaMA Factory深度解析:中小规模业务的大模型微调框架,轻松实现从数据准备到API部署的全流程!

LLaMA Factory是一款专为中小规模业务设计的大模型微调框架,核心优势在于全流程数据适配、轻量多任务调度和部署生态兼容。支持8G显存运行7B模型,提供低代码数据处理、多任务权重配置和快速部署能力。通过企业客服问答系统实战案例,展示了从数据准备、模型微调到API部署的完整流程,让业务人员无需编写复杂代码即可落地大模型应用。

2401_84204413的博客 1814

Dr_can Kalman Filter学习笔记(一)

本文是在b站Dr_can的卡尔曼滤波课程学习过程中的学习笔记

苏大侠的博客 1054

对比测评:Llama-Factory vs 其他微调框架的优劣分析

本文系统对比Llama-Factory与主流微调框架在易用性、效率和功能上的差异,突出其在低资源环境下支持QLoRA、可视化操作和快速部署的优势,适用于中小团队高效实现大模型领域适配。

weixin_30205153的博客 1092

Llama模型结构拆解:为什么MLP模块要这样设计?从参数配置到计算流程全解析

本文深入解析了Llama模型MLP模块的设计精髓。通过拆解其三线性层结构、门控机制与SwiGLU激活函数,揭示了并行计算如何提升效率,并详细阐述了intermediate_size参数配置背后的经验权衡与计算考量,帮助读者透彻理解这一核心组件的设计逻辑与工程实现。

mac99的博客 530

Python实战:5分钟搞定抖音无水印视频下载(附完整代码)

本文系统介绍了抖音无水印视频下载的多种技术方案,重点解析了抖音视频的获取逻辑与去水印原理。文章提供了从零代码的浏览器插件到可编程的Python脚本的完整实现路径,并附带了详细的代码示例,帮助用户快速构建自己的抖音视频下载工具箱。

weixin_29089057的博客 851

LLaMA系列模型如何快速微调?Llama-Factory给出标准答案

本文介绍如何使用Llama-Factory高效微调LLaMA系列大模型,支持全参数、LoRA和QLoRA等多种方式,结合WebUI实现零代码训练,并可在消费级显卡上运行。框架统一管理主流模型,简化分布式训练与部署流程,显著降低大模型定制门槛。

weixin_33245447的博客 1066

IBM Storwize V3700存储维护实战:硬盘更换、电源模块热插拔与带外管理IP配置

在企业IT基础设施中,存储阵列是数据持久化的核心组件,其稳定运行直接关系到业务连续性。存储阵列通常采用RAID技术实现数据冗余,并通过热插拔、冗余电源等设计保障高可用性。带外管理则提供了独立于业务网络的硬件级监控与管理通道,是运维的关键手段。本次实战以一台IBM Storwize V3700存储阵列为例,详细记录了在业务低峰期,依据严谨的操作流程,对出现SMART预警的硬盘进行在线更换,并对有异响的冗余电源模块实施热插拔更换。针对管理界面强制要求设置VIP才能配置带外管理地址的限制,文章提供了通过SSH命令

weixin_29172963的博客 304

基于Docker的LLama-Factory镜像上线,开箱即用的大模型微调解决方案

LLama-Factory推出官方Docker镜像,实现开箱即用的大模型微调,支持QLoRA等高效方法,显著降低环境配置与硬件门槛。通过容器化技术,保障跨平台一致性,提升团队协作与生产部署效率,推动大模型定制的标准化和工业化。

weixin_35811662的博客 842

RPA实战-UiPath自动化处理Outlook邮件附件全流程解析

本文详细解析了如何使用UiPath实现Outlook邮件附件的自动化处理全流程,涵盖环境配置、核心流程实现、高级功能扩展及性能优化技巧。通过RPA技术,企业可大幅提升邮件附件处理效率,减少人工操作错误,适用于财务、物流等多个场景。

weixin_33701251的博客 430

【C2000系列DSP的堆栈评估方法】程序跑飞,如何快速定位是否堆栈溢出?

静态分析:通过 CCS 编译器快速获取理论堆栈使用量,适合初步评估,无法覆盖动态场景; RAM 填充法:最可靠的动态评估方法,通过填充特征值检测实际最大堆栈使用量,需覆盖所有运行场景; 调试器监控:调试阶段快速验证堆栈指针变化,辅助确认关键函数 / 中断的堆栈占用。

昔时扬尘处 235

如何高效微调大模型?LLama-Factory一站式解决方案全解析

更多AI大模型开发都在这>><< >><<

2401_85592132的博客 1310

多智能体系统在军事仿真中的应用:AI人工智能战略推演

本文旨在全面解析多智能体系统在军事仿真领域的应用技术,重点探讨AI驱动的战略推演系统的设计原理和实现方法。研究范围涵盖从基础理论到实际应用的完整技术栈。本文采用从理论到实践的递进结构,首先介绍核心概念,然后深入算法实现,最后展示实际应用案例和未来展望。多智能体系统(MAS):由多个相互作用的智能体组成的分布式系统军事仿真(Military Simulation):通过计算机模拟军事行动和战争场景战略推演(Strategic Wargaming):通过模拟推演评估军事战略的有效性更高保真度的仿真。

AI天才研究院 1779

LLaMA Factory微调大模型完整指南:从数据准备到API部署

本文介绍了使用LLaMA Factory对大语言模型进行指令监督微调(SFT)的完整流程。首先阐述了微调的必要性,即在基础模型上通过专业数据集训练提升特定任务表现。详细讲解了数据准备阶段如何构建符合ShareGPT格式的训练数据,并配置到LLaMA Factory中。文章对比了全量微调(Full FT)和参数高效微调(PEFT/LoRA)两种技术方法,提供了从模型下载到训练配置的完整指导。最后介绍了通过LLaMA Factory API和Ollama API实现模型部署的步骤,帮助开发者将基础LLM转化为解

2401_85375151的博客 953

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

【强烈推荐】大模型微调实战指南:从LLaMA Factory到Ollama,打造你的专属模型

模型微调,顾名思义,就是对模型微微做一些调整。为什么要做微调呢?如果可以的话,每个公司都想拥有一个属于自己的大模型。但是,现实比较残酷,训练一个大模型需要花太多的钱。按照一些大公司的说法,一个千亿参数的大模型,训练一次的成本大约需要几百万美元。这显然就超过一个普通公司承受的范围。虽然我们无法训练一个属于自己的大模型,但一个好消息是,我们可以做模型微调。大模型是构建于神经网络基础之上的,神经网络可以理解成一个一个的神经元构建的网络。训练模型,就是在调整神经元之间的连接方式。

大模型教程的博客 957

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

模型微调完全指南:从LLaMa Factory到Ollama,收藏级教程

本文系统讲解了模型微调的核心概念与完整流程。首先阐明微调是对预训练模型部分参数的调整,相比全量训练成本更低;其次将微调流程拆解为数据准备、模型训练、效果评估和部署应用四个关键环节;最后以LLaMA Factory为例,从数据格式准备到图形界面操作,详细演示了从alpaca/sharegpt格式数据准备、GGUF格式转换到Ollama平台部署的全过程,为开发者提供了完整的开源模型微调实践方案,特别强调了高质量数据准备对微调效果的决定性影响。

ytt0523_com的博客 1041

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

LLaMA-Factory微调大模型实战指南

详解如何使用LLaMA-Factory进行大模型微调,涵盖环境搭建、数据集准备、LoRA训练与续训、模型评估及API部署。支持从断点恢复训练并导出量化模型,适合中文场景下的高效微调实践。

weixin_35751194的博客 759

大模型微调需要多少Token?我们用Llama-Factory算给你看

本文通过LLama-Factory框架,结合实际配置详解大模型微调所需的Token数量。重点分析有效训练Token的计算方式,涵盖数据量、batch size、梯度累积和epoch等因素,并给出100万至1000万Token的实践建议,帮助开发者科学规划微调任务。

weixin_35752122的博客 1278

大模型微调完全指南:从理论到LLaMA Factory实战,小白也能轻松掌握!

本文详细介绍了大模型微调的概念、方法和实践流程。首先解释了微调相比完整训练的成本优势,然后介绍了微调的基本步骤。重点讲解了使用LLaMA Factory进行微调的完整过程,包括数据准备、格式转换和图形界面操作。最后说明了如何在Ollama中部署微调后的模型,并通过与RAG技术结合使用,既保证数据新鲜度又确保服务质量。文章为开发者提供了从理论到实践的全面指导。

2401_85378759的博客 1013

腾讯混元大模型微调路径:是否采用类似Llama-Factory架构?

本文探讨腾讯混元大模型在微调技术路径上是否借鉴类似LLama-Factory的架构设计,重点分析多模型兼容、LoRA/QLoRA高效微调、图形化界面与端到端流水线等关键技术如何支撑企业级AI落地,揭示大模型定制向标准化、低代码化发展的趋势。

weixin_35972981的博客 1006

零代码玩转百模!LLaMA-Factory:大模型微调从未如此简单

还在为大模型微调烧显卡发愁?北航团队开源的 LLaMA-Factory 重新定义了大模型定制姿势!这个 GitHub 爆火项目已斩获 32.1K+ Stars,堪称大模型界的「瑞士军刀」🔧

2301_81888214的博客 949

大模型微调理论、实战:LLaMA-Factory、Unsloth

概述:策略、Prompt Tuning、Instruction Tuning、Prefix Tuning、Adapter Tuning、对比RAG、实战、数据集; 框架:LLaMA-Factory、Unsloth、ColossalAI、MS-Swift、XTuner、MindSpeed LLM、对比选型、其他框架。

lonelymanontheway的博客 1421

OLLAMA+LLama-Factory强强联合,本地化运行与微调大模型更高效

本文介绍如何利用Ollama与LLama-Factory实现大模型的本地化微调与部署,涵盖QLoRA低资源训练、GGUF量化推理、自定义模型封装及企业级应用集成,突出数据质量、显存优化与合规性等关键工程要点。

weixin_33205138的博客 996

如何用Llama-Factory低成本微调LLaMA?附完整Token购买指南

本文介绍如何利用Llama-Factory和QLoRA技术,在单张RTX 3090上完成对LLaMA-2-7B等大模型的高效微调。通过4-bit量化、LoRA适配器和一体化框架,显著降低显存占用与使用门槛,实现消费级硬件上的本地化模型定制。

weixin_35761094的博客 1060

使用LLaMA-Factory微调Llama3模型实战

通过LLaMA-Factory快速实现Llama3-8B的LoRA微调,涵盖环境配置、数据集构建、训练推理、模型合并与API部署,支持webui可视化操作及批量评估,完整流程助你高效定制专属大模型。

weixin_42604188的博客 968

零代码微调大模型!LLaMA-Factory Online让定制专属模型像打开浏览器一样简单

文章介绍了如何让大模型更好地适配业务需求,强调需同时运用Prompt工程、RAG和微调三种技术。应先通过Prompt和RAG测试评估模型表现,当效果接近上限时再考虑微调。微调能让模型真正理解业务逻辑和风格,但传统微调门槛高。LLaMA-Factory Online平台提供了一站式解决方案,无需编写代码即可完成模型微调,帮助团队将业务经验转化为"懂你"的专属AI模型。

xzp740813的博客 650
上一篇: 使用 LLaMA-Factory 微调自定义数据并加载对话的完整流程
下一篇: Github-Awesome LLM Apps:大型语言模型应用宝库
AI_小站
博客等级 码龄3年 6255粉丝 1155原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值