大模型微调实战 70B模型——30分钟完成微调!

DGX Spark在教育科研领域的深度应用:构建200B参数级学科大模型实战 DGX Spark作为一款革命性的桌面级AI超算,为教育科研工作者提供了强大的计算能力,使得在本地进行大规模教育AI模型开发和部署成为可能。通过本文介绍的技术方案和实践案例,我们可以看到其在教育知识图谱构建、个性化学习推荐、实时学习分析等方面的巨大潜力。随着教育智能化的深入发展,DGX Spark将成为教育科研领域的重要工具,助力教育工作者和研究人員开发更加智能、高效的教育解决方案,最终推动教育质量的全面提升。进一步学习资源NVIDIA DGX Spark官方文档教育知识图谱构建最佳实践。 阅读详情
AI摘要

本文介绍基于DGX Spark平台对70B参数大模型进行QLoRA微调的全过程,实测仅用30分钟完成训练,准确率达74.5%。依托128G统一内存架构与4-bit量化技术,实现高效低耗的大模型训练,同时兼容3B至32B等多类模型,展现强大适配性与企业级应用潜力。

作为AI领域的技术从业者,我们一直在寻找能够高效处理大模型微调的硬件平台。今天,我们将为大家带来DGX Spark在模型微调场景下的深度测试报告,看看这款被誉为"AI超级计算机"的设备在实际应用中的表现如何。
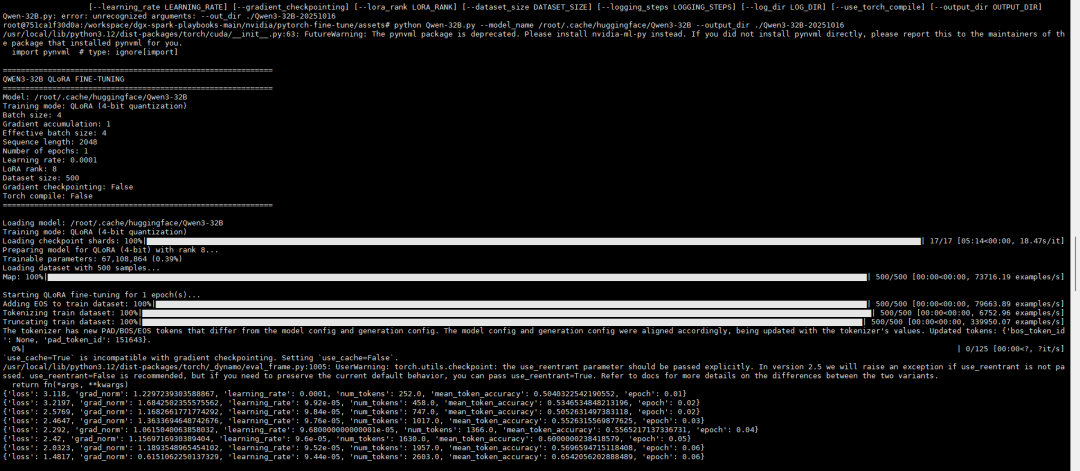
DGX Spark训练过程界面

NO.1

focal point

测试环境配置

硬件环境

· 测试平台:DGX Spark

· GPU配置:GB 10超级芯片

· 内存配置:128G统一共享内存

· 存储系统:4T 高速NVMe存储

软件环境

· 容器平台:Docker

· 基础镜像:nvcr.io/nvidia/pytorch:25.09-py3

· 深度学习框架:PyTorch 2.9.0

· 微调技术:QLoRA、全参数微调

数据集配置

· 数据集来源:Alpaca数据集

· 本地文件:train-00000-of-00001

-a09b74b3ef9c3b56.parquet(23.1MB)

· 样本数量:500条训练样本

· 数据格式:Parquet格式,包含instruction、 input、output三个字段

NO.2

focal point

测试模型概览

本次测试我们选择了三个不同规模的代表性模型:

  1. DeepSeek-R1-Distill-Llama-70B - 70B参数大模型

  2. Llama-3.2-3B-Instruct - 3B参数轻量级模型

  3. Qwen3-32B - 32B参数中大型模型

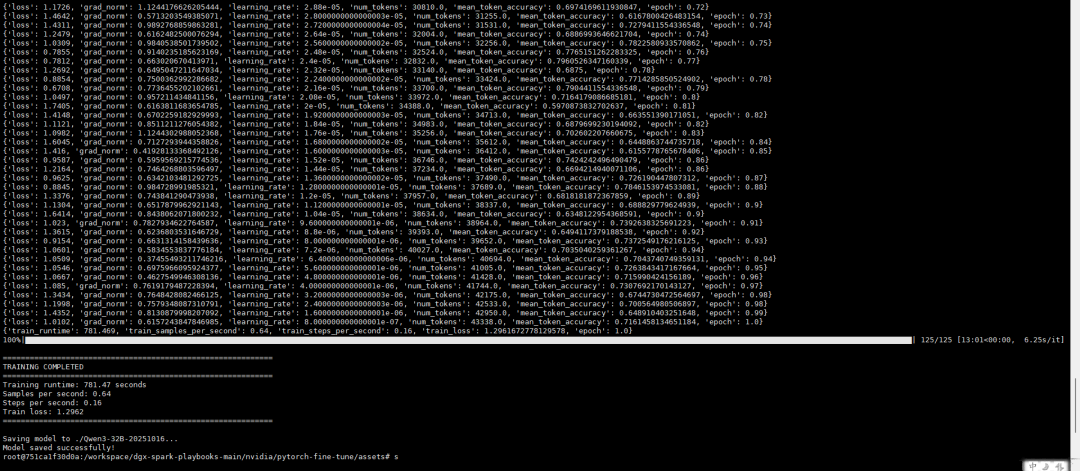
Qwen3-32B模型训练过程监控

NO.3

focal point

详细测试结果

1. DeepSeek-R1-Distill-Llama-70B测试

技术配置

· 微调方式:QLoRA(4-bit量化)

· 量化配置:NF4量化,双重量化,bfloat16计算

精度

· 批次大小:8

· 序列长度:2048

· 学习率:1e-4

· LoRA rank:8,LoRA alpha=16

· 目标模块:q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj

· 数据集格式:Alpaca标准格式

测试结果:

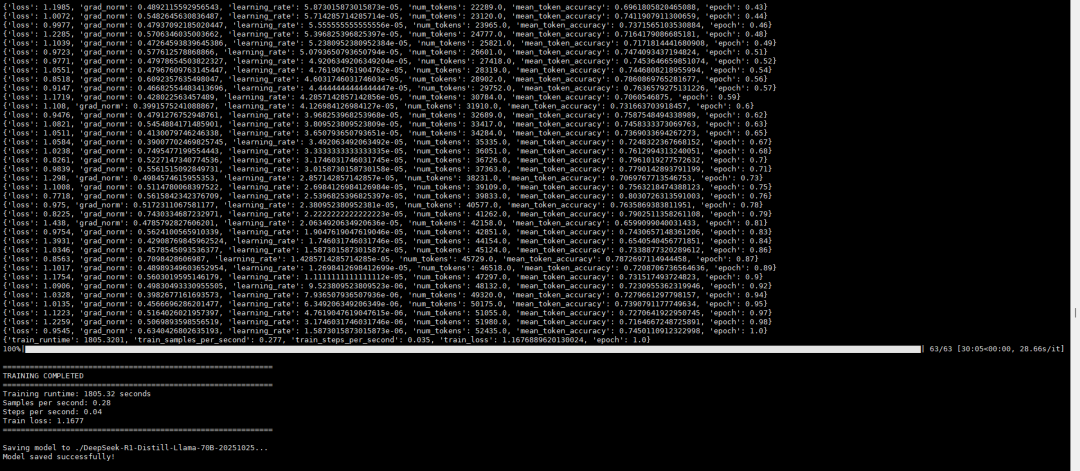
· 训练时间:1805.32秒(约30分钟)

· 训练损失:1.1677

· 可训练参数:103,546,880(仅占0.28%)

· 平均token准确率:最终达到74.5%

· 设备映射:balanced模式,自动分配GPU资源
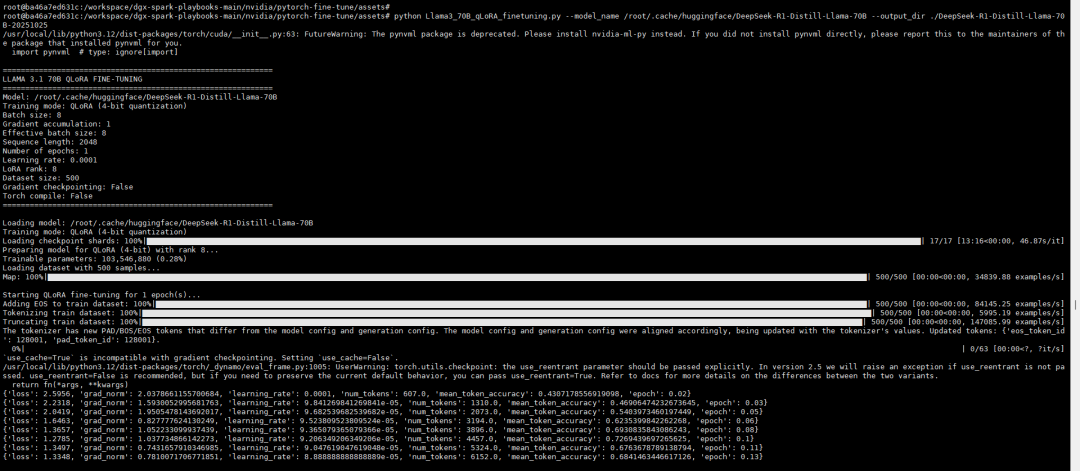
70B模型训练过程

技术亮点:

得益于DGX Spark创新的128G统一寻址系统内存架构,结合QLoRA量化技术,70B大模型得以在无需传统显存限制的情况下进行高效训练。这种架构消除了CPU和GPU之间的数据传输瓶颈,让大模型训练变得更加流畅,同时保持了良好的训练效果。训练过程稳定,损失曲线平滑下降。

理论说再多,不如一次实际的运行。我们直接用当下热门的AI模型来检验DGX Spark的真实战力。

2. Llama-3.2-3B-Instruct测试

技术配置:

· 微调方式:全参数微调(Full SFT)

· 批次大小:8

· 序列长度:2048

· 学习率:5e-5

· 数据集格式:Alpaca标准格式

· 优化器:adamw_torch

· 数据类型:bfloat16

测试结果:

· 训练时间:99.36秒(仅1.5分钟!)

· 训练损失:1.0989

· 可训练参数:3,212,749,824(100%全参数)

· 平均token准确率:最终达到75.4%

· 训练速度:5.03 samples/second
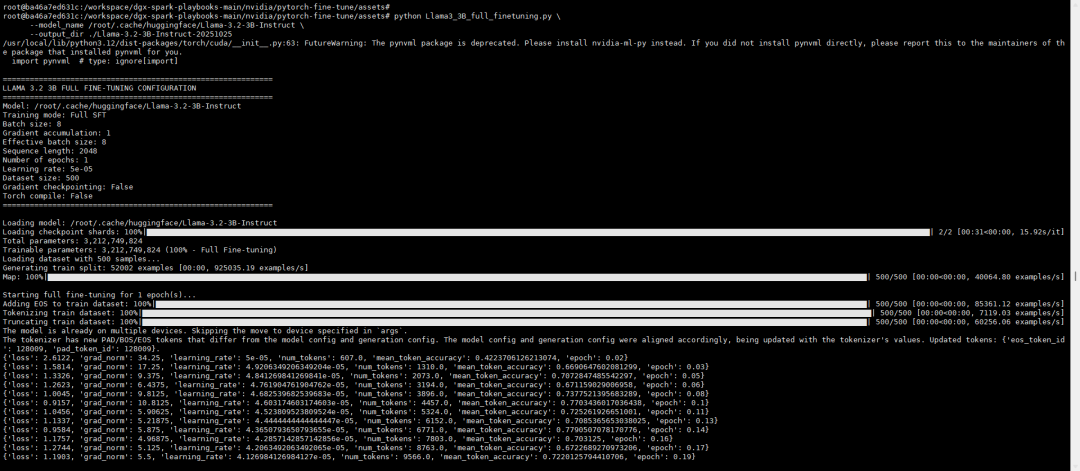
3B模型全参数微调实时监控

性能表现:

小模型的全参数微调展现了惊人的速度,不到2分钟就完成了整个训练过程,这对于快速原型验证和迭代开发非常有价值。

3. Qwen3-32B测试

技术配置:

· 微调方式:QLoRA(4-bit量化)

· 批次大小:4(比其他模型更保守)

· 序列长度:2048

· 学习率:1e-4

· LoRA rank:8,LoRA alpha=16

· 特殊处理:Qwen专用对话格式

· 数据集:本地parquet文件加载

Qwen特殊对话格式:

<|im_start|>system

You are a helpful assistant.<|im_end|>

<|im_start|>user

{instruction}<|im_end|>

<|im_start|>assistant

{output}

测试结果:

· 训练时间:781.47秒(约13分钟)

· 训练损失:1.2962

· 可训练参数:67,108,864(占0.39%)

· 平均token准确率:最终达到71.6%

· 训练速度:0.64 samples/second
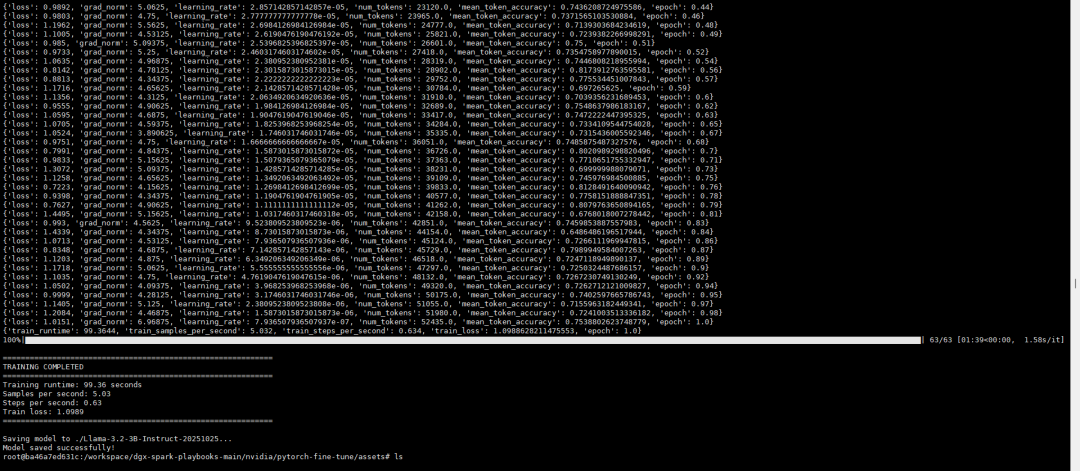
训练完成后的模型保存确认

NO.4

focal point

技术实现细节

数据处理流程

所有模型都使用了相同的数据预处理流程:

  1. 从本地parquet文件或HuggingFace加载Alpaca数据集

  2. 随机打乱并选择500个样本

  3. 根据不同模型格式化对话模板

  4. 批量处理并移除原始列

QLoRA技术优势

· 4-bit量化:大幅减少显存占用

· 双重量化:进一步优化存储效率

· NF4量化:保持数值精度

· LoRA适配:仅训练少量参数,降低计算成本

模型格式差异

· Llama系列:使用Alpaca标准格式

· Qwen系列:使用特殊的对话模板格式

· 统一处理:所有模型都添加EOS token确保完整 性

性能对比分析
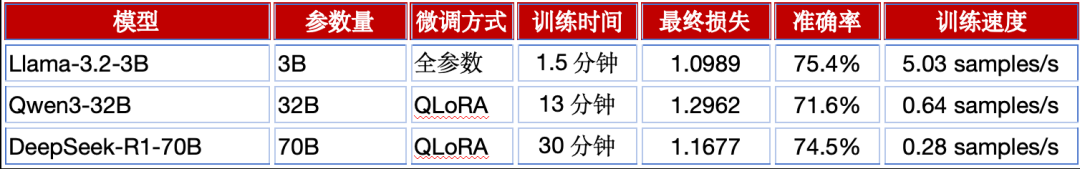
训练完成状态和性能统计

NO.5

focal point

技术洞察

1. 量化技术的威力

DGX Spark创新的128G统一寻址内存架构,彻底打破了传统GPU显存的限制。结合QLoRA技术,我们不仅能轻松驾驭70B级别的大模型训练,更通过仅训练0.28%-0.39%的参数,实现了接近全参数微调的效果,为企业级AI应用提供了前所未有的高效解决方案。

2. 训练效率的突破

· 3B模型全参数微调:1.5分钟完成

· 32B模型QLoRA微调:13分钟完成

· 70B模型QLoRA微调:30分钟完成

这样的训练速度在传统硬件上是难以想象的,DGX Spark展现了卓越的计算能力。

3. 模型适配性

不同模型架构(Llama vs Qwen)需要不同的对话模板,但DGX Spark都能很好地适配,展现了良好的兼容性。

NO.6

focal point

商业价值分析

对于企业用户

  1. 成本效益:大幅缩短训练时间,降低计算成本

  2. 快速迭代:支持快速原型验证和模型优化

  3. 扩展性强:从3B到70B模型都能高效处理

  4. 技术门槛低:标准化的脚本和配置,易于使用

对于研究机构

  1. 研究效率:加速大模型研究进程

  2. 资源优化:充分利用硬件资源

  3. 实验灵活性:支持多种微调策略

  4. 可重现性:标准化的测试流程

NO.7

focal point

使用建议

场景推荐

· 快速验证:使用3B模型进行全参数微调,1.5分钟获得结果

· 生产部署:使用32B-70B模型进行QLoRA微调,平衡效果和成本

· 研究探索:根据需求灵活选择模型规模和微调策略

最佳实践

批次大小选择:根据模型大小调整,大模型使用更小的批次

学习率设置:QLoRA使用1e-4,全参数使用5e-5

数据格式:确保使用正确的对话模板格式

监控训练:密切关注损失曲线和准确率变化

NO.8

focal point

实战说明

DGX Spark在大模型微调场景下表现卓越,无论是小模型的快速迭代还是大模型的高效训练,都能提供出色的性能支持。特别是70B模型30分钟完成训练的成绩,为企业级AI应用落地提供了强有力的技术保障。

关键成果

· 3B模型:1.5分钟完成全参数微调,准确率75.4%

· 32B模型:13分钟完成QLoRA微调,准确率71.6%

· 70B模型:30分钟完成QLoRA微调,准确率74.5%

技术优势

· QLoRA技术:让大模型微调变得可行

· 高效训练:显著缩短训练时间

· 稳定可靠:所有测试都顺利完成

· 易于使用:标准化的脚本和配置

NO.9

focal point

总结

DGX Spark在大模型微调场景下表现卓越,无论是小模型的快速迭代还是大模型的高效训练,都能提供出色的性能支持。特别是70B模型30分钟完成训练的成绩,为科研或企业级AI应用落地提供了强有力的技术保障。

对于需要在生产环境中进行大模型微调的科研团队、企业来说,DGX Spark 无疑是一个值得考虑的选择。

它不仅提供了强大的计算能力,更重要的是通过优化的软件栈和容器化部署,让复杂的AI训练变得简单高效。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

初探NVIDIA DGX Spark:桌面端大模型本地推理与开发的技术实践 摘要: NVIDIA推出的DGXSpark是一款面向本地化AI开发的一体化计算系统,搭载Grace Blackwell超级芯片,提供128GB CPU-GPU统一内存和1000TOPS算力,支持FP4稀疏计算与双机互联扩展。其紧凑设计适用于大模型推理、轻量化微调及科研场景,集成全栈AI软件,但存在存储限制且无法扩展GPU。DGXSpark体现了“云地协同”趋势,适合对隐私和延迟敏感的中小规模团队,需结合实际需求评估使用。 阅读详情

相关推荐

NVIDIA DGX Spark 深度应用解析:从大模型训练到边缘推理的完整实践指南

内存管理:充分利用统一内存架构,避免不必要的数据传输批处理大小:根据模型大小调整批处理大小以优化内存使用精度选择:在精度损失可接受范围内使用较低精度计算流水线优化:重叠计算和数据传输操作DGX Spark作为一个专门的AI计算平台,在大模型开发的各个阶段都能发挥重要作用。从数据预处理到模型训练,从微调到推理部署,其统一内存架构和强大的计算能力为AI开发者提供了前所未有的本地开发体验。需要注意的是,虽然DGX Spark性能强大,但合理的算法设计和系统优化仍然是获得最佳性能的关键。

time_days的博客 2872

通过实践聊聊NVIDIA DGX Spark真的适合部署企业级大模型吗?

NVIDIA推出基于Grace Blackwell超级芯片的GB10主机,搭载20核ARM CPU(10大核+10小核)和6144 CUDA核的Blackwell GPU,FP4算力达11PetaFLOPS。本文详细记录了在NVIDIA DGX Spark上部署Qwen3-30B-A3B-FP4模型的过程:使用TensorRT LLM推理框架(比vLLM快10%),通过Docker启动服务。测试显示在512输入输出时支持120并发,2048输入输出时支持50并发,性能优于oss-gpt-120b模型。文章最

weixin_42058778的博客 3530

DGX Spark vs 传统GPU:大模型微调的性能与成本大比拼

本文深入对比了DGX Spark与传统GPU在大模型微调中的性能与成本差异。DGX Spark凭借128GB统一内存架构和QLoRA技术,在70B参数模型微调中展现出显著优势,仅需30分钟即可完成,而传统GPU集群则耗时更长或无法完成。文章还分析了不同规模模型的性能表现和长期成本效益,为技术决策者提供了全面的参考依据。

l3m4n的博客 1405

deepseek 本地化部署和小模型微调

因为本人gpu卡的机器系统是centos 7, 直接使用ollama会报所以ollama使用镜像方式进行部署, 拉取镜像ollama/ollama启动命令查看ollama 是否启动成功,Ollama 没有用户界面,在后台运行。打开浏览器,输入 “http://xx:11434/”,显示 “Ollama is running”。deepseek-r1 目前有7b, 32b, 70b, 671b 多个版本

陈锐的技术笔记 2万+

QLoRA量化技术实战:70B大模型微调效率提升300%

本文深入解析QLoRA量化技术如何实现70B大模型在消费级硬件上的高效微调,显存占用降低74%,训练效率提升300%。通过NF4量化、双重量化和分页优化器等关键技术组合,结合DGX Spark平台实战案例,展示了大模型微调的革命性突破。

weixin_29098391的博客 507

免费微调自己的大模型(llama-factory微调llama3.1-8b)

本文主要介绍通过llama-factory框架,使用Lora微调方法,微调meta开源的llama3.1-8b模型,平台使用的是趋动云GPU算力资源。

ATpiu的博客 1406

大模型微调实战 70B模型——30分钟完成微调

今天,我们将为大家带来DGX Spark在模型微调场景下的深度测试报告,看看这款被誉为"AI超级计算机"的设备在实际应用中的表现如何。

DEVELOPERAA的博客 965

从零构建高精度温控系统:ADN8835的单电感拓扑与0.01℃稳定性实战解析

本文深入解析了如何利用ADN8835构建高精度温控系统,重点介绍了其创新的单电感拓扑架构如何实现0.01℃的长期稳定性。内容涵盖精密PCB布局、电源滤波设计,并详细阐述了针对不同热容负载的数字PID控制参数整定策略,为开发精密仪器和医疗设备提供了实战指南。

r2s3t4的博客 240

零基础入门大模型微调,20分钟实战LoRA技术!

文章详细介绍了大模型微调技术,包括全参数微调、参数高效微调(如LoRA)和强化学习微调等方法。通过SecGPT-1.5B模型为例,展示了从环境准备、数据集定制到LoRA微调训练的完整流程,并对比了微调前后的效果差异。文章还讨论了微调过程中的问题及模型评估方法,为零基础学习者提供了实用入门指南。

m0_74942241的博客 996

契约锁代码审计分析

但是正常来讲,定义了这么多的路由,肯定会有一个通用的判断逻辑,来判断请求的url是否和这些路由匹配。POC中有一点值得注意,Spring新一些的版本中支持以表单的形式来为参数赋值,且无需用注解。但是需要注意4.2.8的代码逻辑和新版本中的不同,此漏洞可能存在于版本大于4.2.8的版本中。方法用于解析LICENSE,先进行AES解密,再从字符串转换成json格式的License。loadPath实际判断传入的path是否和下面的path相等,如果不相等返回null。,如果包含这三个中的一个就会抛出异常。

好记性不如烂笔头 5752

CXL协议-第三章 CXL事务层

CXL.io为I/O设备提供了一个非一致的负载/存储接口。图3-1显示了Flex总线分层层次结构中的位置。事务类型、事务分组格式、基于信用的流量控制、虚拟通道管理和事务排序规则遵循PCIe*定义,详情请参考PCIe基础规范的“事务层规范”章节。本章重点介绍了用于CXL.io的著名的PCIe操作模式或特性。

qq_41305217的博客 2771

【AI黑科技】原来微调大模型这么简单!手把手教学,零基础也能30分钟搞定!小白程序员的AI进阶之路!

本文详细介绍了在ModelScope平台上使用LLaMA-Factory微调Qwen2.5-VL-7B-Instruct大模型的完整流程。从注册登录、GPU环境配置、依赖安装到模型下载、参数设置和训练测试,提供了保姆级操作指南,使编程初学者无需深厚基础即可掌握大模型微调技术,体验AI模型定制能力。

m0_59163425的博客 743

Android音频学习(十四)——加载音频设备

loadHwModule 是 Android 音频系统的核心初始化函数,负责加载音频硬件抽象层(HAL)的模块实现。它建立 AudioPolicyService 与底层硬件的桥梁,将配置文件(audio_policy_config.xml)中的标签<module>定义转化为可操作的硬件对象,加载的是音频硬件模块(HAL实现),每个模块对应一种音频设备类型,以动态库的形式存在,负责与底层音频硬件交互。

miemie2014的博客 1732

【大模型微调实战】3. QLoRA法律模型压缩实战:24GB显存跑70B大模型,合同审核精度提升40%

摘要:本文聚焦QLoRA(Quantized LoRA)技术在法律大模型压缩中的实战应用,通过4-bit量化与LoRA低秩适配的双重优化,实现70B参数法律模型在24GB显存的RTX 3090/4090显卡上的稳定运行。文中详解QLoRA的三大技术内核:正态浮点4-bit(NF4)量化、双重量化与分页优化器,显存占用较FP16降低85%。以法律合同审核场景为例,提供五步完整实操流程:领域数据集构建、4-bit模型加载、LoRA适配器注入、高效训练配置及风险检测部署,附详细代码与执行结果.

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 2179

Oracle 11g安装教程(保姆级超详细安装教程)

Oracle详细安装步骤,每一步都配有图例引导 ORACLE是数据库(Oracle服务端)。是连接数据库的客户端(Oracle客户端)。是连接oracle的可视化客户端软件。

2302_81846649的博客 1万+

在RStudio中使用GitHub Copilot:代码自动生成,从此告别手敲!

可以通过自定义提示词来引导Copilot生成符合自己需求的代码。再看一个做统计分析的。

Codewar的博客 334

5分钟完成情侣约会DeepSeek模型微调,从此告别情场小白

现存在的大模型已经很完善了,但在特殊场景下,他们的完成效果并不理想,也存在很多禁忌。主要体现在以下方面:1、由于不可抗原因,对输出内容限制,对敏感内容禁止输出。2、达不到理想的回复效果,忠实性不太理想,会天马行空。3、想对产品做推广回复,在回复中要忠于产品,推广产品。4、响应时长及稳定性问题Lora 微调大模型的微调需要较多资源,lora用于解决训练资源匮乏时的模型微调。主要思路是,在原模型中增加低秩矩阵,对低秩矩阵进行训练,以达到对模型微调的目的。

python12345678_的博客 3262

软件设计师高频考点—套路题

学习交流的总结

秩沅 2541

7G显存+半小时出结果!保姆级DeepSeek R1大模型微调实战:用Unsloth搞定医疗领域SFT,从0到1定制专业大模型

文章摘要: 本文基于DeepSeek R1 Distill 7B大模型,通过Unsloth框架实现高效微调,仅需7G显存和半小时即可完成医疗领域适配。作者详细拆解了微调的核心概念(如LoRA技术、知识灌注与推理能力优化),并提供了从环境搭建到微调落地的全流程指南。通过医疗数据集(medical-o1-reasoning-SFT)的SFT训练,模型在医学问答中展现出更精准的专业知识和逻辑推理能力。实验证明,该方法显著降低算力门槛,适合AI新手快速实现垂直领域大模型定制化。

weixin_52610848的博客 1888

Cesium初级开发教程之三十:Primitive集合

教程示例网站:https://thomaz529.github.io。

485

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

DeepSeek本地化部署实战:用4090显卡跑通70B模型全流程,大模型从入门到精通,收藏这篇就够了

今天咱们就整点硬核的!用两张4090显卡(总价不到3万块)给大伙表演个"显卡跑马灯",手把手教你怎么在家搭个能写代码、能搞翻译、还能帮你编周报的AI核武器库。

2301_81888214的博客 3262

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

收藏!10分钟改变大模型自我认知:LoRA微调全流程实战教程,小白也能轻松上手

LoRA(Low-Rank Adaptation)是一种参数高效的微调方法。它的核心思想很简单:冻结原模型参数,只训练额外的小参数矩阵来调整模型输出创建数据处理脚本import os"""处理自我认知数据,替换占位符Args:row: 数据行name: 模型名称 [中文名, 英文名]author: 作者名称 [中文名, 英文名]"""continue# 根据语言标签选择中文或英文continue# 替换占位符return row"""处理自我认知数据集"""

EnjoyEDU的博客 1814

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

零基础入门大模型微调,非常详细收藏我这一篇就够了!

本文为零基础用户提供了大模型微调的入门指南,重点介绍了LoRA(低秩适配)微调技术。文章首先解释了全参数微调和参数高效微调(PEFT)的区别,并详细说明了LoRA的原理、优势及适用场景。接着,文章通过SecGPT大模型的实例,逐步展示了如何准备算力资源、配置微调环境、定制数据集、进行训练与推理,并评估微调效果。文章还提供了完整的LoRA微调代码,帮助读者在实战中理解微调技术。最后,文章总结了微调过程中可能遇到的问题及评估模型效果的方法,帮助读者更好地掌握大模型微调技术。

2401_84204207的博客 1527

零基础入门大模型微调:LoRA微调全流程实战指南!

本文详细介绍大模型微调技术,重点讲解LoRA参数高效微调方法。从环境准备、数据集定制到训练与评估,提供完整实操流程,展示微调前后效果对比。解答微调常见问题,包括LoRA原理理解、参数配置技巧及模型效果评估方法,帮助读者用低成本算力实现大模型定制,提升特定任务表现。

m0_63171455的博客 1323

手把手实操LoRA高效微调,定制垂直行业深度大模型,让你真正能懂会用!

对大模型进行微调,让通用大模型具备“特殊能力”,能够完成特定的任务。 如果大家的电脑配置跑不了大模型的微调任务,可以申请阿里云ACP考试的免费试用。 老规矩,先看最终效果。 选用的原始大模型是“Qwen2.5-1.5B-Instruct” (因为足够小、足够傻)。 微调的目标是:让其具备解答数学题的能力,其他行业模型微调方法类似 。

2401_85327249的博客 1260

【LLaMA-Factory】3分钟上手:小白也能玩转大模型微调!(附代码)大模型入门到精通,收藏这篇就足够了!

你是否也曾被大模型微调的高门槛劝退?显卡贵、代码复杂、配置繁琐…今天给大家带来一个 「零代码」 解决方案——LLaMA-Factory,让你轻松玩转100+大模型微调!

pythonhy的博客 1052
上一篇: LLM-Universe —小白也能上手的AI大模型开发学习教程:帮你快速入门大模型
下一篇: AI智能体构建总结:17种架构详细实现!
AI_小站
博客等级 码龄3年 6255粉丝 1154原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值