2小时打造专业医疗助手:基于CareGPT与Qwen3-8B的微调实战

医疗大语言模型微调实战:基于CareGPT构建专业AI助手 大语言模型(LLM)的微调技术是当前人工智能领域的热点,它通过参数高效微调方法,如LoRA和QLoRA,使通用模型快速适配垂直领域。其核心原理是在冻结预训练模型大部分参数的基础上,引入少量可训练的低秩矩阵,从而高效注入领域知识,显著降低计算资源需求。这一技术价值在于,它让中小团队甚至个人开发者能在消费级硬件上定制专业模型,极大推动了AI的普惠化。在医疗、法律、金融等强知识驱动场景中,微调技术能有效提升模型的专业术语理解、逻辑推理和内容生成准确性。以医疗领域为例,通过高质量医患对话数据对开源基座模型进行监督微 阅读详情

凌晨一点,突发剧烈头痛,视力也开始模糊。在这种紧急情况下,使用通用AI助手寻求建议,往往只能得到“请及时就医”这样正确但无用的回答。用户真正需要的,是具备初步症状识别、风险评估和就医指引能力的专业助手。

这正是当前通用大模型在医疗场景中的典型短板:

  • 缺乏专业医学知识体系,无法进行症状关联分析
  • 回答过于保守,难以提供具针对性的分级建议
  • 无法识别症状组合背后的潜在疾病类型差异

现在,通过LLaMA-Factory Online平台,我们只需要2小时,就能基于CareGPT和Qwen3-8B模型,系统性地构建一个真正“懂症状、能判断”的智能医疗助手。实际效果对比如下:

用户提问:“我突然剧烈头痛,视力模糊,可能是什么原因?

通用模型回答虽然结构完整,但存在明显不足:建议过于保守,仅笼统地建议“观察症状”和“及时就医”,缺乏具体的风险评估和紧急情况指引,对急性症状的响应不够充分。

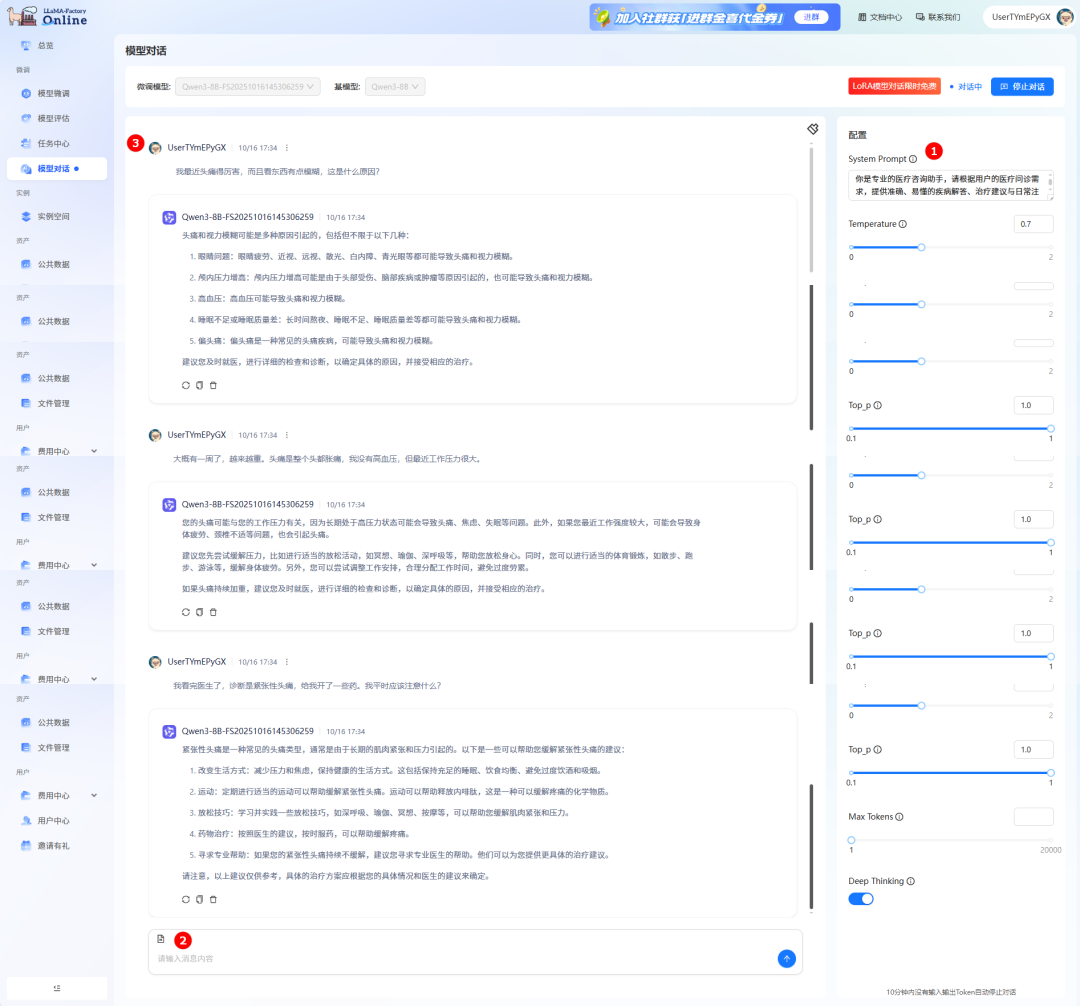
微调后的医疗助手回答展现出明显的改进,回答涵盖了更全面的病因分析,从眼部问题到颅内状况,从血压因素到偏头痛,提供了更具参考价值的医学信息。虽然仍有优化空间,但已经展现出从“通用回复”到“专业解答”的明显进步。
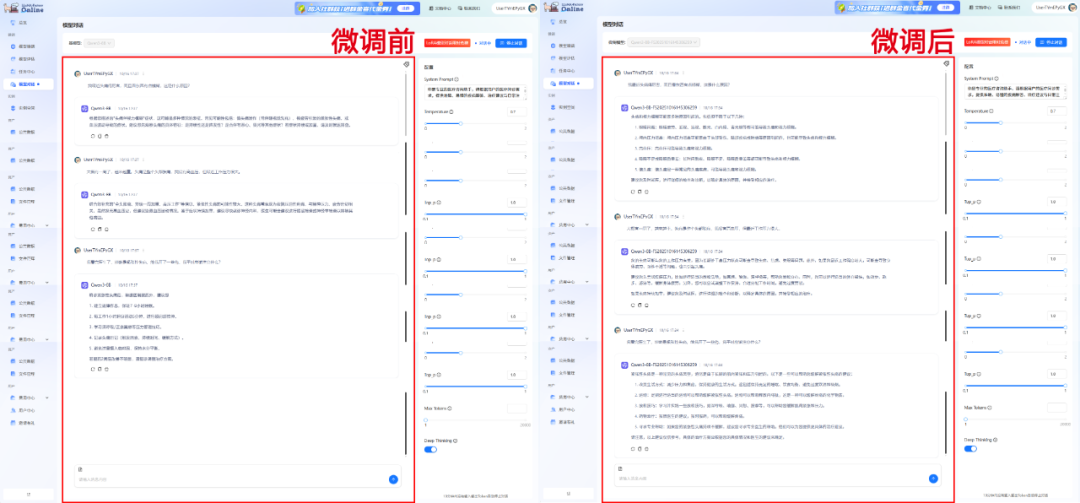
这种具备症状初步分析、风险评估和明确就医指引的专业回应,正是通过CareGPT医疗语料与Qwen3-8B的高效微调实现的。在接下来的内容中,我将完整演示如何通过LLaMA Factory Online平台,在2小时内完成从数据准备、模型微调到效果验证的全流程。

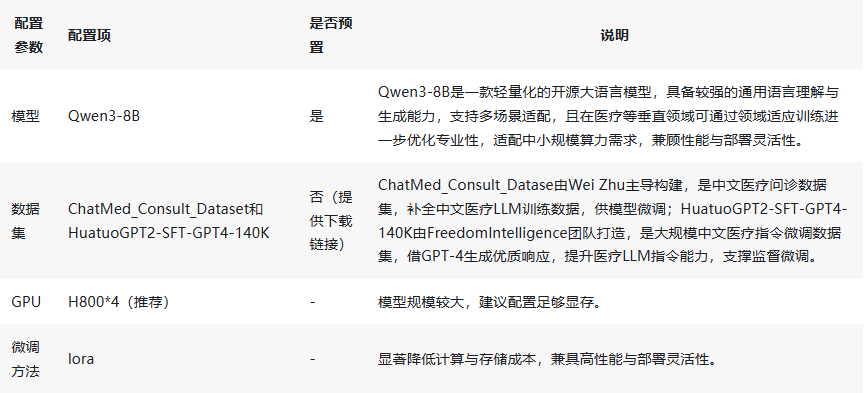
配置概览说明
资源消耗预计

使用推荐资源(H800*4)进行微调时微调过程总时长约2h16min。

具体操作步骤

步骤一:数据准备

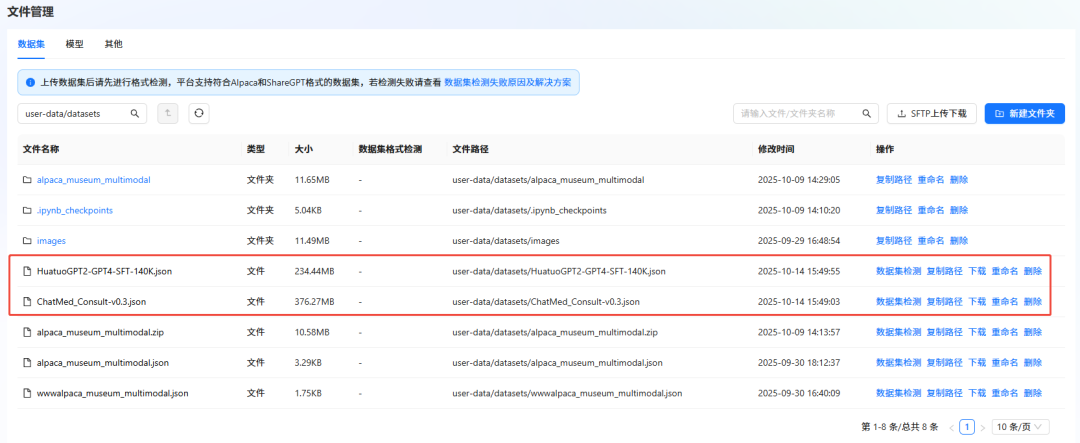
  1. 下载数据集。数据集下载完成后,需上传至文件管理。具体操作,可参考SFTP上传下载完成数据集上传。
  • 登录官网,下载ChatMed_Consult_Dataset数据集。
  • 登录官网,下载HuatuoGPT2-SFT-GPT4-140K数据集。

  1. 数据格式转换。

LLaMA Factory作为主流的大语言模型微调框架,对医疗问诊类数据有明确的格式要求(需包含instruction、input、output核心字段,支持多轮对话的history字段可选)。针对ChatMed_Consult_Dataset数据集原有的 “query-response” 二元结构,需通过字段映射与格式重构,将其转换为LLaMA Factory兼容的数据格式。数据格式转换的具体步骤如下:

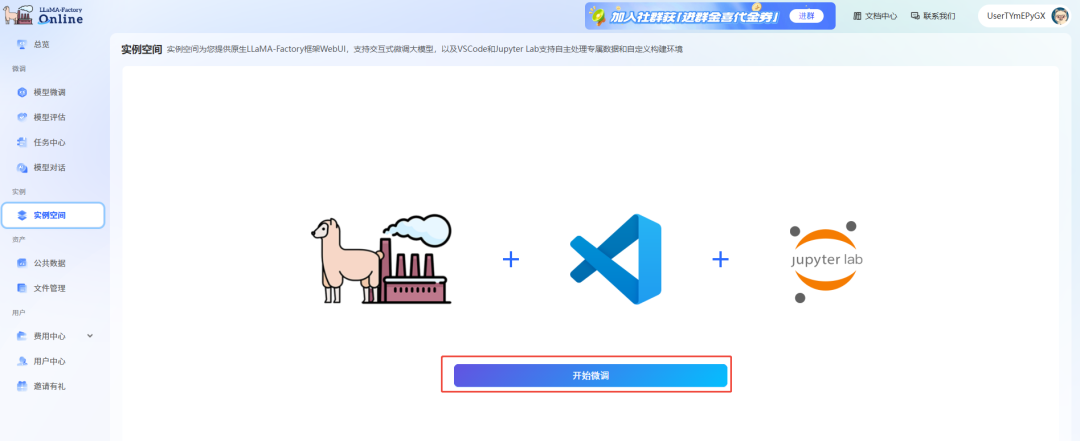
a. 进入LLaMA-Factory Online平台,单击“控制台”,进入控制台后单击左侧导航栏的“实例空间”,然后在页面单击“开始微调”。
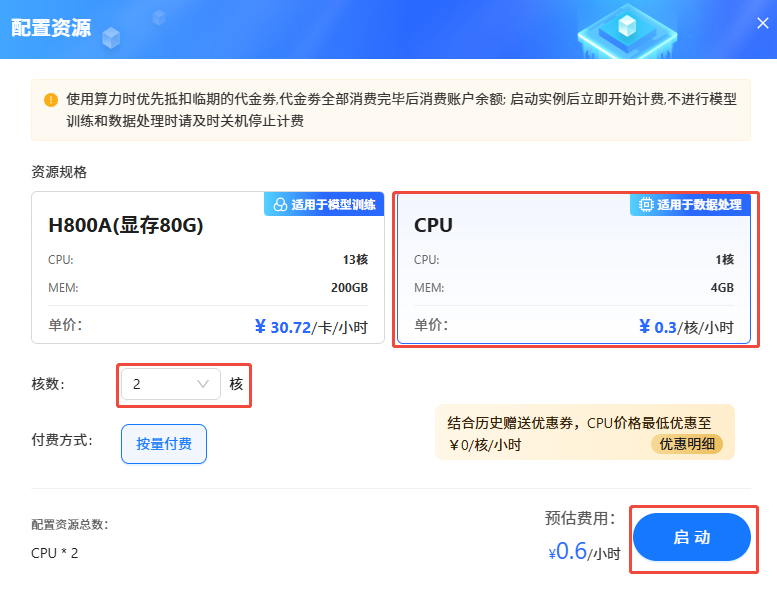
b. 在弹出的页面选择“CPU”,核数选择“2核”,然后单击“启动”。
c. 实例启动后,单击[VSCode处理专属数据]页签,进入VSCode编辑页面。您也可以根据需要打开JupyterLab处理数据,本示例指导您通过VSCode处理数据。

d. 在VSCode页面左侧user-data/datasets目录下(如图①)新建一个.py后缀的文件(如图②),然后复制以下命令至文件中(如图③)。

import json
import pandas as pd
import jsonlines
from typing import List, Dict
def chatmed_to_llamafactory(
input_path: str,
output_path: str,
instruction: str = "
你是专业的医疗咨询助手,请根据用户的医疗问诊需求,提供准确、易懂的疾病解答、治疗建议与日常注意事项,回答需符合医学常识,同时提示用户最终需咨询专业医生确认诊断。"
) -> None:
raw_data: List[Dict] = []
with jsonlines.open(input_path, "r") as f:
for line in f:
raw_data.append(line)
llamafactory_data: List[Dict] = []
for idx, item in enumerate(raw_data):
try:
if "query" not in item or "response" not in item:
print(f"
跳过第{idx+1}条数据:缺失query或response字段")
continue
converted_item = {
"instruction": instruction,
"input": item["query"].strip(),
"output": item["response"].strip(),
"history": []
}
llamafactory_data.append(converted_item)
except Exception as e:
print(f"
处理第{idx+1}条数据时出错:{str(e)},已跳过")
continue
with open(output_path, "w", encoding="utf-8") as f:
json.dump(llamafactory_data, f, ensure_ascii=False, indent=2)
print(f"
转换完成!原始数据共{len(raw_data)}条,有效转换{len(llamafactory_data)}条,输出路径:{output_path}")
if __name__ == "__main__":
INPUT_FILE = "./ChatMed_Consult-v0.3.json"
OUTPUT_FILE = "./datasets/multi-med.json"
chatmed_to_llamafactory(
input_path=INPUT_FILE,
output_path=OUTPUT_FILE,
)
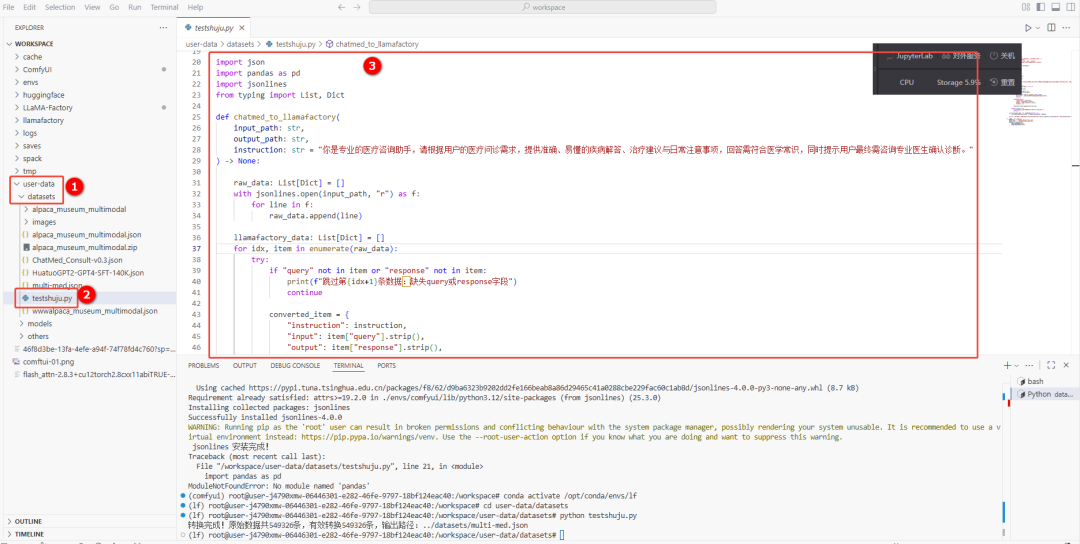
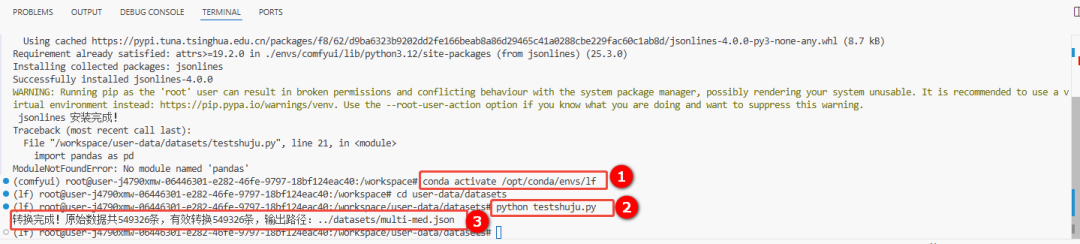
e. VSCode页面,新建一个终端,依次执行以下命令,进行数据格式转换(如图①和②)。

conda activate /opt/conda/envs/lf
python testshuju.py

💡提示

testshuju.py为本示例新建的文件,请根据您的实际情况进行替换。

回显信息如图③所示,说明数据格式转换成功,且转换后的数据存放在/datasets/multi-med.json中,即原数据集文件ChatMed_Consult_Dataset经格式转换后生成新的数据集文件multi-med。
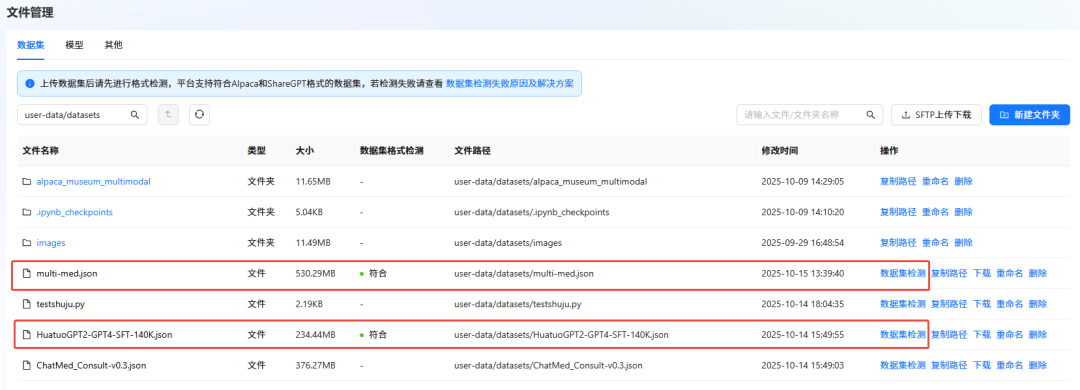
  1. 数据集检测。

a. 返回LLaMA-Factory Online控制台,单击左侧导航栏的“文件管理”。

b. 单击目标数据集右侧“操作”列的"数据集检测",检测数据集。如下图所示,若“数据集格式检测”结果显示“符合”,则表示数据集符合格式要求。
步骤二:模型微调

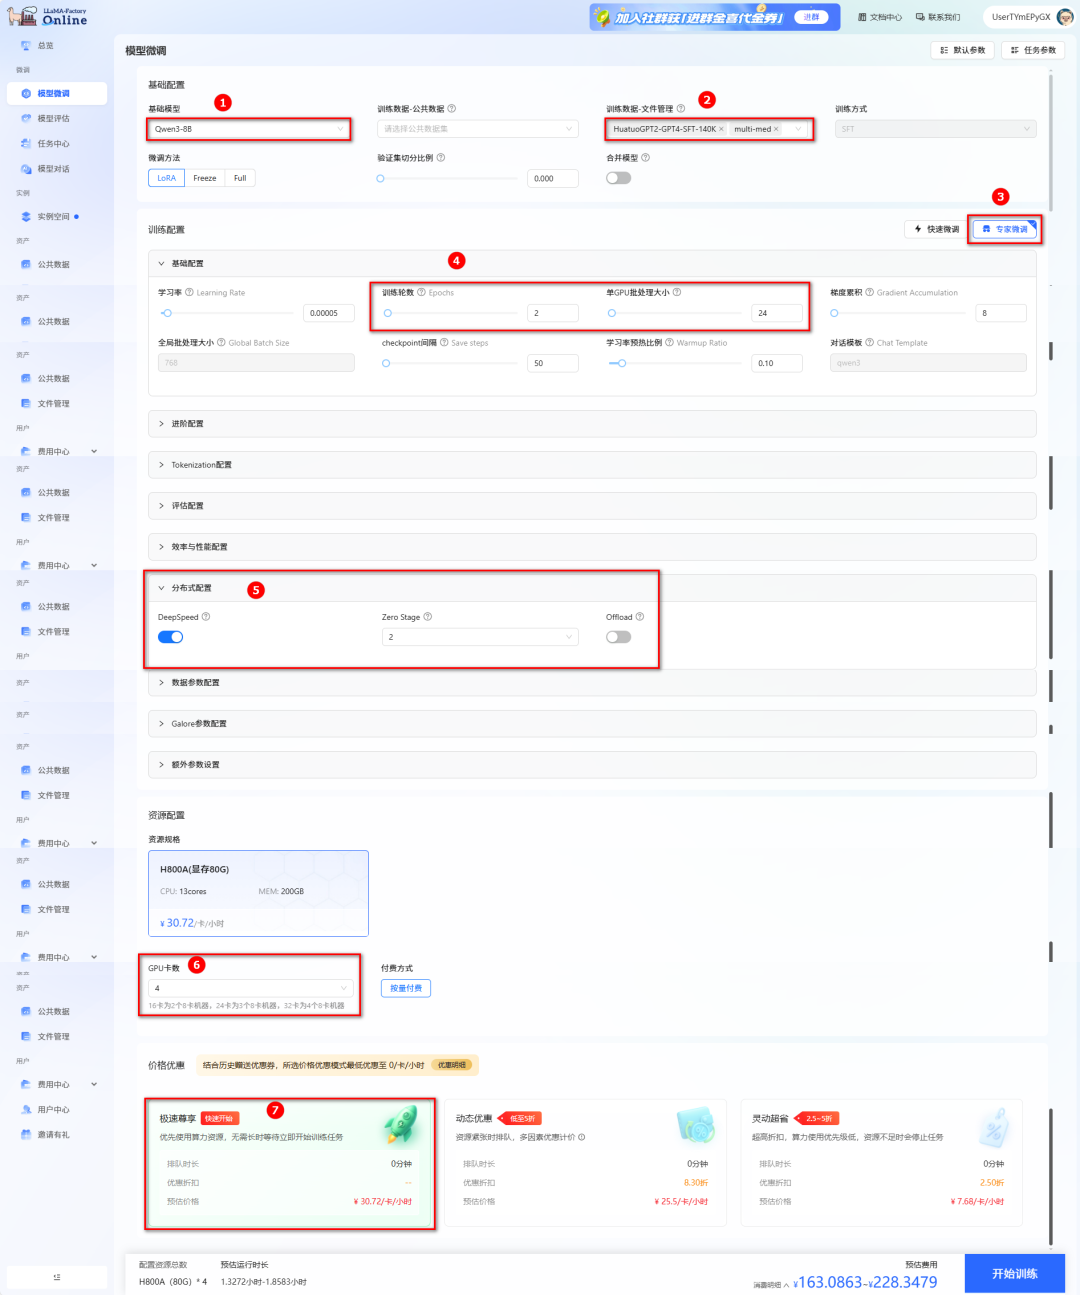
  1. 进入LLaMA-Factory Online平台,单击“控制台”,进入控制台后单击左侧导航栏的“模型微调”进入页面。

  2. 选择模型和数据集,进行参数配置。

  • 本实践使用平台内置的Qwen3-8B作为基础模型(如图①),数据集为ChatMed_Consult_Dataset(multi-med)和HuatuoGPT2-SFT-GPT4-140K(如图②)。

  • 训练配置:选择“专家微调”(如图③);“训练轮数”配置为“2”,“单CPU批处理大小”配置为“24”(如图④)。

  • 分布式配置:打开“DeepSpeed”开关(如图⑤)。

  • 资源配置:推荐卡数为4卡(如图⑥)。

  • 选择价格模式:本实践选择“极速尊享”(如图⑦),不同模式的计费模式参考官网说明。

  • 开始训练:单击“开始训练”,开始模型训练。

💡提示

配置模型与数据集后,系统将根据所需资源及其相关参数,动态预估任务运行时长及微调费用,您可在页面底部查看预估结果。

  1. 通过任务中心查看任务状态。 在左侧边栏选择“任务中心”,在“模型微调”页面即可看到刚刚提交的任务。
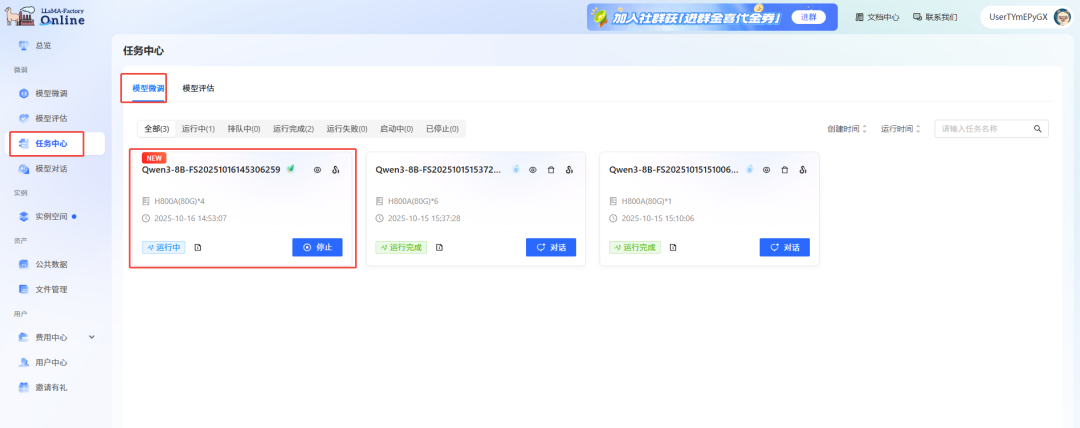
单击任务框,可查看任务的详细信息、超参数、训练追踪和日志。
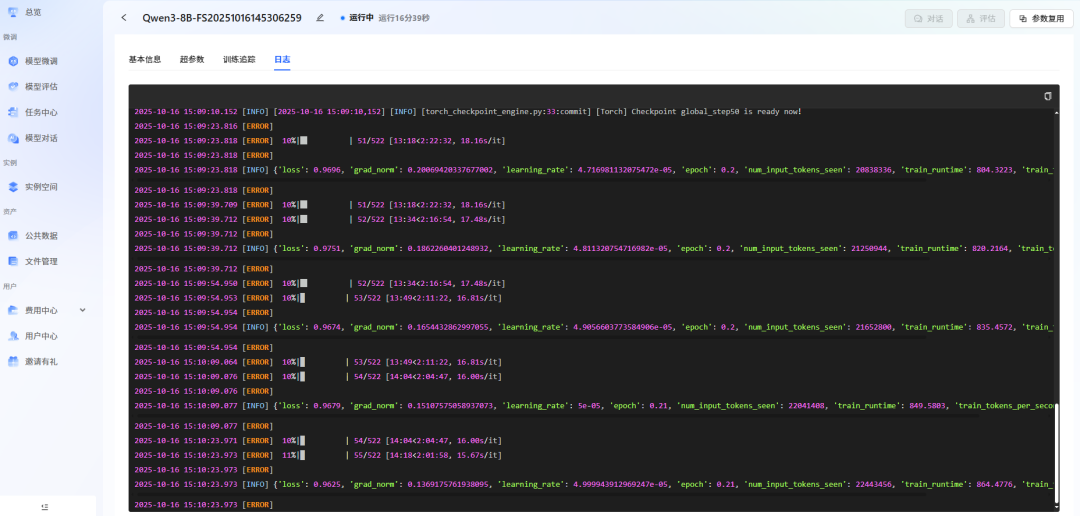
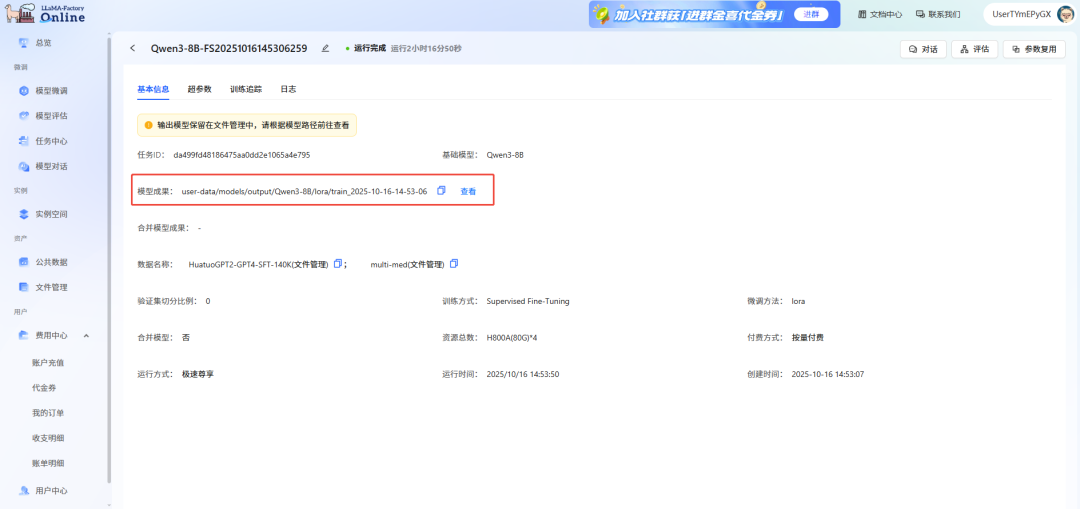
  1. 任务完成后,模型自动保存在"文件管理->模型->output"文件夹中。可在"任务中心->基本信息->模型成果"处查看保存路径。
步骤三:模型评估

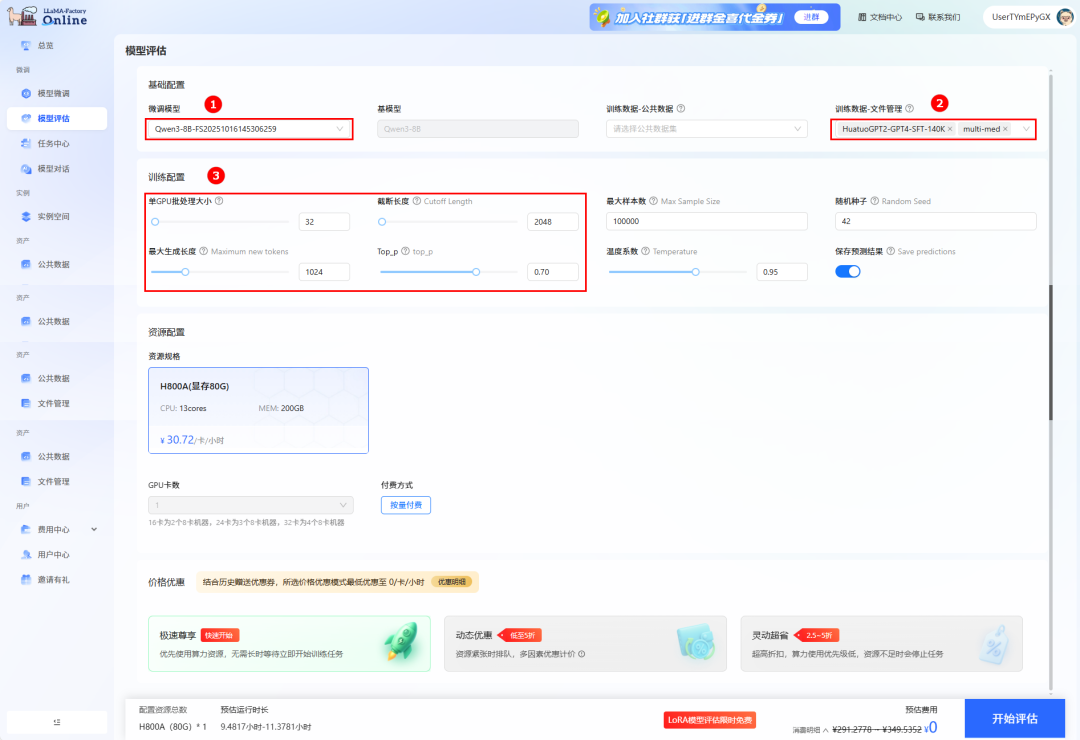
  1. 单击页面左侧导航栏的“模型评估”,进行评估训练配置。

  2. 微调模型选择上一步骤微调后的模型(如图①),评估数据集为ChatMed_Consult_Dataset(multi-med)和HuatuoGPT2-SFT-GPT4-140K(如图②)。然后配置如下参数(如图③):

  • 单GPU批处理大小:设置为32。

  • 截断长度:设置为2048。

  • 最大生成长度:设置为1024。

其他参数设置为默认即可。

💡提示

配置模型与数据集后,系统将根据所需资源及其相关参数,动态预估任务运行时长及微调费用,您可在页面底部查看预估结果。

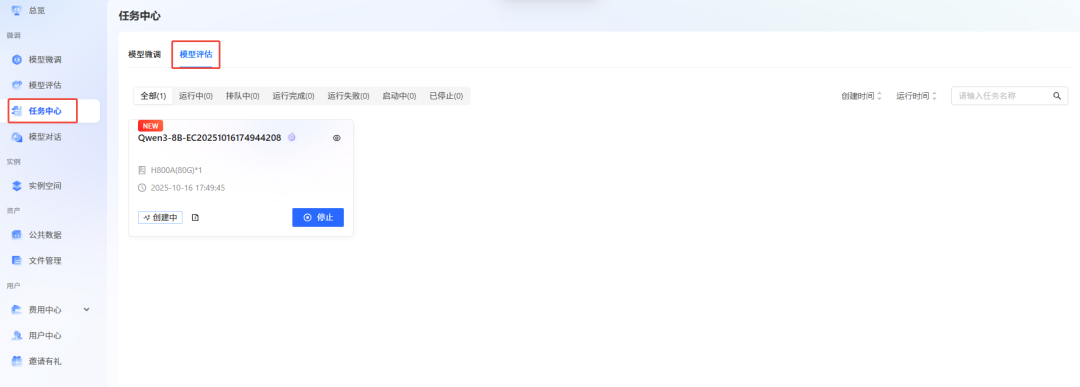
  1. 可以在“任务中心->模型评估”下看到评估任务的运行状态。

4.单击“创建中”右侧图标,进入任务基本信息查看页面。用户可查看评估任务的基本信息、日志以及评估结果。

步骤四:模型对话

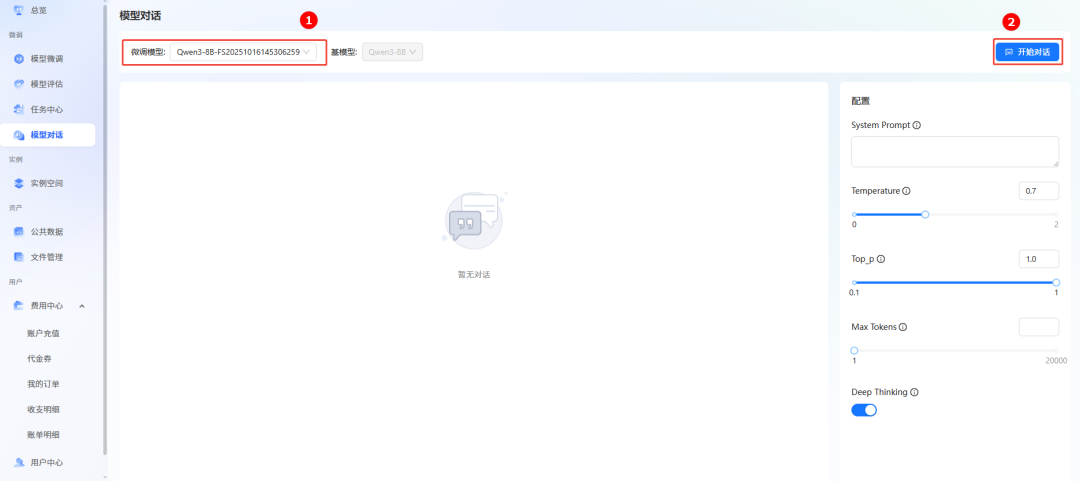
1.单击页面左侧导航栏“模型对话”,进入模型对话页面。

2.在微调模型处选择目标模型名称(如图①),单击右上角“开始对话”(如图②),在弹出的对话框单击“立即对话”。
3.在右侧配置栏的“System Prompt”处输入提示词(如图①),在输入框中输入问题(如图②),单击发送;在对话框中查看对话详情(如图③)。
本次基于Qwen3-8B模型,采用LoRA方法在专业医疗数据集上的微调实践表明,该技术方案在保持模型通用能力的同时,显著提升了医疗问答的专业性和实用性。从技术演进角度看,微调后的模型与医疗系统深度融合将释放更大价值。

这种**“领域微调+系统集成”**的技术路径,为AI在医疗等专业场景的落地提供了经过验证的解决方案。LLaMA-Factory Online平台为领域适配提供了高效的工程化路径,这种轻量化微调方案兼具效率与实用性,值得在更多专业场景中推广验证。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

3天干完6个月的活,Claude把模型搬上AMD 一条挺刺激的消息:Anthropic 给投资人的材料里有一张幻灯片,写着它的 Claude Mythos Preview 只花了大约​,就摸清了怎么让另一个 Claude 模型在 AMD 的 MI355X 上跑起来。同一处还写了个对照数字:过去给一块新芯片做推理适配,通常要几十名工程师、​。3 天对 6 个月,这个比值太扎眼,当天中文互联网上就冒出一堆「英伟达的护城河塌了」的说法。我把能翻到的材料都翻了一遍,越看越觉得,塌掉的那一小块是真的,可塌的位置和很多人想的不一样。 阅读详情

相关推荐

如何处理动态语言(Python / JS)的“隐形”调用链?

本文揭示动态语言(Python/JS)中静态AST解析导致调用链“断链”的核心问题,提出通过运行时追踪补全图谱的解决方案。基于Code-Graph-RAG的cgr trace机制,分别利用pytest插件与V8 Profiler捕获真实调用路径,将动态边合并至静态图谱,并在权重体系中提升动态边优先级。实践表明,该方法可显著提升图谱覆盖率,实现“结构+行为”双视角理解代码,为MCP与Rerank系统提供可靠支持。

xianyinsuifeng的博客 421

DroidDeck Steam 启动优化实战:31 秒到 6 秒,MangoHud 四级面板与三套线程同步后端怎么选

DroidDeck 把 SteamOS 体验跑在 Android 掌机上。本文带你做性能优化:Steam 启动加速、MangoHud 叠加层、esync/fsync 线程同步,开关位置与生效规则一次写清。 ## ⚙️ 所有性能开关都藏在哪?先记住一条总规则 动手之前,先确认开关的位置。DroidDeck 把性能项全部集中在应用内的 **Performance(性能)** 页面(页面实现见 [P

gitblog_00093的博客 431

CareGPT:基于多源医疗数据的智能大语言模型实战项目

近年来,大语言模型(LLM)在通用自然语言处理任务中取得突破性进展,但直接迁移至医疗领域面临显著局限。医学文本具有高度专业化、上下文敏感和术语密集等特点,通用模型常因缺乏领域知识而产生“医学幻觉”。例如,在诊断推理场景中,模型需准确理解“IHD”指代“缺血性心脏病”而非字面缩写。为此,CareGPT基于Transformer架构进行深度定制,引入医学词表扩展机制,将SNOMED CT、UMLS等标准术语系统注入分词器,提升实体识别精度。# 示例:自定义医学Tokenizer扩展。

weixin_42527589的博客 1217

开源中文关系抽取框架,来自浙大知识引擎实验室

向AI转型的程序员都关注了这个号????????????机器学习AI算法工程 公众号:datayxDeepKEDeepKE 是基于 Pytorch 的深度学习中文关系抽取处理套件。环...

datayx的文章 2806

STM32+Air724UG基于阿里云物联网平台的OTA远程升级实战指南

本文提供了一套基于STM32微控制器与Air724UG 4G Cat.1通信模组,通过阿里云物联网平台实现OTA远程升级的完整实战指南。文章详细阐述了BootLoader与用户程序的分工、云端配置、固件下载与烧写流程,并分享了关键代码实现与常见问题排查方法,帮助开发者快速为物联网设备部署稳定可靠的无线升级功能。

weixin_28285943的博客 515

【BlueZ】编译产物详解:可执行文件/库文件/工具的生成路径与用途

BlueZ二次开发编译产物机制解析 摘要:在BlueZ蓝牙协议栈二次开发中,90%的报错源于对编译产物类型和路径的混淆。本文系统剖析BlueZ的三阶段编译机制:1)配置阶段生成Makefile;2)编译阶段在.libs目录下产生临时库和可执行文件(不可直接运行);3)安装阶段将产物部署到系统标准路径。重点解析守护进程、命令行工具、动态库的核心路径差异,并针对五大高频问题(如临时库运行崩溃、动态库不匹配、系统覆盖等)给出解决方案。

byte轻骑兵的技术小窝 1万+

CareGPT:开源驱动的医疗大语言模型

CareGPT,全称"关怀GPT",是一个专注于医疗领域的大语言模型。它不仅仅是一个单一的模型,更是一个综合性的项目,集合了数十个公开可用的医疗微调数据集和开放可用的医疗大语言模型。这个项目涵盖了从模型训练、性能测评到实际部署的全过程,旨在促进医疗大语言模型的快速发展。CareGPT代表了医疗AI的一个重要里程碑。作为一个开源项目,它不仅展示了技术的潜力,更体现了开放协作在推动科技进步中的重要作用。

helloaiworld的博客 1207

汽车行业新能源汽车数据爬虫:抓取新能源汽车数据,分析市场发展和技术创新

在汽车行业,新能源汽车市场的发展和技术创新是当前的热点话题。通过抓取新能源汽车的数据,我们可以深入了解市场趋势、消费者需求以及技术创新的方向。本文将详细介绍如何使用 Python 爬虫技术抓取新能源汽车数据,并对数据进行分析和可视化展示。

u014481728的博客 1144

AI菜鸟向前飞 — LLM简介

AI菜鸟向前飞 — LLM简介

2401_82469710的博客 2577

RK3399平台开发系列讲解(内核入门篇)1.1、通过sysfs清楚了解设备的系统状况

文章目录1、不敢高声语,恐惊天上人:sysfs目的2、窥一斑而知全豹:sysfs目录介绍3、千丝万缕:sysfs中要素的关系4、数据观星:sysfs中相关结构体 1、不敢高声语,恐惊天上人:sysfs目的 我们想通过sys下面的目录和文件清楚的了解跑Liunx系统的嵌入式设备的系统状况。 2、窥一斑而知全豹:sysfs目录介绍 sysfs把连接在系统上的设备和总线组织成为一个分级的文件,它们可以由用户空间存取,向用户空间导出内核的数据结构以及它们的属性。sysfs的一个目的就是展示设备驱动模型中各组件.

内核笔记 1万+

Kong API Gateway 配置与深入

Kong是一个开源的、高性能的API网关,提供了一种简单易用的服务间路由、流量管理和安全防护方案,其最初起源于Nginx Inc.,但后迁移至Apache Software Foundation。Kong支持RESTful、GraphQL、TCP/UDP等协议,可与AWS Lambda、Azure Functions、Google Cloud Functions等云函数平台集成。其主要功能包括:服务发现与负载均衡、请求代理、身份认证与授权、缓存、日志记录、监控指标、灰度发布、多种插件等。

AI天才研究院 2286

本地化部署 DeepSeek,构建单细胞与空间转录组 AI 分析平台

本地化部署 DeepSeek,构建单细胞与空间转录组 AI 分析平台

weixin_53637133的博客 182

CAPL通过SecMgrCANoeClient.dll实现AES 128

需要加载SecMgrCANoeClient.dll这个动态库,可以在canoe安装路径下Exec32这个文件夹里找。这个库不是哪版canoe都带,canoe15就没有,11,14是有的。我需要用到的是AES 128 ECB nopadding,这里函数介绍说是padding mode PKCS5,但是最后算出的结果是我可以使用的。CAPL中可以使用下列函数实现AES 128的算法。需要注意输入输出字节的长度。

天赐好车的博客 4932

【第 009 讲】全面掌握 Python 注释:注释的定义与作用 | 单行注释 | 三引号与多行注释 | 注释使用的最佳实践

本文系统讲解 Python 注释的完整知识体系:从注释的定义与作用讲起,梳理单行注释的书写位置、临时屏蔽用法与 PEP 8 排版规范,剖析注释被忽略的底层机制;进而说明三引号字符串的本质与嵌套问题;最后给出注释使用的三条实践原则,帮助读者写好可读性高的注释。

大模型全栈工程师 · Thanks_ks 1050

如何理解下一代ERP 即:华为MetaERP

如何理解下一代ERP 即:华为MetaERP 华为的 MetaERP核心定位: 华为MetaERP是华为公司自主研发的下一代企业核心商业管理系统。它不仅仅是一个传统的ERP(企业资源规划)系统,更是一个面向未来、基于云原生、AI驱动、安全可信的企业核心管理平台。

金牌架构师 1144

站在评审的角度写国自然基金本子,搭配这5条AI提示词,帮你一键提升本子中标率

多数同仁的选题失败,不是因为你的idea不好,而是你的逻辑没有立起来,你必须让评审看到,你是怎么从问题走向方法的。请你按照“同行做到哪、瓶颈卡在哪、我该怎么破”的逻辑,将我的创新点进行重构:【粘贴你原始的创新点描述】,要求:表达需结构化、可量化、可验证,突出对比后的实质性突破。与其等着评审指出问题,等着本子被拒,不如让AI提前模拟评审,帮你从可行性、创新性、国家价值、团队能力四个维度给你打分,并指出项目的致命破绽,提示词这样设计。创新点如果写不好,本子往往也会被拒,而评审一般喜欢的创新点都是有固定结构的。

智能AI让学术科研更容易 1241

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 436

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Python 的 yield from 到底转发了什么:拆开 send、throw 和那个 return 值

很多人把yield from记成「省一层 for 循环的语法糖」。写和写,结果看着一样,于是就当它只是少敲几个字。这个理解会在三个地方翻车:调用方.send()的值送不进去、子生成器return的值拿不到、异常和close()传不下去。yield from真正做的事是,外层生成器退成一个透明通道。本文所有输出来自本机 CPython 3.13.14 实测。yield from不是循环,是委托——nextsendthrowclose四个方向的流量全部直通子生成器,并且子生成器return。

小小张说故事的博客 152

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 246

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

【每天一个 Python 小案例30】Python 基础知识综合小项目:我的工具盒

作为系列收官,本篇把前 29 篇的知识点合成一个能直接用的命令行工具"我的工具盒":计算器(用 ast 解析表达式,不碰 eval)、单位换算与温度转换(一张换算表 + 特例分支)、记账与分类统计(Decimal + JSON 持久化)、以及用"字典当命令表"把菜单和业务逻辑解耦的主循环。文中对比了 eval 的安全隐患与 ast 白名单的做法,解释了 lambda 闭包在字典里的写法与晚绑定陷阱,并在最后给出整个系列的知识地图,把变量、数据结构、控制流、函数、类、异常、文件、标准库八块内容对应到具体篇目。

xinjiyaya的博客 431

yolo 和 deft 算法的区别

你应该是打错了:是,不是 defrat;

曾大强博客 259

蓝桥杯·全国青少年信息素养大赛·电子学会Python/C++考级 备考:莫队算法离线区间查询详解

备赛进行时:第十八届蓝桥杯软件赛报名已于 2026-10-08 10:00 开启、12-18 14:00 截止,省赛定在 2027-04-10(C/C++·Python 程序设计 9:00–13:00);中国电子学会 2026 年 12 月软件编程(C/C++ 一级至十级、Python 一级至六级)考级报名 9/23–12/2 16:00、统考 12-12;全国青少年信息素养大赛 2026—2027 赛季算法应用主题赛也已进入复盘练兵窗口。

IT_Scratch的博客 181

两张表合并之后,行数悄悄多了一倍

pandas merge 行数异常膨胀源于右表键不唯一,导致数据静默复制。实测显示,未聚合的右表(756行)与左表合并后行数增至504行,合计膨胀3.5倍,但无报错。validate 参数仅在检查键唯一性时有效,one_to_one 和 many_to_one 可拦截问题,但需结合 duplicated() 前置检查。正确做法为先按键聚合右表,再合并,避免重复。建议合并前后核对行数、合计,并使用 indicator=True 排查匹配情况,确保数据一致性。

patrickstar231的博客 249

智慧农业实战:育秧车间秧盘计数与苗情分级的Python实现

首先,建立统一的数据结构,保存每盘秧苗的编号、批次、覆盖度、叶色得分和播种天数。A = "壮苗"B = "合格苗"C = "弱苗"@dataclassdays: int。

荆棘鸟智能的博客 137
上一篇: 什么是LangChain,大模型入门到精通,收藏这篇就足够了!
下一篇: 大模型微调最佳实践指南问答(文末附最佳实践操作)
AI_小站
博客等级 码龄3年 6255粉丝 1154原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值