


检索增强生成(Retrieval-Augmented Generation, RAG)正在改变大型语言模型(LLMs)利用外部知识的方式。问题在于许多开发者误解了 RAG 的实际作用。他们关注存储在向量数据库中的文档,并认为所有的“魔法”始于此、终于此,但这完全是错误的。索引和检索根本不是一回事。
索引在于你如何选择表示的知识。检索在于模型可以看到哪些部分的知识。一旦你了解到了这个差异,整个思路就会很清晰,就会明白自己对模型的推理、速度和基础性有多大的控制权。
什么是 RAG 索引?
RAG 索引是检索的基础。它是将原始知识转化为可经由相似性查询搜索的数值数据的过程。这些数值数据被称为 嵌入(embeddings),嵌入捕获的是含义,而不仅仅是表面的文本。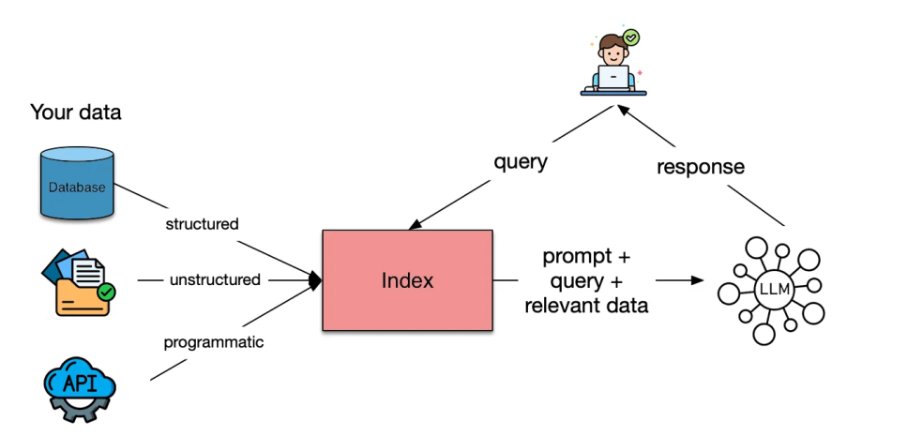
可以将其视为构建一个可搜索的知识库语义地图。每个知识块、摘要或查询变体都成为地图上的一个点。地图组织得越好,当用户提问时,你的检索器就能越好地识别出相关的知识。
如果你的索引出了问题,例如知识块太大、嵌入捕捉到了噪音,或者数据的表示没有反映用户的意图,那么再好的 LLM 也帮不了你多少。检索的质量始终取决于数据索引的有效性,而不是你的机器学习模型有多优秀。
为什么它很重要?
你检索到的内容并不一定是你索引的内容。你的 RAG 系统的力量在于你的索引能否有效地反映含义而非文本。索引明确了你的检索器看待知识的框架。
当你将索引策略与你的数据和用户需求相匹配时,检索会变得更精确,模型将减少幻觉,用户将获得准确的补全。一个设计良好的索引能将 RAG 从一个检索管道转变为一个真正的语义推理引擎。
真正有效的 RAG 索引策略
假设我们有一篇关于 Python 编程的文档:
文档是一种多功能编程语言,广泛应用于数据科学、机器学习和开发。它支持多种编程范式,并拥有、和等丰富的库生态系统。
现在,让我们探讨何时有效地使用每种 RAG 索引策略,以及如何为构建高性能检索系统而实现这些策略。
1. 块索引(Chunk Indexing)
这是大多数 RAG 管道的起点。你将大型文档拆分成更小的、语义连贯的块,并使用某个嵌入模型对每个块进行嵌入。然后,这些嵌入被存储在一个向量数据库中。
示例代码:
# 1. Chunk Indexing def chunk_indexing(document, chunk_size=100): words = document.split() chunks = [] current_chunk = [] current_len = 0 for word in words: current_len += len(word) + 1# +1 for space current_chunk.append(word) if current_len >= chunk_size: chunks.append(" ".join(current_chunk)) current_chunk = [] current_len = 0 if current_chunk: chunks.append(" ".join(current_chunk)) chunk_embeddings = [embed(chunk) for chunk in chunks] return chunks, chunk_embeddings chunks, chunk_embeddings = chunk_indexing(doc_text, chunk_size=50) print("Chunks:\n", chunks)
核心逻辑是将文档按字数或字符数分割成多个块,然后对每个块生成嵌入向量。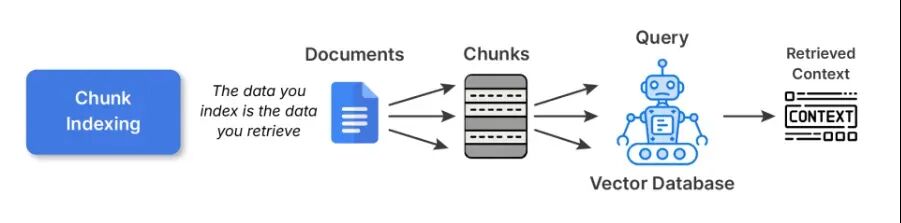
最佳实践:
- 对于短篇文本,始终将块保持在 200-400 个 Token 左右;对于长篇技术内容,可保持在 500-800 个 Token。
- 确保避免在句中或段落中间进行分割,使用逻辑性的、语义上的断点以获得更好的分块效果。
- 最好使用 20-30% 的重叠窗口,以确保在边界处不会丢失上下文。
权衡:块索引是简单且通用的索引方式。然而,更大的块可能会损害检索精度,而更小的块可能会分散上下文,并用不连贯的片段使 LLM 感到不知所措。
2. 子块索引(Sub-chunk Indexing)
子块索引是在块索引基础上进行精炼的一层。在嵌入正常知识块时,你会将知识块进一步划分成更小的子块。在进行检索时,你将子块与查询进行比较,一旦子块匹配你的查询,完整的父块就会作为输入传递给 LLM。
这种方法有效的原因:子块使你能够以一种更精确、更微妙、更准确的方式进行搜索,同时保留了你进行推理所需的大上下文。例如,你可能有一篇长篇研究文章,而该文章中某一部分内容的子块可能就是长段落中某个公式的解释,从而提高了精度和可解释性。
# 2. Sub-chunk Indexingdef sub_chunk_indexing(chunk, sub_chunk_size=25): words = chunk.split() sub_chunks = [] current_sub_chunk = [] current_len = 0 for word in words: current_len += len(word) + 1 current_sub_chunk.append(word) if current_len >= sub_chunk_size: sub_chunks.append(" ".join(current_sub_chunk)) current_sub_chunk = [] current_len = 0 if current_sub_chunk: sub_chunks.append(" ".join(current_sub_chunk)) return sub_chunks# Sub-chunks for first chunk (as example)sub_chunks = sub_chunk_indexing(chunks[0], sub_chunk_size=30)sub_embeddings = [embed(sub_chunk) for sub_chunk in sub_chunks]print("Sub-chunks:\n", sub_chunks)
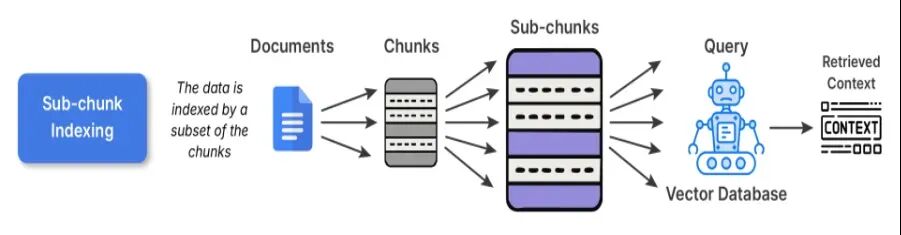
何时使用:对于每个段落中包含多个不同观点的数据集会很有优势;例如,知识库、教科书、研究文章等会是理想的选择。
权衡:由于嵌入有所重叠,预处理和存储成本略高,但它在查询和内容之间的对齐方面有实质性的提升。
3. 查询索引(Query Indexing)
在查询索引的情况下,原始文本不会被直接嵌入。相反,我们会生成针对每个知识块的几个假想问题,然后嵌入这些问题文本。这样做部分是为了弥合用户提问方式与文档描述事物方式之间的语义鸿沟。
例如,如果你的知识块说:“LangChain 拥有用于构建 RAG 管道的实用工具”
模型会生成类似这样的查询:
- 我如何在 LangChain 中构建 RAG 管道?
- LangChain 有哪些用于检索的工具?
# 3. Query Indexing - generate synthetic queries related to the chunkdef generate_queries(chunk): # Simple synthetic queries for demonstration queries = [ "What is Python used for?", "Which libraries does Python support?", "What paradigms does Python support?" ] query_embeddings = [embed(q) for q in queries] return queries, query_embeddingsqueries, query_embeddings = generate_queries(doc_text)print("Synthetic Queries:\n", queries)
然后,当任何真实用户提出类似问题时,检索将直接命中其中一个索引的查询。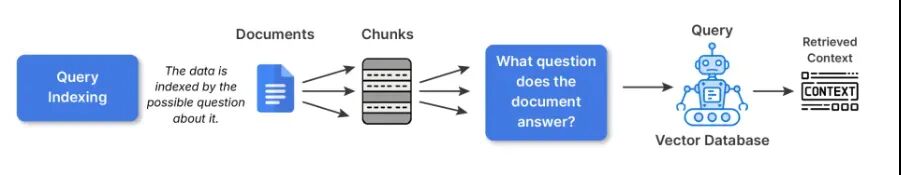
最佳实践:
- 在编写索引查询时,建议使用 LLM 为每个知识块生成 3-5 个查询。
- 你也可以对所有相似的问题进行去重或聚类,以缩小实际索引的规模。
何时使用:
- 问答系统或大多数用户交互都由自然语言问题驱动的聊天机器人。
- 用户很可能会询问“是什么”、“如何做”或“为什么”等类型查询的搜索体验。
权衡:虽然合成扩展增加了预处理时间和空间,但它为面向用户的系统提供了有意义的检索相关性提升。
4. 摘要索引(Summary Indexing)
摘要索引允许你在嵌入之前,将资料片段重构成更小的摘要。你将完整的原始内容保留在另一个位置,然后在摘要版本上执行检索。
这种方法的好处:结构化、密集或重复的源材料(例如电子表格、政策文件、技术手册)通常是直接从原始文本嵌入会捕获噪音的材料。摘要抽象掉了不那么相关的表面细节,对于嵌入而言语义上更有意义。
例如:原始文本说:“2020 年至 2025 年的温度读数范围为 22 至 42 摄氏度,异常归因于厄尔尼诺现象。” 摘要将是:“年度温度趋势(2020-2025),涉及厄尔尼诺相关的异常现象。” 摘要表示形式将焦点集中在概念上。
示例代码
# 4. Summary Indexingdef summarize(text): # Simple summary for demonstration (replace with an actual summarizer for real use) if"Python"in text: return"Python: versatile language, used in data science and web development with many libraries." return textsummary = summarize(doc_text)summary_embedding = embed(summary)print("Summary:", summary)
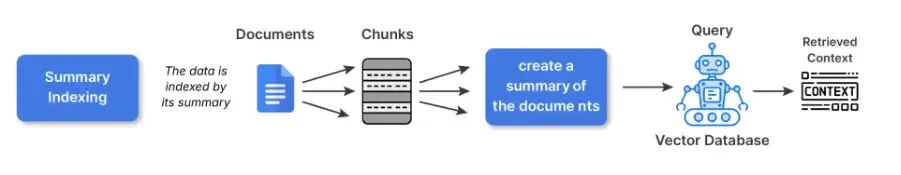
何时使用:
- 处理结构化数据(表格、CSV、日志文件)。
- 技术性或冗长的内容,如果使用原始文本嵌入,嵌入效果会不佳。
权衡:如果摘要过于抽象,可能会有损失细微差别/事实准确性的风险。对于特定领域(尤其是法律、金融等)的关键研究,应链接到原始文本进行参考。
5. 分层索引(Hierarchical Indexing)
分层索引将信息组织成多个不同级别:文档、章节、段落、子段落。你分阶段进行检索,从广泛的介绍开始,逐步缩小到特定的上下文。顶层组件检索相关文档的章节,下一层检索在这些检索到的文档章节内的特定上下文的段落或子段落。
这意味着什么?分层检索可以减少系统中的噪音,并且在你需要控制上下文大小时非常有用。当处理大量文档且无法一次性全部拉取时,这尤其有用。它还可以提高后续分析的可解释性,因为你可以知道是哪个文档的哪个部分促成了最终答案。示例代码
# 5. Hierarchical Indexing # Organize document into levels: document -> chunks -> sub-chunks hierarchical_index = { "document": doc_text, "chunks": chunks, "sub_chunks": {chunk: sub_chunk_indexing(chunk) for chunk in chunks} } print("Hierarchical index example:") print(hierarchical_index)
最佳实践:
- 使用多个嵌入级别或嵌入与关键词搜索的组合。例如,最初仅使用 BM25 检索文档,然后使用嵌入更精确地检索那些相关的块或组件。
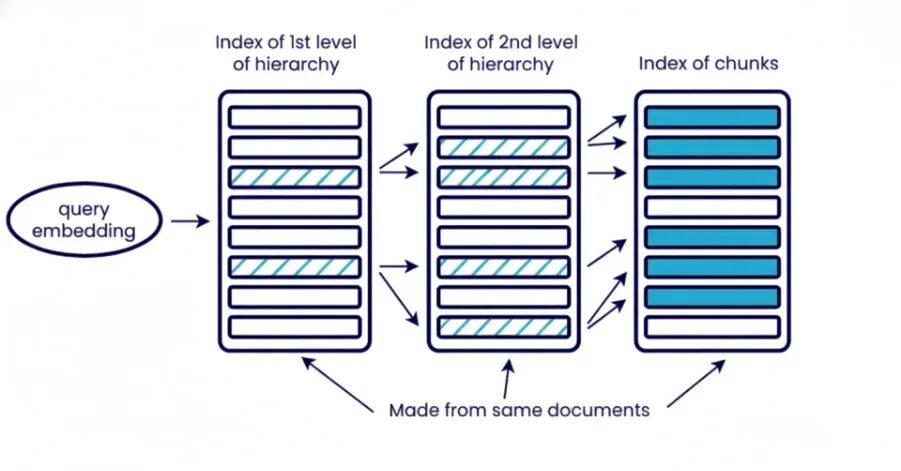
何时使用:
- 拥有数千份文档的企业级 RAG。
- 从书籍、法律档案或技术 PDF 等长篇来源中检索。
权衡:由于需要多个检索级别,复杂性增加。还需要额外的存储和预处理来进行元数据/摘要。由于多步骤检索,查询延迟增加,不适合大型非结构化数据。
6. 混合索引(Hybrid Indexing / Multi-Modal)
知识不仅仅存在于文本中。在混合索引形式中,RAG 通过做两件事来处理多种形式的数据或模态:检索器使用针对每种可能模态专门化或调优的不同编码器生成的嵌入。然后,它从每个相关的嵌入中获取结果,并使用评分策略或**晚期融合(late-fusion)**方法将它们结合起来生成响应。
以下是其用法的示例:
- 使用 CLIP 或 BLIP 处理图像和文本标题。
- 使用 CodeBERT 或 StarCoder 嵌入来处理代码。
示例代码
# 6. Hybrid Indexing (example with text + image)# Example text and dummy image embedding (replace embed_image with actual model)def embed_image(image_data): # Dummy example: image data represented as length of string (replace with CLIP/BLIP encoder) return [len(image_data) / 1000]text_embedding = embed(doc_text)image_embedding = embed_image("image_bytes_or_path_here")print("Text embedding size:", len(text_embedding))print("Image embedding size:", len(image_embedding))
何时使用混合索引:
- 处理包含图像或图表的技术手册或文档。
- 多模态文档或支持文章。
- 产品目录或电子商务。
权衡:检索逻辑和存储模型更为复杂,但在响应中能提供更丰富的上下文理解,并在领域内具有更高的灵活性。
成功的 RAG 系统取决于针对数据类型和待回答问题的适当索引策略。索引指导着检索器找到什么,以及语言模型将以什么为基础进行生成,使其成为超越检索的关键基础。你使用的索引类型可能是块、子块、查询、摘要、分层或混合索引,并且该索引应遵循数据中存在的结构,这将提高相关性并消除噪音。精心设计的索引过程将减少幻觉,并提供一个准确、值得信赖的系统。
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 5306


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


