初识 Embedding,为何大家都基于它搭建私人智能客服?

Embedding模型到底是什么?看完这篇就懂啦! 2024年1月1日,​​正式推出V1.0版本,其核心亮点之一便是对​​的深度支持。作为AI数智化开发平台,JBoltAI通过集成Embedding技术,实现了从文本、图像到结构化数据的语义向量化处理能力,为开发者提供了一套完整的AI应用开发解决方案。这一版本不仅支持多模型配置(如大语言模型、Embedding模型、向量数据库),还创新性地推出AI智能大搜、Text2Sql等工具,迅速获得央国企、事业单位及高校的广泛合作。那么,Embedding模型到底是什么?有什么用?下面就来给大家逐一解答。 阅读详情

随着 AI 技术的发展,大家在日常使用过程中经常会碰到一些目前 GPT4 也无法解决的问题:

  • 无法获取个人私有数据信息,进行智能问答
  • 无法获取最新信息,LLM 模型训练都是都是有截止日期的
  • 无法定制化私有的专属模型,从而在某个领域内取得更好效果

基于以上问题 OpenAI 官方提供了两种不同私有化模型定制方式:Fine-Tuning(微调)、Embedding(嵌入)。

一、Fine-Tuning 与 Embedding 区别

两种方式信息概括如下:

  • Fine-Tuning(微调):在一个已经预训练好的模型的基础上,使用用户提供的数据进行进一步的训练,从而使模型更适合用户的特定应用场景。微调可以提高模型的质量、准确性和可靠性,以及降低请求的延迟和代价。微调需要用户准备和上传训练数据,以及选择合适的模型和参数。
  • Embedding(嵌入):指将文本或其他内容转换为数值向量的形式,从而可以计算内容之间的相似度或相关性。OpenAI 的 Embedding 模型可以将文本解析为 1536 个维度,每个维度代表一个概念或特征。用户可以通过 Embedding 模型来存储、检索或比较文本或其他内容。Embedding 不需要用户提供训练数据,也不需要选择模型和参数。

Fine-Tuning 微调训练的成本较高,且自身需要一定的模型训练经验和一定规模的数据集,否则微调出来的模型效果并不会很理想。所以更推崇使用 Embedding 方式对数据进行处理从而达到预期效果,比如目前市面上智能客服完全可以通过 Embedding 实现落地。

二、Embedding 详细分析

接下来我们就来重点聊聊 Embedding ,它的大致流程是:

  1. 将已有数据集维护成对应的向量数据库
  2. 当用户通过 Prompt 进行提问时,从向量数据库提取相似或相近的信息
  3. 将信息连同 Prompt 一起发送给 GPT 模型来生成结果

这样做有一个好处就是我们只需要将相关的数据发送给 ChatGPT 即可,相对比较节约 Token。

Embedding 将数据转成成连续向量空间的过程,我们并不需要去深入了解。所以我们从 Embedding 如何识别相似或关联性数据讲起。

1. 如何从向量数据库提取相关数据?

从上面的概述我们可以了解到一个重点是:Embedding 模型需要将数据解析为 1536 个维度,每个维度代表一个概念或特征。

将一段文字转换成这么多个维度的数据,从向量数据库提取的过程中就是根据这些维度进行计算。

人类是如何辨别一个人,想象自己平时是如何认出谁是谁呢?我们都是通过外表容貌来认人的(如眼睛大小、鼻子大小、脸型、发型等等),对我们熟悉的人,我们的脑海中会记住他的五官、身材等关键信息。

映射到向量数据也是一样的道理,将数据的 1536 个维度认为是它的“五官”,当我们需要从向量数据库中提取数据时只需要找到“五官”相似的数据即可。
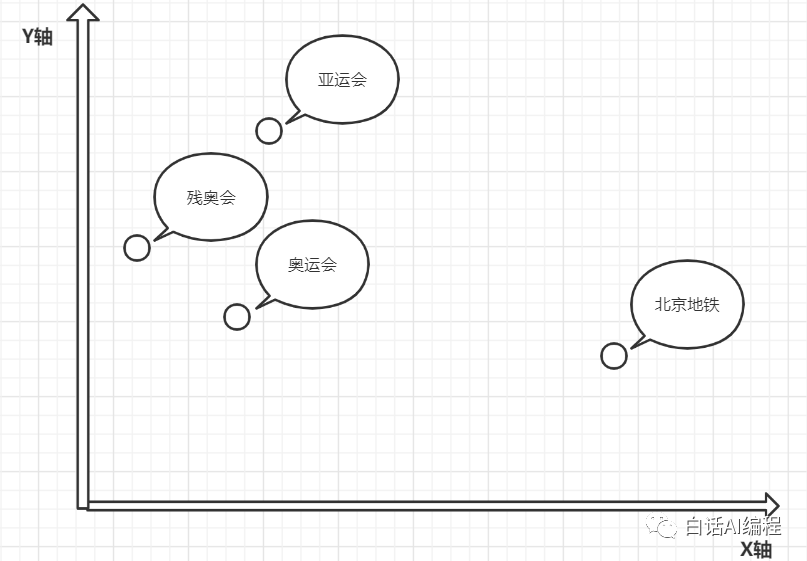
图片

以如上二维坐标进行举例,相似或有关联性的向量数据就会分布在坐标系中比较临近的位置(奥运会、亚运会、残奥会),而内容基本不相干的向量数据(北京地铁)在坐标系中就会离得比较远。

2. 使用 OpenAI 生成向量数据

通过 OpenAI 官网我们也可以看到,价格还是比较便宜的。使用量按每个输入令牌定价,收费为每1000个 tokens 大约0.0004美元。
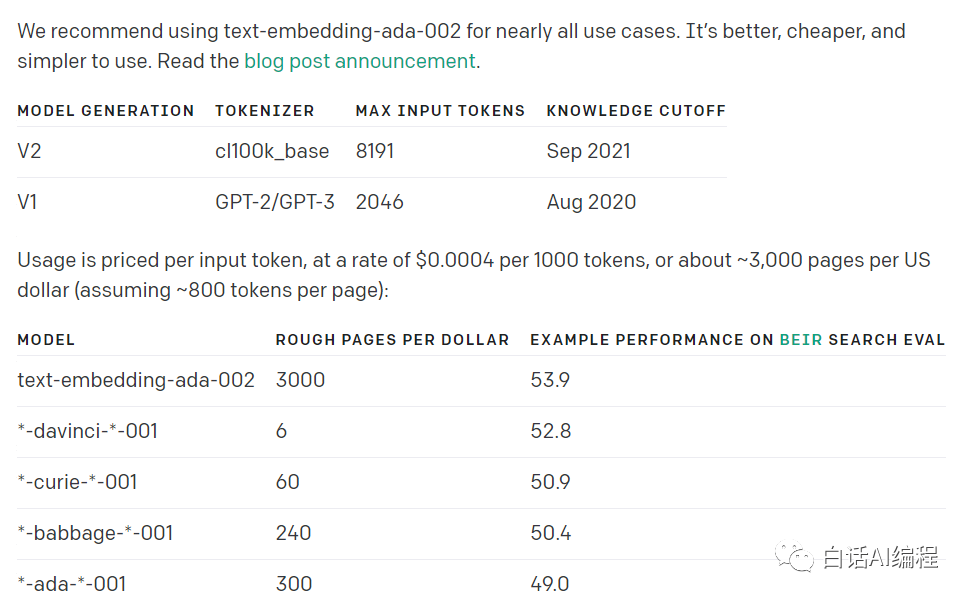
图片

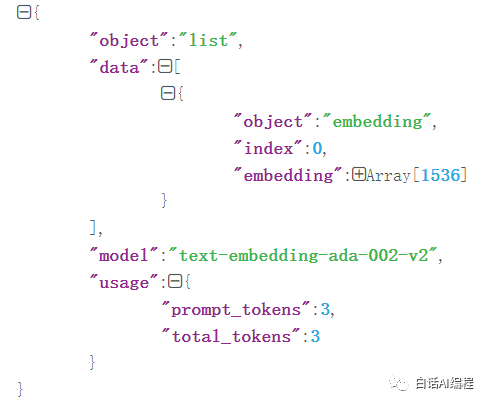
通过 OpenAI 的 Embedding 方法调用,看看返回数据啥样。
在这里插入图片描述

接口返回了该文本对应的 1536 个维度数据,相当于我们已经掌握了这份文本数据的“五官”信息了。
图片

3. 如何提取相似数据?

在上面的方法上使用余弦值来比较相似度,代码如下:

import openai
from sklearn.metrics.pairwise import cosine_similarity

openai.api_key = "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"

if __name__ == '__main__':
    evaluate_one_text = "奥运会"    
    evaluate_two_text = "亚运会"    
    evaluate_three_text = "北京地铁"   
     
    # 对数据进行 embedding    
    embeddings = openai.Embedding.create(    
        model="text-embedding-ada-002",        
        input=[evaluate_one_text, evaluate_two_text, evaluate_three_text],    
    )    
    
    evaluate_one = embeddings["data"][0]["embedding"]    
    evaluate_two = embeddings["data"][1]["embedding"]    
    evaluate_three = embeddings["data"][2]["embedding"]   
    
    print("奥运会&亚运会的余弦距离:" + format(cosine_similarity([evaluate_one], [evaluate_two])[0][0]))    
    print("奥运会&北京地铁的余弦距离:" + format(cosine_similarity([evaluate_one], [evaluate_three])[0][0]))    
    print("北京地铁&亚运会的余弦距离:" + format(cosine_similarity([evaluate_three], [evaluate_two])[0][0]))

结果如下:

奥运会&亚运会的余弦距离:0.9022809359592784
奥运会&北京地铁的余弦距离:0.7898007980212471
北京地铁&亚运会的余弦距离:0.7767229785942393

计算两个数据的相似度,我们可以使用余弦相似度(cosine similarity)的方法,即计算两个向量之间的夹角的余弦值。余弦相似度的范围是[-1, 1],其中 1 表示完全相同,0表示正向相关性,-1表示完全相反。

通过这样一个简单的案例,我们就可以知道 OpenAI 是如何从向量数据库中提取到相似或相关联的数据。

结尾

本文主要讲解了 Embedding 的一些基本概念,后续会更新如何基于 Embedding 转换私人数据搭建私人客服。
​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

从零搭建私人AI助手:本地模型、RAG与语音交互实践 大语言模型正加速进入日常生活,但通用聊天助手难以满足家庭场景对隐私、记忆和交互门槛的要求。通过本地部署开源模型,配合检索增强生成(RAG)技术,可以构建一个真正理解家庭背景、数据不出内网的私人AI助手。这套方案涉及Ollama模型部署、API中间层设计、家庭知识库接入、语音交互入口以及安全边界控制,适合希望为家人提供自然、安全、可定制AI服务的开发者参考。从最小可运行版本起步,逐步扩展工具能力,即可复现一套稳定、可控的本地智能服务系统。 阅读详情

相关推荐

Qwen3+RAGFlow私人AI知识库搭建:20分钟完成本地部署

检索增强生成(RAG)技术通过将大语言模型与外部知识库结合,有效解决了模型幻觉问题。其核心原理是将文档进行向量化处理,通过语义检索为LLM提供准确上下文。这种架构在构建企业知识库、技术文档问答等场景中具有重要价值,能够确保回答基于实际文档资料。基于深度文档理解的RAGFlow引擎支持PDF、Word等多种格式解析,结合阿里云通义千问Qwen3模型的强大生成能力,为私人AI知识库搭建提供了完整解决方案。本文针对Docker环境配置和模型部署中的常见问题,提供了详细的实操指南和代码示例。

weixin_32296621的博客 236

Transformer从0-1模型详解通俗易懂(附代码)

位置编码一方面通过正弦和余弦函数来编码位置信息,能够使得不同位置的编码在空间上有良好的分布。另一方面分别使用正弦和余弦函数来编码偶数和奇数的位置,以确保位置编码可以捕捉到位置之间的关系代表遮掩,码是张量中的数值,尺寸不一定,一般里面只有1和0,代表位置是否被遮掩,0代表遮掩,1可以自定义,因此他的作用就是让另一个张量中的一些树值被遮掩观察事物的时候,之所以可以快速判断一种事物,是因为我们大脑可以很快的把注意力把事物具有辨别度的部分区分开,而不是从头到尾的观察,基于这样的理论,产生了注意力机制;

qq_52491868的博客 1581

ChatGPT基础知识系列之Embeddings模型

这一节主要介绍了ChatGPT的Embeddings模型,主要包括Embeddings 的发展历程和使用方式Embeddings 的使用场景Embedding可以作为其他机器学习模型的输入。

5万+

pytorch中使用embedding层的示例

【代码】pytorch中使用embedding层的示例。

weixin_44055664的博客 514

深度学习-131-RAG技术之基于Anything LLM搭建本地私人知识库的应用策略问题总结(二)

真正实现RAG管道中从足够多的片段中检索到最为相关的TopK个片段:(1)调小Chunk Size;(2)调大TopK检索召回片段数;(3)不要点Pin图钉。

qq_20466211的博客 614

大模型——使用 Embedding 模型和向量数据库的 Spring AI RAG

本文介绍了如何使用 Embedding API 将文本或文档转换为Embedding,以及如何使用向量数据库来存储和检索Embedding信息。最后,还实现了 RAG(检索增强生成),通过检索到的信息来使用 AI 模型回答问题。

3993

深度学习中Embedding的解释

转载于https://zhuanlan.zhihu.com/p/164502624 什么是Embedding?近年来,NLP自然语言处理、推荐系统,以及计算机视觉已成为目前工业界算法岗的主流方向,无论在哪个领域,对“Embedding”这个词概念的理解都是每个庞大知识体系的基石。今天我们就以诙谐生动的方式来理解一下这个看似高大上的名词吧。“Embedding”直译是嵌入式、嵌入层。看到这个翻译的时候是不是一脸懵圈?什么叫嵌入?意思是牢固地或深深地固定?那么它能把什么嵌入到什么呢?很开心地告诉你,它能把万物.

yuanmiyu6522的博客 2万+

QGIS效率提升神器:qgis_mcp插件+VSCode联合工作流配置全解析

本文详细解析了如何通过配置qgis_mcp插件与VSCode的联合工作流,实现语音控制和代码自动化来大幅提升QGIS操作效率。该方案将自然语言交互与现代编辑器生态结合,为地理信息专业人士构建了智能、高效的全新工作模式,彻底改变传统GIS操作方式。

weixin_29228203的博客 192

搭建 Embedding 向量数据库,手把手教你创造自己的私人智能助理

上篇文章讲解了 Embedding 的一些基本信息并使用 OpenAI 的 Embedding API 进行演示。上篇文章的案例是每次都重新构建向量数据,虽然 Embedding 方法调用并不算贵,若是私有数据较大,每次都将私有数据转换成对应的向量数据也是一个大开销,这时候就需要的存在。

python1234567_的博客 1979

windows10系统上安装最新版mysql 8.0详细步骤

windows10系统上安装最新版mysql 8.0详细步骤

glei20的博客 6715

Python爬虫实战:用Selenium+ChromeDriver批量抓取政府网站政策文件(附完整代码)

本文详细介绍了使用Python的Selenium和ChromeDriver进行政府网站政策文件批量抓取的实战技巧。从环境配置、动态页面元素定位到分页机制破解和反爬虫策略,提供了完整的解决方案和代码示例,帮助开发者高效获取结构化政策数据。

weixin_42531710的博客 266

【AI测试学习】AnythingLLM+Ollama+DeepSeek部署私人知识库

DeepSeek+Ollama+AnythingLLM 本地部署完全指南,打造专属知识库。

Yansky的博客 1329

SAP VC实战:用CU01和CS02搞定BOM里的‘智能’对象相关性(附语法避坑指南)

在工业制造领域,产品配置的复杂性往往超出想象。想象一下,当客户需要定制一台工业设备时,可能有数百种配置选项相互影响——从基础材质到动力系统,从控制模块到安全装置。如何在SAP系统中优雅地管理这种复杂性?对象相关性(Object Dependencies)就是解决这一挑战的利器。

weixin_42524824的博客 468

DeepSeek + Dify :零成本搭建企业级本地私有化知识库保姆级喂饭教程

DeepSeek作为可以私有化本地部署的大模型,加上Dify这个组合,我们还可以有很多其他应用场景,比如:智能客服,智能题库。也可以把自己的个人资料,过往输出文章,日记等所有个人信息上传到本地知识库,打造自己的私人助理。Dify还有很多其他功能,有了deepseek这样的优秀国产AI大模型加持,我们可以做更多智能体应用。当然,Dify也可以像coze一样,发布为对外服务的api,这样,它就可以结合cursor快速做出更多的AI应用。何以破局,唯有行动!

atbigapp的博客 1448

LDO稳定性分析

根据补偿方式和拓扑结构的不同,三个极点之间的相互位置有可能发生变化,但 是 LDO 通常采用较大的输出电容 Cout,以及较大的调整管也会导致较大的 Cpar, 所以 p1、p2 通常位于较低的频率处,而 p3 和 z1 则由于 Resr较小会位于较高的频 率处。不过幸运的是,对于较大的 Cout来说,只要选择合适的 Resr,就可以将左半平面零点 Z1 的频率降低,甚至使 Z1 进入单位增益带宽内,左半平面零点的进入将对相位有所改善,这不仅可以消除振荡的风险,还可以在单位增益频率处得到较好的相位裕度。

模拟芯片设计 1594

Unity FPS射击控制系统:数据驱动的武器行为解耦方案

在Unity第一人称射击(FPS)开发中,射击系统常因输入、状态、行为耦合导致连发异常、换弹冲突与网络同步失准。其本质是缺乏对‘武器行为’(如后坐力曲线、弹药逻辑)与‘射击控制’(如输入合法性校验、冷却调度)的正交分离。本方案基于ScriptableObject实现WeaponData数据资产化,配合ShootingController状态机服务,达成输入解耦、运行时参数可调、协程受控、网络预测友好等工程目标。适用于中大型FPS项目架构升级与数据驱动转型,尤其解决Unity InputSystem与物理反馈

weixin_30536861的博客 614

深度揭密 AI 私人知识库之一:RAG回答前准备流程

RAG技术突破大模型知识局限,通过检索增强生成实现精准问答。其核心流程包括:1)知识拆解,将文档分割为语义片段;2)向量化编码,使用Embedding模型转换文本;3)向量数据库存储,支持高效语义检索。该技术可应用于企业知识管理、智能客服等场景,解决传统知识检索响应慢、覆盖不全等问题。文中提供了Python实现代码,涵盖文本处理、向量化和检索全流程。RAG技术具有行业普适性,能有效解决企业"知识孤岛"问题,构建智能化的知识管理体系。

Q2024107的博客 1122

【汇编】TSR内存驻留程序实现与删除及热键设置——以实现时钟为例

【汇编】TSR内存驻留程序实现与删除及热键设置——以实现时钟为例 最近完成了一个关于时钟中断驻留的汇编大作业,对于TSR很是感兴趣,查阅了不少资料,发现现在很少相关的内容资料。尤其是TSR删除这一块几乎找不到在低的水平完全正确的做法,下面我对于TSR的删除我会介绍一种几乎小程序可以完成的方法。当然,标题中的TSR实现,热键设置我也会一一介绍。

cly116的博客 3971

从零搭建私人 RAG 实战:用 Markdown 沉淀技术决策与业务决策

本文介绍如何构建私人RAG系统,解决日常工作中决策记录分散的问题。系统通过解析Markdown笔记,进行语义切分后存入向量数据库,结合LLM实现自然语言查询。主要步骤包括:环境配置、文档解析与切分、向量存储构建、检索增强生成。建议记录决策时采用规范格式(如明确标题层级、标注关键信息)。该系统支持快速回溯历史决策,后续可优化嵌入模型、增加多格式支持等。核心价值在于将碎片化知识结构化,提升信息检索效率。

m0_62937412的博客 159

全网最全-DA14531-全球最小-BLE从入门到精通开发教程

本教程主要适用于低功耗产品,DA14531它体积小,非常适用于对体积敏感的设备,如无线可穿戴、传感器、助听器等设备。本文经过作者发大量时间来记录开发项目的调试方法,里面有许多笔者开发心得体会,旨在让读者工程师快速上手,减少摸索时间,提高软件质量。读者对象本文档主要适用以下工程师:嵌入式系统工程师单片机软件工程师IOT固件工程师BLE固件工程师。

hejinwu1314的博客 5138

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

10分钟私人定制 DeepSeek-R1 满血版知识库,火山引擎加Cherry的组合无敌了

10 分钟,从 0 到拥有自己的 AI 知识库。还在等什么?让你的知识活起来,让 AI 更懂你。我是江树, 一起在 AI 时代抢占先机。

2501_90975234的博客 1471

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

AI工程实践:从语义搜索到智能客服的Airbnb技术架构解析

在当今的互联网平台业务中,人工智能技术正从概念走向工程实践,深刻改变着产品体验与运营效率。其核心原理在于通过机器学习模型理解非结构化数据,实现智能匹配与自动化决策。从技术价值角度看,AI能够显著降低人工审核成本、提升供需匹配精度,并创造个性化用户体验。在应用场景上,电商平台、内容社区、在线服务等领域的搜索推荐、智能客服、内容审核等环节都是典型落地场景。本文以Airbnb的业务架构为例,深入探讨了如何构建基于向量数据库和RAG架构的智能房源匹配系统,其中涉及大语言模型(LLM)的工程化集成与多模态数据处理等关

weixin_33858485的博客 468

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

【 本地 LLM 知识库搭建(RAG)完整攻略:Open WebUI + ChromaDB 实现私人知识助手标题】

本文详细介绍了如何使用Open WebUI和ChromaDB搭建本地RAG知识库系统,实现私有文档的AI智能问答。主要内容包括:RAG技术原理(检索+生成)、Open WebUI的RAG架构设计、从文档准备到知识库创建的全流程实战指南,以及技术文档助手、论文阅读等实用场景。文章还提供了文本切分参数调整、Embedding模型更换等进阶配置方法,并针对常见问题给出解决方案。该系统完全本地运行,保障数据隐私,让用户能安全地使用AI处理私有文档信息。

Ai_easygo的博客 523

模型又更新了!阿里发布Qwen3-Embedding系列模型

今天阿里发布了Qwen3-Embedding系列模型,包括Qwen3-Embedding和\**Qwen3-Reranker。专为文本嵌入和排序任务设计,基于 Qwen3 基础模型进行训练

m0_59235245的博客 1313

《别再只会调API了!10分钟教你用DeepSeek + LangChain搭建私人知识库》

DeepSeek V3发布后效果惊艳,但如何让它“读懂”你私有的PDF文档、公司财报或个人笔记?这就是RAG(检索增强生成)技术的魅力。今天手把手带大家搭建一个本地知识库,不花一分钱,打造你的专属AI助手!

nanshaws的博客 575
上一篇: 万字长文:大语言模型或将重塑现代金融市场工作者的工作方式
下一篇: 搭建 Embedding 向量数据库,手把手教你创造自己的私人智能助理
AI_小站
博客等级 码龄3年 6255粉丝 1154原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值