


写在前面
前几篇,分享的都是如何白嫖国内外各大厂商的免费大模型服务~
有小伙伴问,如果我想在本地搞个大模型玩玩,有什么解决方案?
Ollama,它来了,专为在本地机器便捷部署和运行大模型而设计。
也许是目前最便捷的大模型部署和运行工具,配合Open WebUI,人人都可以拥有大模型自由。
今天,就带着大家实操一番,从 0 到 1 玩转 Ollama。
1. 部署
1.1 Mac & Windows
相对简单,根据你电脑的不同操作系统,下载对应的客户端软件,并安装:
- macOS:https://ollama.com/download/Ollama-darwin.zip
- Windows:https://ollama.com/download/OllamaSetup.exe
1.2 Linux
推荐大家使用 Linux 服务器进行部署,毕竟大模型的对机器配置还是有一定要求。
裸机部署
step 1: 下载 & 安装
命令行一键下载和安装:
curl -fsSL https://ollama.com/install.sh | sh
如果没有报错,它会提示你 ollama 的默认配置文件地址:
Created symlink /etc/systemd/system/default.target.wants/ollama.service → /etc/systemd/system/ollama.service.
接下来,我们采用如下命令查看下服务状态, running 就没问题了:
systemctl status ollama
查看是否安装成功,出现版本号说明安装成功:
ollama -v
step 2: 服务启动
浏览器中打开:http://your_ip:11434/,如果出现 Ollama is running,说明服务已经成功运行。

step 3: 修改配置(可选) 如果有个性化需求,需要修改默认配置:
配置文件在:
/etc/systemd/system/ollama.service,采用任意编辑器打开,推荐vim
- 默认只能本地访问,如果需要局域网内其他机器也能访问(比如嵌入式设别要访问本地电脑),需要对 HOST 进行配置,开启监听任何来源IP
[Service]
Environment="OLLAMA_HOST=0.0.0.0"
- 如果需要更改模型存放位置,方便管理,需要对 OLLAMA_MODELS 进行配置:
[Service]
Environment="OLLAMA_MODELS=/data/ollama/models"
不同操作系统,模型默认存放在:
macOS: ~/.ollama/models
Linux: /usr/share/ollama/.ollama/models
Windows: C:\Users\xxx\.ollama\models
- 如果有多张 GPU,可以对 CUDA_VISIBLE_DEVICES 配置,指定运行的 GPU,默认使用多卡。
Environment="CUDA_VISIBLE_DEVICES=0,1"
4.配置修改后,需要重启 ollama
systemctl daemon-reload
systemctl restart ollama
注意:上面两条指令通常需要同时使用:只要你修改了任意服务的配置文件(如 .service 文件),都需要运行systemctl daemon-reload使更改生效。
Docker 部署
我们也介绍下 Docker 部署,无需配置各种环境,相对小白来说,更加友好。
step 1: 一键安装
如果是一台没有 GPU 的轻量级服务器:
docker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama --restart always ollama/ollama
简单介绍下这个命令的参数:
- docker run:用于创建并启动一个新的 Docker 容器。
- -d:表示以分离模式(后台)运行容器。
- -v ollama:/root/.ollama:将宿主机上的 ollama 目录挂载到容器内的 /root/.ollama 目录,便于数据持久化。
- -p 11434:11434:将宿主机的 11434 端口映射到容器的 11434 端口,使外部可以访问容器服务。
- –name ollama:为新创建的容器指定一个名称为 ollama,便于后续管理。
- –restart always:容器在退出时自动重启,无论是因为错误还是手动停止。
- ollama/ollama:指定要使用的 Docker 镜像,这里是 ollama 镜像。
宿主机上的数据卷 volume 通常在 /var/lib/docker/volumes/,可以采用如下命令进行查看:
[root@instance-20240702-1632 ~]# docker volume ls
DRIVER    VOLUME NAME
local     dockers_postgres-data
local     ollama
local     open-webui
[root@instance-20240702-1632 ~]# ls /var/lib/docker/volumes/
backingFsBlockDev  dockers_postgres-data  metadata.db  ollama  open-webui
如果拥有 Nvidia-GPU:
docker run -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama
安装成功后,注意要给服务器打开 11434 端口的防火墙,然后浏览器打开 http://your_ip:11434/,如果出现 Ollama is running,说明服务已经成功运行。
step 2: 进入容器
如何进入容器中执行指令呢?
docker exec -it ollama /bin/bash
参数说明:
- exec:在运行中的容器中执行命令。
- -it:表示以交互模式运行,并分配一个伪终端。
- ollama:容器的名称。
- /bin/bash:要执行的命令,这里是打开一个 Bash shell。
执行后,你将进入容器的命令行,和你本地机器上使用没有任何区别。
如果不想进入容器,当然也可以参考如下指令,一键运行容器中的模型:
docker exec -it ollama ollama run qwen2:0.5b
如果一段时间内没有请求,模型会自动下线。
2. 使用
2.1 Ollama 常用命令
Ollama 都有哪些指令?
终端输入 ollama:
Usage:
  ollama [flags]
  ollama [command]

Available Commands:
  serve       Start ollama
  create      Create a model from a Modelfile
  show        Show information for a model
  run         Run a model
  pull        Pull a model from a registry
  push        Push a model to a registry
  list        List models
  ps          List running models
  cp          Copy a model
  rm          Remove a model
  help        Help about any command

Flags:
  -h, --help      help for ollama
  -v, --version   Show version information

Use "ollama [command] --help" for more information about a command.
我们翻译过来,和 docker 命令非常类似:
ollama serve # 启动ollama
ollama create # 从模型文件创建模型
ollama show  # 显示模型信息
ollama run  # 运行模型,会先自动下载模型
ollama pull  # 从注册仓库中拉取模型
ollama push  # 将模型推送到注册仓库
ollama list  # 列出已下载模型
ollama ps  # 列出正在运行的模型
ollama cp  # 复制模型
ollama rm  # 删除模型
2.2 Ollama 模型库
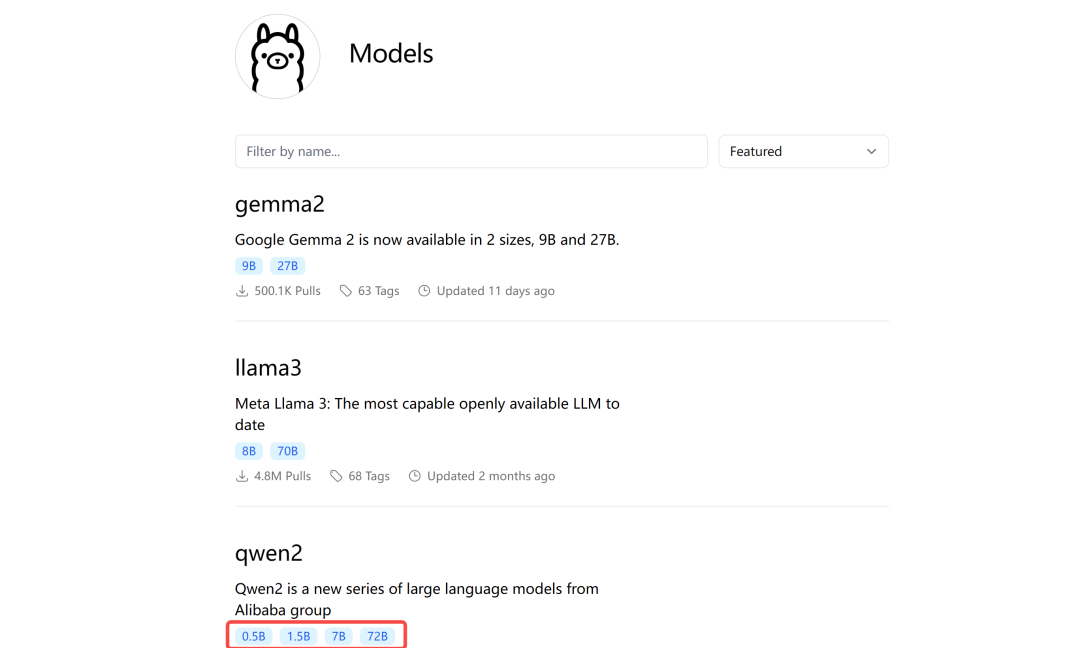
类似 Docker 托管镜像的 Docker Hub,Ollama 也有个 Library 托管支持的大模型。
传送门:https://ollama.com/library
从0.5B 到 236B,各种模型应有尽有,大家可以根据自己的机器配置,选用合适的模型。
同时,官方也贴心地给出了不同 RAM 推荐的模型大小,以及命令:

注:至少确保,8GB的 RAM 用于运行 7B 模型,16GB 用于运行 13B 模型,32GB 用于运行 33B 模型。这些模型需经过量化。
因为我的是一台没有 GPU 的轻量级服务器,所以跑一个 0.5B 的 qwen 模型,给大家做下演示:
root@535ec4243693:/# ollama run qwen2:0.5b
pulling manifest
pulling 8de95da68dc4... 100% ▕████████████████████████████████████▏ 352 MB
pulling 62fbfd9ed093... 100% ▕████████████████████████████████████▏  182 B
pulling c156170b718e... 100% ▕████████████████████████████████████▏  11 KB
pulling f02dd72bb242... 100% ▕████████████████████████████████████▏   59 B
pulling 2184ab82477b... 100% ▕████████████████████████████████████▏  488 B
verifying sha256 digest
writing manifest
removing any unused layers
success
>>> 你是谁
我是来自阿里云的超大规模语言模型——通义千问。我能够理解、生产、传播各种语言和文字,可以回答您在任
何语言或任何问题的问题。

>>> Send a message (/? for help)
2.3 自定义模型
如果要使用的模型不在 Ollama 模型库怎么办?
GGUF (GPT-Generated Unified Format)模型
GGUF 是由 llama.cpp 定义的一种高效存储和交换大模型预训练结果的二进制格式。
Ollama 支持采用 Modelfile 文件中导入 GGUF 模型。
下面我们以本地的 llama3 举例,详细介绍下实操流程:
step 1: 新建一个文件名为 Modelfile 的文件,然后在其中指定 llama3 模型路径:
FROM /root/models/xxx/Llama3-FP16.gguf
step 2: 创建模型
ollama create llama3 -f Modelfile
step 3: 运行模型
ollama run llama3
终端出现 >>,开启和 Ollama 的对话旅程吧~
下面是几个常用案例:
- 多行输入:用"""包裹
>>> """Hello,
... world!
... """
I'm a basic program that prints the famous "Hello, world!" message to the console.
- 多模态模型:文本 + 图片地址
>>> What's in this image? /Users/jmorgan/Desktop/smile.png
The image features a yellow smiley face, which is likely the central focus of the picture.
- 将提示作为参数传递
$ ollama run llama3 "Summarize this file: $(cat README.md)"
 Ollama is a lightweight, extensible framework for building and running language models on the local machine.
PyTorch or Safetensors 模型
Ollama 本身不支持 PyTorch or Safetensors 类型,不过可以通过 llama.cpp 进行转换、量化处理成 GGUF 格式,然后再给 Ollama 使用。
关于 llama.cpp 的使用,小伙伴可以前往官方仓库:https://github.com/ggerganov/llama.cpp。下载后需要编译使用,成功后会在目录下生成三个可执行文件:
main:模型推理
quantize:模型量化,包括1.5位、2位、3位、4位、5位、6位和8位整数量化
server:提供模型API服务
不过我们只能需要用到它的模型转换功能,还是以 llama3 举例:首先安装项目依赖,然后调用 convert.py 实现模型转换:
pip install -r requirements.txt
python convert.py  /root/xxx/Llama3-Chinese-8B-Instruct/ --outtype f16 --vocab-type bpe --outfile ./models/Llama3-FP16.gguf
提示词实现模型定制
刚才我们介绍了 Modelfile,其中我们还可以自定义提示词,实现更个性化的智能体。
假设现在你从模型库下载了一个 llama3:
ollama pull llama3
然后我们新建一个 Modelfile,其中输入:
FROM llama3

# 设置温度参数
PARAMETER temperature 0.7

# 设置SYSTEM 消息
SYSTEM """
你是猴哥的 AI 智能助手,将基于猴哥发表的所有文章内容回答问题,拒绝回答任何无关内容。
"""
Ollama 实现模型量化
Ollama 原生支持 FP16 or FP32 模型的进一步量化,支持的量化方法包括:
Q4_0 Q4_1 Q5_0 Q5_1 Q8_0

K-means Quantizations:
Q3_K_S Q3_K_M Q3_K_L Q4_K_S Q4_K_M Q5_K_S Q5_K_M Q6_K
在编写好 Modelfile 文件后,创建模型时加入 -q 标志:
FROM /path/to/my/gemma/f16/model
ollama create -q Q4_K_M mymodel -f Modelfile
2.3 API 服务
除了本地运行模型以外,还可以把模型部署成 API 服务。
执行下述指令,可以一键启动 REST API 服务:
ollama serve
下面介绍两个常用示例:
1、生成回复
curl http://129.150.63.xxx:11434/api/generate -d '{
  "model": "qwen2:0.5b",
  "prompt":"Why is the sky blue?",
  "stream":false
}'
2、模型对话
curl http://localhost:11434/api/chat -d '{
  "model": "qwen2:0.5b",
  "messages": [
    { "role": "user", "content": "why is the sky blue?" }
  ],
  "stream":false
}'
更多参数和使用,可参考 API 文档:https://github.com/ollama/ollama/blob/main/docs/api.md
2.4 OneAPI 集成
前段时间,我们已经完成了 OneAPI 的部署。
OneAPI 也支持 Ollama 模型,我们只需在 OneAPI 中为 Ollama 添加一个渠道。

创建好之后,点击 测试 一下,右上角出现提示,说明已经配置成功,接下来就可以采用 OpenAI 的方式调用了。

2.5 Open WebUI 界面搭建
Open WebUI 是一个可扩展的自托管 WebUI,前身就是 Ollama WebUI,为 Ollama 提供一个可视化界面,可以完全离线运行,支持 Ollama 和兼容 OpenAI 的 API。
🚀 一键直达:https://github.com/open-webui/open-webui
Open WebUI 部署
我们直接采用 docker 部署 Open WebUI:
因为我们已经部署了 Ollama,故采用如下命令:
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main
其中:--add-host=host.docker.internal:host-gateway 是为了添加一个主机名映射,将 host.docker.internal 指向宿主机的网关,方便容器访问宿主机服务
假设你之前没有安装过 Ollama,也可以采用如下镜像(打包安装Ollama + Open WebUI):
docker run -d -p 3000:8080 -v ollama:/root/.ollama -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:ollama
Open WebUI 使用
在打开主机 3000 端口的防火墙之后,浏览器中输入:http://your_ip:3000/,注册一个账号:

可以发现界面和 ChatGPT 一样简洁美观,首先需要选择一个模型,由于我们只部署了 qwen2:0.5b,于是先用它试试:

右上角这里可以设置系统提示词,以及模型参数等等:

在个人设置这里,可以看到内置的 TTS 服务:
管理员面板这里,有更多探索性功能,比如图像生成,如果你部署了 StableDiffusion,这里同样支持调用:

不得不说,Open WebUI 的功能真的非常强大,更多功能可参考官方文档:https://docs.openwebui.com/
感兴趣的小伙伴赶紧去试试吧~
3. 文末福利
相信看到这里的你,已经基本可以玩转 Ollama 了。
只不过觉得上述流程略显麻烦?
没问题,你的困惑早有人帮你搞定了,GitHub 上有开发者做了 docker-compose 一键整合安装包:
传送门:https://github.com/valiantlynx/ollama-docker
你只需要一行命令:
docker-compose up -d
就能一键启动 Ollama + Open WebUI~
启动成功后,注意看一下不同容器的端口号:
docker ps
接下来的操作,和前两部分一致,快去愉快玩耍吧~
写在最后
至此,我们一起走完了 Ollama 的部署和实战流程。
在我看来,Ollama 也许是目前最便捷的大模型部署和使用工具,对小白非常友好。
简单的命令行操作,用户即可快速启动和管理模型,极大降低了技术门槛,用户可以专注于模型的应用,而无需关注底层技术细节。此外,Ollama 的离线运行也为数据安全提供了保障。
期待大家在使用 Ollama 的过程中,发现更多有趣的 AI 应用场景。让我们一起推动大模型技术的应用落地,探索更广阔的可能性!
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 4348


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


