Transformer 动画揭秘:数据处理的四大关键技术

表格数据处理:Transformer 超越决策树 TabPFN平均归一化RMSE **0.923**,优于CatBoost(0.872)和XGBoost(0.855),尤其在非线性关系场景(如“混凝土强度预测”)中,误差降低30%。:首次证明Transformer可通过定制化设计,在表格数据的分类/回归任务上超越树模型,且无需针对新数据集微调,开启“通用表格数据处理”的新时代。:开源协议(Apache 2.0)和轻量化设计,推动Transformer在医疗、金融、科研等领域的快速落地,开启“表格数据处理民主化”的新篇章。 阅读详情

0背景

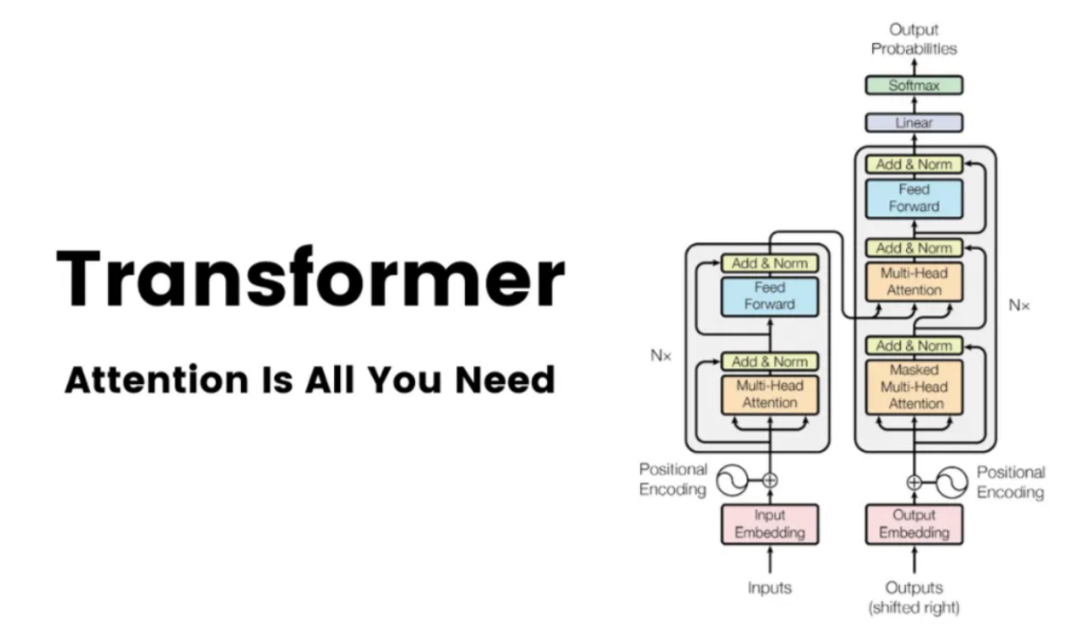
Transformer 大模型,一种基于自注意力机制的神经网络架构,已被广泛应用于各种自然语言处理任务,比如:机器翻译、文本摘要、生成问答等。
图片

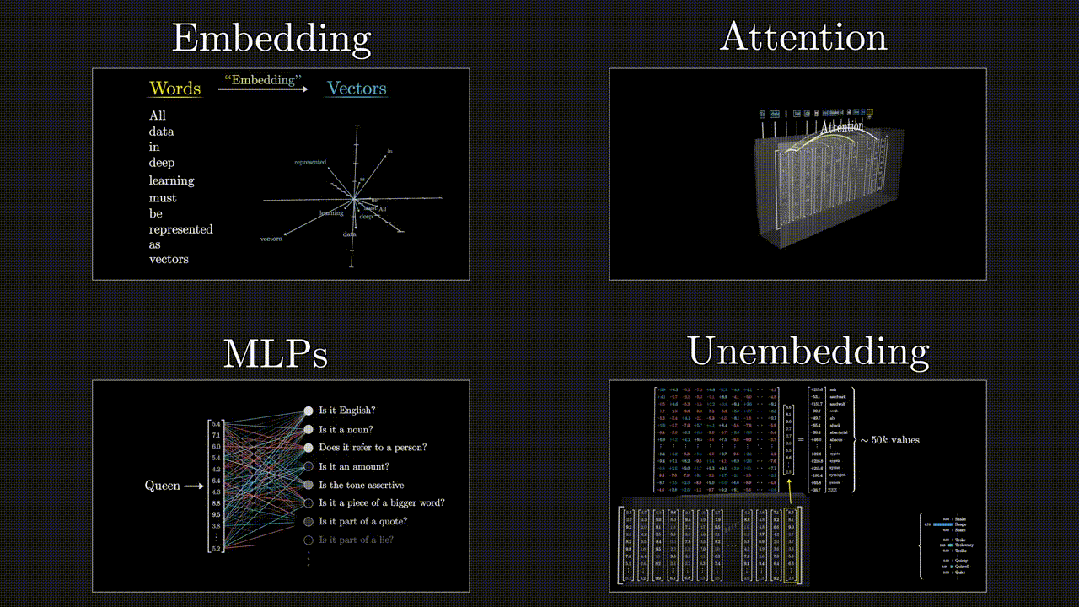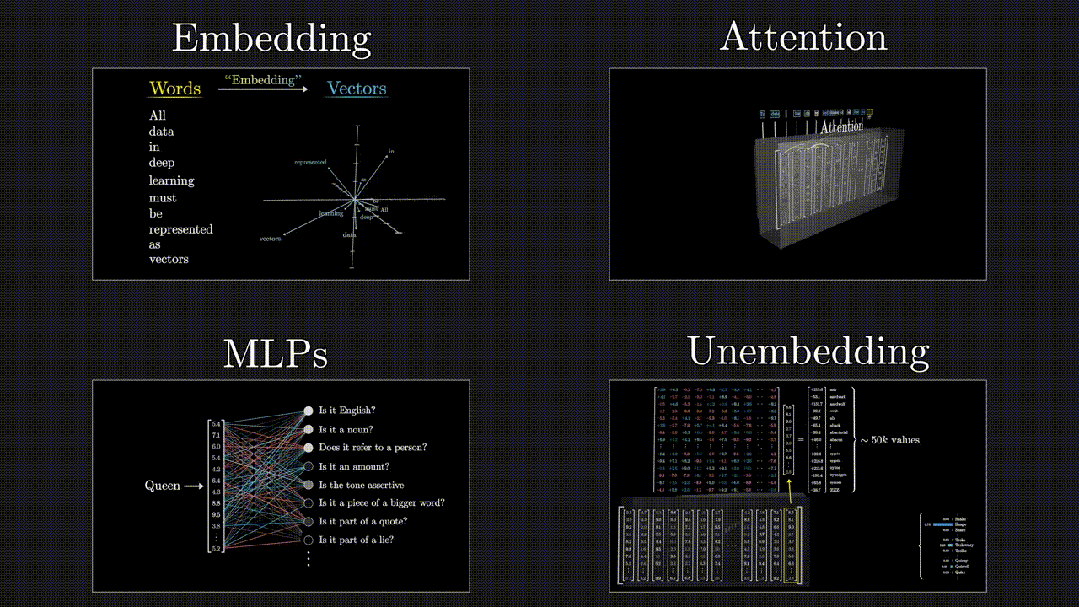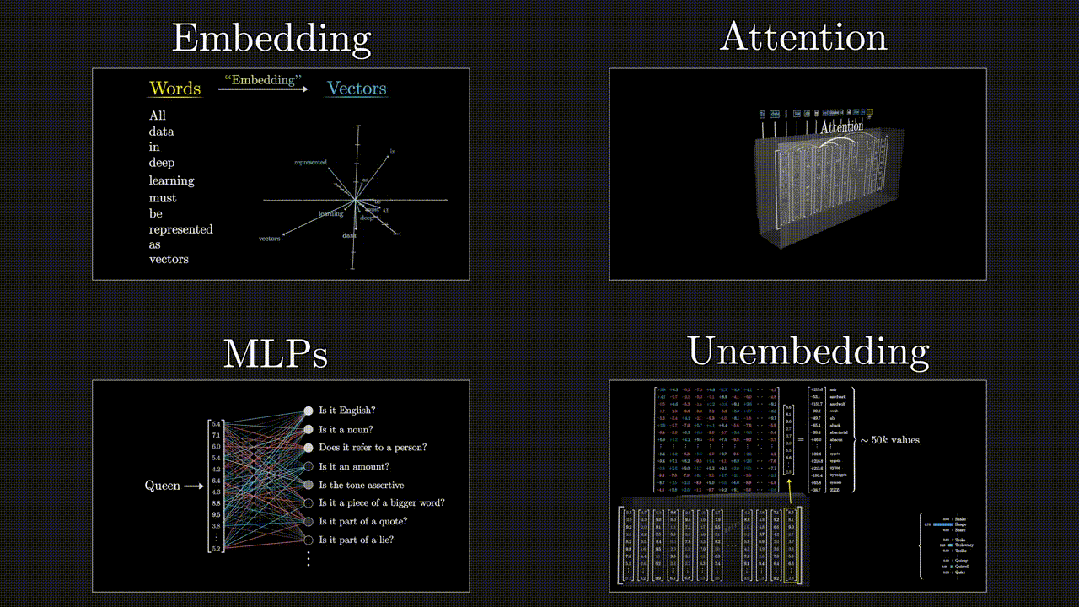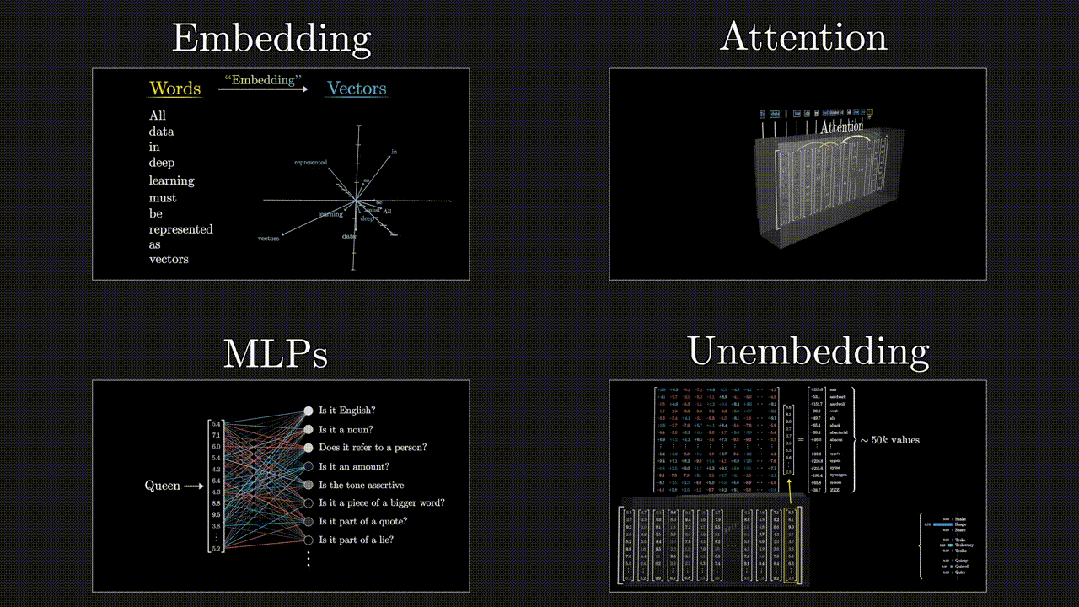
从端到端的角度来看,Transformer 大模型中数据的处理流程主要包括四个阶段:首先是嵌入阶段(Embedding),随后是注意力机制阶段(Attention),然后是通过多层感知机(MLPs)进行处理,最后是从模型的表示转换到最终输出的解嵌入阶段(Unembedding),如下图所示:
图片

图:Embedding -> Attention -> MLPs -> Unembedding

下面是对这四个阶段的简要介绍。

—1—Embedding(嵌入)阶段

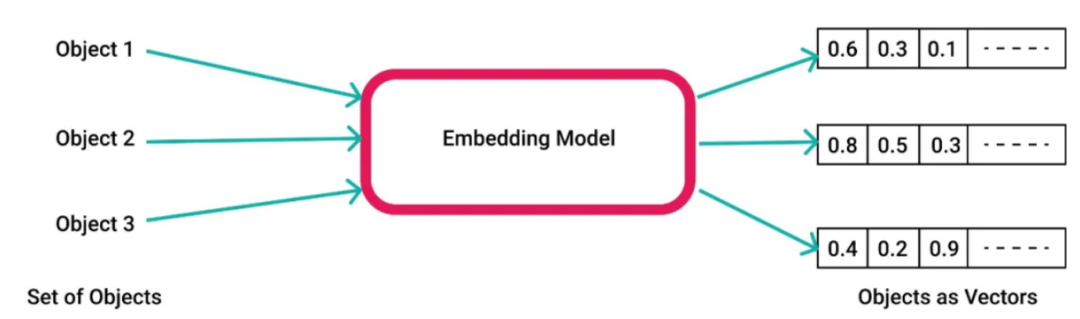
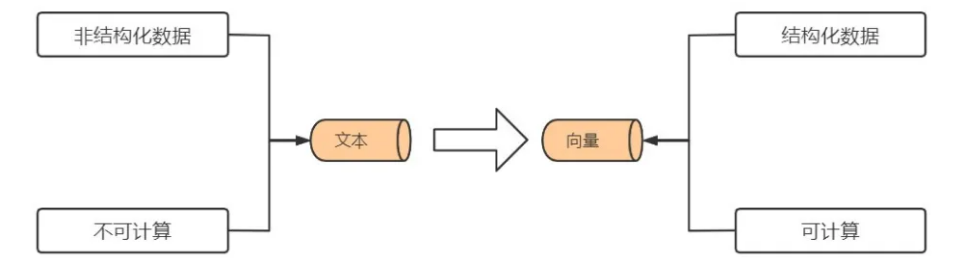
大模型的输入通常由离散的词汇或符号组成(比如:在英文文本中,每个单词或标点符号都是一个单独的符号)。嵌入层的作用是将这些离散的符号转换成连续的、具有固定维度的向量(通常称为词嵌入)。这些向量能够捕获符号的语义以及上下文信息。
图片

在Transformer 大模型中,无论是编码器(Encoder)还是解码器(Decoder),都包含一个嵌入层。此外,在解码器中,还会添加一个位置嵌入(Positional Embedding)层,用于记录序列中单词的位置信息,这是因为 Transformer 大模型不通过 RNN 或 CNN 等传统结构来直接捕捉序列的顺序信息。
图片

—2—Attention (注意力机制)阶段

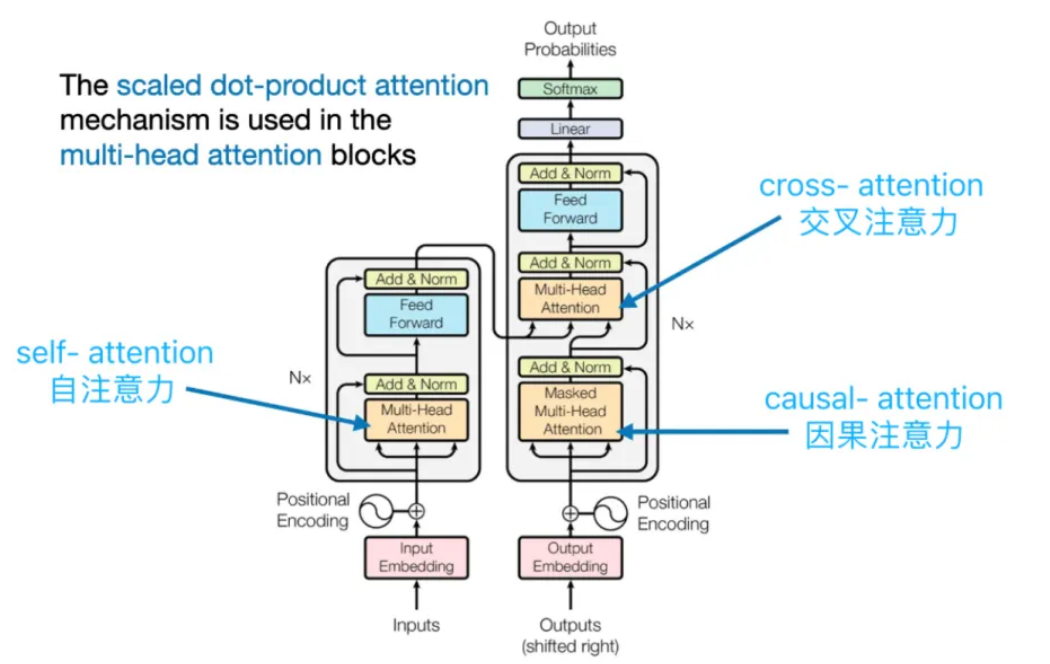
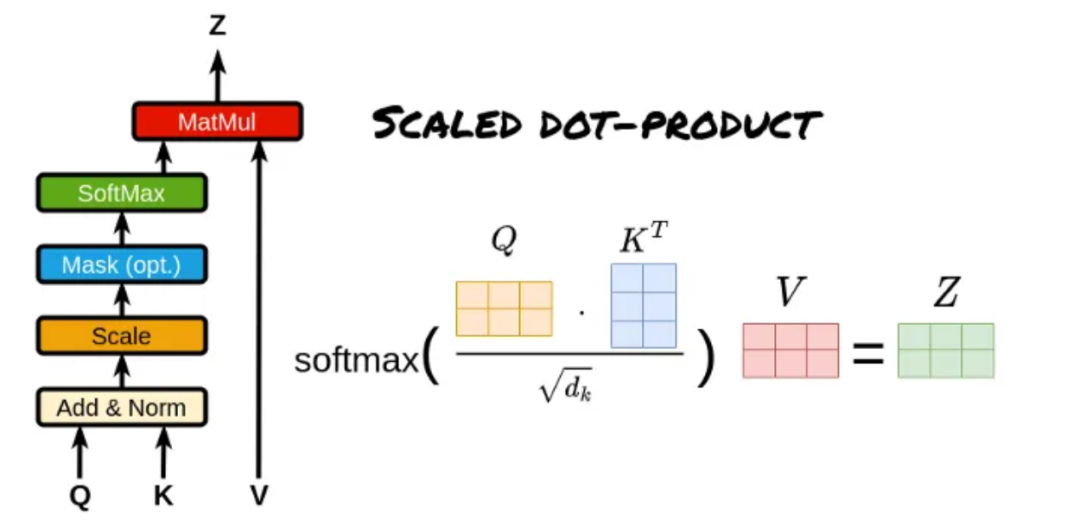
注意力机制构成了 Transformer 大模型的基石,它使得大模型能够在产生当前输出时聚焦于输入序列中的各个部分。Transformer 大模型采用了多种类型的注意力机制,其中包括自注意力(Self-Attention)、编码器-解码器注意力(Encoder-Decoder Attention)以及掩码多头注意力(Masked Multi-Head Attention)。
图片

自注意力机制使得大模型能够识别序列内不同位置之间的相互关系,进而把握序列的内在结构。编码器-解码器注意力机制则使得大模型在输出生成过程中能够针对输入序列的特定部分给予关注。在注意力机制的运算过程中,会生成一个注意力权重矩阵,该矩阵揭示了输入序列中每个位置对于当前位置的贡献程度。
图片

—3—MLPs(多层感知机,也称为前馈神经网络)阶段

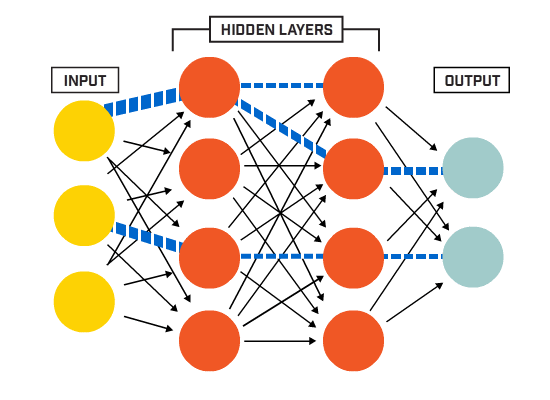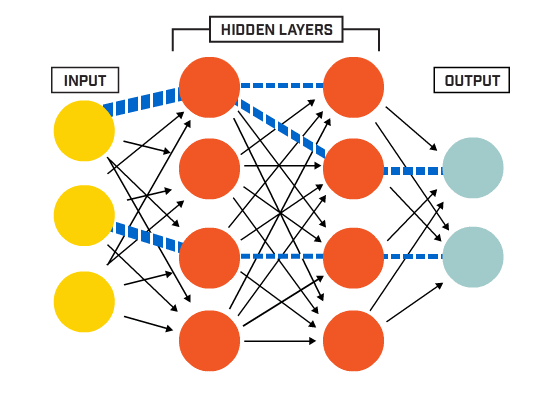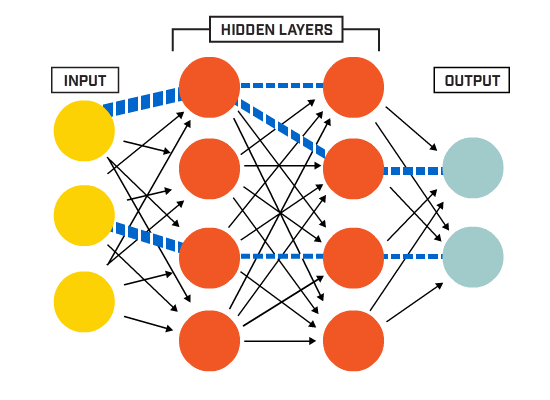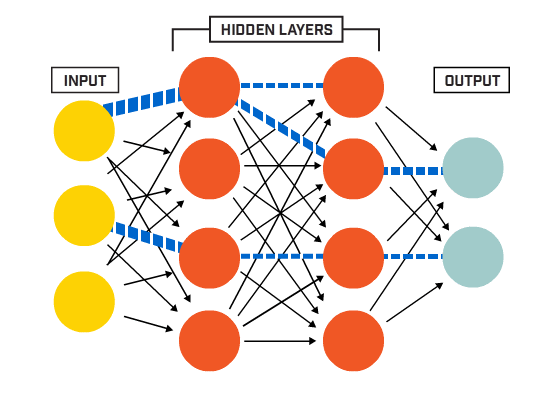
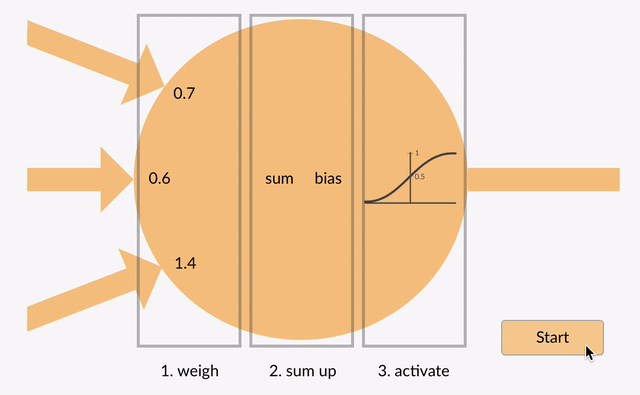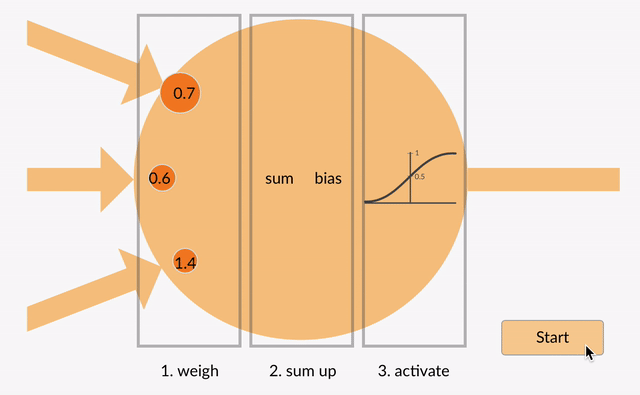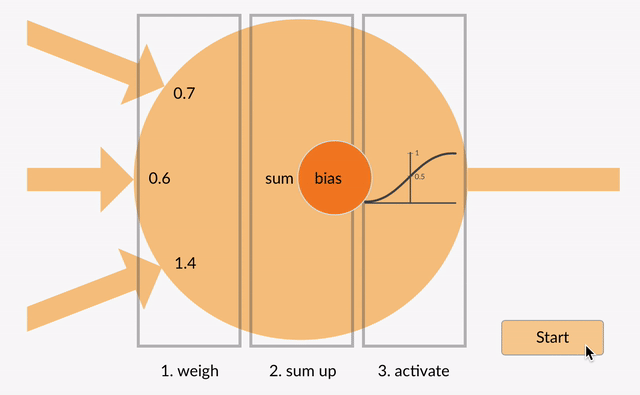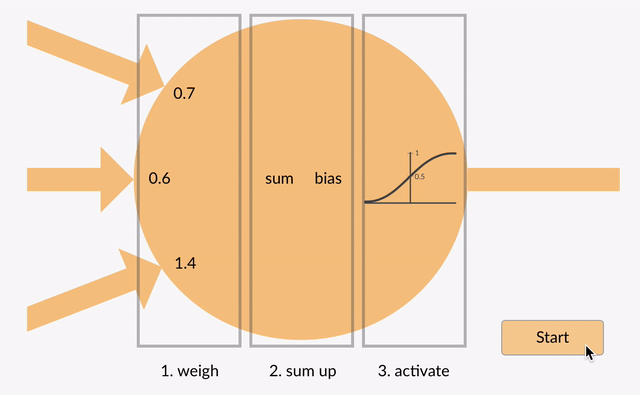
在注意力机制处理之后,大模型会利用一个或多个全连接层(也称为前馈网络或 MLPs)来进行更深层次的变换和特征提取。
图片

这些全连接层能够捕捉输入数据中的非线性关系,并辅助模型识别更复杂的模式。在 Transformer 大模型中,MLPs 一般被置于自注意力层和归一化层之间,共同构成了所谓的“编码器块”或“解码器块”。
图片

—4—Unembedding(从模型表示到最终输出)阶段

这一过程可以被视作从大模型的内部表示到最终输出格式的转换。

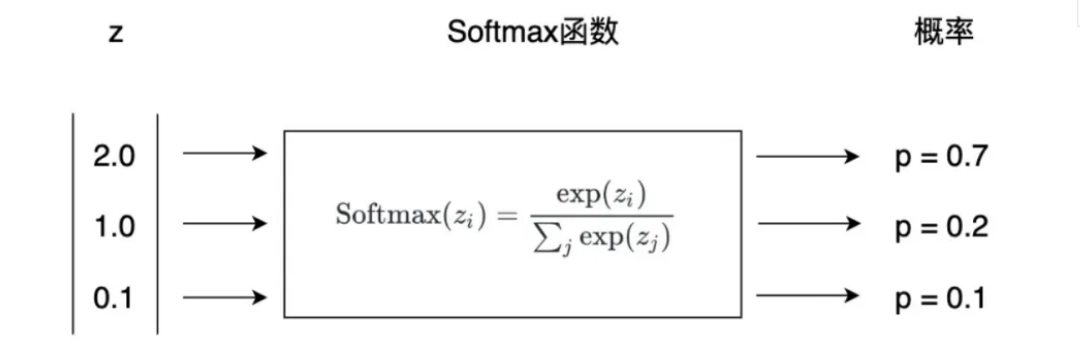
在文本生成任务中,比如:机器翻译,解码器的输出将通过一个线性层和一个 Softmax 函数,以产生一个概率分布,该分布反映了下一个输出词(token)的概率。
图片

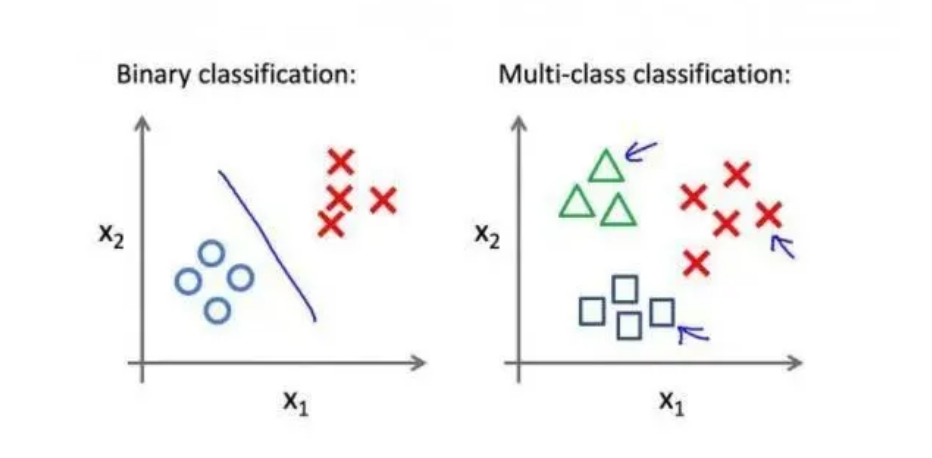
而在其他类型的任务中,比如:文本分类,解码器的输出可能直接用于损失函数的计算(比如:交叉熵损失),或者通过其他方法转换成最终的预测结果。
图片

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

基于Pytorch的Transformer翻译模型前期数据处理方法 Google于2017年6月在arxiv上发布了一篇非常经典的文章:Attention is all you need,提出了解决sequence to sequence问题的transformer模型,该文章使用全Attention的结构代替了LSTM,抛弃了之前传统的encoder-decoder模型必须结合CNN或者RNN的固有模式。在减少计算量和提高并行效率的同时还取得了更好的结果,也被评为2017年 NLP 领域的年度最佳论文。 阅读详情

相关推荐

Transformer动画讲解 - 工作原理

Transformer模型在多模态数据处理中同样扮演着重要角色,其能够高效、准确地处理包含不同类型(如图像、文本、音频、视频等)的多模态数据。 Transformer工作原理四部曲:Embedding(向量化)、Attention(注意力机制)、MLPs(多层感知机)和Unembedding(模型

weixin_53880910的博客 1393

昇腾300I npu部署bge-m3 embedding模型

摘要:本文介绍了使用mis-tei镜像部署bge-m3模型的步骤。首先需申请并下载昇腾镜像仓库的mis-tei镜像,然后通过docker命令启动容器,配置环境变量、挂载目录等参数,指定entrypoint脚本。最后进行API测试,通过curl发送请求验证服务是否正常运行。部署过程需注意镜像版本、设备ID等配置参数的正确设置。全文提供了详细的命令行操作示例,便于开发者参考实施。(150字)

2201_76008113的博客 2058

手撕代码系列:Conv2D

在实际的神经网络中,每个卷积核都会对应一个偏置值。这意味着如果网络有多个卷积核,每个卷积核的输出都可以加上对应的偏置。

qq_55794606的博客 910

实战精选 | 在NPU上运行BGE embedding模型,提升RAG整体性能

BGE全称是BAAI General Embedding,即北京智源人工智能研究院通用Embedding模型,它可以将任意文本映射到低维的稠密向量,在文本向量化任务中得到了广泛的应用。可以看到在C-MTEB中文排行榜中,BGE系列模型的综合能力名列前茅,而在MTEB排行榜所有小于500MB的模型列表中,基于相同模型结构的BGE英文版本bge-large-en-v1.5的综合能力也能位列前五。图:BGE模型性能指标­。

xxue345678的博客 2623

在统信UOS Server 20上踩坑记:手把手教你搞定openGauss 5.0.0企业版安装(附常见报错解决方案)

本文详细记录了在统信UOS Server 20上安装openGauss 5.0企业版的实战经验,包括环境准备、依赖库问题、目录权限、内存参数调优等常见问题的解决方案。通过伪装系统标识、建立软链接、调整内存参数等方法,成功克服国产操作系统与企业级数据库的兼容性挑战,为开发者提供了一份深度排雷指南。

weixin_28698059的博客 264

FPGA可重构技术

介绍FPGA 可重构技术的实现方法,包括全局重构和部分重构

航天领域资深码农,型号经验丰富,一线干货分享 1989

Transformer 动画讲解:数据处理的四大关键步骤

节前,我们组织了一场算法岗技术&面试讨论会,邀请了一些互联网大厂朋友、今年参加社招和校招面试的同学。针对大模型技术趋势、大模型落地项目经验分享、新手如何入门算法岗、该如何准备面试攻略、面试常考点等热门话题进行了深入的讨论。Transformer 大模型,一种基于自注意力机制的神经网络架构,已被广泛应用于各种自然语言处理任务,比如:机器翻译、文本摘要、生成问答等。从端到端的角度来看,Transformer 大模型中数据的处理流程主要包括四个阶段:首先是(Embedding),随后是。

机器学习社区 1630

秦时明月6.2魔改版_从零到一部署指南_含安卓客户端配置与GM后台直通

本文提供《秦时明月》6.2魔改版从零开始的完整部署指南。详细讲解CentOS服务器环境准备、服务端文件部署与安装、关键端口开放及进程验证。重点涵盖安卓客户端APK的IP修改与重签名方法,并介绍了GM后台工具的访问与使用,助你快速搭建并管理专属游戏服务器。

garlic的博客 311

Transformer动画讲解:数据处理的四大关键步骤

Transformer 大模型,一种基于自注意力机制的神经网络架构,已被广泛应用于各种自然语言处理任务,比如:机器翻译、文本摘要、生成问答等。

bugyinyin的博客 1250

米哈游 AI产品经理面试题精选:10道高频考题+答案解析(附PDF)

米哈游是全球知名游戏开发商,以《原神》《崩坏》系列著称,专注二次元文化与AI技术创新。本文整理了10道AI产品经理面试题,涵盖Transformer架构、智能NPC设计、机器学习应用、AIGC产品规划等核心领域。题目既考察技术理解(如RAG原理、多模态模型),又关注产品落地(游戏平衡性优化、伦理安全),同时强调跨团队协作能力。参考答案均结合米哈游业务场景,体现技术驱动与玩家体验并重的产品思维,展现AI在游戏行业的创新应用前景。

ZHHHHH15的博客 682

【linux】linux 出现一个网卡绑定多个ip怎么处理

我的原因是我使用了dhcp,这个会自动分配ip, 将 BOOTPROTO 参数由 dhcp 改为 static,并移除或注释掉与动态分配地址 10.0.2.15 相关的配置行(如果存在)。执行后,您可以再次使用 ip -4 a 或 ifconfig 命令确认 IP 地址已被移除。输出可以看出,您的虚拟机(k8s003)中存在一个名为 enp0s3 的网卡绑定了多个 IPv4 地址。对于某些 Linux 发行版(如 Ubuntu、Debian),您可能需要编辑网络接口的配置文件来移除多余的 IP 地址。

九师兄 297

Transformer动画讲解 - 数据处理的四个阶段

Transformer动画讲解1。原创 AllenTang。

具身机器人和通用AI 904

NL2SQL进阶系列(3):Data-Copilot、Chat2DB、Vanna Text2SQL优化框架开源应用实践详解[Text2SQL]

NL2SQL进阶系列(3):Data-Copilot、Chat2DB、Vanna Text2SQL优化框架开源应用实践详解[Text2SQL]

丨汀、的博客 5421

动画讲解:揭秘Transformer模型的工作原理

*“Generative”意味着这个模型是生成式的。**与判别式模型不同,生成式模型试图捕捉数据的分布,并能够生成新的、看似真实的数据样本。,使模型学习到文本中的语言结构和语义信息。**“Transformer”是GPT模型的核心架构。**Transformer是一种基于自注意力机制的神经网络架构,包括编码器和解码器两部分。*******,其能够高效、准确地处理包含不同类型(如图像、文本、音频、视频等)的多模态数据。*******但在机器学习和自然语言处理的上下文中,我们更倾向于将其理解为。

2401_85375186的博客 815

基于STM32的智能快递柜设计(全部资料)

本文设计了一种基于STM32F407ZGT6的智能快递柜系统,通过模块化硬件设计和软件算法优化,实现了24小时无人值守、温湿度智能调控、远程监控等功能。系统集成OLED显示、GSM通信、舵机控制、超声波检测等模块,存取响应时间≤3秒,识别准确率达99.2%,较传统模式效率提升60%。测试表明系统运行稳定,用户满意度达92%,具有成本低、安全性高、可扩展性强等特点,为智慧物流末端配送提供了创新解决方案。未来可引入AI算法、太阳能供电等功能进一步优化系统性能。

3254968421的博客 587

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

什么是 GPT?Transformer 工作原理的动画展示

如果一切顺利,最后一层 feed-forward 输出中的最后一个向量(the very last vector in the sequence), 就已经包含了句子的核心意义(essential meaning of the passage)。对这个向量进行 unembedding 操作(也是一次性矩阵运算), 得到的就是下一个单词的备选列表及其概率:图:原始输入为 "To date, the cleverest thinker of all time was",让模型预测下一个 token。

hao_wujing的专栏 3096

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

【Transformer系列】深入浅出理解ViT(Vision Transformer)模型

【Transformer系列】深入浅出理解ViT(Vision Transformer)网络模型

IT菜鸟 6万+

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Transformer数据处理核心:collate_batch函数深度解析

还在为Transformer模型的数据预处理头疼吗?批量处理的复杂性常常让初学者望而却步。本文将深入剖析annotated-transformer中的`collate_batch`函数,一文掌握Transformer数据处理的核心技巧! **读完本文你将获得:** - ✅ 理解collate_batch函数的核心作用 - ✅ 掌握序列填充与截断的最佳实践 - ✅ 学会特殊标记的处理方法 - ✅

gitblog_00377的博客 1099
上一篇: # 搭建本地大模型和知识库最简单的方法
下一篇: 务必收藏,Transformer细节18问18答
AI大模型_学习君
博客等级 码龄3年 6137粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值