在NPU上运行BGE embedding模型,提升RAG整体性能

24G算力卡NPU主机:本地跑大模型的低成本实践 大模型推理的成本与隐私问题正在推动AI部署方式向本地化演进。与通用GPU工作站相比,NPU主机以专用加速单元和小体积设计,在功耗、噪音与性价比上具备独特优势。当搭配24G算力卡时,可在本地高效运行7B至32B量化模型,将按token计费的云端模式转变为一次投入的“买断制”。这一方案不仅大幅降低高频RAG知识库、AI Agent等场景的调用成本,还能确保敏感数据不出内网。本文从硬件选型、系统配置、推理框架到完整案例,提供一套可复现的本地大模型部署参考,帮助开发者和技术团队用更低成本获得稳定的AI推理能力。 阅读详情

介绍

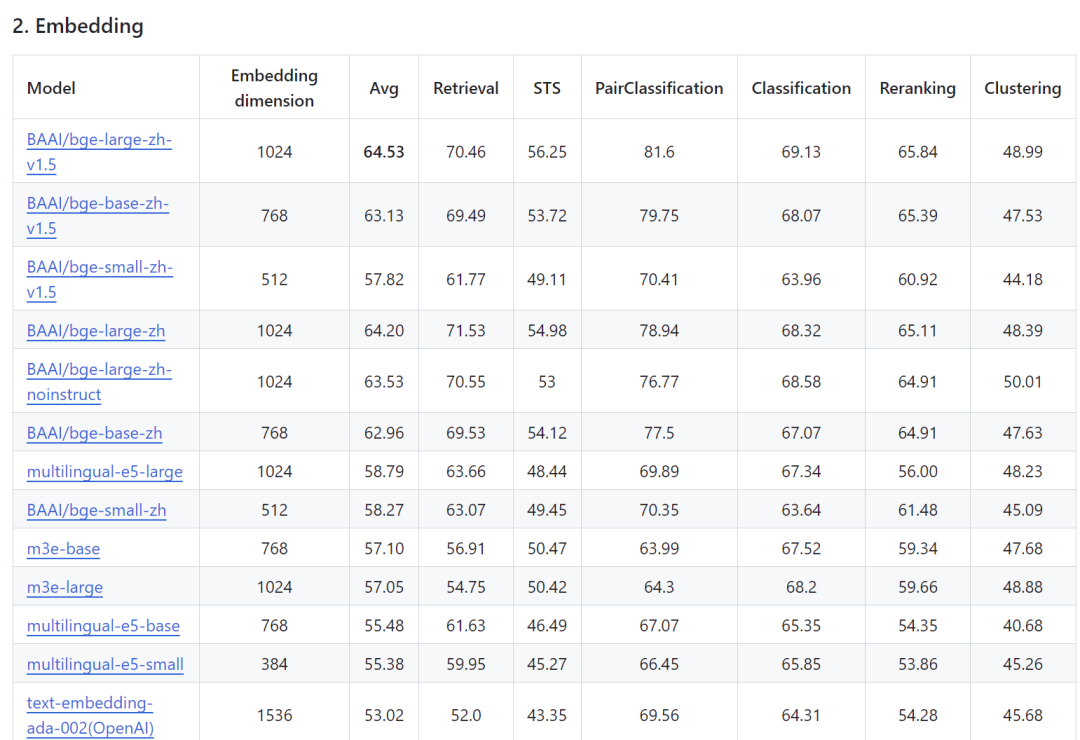
BGE全称是BAAI General Embedding,即北京智源人工智能研究院通用Embedding模型,它可以将任意文本映射到低维的稠密向量,在文本向量化任务中得到了广泛的应用。可以看到在C-MTEB中文排行榜中,BGE系列模型的综合能力名列前茅,而在MTEB排行榜所有小于500MB的模型列表中,基于相同模型结构的BGE英文版本bge-large-en-v1.5的综合能力也能位列前五。
d48d50163ffbe7798b5c36d850fea753.png

图:BGE模型性能指标­

而作为英特尔AIPC架构中专用的AI处理器,NPU相较于CPU拥有更高的算力,并能以更低的能耗来运行深度学习模型。在类似RAG等的复杂任务中,我们往往需要利用Embedding, LLM, Ranker等多个模型­协同处理数据,通过将Embedding模型部署在NPU上,可以进一步优化其性能和能耗。OpenVINO™作为目前唯一可以同时在Intel CPU, GPU以及NPU平台上部署AI模型的工具套件,提供了一套通用API接口函数,方便开发者灵活地调度AIPC上的异构资源。本文将分享如何利用 OpenVINO™ 工具套件在NPU上部署BGE Embedding模型。

示例完整代码: https://github.com/openvinotoolkit/openvino_notebooks/tree/latest/notebooks/llm-rag-langchain

OpenVINO™

模型转换

利用Optimum-intel命令行工具,我们便可以非常快速将BGE embedding模型导出为 OpenVINO™ 的IR格式文件。这里只需要指定模型的Hugging Face ID或是本地路径,以及任务类别为feature-extraction。

optimum-cli export openvino --model bge-large-zh-v1.5 --task feature-extraction bge-small-zh-v1.5

当以上命令执行完毕后,IR格式模型以及对应的tokenizer文件将被保存在bge-large-zh-v1.5目录下:

├── config.json

├── openvino_model.bin

├── openvino_model.xml

├── special_tokens_map.json

├── tokenizer_config.json

├── tokenizer.json

└── vocab.txt

由于 NPU 中的所有数据都将被转到到 fp16 精度进行计算,而 BGE Embedding 模型的原始精度是FP32,因此在FP32转FP16的过程中部分超过FP16表达范围的值会溢出,例如一个极小的负数,BGE Embedding也同样存在这个问题,所以这里我们会将这种类型的 Tensor 利用 OpenVINO™ 的 Transformation


大模型入门必知:从Transformer到RAG的100个核心概念解析 Transformer架构作为现代大语言模型的核心,通过自注意力机制实现了对长序列的高效并行处理,奠定了模型理解与生成能力的基础。其编码器-解码器结构衍生出BERT、GPT等不同架构,分别擅长文本理解与生成任务。基于此,检索增强生成(RAG)技术通过结合外部知识库与生成模型,有效缓解了模型幻觉问题,提升了回答的准确性与时效性,成为企业级AI应用的关键解决方案。掌握这些基础原理与技术价值,是理解大模型训练流程、性能评估及实际应用场景的起点,也是构建智能问答、内容创作等实践项目的认知基石。 阅读详情

相关推荐

AI工程实践指南:RAG与微调的决策框架与落地细节

RAG(检索增强生成)和模型微调是当前大语言模型落地的两大核心技术路径。其本质区别在于知识更新方式——RAG实现动态知识注入,微调则完成静态能力固化。理解二者在数据新鲜度、安全合规、资源消耗与可解释性上的权衡原理,是构建高可用AI系统的关键技术基础。在多租户SaaS、金融客服、医疗问答等强监管或实时性敏感场景中,混合架构正成为主流选择。本文基于Towards AI工程团队的季度实践总结,深入拆解chunking策略、重排序优化、LoRA微调隐性成本、PaliGemma多模态部署等真实战场细节,提供可复用的技

weixin_33895516的博客 512

大模型时代职业指南:从零基础到应用开发工程师的实战路径

大语言模型(LLM)作为人工智能领域的前沿技术,其核心原理是基于Transformer架构的海量参数模型,通过预训练和微调来理解和生成人类语言。这项技术的价值在于将强大的自然语言处理能力工程化、平民化,使其不再是实验室的专属,而是能够广泛应用于各行各业的赋能工具。在应用场景上,大模型正通过检索增强生成(RAG)、智能体(Agent)等技术范式,深度融入金融分析、智能客服、内容创作和企业知识管理等具体业务中,解决信息过载与效率瓶颈问题。本文聚焦于大模型应用开发这一热门方向,为希望入局的开发者梳理出一条清晰的技

418

中国AI开源16强:国产大模型与推理框架实测清单

开源大模型和AI推理框架是构建自主可控AI应用的底层基石。其核心原理在于通过开放代码、权重与工具链,降低算法集成、模型部署与中文场景适配门槛;技术价值体现在开箱即用性、国产硬件兼容性及真实业务闭环能力;典型应用场景覆盖政务智能问答、金融研报生成、边缘端代码辅助等高需求领域。尤其在中文长文本理解、法律/医疗术语处理、昇腾/飞腾平台支持等方面,一批深度本地化的开源项目已形成实质性生产力。本文聚焦经三平台实测验证的中国AI开源代表项目,涵盖Qwen2、BGE-M3、vLLM-CN、LightLLM等关键组件。

516

AI工程中的模型选型:任务对齐与多智能体协同实践

大语言模型(LLM)并非通用黑箱,其能力具有显著的不可互换性——不同模型在知识广度、领域深度与工程友好度上构成三维能力空间。理解这一本质,是构建稳定AI系统的基础。本文聚焦模型选型的核心逻辑:从脱离业务的参数崇拜,转向以任务为锚点的对齐评估;通过输入模态约束、输出确定性要求、延迟吞吐平衡与数据主权红线四象限法,实现技术决策可量化;进一步引入多智能体协同调度思想,让Phi-3-mini做轻量路由、DeepSeek-V2专精结构化抽取、Qwen2系列强化中文长文本理解,形成分工明确、故障隔离的生产级架构。结合无

weixin_30587927的博客 352

端侧语义搜图实战:基于SigLIP2的图片向量化与检索优化

随着移动设备算力的提升,端侧AI正在成为隐私敏感场景下的关键技术路径。以自然语言检索本地图片为例,传统标签方案受限于有限词表,难以覆盖开放式的用户描述。多模态模型CLIP系列通过将图像与文本映射到统一向量空间,让语义搜索成为可能。本文从向量化原理出发,探讨SigLIP2模型在端侧部署中的选型与量化技巧,并介绍如何借助SQLite向量索引实现高效检索。该方案可广泛应用于智能相册、本地知识库及离线RAG系统,在保护隐私的同时提供流畅的搜索体验。文章结合工程实践,剖析了图像与文本预处理的细节、性能优化策略及真实场

weixin_34347651的博客 450

79、昇腾系列服务器/昇腾系列推理卡/昇腾系列嵌入式开发板+Dify+one api部署DeepSeek-R1-Distill-Qwen-32BW8A8+RAG本地模型知识库和负载均衡双实例

阶段,安装过程缺什么,,在docker外面git下源码,进入容器内部进行量化,这里的容器建议在创建个8卡的容器,双卡容器量化会显示npu显存不够,除非你用cpu转模型,我就懒得创建容器了,使用cpu量化吧,巨慢;创建容器,进入容器,计划使用两张昇腾NPU卡推理DeepSeek-R1-Distill-Qwen-32B的W8A8模型,所以构建的容器用两张卡,选6、7卡吧,0-6号卡可以跑文本嵌入模型、重排序模型;直接进入量化阶段,在容器外面操作即可,环境不用管,因为系统已经默认配置了环境,直接跳到。

sxj731533730 6118

【信息科学与工程学】【数据中心】第四十五篇 Volcano + HAMi + K8s + GPU 的运营调度01

plugins并发:predicates(资源/亲和)、gang(minMember)、drf/proportion(队列公平)、priority(优先级)、deviceshare(vgpu binpack/spread)、nodeorder(拓扑/NUMA/NVLink)、binpack(碎片最小化);不对,3g.40gb占用40GB,两个就是80GB,再加1g.10gb超出。动态将2g.20gb拆成2个1g.10gb,3g.40gb拆成3个1g.10gb+1个3g.20gb(备用),满足全部需求。

weixin_49199313的博客 40

cst-python联合仿真的问题解决

cst与python联合仿真出现无法调用CST的问题解决

ayihu_的博客 2373

如何在软件复位后保留指定RAM区域的数据

本文主要介绍S32K144的RAM retention功能

北极熊的脖子(16605192620@163.com) 1万+

zabbix监控深信服下一代防火墙配置

深信服下一代防火墙v8.0管理界面,zabbix,SNMP

weixin_43996471的博客 6873

从零开始:用ADS仿真设计一个2.4GHz Wi-Fi低噪声放大器(含完整电路图)

本文提供了一份详细的ADS软件仿真指南,手把手教你从零开始设计一个2.4GHz Wi-Fi低噪声放大器。内容涵盖核心指标理解、晶体管选型与建模、匹配网络设计、偏置电路集成,并通过S参数仿真、噪声优化及线性度验证等步骤,最终呈现完整的优化电路图,助力射频初学者掌握LNA设计全流程。

weixin_29197835的博客 807

学Simulink--环境感知场景实例:基于Simulink的毫米波雷达多目标跟踪仿真

本文介绍了基于Simulink的毫米波雷达多目标跟踪仿真系统,重点分析了FMCW雷达信号处理流程(Range/Doppler FFT、CFAR检测)和多目标跟踪算法(JPDA数据关联、EKF状态估计)。通过构建城市道路交叉场景,验证了系统在跟踪精度(位置误差<0.2m)、实时性(单帧处理24ms)和鲁棒性(ID切换率<5%)方面的性能优势,并提出了UKF滤波、多传感器融合等优化方向。该仿真系统为自动驾驶环境感知提供了实用的毫米波雷达跟踪解决方案。

amy_mhd的博客 92

【雕爷学编程】Arduino动手做(45)---红外光电避障传感器模块4

雕爷学编程,Arduino动手做,开源硬件,创客传感器,红外光电避障传感器模块

雕爷学编程 2503

Linux系统安全学习手册

Linux反弹shell Linux系统应急响应 Linux服务器安全加固 Linux下的用户、组和权限 Linux中的gcc Linux中su和sudo的用法和区别 Linux系统python2与python3共存 Linux中grep工具的使用 Linux中环境变量的设置 Linux中常见的150个命令(干货) Linux中编写Shell脚本 LNMP环境搭建Wordpress博客 LAMP环境搭建一个Discuz论坛 Linux运维比较常用的一些脚本 Linux系统中安装软

谢公子的博客 7532

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

上一篇: 大模型的 Embedding 模型该如何进行微调?
下一篇: 【大模型】2024大模型典型示范应用案例集——附219页PDF
普通网友
博客等级 码龄3年 4493粉丝 309原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值