


2023年,大模型如雨后春笋般爆发,58同城TEG-AI Lab作为AI平台部门,紧跟大语言模型技术发展步伐,打造了大语言模型平台,支持大语言模型训练和推理部署,并基于大语言模型平台构建了58同城生活服务领域(房产、招聘、汽车、黄页)垂类大模型灵犀大语言模型(ChatLing) ,支撑了业务方大模型应用的探索落地。灵犀大语言模型在公开评测集和实际应用场景下,效果均优于开源通用大语言模型以及商用通用大语言模型。
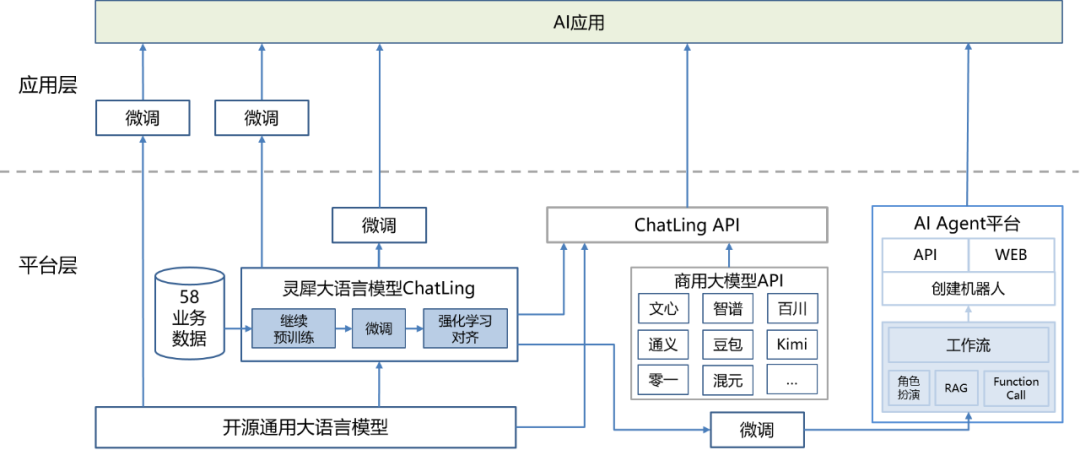
在研发灵犀大模型过程中,我们在大模型参数高效微调PEFT(Parameter-Efficient-FineTuning)上进行了广泛实践。本文系统性地解析了几种常用的大模型参数高效微调(PEFT)方法,并对每种方法的算法原理和应用效果进行了详细介绍。首先本文将阐述参数高效微调的重要性和基本概念,随后简要介绍LoRA微调之前的两种PEFT方法Adapter Tuning和Prefix Tuning,然后本文会详细介绍LoRA(Low-Rank Adaptation)、QLoRA(Quantized LoRA)和AdaLoRA(Adaptive Low-Rank Adaptor)以及SoRA(Sparse low rank adaptation)四种参数高效方法。这些方法旨在减少训练参数量、降低微调成本,同时保持模型性能。此外,本文还将分享基于Unsloth的微调加速实践经验,并且展示了在不同模型和数据集上的训练加速效果和显存占用降低效果。综上,本文将从微调方法和训练加速两个角度分享相关的技术解析和实践经验。
参数高效微调(PEFT)
自ChatGPT走红以来,众多厂商纷纷投身于人工智能大型语言模型的研发与应用。然而,高昂的计算成本使得从零开始训练一个大型语言模型对许多人而言是难以企及的。因此,自Transformer和BERT时代起,微调(fine-tuning)技术因其亲民性而受到青睐。对于业务应用而言,基于开源模型在大量语料上训练的语言模型,再针对特定业务领域数据进行微调,这种成本效益更高的方法在当前阶段似乎更符合大多数公司的需求。微调技术指的是在一个已经训练好的模型(预训练模型)的基础上,通过特定的下游任务数据对其进行进一步训练,从而使模型能够更好地适应特定任务的需求。预训练模型如同一个高效的特征提取器,基于先前训练数据中积累的经验,能够提取出有效的特征,从而显著提升下游任务的训练效果和收敛速度。全参数微调是指在下游任务的训练过程中,对预训练模型的所有参数进行更新。如下图所示在微调过程中,权重矩阵中的每个参数(d*d个参数)都要参与更新。然而对于大规模语言模型而言,传统的全参数微调方法所需的计算资源和时间成本极其高昂。例如,最近发布的开源模型如LLaMA 3-70B、Qwen 1.5-110B和DeepSeek-V2等,这些模型的参数规模之大使得即使是进行微调普通用户也难以承受。
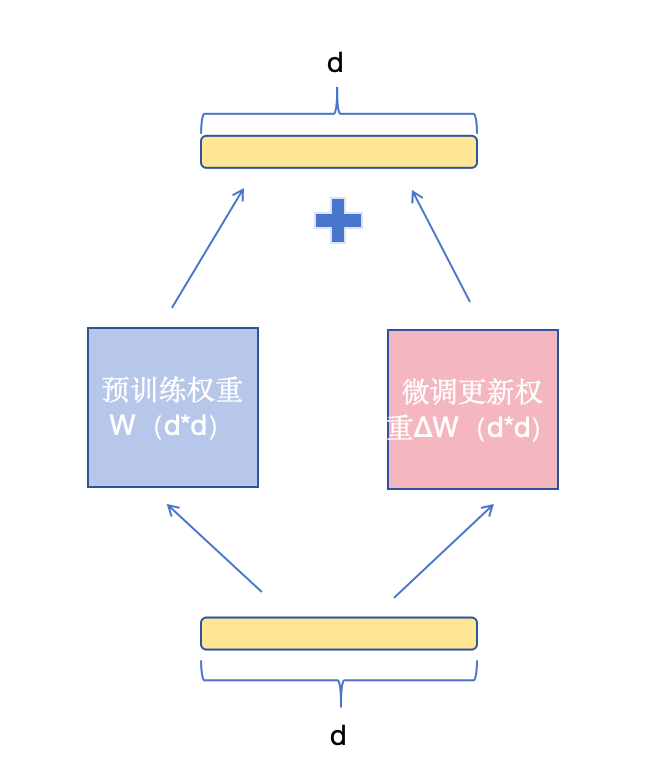
但是,由于模型在预训练阶段已经见过足够多的数据,收获了足够的经验,因此我只要想办法给模型增加一个额外知识模块,让这个小模块去适配我的下游任务,模型主体保持不变(freeze)即可。这就称之为参数高效微调,这种方式显然可以大大降低训练参数量,也就降低了微调成本,而且大幅提高了微调效率。下面,本文将介绍几种广泛使用的高效微调方法。
Adapter Tuning与Prefix Tuning
Adapter Tuning
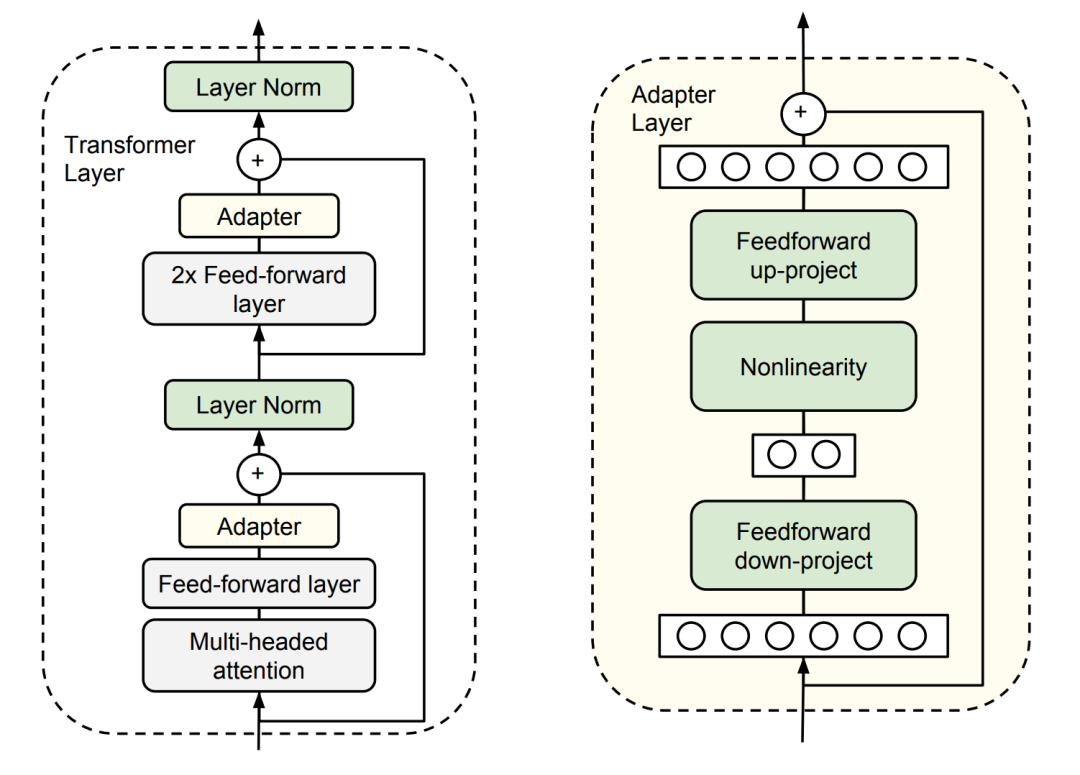
2019 年,Adapter Tuning将 Adapter 引入 NLP 领域,作为全模型微调的一种替代方案。Adapter 主体架构如下图所示。图例中的左边是一层Transformer Layer结构,其中的Adapter是前文描述的“额外知识模块”;右边是Adatper的具体结构。在微调时,除了Adapter的部分,其余的参数都是被冻住的(freeze),这样能有效降低训练参数量。Adapter的内部架构不是本文所述的重点,这里就不再介绍了。但这样的结构设计存在一个显著劣势:添加了Adapter后,模型结构整体变的更深了,会增加推理时长。
Prefix Tuning
前缀微调(prefix-tunning),用于生成任务的轻量微调。前缀微调将一个连续的特定于任务的向量序列添加到输入,称之为前缀。与提示(prompt)不同的是,前缀完全由自由参数组成,与真正的 token 不对应。相比于传统的微调,前缀微调只优化了前缀。因此,我们只需要存储一个大型 Transformer 和已知任务特定前缀的副本,对每个额外任务产生非常小的开销。Prefix Tuning通过在输入数据前增加prefix前缀来给模型提供一些先验知识的方式来提升微调效果,提供prefix的长度在训练中是一个可调整的超参,在微调中,同样需要冻结住模型其余模块,只训练prefix相关的超参即可。
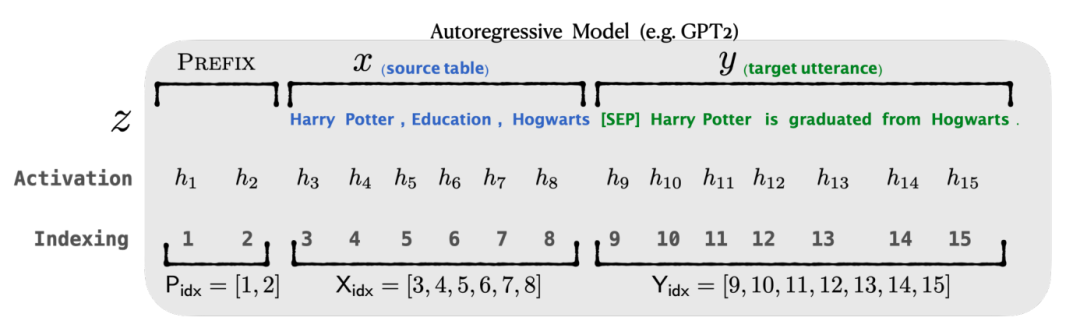
如上论文图给出的是gpt2模型 ,prefix的作用是引导模型提取x相关的信息,进而更好地生成y。例如,我们要做一个summarization的任务,那么经过微调后,我们希望prefix能引导模型去提取输入x中的核心信息做总结。但是这样也会导致模型输入的增加,增加计算量和推理时间,并且增加prefix难以保证训练效果。
LoRA(Low-Rank Adaptation)
原理
由于上面两种方法的劣势,我们希望找到一种方法既能像全参微调一样不增加额外输入或改变模型结构,又能大幅度减少训练参数量降低微调成本的方法。基于此LoRA(Low-Rank Adaptation,低秩适配器)第一个解决了这个问题。如下图是LoRA的整体架构,Lora通过在原始权重矩阵W的旁边新增一个旁路,这个旁路由低秩的两个矩阵 A 和 B 组成,这两个低秩矩阵组合用来近似模拟全参更新中的 ΔW 增量矩阵。在训练过程中,我们冻结住原始预训练模型的权重 W ,只更新LoRA的两个低秩参数矩阵 A 和 B 。为了在训练的初始时刻能保证加了LoRA Adapter之后不影响原始模型的能力,我们分别使用高斯初始化和零初始化来初始化 A 和 B 。
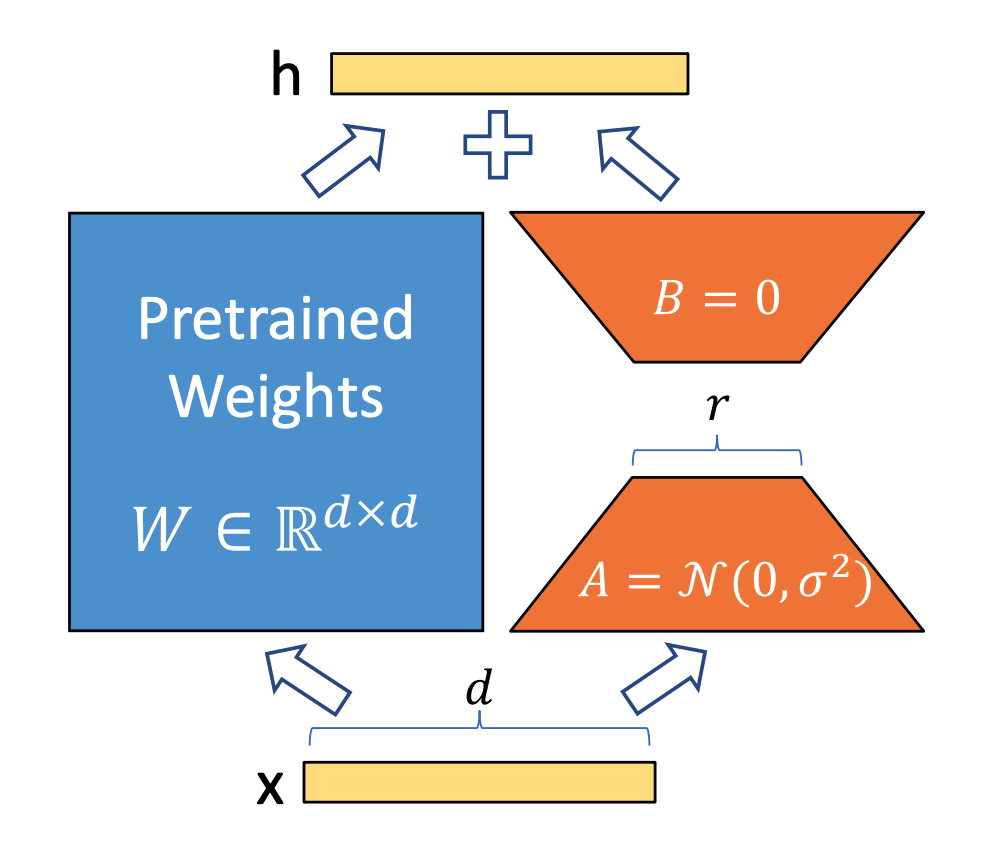
假设原始权重矩阵的维度是 d×d,LoRA低秩矩阵A的维度设置为 r×d,矩阵B的维度为 d×r,这里我们冻结原始权重,相当于只更新增量权重。可以理解为我们先通过A矩阵进行一个降维操作,然后再使用B矩阵进行升维操作。这样微调的参数就从原来的 d×d 降低到了 2×d×r。因为一般设置的参数 r 会远小于 d,所以这里能大大降低训练参数量。在训练过程中,由于预训练权重 W 被冻结,仅对低秩矩阵 A 和 B 进行训练。因此,在保存LoRA训练的权重时,仅需保存参数量相对较小的低秩部分即可。训练时,GPU显存通常存储以下内容:输入数据、模型权重、模型的中间结果、梯度以及优化器状态。相比全参数微调方法,LoRA训练中输入数据部分显存占用不变。而因为原始权重也需要参与计算,因此模型权重和中间结果的占用也不变(增加的LoRA部分权重几乎可以忽略不计)。关于梯度的显存占用分析则相对复杂,以反向传播时 B 的梯度计算为例进行具体分析如下:
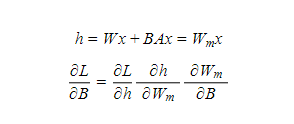
考虑 B 梯度的前两项,梯度的维度和预训练权重的梯度相同,均为 d×d。然而,由于LoRA并不作用于模型的所有层,并且由于训练参数的减少,优化器状态的存储显著减少,因为通常像类似adam优化器需要存储一阶梯度和二阶动量,而且通常优化器状态中存储的都是fp32类型的值,所以这部分显存占用相比全参微调大大降低,总体上显著降低了显存的占用。在推理时,将LoRA权重与原始权重合并即 h=(W+BA)x 的方式得到与原始模型一样的结构。这意味着完全不需要改变模型的任何结构,微调后模型的推理参数量与原始模型参数量完全一致。且这种方式让我们可以根据不同的业务场景基于同一个基座模型训练不同的LoRA权重,然后在不同的应用上加载不同的LoRA权重,非常灵活,而且LoRA权重通常非常小,也很易于存储和加载。
LoRA特点总结:
- • 对 A 采用高斯初始化,对 B 采用零初始化;
- • 微调的参数就从原来的 d×d 降低到 2×d×r ; r << d。
- • 推理时不增加任何计算量,与原始模型架构完全一致
- • 可以基于同一个基座在不同的场景下训练不同的lora模型加载使用
实验
LoRA现已在业界广泛应用于各个场景的微调任务,在诸多任务中都被验证是有效且可行的。我们也基于两个业务场景做了单一任务的微调实践。LoRA的原理在于增量矩阵 ΔW 满足低秩假设, h=(W+ΔW)×x 中的 ΔW 确实是一个低秩矩阵。如果不满足该假设,那么LoRA的分解就一定会有精度损失,而达不到最好的微调效果。因此需要在任务中需要选择合适的 r,理论上说,针对复杂的任务可能需要更大的 r,但是 r 的值越大,可训练的参数量就越大,训练时长和显存占用就会同时变得更大。一般来说增大 r 的值会取得更好的微调效果,但是也不是一定如此,对于简单任务的微调太大的训练参数反而会使模型训练容易过拟合而导致效果变差。因此在实验阶段我们在两个NLU业务数据集上对比了全参训练、以及不同大小的 r 的训练效果,同时为了证明微调的效果,我们还加入了使用GPT4 zero-shot做该任务的效果对比。实验基座模型采用qwen1.5-7b-base,我们分别对比全参微调、LoRA不同 r 的微调以及直接使用GPT4的效果对比(业务数据集2中“有效问题”指除了标签为“其它”的数据,“拒识”指标签为“其它”的数据):
NLU业务数据集1:
| 指标 | Precision | Recall | F1-Score |
|---|---|---|---|
| GPT4 | 63% | 58% | 59% |
| 全参 | 89.96% | 85.53% | 87 |


 1196


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


