【收藏必备】小白也能懂:文本召回与大模型RAG的向量检索技术入门

大模型外挂知识库优化——如何利用大模型辅助召回 大模型外挂知识库优化旨在通过利用大模型辅助召回,提高文档召回和模型回答的质量。HYDE策略通过生成假答案并结合用户问题进行向量召回,增强召回效果,但在微调过的向量化模型上效果不佳。FLARE策略提出主动多次召回,通过设计prompt让模型在需要时自动触发召回,解决了传统一次召回的不足。策略1通过增加生成主动召回标识的概率来促进召回,策略2则基于生成词的概率进行召回,提高了召回的准确性和效率。总体而言,这些策略通过优化召回过程,显著提升了大模型外挂知识库的性能和回答质量。 阅读详情

本文深入解析文本召回技术,详解大模型RAG的核心原理。从稀疏检索的TF-IDF、BM25到稠密检索的BERT、GPT,全面对比各类模型的特点与应用场景。无论您是刚入门的小白还是寻求进阶的程序员,本文都将帮助您构建完整的知识体系,掌握向量检索的关键技术,为构建高效的大模型应用奠定坚实基础。


什么是文本召回?是从向量数据库中召回与用户问题相关的文本片段。

最简单的文本召回环节示意图如下所示:
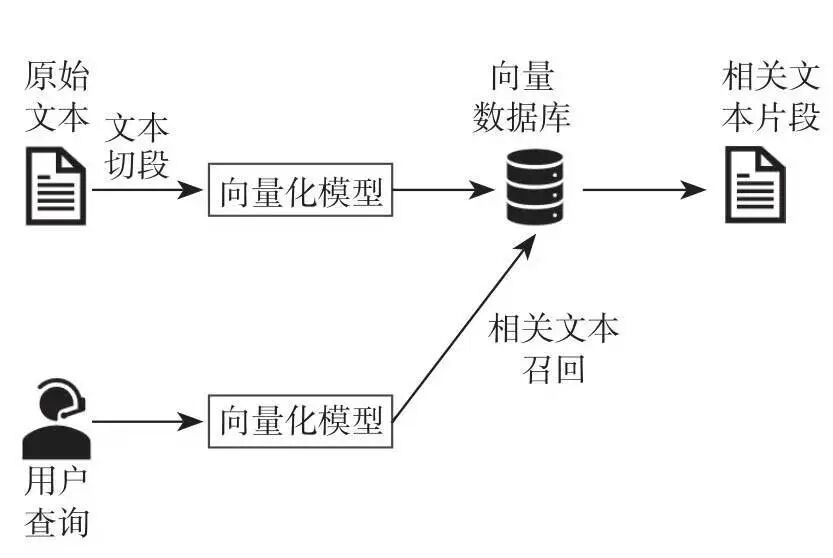
文本召回模型是大模型RAG的核心,介绍一下经典模型,包括稠密向量检索模型和稀疏向量检索模型。一类是基于BERT、GPT等深度学习模型的稠密向量检索模型,一类是以TF-IDF、BM25为代表的稀疏向量检索模型。稠密向量检索模型更擅长提取文本中的语义信息,稀疏向量检索模型更擅长提取关键词信息。大家看到常用的混合检索是把这两类模型优点都吸收了。

稀疏向量检索模型

介绍TF-IDF模型前,先介绍下最初的朴素词袋模型,朴素词袋模型是将文本片段转换为向量的一种最简单的方法,它将文本看作一个“袋子”,只关注文本中是否包含某个词,并统计每个词出现的频率,而不考虑词的顺序,也无法提取文本的语义信息。这个模型存在2个缺点,1是没有考虑文本长度对词频的影响,文本越长,某些词的可能性就会越大。2是该模型没有考虑常见词(如“的”,“你”)的权重问题。

TF-IDF是由词频(TF)和逆文件频率(IDF)相乘得到的。TF-IDF就是解决以上2个问题,它的核心思想是,一个词在一段文本中出现的次数越多,同时在其他文本中出现的次数越少,越能够代表该段文本。像一些搜索,检索类的框架用这个算法来推荐打分,比如Elasticsearch相关评分度。

BM25与朴素词袋模型和TF-IDF不同,它不是先计算文本向量,再通过向量计算相似度,而是直接根据查询文本和候选文本计算相似度。BM25是一个改进版,1是它考虑了词频对相似度评分的饱和度影响。比如一段100个词的文本,其中有10个词是“桃子”,根据BM25的思想,认为该文本跟“桃子”是强相关,而不要求“桃子”出现100词才能认为强相关。BM25会设置一个阈值,当到达了后,后续再出现就不会产生很大的影响。2是BM25在计算相似度时不仅考虑当前文本的长度,还考虑它与平均文本长度的相对大小。

稠密向量检索模型

BERT模型是基于transformer编码器结构而来的。每个位置的token拥有双向注意力,在句子开头位置的[cls]token也可以感知文本的全局信息。允许他前后翻看,联系上下文来理解每一个词、每一句话的真正含义。

GPT模型是基于transformer解码器结构而来的。它采用的单向注意力机制,每个位置的token只能感知到其之前的信息。如果想用单个位置向量来代表句向量,那么只能选用最后位置的向量。他只能根据已经写出来的内容(上文)来预测下一个最可能是什么(单向注意力)。

通过以上我们也了解为什么BERT更适合做情感分析,文本分类,语义分析;GPT则更适合做生成式的创造和预测内容,比如创造文章,对话聊天。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

作为一名从业五年的资深大模型算法工程师,我经常会收到一些评论和私信,我是小白,学习大模型该从哪里入手呢?我自学没有方向怎么办?这个地方我不会啊。如果你也有类似的经历,一定要继续看下去!这些问题啊,也不是三言两语啊就能讲明白的。

所以我综合了大模型的所有知识点,给大家带来一套全网最全最细的大模型零基础教程。在做这套教程之前呢,我就曾放空大脑,以一个大模型小白的角度去重新解析它,采用基础知识和实战项目相结合的教学方式,历时3个月,终于完成了这样的课程,让你真正体会到什么是每一秒都在疯狂输出知识点。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

大模型RAG的召回模式 模式描述特点应用场景稀疏召回关键词匹配快速、精准但语义弱传统检索稠密召回向量相似度语义强、可扩展QA/RAG混合召回稀疏+稠密提升Recall覆盖通用RAG多模态召回图文检索等支持多模态输入图文问答生成式召回LLM生成检索线索灵活、可控指令召回LLM控制检索流程可解释、复杂推理多跳QA/Agent。 阅读详情

相关推荐

【大模型RAG实战】文本召回模型

文本召回模型是大模型RAG的核心。本章首先介绍文本文本召回模型相关的基础知识,包括如何计算文本相似度和获取句子向量表示等。然后介绍一些经典模型,包括稠密向量检索和稀疏向量检索模型。重排序模型会在本章最后进行介绍,它进一步提高文本召回效果。

sysu_lluozh 2090

一文读懂大模型召回机制和chunk

本文系统介绍了大模型召回机制及相关技术要点。主要内容包括: 召回定义与应用:在RAG架构中通过向量检索从知识库获取相关文本块(chunk)以补充模型知识,应用于问答、语义搜索等场景; 关键技术要素:涵盖Embedding模型、chunk切分策略(100-500 tokens)、向量数据库(FAISS等)及评估指标(Recall@K); 上下文窗口对比:列举主流模型(如GPT-4达32K、Gemini 1.5Pro支持2M tokens)的处理能力; 优化方法:采用混合召回策略、滑动窗口切分及高质量Embed

何哥的博客 4670

antiSMASH安装与使用

antiSMASH本地安装 简要: antiSMASH的本地安装需要安装很多的依赖包,本文章使用conda辅助安装 参考: 官方:https://docs.antismash.secondarymetabolites.org/install/ 文章:http://blog.sciencenet.cn/blog-3416913-1240614.html 依赖包下载 conda install -y diamond=0.8.36 conda install -y fasttree=2.1.9 conda ins

Curry_chenhu的博客 7225

大模型召回重排

大模型重排,简单来说,就是在初步召回结果的基础上,利用大型深度学习模型对结果进行重新排序和优化。它的目的是根据特定的评估指标,将最符合用户需求、最有可能被用户点击或选择的结果排在前面,提高结果的准确性和用户满意度。大模型召回就是利用大型深度学习模型的强大能力,通过学习和理解数据的内在规律和特征,来快速定位到相关的信息。它可以帮助我们在海量的数据中迅速找到我们需要的内容,提高召回效率和准确率。在大数据和人工智能的时代,我们有了海量的数据和信息,如何从中快速准确地找到我们想要的内容,就成了一个重要的问题。

tqs_123456的博客 2226

原生H5如何优雅拦截浏览器返回事件:全面屏侧滑退出的解决方案

本文深入探讨了在原生H5中如何优雅地处理浏览器返回事件,特别是针对全面屏手机侧滑返回手势的解决方案。核心是利用HTML5 History API,通过`history.pushState`方法在历史栈中插入记录,并监听`popstate`事件,从而实现在用户侧滑时平滑关闭全屏预览层而非直接退出页面,有效提升了移动端H5应用的原生交互体验。

i0j1k2l3m的博客 270

逆变器LCL滤波器参数设计(一)

1.基本介绍 并网型逆变器一般是电流源逆变器,滤波器基本用LCL结构。 假设要设计额定功率10KVA的单相逆变器,采用两电平的全桥拓扑,采用SPWM控制,载波频率20KHz,电网等级220V,频率50Hz。 拓扑结构如图所示: 直流输入电压分为上下母线各1/2Vin,半母线电压为380V。 L1采用高频磁芯绕制,称为高频电感;L2用工频电感绕制,称工频电感;C是滤波电容,为高频谐波电流提供通路;Vg为电网电压。 载波调制比为:Mr=220*1.414/380=0.819 2.高频电感量的计算 逆变器可以等

weixin_43549807的博客 5万+

【收藏必备】RAG检索模块全解析:从向量检索到混合检索的实战指南

文章详解RAG系统中的检索模块,涵盖Query向量化、召回策略(向量、关键词、混合检索)、重排和结果过滤等关键步骤。强调检索优化需平衡召回率与精确率、降低延迟、处理专有词等挑战,提供实战案例和面试框架。核心观点是:检索优化是工程平衡的艺术,好的RAG系统依靠稳定的检索和准确的知识,而非玄学Prompt。

Android23333的博客 793

renderdoc的使用

renderdoc可以用来捕获帧渲染情况,排查一些GPU渲染、资源规格等问题。 下面讲述一些该软件连接真机调试使用。 一、下载安装renderdoc 软件的下载地址:https://renderdoc.org/可直接点击下载即可。该软件是开源免费的,不用破解。 下载后直接安装即可使用。 二、打开使用renderdoc 打开界面后,默认的界面布局如下图所示,(这里我已经设置了黑色主题,可以忽略这点),renderdo中主要的窗口有Texture Viewer(纹理查看器)、Event B.

x_xingduo_2315的博客 2万+

必收藏!一篇吃透RAG到底是什么?(小白&程序员入门必备)

当我们需要衡量一个检索系统(或 RAG 的召回阶段)表现好坏时,“召回率”是一个最核心的度量标准。举个例子,系统里面 100 本关于产品使用手册的书,但是我发起检索之后系统回收了 60 本书,但是只有 50 本的内容跟产品使用手册有关系,那我们的召回率就是 60/50=83.33,相当于我们只找回来了 83 的知识,还有 17 的内容给遗漏了召回率越高,说明系统越"完整"——重要的信息不容易被漏掉。

EnjoyEDU的博客 2170

PLL锁相环性能上不去?可能是电荷泵的电流失配在捣鬼(附Jae-Shin Lee经典方案解析)

本文深入分析了PLL锁相环性能瓶颈的根源——电荷泵电流失配问题,详细解析了Current Mismatch和Current Deviation的区别及其对系统的影响。重点介绍了Jae-Shin Lee的多级电流镜技术,该方案通过运放构建虚拟短路和四级电流镜结构,显著降低了电流失配,使参考杂散改善15dB以上。文章还提供了从仿真到流片的完整优化流程,帮助工程师系统解决电荷泵性能问题。

weixin_30684743的博客 370

FreeRTOS实战:如何避免HAL_Delay在高优先级中断中的坑(附TIM6配置指南)

本文深入剖析了在STM32 FreeRTOS项目中,于高优先级中断内调用HAL_Delay函数导致系统假死的根本原因——SysTick时基被FreeRTOS占用且优先级最低。文章提供了治本方案:通过配置TIM6作为独立且最高优先级的HAL时基,实现与FreeRTOS系统心跳的解耦,并附上详细的CubeMX配置与代码移植指南,确保系统实时性与稳定性。

weixin_29230059的博客 64

【收藏必备】RAG检索增强生成技术:从入门到实战,小白与大模型程序员必学指南

文章详细介绍了RAG(检索增强生成)技术,这是一种结合信息检索与文本生成的人工智能技术,旨在通过引入外部知识库解决大语言模型的幻觉问题。文章阐述了RAG的三阶段工作流程(检索、增强、生成),讲解了知识库构建中的文本分块与向量化技术,以及知识图谱构建中的实体关系抽取方法。通过结合Prompt工程与RAG技术,可实现更精准高效的文本生成,提升大模型在特定领域的应用效果。

Gaga246的博客 856

SCSA,scCATCH,SciBet,SingleR 四种注释方法比较

以下是和四种细胞类型注释方法的详细对比,从。

qq_40256654的博客 1215

收藏必备!RAG检索增强生成技术详解:解决大模型知识局限与幻觉问题的实战指南

RAG结合信息检索与文本生成,通过外部知识源增强大模型回答能力,解决知识局限、信息过时、幻觉问题和可解释性差等挑战。其流程包括数据处理(知识库构建)、检索召回和模型生成三阶段。通过文本切片优化、检索策略选择和答案验证等方法提升效果,但仍面临检索质量依赖、复杂文档处理等挑战。

2401_85154887的博客 1322

库存管理系统项目部署方案(基于jdk17)

不需要安装到服务器,运维本地安装就行,主要是用来编译前端代码的。构建完成后将dist文件夹复制到服务器内。

程序员诚哥 6373

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

【收藏必备】大模型RAG检索增强:从入门到实战,解决知识过时与幻觉问题的完整指南

RAG(检索增强生成)是解决大模型知识过时和幻觉问题的关键技术,通过结合外部知识库确保输出基于真实信息。本文详细介绍了RAG的基本流程、多轮对话优化策略及全链路优化方法,涵盖文档准备、解析切片、向量化存储、检索召回和答案生成等环节,并通过企业HR问答系统案例展示了实际应用。

2401_85325726的博客 1217

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

【收藏必备】RAG检索优化实践:混合检索与重排序解决检索失效问题

本文分析了RAG应用中检索失效的两大问题:专有名词匹配失败和语义漂移。提出解决方案为混合检索(结合向量检索和BM25关键词检索)与重排序技术。混合检索通过RRF算法融合两种检索结果提高召回率,重排序使用Cross-Encoder模型对候选文档精确评分提升精度。这种"粗排+精排"的分层架构在不同领域均有重要应用价值,是构建高精度RAG系统的基石。

2401_85325726的博客 1172

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【收藏必备】一文搞懂RAG技术栈:大模型应用开发者的实战宝典

本文全面介绍了RAG技术在大模型应用开发中的重要性,详细解析了RAG的概念、核心组件、技术栈和工作流程,包括数据处理、向量工程、检索策略、生成增强及系统集成等层面的工具选型和实现方法,为开发者提供了构建高质量RAG系统的完整指南,帮助读者掌握大模型应用开发的核心技能。

2401_85154887的博客 981

程序员必备:一文搞懂RAG检索增强生成,收藏级大模型应用指南

RAG(检索增强生成)技术通过外部文档分片、向量化存储、相似度检索和重排筛选,使大模型能够查阅外部知识库并生成准确回答。该技术解决了大模型知识局限问题,让模型能够像人类一样先查找信息再回答问题,广泛应用于企业文档处理、知识库问答等场景,是提升大模型应用能力的重要技术。

2401_85375186的博客 692

【收藏必备】大模型RAG技术全攻略:从基础到高级优化,一文掌握检索增强生成

文章全面介绍检索增强生成(RAG)技术,涵盖基本流程(文档解析、向量化存储、检索生成)、多轮对话优化及各环节改进策略。通过企业HR问答系统案例展示实践应用,强调RAG能解决大模型知识过时和幻觉问题,使模型基于真实信息输出答案。提供从入门到进阶的大模型学习资料,适合小白和程序员系统掌握这一关键技术。

2401_85325726的博客 814

RAG技术深度解析:解决召回质量问题的关键优化方案,程序员必备收藏

文章深入探讨RAG技术在企业应用中的挑战与优化方案,强调其本质是快速准确召回文档,难点主要在文档处理和数据召回两阶段。文档处理面临复杂格式、多模态数据处理等挑战;数据召回存在无法召回有效数据或召回不相关数据的问题;增强生成阶段需对召回数据进行清洗和格式化。随着智能体技术发展,RAG系统正获得动态获取外部数据的能力,提升整体应用效果。

Android_XG的博客 889

【收藏必备】深入浅出RAG技术:大模型时代检索增强生成的完整指南

文件类型和版面的持续优化:这是一个长期需要优化的过程,话繁多样的文件格式,每种格式存在不同的版面,该部分存在版面识别算力资源和效率之间的trade-off,使用诸如PP-DocLayoutV2+PaddleOCR的方式可以对文件很好的做拆分然后单独识别,但是面对线上每日成千上万的文档这样的资源耗费量是巨大的;

kaka0722ww的博客 963

大模型开发必备技能!RAG召回策略全解析(建议收藏)

RAG技术的核心评判标准是召回精度,召回策略主要分为左侧增强(文档处理)和右侧增强(召回策略)。本文重点介绍了右侧增强的五种召回策略:意图识别、问题分解、假设性文档召回(HyDE)、上下文召回和重排序。这些策略能显著提升RAG系统的召回准确率,但需注意控制响应时间和模型输出长度。文章最后提供了大模型学习路径和资料,适合不同背景的学习者。

Android_XG的博客 711

什么是向量数据库(Vector Database)?收藏版|大模型入门必学

Embedding是对原始数据(文本、图像、音频、视频)等非结构化数据通过编码模型生成向量的密集数值表示,并且可以量化类别之间的相似性。简而言之,就是非结构化数据转换成向量的过程。Embedding的作用:通过深度学习训练,将真实世界的离散数据,投影到高维数据空间,通过数据在空间中的距离体现真实世界的相似度。向量数据是由多个数值组成的序列,可以表示一个数据量的大小和方向。

m0_48891301的博客 1918

【必学干货】RAG检索增强生成:大模型应用入门与实战指南,程序员必收藏

RAG是一个强大的功能,能够提高语义搜索效率。它让大语言模型(LLM)在回答问题前,先从外部知识库中检索相关信息,再基于检索结果生成更准确、可靠的回答。主要解决了知识时效性、 幻觉问题、 专业领域知识、可解释性问题。覆盖了智能客服、 企业知识库、 法律咨询、医疗辅助、AI搜索引擎等多种典型应用场景。

python12345_的博客 1129

什么是RAG技术,大模型入门到精通,收藏这篇就足够了!

RAG(Retrieval Augmented Generation,检索增强生成)是一种结合了信息检索和生成式模型的技术,简单来说,就是能够让大模型在计算时,结合外部知识库中的相关信息,使生成的答案更加精准

瓦罗兰特顶级C位的博客 1663
上一篇: 大模型技术全解析:预训练、微调与提示学习,一篇收藏就够了
下一篇: 收藏级干货!AI Agent开发技术深度解析与实战指南
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值