


作者: 张家星
邮箱: zhangjx@stu.zuel.edu.cn
本推文提供:
- 批量抓取
NBER工作论文信息的Python代码 - 获得正确代码的
ChatGPT Prompt过程 - 本文适用于完全不会
爬虫的新手- 无需下载
Python - 手动更改
0行代码 云端迅速得到结果
- 无需下载
- 抛砖引玉,欢迎讨论!
【本文内容较多,可以参照目录选择性阅读】
目录:
- \1. 目的
- \2. 工具
- 2.1 ChatGPT
- 2.2 Google Colab
- 2.3 GPT+Colab
- \3. 代码
- 3.1完整代码
- 3.2代码详解
- \4. Prompt 全过程
- 写在后面
1. 目的
NBER Working Paper是由美国国家经济研究局(NBER)发布的一系列学术论文,旨在分享和讨论经济学领域中的前沿研究成果。
本篇推文的目的是【批量抓取NBER工作论文中的题目、作者、摘要等信息】
未来有待完善之处:
- 通过调用
开源大模型,抓取后直接翻译为中文,并形成markdown格式文件,方便形成公众号推文。 - 同时下载好
pdf格式的论文 - 只下载本周
最新的论文 - 进一步研究
Google Colab平台
2. 工具
2.1 ChatGPT
前段时间是 ChatGPT 发布两周年,相信大家对它已经十分熟悉,因此这里不再赘述。
2.2 Google Colab
Google Colab(全称 Google Colaboratory)是由 Google 提供的一种基于云端的 Jupyter Notebook 环境,允许用户编写和执行 Python 代码。
Colab 提供免费的计算资源(包括 GPU 和 TPU),使得数据科学、机器学习和深度学习等计算密集型任务更加容易进行。它支持直接从 Google Drive 导入和存储文件,方便用户管理数据。
Colab 主要特点包括:
- 无需配置环境:用户可以直接在浏览器中使用,免去安装和配置的烦恼。
- 免费的计算资源:提供 GPU 和 TPU 支持,适合需要高性能计算的项目。
- 云端存储与共享:与 Google Drive 集成,支持文档和项目的轻松共享和协作。
- 支持 Python 和常见库:内置了大量 Python 库,特别适合数据分析、机器学习等任务。
- 代码执行与可视化:支持实时执行代码,并将结果以图形、表格等形式直观展示。
2.3 GPT+Colab
本文通过在 ChatGPT 中提问获取爬虫代码,并将其复制到 Colab 中执行。
实际上谷歌浏览器有个ChatGPT for Google Colab插件,感兴趣的可以下载尝试。
3. 代码
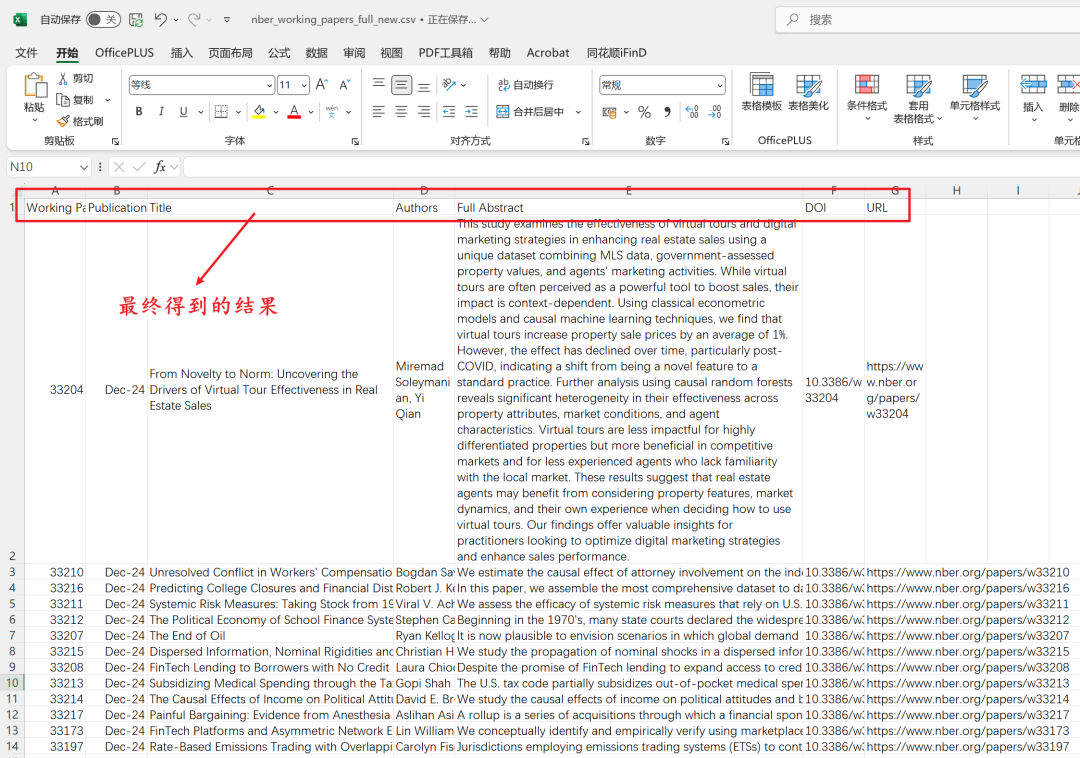
先看一下最终得到的文件,4S下载了50篇论文的信息。
3.1完整代码
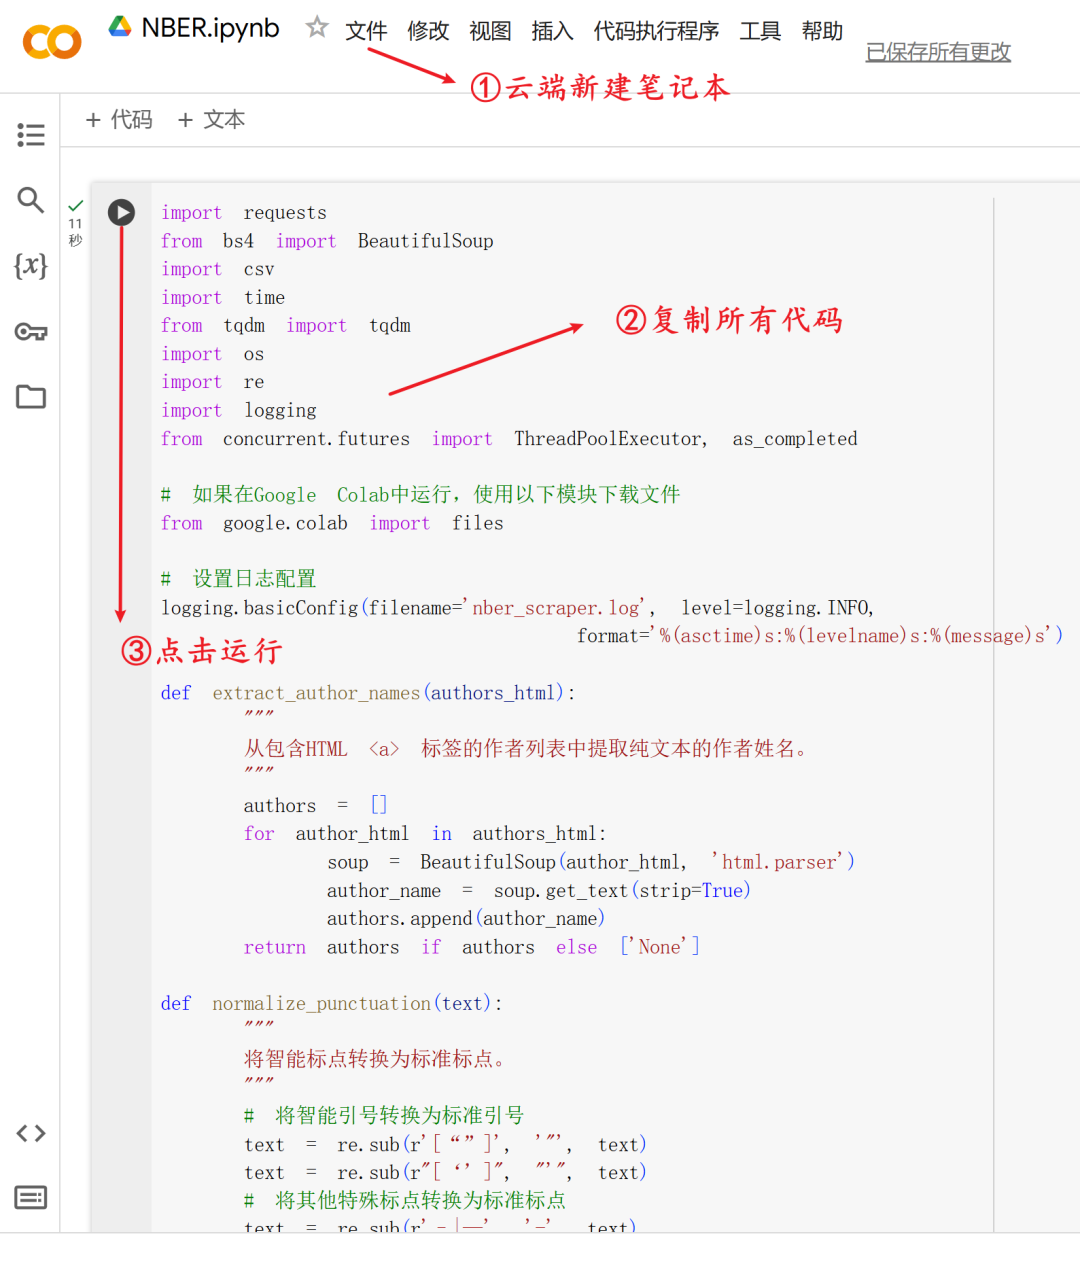
无需配置本地 Python 环境,直接将下面的代码,复制到 Google Colab 的笔记本中,运行代码即可。(截至2024年12月4日13:28:06,亲测可用)
如果想要理解代码逻辑,请看3.2代码详解
# python

import requests
from bs4 import BeautifulSoup
import csv
import time
from tqdm import tqdm
import os
import re
import logging
from concurrent.futures import ThreadPoolExecutor, as_completed

# 如果在Google Colab中运行,使用以下模块下载文件
from google.colab import files

# 设置日志配置
logging.basicConfig(filename='nber_scraper.log', level=logging.INFO,
                    format='%(asctime)s:%(levelname)s:%(message)s')

def extract_author_names(authors_html):
    """
    从包含HTML <a> 标签的作者列表中提取纯文本的作者姓名。
    """
    authors = []
    for author_html in authors_html:
        soup = BeautifulSoup(author_html, 'html.parser')
        author_name = soup.get_text(strip=True)
        authors.append(author_name)
    return authors if authors else ['None']

def normalize_punctuation(text):
    """
    将智能标点转换为标准标点。
    """
    # 将智能引号转换为标准引号
    text = re.sub(r'[“”]', '"', text)
    text = re.sub(r"[‘’]", "'", text)
    # 将其他特殊标点转换为标准标点
    text = re.sub(r'–|—', '-', text)
    # 处理其他可能的乱码字符,如"鈥"
    text = text.replace('鈥', '"').replace('鈥', '"').replace('鈥', '"')  # 根据需要添加更多替换规则
    return text

def fetch_nber_working_papers(page=1, per_page=50, sort_by='public_date'):
    """
    从NBER API获取工作论文,并提取标题、作者、发布日期、URL。
    """
    api_url = 'https://www.nber.org/api/v1/working_page_listing/contentType/working_paper/_/_/search'
    params = {
        'page': page,
        'perPage': per_page,
        'sortBy': sort_by
    }

    response = requests.get(api_url, params=params)

    if response.status_code == 200:
        data = response.json()
        papers = data.get('results', [])

        extracted_papers = []

        for paper in papers:
            title = paper.get('title', 'No Title')

            # 提取作者姓名
            authors_html = paper.get('authors', [])
            authors = extract_author_names(authors_html)

            # 使用 displaydate 作为发布日期
            display_date = paper.get('displaydate', 'None')

            # 构建完整的论文URL
            paper_url = f"https://www.nber.org{paper.get('url', '')}"

            extracted_papers.append({
                'title': title,
                'authors': authors,
                'publication_date': display_date,
                'url': paper_url
            })

        return extracted_papers
    else:
        logging.error(f"请求失败,状态码: {response.status_code}")
        return []

def fetch_full_details(paper_url):
    """
    使用requests和BeautifulSoup提取摘要、Working Paper编号和DOI。
    """
    try:
        headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko)\
             Chrome/91.0.4472.124 Safari/537.36'
        }
        response = requests.get(paper_url, headers=headers, timeout=10)
        if response.status_code == 200:
            soup = BeautifulSoup(response.text, 'html.parser')

            # 定位摘要所在的div
            intro_div = soup.find('div', class_='page-header__intro-inner')
            abstract = 'None'
            if intro_div:
                abstract_p = intro_div.find('p')
                if abstract_p:
                    abstract = abstract_p.get_text(separator=' ', strip=True)
                    abstract = normalize_punctuation(abstract)

            # 定位citation信息
            citation_div = soup.find('div', class_='page-header__citation-info')
            working_paper_number = 'None'
            doi = 'None'
            if citation_div:
                citation_items = citation_div.find_all('div', class_='page-header__citation-item')
                for item in citation_items:
                    label = item.find('span', class_='page-header__citation-item-label')
                    if label:
                        label_text = label.get_text(strip=True)
                        if label_text == 'Working Paper':
                            working_paper_number = item.get_text(strip=True).replace('Working Paper', '').strip()
                        elif label_text == 'DOI':
                            doi = item.get_text(strip=True).replace('DOI', '').strip()

            logging.info(f"成功获取论文详细信息: {paper_url}")
            return {
                'abstract': abstract,
                'working_paper_number': working_paper_number,
                'doi': doi
            }

        else:
            logging.error(f"无法访问论文页面,状态码: {response.status_code},URL: {paper_url}")
            return {'abstract': 'None', 'working_paper_number': 'None', 'doi': 'None'}
    except Exception as e:
        logging.error(f"在获取详细信息时发生错误: {e},URL: {paper_url}")
        return {'abstract': 'None', 'working_paper_number': 'None', 'doi': 'None'}

def fetch_all_details_concurrently(papers):
    """
    使用多线程并发获取所有论文的详细信息。
    """
    with ThreadPoolExecutor(max_workers=10) as executor:
        futures = {executor.submit(fetch_full_details, paper['url']): paper for paper in papers}
        for future in tqdm(as_completed(futures), total=len(futures), desc="并发获取详细信息"):
            paper = futures[future]
            try:
                details = future.result()
                paper['abstract'] = details['abstract']
                paper['working_paper_number'] = details['working_paper_number']
                paper['doi'] = details['doi']
            except Exception as e:
                logging.error(f"在获取论文详细信息时出错: {e},URL: {paper['url']}")
                paper['abstract'] = 'None'
                paper['working_paper_number'] = 'None'
                paper['doi'] = 'None'

def save_to_csv(papers, filename='nber_working_papers_full.csv'):
    """
    将提取的论文信息保存到CSV文件中,并在Google Colab中下载。
    """
    # 定义CSV列的顺序
    fieldnames = ['Working Paper Number', 'Publication Date', 'Title', 'Authors', 'Full Abstract', 'DOI', 'URL']

    # 定义保存路径为 /content 目录(Google Colab环境)
    save_path = os.path.join('/content', filename)

    print(f"准备保存 {len(papers)} 篇论文到 CSV 文件: {save_path}")

    with open(save_path, mode='w', encoding='utf-8-sig', newline='') as file:
        writer = csv.DictWriter(file, fieldnames=fieldnames)
        writer.writeheader()
        for paper in papers:
            writer.writerow({
                'Working Paper Number': paper.get('working_paper_number', 'None'),
                'Publication Date': paper['publication_date'],
                'Title': paper['title'],
                'Authors': ', '.join(paper['authors']),
                'Full Abstract': paper.get('abstract', 'None'),
                'DOI': paper.get('doi', 'None'),
                'URL': paper['url']
            })
            # 可选:打印已保存的论文标题
            print(f"已保存论文: {paper['title']}")

    print(f"数据已保存到 {save_path}")

    # 在Google Colab中下载文件
    try:
        files.download(save_path)
        print(f"文件 {filename} 已下载到本地。")
    except Exception as e:
        print(f"下载文件时出错: {e}")

def main():
    # 打印当前工作目录
    print(f"当前工作目录: {os.getcwd()}")

    # 设置要获取的页数和每页的论文数量
    total_pages = 1  # 示例:获取第一页
    per_page = 50

    all_papers = []

    for page in range(1, total_pages + 1):
        print(f"获取第 {page} 页的论文信息...")
        papers = fetch_nber_working_papers(page=page, per_page=per_page, sort_by='public_date')
        all_papers.extend(papers)
        time.sleep(1)  # 为了避免过于频繁的请求,暂停1秒

    print(f"共获取到 {len(all_papers)} 篇论文的信息。")

    # 使用多线程并发获取详细信息
    print("开始并发获取每篇论文的详细信息...")
    fetch_all_details_concurrently(all_papers)

    # 保存到CSV文件并下载
    save_to_csv(all_papers)

if __name__ == "__main__":
    main()
3.2代码详解
本节根据ChatGPT o1-preview 的回答,提供全部代码解释。
1. 导入必要的模块
# python
import requests
from bs4 import BeautifulSoup
import csv
import time
from tqdm import tqdm
import os
import re
import logging
from concurrent.futures import ThreadPoolExecutor, as_completed  # 修改导入语句

# 如果在Google Colab中运行,使用以下模块下载文件
from google.colab import files
模块解释:
requests:用于发送HTTP请求,从NBER API和论文网页获取数据。BeautifulSoup (bs4):用于解析HTML内容,从网页中提取所需的信息。csv:用于将提取的数据写入CSV文件。time:用于控制请求之间的延时,防止过于频繁的请求。tqdm:用于显示进度条,跟踪长时间运行的操作的进度。os:用于处理文件路径和操作系统相关的功能。re:用于正则表达式操作,处理文本中的特殊字符。logging:用于记录脚本运行过程中的信息、错误和警告,便于调试和维护。concurrent.futures.ThreadPoolExecutor, as_completed:用于实现多线程并发请求,提高数据抓取的效率。google.colab.files:专门用于在Google Colab环境中下载生成的文件到本地计算机。
2. 设置日志配置
# 设置日志配置
logging.basicConfig(filename='nber_scraper.log', level=logging.INFO,
                    format='%(asctime)s:%(levelname)s:%(message)s')
**目的:**记录脚本运行过程中发生的事件和错误,便于后续分析和调试。
logging.basicConfig:配置日志记录的基本设置。filename='nber_scraper.log':将日志信息写入名为nber_scraper.log的文件中。level=logging.INFO:设置日志级别为INFO,记录INFO及以上级别的信息(如WARNING、ERROR等)。format='%(asctime)s:%(levelname)s:%(message)s':定义日志信息的格式,包括时间戳、日志级别和消息内容。
3. 定义函数:extract_author_names
def extract_author_names(authors_html):
    """
    从包含HTML <a> 标签的作者列表中提取纯文本的作者姓名。
    """
    authors = []
    for author_html in authors_html:
        soup = BeautifulSoup(author_html, 'html.parser')
        author_name = soup.get_text(strip=True)
        authors.append(author_name)
    return authors if authors else ['None']
目的:将HTML格式的作者信息转换为纯文本,便于后续处理和保存。
- 输入参数:
authors_html,包含多个HTML 标签的作者信息。 - 遍历每个作者的HTML片段。
- 使用BeautifulSoup解析HTML,提取纯文本的作者姓名。
- 将提取的作者姓名添加到authors列表中。
- 返回值:返回包含所有作者姓名的列表;如果没有作者信息,则返回[‘None’]。
4. 定义函数:normalize_punctuation
def normalize_punctuation(text):
    """
    将智能标点转换为标准标点。
    """
    # 将智能引号转换为标准引号
    text = re.sub(r'[“”]', '"', text)
    text = re.sub(r"[‘’]", "'", text)
    # 将其他特殊标点转换为标准标点
    text = re.sub(r'–|—', '-', text)
    # 处理其他可能的乱码字符,如"鈥"
    text = text.replace('鈥', '"').replace('鈥', '"').replace('鈥', '"')  # 根据需要添加更多替换规则
    return text
目的: 确保文本中的标点符号统一,避免在保存到CSV或显示时出现乱码问题。
- 输入参数:
text,包含可能的智能标点或乱码字符的文本。
5. 定义函数:fetch_nber_working_papers
def fetch_nber_working_papers(page=1, per_page=50, sort_by='public_date'):
    """
    从NBER API获取工作论文,并提取标题、作者、发布日期、URL。
    """
    api_url = 'https://www.nber.org/api/v1/working_page_listing/contentType/working_paper/_/_/search'
    params = {
        'page': page,
        'perPage': per_page,
        'sortBy': sort_by
    }

    response = requests.get(api_url, params=params)

    if response.status_code == 200:
        data = response.json()
        papers = data.get('results', [])

        extracted_papers = []

        for paper in papers:
            title = paper.get('title', 'No Title')

            # 提取作者姓名
            authors_html = paper.get('authors', [])
            authors = extract_author_names(authors_html)

            # 使用 displaydate 作为发布日期
            display_date = paper.get('displaydate', 'None')

            # 构建完整的论文URL
            paper_url = f"https://www.nber.org{paper.get('url', '')}"

            extracted_papers.append({
                'title': title,
                'authors': authors,
                'publication_date': display_date,
                'url': paper_url
            })

        return extracted_papers
    else:
        logging.error(f"请求失败,状态码: {response.status_code}")
        return []
目的: 通过NBER的API获取工作论文的基本信息,为后续提取更详细的信息(如摘要、DOI等)做准备。
- 输入参数:
page:要获取的页面编号,默认为1。per_page:每页显示的论文数量,默认为50。sort_by:排序方式,默认为按public_date(发布日期)排序。
- 构建API请求:
api_url:NBER API的URL,用于获取工作论文列表。params:请求参数,包括页面编号、每页数量和排序方式。
- 发送HTTP GET请求:
- 使用
requests.get发送请求,传递URL和参数。
- 使用
- 处理响应:
- 如果响应状态码为200(成功),则解析JSON响应。
- 从JSON数据中提取results,即论文列表。
- 提取所需信息:
- 遍历每篇论文,提取标题、作者、发布日期和URL。
- 使用
extract_author_names函数提取作者姓名。 - 构建完整的论文URL(因为API返回的URL可能是相对路径)。
- 将提取的信息添加到
extracted_papers列表中。
- 返回结果:
- 返回包含所有提取论文信息的列表。
- 如果请求失败,记录错误并返回空列表。
6. 定义函数:fetch_full_details
def fetch_full_details(paper_url):
    """
    使用requests和BeautifulSoup提取摘要、Working Paper编号和DOI。
    """
    try:
        headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko)\
             Chrome/91.0.4472.124 Safari/537.36'
        }
        response = requests.get(paper_url, headers=headers, timeout=10)
        if response.status_code == 200:
            soup = BeautifulSoup(response.text, 'html.parser')

            # 定位摘要所在的div
            intro_div = soup.find('div', class_='page-header__intro-inner')
            abstract = 'None'
            if intro_div:
                abstract_p = intro_div.find('p')
                if abstract_p:
                    abstract = abstract_p.get_text(separator=' ', strip=True)
                    abstract = normalize_punctuation(abstract)

            # 定位citation信息
            citation_div = soup.find('div', class_='page-header__citation-info')
            working_paper_number = 'None'
            doi = 'None'
            if citation_div:
                citation_items = citation_div.find_all('div', class_='page-header__citation-item')
                for item in citation_items:
                    label = item.find('span', class_='page-header__citation-item-label')
                    if label:
                        label_text = label.get_text(strip=True)
                        if label_text == 'Working Paper':
                            working_paper_number = item.get_text(strip=True).replace('Working Paper', '').strip()
                        elif label_text == 'DOI':
                            doi = item.get_text(strip=True).replace('DOI', '').strip()

            logging.info(f"成功获取论文详细信息: {paper_url}")
            return {
                'abstract': abstract,
                'working_paper_number': working_paper_number,
                'doi': doi
            }

        else:
            logging.error(f"无法访问论文页面,状态码: {response.status_code},URL: {paper_url}")
            return {'abstract': 'None', 'working_paper_number': 'None', 'doi': 'None'}
    except Exception as e:
        logging.error(f"在获取详细信息时发生错误: {e},URL: {paper_url}")
        return {'abstract': 'None', 'working_paper_number': 'None', 'doi': 'None'}
目的: 从每篇论文的详细页面中提取更具体的信息(摘要、工作论文编号、DOI),补充之前通过API获取的基本信息
-
输入参数:paper_url,单篇论文的详细页面URL。
-
功能:
-
发送HTTP GET请求:
- 使用
requests.get发送请求,附带自定义的User-Agent头,以模拟真实的浏览器请求,避免被网站拒绝。 - 设置timeout=10,即请求超时时间为10秒,防止长时间等待。
- 使用
-
处理响应:
- 如果响应状态码为200(成功),则解析HTML内容。
-
提取摘要:
- 使用
BeautifulSoup查找包含摘要的``,其类名为page-header__intro-inner。 - 在该
内找到标签,提取文本内容。 - 使用
normalize_punctuation函数标准化标点符号,避免乱码。
- 使用
-
提取工作论文编号和DOI:
-
Working Paper:提取工作论文编号。
-
DOI:提取DOI号。
-
查找包含引用信息的``,类名为
page-header__citation-info。 -
在该
内找到所有子,类名为page-header__citation-item。 -
遍历每个子
,根据标签(的文本)确定提取内容:
-
-
记录日志:
- 成功提取后,记录成功信息。
- 如果请求失败或解析错误,记录错误信息。
-
返回结果:
- 返回包含摘要、工作论文编号和DOI的字典。
- 如果提取失败,返回默认值’None’。
7. 定义函数:fetch_all_details_concurrently
def fetch_all_details_concurrently(papers):
    """
    使用多线程并发获取所有论文的详细信息。
    """
    with ThreadPoolExecutor(max_workers=10) as executor:
        futures = {executor.submit(fetch_full_details, paper['url']): paper for paper in papers}
        for future in tqdm(as_completed(futures), total=len(futures), desc="并发获取详细信息"):
            paper = futures[future]
            try:
                details = future.result()
                paper['abstract'] = details['abstract']
                paper['working_paper_number'] = details['working_paper_number']
                paper['doi'] = details['doi']
            except Exception as e:
                logging.error(f"在获取论文详细信息时出错: {e},URL: {paper['url']}")
                paper['abstract'] = 'None'
                paper['working_paper_number'] = 'None'
                paper['doi'] = 'None'
目的: 并发地提取所有论文的详细信息,显著提升抓取效率。
- 输入参数:
papers,包含基本信息的论文列表,每篇论文是一个字典,包含标题、作者、发布日期和URL。 - 功能:
- 创建线程池:
- 使用
ThreadPoolExecutor创建一个包含10个线程的线程池,max_workers=10。 - 原因:多线程允许同时发送多个HTTP请求,提高数据抓取的效率,显著减少总运行时间。
- 使用
- 提交任务:
- 遍历每篇论文,使用
executor.submit提交fetch_full_details函数的任务,传入论文的URL。 - 创建一个字典
futures,键为未来(future)对象,值为对应的论文字典。
- 遍历每篇论文,使用
- 处理完成的任务:
- 使用
tqdm和as_completed函数,遍历已完成的未来对象,显示进度条。 - 对于每个已完成的任务:
- 获取对应的论文字典。
- 调用
future.result()获取提取的详细信息。 - 更新论文字典,添加摘要、工作论文编号和DOI。
- 错误处理:如果在获取详细信息时发生异常,记录错误并将相关字段设为
None。
- 使用
8. 定义函数:save_to_csv
def save_to_csv(papers, filename='nber_working_papers_full.csv'):
    """
    将提取的论文信息保存到CSV文件中,并在Google Colab中下载。
    """
    # 定义CSV列的顺序
    fieldnames = ['Working Paper Number', 'Publication Date', 'Title', 'Authors', 'Full Abstract', 'DOI', 'URL']

    # 定义保存路径为 /content 目录(Google Colab环境)
    save_path = os.path.join('/content', filename)

    print(f"准备保存 {len(papers)} 篇论文到 CSV 文件: {save_path}")

    with open(save_path, mode='w', encoding='utf-8-sig', newline='') as file:
        writer = csv.DictWriter(file, fieldnames=fieldnames)
        writer.writeheader()
        for paper in papers:
            writer.writerow({
                'Working Paper Number': paper.get('working_paper_number', 'None'),
                'Publication Date': paper['publication_date'],
                'Title': paper['title'],
                'Authors': ', '.join(paper['authors']),
                'Full Abstract': paper.get('abstract', 'None'),
                'DOI': paper.get('doi', 'None'),
                'URL': paper['url']
            })
            # 可选:打印已保存的论文标题
            print(f"已保存论文: {paper['title']}")

    print(f"数据已保存到 {save_path}")

    # 在Google Colab中下载文件
    try:
        files.download(save_path)
        print(f"文件 {filename} 已下载到本地。")
    except Exception as e:
        print(f"下载文件时出错: {e}")
目的: 将所有提取的论文信息按照指定的列顺序保存到CSV文件中,并在Google Colab环境中自动下载该文件,便于后续分析和使用。
-
输入参数:
papers:包含所有论文信息的列表,每篇论文是一个字典。filename:保存的CSV文件名,默认为nber_working_papers_full.csv。
-
功能:
-
定义CSV列的顺序:
-
Working Paper Number -
Publication Date -
Title -
Authors -
Full Abstract -
DOI -
URL -
fieldnames列表按照用户指定的顺序排列:
-
-
构建保存路径:
- 使用
os.path.join将目录/content与文件名组合,形成完整的保存路径save_path。 - 注意:/content是Google Colab的默认工作目录。
- 使用
-
打开CSV文件:
- 使用open函数以写模式(
'w')打开文件,指定编码为utf-8-sig: utf-8-sig:在文件开头添加BOM(字节顺序标记),有助于某些软件(如Excel)正确识别UTF-8编码。newline='':避免在写入CSV时出现多余的空行。
- 使用open函数以写模式(
-
写入CSV文件:
-
使用
paper.get('field', 'None')获取字段值,如果字段不存在则使用None作为默认值。 -
', '.join(paper['authors']):将作者列表转换为以逗号分隔的字符串。 -
创建
csv.DictWriter对象,指定列名。 -
写入表头(header)。
-
遍历每篇论文,按照
fieldnames顺序写入数据: -
打印保存信息:每保存一篇论文,打印一条消息,显示已保存的论文标题。
-
-
下载CSV文件:
- 使用
google.colab.files.download方法在Google Colab中自动下载生成的CSV文件到本地计算机。 - 错误处理:如果下载过程中发生错误,打印错误信息。
- 使用
9. 定义函数:main
def main():
    # 打印当前工作目录
    print(f"当前工作目录: {os.getcwd()}")

    # 设置要获取的页数和每页的论文数量
    total_pages = 2  # 示例:获取第一页
    per_page = 50

    all_papers = []

    for page in range(1, total_pages + 1):
        print(f"获取第 {page} 页的论文信息...")
        papers = fetch_nber_working_papers(page=page, per_page=per_page, sort_by='public_date')
        all_papers.extend(papers)
        time.sleep(1)  # 为了避免过于频繁的请求,暂停1秒

    print(f"共获取到 {len(all_papers)} 篇论文的信息。")

    # 使用多线程并发获取详细信息
    print("开始并发获取每篇论文的详细信息...")
    fetch_all_details_concurrently(all_papers)

    # 保存到CSV文件并下载
    save_to_csv(all_papers)
目的:协调整个抓取流程,从获取基本信息到提取详细信息,再到保存和下载,确保流程高效、有序地完成。
-
打印当前工作目录:
- 使用
os.getcwd()获取并打印当前的工作目录路径。 - 目的:确认脚本的运行环境和文件保存位置。
- 使用
-
设置抓取参数:
total_pages = 2:设置要抓取的页数为2页(示例)。per_page = 50:每页抓取50篇论文。
-
抓取论文基本信息:
-
打印当前抓取的页数。
-
调用
fetch_nber_working_papers函数抓取当前页的论文信息。 -
将抓取到的论文信息添加到
all_papers列表中。 -
使用
time.sleep(1)暂停1秒,防止过于频繁的请求导致被目标网站封禁。 -
初始化空列表
all_papers,用于存储所有论文的信息。 -
使用
for循环遍历每一页:
-
-
打印抓取结果:
- 打印总共抓取到的论文数量。
-
并发获取详细信息:
- 打印开始并发获取详细信息的消息。
- 调用
fetch_all_details_concurrently函数,使用多线程并发地抓取每篇论文的详细信息(摘要、工作论文编号、DOI)。
-
保存并下载CSV文件:
- 调用
save_to_csv函数,将所有论文信息保存到CSV文件中,并在Google Colab中自动下载。
- 调用
10. 主程序入口
if __name__ == "__main__":
    main()
- 作用:
- 当脚本作为主程序运行时(而不是被导入为模块),执行main()函数。
- 这是Python中常见的惯用法,用于定义脚本的入口点,确保在直接运行脚本时执行特定的代码。
4. Prompt 全过程
授人以鱼,不如授人以渔。本节提供得到正确代码的全部 Prompt 过程,仅供参考。
Q1: 帮我爬取https://www.nber.org/papers?page=1&perPage=50&sortBy=public_date 这个网站里面所有文章的题目、作者、摘要等信息,并提供google colab 的代码
第一轮回复(ChatGPT 4o):您可以使用 Python 的 requests 库来获取网页内容,并使用 BeautifulSoup 解析 HTML。……
【我将提供的代码复制到 Google Colab 中,并未得到结果。】
Q2: 不好使呢
第二轮回复(ChatGPT 4o):抱歉,可能是因为页面的结构或者 JavaScript 渲染的问题。NBER 网站可能使用了 JavaScript 动态加载数据,而 requests 和 BeautifulSoup 只能解析静态页面,无法处理这些动态加载的内容。
一种有效的方式是使用 Selenium 来模拟浏览器行为,加载所有的 JavaScript 内容并抓取页面。这里是一个更新的示例,使用 Selenium 来爬取 NBER 网站上的文章信息。……
【但在几轮追问下,我仍然无法使用 Selenium 模拟浏览器抓取数据。】
值得注意的是,为了考验 ChatGPT 的能力,我并没有根据它提供的代码进行手动调整(实际是因为我根本不会),而是直接复制它提供的完整代码,在 Colab 中运行,看其能否提供想要的结果。
于是我选择最新的模型 ChatGPT o1-preview 进行追问。
Q3: https://www.nber.org/papers?page=1&perPage=50&sortBy=public_date 帮我把前5篇文章的题目、作者和摘要提取出来
第X轮回复(o1-preview): 思考持续5秒后,给我提供详细的步骤,包括安装必要的依赖项、配置Selenium并启动浏览器、编写爬虫代码以提取前5篇文章的信息等。
【但在几轮追问下,ChatGPT o1-preview 提供的代码仍然无法运行成功。】
或许是给它提供的信息有限?
Q4: 【此处为NBER的网站的源代码(右键查看网页源代码既可获得)】这是网页的源代码,应该如何爬取呢?
第X轮回复(o1-preview): 要爬取您提供的网页源代码中的数据,您需要了解网页内容是如何加载的。根据您提供的源代码,这个网页(NBER的“Working Papers”页面)可能使用动态加载的数据,例如通过API请求获取内容。这意味着直接从静态HTML中提取数据可能不够有效。因此,以下是一个系统化的步骤指南,帮助您有效地爬取所需的数据。
提供相关代码:步骤 1:了解网页结构和数据加载方式;步骤 2:检查API端点……
注意: 根据实际的API响应结构,您可能需要调整数据提取部分。
有些API端点可能需要身份验证或特定的请求头,请根据需要进行设置。
Q5: 示例:使用 requests 访问API,但是无法得到作者等。标题: FinTech Platforms and Asymmetric Network Effects: Theory and Evidence from Marketplace Lending 作者: None 发布日期: None
第X轮回复(o1-preview): 理解了,您在使用 requests 访问 API 时,虽然能够获取到论文标题,但无法获取到作者和发布日期。这个问题可能出在以下几个方面:
- API 响应结构:可能作者和发布日期信息位于 JSON 数据的嵌套字段中,您的代码未能正确解析。
- 请求参数:可能需要调整请求参数,以确保 API 返回完整的数据。
- 访问权限:某些字段可能需要特定的权限或认证才能访问
步骤 1:检查 API 响应结构(提供相关代码)……
import requests
import json

# 定义API端点
api_url = 'https://www.nber.org/api/v1/working_page_listing/contentType/working_paper/_/_/search'

# 定义请求参数(根据需要调整)
params = {
    'page': 1,
    'perPage': 50,
    'sortBy': 'public_date'
}

# 发送GET请求
response = requests.get(api_url, params=params)

# 检查响应状态
if response.status_code == 200:
    data = response.json()
    # 打印完整的JSON响应,便于检查结构
    print(json.dumps(data, indent=2, ensure_ascii=False))
else:
    print(f"请求失败,状态码: {response.status_code}")
【运行了上述代码后,我将返回的信息,再次发给o1-preview】
第X轮回复(o1-preview): 理解了,您在使用 requests 访问 API 时,虽然能够获取到论文标题,但作者和发布日期仍显示为 None。根据您提供的 JSON 数据,问题可能出在以下几个方面:
- 发布日期字段:publisheddate 字段为 null,而实际的发布日期信息存储在 displaydate 字段中。
- 作者字段的格式:authors 字段中的作者名称是包含在 HTML 标签中的字符串,直接提取可能导致解析错误或显示为 None。
对此:
- 使用 displaydate 字段代替 publisheddate 字段来获取发布日期。
- 解析 authors 字段中的 HTML 字符串,以提取纯文本的作者姓名。
以下是一个完整的 Python 示例,展示如何正确提取标题、作者和发布日期:……
【需要注意的是,在NBER的首页仅能看到文章的部分摘要,因此需要点击相应文章,跳转到新的页面,才能够得到全部摘要。】
于是乎……
Q6: 但是在这个页面中摘要是不完全的,需要单击相应的文章跳转到另外一个页面才可以
第X轮回复(o1-preview):
- 使用API获取基本信息:通过API获取工作论文的基本信息,包括标题、作者、显示日期和论文的URL。
- 访问每篇论文的单独页面:使用获取的URL访问每篇论文的详细页面。
- 解析详细页面获取完整摘要:从每个详细页面中提取完整的摘要。
- 数据存储:将提取的所有信息(标题、作者、发布日期、完整摘要、链接)保存到CSV或其他格式中。 ……
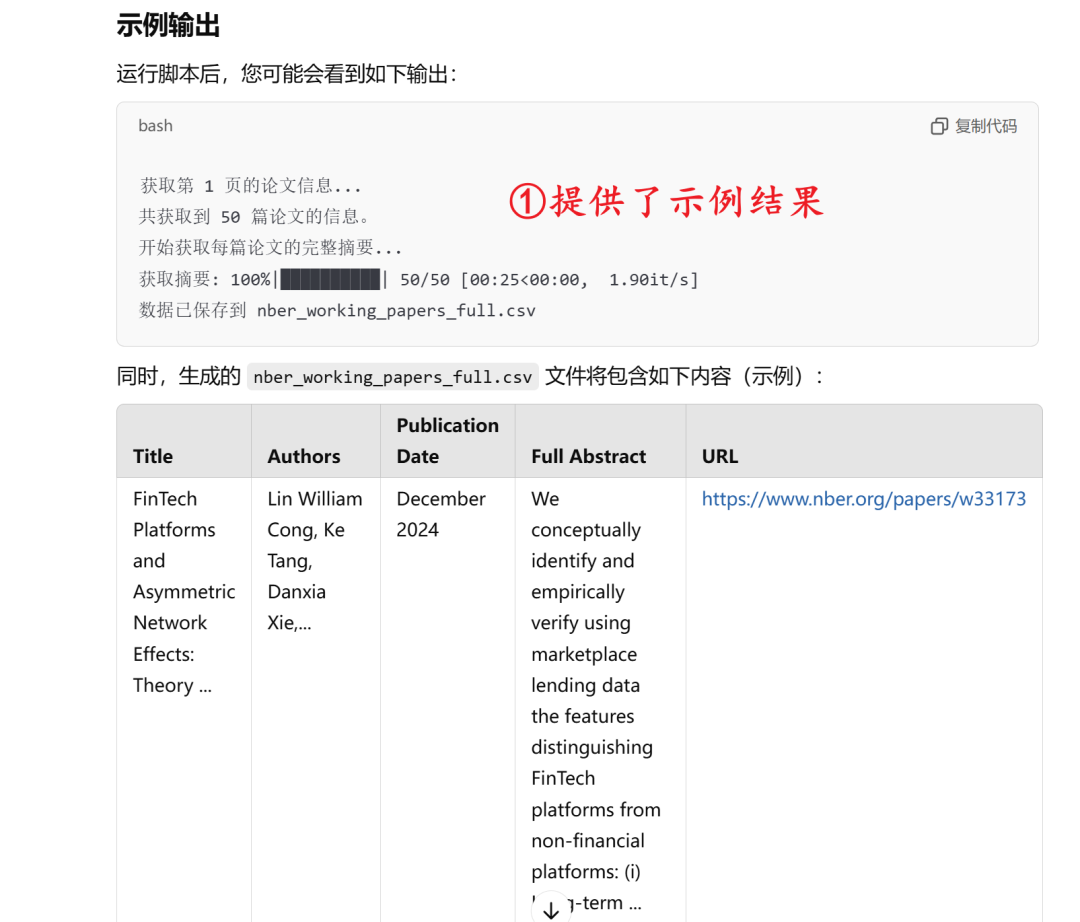
Q7: 我想把文件存在C:\Users\Admin\Desktop
【追问几轮后(需要将报错反馈给o1-preview),发现可以将文件下载到本地,但是抓取下来的摘要仍不是全部的。】
Q8: 摘要是需要点击对应文章的URL后,去提取摘要。这是点击其中一篇文章的url后得到的网页源代码【相应源代码】
第X轮回复(o1-preview): 给出了相应代码……
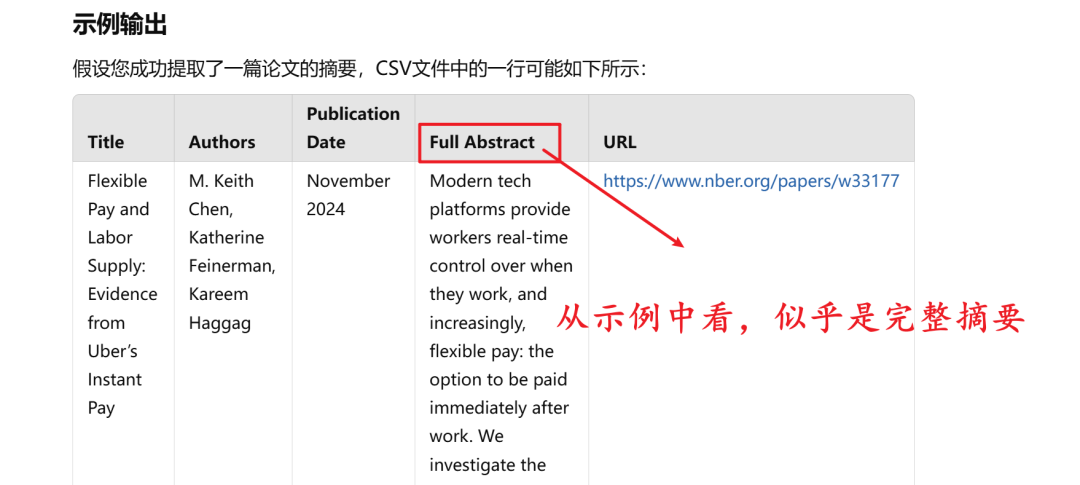
【复制到 Colab 中可以成功下载,但是会发现有些标点符号或者西文是乱码的。】
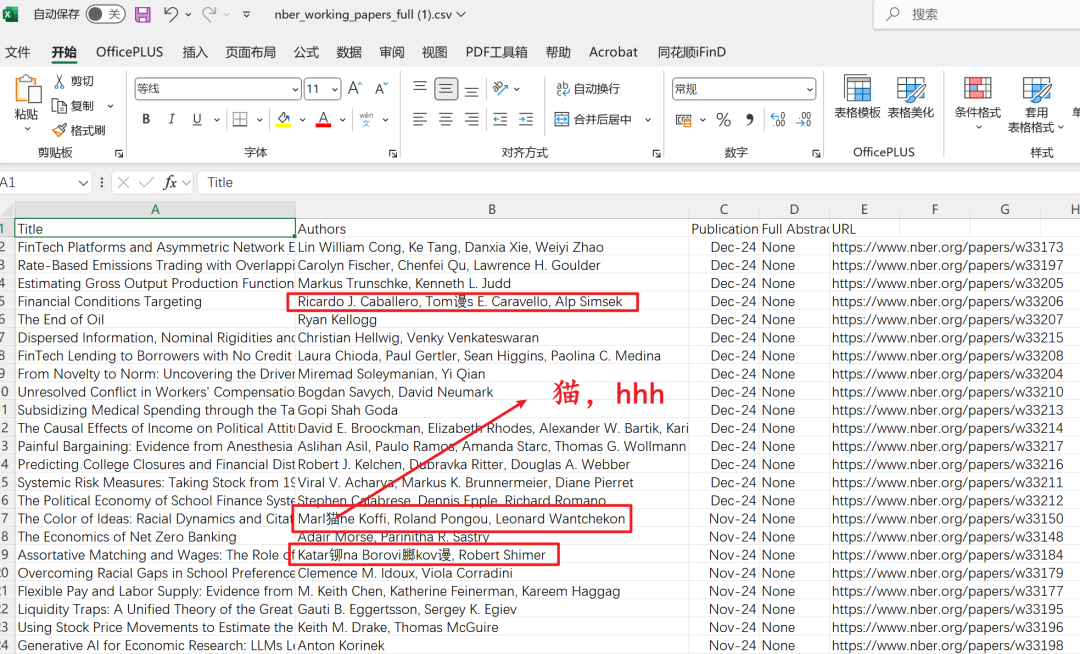
Q8: 我输出的文字中会有乱码,我看了下实际是一些标点符号
第X轮回复(o1-preview): 给出了相应代码……
【乱码问题解决,但人总是不满足的。】
Q9: 我还想要:Working Paper 33152 DOI 10.3386/w33152 这样的信息
第X轮回复(o1-preview): 给出了相应代码……
【成功得到想要的信息。】
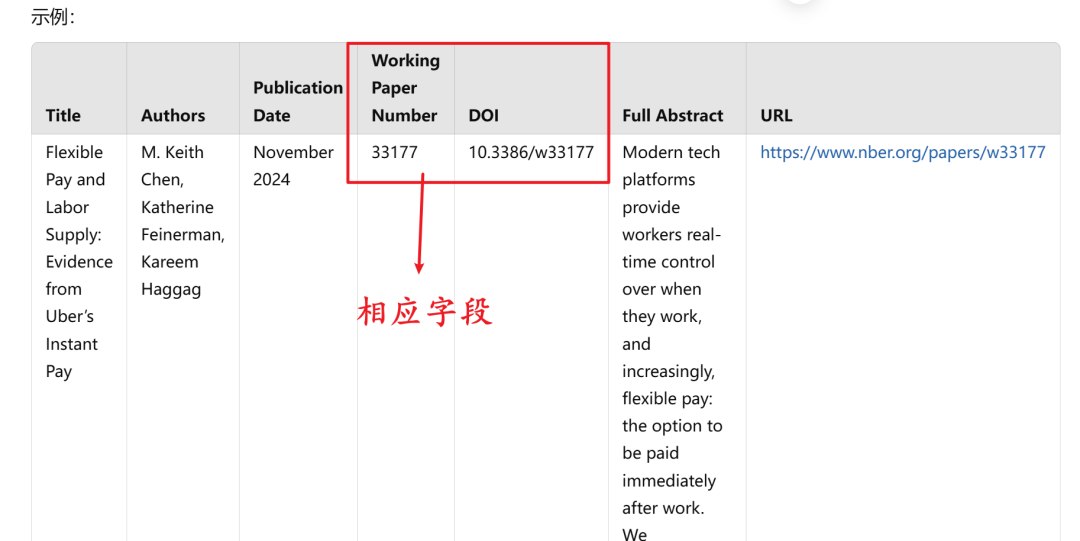
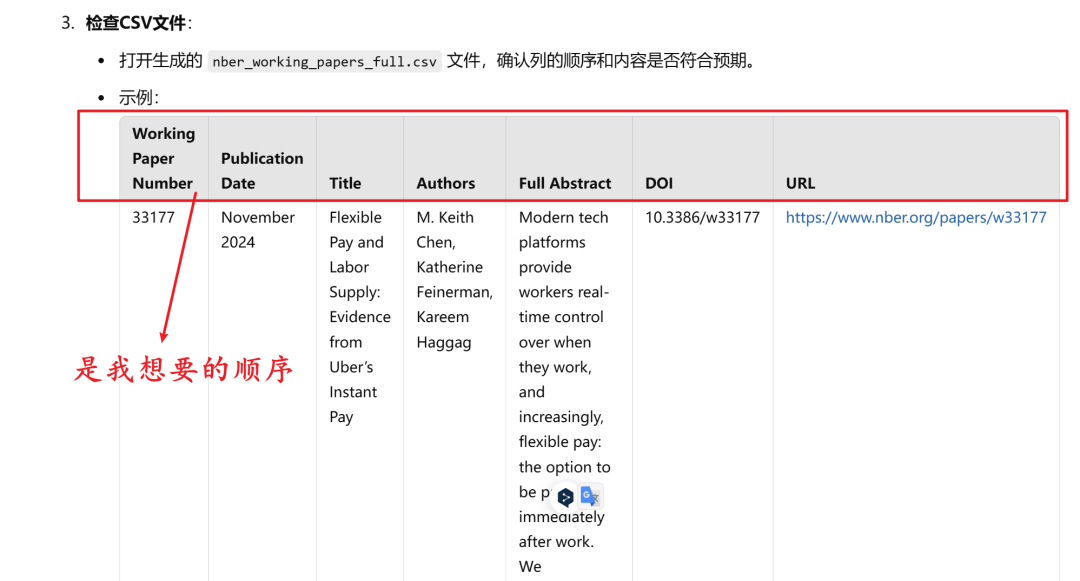
Q10: 我想按照 Working Paper Number、Publication Date、Title Authors Full Abstract DOI URL 的顺序
第X轮回复(o1-preview): 给出了相应代码……
【得到想要的字段排序。】
写在后面
NBER 可能并不是很难爬取的网站,但是 ChatGPT o1-preview 和 Google Colab 组合起来的威力,还是让我吃惊的。
我之前没有 Python 爬虫基础(甚至Pyhon的基础语法也不是很熟悉),仅是用 Stata 做过一点简单的爬虫。但是通过不断向 ChatGPT 提问,竟然得到了一个完全不用修改的代码。
Google Colab 提供的在线平台,大大省去了本地配置环境的时间。需要注意的是,Colab 提供的免费算力和储存空间是有限的。不过,一般的项目应该是足以应付的。
技术的壁垒正在大大降低,思想的重要性大大增加。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 3735


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


