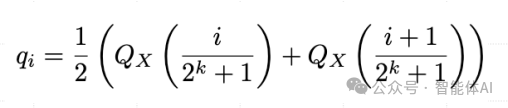从LoRA到QLoRA:量化技术如何改变预训练模型的微调方式

LLM参数高效微调(LORA,QLORA) 这个通路包含两个矩阵:( A )实现降维,而( B )完成升维,它们的乘积表达了模型的“本征秩”(intrinsic rank),即更新中保留的核心信息。此外,它也更容易过拟合,尤其是在小数据集上。QLoRA的创新之处在于它显著减少了内存的使用,使得可以在单个48GB的GPU上微调一个有650亿参数的模型,同时保持16比特微调的性能。因此,通过采用参数高效微调技术,如适配器、LoRA或提示微调,可以在保持预训练模型大部分权重不变的情况下,仅对一小部分参数进行微调,从而大大减少计算资源和训练时间的需求。 阅读详情

在现代人工智能的发展中,预训练语言模型(LLM)已成为各种自然语言处理任务中的关键技术。这些模型通常具有数十亿甚至数千亿的参数,因此需要巨大的计算和存储资源来进行微调。QLoRA提出了一种新方法,使得在单个48GB的GPU上微调具有65B参数的大模型成为可能,并且保持了16-bit微调任务的性能。本文将详细介绍QLoRA的方法及其带来的变革。

一、 FFT vs LoRA vs QLoRA

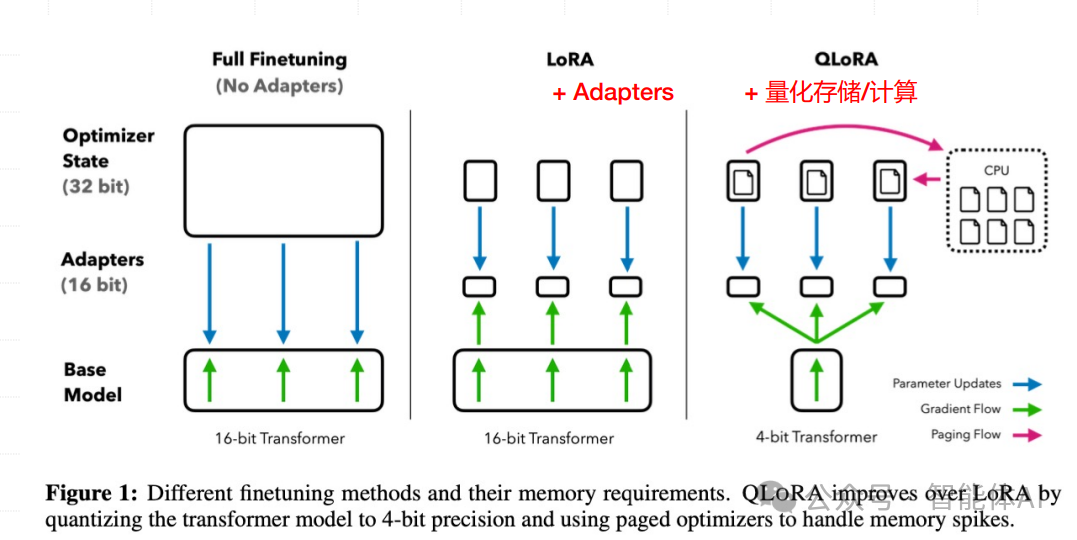
在讨论QLoRA之前,有必要了解全量微调(Full Fine-Tuning,FFT)和低秩适配器(Low-Rank Adaptation,LoRA)这两种现有的方法。
图片

1.1 全量微调(FFT)

全量微调是一种传统的方法,要求对预训练模型的所有参数进行更新。这意味着每次微调任务都需要大量的计算和存储资源。虽然这种方法可以在微调任务中达到最佳性能,但在处理大规模模型时,其资源消耗非常高。例如,微调一个具有数十亿参数的模型可能需要多个高性能GPU和大量的时间。

1.2 LoRA

LoRA提出了一种低秩适配器的方法,通过引入低秩矩阵来调整预训练模型的参数,从而减少需要更新的参数数量。这样做的好处是显著降低了计算和存储需求,使得在相对有限的硬件资源上也能进行有效的微调。然而,LoRA在某些情况下的性能可能不如全量微调,因为它只对部分参数进行了调整。

1.3 QLoRA

QLoRA在LoRA的基础上进一步优化,通过引入量化技术,使得在单个48GB GPU上微调65B参数模型成为可能。QLoRA通过冻结int4量化预训练语言模型,并将梯度反向传播到低秩适配器LoRA,实现了高效的微调。这种方法既保留了LoRA的低秩适配优势,又通过量化技术降低了计算和存储需求。
图片

二、 QLoRA 提出新数据类型 4-bit NormalFloat (NF4)

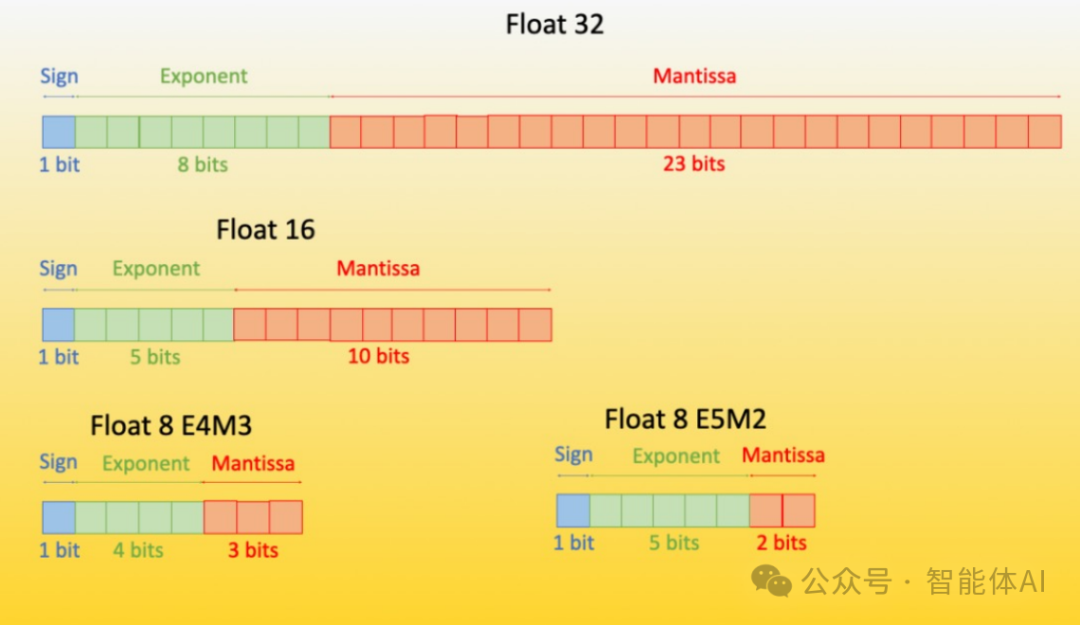
QLoRA的一个关键创新在于其量化技术,尤其是新提出的4-bit NormalFloat (NF4) 数据类型。

2.1 8-bit 量化和量化常数c

在传统的量化方法中,8-bit量化是一种常见的技术。它通过一个量化常数c将输入张量的值映射到8-bit的范围内,从而实现数据压缩。然而,8-bit量化在处理大规模模型时仍然需要大量的存储空间和计算资源。
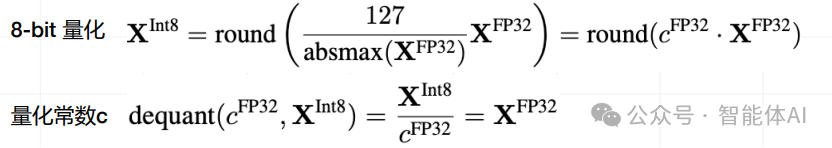
图片

2.2 NormalFloat (NF) 数据类型

NormalFloat (NF) 数据类型建立在分位数量化(Quantile Quantization)基础上。这是一种信息论最优的数据类型,能够确保每个量化区间中具有相同数量的值。分位数量化通过经验累积分布函数(ECDF)估计输入张量的分位数,虽然分位数估计过程较为昂贵,但快速分位数近似算法(如SRAM分位数)可以有效解决这一问题。

2.3 4-bit NormalFloat (NF4)

由于预训练神经网络的权重通常具有标准差为σ的零中心正态分布,通过缩放σ可以将所有权重转换为单个固定分布,使其符合NF4的数据范围。在QLoRA中,NF4的数据范围被设定为[-1, 1]。通过归一化,神经网络权重的分位数能够匹配这一范围,从而实现高效的量化。具体来说,NF4通过以下步骤实现:

  • 估计标准正态分布N(0,1)的分位数,得到正态分布的k位分位数量化数据类型。
  • 将这些分位数值归一化到[-1, 1]范围内。
  • 将输入权重张量归一化到[-1, 1]范围内进行量化。

图片

三、QLoRA 提出双量化技术:量化(量化常数)

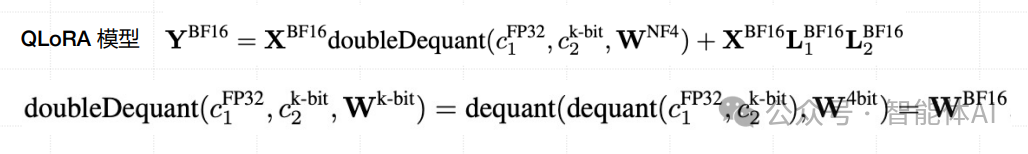
除了数据类型的创新,QLoRA还提出了双量化技术,这种技术设计了存储数据类型(4-bit NormalFloat)和计算数据类型(16-bit BrainFloat)。

3.1 双量化技术的应用

在QLoRA中,权重从存储数据类型(4-bit NormalFloat)反量化为计算数据类型(16-bit BrainFloat),以进行前向和后向传播。然而,只有16-bit BrainFloat的LoRA参数的权重梯度会被计算,这样一来,权重只有在需要时才会解压缩。这种方法在训练和推理期间保持了较低的内存使用率。
图片

3.2 优化内存使用

双量化技术的应用使得在单个GPU上进行大规模模型的微调成为可能,同时显著降低了内存使用率。这对于资源有限但需要处理大规模模型的应用场景来说,具有重要意义。通过这种方法,可以在有限的硬件资源上实现高效的模型微调和推理,极大地提高了计算资源的利用效率。

四、总结

QLoRA通过引入4-bit NormalFloat数据类型和双量化技术,成功在低资源条件下实现了大规模预训练模型的高效微调。这种方法不仅保留了LoRA的低秩适配优势,还进一步优化了内存使用和计算效率,为大规模模型的实际应用提供了新的可能性。未来,QLoRA有望在更多的自然语言处理任务中发挥重要作用,推动人工智能技术的进一步发展。

如何转行/入门AI产品经理?

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,转行/入门AI产品经理,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI产品经理入门手册、AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

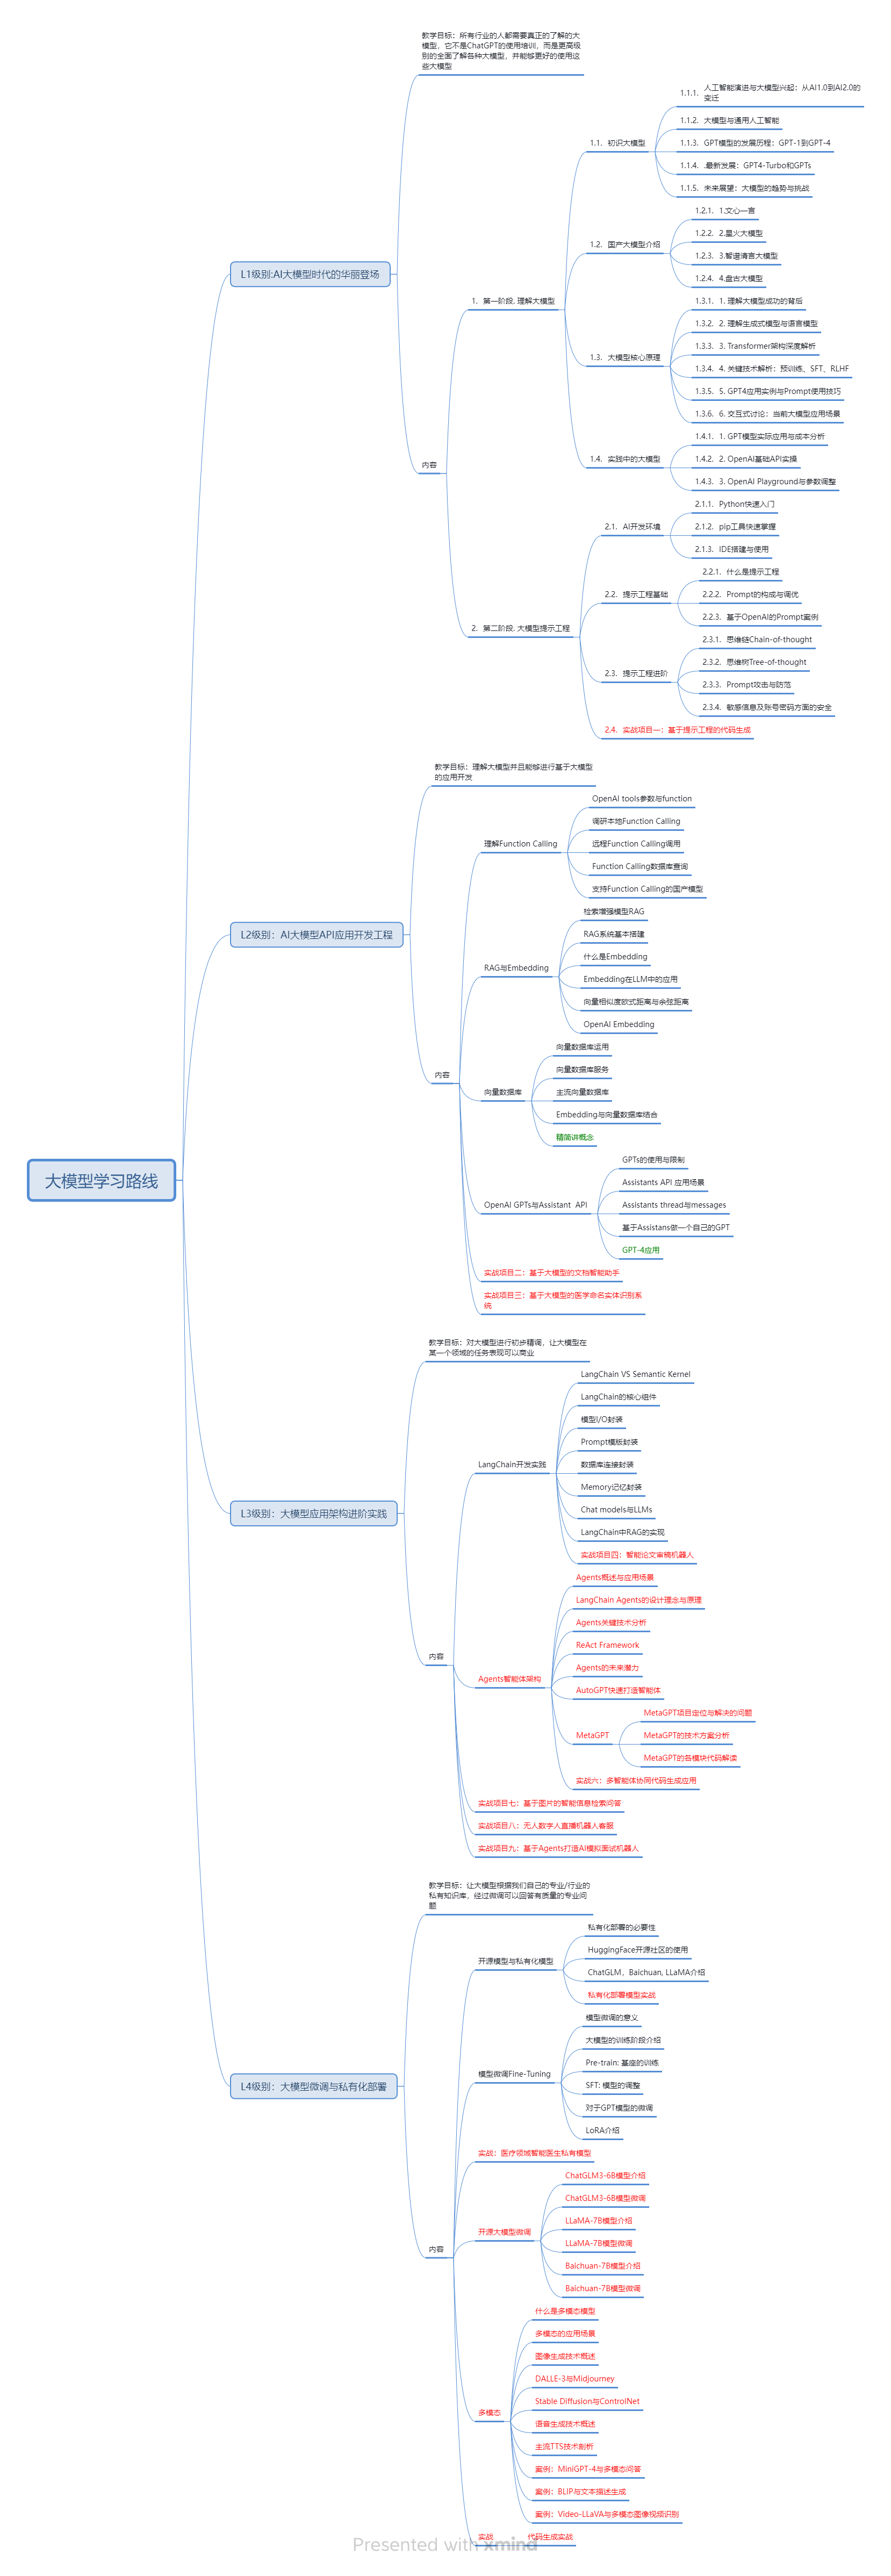
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
在这里插入图片描述

二、AI产品经理入门手册

在这里插入图片描述

三、AI大模型视频教程

在这里插入图片描述

四、AI大模型各大学习书籍

在这里插入图片描述

五、AI大模型各大场景实战案例

在这里插入图片描述

六、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

大模型微调终极方案:LoRA、QLoRA原理详解与LLaMA-Factory、Xtuner实战对比 微调(Fine-tuning)是深度学习中一种利用预训练模型进行特定任务优化的方法,旨在提升模型在特定任务上的性能。微调步骤包括加载预训练模型、修改模型结构、设置优化器和损失函数、训练模型及评估性能。微调场景涵盖修改模型输出层、自我认知及对话风格等。微调方法主要分为增量微调、局部微调和全量微调,各方法在参数调整范围、显存需求、训练速度及效果等方面有所不同。微调技术如LoRA和QLoRA通过引入低秩矩阵和量化技术,减少参数数量和计算成本,适用于资源有限或内存要求苛刻的场景。微调框架如LLaMA-Factory 阅读详情

相关推荐

LLaMA3微调全流程:从LoRA到QLoRA,7B参数模型推理速度提升4倍的代码实战

LLaMA3微调全流程:从LoRA到QLoRA,7B参数模型推理速度提升4倍的代码实战

我是 二川兄,对Web开发、GIS开发、3D模型、机器学习、面试技巧等方面都有一些涉猎~ 欢迎您加入技术交流圈!你可以在我的文章末尾找到我~ 3348

大模型微调技术揭秘——LoRA

受此启发,微软提出了低秩适配(LoRA)方法,设计了特定结构,在涉及矩阵乘法的模块中引入两个低秩矩阵A和B,以模拟完全微调过程。这相当于只对语言模型中起关键作用的低秩本质维度进行更新。

Whitney66的博客 3942

大模型微调---LoRA、QLoRA

LoRA微调是一种高效微调方式,它不直接更新模型的所有参数,而是引用低秩矩阵来对预训练模型进行适应,从而减少训练参数量和计算开销。

2201_75762674的博客 1551

qLoRA的双量化Double Quantization-原创详解

qLoRA是对LoRA的改进版,本文介绍其三个改进之一的双量化技术。属于深度学习,大模型训练方面的原创详解。

wangzhengkui123的博客 1866

大模型微调---QLora微调实战

LoRA是一种参数高效的微调技术,其原理可以参考Lora原理与实战这里我们着重讲一下QLoraQLora在LoRA:j结合了分位数量化和分块量化的4位标准浮点数量化双重量化:通过量化量化常量来节省内存。分⻚优化器:使用CPU内存代替GPU显存保存部分梯度参数因此我们通过peft框架实现QLora,只要开启上面三个机制就可以在⼤模型训练过程中,量化是⼀种降低模型计算复杂度和存储需求的技术。

niulinbiao的博客 2192

PEFT中的主流微调方法(LORA、QLoRA、Adapter Tuning、Prefix Tuning、Prompt Tuning、P-Tuning及P-Tuning v2)

PEFT中的主流微调方法(LORA、QLoRA、Adapter Tuning、Prefix Tuning、Prompt Tuning、P-Tuning及P-Tuning v2)

安静的软件工程师 2695

大模型的Double Quantization(双量化)

flyfish

二分掌柜的 1469

AI大模型探索之路-训练篇17:大语言模型预训练-微调技术之QLoRA

在深度学习的不断进步中,大型语言模型(LLMs)的预训练和微调技术成为了研究的热点。其中,量化技术以其在模型压缩和加速方面的潜力备受关注。本文将深入探讨QLoRA(Quantized Low-Rank Adaptation)技术的原理、实践及应用。

寻道AI,探索AI无限可能! 4208

每日论文推荐:LLaMA3的低比特量化效果详细总结

📌 元数据概览: 标题:这篇论文的标题是“How Good Are Low-bit Quantized LLAMA3 Models? An Empirical Study”,它可能探讨的是低比特权量化技术在LLAMA3模型上的应用效果和性能。 作者:论文的作者包括来自香港大学、北京航空航天大学、苏黎世联邦理工学院等机构的研究人员。他们的专业领域可能涉及计算机科学、机器学习和人工智能。 链接:论文的具体网址是 https://arxiv.org/pdf/2404.14047.pdf,这个链接指向了论文的

林夕 1559

Grey Hack v0.7.3618 保姆级教程:手把手教你用metaxploit.so写一个自动提权脚本

本文详细介绍了如何在Grey Hack v0.7.3618中使用metaxploit.so库编写自动化提权脚本。从环境准备到核心功能解析,再到漏洞利用链构建和权限提升的智能处理,手把手教你掌握游戏中的高级黑客技巧。通过多库联合利用和错误处理优化,提升脚本的效率和成功率。

weixin_42537919的博客 394

手把手教你搞定6脚三位一体数码管的驱动(附C语言源码与Visual Studio调试技巧)

本文详细解析了6脚三位一体数码管的驱动原理与实战技巧,包括引脚复用、动态扫描时序、Visual Studio模拟调试及单片机实现。通过C语言源码示例和调试技巧,帮助开发者快速掌握非标准数码管的驱动方法,提升硬件开发效率。

weixin_30613727的博客 588

QLora 里的双重量化Block-wise Quantization内存占用解释

双重量化我们引入了双重量化(Double Quantization,DQ),这是一种为了额外的内存节省而量化量化常数的过程。虽然需要较小的块大小来进行精确的4位量化[13],但它也带来了相当大的内存开销。例如,使用32位常数和64的块大小对W进行量化,平均每个参数的量化常数增加32/64 = 0.5位。。更具体地说,双重量化将第一次量化的量化常数cFP322作为第二次量化的输入。这个第二步产生了量化的量化常数cFP82和第二级的量化常数cFP321。

samoyan的博客,记录技术成长~ 1698

强化学习Q值迭代的几何视角:从策略区域到快速收敛

在强化学习中,Q值迭代是求解最优策略的核心算法,其理论基础建立在贝尔曼不动点定理之上。该算法通过迭代更新Q函数,使其逐步逼近最优值函数。从几何视角看,整个Q函数空间可被视为一个高维流形,每个Q函数对应流形上的一个点,而贝尔曼最优算子则定义了流形上的变换轨迹。理解这一几何结构,特别是由策略超平面划分出的凸多面体区域,对于分析算法的收敛行为至关重要。在实际工程中,传统Q值迭代可能在高维或稀疏奖励环境下收敛缓慢,甚至陷入策略高原。通过引入策略区域缓存与自适应学习率等几何启发方法,可以更高效地导航策略空间,加速策略

weixin_30444111的博客 317

大模型微调笔记:对比LoRA、QLoRA、AdaLoRA、LoRA+

大模型微调笔记:对比LoRA、QLoRA、AdaLoRA、LoRA+

一只努力学习的小碗~ 3834

深入解析国家企业征信系统瑞数6vmp算法逆向实战

本文深入解析了国家企业征信系统所采用的双层防护机制,重点聚焦于瑞数6代vmp算法的逆向实战。文章详细拆解了从加速乐521状态码的绕过,到瑞数412挑战的核心算法还原过程,提供了通过动态Hook、日志分析进行算法逆向,并用Python实现自动化请求链的完整技术方案,旨在为安全研究与技术学习提供参考。

yellow的专栏 607

攻克JESD204B多ADC同步:从时钟对齐到数据对齐的实战解析

本文深入解析了JESD204B多ADC同步的系统性挑战与实战解决方案。从确保设备时钟同源、精确捕获SYSREF信号,到管理接收端弹性缓冲区与释放点,文章提供了从时钟对齐到数据对齐的完整调试路径与排查清单,是攻克高速数据采集系统中多片ADC同步难题的实用指南。

weixin_29231725的博客 197

解锁大模型微调新姿势:从LoRA到QLoRA再到全量微调

在大模型微调的领域中,LoRA、QLoRA 和全量微调各自占据着独特的地位,它们为不同需求和资源条件的用户提供了多样化的选择。LoRA 以其低秩矩阵的创新设计,在减少参数量和内存占用的同时,保持了较高的训练效率,成为资源有限场景下的首选微调技术。QLoRA 则在 LoRA 的基础上更进一步,通过 4 位量化技术和分页优化器,实现了在极低内存消耗下对超大规模模型的高效微调,为大模型在资源受限环境中的应用开辟了新的道路。

2401_85592132的博客 1345

U24时钟信号上升下降沿出现非单调性--简单分析

交换机U24时钟信号上升下降沿出现非单调性--简单分析

qq_45185504的博客 1131

一文读懂大模型微调:从 LoRA 到 QLoRA 再到全量微调的核心差异

一文读懂大模型微调:从 LoRA 到 QLoRA 再到全量微调的核心差异

xxue345678的博客 1250

实测对比:DINOv2、CLIP、ResNet在图像相似度任务上谁更强?(含Python代码与避坑指南)

本文通过实测对比DINOv2、CLIP和ResNet在图像相似度任务中的表现,提供Python代码实现与避坑指南。实验结果显示,DINOv2在精度上表现最佳,CLIP在多模态场景中优势明显,而ResNet则在计算效率上更优。文章还针对不同业务场景给出了具体选型建议,帮助开发者在图像搜索和版权检测等项目中做出更明智的技术决策。

weixin_30588381的博客 285

西门子V90伺服——章节0、西门子V90章节总述

格式规范:西门子V90伺服——章节1、产品介绍(1、伺服系统初步介绍)@[TOC](西门子V90伺服——章节1、产品介绍)课时1伺服系统初步介绍(1)课时2 伺服系统初步介绍(2)课时3 运动控制基础(1)课时4 运动控制基础(2)课时5 产品概览课时6 相关选件课时7 控制模式介绍(1)课时8 控制模式介绍(2)课时9 产品选型课时10 调试工具及相关资料介绍。

大小曲奇的博客 121

原理剖析 + 实战教程 + 资源优化总结大模型微调实战:LoRA / QLoRA / PEFT 全解析,教你低成本玩转大模型微调

随着大语言模型(LLM)在自然语言处理各领域取得突破性进展,越来越多开发者和企业开始关注模型的微调方式。然而,全参数微调不仅成本高昂、资源要求极高,还容易引发过拟合与知识遗忘等问题。为此,LoRA、QLoRA、PEFT 等轻量级微调技术迅速崛起,成为大模型落地实践的热门选择。

引用原创内容标明出处即可 2642

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

大模型微调技术:全参数微调、LoRA与QLoRA解析

摘要:本文介绍了三种大模型微调技术:全参数微调(Full Fine-Tuning)、低秩适配(LoRA)和量化低秩适配(QLoRA)。全参数微调适用于复杂任务,但计算成本高;LoRA通过低秩矩阵减少参数量,适合个性化定制;QLoRA结合4-bit量化和LoRA,极大降低内存需求,适合资源受限场景。文章详细阐述了各技术的原理、适用场景、代码实现及优缺点,为开发者选择合适方法提供参考。

没事学AI的博客 1162

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

LoRA和QLoRA微调

LoRA和QLoRA是两种高效微调大语言模型的技术,通过低秩矩阵分解和模型量化显著降低计算资源需求。LoRA冻结预训练权重并注入可训练的低秩矩阵,仅需优化少量参数;QLoRA进一步引入4位量化技术,使大模型微调可在消费级GPU上运行。两种方法在保持模型性能的同时,将参数量降至全量微调的千分之一以下,支持快速任务切换。实践环节详细介绍了代码实现步骤、关键参数配置(如秩、学习率等)、训练监控方法和常见问题解决方案,并分析了不同GPU配置下的适用模型规模。技术对比显示,AdamW优化器比Adam更适合抑制过拟合,

jingzhi111的博客 1071

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

大模型微调技术:从LoRA到QLoRA的实践指南!

本文全面介绍大模型微调技术,涵盖基础概念、LoRA与QLoRA高效方法、四大应用场景、主流工具、评估框架及软硬件配置。详细说明不同规模模型显存需求,重点讲解Qwen3系列模型微调的数据构造方法,为开发者提供从理论到实践的完整微调解决方案。

2401_85390073的博客 1604

低秩适应(LoRA)与量化LoRA(QLoRA)技术解析

通过这种技术,我们可以巧妙地绕过直接修改原始模型的庞大参数,而是添加训练一组规模小得多的参数矩阵。QLoRA(Quantized LoRA)是LoRA的进阶版本,它将量化技术与低秩适应相结合。通过将原模型量化到较低精度(如4位整数),同时使用LoRA进行微调,可以实现更高效的内存使用。值得注意的是,LoRA通常不应用于偏置项(bias)和层归一化(layer normalization)参数,这些参数量相对较小,可以直接训练。这样做可以更好地控制微调的程度,α与r的比值影响着学习率的选择。

ngadminq的博客 4557
上一篇: 实战 Transformers 模型微调之数据集处理库 Hugging Face Datasets
下一篇: 8月最新大模型新书-《自然语言处理:大模型理论与实践》(附PDF)西财赵宇教授新作
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值