本地部署huggingface模型,建立自己的翻译应用

HuggingFace入门指南:从核心概念到模型微调与部署 在人工智能与自然语言处理领域,预训练模型已成为技术落地的关键基础设施,而HuggingFace作为模型共享与工具集成的生态平台,正逐步统一模型获取、数据处理与推理部署的标准化流程。其核心价值在于通过Tokenizer、Model、Pipeline等组件,将复杂的深度学习原理封装为简洁易用的接口,让开发者无需深入底层机制,即可调用BERT、GPT等先进模型完成文本分类、情感分析等任务。同时,datasets与accelerate库进一步降低了数据准备和分布式训练的门槛,使得在小规模算力下进行模型微调成为可能。 阅读详情
AI摘要

本文介绍如何本地部署HuggingFace的翻译模型,实现中英文互译。通过具体步骤和代码示例,展示了如何下载模型、安装所需组件,并使用Python进行翻译操作。

过去,我们使用翻译接口时,往往都是使用百度等的接口,每天有一定量的免费额度。今天为大家介绍一个可以进行翻译的模型,具备英译中、中译英的能力。并且在这个过程中,向大家介绍一个如何在本地部署模型。在之前的”五天入门RAG“中,我们介绍过如何线上运行,但这是需要网络条件的,当你不具备时,可以在本地安装使用。

这个模型就是Helsinki-NLP/opus-mt-zh-en和Helsinki-NLP/opus-mt-en-zh。在后面,我们会再带大家体验具备语音翻译,转录的模型SeamlessM4T。

首先进入:https://huggingface.co/

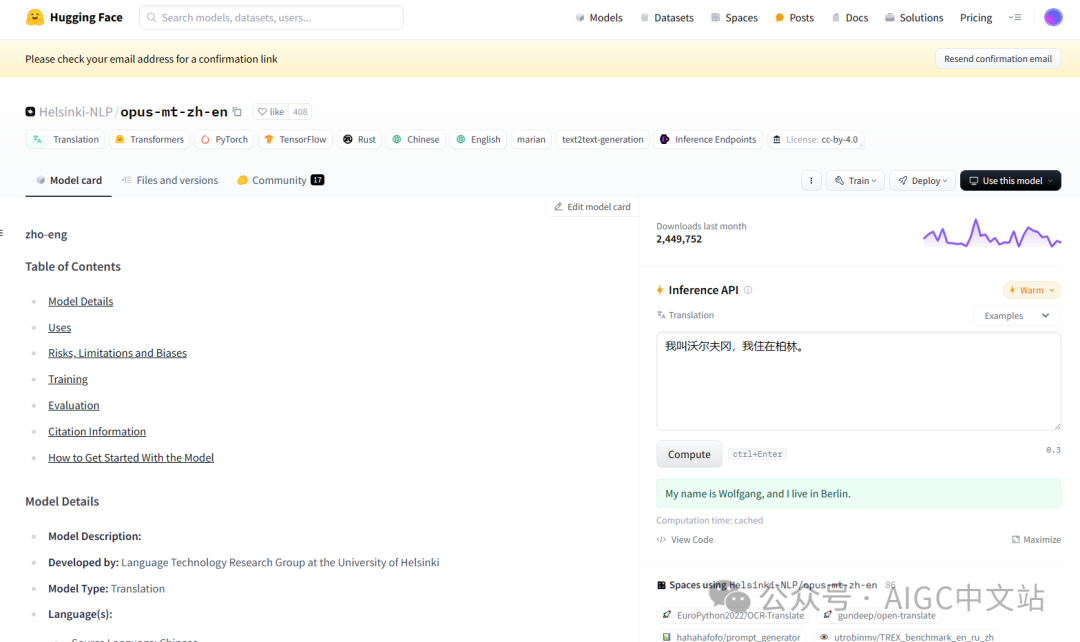
搜索:Helsinki-NLP/opus-mt-zh-en
图片

点击右边的compute试一下,翻译效果还不错。

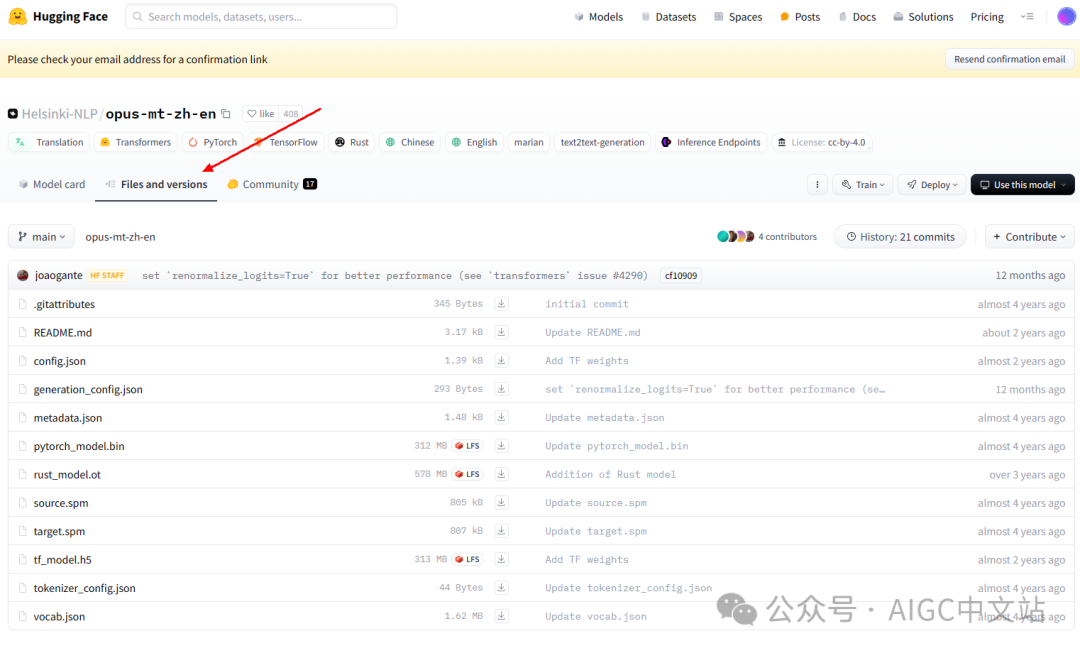
然后点击files卡片。
图片

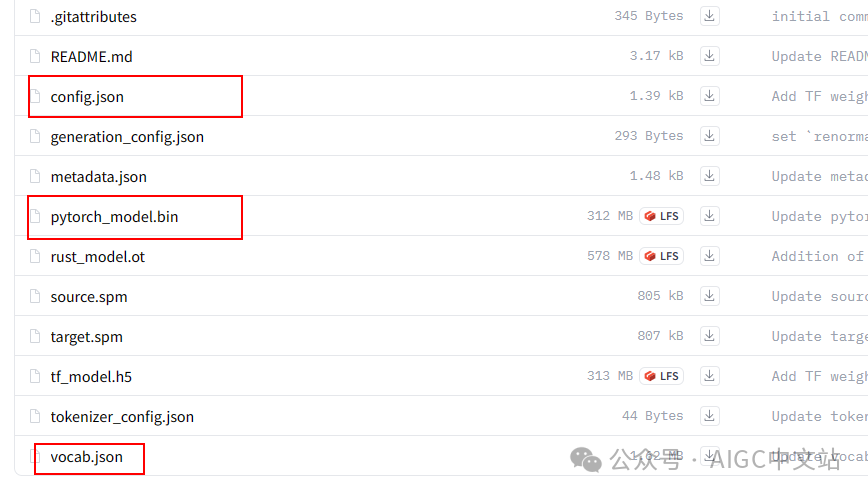
主要下载如下的几个文件。

图片

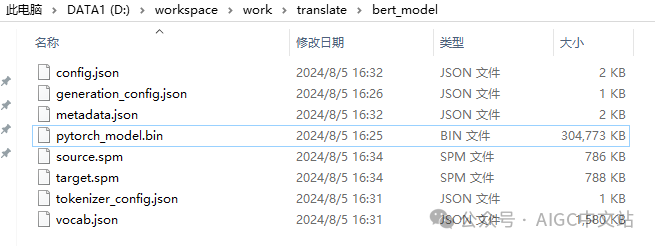
放到自己本地目录下:

图片

然后输入我们的翻译代码:

from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

# 模型名称,如果模型已经下载到本地,可以直接指定路径
modelName = "D:/workspace/work/translate/bert_model/"
srcText = [
"大家好,我是一只来自中国的大熊猫",
"在这种方式下,我们的transformers才能发挥最大的作用",
"啊!华山,你可真是壮美",
]


#---------------------------------

tokenizer = AutoTokenizer.from_pretrained(modelName)
model = AutoModelForSeq2SeqLM.from_pretrained(modelName)
translated = model.generate(**tokenizer(srcText, return_tensors="pt", padding=True))
# 返回结果
r = [tokenizer.decode(t, skip_special_tokens=True) for t in translated]


print(r)

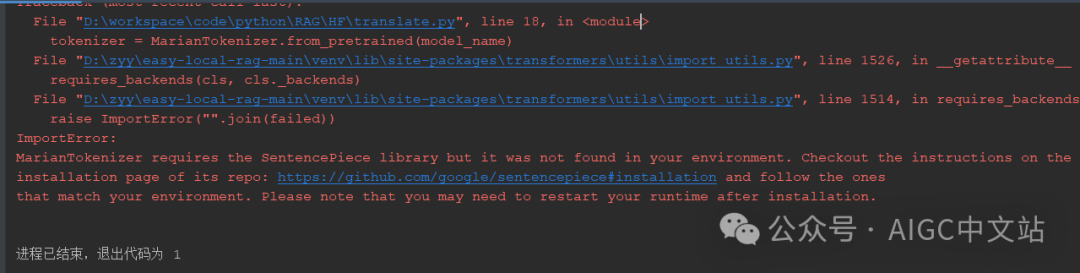
代码可能会提示错误
图片

那么我们安装这个就是了,代码如下:

pip install SentencePiece

然后再运行:

图片

["Hello. I'm a big panda from China.", 
"In this way, our transformers will be most effective.", 
"Oh, you're so beautiful, Wahshan."]

同样的,英译中使用另一个模型即可。

我们简单解释一下代码!

AutoTokenizer.from_pretrained

用于加载预训练的文本处理模型(Tokenizer),以便将文本数据转换为模型可以接受的输入格式。这个方法接受多个参数,以下是这些参数的详细说明:

1.pretrained_model_name_or_path (str):

-这是最重要的参数,指定要加载的预训练模型的名称或路径。可以是模型名称(例如 “bert-base-uncased”)或模型文件夹的路径。

\2. inputs (additional positional arguments, optional)

它表示额外的位置参数,这些参数会传递给标记器(Tokenizer)的__init__()方法。这允许你进一步自定义标记器的初始化。

\3. config ([PretrainedConfig], optional)

这个配置对象用于确定要实例化的分词器类。

4.cache_dir (str, optional):

用于缓存模型文件的目录路径

\5. force_download (bool, optional):

如果设置为 True,将强制重新下载模型配置,覆盖任何现有的缓存。

\6. resume_download (bool, optional):

-这是可选参数,如果设置为 True,则在下载过程中重新开始下载,即使部分文件已经存在。

\7. proxies (Dict[str, str], optional)

proxies(可选参数):这是一个字典,用于指定代理服务器的设置。代理服务器允许您在访问互联网资源时通过中继服务器进行请求,这对于在受限网络环境中使用 Transformers 库来加载模型配置信息非常有用。

​ proxies = { “http”: “http://your_http_proxy_url”, “https”: “https://your_https_proxy_url” }

\8. revision (str, optional):

指定要加载的模型的 Git 版本(通过提交哈希)。

\9. subfolder (str, optional)

如果相关文件位于 huggingface.co 模型仓库的子文件夹内(例如 facebook/rag-token-base),请在这里指定。

\10. use_fast (bool, optional, defaults to True)

这是一个布尔值,指示是否强制使用 fast tokenizer,即使其不支持特定模型的功能。默认为 True。

\11. tokenizer_type (str, optional)

参数用于指定要实例化的分词器的类型

\12. trust_remote_code (bool, optional, defaults to False)

trust_remote_code=True:

默认情况下,trust_remote_code 设置为 True。这意味着当您使用 from_pretrained() 方法加载模型配置文件时,它将下载来自 Hugging Face 模型中心或其他在线资源的配置文件。这是一个方便的默认行为,因为通常这些配置文件是由官方提供的,且是可信的。

trust_remote_code=False:

如果您将 trust_remote_code 设置为 False,则表示您不信任从远程下载的配置文件,希望加载本地的配置文件。这对于安全性或定制性要求较高的场景可能是有用的。

在这种情况下,您需要提供一个本地文件路径,以明确指定要加载的配置文件

总之,trust_remote_code 参数允许您在使用 Hugging Face Transformers 库时控制是否信任从远程下载的配置文件。默认情况下,它被设置为 True,以方便加载官方提供的配置文件,但您可以将其设置为 False 并提供本地配置文件的路径,以进行更精细的控制。

AutoModel.from_pretrained()

AutoModel.from_pretrained() 是 Hugging Face Transformers 库中的一个函数,用于加载预训练的深度学习模型。它允许你加载各种不同的模型,如BERT、GPT-2、RoBERTa 等,而无需为每个模型类型编写单独的加载代码。以下是 AutoModel.from_pretrained() 函数的主要参数:

\1. pretrained_model_name_or_path (str):

-这是一个字符串参数,用于指定要加载的预训练模型的名称或路径。可以是模型的名称(如 “bert-base-uncased”)或模型文件夹的路径。

\2. *model_args

直接传参的方式,传入配置项,例如,我们将编码器层数改为3层

model = AutoModel.from_pretrained(“./models/bert-base-chinese”, num_hidden_layers=3)

加载模型时,指定配置类实例

model = AutoModel.from_pretrained(“./models/bert-base-chinese”, config=config)

3.trust_remote_code (bool, optional, defaults to False)

trust_remote_code=True:

默认情况下,trust_remote_code 设置为 True。这意味着当您使用 from_pretrained() 方法加载模型配置文件时,它将下载来自 Hugging Face 模型中心或其他在线资源的配置文件。这是一个方便的默认行为,因为通常这些配置文件是由官方提供的,且是可信的。

trust_remote_code=False:

如果您将 trust_remote_code 设置为 False,则表示您不信任从远程下载的配置文件,希望加载本地的配置文件。这对于安全性或定制性要求较高的场景可能是有用的。

在这种情况下,您需要提供一个本地文件路径,以明确指定要加载的配置文件

总之,trust_remote_code 参数允许您在使用 Hugging Face Transformers 库时控制是否信任从远程下载的配置文件。默认情况下,它被设置为 True,以方便加载官方提供的配置文件,但您可以将其设置为 False 并提供本地配置文件的路径,以进行更精细的控制。

hub_kwargs_names = [

“cache_dir”, #同上面

“force_download”,#同上面

“local_files_only”,

“proxies”, #同上面

“resume_download”, #同上面

“revision”, #同上面

“subfolder”, #同上面

“use_auth_token”,

]

local_files_only:

如果设置为True,将只尝试从本地文件系统加载模型。如果本地文件不存在,它将不会尝试从Hugging Face模型存储库下载模型文件。如果本地存在模型文件,它将从本地加载。如果设置为False(默认值),它将首先尝试从本地加载,如果本地不存在模型文件,它将尝试从Hugging Face模型存储库下载模型文件并缓存到本地,然后加载。

from transformers import AutoModel

model = AutoModel.from_pretrained(“bert-base-uncased”, local_files_only=True)

详解 use_auth_token 参数:

默认值:use_auth_token 参数的默认值通常为 None,这意味着在默认情况下不使用身份验证令牌。

作用:Hugging Face Model Hub 上的一些模型可能需要身份验证令牌才能访问。这通常是因为模型的创建者希望对其进行访问控制,或者出于其他原因需要进行身份验证。如果模型需要身份验证令牌,你可以在 use_auth_token 参数中提供有效的令牌,以便在下载模型时使用。

获取身份验证令牌:要获得有效的身份验证令牌,你需要注册并登录到 Hugging Face Model Hub,然后访问你的个人配置文件(profile),那里会提供一个 API 令牌(API token),你可以将其用作 use_auth_token 的值。

from transformers import AutoModel

# 使用身份验证令牌来加载模型

model = AutoModel.from_pretrained(‘model_name’, use_auth_token=‘your_auth_token’)

大多数模型不需要身份验证令牌,并且可以在不提供 use_auth_token 参数的情况下加载。只有在你确实需要进行身份验证才需要使用此参数。

model.generate()

model()的使用场景:当你需要对输入数据执行一次完整的前向计算时使用,如分类任务、特征提取等。
model.generate()的使用场景:当你需要模型自动生成文本或序列,尤其是在语言模型中,如GPT、T5等。

return_tensors=‘pt’, 自动的将所有的结果都转化成二纬的tensor数据,因此,后面我们还需要将数据进行解码,完成编码解码。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

微调Helsinki-NLP-en-zh模型 Helsinki-NLP 是一个广泛使用的开源机器翻译(Machine Translation,MT)模型系列,基于 Marian NMT 框架原本的模型对于国内外公司的名称支持度很差,比如会把‘FireFox‘翻译成‘消防’,所以我需要在保留原本翻译能力的基础上,增强对公司名称的翻译能力。 阅读详情

相关推荐

搭建属于自己的翻译系统

你有没有用过翻译系统?你有没有想过搭建一套属于自己的翻译系统?

ShenweiFFF的博客 1356

部署并访问本地模型

官网:https://huggingface.co/HuggingFace 是一个自然语言处理(NLP)领域的开源社区和平台,它提供了一系列强大的工具、库和预训练模型,帮助开发者快速构建和部署自然语言处理应用。HuggingFace 平台的主要组成部分和特点如下:1.:HuggingFace 的 Transformers 库是其最著名和核心的部分。

weixin_69365186的博客 2290

HuggingFace实战指南:从模型调用、数据准备到微调部署

在自然语言处理(NLP)和大模型应用开发中,统一工具链是提升效率的关键。HuggingFace生态以Transformer模型为核心,通过AutoModel、AutoTokenizer等标准化接口,将模型调用、数据处理、微调与部署串成一条完整链路。无论是文本分类、命名实体识别还是生成式任务,开发者都可以基于同一套API快速构建和切换模型。面对真实业务,数据清洗与分词、参数高效微调(如LoRA)、量化部署等环节常常成为落地瓶颈。这篇内容从实践出发,按照模型调用、数据准备、微调、部署的顺序,梳理每个模块的作用与

weixin_30911451的博客 413

本地化Huggingface模型:轻松创建自己的翻译应用

过去,我们使用翻译接口时,往往都是使用百度等的接口,每天有一定量的免费额度。今天为大家介绍一个可以进行翻译的模型,具备英译中、中译英的能力。并且在这个过程中,向大家介绍一个如何在本地部署模型。在之前的”五天入门RAG“中,我们介绍过如何线上运行,但这是需要网络条件的,当你不具备时,可以在本地安装使用。这个模型就是Helsinki-NLP/opus-mt-zh-en和Helsinki-NLP/opus-mt-en-zh。在后面,我们会再带大家体验具备语音翻译,转录的模型SeamlessM4T。

2401_84495872的博客 1539

【模型之美】18、HuggingFace大模型部署全攻略:从本地测试到生产环境一键上线

大模型部署实战:HuggingFace工具链全解析 本文系统介绍HuggingFace生态的核心工具链,帮助开发者实现大模型的高效部署。主要内容包括: 基础工具:Transformers Pipeline实现一行代码调用模型,支持30+种任务,自动处理预处理/推理/后处理全流程。 模型优化:通过量化和剪枝技术提升性能,量化可将7B模型从13GB压缩至3.5GB(Int4),推理速度提升4-6倍。 部署方案: 免费部署:HuggingFace Spaces提供容器化Web应用托管 生产级部署:推理端点支持自动

2025博客之星Top81。专注AI工程化与架构实战。从分布式思维到模型部署,用工程化视角为你厘清AI落地的真实路径。 1637

Helsinki-NLP 中英文翻译模型opus-mt-en-zh/opus-mt-zh-en

# Python本地离线运行机器翻译: 中英文翻译模型说明: 英语到中文: Helsinki-NLP/opus-mt-en-zh 中文到英语: Helsinki-NLP/opus-mt-zh-en

HuggingFace镜像网站支持模型卡片翻译

HuggingFace镜像站现已支持模型卡片自动翻译为中文,结合ms-swift框架实现高效下载、轻量微调与一键部署,显著降低中文开发者使用门槛。通过CDN加速和智能路由,模型获取速度提升5-10倍,配合QLoRA等技术,单卡即可完成大模型微调,真正实现开箱即用的本地化开发体验。

weixin_28872035的博客 737

华大HC32F460 TCP Server实验

华大HC32F460 TCP Server实验

ZhuoWuKeJi的博客 1270

LLM大模型-大模型 API 集成使用、部署本地大模型(huggingface、modelscope)、实现Qwen和Deepseek本地部署

人工智能中的大模型(Large Model / Foundation Model),是指参数规模通常在数十亿甚至千亿以上的深度神经网络。它们依靠大规模数据和高算力平台训练而成,具备强泛化能力和跨任务迁移能力,能够在自然语言处理、计算机视觉、语音、多模态等多个领域展现出较强的性能。参数规模巨大:例如 GPT-3 拥有 1750 亿参数。预训练 + 微调:先在海量通用数据上进行预训练,再通过少量标注数据进行下游任务微调。

2202_75674969的博客 2414

数据清洗(Data Cleansing)

数据清洗(Data Cleansing)是指对数据进行处理和纠错,以去除或修复数据集中存在的错误、不致、不完整和冗余的数据,从而使数据更加准确、可靠和有用。数据清洗是数据处理和数据分析中一个非常重要的步骤,它可以帮助我们提高数据的质量,从而提高数据分析和机器学习的准确性和可靠性。数据清洗是一个重要的过程,它可以帮助我们提高数据的质量,从而提高数据分析和机器学习的准确性和可靠性。在实际应用中,我们可以使用一些工具和技术来实现数据清洗,例如 Pandas、NumPy 和 OpenRefine 等。通过数据清洗,

meimei169500的博客 1万+

算法交易VWAP&TWAP

VWAP的一些算法模型细节参考博客地址http://blog.sina.com.cn/s/blog_ad47bc5b01014elx.html 日内交易量预测模型http://blog.sina.com.cn/s/blog_976461170102v43p.html 算法交易其实主要是用在基金公司、券商量化比较多。例如我已经选好股,要大量买入,但是单凭交易员的操作海量单而且要完

shulixu的博客 1万+

学习AI第一课:本地部署AI大模型

AI 大模型发展到现在,国内外都有在线和离线版本,那如何在自己本地部署大模型呢?本文分享了一种简单的办法,一起来看看吧。我们经常能看到某某公司开源了一款 AI 大模型的新闻。这些模型都有着超强的能力,从生成大段的文字、逼真的图像,到理解和翻译不同语言,再到创造出令人叹为观止的音乐和艺术作品。对于我们普通人来说,这些高科技听起来不仅遥不可及,而且似乎与我们的日常生活无关,他们像是只有那些天才和大神们才能操作和使用的。

GIS摆渡人 4112

Mamba与iTransformer融合:时间序列预测中的曼巴注意力机制创新实践

本文探讨了Mamba与iTransformer融合在时间序列预测中的创新实践,重点介绍了曼巴注意力机制的设计与优势。通过双路径信息流设计,该方案在保持O(n)复杂度的同时,显著提升了预测精度和训练效率。实验证明,混合架构在电力负荷、气象数据等多变量长序列场景中表现优异,预测误差降低至0.083,内存占用仅4.2GB。

weixin_29292535的博客 219

三步搞定HuggingFace BERT预训练模型的本地部署与调用

本文详细介绍了如何将HuggingFace BERT预训练模型下载并部署到本地,实现离线调用。通过精准获取模型文件、配置Python环境、从本地路径加载模型三个核心步骤,帮助开发者彻底摆脱网络依赖,提升模型推理的稳定性和速度,适用于网络受限或需要离线部署的NLP项目场景。

weixin_29276847的博客 420

25届电信保研经验贴(空天院)

学校:中九专业:电子信息工程加权:92.89绩点:3.91/4.0rank:前五学期rank2/95,综合排名rank1(前六学期和综合排名出的晚,实际上只用到了前五学期)科研竞赛:市级大创、数模省一、数竞省二,其他校奖若干英语:六级462、四级548个人感觉:rank=科研>竞赛>英语总之rank和科研必须得有一项,要么就rank高,很多强com院校入营看rank。我rank比较有优势,因此报的多是强com院校。要么就科研经历丰富,多主动联系老师,特别是弱com院校。冬令营:空天院。

qq_68608661的博客 6340

OpenClaw更新后变傻了?一分钟教你快速恢复(OpenClaw更新版本后降智、缺少权限问题的解决方案)

OpenClaw 版本更新后出现降智问题,AI不再执行具体任务。本文详细分析问题原因,提供最简便的解决方案✅

XiaoqiangClub的博客 3883

HuggingFace翻译模型ONNX部署实战:从导出到量化

将HuggingFace上的生成式模型投入生产环境时,常见的部署瓶颈是笨重的PyTorch运行时与低效的CPU推理。ONNX Runtime通过静态计算图和轻量执行引擎,让模型脱离原始库独立运行,成为工业界主流的模型优化与部署方案。以英译中任务为例,翻译模型属于Encoder-Decoder架构,推理需自回归生成,无法像分类模型那样一次导出,必须将编码器与解码器拆分为独立ONNX文件,并手写解码循环。文章围绕这一核心挑战,详细梳理了从Optimum导出、动态轴配置、精度对比到Int8量化的完整链路,并给出了

weixin_29042035的博客 206

PCIe协议之 Equalization篇 之 理论篇 之 FFE

作为最后一道“精加工”工序,DFE利用其不放大噪声的优势,精准地消除残余的、强烈的后光标ISI,最终得到一个非常干净、张得很开的眼图,供判决器使用。信号经过信道衰减后变得模糊,首先由CTLE进行“粗调”,提供一个宽频带的增益,将眼图初步打开,为后面的DFE创造一个可以正常工作的信号环境。,它通过将输入信号在不同时间点上的多个副本(称为“抽头”)进行加权求和,来直接塑造或“整形”输出信号的波形。:这是最主要的信号路径,通常系数为正值,决定了信号的幅度。:将所有加权后的信号相加,产生最终的均衡输出。

那么菜的博客 755

HuggingFace模型迁移ONNX实战:翻译模型部署优化与量化指南

在生产环境中部署深度学习模型,常常要面对依赖臃肿、启动缓慢和推理性能不足等难题。开放神经网络交换格式ONNX作为一种跨框架的中间表示,能将训练好的模型标准化导出,并借助ONNX Runtime实现高效推理。其原理在于将计算图进行算子融合、内存复用等静态优化,配合动态量化技术可进一步缩减模型体积并提升CPU处理速度。这一技术路线广泛应用于NLP推理服务、边缘设备部署等场景。本文以英译中翻译模型为案例,完整演示了从HuggingFace平台选取模型、手动导出ONNX、配置动态轴、int8量化,到使用ONNX R

weixin_29048775的博客 290

ATECC508A芯片开发笔记(四):自定义配置508功能,规划DataZone数据存储

ATECC508A芯片开发笔记(四):自定义配置508功能,规划DataZone数据存储 508A内部存储区介绍 Data Zone Config Zone 508A Config Zone配置(自定义) - ATECC508A芯片在使用之前,需要自定义配置ConfigZone与DataZone,并同Lock命令将两个区域锁住,否则无法正常使用功能。而一旦锁上就是永久性的,配置区不能够进行解锁

HowieXue 薛永浩的博客 2万+

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

HuggingFace镜像站也能用!腾讯HunyuanOCR模型下载与部署技巧

腾讯推出的HunyuanOCR将检测、识别与结构化抽取集成于1B参数的端到端模型中,支持百种语言且适配消费级显卡。借助HuggingFace镜像站,国内用户可高效下载并部署,结合vLLM加速和FastAPI服务,轻松构建高性能OCR系统。

weixin_33816734的博客 761

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Hunyuan-MT-7B-WEBUI能否翻译HuggingFace模型卡片?

Hunyuan-MT-7B-WEBUI凭借强大的多语言翻译能力与图形化操作界面,能够准确翻译HuggingFace上的英文模型卡片。它在技术术语处理、上下文理解方面表现优异,特别优化中英互译,配合一键部署的WEBUI系统,让非专业用户也能快速获取高质量译文,极大提升了中文用户使用国际AI资源的效率。

weixin_35728286的博客 1054

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

HuggingFace 入门到实战:模型下载、本地推理与 API 部署全指南

大模型应用开发中,模型托管与推理接口的统一是降低工程门槛的关键。HuggingFace 作为全球主流的模型平台,集中了海量预训练权重与开源工具链,通过 Transformers 库将不同架构的模型封装为一致的 Pipeline 调用方式。开发者借助国内镜像加速,可稳定完成模型下载与本地部署,无需从零训练即可实现文本分类、文生图、OCR、语音合成等任务。平台还提供数据集管理、模型微调及 Gradio/FastAPI 接口封装能力,支撑从离线验证到生产环境 API 服务的完整链路。本文围绕资源获取、环境配置、推

weixin_31499265的博客 344

HuggingFace实战指南:从模型调用到微调部署全流程

自然语言处理(NLP)是人工智能的核心方向,而大模型的兴起让文本理解与生成的工程化门槛大幅下降。但面对HuggingFace生态,新手常常困惑于transformers、datasets、tokenizers等模块如何协作,以及如何在有限资源下完成模型微调和本地部署。HuggingFace本身解决了预训练模型标准化复用的问题,它将分词、模型加载、训练循环和推理封装为统一接口,使开发者无需从零实现深度学习细节。通过pipeline可以快速验证模型效果,借助Trainer与LoRA能够低成本适配业务数据,配合F

weixin_34189116的博客 438
上一篇: 你的大模型为什么训不快?大模型预训练技术精要
下一篇: 不需要网络/不需要显卡,手把手教大家本地部署GPT
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值