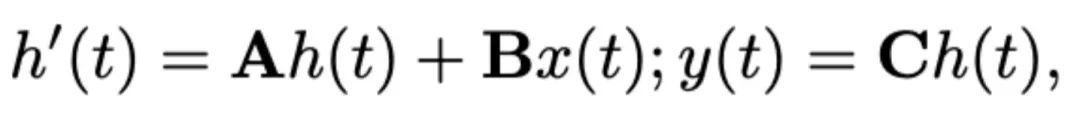北大推出全新机器人多模态大模型!面向通用和机器人场景的高效推理和操作

多模态 + Mamba,这对 “CP” 直接锁死啦! 作为序列建模领域的革命性技术,Mamba以线性复杂度的长距离依赖建模能力,与多模态技术的跨维度信息整合优势形成化学反应,推动模型在准确性、鲁棒性和泛化性上实现跨越式突破。从医疗影像的多模态诊断到工业质检的跨模态缺陷检测,从智慧城市的多源数据融合到元宇宙的沉浸式交互,技术应用版图持续裂变。学术领域更是成果井喷,如ICASSP 2025最新成果DepMamba,在多模态视频理解任务中实现计算效率与准确率的双重突破。 阅读详情

为了赋予机器人端到端的推理和操纵能力,本文创新性地将视觉编码器与高效的状态空间语言模型集成,构建了全新的 RoboMamba 多模态大模型,使其具备视觉常识任务和机器人相关任务的推理能力,并都取得了先进的性能表现。同时,本文发现当 RoboMamba 具备强大的推理能力后,我们可以通过极低的训练成本使得 RoboMamba 掌握多种操纵位姿预测能力。
图片

  • 论文:RoboMamba: Multimodal State Space Model for Efficient Robot Reasoning and Manipulation
  • 论文链接:https://arxiv.org/abs/2406.04339
  • 项目主页:https://sites.google.com/view/robomamba-web
  • Github:https://github.com/lmzpai/roboMamba
图片

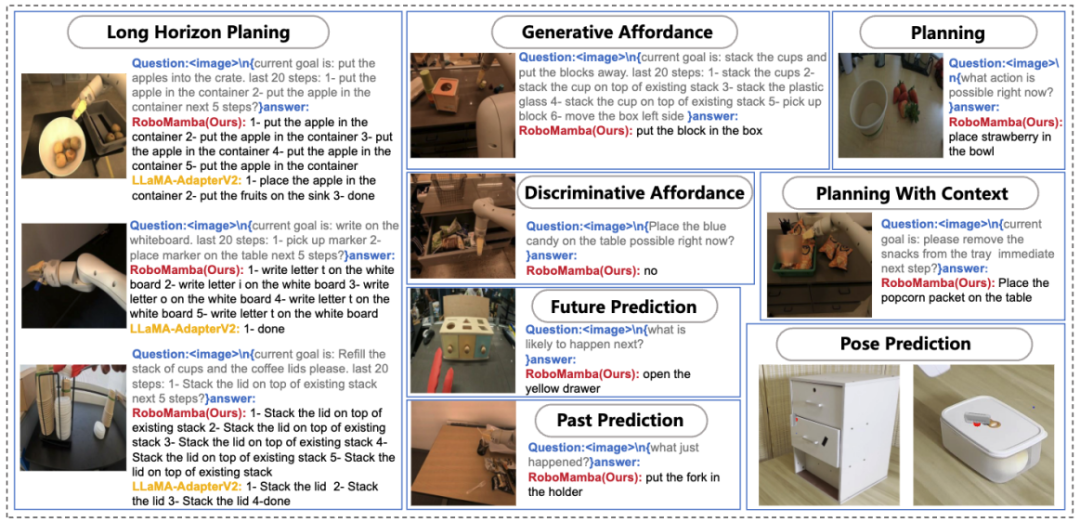
图 1. RoboMamba 具备的机器人相关能力,其中包括任务规划、提示性任务规划、长程任务规划、可操纵性判断、可操纵性生成、未来与过去预测、末端执行器位姿预测等。

摘要

机器人操纵的一个基本目标是使模型能够理解视觉场景并执行动作。尽管现有的机器人多模态大模型(MLLM)可以处理一系列基本任务,但它们仍然面临两个方面的挑战:1) 处理复杂任务的推理能力不足;2) MLLM 微调和推理的计算成本较高。最近提出的状态空间模型(SSM),即 Mamba,其具备线性推理复杂度同时在序列建模中展示了令人期待的能力。受此启发,我们推出了端到端机器人 MLLM—RoboMamba,它利用 Mamba 模型提供机器人推理和行动能力,同时保持高效的微调和推理能力。

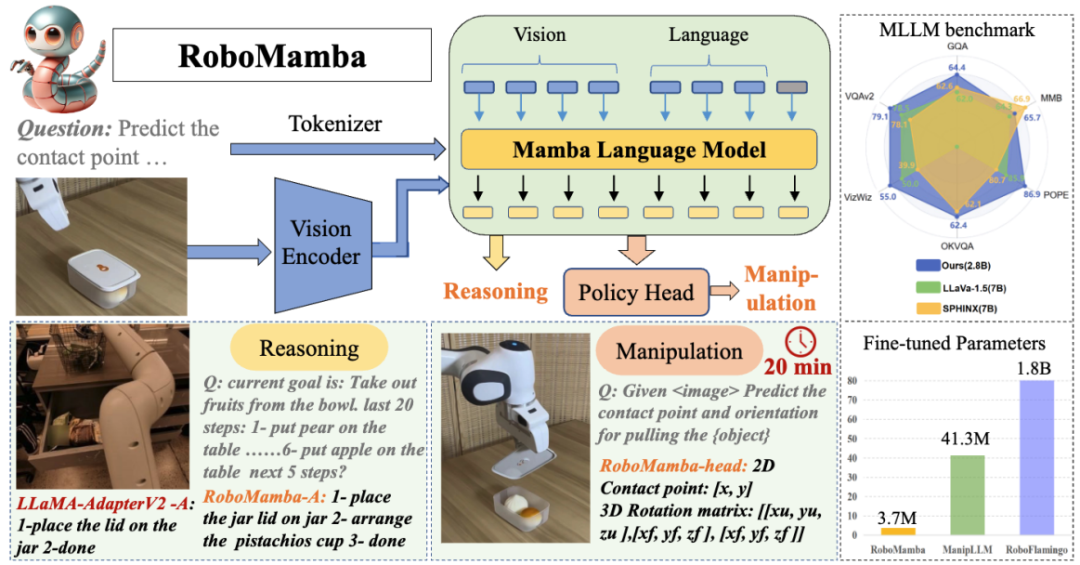
具体来说,我们首先将视觉编码器与 Mamba 集成在一起,通过共同训练将视觉数据与语言嵌入对齐,使我们的模型具有视觉常识和与机器人相关的推理能力。为了进一步增强 RoboMamba 的操纵位姿预测能力,我们探索了一种仅使用简单 Policy Head 的高效微调策略。我们发现,一旦 RoboMamba 拥有足够的推理能力,它可以通过极少的微调参数(模型的 0.1%)和微调时间(20 分钟)来掌握多种操作技能。在实验中,RoboMamba 在通用和机器人评估基准上展示了出色的推理能力,如图 2 所示。同时,我们的模型在模拟和现实世界实验中展示了令人印象深刻的操纵位姿预测能力,其推理速度比现有的机器人 MLLMs 快 7 倍。
图片

图 2. 概述:Robomamba 是一种高效的机器人多模态大模型,同时具备强大的推理和操作能力。RoboMamba-2.8B 在通用 MLLM 基准上实现了与其他 7B MLLM 可竞争的推理性能,同时在机器人任务中展示了长程推理能力。随后,我们引入了一种极其高效的微调策略,使 RoboMamba 具备操纵位姿预测能力,只需 20 分钟即可微调一个简单的策略头。

本文主要贡献总结如下:

  • 我们创新地将视觉编码器与高效的 Mamba 语言模型集成,构建了全新的端到端机器人多模态大模型,RoboMamba,其具备视觉常识和机器人相关的全面推理能力。
  • 为了使 RoboMamba 具备末端执行器操纵位姿预测能力,我们探索了一种使用简单 Policy Head 的高效微调策略。我们发现,一旦 RoboMamba 达到足够的推理能力,它可以以极低的成本掌握操纵位姿预测技能。
  • 在我们的大量实验中,RoboMamba 在通用和机器人推理评估基准上表现出色,并在模拟器和真实世界实验中展示了令人印象深刻的位姿预测结果。

研究背景

数据的 scaling up 显著推动了大语言模型(LLMs)研究的发展,展示了在自然语言处理(NLP)中推理和泛化能力的显著进步。为了理解多模态信息,多模态大语言模型(MLLMs)应运而生,赋予 LLMs 视觉指令跟随和场景理解的能力。受 MLLMs 在通用环境中强大能力的启发,近期研究旨在将 MLLMs 应用于机器人操作领域。一些研究工作使机器人能够理解自然语言和视觉场景,自动生成任务计划。另一些研究工作则是利用 MLLMs 的固有能力,使其具备预测操作位姿的能力。

机器人操作涉及在动态环境中与物体交互,需要类人推理能力以理解场景的语义信息,以及强大的操纵位姿预测能力。虽然现有基于机器人 MLLM 可以处理一系列基础任务,但它们在两个方面仍然面临挑战。

1)首先,预训练的 MLLMs 在机器人场景中的推理能力被发现是不足的。正如图 2

所示,当微调后的机器人 MLLMs 遇到复杂推理任务时,这种缺陷会带来挑战。

2)其次,由于现有 MLLM 注意力机制的计算复杂度较高,微调 MLLMs 并使用它们生成机器人操作动作会产生更高的计算成本。

为了平衡推理能力和效率,NLP 领域出现了几项研究。尤其是,Mamba 引入了创新的选择性状态空间模型(SSM),在保持线性复杂度的同时,促进了上下文感知的推理。

受此启发,我们提出一个问题:“我们能否开发出一种高效的机器人 MLLM,既具备强大的推理能力,又能以非常经济的方式获得机器人操作技能?”

RoboMamba 方法

1. 背景知识

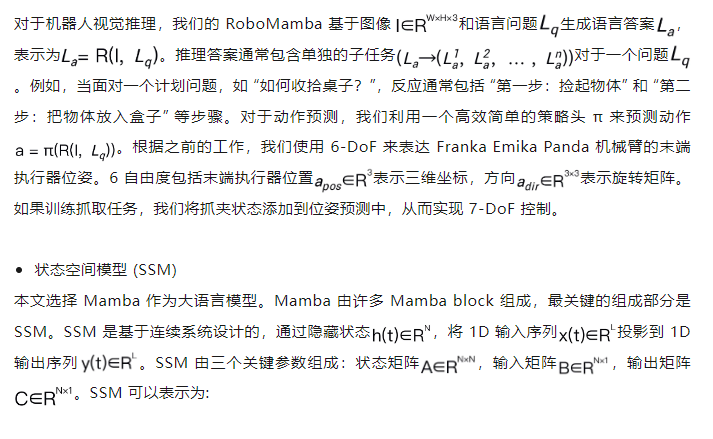
  • 问题陈述

在这里插入图片描述

图片

在这里插入图片描述

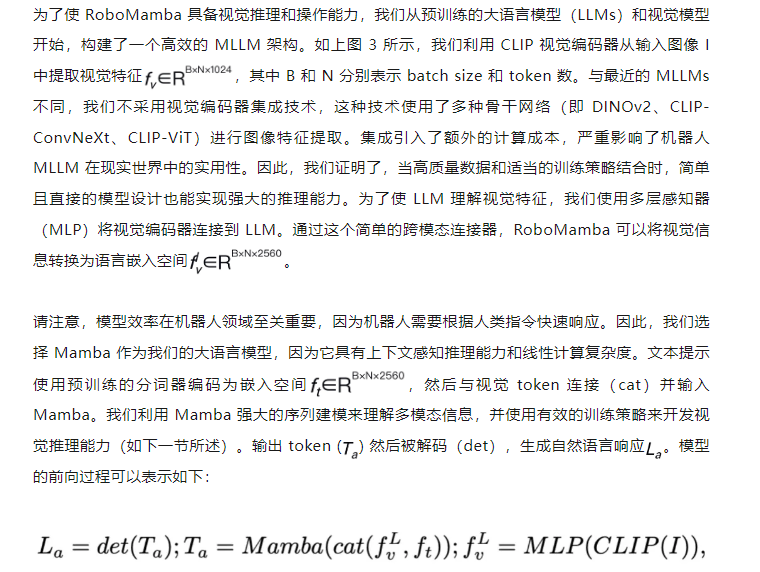
2. RoboMamba 模型结构

图片

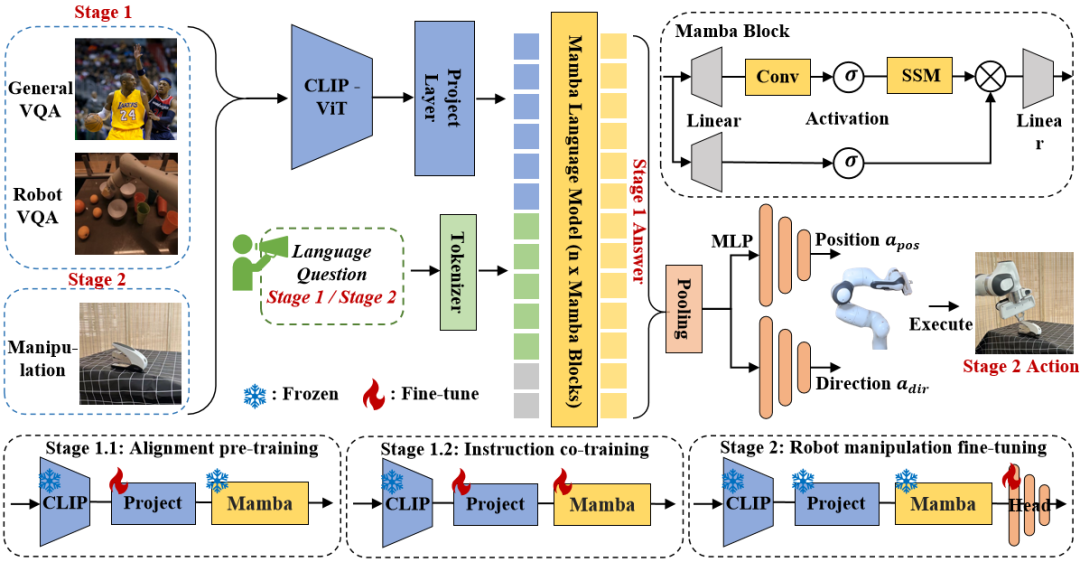
图 3. Robomamba 整体框架。RoboMamba 通过视觉编码器和投影层将图像投影到 Mamba 的语言嵌入空间,然后与文本 tokens 连接,并输入到 Mamba 模型中。为了预测末端执行器的位置和方向,我们引入简单的 MLP 策略头,并使用池化操作从语言输出 tokens 生成的全局 token 作为输入。RoboMamba 的训练策略。为了进行模型训练,我们将训练流程分为两个阶段。在 Stage 1,我们引入对齐预训练(Stage 1.1)和指令共同训练(Stage 1.2),以使 RoboMamba 具备常识推理和机器人相关的推理能力。在 Stage 2,我们提出机器人操作微调,以高效地赋予 RoboMamba Low-Level 操作技能。
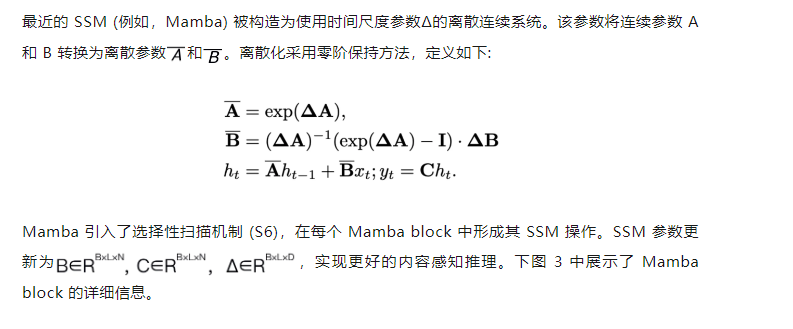
在这里插入图片描述

3.RoboMamba 通用视觉和机器人推理能力训练

在构建了 RoboMamba 架构后,接下来的目标是训练我们的模型学习通用视觉推理和机器人相关的推理能力。如图 3 所示,我们将 Stage 1 的训练分为两个子步骤:对齐预训练(Stage 1.1)和指令共同训练(Stage 1.2)。具体而言,与以往的 MLLM 训练方法不同,我们的目标是使 RoboMamba 能够理解通用视觉和机器人场景。鉴于机器人领域涉及许多复杂且新颖的任务,RoboMamba 需要更强的泛化能力。因此,我们在 Stage 1.2 阶段采用了共同训练策略,将高层次的机器人数据(例如任务规划)与通用指令数据结合起来。我们发现,共同训练不仅可以获得更具泛化能力的机器人策略,还由于机器人数据中的复杂推理任务而带来的通用场景推理能力增强。训练细节如下:

  • Stage 1.1:对齐预训练。

我们采用 LLaVA 过滤的 558k 图像 - 文本配对数据集进行跨模态对齐。如图 3 所示,我们冻结 CLIP 编码器和 Mamba 语言模型的参数,仅更新投影层。通过这种方式,我们可以将图像特征与预训练的 Mamba 词嵌入对齐。

  • Stage 1.2:指令共同训练。

在这一阶段,我们首先遵循先前 MLLM 的工作进行通用视觉指令数据收集。我们采用了 655K LLaVA 混合指令数据集和 400K LRV-Instruct 数据集,分别用于学习视觉指令跟随和减轻幻觉。需要注意的是,减轻幻觉在机器人场景中起着重要作用,因为机器人 MLLM 需要基于真实场景生成任务规划,而不是想象中的场景。例如,现有的 MLLMs 可能公式化地回答 “打开微波炉” 时说 “步骤 1:找到把手”,但许多微波炉没有把手。接下来,我们结合了 800K RoboVQA 数据集,以学习高层次的机器人技能,如长程任务规划、可操纵性判断、可操纵性生成、未来与过去预测等。在共同训练期间,如图 3 所示,我们冻结 CLIP 编码器的参数,并在 1.8m 合并数据集上微调投影层和 Mamba。所有来自 Mamba 语言模型的输出都使用交叉熵损失进行监督。

4.RoboMamba 操纵能力微调训练

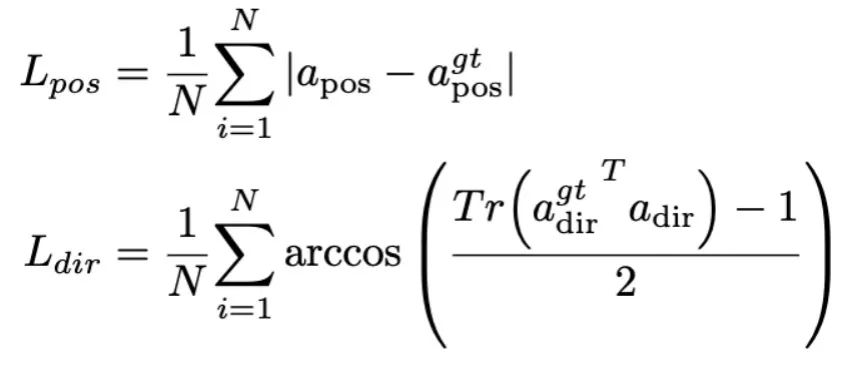
在 RoboMamba 强大的推理能力基础上,我们在本节介绍了我们的机器人操作微调策略,在图 3 中称为训练 Stage 2。现有的基于 MLLM 的机器人操作方法在操作微调阶段需要更新投影层和整个 LLM。虽然这种范式可以赋予模型动作位姿预测能力,但它也破坏了 MLLM 的固有能力,并且需要大量的训练资源。为了解决这些挑战,我们提出了一种高效的微调策略,如图 3 所示。我们冻结 RoboMamba 的所有参数,并引入一个简单的 Policy head 来建模 Mamba 的输出 token。Policy head 包含两个 MLP 分别学习末端执行器位置和方向,总共占用整个模型参数的 0.1%。根据前期工作 where2act,位置和方向的损失公式如下:
图片

其中,N 表示训练样本的数量,Tr (A) 表示矩阵 A 的迹。RoboMamba 只预测图像中接触像素的二维位置(x, y),然后使用深度信息将其转换为三维空间。为了评估这一微调策略,我们使用 SAPIEN 模拟生成了一个包含 1 万条末端执行器位姿预测的数据集。

在操作微调之后,我们发现一旦 RoboMamba 具备了足够的推理能力,它可以通过极高效的微调来获取位姿预测技能。由于微调参数(7MB)极少且模型设计高效,我们只需 20 分钟即可实现新的操作技能学习。这一发现突出了推理能力对于学习操作技能的重要性,并提出了一个新的视角:我们可以在不影响 MLLM 固有推理能力的情况下,高效地赋予其操作能力。最后,RoboMamba 可以使用语言响应进行常识和与机器人相关的推理,并使用 Policy head 进行动作位姿预测。

定量实验

1. 通用推理能力评估(MLLM Benchmarks)

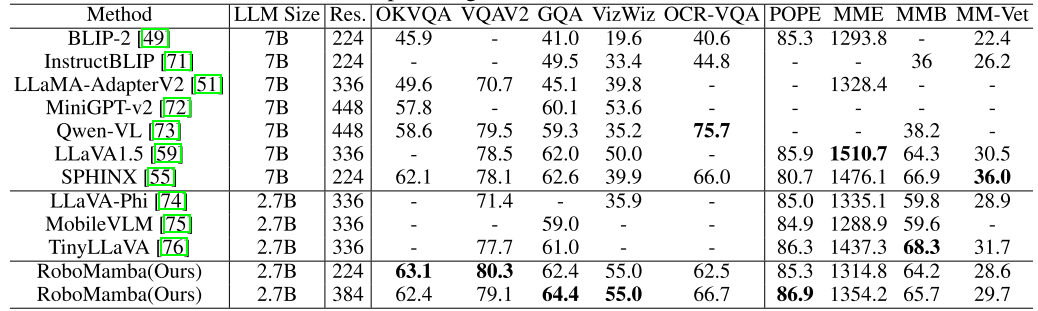
为了评估推理能力,我们使用了几个流行的基准,包括 VQAv2、OKVQA、GQA、OCRVQA、VizWiz、POPE、MME、MMBench 和 MM-Vet。除此之外,我们还在 RoboVQA 的 18k 验证数据集上直接评估了 RoboMamba 的机器人相关推理能力,涵盖了机器人任务,如任务规划、提示性任务规划、长程任务规划、可操纵性判断、可操纵性生成、过去描述和未来预测等。
图片

表 1. Robomamba 与现有 MLLMs 在多个基准上的通用推理能力比较。

如表 1 所示,我们将 RoboMamba 与以前最先进的 (SOTA) MLLM 在通用的 VQA 和最近的 MLLM 基准测试上进行比较。首先,我们发现 RoboMamba 仅使用 2.7B 语言模型,就在所有 VQA 基准测试中取得了令人满意的结果。结果表明,简单的结构设计是有效的。对齐预训练和指令协同训练显著提高了 MLLM 的推理能力。例如,由于在协同训练阶段引入了大量的机器人数据,RoboMamba 在 GQA 基准上的空间识别性能得到了提高。同时,我们还在最近提出的 MLLM 基准上测试了我们的 RoboMamba。与以前的 MLLMs 相比,我们观察到我们的模型在所有基准测试中都取得了具有竞争力的结果。虽然 RoboMamba 的一些性能仍然低于最先进的 7B MLLM (e.g., LLaVA1.5 和 SPHINX),但我们优先使用更小更快的 Mamba-2.7B 来平衡机器人模型的效率。在未来,我们计划为资源不受限制的场景开发 RoboMamba-7B。

2. 机器人推理能力评估(RoboVQA Benchmark)

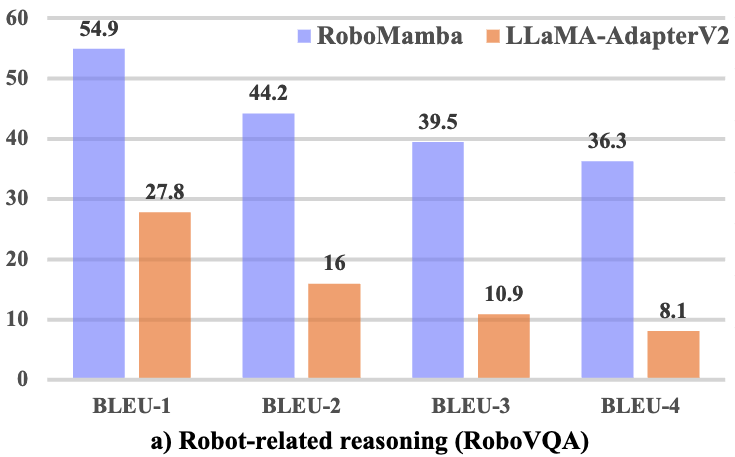
另外,为了全面比较 RoboMamba 与机器人相关的推理能力,我们在 RoboVQA 验证集上与 LLaMA-AdapterV2 进行基准测试。我们选择 LLaMA-AdapterV2 作为基准,因为它是当前 SOTA 机器人 MLLM (ManipLLM) 的基础模型。为了进行公平的比较,我们加载了 LLaMA-AdapterV2 预训练参数,并使用其官方指令微调方法在 RoboVQA 训练集上对其进行了两个 epoch 的微调。如图 4 a)所示,RoboMamba 在 BLEU-1 到 BLEU-4 之间实现了卓越的性能。结果表明,我们的模型具有先进的机器人相关推理能力,并证实了我们的训练策略的有效性。除了更高的准确率外,我们的模型实现的推理速度比 LLaMA-AdapterV2 和 ManipLLM 快 7 倍,这可以归因于 Mamba 语言模型的内容感知推理能力和效率。
图片

图 4. RoboVQA 上与机器人相关的推理对比。

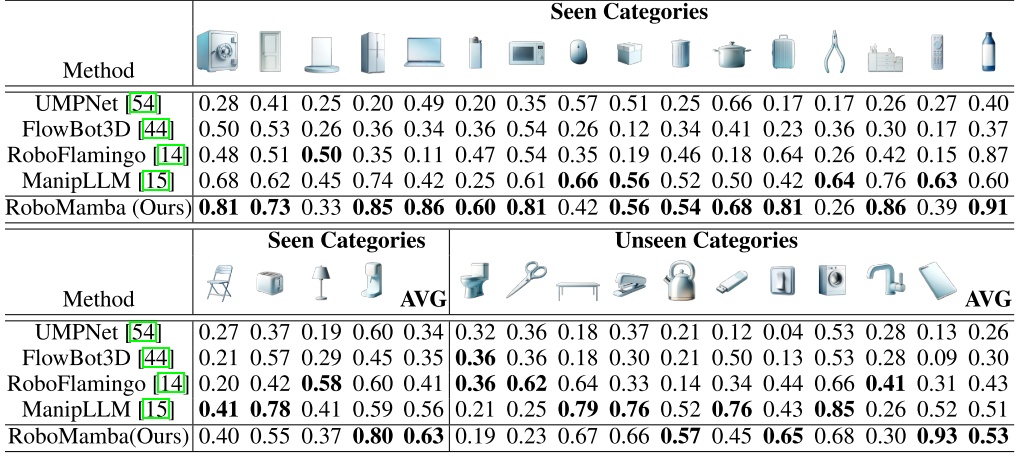
3. 机器人操纵能力评估(SAPIEN)

为了评估 RoboMamba 的操作能力,我们将我们的模型与四个基线进行了比较:UMPNet, Flowbot3D, RoboFlamingo 和 ManipLLM。在比较之前,我们复现所有基线并在我们收集的数据集上训练它们。对于 UMPNet,我们在预测的接触点上执行操作,方向垂直于物体表面。Flowbot3D 在点云上预测运动方向,选择最大的流作为交互点,并使用流方向表示末端执行器的方向。RoboFlamingo 和 ManipLLM 分别加载 OpenFlamingo 和 LLaMA-AdapterV2 预训练参数,并遵循各自的微调和模型更新策略。如表 2 所示,与之前的 SOTA ManipLLM 相比,我们的 RoboMamba 在可见类别上实现了 7.0% 的改进,在不可见类别上实现了 2.0% 的改进。在效率方面,RoboFlamingo 更新了 35.5% (1.8B) 的模型参数,ManipLLM 更新了 LLM 中的适配器 (41.3M),包含 0.5% 的模型参数,而我们的微调 Policy head (3.7M) 仅占模型参数的 0.1%。RoboMamba 比以前基于 MLLM 的方法更新的参数少了 10 倍,而推理速度提高了 7 倍。结果表明,我们的 RoboMamba 不仅具有强大的推理能力,而且能够以低成本的方式获得操纵能力。
图片

表 2. Robomamba 与其他 baseline 的成功率比较

**
**

定性结果
图片

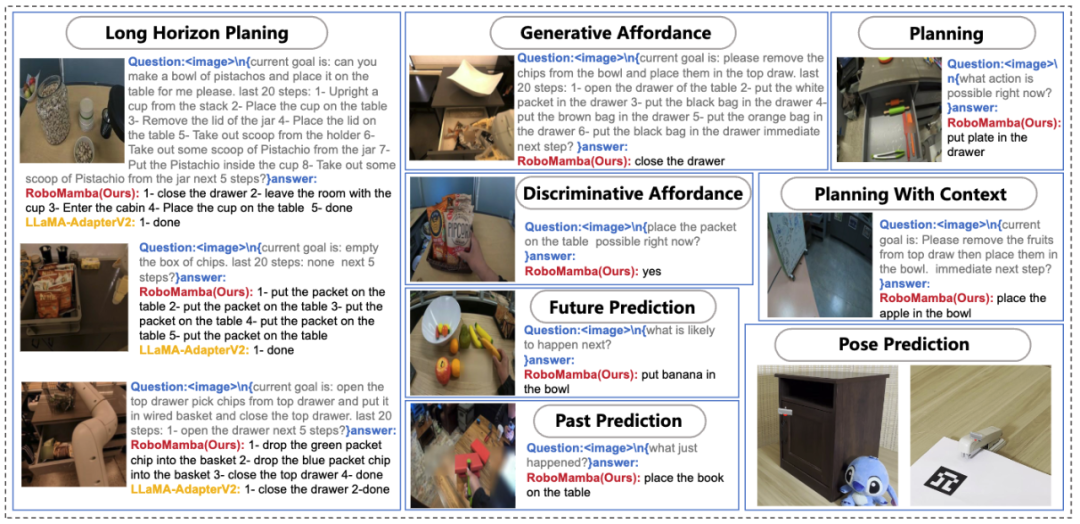
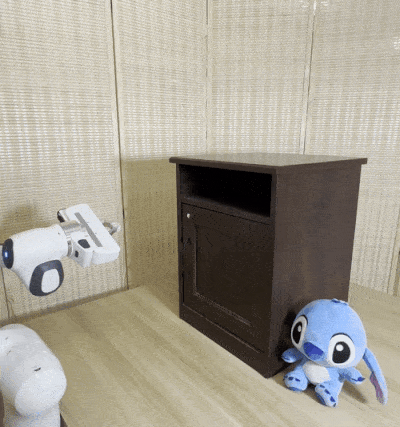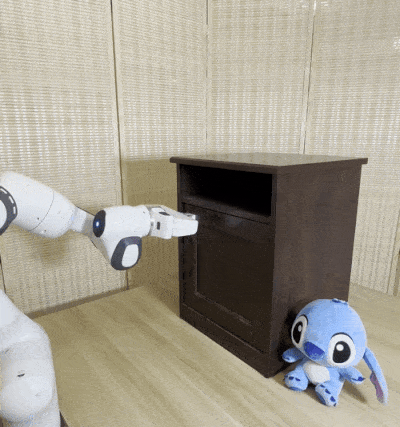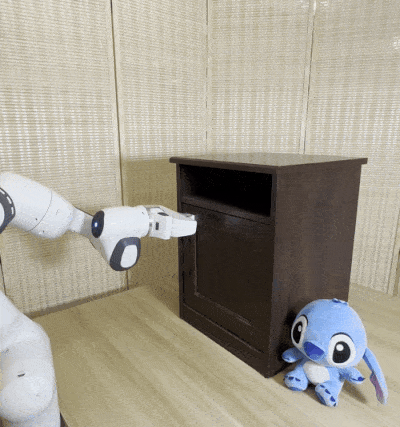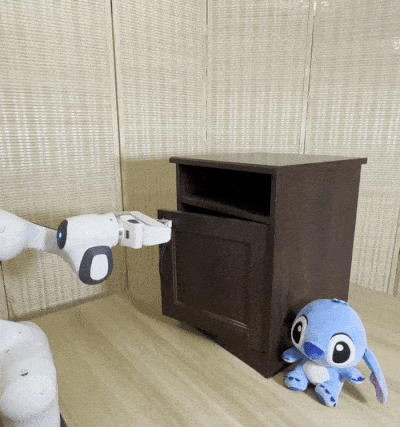
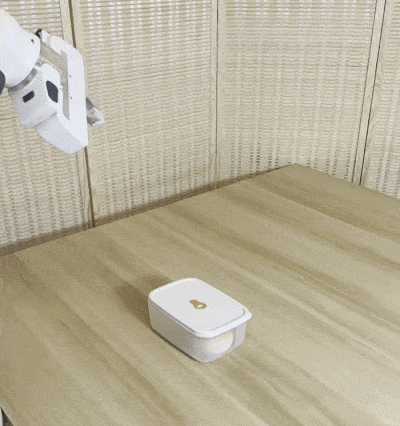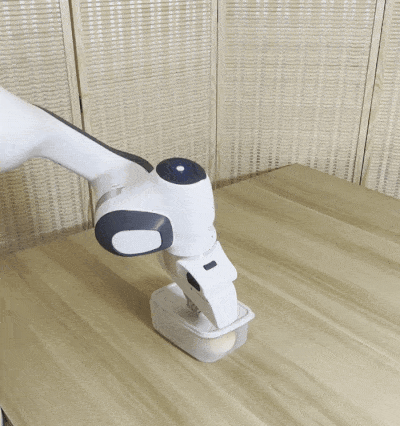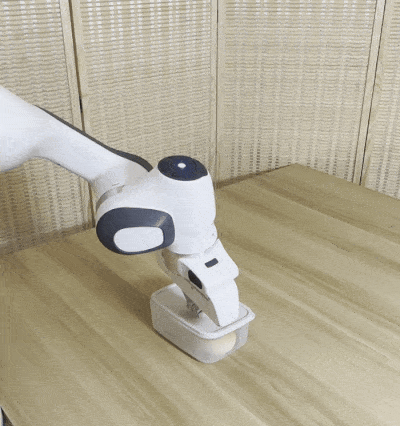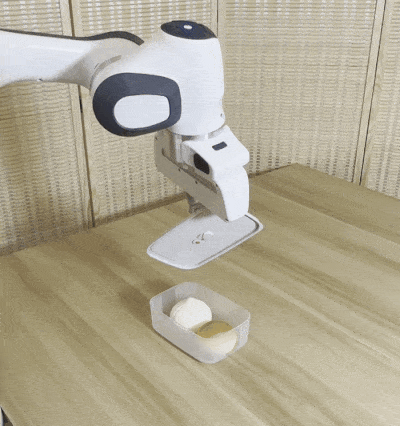
图 4. RoboMamba 面对现实世界中各种机器人下游任务的可视化。

如图 4 所示,我们可视化了 RoboMamba 在各种机器人下游任务中的推理结果。在任务规划方面,相较于 LLaMA-AdapterV2, RoboMamba 凭借其强大的推理能力,展现出了更准确、更长远的规划能力。为了进行公平的比较,我们还对 RoboVQA 数据集上的基准 LLaMA-AdapterV2 进行了微调。对于操纵位姿预测,我们使用了 Franka Emika 机械臂来与各种家庭物品进行交互。我们将 RoboMamba 预测的 3D 位姿投影到 2D 图像上,使用红点表示接触点,末端执行器表示方向,如图右下角所示。
图片

图片

图片

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Gemini不是变差了,是用错了位置:知识保真型AI的实战方法论 大语言模型并非万能工具,其核心价值取决于能力定位与任务匹配。‘知识保真’和‘语义一致性’是专业场景中决定AI输出可信度的关键技术指标,直接影响技术文档、合规报告、学术综述等高要求内容的准确性与可验证性。具备强事实召回精度与长尾知识覆盖能力的模型(如Gemini 3.1 Pro),在需要严格依据权威信源、保持逻辑锚定与跨段落一致性的任务中展现出不可替代性。本文聚焦于将模型能力光谱映射到真实工作流,通过任务拆解四象限、提示词‘框界’设计与免费版深度激活策略,实现知识协作者的精准调用。 阅读详情

相关推荐

【信息科学与工程学】信息科学领域——第一百五十五篇 IT/CT领域架构范式演进的代表性产品/技术体系01

​。

weixin_49199313的博客 101

MambaDFuse:一种基于mamba的多模态图像融合双相位模型

多模态图像融合(MMIF)旨在将来自不同模态的互补信息整合到单一的融合图像中,以全面地表征成像场景并促进下游视觉任务的完成。近年来,由于深度神经网络的进步,在MMIF任务上取得了显著的进展。然而,现有方法受到固有的局部还原性偏差(CNN)或二次计算复杂度(Transformers)的限制,无法有效且高效地提取模态特定和模态融合特征。为了克服这个问题,作者提出了一个基于Mamba的双阶段融合(MambaDFuse)模型。

qq_45880982的博客 5469

深入解析MTK DRM初始化流程:从KMS模块到组件框架

本文深入解析了联发科(MTK)平台上DRM显示框架的初始化流程。从内核模块加载、Component框架管理依赖,到核心的mtk_drm_bind函数构建KMS对象(CRTC、Plane、Encoder、Connector),最终完成DRM设备注册并创建用户空间接口。文章结合调试经验,为开发者梳理了从驱动启动到屏幕点亮的完整路径与关键排查点。

onion的博客 767

华为提出DenseMamba:大模型的DenseNet时刻!Mamba和RetNet精度显著提升

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【扩散模型和多模态】交流群添加微信:CVer444,小助手会拉你进群!扫描下方二维码,加入CVer学术星球,可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文搞科研,强烈推荐!转载自:机器之心近期,来自华为诺亚方舟实验室的研究者提出了 DenseSSM,用于增强 SSM 中各层间隐...

阿木寺的博客 652

gesp c++ 五级知识点

gesp c++ 五级知识点

MMD.然大大 2009

CAPL 中的变量类型详解与应用

CAPL 中的变量类型详解与应用

qq_42268594的博客 1448

Mamba和Transformer合体!Jamba来了:超越Transformer!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba/扩散和多模态】微信交流群添加微信:CVer5555,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!转载自:机器之心 | 编辑:小舟Mamba 时代来了?自 2017 年开创性研究论文...

阿木寺的博客 790

蛋白质组学实战指南 | (八)从数据到洞见:差异蛋白筛选与功能解析全流程

本文系统阐述了蛋白质组学数据分析中,从原始数据质控到差异蛋白筛选与功能解析的全流程。重点介绍了数据质量评估、差异蛋白筛选的统计方法(包括多重检验校正)、功能注释与富集分析,以及蛋白互作网络构建与关键节点识别。最后,为如何将生物信息学洞见转化为实验验证提供了清晰的规划思路,助力研究者完成从数据到生物学知识的闭环。

weixin_29250573的博客 372

Mamba多模态到底有多强大?“低成本高性能”属性,轻松拿捏A会!

本文提出了一种新的全层多模态交互网络(AINet),通过渐进融合Mamba实现RGBT跟踪中的高效和有效的特征交互。该网络通过四向选择性扫描融合策略,同时学习单模态局部特征和跨模态全局特征,提高了小目标的可区分性和不同类别的区分能力。2.设计了基于Mamba的选择性扫描2D机制(SS2D)的CFM模块,实现了多尺度特征的四向扫描,有效解耦密集分布的小目标,并提取全局信息。框架下,可以设计特定的模型架构来增强跨模态信息之间的交互和融合,从而实现对多模态数据的全面分析和处理。

m0_73122726的博客 942

如何在多 GPU 配置上运行 Unsloth:数据并行或模型并行

当工作负载受限于内存(模型或批次无法放入单张显卡)、或受限于计算且计算与通信比率较高时(即每块 GPU 的额外计算量超过同步参数的开销,如在 DDP 中,或超过传递激活值的开销,如在模型并行中),多 GPU 配置才开始显现优势。在松散连接的显卡上(尤其是 PCIe 版本的 H100 或 A100),额外的设备间数据传输会导致性能显著低于单 GPU 运行。让我们厘清概念,明确说明如何通过模型并行(将模型拆分到多个 GPU)或数据并行(在每个 GPU 上复制模型)来跨多 GPU 运行 Unsloth。

人工智能领域专家 646

NL2SQL实践系列(1):深入解析Prompt工程在text2sql中的应用技巧

NL2SQL实践系列(1):深入解析Prompt工程在text2sql中的应用技巧

丨汀、的博客 4327

北大新作RoboMamba:面向通用和机器人场景的高效推理!实时轻量大模型已成现实?...

点击下方卡片,关注「3D视觉工坊」公众号选择星标,干货第一时间送达来源:3D视觉工坊添加小助理:cv3d001,备注:方向+学校/公司+昵称,拉你入群。文末附3D视觉行业细分群。扫描下方二维码,加入「3D视觉从入门到精通」知识星球,星球内凝聚了众多3D视觉实战问题,以及各个模块的学习资料:近20门秘制视频课程、最新顶会论文、计算机视觉书籍、优质3D视觉算法源码等。想要入门3D视觉、做项目、搞科研,...

3D视觉工坊 542

在 Zynq 7010 上运行 VxWorks 7.0 的详细流程【持续更新】

本文介绍了在Zynq 7010开发板上运行VxWorks 7.0的完整流程。主要包括:1)使用Vivado创建硬件设计,配置Zynq模块并生成比特流文件;2)通过Workbench 4创建VxWorks工程,配置启动参数并生成镜像;3)下载运行步骤。此外还讲解了使用Workbench 4开发VSB和VIP工程的方法,包括工程创建、配置和调试流程。文中提供了关键操作截图和注意事项,为开发者提供了完整的Zynq 7010平台VxWorks开发解决方案。

weixin_45397344的博客 1223

大模型日报|6 篇必读的大模型论文

大模型日报|6 篇必读的大模型论文

AMiner2006的博客 1135

npm报错 npm WARN deprecated....的问题解决方式

报错 :npm WARN deprecated … 现象:无法进行有效的vue项目的部署以及npm install 命令的执行。 原因一:版本问题 说明:由于npm的版本过低或者过高导致的报错 检查版本: npm -v 如果版本是比较旧的,或者是最新的,这里可以进行对npm的更新和回退。 更新npm版本: npm updated -d 查看可以更新的版本 npm install -g npm 默认安装最新版本 安装回退指定的版本: npm updated -d 查看所有的版本 npm -g i.

任聪聪的博客 16万+

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

自回归统一建模的原生多模态大模型

摘要:自回归多模态大模型采用"下一个token预测"技术,将文本、图像、视频等统一编码为离散token进行联合训练,实现跨模态理解与生成。代表模型包括智源Emu3、北大VARGPT等,在图像生成、视觉问答等任务表现优异。该技术优势在于参数共享和端到端处理,但面临计算效率低、数据需求大等挑战。应用涵盖机器人、数字人生成、AI搜索等领域,是迈向AGI的重要路径,仍需在训练效率等方面持续优化。

Matathe的博客 873

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2317

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

腾讯开源HY-MT1.5翻译模型,英伟达发布Rubin架构与Alpamayo模型

近期AI领域迎来多项重要开源成果:腾讯推出HY-MT1.5翻译模型,包含端侧1.8B和服务器7B版本,性能超越主流产品;中国电信开源千亿MoE大模型TeleChat3,实现全栈国产化;英伟达发布Rubin架构与Alpamayo模型,降低AI推理成本;MMSI-Video-Bench评测显示多模态模型空间智能与人类差距显著;北大Paper2Any实现科研绘图与PPT自动生成;陈天桥团队MiroThinker 1.5以30B参数媲美千亿级性能;九坤开源IQuest-Coder-V1代码大模型,创新Code-Fl

TechTrek的专栏 723

中国生成式AI大会,涵盖大模型、AI Infra、端侧AI、视频生成和具身智能等方向...

12月5-6日,2024中国生成式AI大会(上海站)「GenAICon 2024」将在上海中星铂尔曼大酒店盛大举办。中国生成式AI大会已成功举办两届,迅速成长为国内生成式AI领域最具影响力的产业峰会之一。此次也是中国生成式AI大会首次登陆上海举办。大会由智一科技旗下智能产业第一媒体智东西、AI与硬科技知识分享社区智猩猩共同发起主办。上海市人工智能行业协会为大会的指导单位。大会上海站由“主会场峰会+...

深度学习技术前沿 494

【Reading Notes】(6)Favorite Articles from 2023

Feature-Based Knowledge,一般而言,在基于特征的知识迁移中,研究的对象包括了:如何需选择知识类型?对于台积电的客户来说,这个数字是难以接受的,因为客户需要为整个晶圆买单,包括其中有缺陷的芯片。最后大家采取了一个折中方案,4号线经过北大的789米轨道段,将采用世界上最先进的轨道减振技术,也就是在钢轨下铺设钢弹簧浮置板。毕竟,有苹果这样的金主愿意成为台积电新制造工艺的第一个客户,能分担台积电先进制程节点的研发费用和专用工厂的建设费用。(2023年01月01日)(2023年01月04日)

bryant_meng 1717

中文大语言模型完全指南:100+开源资源一站式获取

你是否正在寻找高质量的中文大语言模型资源?Awesome-Chinese-LLM项目为你整理了一份完整的中文LLM资源清单,涵盖从基础模型到垂直领域应用的100+开源项目。这个资源库特别关注规模较小、可私有化部署且训练成本较低的模型,是中文AI开发者的必备宝典。 ## 📊 项目概览:中文LLM的生态全景图 Awesome-Chinese-LLM项目系统性地整理了中文大语言模型的全景生态,包括

gitblog_00158的博客 361

前沿 | 具身智能的“大脑”与“小脑”:整体架构与小脑运控分析

摘要: 本文基于生物“大脑-小脑”分工机制,系统剖析具身智能机器人的分层架构设计。其中,“大脑”负责感知决策(如VLA大模型、分层规划),解决“做什么”问题;“小脑”专注运动控制(模型预测、模仿学习、强化学习),解决“怎么做”问题。文章详细对比了三大控制技术路线的优劣,指出强化学习在步态控制中的主导地位,并探讨力控与运控的融合趋势。通过构建从架构设计到算法实现的完整技术地图,为具身智能的“双脑协同”发展提供系统性参考。

Robot-Nav的博客 2934

51c深度学习~合集8

方法的完整数学描述略显复杂,如果只是想了解主要思想,可以只看上面 PatchMix的流程图即可(其实只是公式多,每个公式也不复杂,后续有机会做个演示动画,帮助大家理解。这个方法也可以用简单的 Mask 方法实现,但是本方法在大规模图像处理上效率是最高的),对该工作感兴趣的同行可以看一下,我尽量写得清楚一些。结合 PatMix 的流程图,主要过程如下:由于混合图像和混合图像之间,重叠比例的不同,mix-to-mix label 中每一项的权重分数是不同的,根据上图,可以得到权重系数可以表示为。

whaosoft~aiotの开发板商城 2962

极市平台 | 首个Mamba+Transformer混合架构多模态大模型来了,实现单卡千图推理

LongLLaVA(长上下文大型语言和视觉助手)这一创新性混合架构模型,在长上下文多模态理解方面表现出色。该模型集成了 Mamba 和 Transformer 模块,利用多个图像之间的时空依赖性构建数据,并采用渐进式训练策略。

csdn_xmj的博客 2050

创飞CNN和Transformer!Mamba+多模态图像融合,性能速度双巅峰!霸榜顶会!

Mamba的引入,给多模态图像融合带来了全新的视角,使图像融合的质量和效率都得到了显著提升!这是因为,以往主要是用CNN和Transformer做多模态图像融合。但CNN无法捕捉全局信息;Transformer囿于二次计算复杂度,计算开销大。而Mamba同时具有长距离依赖建模和计算效率高的优势,能够克服两者的局限。比如模型FusionMamba便通过结合Mamba,不仅性能提升25.5%,在视觉上也展现了更多细节!此外,Mamba作为新模型,当下还在蓝海阶段,创新空间很大。

2401_88190197的博客 1389
上一篇: Transformer 模型的 PyTorch 实现
下一篇: 深度剖析现阶段的多模态大模型做不了医疗
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值