


一、前言
知识库问答是一种应用广泛的系统,可以在许多领域发挥重要作用。不过以往的系统通常是基于固定规则、相似度检索或者seq2seq模型,这类系统开发成本较高、修改也较为麻烦,尤其在数据准备过程需要耗费大量精力。
而大语言模型(LLM)的出现打破了这种局面,在LLM的加持下,无论是系统编写还是数据准备上,工作量都大大减少,可以使用百行代码实现非常智能的知识库问答系统。
本文将分享使用开源LLM,完全离线部署知识库问答系统。
二、前置知识
2.1 大语言模型
语言模型是自然语言处理领域中一个非常重要的概念,语言模型是评估一串有序字符是句子的概率的一种模型。比较经典的有Bert系列、GPT系列等。而现在常说的大语言模型更多是指GPT系列的模型。
以往的GPT模型的训练方式非常简单,就是根据一个句子的前n个词,预测第n+1个词。这种看似非常简单的方式,却给GPT带来了非常大的自由度。
2.2 Prompt工程
比如我们可以直接把GPT应用在情感分析上,我们只需要设置一下输入的前n个词,比如:
“这部电影真烂”的情绪是
然后GPT就可以预测下一个词以及下下个词,最后得到结果“消极”。或者我们可以输入:
这部电影真烂, 消极
太好看了,
然后GPT就可以预测出“积极”。或者我们输入的内容还可以更长:
这部电影真烂, 消极
xxxx, 积极
xxxx, 消极
太好看了,
上面这种通过改变输入内容让GPT输出特定结果的方式就叫做prompt工程,通过修改prompt,我们可以让GPT完成更复杂的工作,比如问答、翻译等。下面以翻译为例,我们只需要输入prompt:
中文:不要温顺的走进那个良夜
英文:
这样就可以让GPT输出句子的英文。
2.3 模板
上面我们列举了一些Prompt示例,在实际使用时,输入的Prompt有部分内容是动态修改的,这部分可以用一些占位符来占位,比如:
这部电影真烂, 消极
{sentence},
我们只需要输入句子s,然后用s替换掉prompt中的{sentence}(字符串替换),就得到了最终输入GPT的Prompt,上面这种带有占位符的Prompt就是模板。
2.4 RLHF
早期的GPT是无监督学习,就是前面描述的根据前n个词预测下一个词。而现在主流的类GPT模型都是使用无监督学习+RLHF的方式。
首先无监督学习部分和早期GPT是一样的,做文字接龙或者类似句子接龙等任务。而RLHF则是基于人类反馈的强化学习,在这个过程中会有人类老师帮助GPT纠正输出,让GPT输出更符合人类的对话形式。也正是RLHF造就了ChatGPT。
三、实现原理
3.1 基于检索的问答
在Bert时代,还有一种基于向量相似度的问答系统。这种系统非常简单,但是前期数据的收集需要花费较多的时间,这种系统与本文要讨论的系统有许多相似的地方。
首先我们需要收集大量的问答对,比如:
江西是省会是哪?南昌
北京是南方还是北方?北方
...?xx
收集完成后,使用bert提取问题的特征向量,然后存储到向量数据库。在提问时,提取问题的特征向量,并检索出最相似的问题,并返回对应答案。

3.2 基于大语言模型知识库问答
基于检索的问答系统有几个问题,因为数据需要问答对的形式,因此数据收集需要消耗大量时间。另外回答的内容是固定的,因此输入同一个问题,会得到相同的结果。在某些系统中,这是个优点,但是如果是客服系统则过于机械。
基于大语言模型的知识库问答的也需要借助向量数据库。下面是具体实现步骤:
- 收集大量文档数据
- 对文档进行拆分,拆分成多个段
- 使用Bert等模型将每段文档进行embedding(提取特征向量)并存储到数据库
- 根据问题检索到k段最相关的文档
- 将文档注入Prompt,利用大语言模型回答问题。
首先是数据收集,我们不再需要问答对形式,只需要处理干净的文档形式,这样就减少了大量的工作。
因为文档通常比较大,而Bert模型(在这里也称为Embedding模型)有上下文长度的限制,因此需要将文档拆分成Embedding模型限制的大小。
而提取embedding和存储向量数据库部分则和3.1是一样的。因为文档有上下文大小的限制,同时某一个问题可能出现在文档的多个位置,因此检索时返回k个相关文档段。
最后利用Prompt工程+LLM完成最后的问答。下图是取自Llamindex的一张图:

四、代码实现
4.1 LLM
首先需要选择一个LLM,现在LLM百花齐放,可以选择的开源方案有很多,包括ChatGLM、Llama2等。这里选择Llama2作为LLM。而Llama2的部署方式也是多种多样,这里使用llamacpp部署,我们需要安装llama-cpp-python模块:
pip install llama-cpp-python
另外还需要编译转换Llama2的模型文件。具体方式参考: www.bilibili.com/video/BV1m3…
然后只需要编写下面的代码就可以运行llama2:
from llama_cpp import Llama

model_path = "llama-2-13b-chat.Q4_0.gguf"
llm = Llama(
    model_path=model_path,
    n_ctx=2048,
    chat_format="llama-2"
)
response = llm('Human:你好啊\nAssistant:', stop=['Human:'])
print(response['choices'][0]['text'])
4.2 文档处理
文档处理对应3.2中的前三步,我们可以使用langchain来完成这步操作,代码如下:
import os
from langchain.document_loaders import DirectoryLoader
from langchain.text_splitter import CharacterTextSplitter
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
from langchain.vectorstores import Chroma

# 加载embedding
embedding_model_dict = {
    "ernie-tiny": "nghuyong/ernie-3.0-nano-zh",
    "ernie-base": "nghuyong/ernie-3.0-base-zh",
    "text2vec": "GanymedeNil/text2vec-large-chinese",
    "text2vec2": "uer/sbert-base-chinese-nli",
    "text2vec3": "shibing624/text2vec-base-chinese",
}


def load_documents(directory="documents"):
    """
    加载books下的文件,进行拆分
    :param directory:
    :return:
    """
    loader = DirectoryLoader(directory)
    documents = loader.load()
    text_spliter = CharacterTextSplitter(chunk_size=256, chunk_overlap=0)
    split_docs = text_spliter.split_documents(documents)
    return split_docs


def load_embedding_model(model_name="text2vec3"):
    """
    加载embedding模型
    :param model_name:
    :return:
    """
    encode_kwargs = {"normalize_embeddings": False}
    model_kwargs = {"device": "cuda:0"}
    return HuggingFaceEmbeddings(
        model_name=embedding_model_dict[model_name],
        model_kwargs=model_kwargs,
        encode_kwargs=encode_kwargs
    )


def store_chroma(docs, embeddings, persist_directory="VectorStore"):
    """
    讲文档向量化,存入向量数据库
    :param docs:
    :param embeddings:
    :param persist_directory:
    :return:
    """
    db = Chroma.from_documents(docs, embeddings, persist_directory=persist_directory)
    db.persist()
    return db


# 加载embedding模型
embeddings = load_embedding_model('text2vec3')
# 加载数据库
if not os.path.exists('VectorStore'):
    documents = load_documents()
    db = store_chroma(documents, embeddings)
else:
    db = Chroma(persist_directory='VectorStore', embedding_function=embeddings)
我们在当前目录下准备一个documents文件夹,在里面放入我们的txt文档即可。在langchain里面内置了包括json、csv、PDF等文档处理的类,这里可以根据自己的需求修改load_documents函数。这里需要注意两个参数:
text_spliter = CharacterTextSplitter(chunk_size=256, chunk_overlap=0)
上面这句是拆分文档的代码。其中chunk_size是每段的长度,而chunk_overlap则是两个段之间重叠的大小。chunk_size可以根据电脑性能、Embedding模型上下文限制、LLM上下文限制来确定。而chunk_overlap可以选0.1或0.5*chunk_size。
另外上面加载的模型都是中文的Embedding,如果有其它语言需求,可以选择用多语言的Bert作为Embedding。具体参考sentence-transformers可用的模型。
4.3 将文档注入Prompt
在输入前,需要先检索相关的文档,比如我存储了“塞尔达王国之泪”的攻略,使用下面代码搜索“究极手”相关内容:
docs = db.similarity_search('究极手是干啥用的', k=5)
for doc in docs:
    print(doc)
得到如下输出:
page_content='尝试用右手打开神殿大门但以失败告终,这是一个自称“劳鲁”的灵体出现在了林克的身后。劳鲁告诉林克需要去岛上的神庙中回复手臂的力量才能打开大门。\n\n来到神殿旁的第一个神庙。\n\n【乌可乌侯神庙—创造之力】\n\n进入神庙与劳鲁对话,获得第一个能力—究极手。\n\n用究极手能力抓取板子搭在两个平台之间,然后再通过。\n\n来到第二个平台后,通过的方法大致相同,不过需要将旁边两块板子拼合成更长一点的长板。\n\n来到神龛前的平台,用一旁的铁钩和木板组合成一个简单移动平台,接着将移动平台挂在铁轨上,站在上面抵达对面。' metadata={'source': 'documents\\王国之泪游侠攻略.txt'}
page_content='还有一个神庙在雪山上。\n\n神庙附近有个呀哈哈,追上发光的物体即可抓到。\n\n接下来我们按照逆时针方向,把初始空岛探索一遍。(顺指针走也行,但是逆时针走对新手来说是更好的体验)\n\n继续往西走有两条路。\n\n可以在神庙下方直接用木板搭桥过去。\n\n也可以到附近的山头上,组合铁钩和木板,从铁轨滑过去。\n\n第3页:初始空岛\n\n西部\n\n初始空岛\n\n西部\n\n来到初始空岛西部,与劳鲁对话。对话木匠魔像学习砍树,旁边树桩上拿到斧子。\n\n用斧子砍树得到圆木,圆木可以组合起来作为立足处,也可以进一步劈开做成木柴。' metadata={'source': 'documents\\王国之泪游民攻略(上).txt'}
page_content='回湖边想办法渡水,因为风是向南刮的,把帆插在木筏上,就可以顺风过去,抵达第二个神庙。(有种孙悟空出海找寻菩提祖师的感觉哈哈)\n\n第4页:初始空岛\n\n伊恩伊萨神庙\n\n初始空岛\n\n伊恩伊萨神庙\n\n走上楼梯,进入神庙。\n\n拾起双手剑。\n\n使用余料建造能力,把石头安装到双手剑上,组合成石锤。(余料建造能力也有多种玩法,也可以给自己的盾上安装东西)\n\n用石锤就可以砸开挡路的石块了。\n\n看左边水池,高处有个宝箱,用石锤打碎石柱即可拿到宝箱。' metadata={'source': 'documents\\王国之泪游民攻略(上).txt'}
page_content='把立方块放到弹射器上,然后踩按钮,立方块就会被往上弹射。\n\n站在立方块上,用时光倒流上升,然后就能滑翔到终点了。\n\n神庙北面的路通往迷雾森林,暂时进不去以后再说。路上齐洛利森林有个深穴,通往地底。\n\n第153页:奥尔汀地区\n\n大妖精之泉(蒂拉)\n\n奥尔汀地区\n\n大妖精之泉(蒂拉)\n\n回到驿站,把两个轮子粘上,帮乐团修好车。\n\n给马装上牵引挽具,骑马拖着车带他们去大妖精之泉。\n\n乐团唤醒蒂拉后,她会为你标出另外三个大妖精之泉的位置。' metadata={'source': 'documents\\王国之泪游民攻略(上).txt'}
page_content='进入神庙发现黑漆漆的,可以把之前获得的采矿套装穿上照亮身旁。不过最好使的还是光亮花,建议多射几个把整个迷宫照亮。\n\n进入迷宫先右拐,用究极手拿出右侧墙壁上的石块,里面有个宝箱,用究极手把宝箱抓出来。\n\n继续往前走,岔路口右拐有个宝箱。\n\n继续往前走,岔路口右拐,把地板揭开有个宝箱,宝箱里拿到小钥匙。\n\n继续往前走,抬头看上面,用通天术上去有个宝箱。\n\n继续往前走,激光后面有个宝箱。\n\n回到入口,用小钥匙开门抵达终点。\n\n第142页:海拉鲁大森林\n\n奇乌悠悠乌神庙\n\n海拉鲁大森林\n\n奇乌悠悠乌神庙' metadata={'source': 'documents\\王国之泪游民攻略(上).txt'}
基于LLM的知识库问答需要一个特殊的Prompt来完成,具体如下如下:
根据下面的上下文(context)内容回答问题。
如果你不知道答案,就回答不知道,不要试图编造答案。
答案最多3句话,保持答案简介。
总是在答案结束时说”谢谢你的提问!“
{context}
问题:{question}
然后需要将文档注入到如下的Prompt里面,代码如下:
template = """
根据下面的上下文(context)内容回答问题。
如果你不知道答案,就回答不知道,不要试图编造答案。
答案最多3句话,保持答案简介。
总是在答案结束时说”谢谢你的提问!“
{context}
问题:{question}"""
query = "究极手是干啥用的"
docs = db.similarity_search(query, k=5)
context = "\n".join([f"{idx + 1}.{doc.page_content}" for (idx, doc) in enumerate(docs)])
prompt = template.format(context=context, question=query)
print(prompt)
最后只需要将这个Prompt输入给LLM即可:
response = llm(f'Human:{prompt}\nAssistant:', stop=['Human:'])
print(response['choices'][0]['text'])
最后输出结果如下:
嗯,究极手是一种非常实用的能力,可以用于装配和拆解各种物品,以及对盾牌和武器进行合成拆卸。你可以用它来组合材料、砍树、打碎石块等,也可以在各种情况下进行优化和适应。
可以看到回答结果部分是正确的。
五、总结
在LLM的加持下,知识库问答的实现变得非常简单。而且现在有诸如langchain、Llamaindex之类的框架集成了许多与LLM相关的操作。另外现在LLM的开源社区非常活跃,出现了诸如Llama2、mistral-7b等优秀的开源LLM。不管是参数量、资源消耗、训练速度等都降低到在消费级显卡上完成。
chatglm实现方案: github.com/IronSpiderM…
llama2模型下载地址: 链接:pan.baidu.com/s/1UFp-kY3u… 提取码:kxwa
如何学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
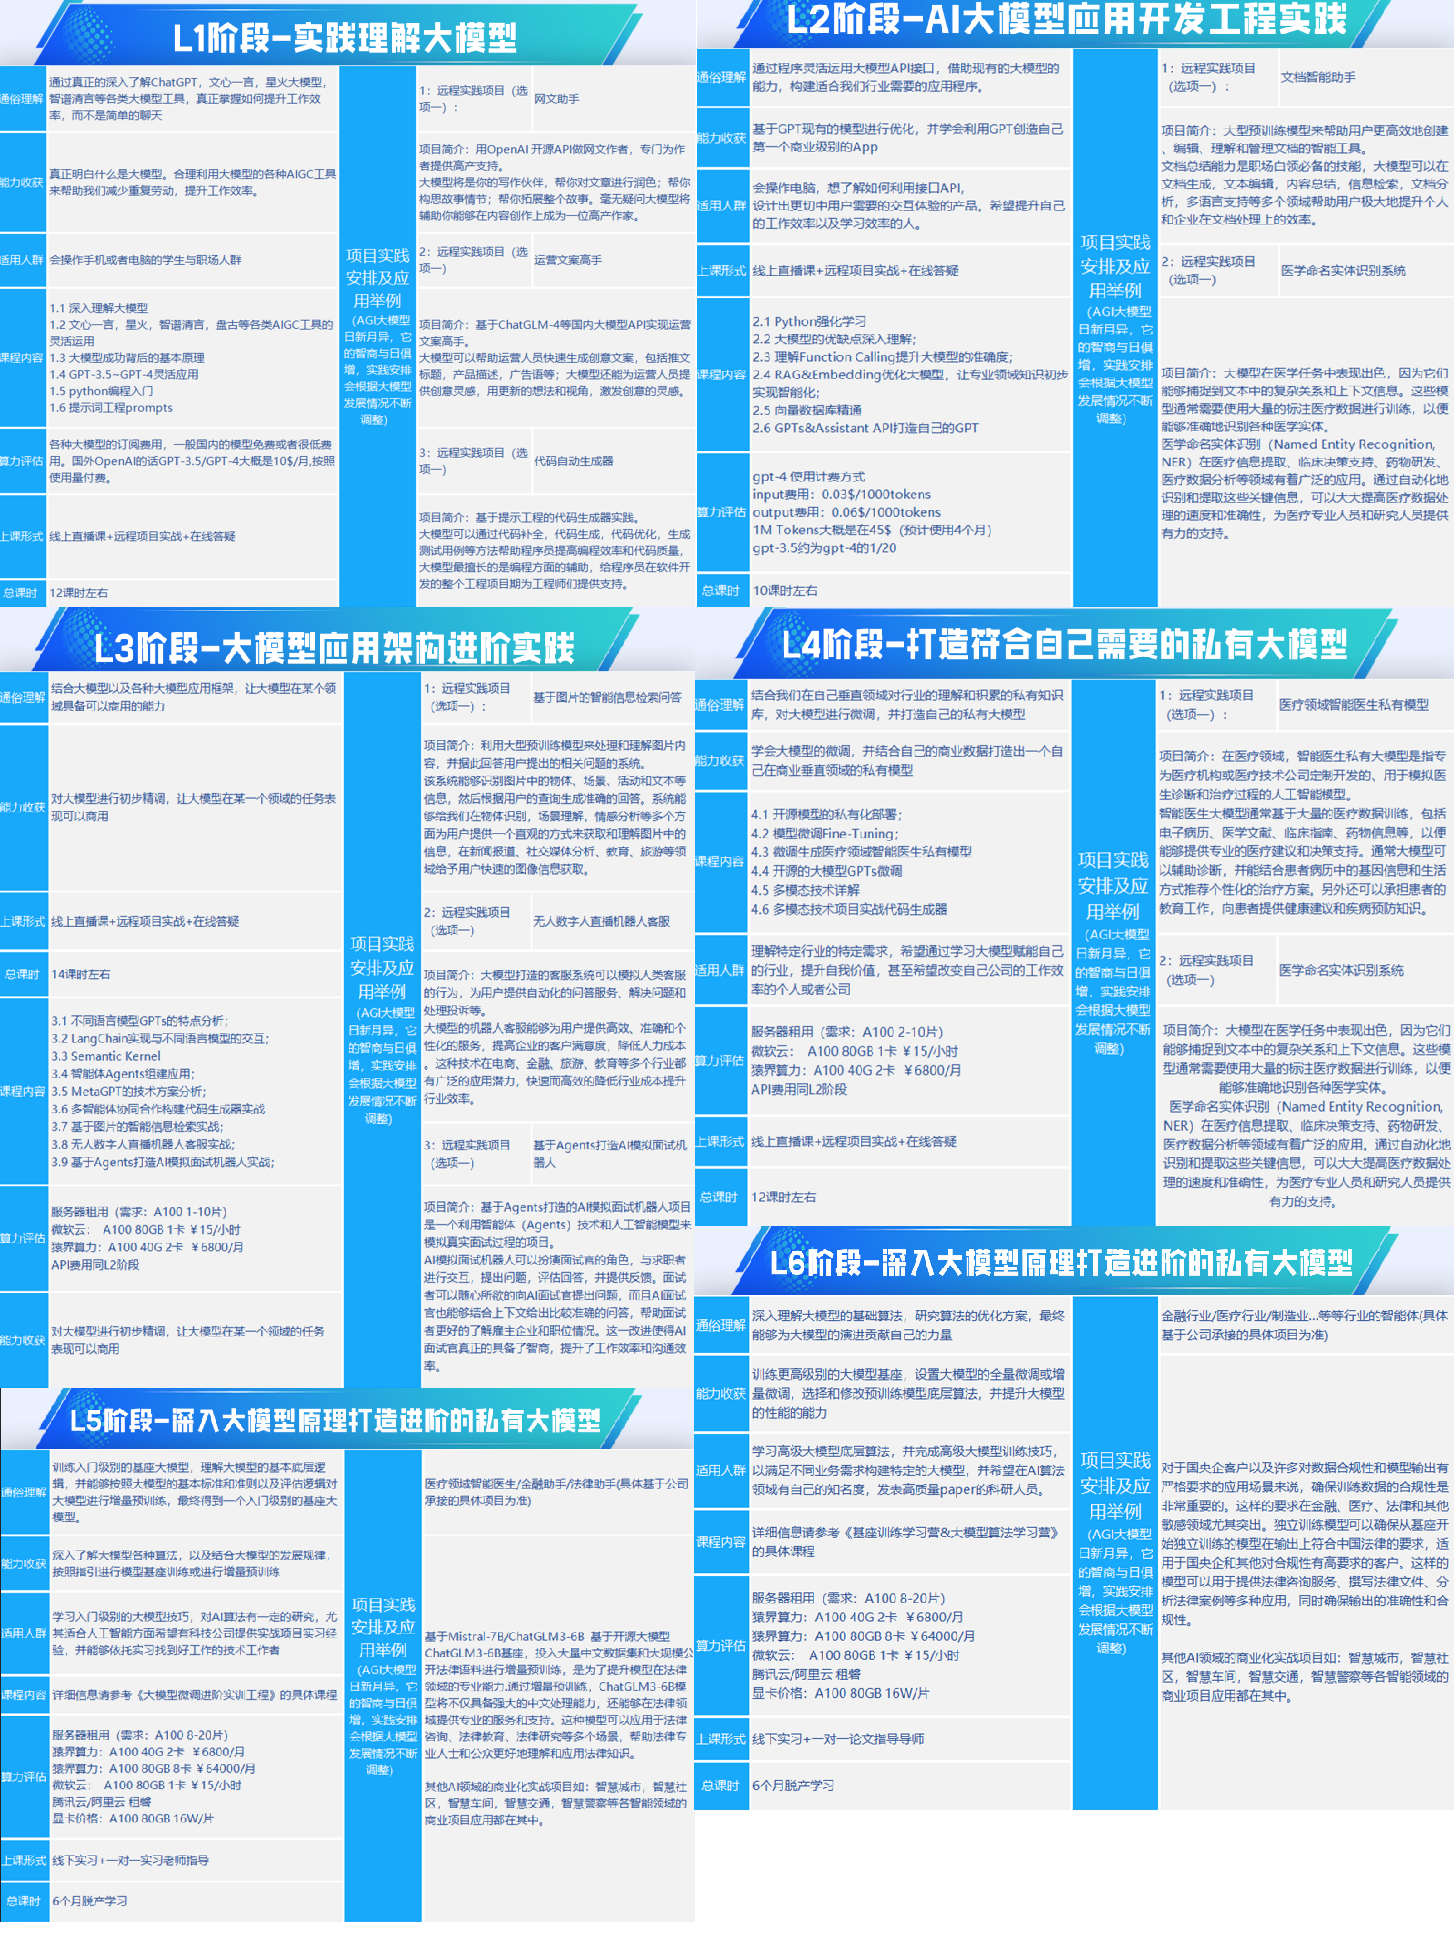
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 1053


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


