解码通用 AI Agent:七步构建你的智能系统

2017款MacBook:OpenClaw本地AI Agent的最佳硬件载体 macOS本地AI Agent是指能在用户设备端直接调用系统API、执行真实操作(如键鼠控制、USB设备管理、窗口自动化)的智能体运行时框架。其技术实现高度依赖内核扩展支持、无障碍权限体系与底层I/O可控性。在苹果逐步收紧安全策略的背景下,2017款MacBook(MacBook 8,1)因无T2芯片、开放EFI固件、兼容SIP关闭后稳定运行等特性,成为当前极少数可深度定制的Intel Mac平台。它支撑OpenClaw等框架完成剪贴板劫持、HID设备接管、声卡驱动修复等关键能力,广泛应用于合同自动化处理、 阅读详情

编者按: 如何才能打造一个能够灵活应对多样场景、高效执行复杂任务的通用智能体系统?传统的硬编码流程已经无法满足快速变化的需求,而简单的提示词模板又显得过于僵化和脆弱。

本文作者详细阐述了从零构建通用 LLM Agent 的七个关键步骤,为读者提供了一个从模型选择、控制逻辑设计到工具集构建、规划后续行动的完整路径。这套方法论不仅仅来自理论推演,更凝聚了作者在实际项目中的宝贵经验。通过对模型能力、行为模式、内存管理等关键环节的深入剖析,本文为读者呈现了一个真实的、可落地的通用 AI 智能体构建蓝图。

在这里插入图片描述

LLM Agent 高层次概述(图片由原文作者提供)

为什么要构建通用 Agent?因为这是一个很好的工具,可以为我们的目标使用场景提供原型,并为设计我们自己的定制 Agent 架构奠定基础。

在我们继续深入之前,先快速介绍一下 LLM Agent。如果您已经了解,可以跳过这部分。

01 什么是 LLM Agent?

LLM Agent 是一种程序,其执行逻辑由底层模型控制。

在这里插入图片描述

从独立的 LLM 到具备 Agent 功能的系统。(图片由原文作者提供)

LLM Agent 与简单的少量样本提示(few-shot prompting)或预设工作流程的不同之处在于,它能够制定并调整执行用户查询所需的步骤。 当拥有诸如代码执行或网络搜索等工具集的访问权限时,Agent 能够自主决定使用何种工具、如何使用,并依据输出结果进行迭代优化。这种灵活性使得系统能够以极低的配置需求应对多样化的场景。

在这里插入图片描述

LLM Agent 架构谱系。(图片由原文作者提供)

Agent 架构存在于一个连续的变化范围内,从固定工作流程的可靠性到 autonomous agents 的高度灵活性。例如,像检索增强生成(RAG)[1]这样的预设流程,可以通过加入自我反思循环(self-reflection loop)来提升改进,使得程序在初次响应不充分时能够进行改进。另一方面,ReAct[2] Agent 可以配备预设流程作为其工具之一,实现一种既灵活又有条理的处理方式。架构的选择最终应根据具体应用场景以及可靠性与灵活性之间的平衡需求来决定。

想要更全面的了解,请观看此视频[3]。

02 让我们从头开始打造一款通用 LLM Agent

第一步:挑选合适的 LLM

挑选合适的模型是实现预期性能的关键。在决策时,需考虑多个因素,如版权许可、成本和语言支持。对于构建 LLM Agent 来说,最关键的考虑因素是模型在核心任务上的表现,例如编程、调用工具和逻辑推理。以下是一些评估标准:

  • 大规模多任务语言理解(MMLU)[4](用于推理能力评估)
  • 伯克利大学的函数调用排行榜[5](用于工具的选择与调用能力评估)
  • HumanEval[6] 和BigCodeBench[7] (用于编程能力评估)

此外,模型的处理窗口大小也非常重要。Agent 的工作流程可能会消耗大量 token —— 有时甚至超过 10 万个 —— 因此,更大的处理窗口将大大提高处理效率。

当前值得关注的模型(本文撰写时)包括:

  • 前沿模型:GPT4-o[8],Claude 3.5[9]
  • 开源模型:Llama 3.2[10],Qwen 2.5[11]

一般来说,模型越大,性能越优越。但能够在本地运行的小型模型也是一个不错的选择。小型模型通常适用于较为简单的场景,并且可能只能与一到两个基础工具对接。

第二步:设定智能体的控制逻辑(亦称为通信结构)

在这里插入图片描述

单智能体(single Agent)架构图示。(图片由原文作者创作)

简单大语言模型(LLM)与智能体(Agent)之间的核心差异,主要体现在系统提示词上。

就 LLM 而言,系统提示词[12]是指在模型开始处理用户查询前,提供给模型的一系列指令和背景信息。

我们可以通过系统提示词来编码大语言模型应展现的智能体行为。

以下是一些常见的智能体行为模式,它们可以根据您的具体需求进行调整:

  • 工具运用:智能体判断何时应将问题转交给适当的工具处理,或是依赖自身知识库。
  • 自我反思:智能体在回复用户前,会审视并修正自己的答案。大多数 LLM 系统也可以加入这一反思过程。
  • Reason-then-Act(ReAct) :智能体通过反复推理来确定解决问题的方法,执行操作,观察结果,并决定是否需要进一步行动或直接给出回答。
  • Plan-then-Execute:智能体通过将任务细分为多个子步骤(如有必要)来进行事前规划,然后逐一执行这些步骤。

在构建通用单智能体时,ReAct 和 Plan-then-Execute 这两种模式通常是起步的最佳选择。

在这里插入图片描述

常见智能体行为模式概览。(图片由原文作者创作)

为了有效地实现这些行为模式,我们需要对提示词进行精心设计。可能还需要采用结构化生成技术[13],这意味着会调整 LLM 的输出,使其符合特定的格式或架构,从而确保智能体的回复与我们所追求的沟通风格保持一致。

举例:下面是 Bee Agent Framework[14] 中一个 ReAct 风格智能体的系统提示词片段。

在这里插入图片描述

第三步:设定智能体的核心指令

我们往往会想当然地认为,大语言模型(LLMs)一开箱就能提供一系列功能。虽然其中某些功能非常出色,但并非所有功能都能满足我们的具体需求。要想实现期望的性能表现,就需要在系统提示词中详细列出应该包含以及不应该包含的功能。

这可能涉及以下指令:

  • 智能体的名称与职责:智能体的命名及其预期执行的任务。
  • 语言风格与简洁性:智能体在交流时应该保持的正式或随意程度,以及信息传达的简洁性。
  • 工具使用时机:确定何时应该利用外部工具,何时依赖模型自身的知识库。
  • 错误处理:当工具使用或流程执行出现问题时,智能体应采取的行动。

示例:以下摘录自 Bee Agent Framework[14] 的操作指南部分。

在这里插入图片描述

第四步:定义并优化核心工具集

工具就是赋予智能体超能力的魔法。只需一套定义明确的工具,就能实现广泛的应用功能。重要的工具包括代码执行、网络检索、文档读取和数据解析等。

对于每一项工具,都需要定义以下信息,并将其融入系统提示词之中:

  • Tool Name:为这项功能起一个独特且具描述性的名称。
  • Tool Description:清晰地阐述该工具的作用及其使用时机。这有助于智能体判断何时选用合适的工具。
  • Tool Input Schema:这是一个框架,它规定了必需和可选的参数、参数类型以及所有约束条件。智能体根据用户的提问,利用这个框架来填充所需的输入。
  • 提供一个指示或者指南,告诉用户或者开发者这个工具应该在哪里以及如何被运行。

例如:以下是从 Langchain 社区摘录的 Arxiv 工具实现片段[15],需要 ArxivAPIWrapper[16] 的支持。

在这里插入图片描述

在某些场景下,为了达到预期的性能,我们需要对工具进行优化。这可能需要通过微调工具名称或描述来进行提示词工程,设置高级配置来处理常见问题,或是过滤、筛选工具的输出结果。

第五步:确立内存管理策略

大语言模型(LLMs)受限于它们的上下文窗口大小 —— 也就是它们一次性能够“记下”的 tokens 数量。在多轮对话中,过往互动、工具输出的长文本或者是 Agent 所依赖的额外上下文信息,都可能迅速占满内存空间。因此,制定一个有效的内存管理策略是非常重要的。

在这里,所谓的“内存”是指智能体(Agent)存储、调用并利用历史交互信息的能力。这种能力使得智能体能够持续跟踪对话上下文,基于之前的对话来优化回答,从而提供更加定制化的用户体验。

常见的内存管理策略包括:

  • Sliding Memory:只保留最近 k 轮对话的记忆,较早的对话则被舍弃。
  • Token Memory:只记下最近 n 个 tokens,其余的则被遗忘。
  • Summarized Memory:每轮对话后,使用 LLM 对对话内容进行总结摘要,并丢弃原始信息。

另外,我们还可以利用 LLM 来识别关键信息(key moments),并将其存储在长期记忆中。这样,智能体就能“记住”用户的重要信息,使用户体验更加个性化。

我们目前所讨论的五个步骤为创建智能体奠定了基础。那么,如果在这个阶段我们通过 LLM 处理用户查询,会发生什么呢?

在这里插入图片描述

答案是:你会得到一段未经处理的文本输出。(图片由作者提供)

示例如下:

在这里插入图片描述

此时,智能体会生成一段原始的文本输出。那么,我们如何确保智能体能够执行后续操作呢?这就需要引入解析和编排机制了。

第六步:解析智能体(Agent)的原始输出

解析器的作用是将原始数据转换成应用程序能够识别和使用的数据格式(例如,带有特定属性的对象)。

对于我们正在构建的智能体,解析器必须能够辨认出我们在第二步中设定的通信结构,并将其转换成结构化数据输出,例如 JSON 格式。这样做可以让应用程序更加便捷地处理和执行智能体的后续动作。

备注:某些模型供应商,例如 OpenAI,可以默认提供可直接解析的输出。而对于其他模型,尤其是那些开源模型,可能需要额外进行解析配置。

第七步:规划智能体的后续行动

最后一步是建立编排逻辑。这一逻辑决定了 LLM 输出内容结果之后的处理流程。依据输出内容,系统将执行以下任一操作:

  1. 执行工具调用,或者
  2. 给出回应 —— 这可能是对用户查询的直接回答,也可能是为了获取更多信息而提出的后续问题。

在这里插入图片描述

扩展的单智能体架构图示。(图片由原文作者提供)

如果触发了工具调用,工具的输出信息会被送回 LLM(作为其工作记忆的一部分)。LLM 将据此决定如何利用这些新数据:是继续进行工具调用,还是直接向用户返回答案。

以下是在代码中实现这种编排逻辑的一个示例:

在这里插入图片描述

大功告成!现在,你已经有了一个能够应对多种场景的智能体系统 —— 无论是进行竞争分析、深入研究,还是实现复杂工作流程的自动化。

03 多智能体(multi-agent)系统在什么情况下派上用场?

尽管当前 LLM 的表现令人印象深刻,但它们在处理海量信息时却显得力不从心[17]。一旦上下文过多或工具使用过杂,模型便可能不堪重负,导致性能下滑。面向多种用途的单智能体系统最终会触及这一上限,尤其是在它们对 token 的消耗量之大已是众所周知。

对于某些使用场景,部署多智能体系统或许更为合适。通过将任务分摊给多个智能体,可以有效避免单一 LLM Agent 的上下文负载过重,从而提高整体的执行效率。

尽管如此,通用的单智能体系统仍然是原型开发的一个极好起点。它能帮助我们迅速验证使用场景,并发现系统何时开始出现故障。在这个过程中,你将能够:

  • 洞察哪些任务环节确实能通过 Agent 模式得到优化。
  • 确定可以作为独立流程分离出来,成为更大工作流程中一环的部分。
  • 从单智能体起步,这样能够获得他人宝贵的经验、见解,以便在构建更复杂系统时调整和优化策略。

04 如何开始上手?

已经迫不及待想要开始构建智能体了吗?使用框架是快速测试和迭代智能体配置的好方法。

  • 如果你打算使用 Llama 3 这样的开源模型,不妨试试 Bee Agent Framework[18] 提供的初始模板[19]。
  • 如果你打算使用 OpenAI 这样的前沿模型,试试 LangGraph[20] 提供的教程[21]可能会给你带来帮助。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

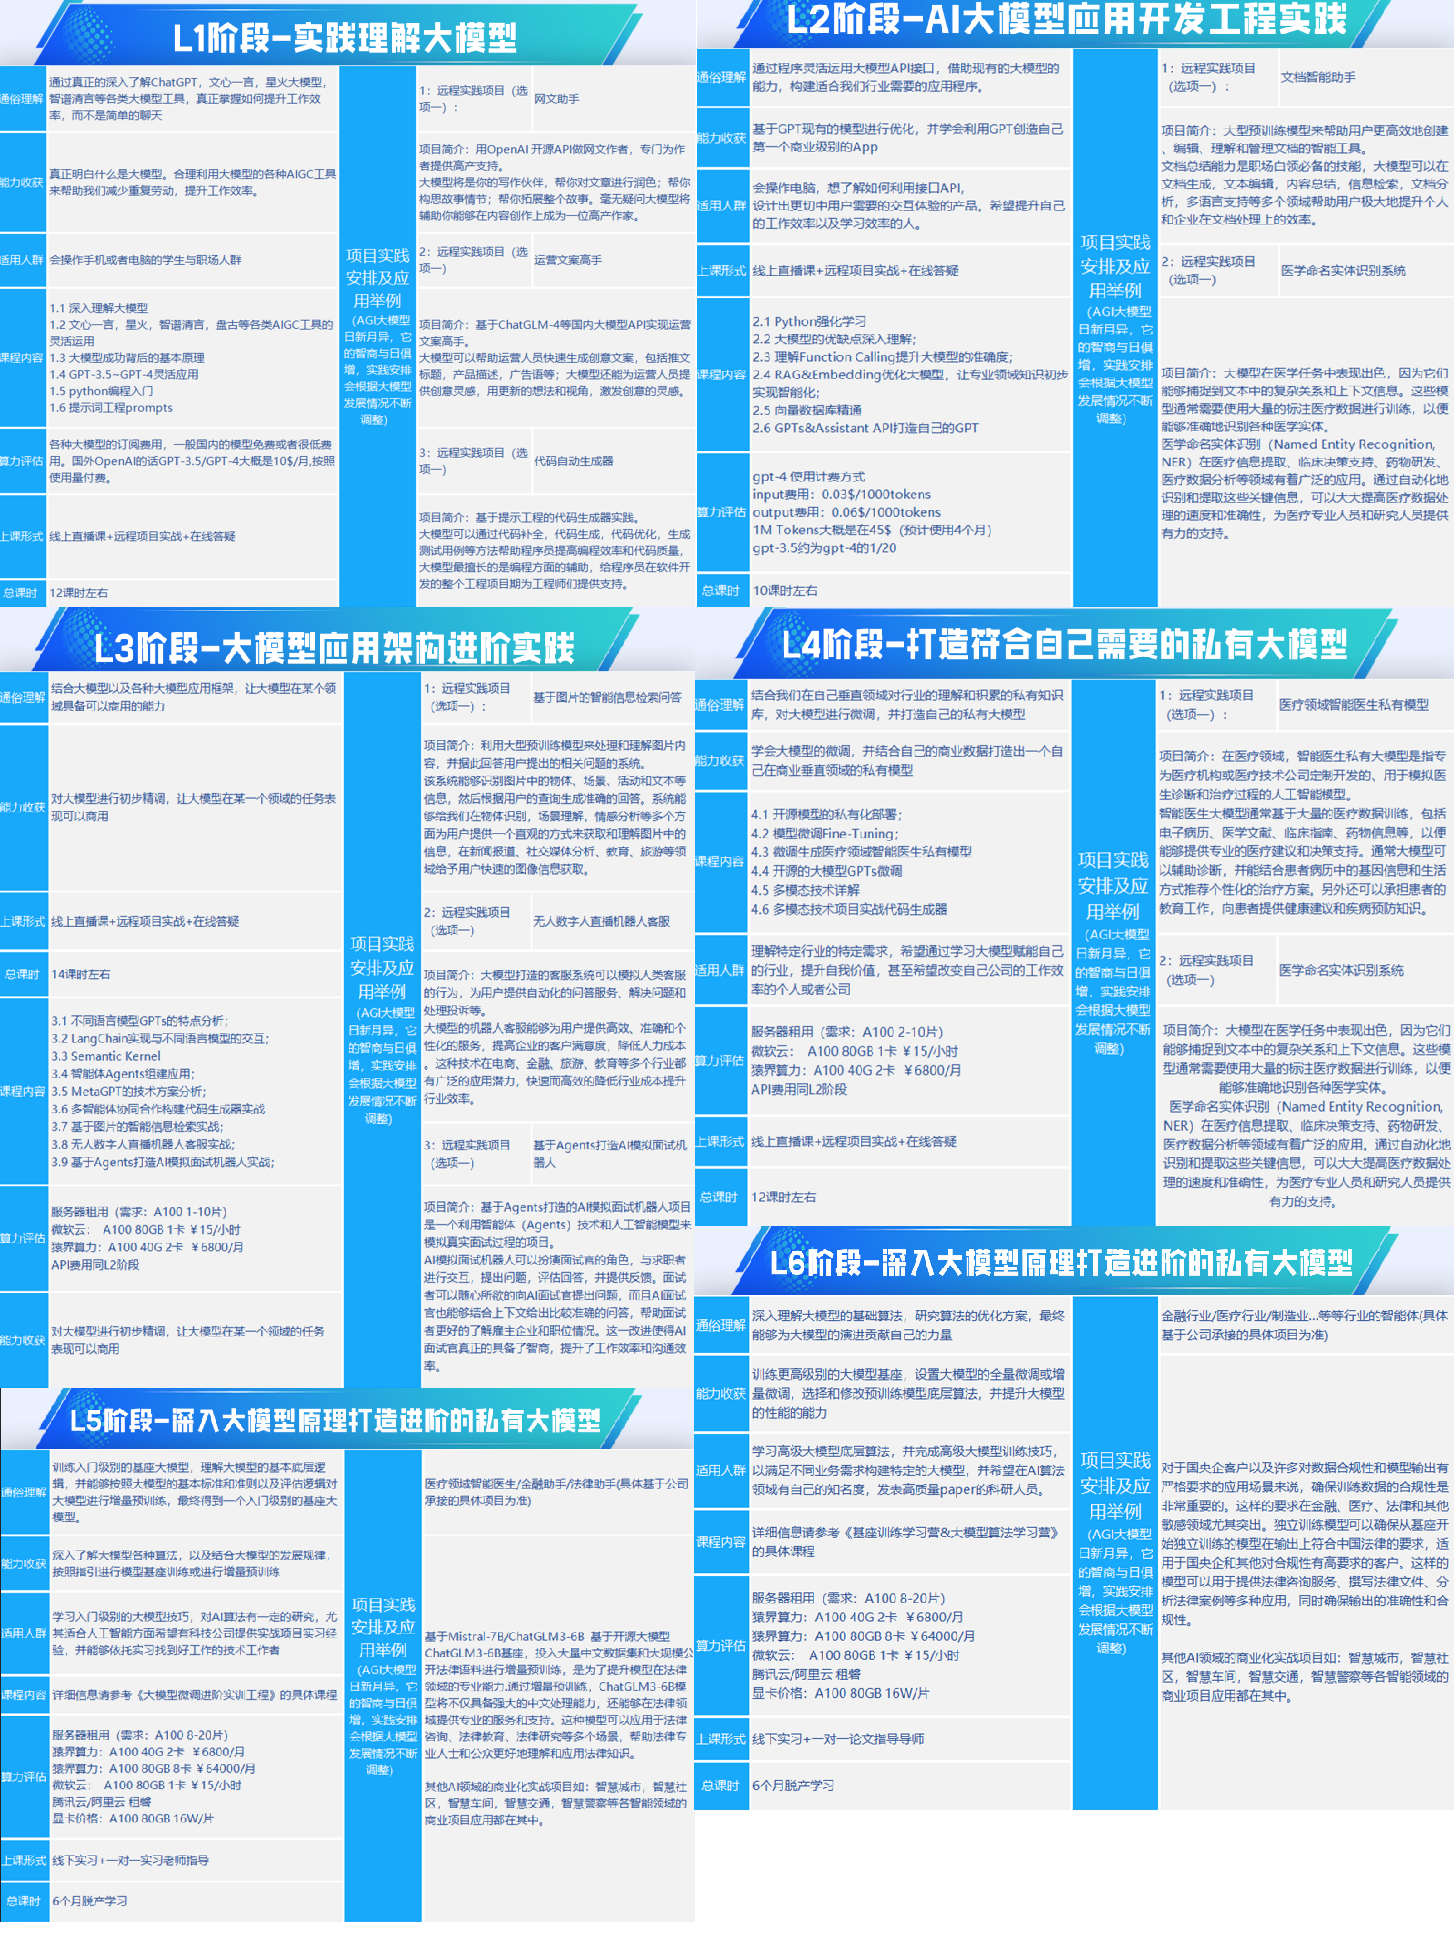
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。 img
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

四、100+套大模型面试题库

在这里插入图片描述

五、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

AI Agent Runtime层的范式迁移:从可选能力到默认基座 AI Agent 已从实验性组件演进为关键业务系统的核心执行单元,其底层 runtime 不再是附加能力,而是决定可靠性、安全性和可审计性的基础设施。其核心原理在于将状态外置为不可变事件日志(session-as-event-log)、执行环境无状态化(harness-as-stateless-executor)、凭证隔离硬件化(credential-isolation-by-design),从而支撑金融、医疗、制造等强监管场景的落地。这种架构显著提升故障可追溯性与合规验证效率,并天然适配多云与混合部署。当 阅读详情

相关推荐

本地部署Qwen3.5-9B:轻量级AI Agent执行层实战指南

大语言模型(LLM)作为AI Agent的执行层,需兼顾低延迟、高可控性与中文语义鲁棒性。Qwen3.5-9B凭借开源可调试特性、GGUF量化后<6GB体积及对中文数字混排等场景的强适配能力,成为消费级显卡(如RTX 4060 Ti 16G)上构建离线智能体的理想选择。其技术价值在于将Agent从‘黑盒API调用’转向‘可观察、可patch、可嵌入工作流’的本地推理引擎,适用于社保查询、网页自动化、多模态UI理解等结构化任务。本文聚焦Qwen3.5-9B在LM Studio中的稳定加载、Unsloth量化版

Envisage123 413

深入浅出:微软和IBM都在推的 Agent-Framework | LeetTalk Daily

“LeetTalk Daily”,每日科技前沿,由LeetTools AI精心筛选,为您带来最新鲜、最具洞察力的科技新闻。在当今快速发展的科技领域,人工智能(AI)正逐渐成为推动各行业创新和效率提升的重要力量。微软和IBM作为全球领先的科技公司,近期分别推出了各自的智能代理框架——微软的Magnetic-One和IBM的Bee Agent Framework。这些框架都是希望通过自动化复杂任务,提...

LinkTime_Cloud的博客 980

Agent Runtime 正在归零:从托管服务到垂直智能体的工程范式迁移

智能体(Agent)作为大模型落地的核心执行单元,其运行时(Runtime)正经历类似云计算早期‘操作系统时刻’的基础设施化演进。当 AWS Bedrock AgentCore、Anthropic Managed Agents 等托管服务将沙箱隔离、会话恢复、凭证管理、可观测性等能力标准化并纳入云原生调度体系,Runtime 层便逐步退化为无感、免费、高 SLA 的底层能力——即所谓‘going to zero’。这一趋势的本质,是工程重心从‘能否运行 agent’转向‘如何定义可审计、可重放、可治理的决策

dianyin7770的博客 338

如何从头建立一个通用AI智能体应用?

简单 LLM 和 Agent 之间的主要区别在于系统提示(system prompt)。在 LLM 上下文中,系统提示是在模型处理用户查询之前提供给模型的一组指令和上下文信息。LLM 所期望的 Agent 行为可以在系统提示中编纂。以下是一些常见的 Agent 模式,可以根据您的需求进行定制:工具使用:Agent 确定何时将查询路由到适当的工具或依靠自己的知识。反思:Agent 在回复用户之前会检查并更正其答案。大多数 LLM 系统也可以添加反思步骤。

m0_59235245的博客 1370

Research Agent工程实践:从状态持久到MCP协议落地

Research Agent并非高级Chatbot,而是面向复杂任务的自主工作流系统,其核心在于状态持久性、工具智能路由与引用可信度分级。理解这一概念需回归AI工程本质:模型只是组件,真正决定系统鲁棒性的是上下文管理机制、协议层抽象(如Model Context Protocol)和多源冲突消解能力。技术价值体现在将学术检索、跨语言推理、人类协同决策等场景封装为可审计、可回溯、可降级的生产级流水线。典型应用场景包括科研辅助系统、金融风控Agent、医疗RAG问答引擎等对准确性与可解释性要求严苛的领域。本文聚

搜索 401

Opus 4.7升级避坑指南:从Agent崩溃到稳定交付的实战重构

Claude Opus 4.7并非简单的能力升级,而是提示工程范式、Token经济模型与多模态执行逻辑的系统性跃迁。其核心在于‘契约式提示’取代启发式引导,要求开发者显式定义任务边界、失败降级策略与思维链强制输出;同时,新版tokenizer与xhigh effort模式引发token消耗激增,需建立实时Token审计机制;而高分辨率图像处理能力虽强,却带来不可预测的上下文溢出风险,倒逼数据管道精细化设计。本文聚焦Agent工作流在Cursor Pro、LangChain及Hermes环境下的真实故障(如a

weixin_34174422的博客 556

BeeAI Framework 使用指南

BeeAI Framework 是一个开源的多代理系统构建框架,支持使用 Python 和 TypeScript 开发生产级别的 AI 代理。该框架允许开发者实现简单到复杂的多代理模式,无缝集成各种模型和工具,并提供生产级别的控制和优化功能。 ## 2. 项目快速启动 ### Python 版本 首先,确保安装了必要的模型。以下示例使用 `ollama` 的 `granite3.1-dens

gitblog_00037的博客 461

医学图像可视化实战:ITK-SNAP与Python+SimpleITK双方案解析

本文深入解析了医学图像可视化的两大核心方案:ITK-SNAP与Python+SimpleITK。ITK-SNAP作为专业无损浏览器,是数据探索与分析的必备工具;而Python+SimpleITK方案则提供了自动化处理能力,但需注意将.nii.gz数据转换为JPG等格式时的信息损失。文章通过实战对比,为医学影像处理者提供了清晰的选择指南与避坑建议。

ol789012的博客 490

如何从0开始构建一个通用AI Agent 智能体架构设计和实现?

AI Agent 智能体,目前更具体地指的是 LLM Agent。这是一种程序,其执行逻辑受其底层模型(LLM)的操控。

lyy2017175913的博客 1952

GD32F450以太网(2-2): PHY芯片IP101GR介绍

IP101是台湾省九阳电子公司生产制造的,符合IEEE 802.3/802.3u标准单端口快速以太网收发器100Mbps和10Mbps操作,它支持自动MDI/MDIX功能,简化网络安装和减少系统维护成本。支持Auto MDI/MDIX已内置4个49.9欧的精密电阻支持中断功能支持 MII/RMII 接口超低功耗

Zhichao_Zhang的博客 1万+

YOLOv8的Anchor-Free革新:从中心点预测到动态IoU匹配的全面解析

本文深入解析了YOLOv8采用Anchor-Free(无锚框)设计的核心优势与实现机制。通过摒弃预设锚框,模型直接预测目标中心点与宽高,结合解耦头、动态IoU匹配及Varifocal Loss等创新,显著简化了训练流程并提升了检测精度,尤其在小目标检测和模型泛化能力上表现突出。

weixin_29094301的博客 358

【解码通用AI Agent】七步构建你的智能系统:从零到精通!

*编者按:**如何才能打造一个能够灵活应对多样场景、高效执行复杂任务的通用智能体系统?传统的硬编码流程已经无法满足快速变化的需求,而简单的提示词模板又显得过于僵化和脆弱。本文作者详细阐述了从零构建通用 LLM Agent 的七个关键步骤,为读者提供了一个从模型选择、控制逻辑设计到工具集构建、规划后续行动的完整路径。这套方法论不仅仅来自理论推演,更凝聚了作者在实际项目中的宝贵经验。通过对模型能力、行为模式、内存管理等关键环节的深入剖析,本文为读者呈现了一个真实的、可落地的通用 AI 智能体构建蓝图。

2401_84494441的博客 2206

用Omniverse Kit开发第一个USD插件:从环境配置到实战案例(Python 3.7版)

本文详细介绍了如何使用NVIDIA Omniverse Kit和Python 3.7开发第一个USD插件,涵盖从环境配置到实战案例的全过程。通过创建可实时同步材质属性的USD插件,开发者可以快速掌握Omniverse开发框架,提升3D内容创作效率。

x8y9z0的博客 589

Impeccable new-work 工作流详解:从新表面创建到视觉世界替换的七步实战指南

在 AI 编码工具中做前端设计时,"给一个新页面"和"推翻重做一套视觉语言"是两类完全不同的工程问题。Impeccable 仓库中的 [new-work 参考文档](https://link.gitcode.com/i/2fdc5e05ef5f0a26dbf360f4caf6ffbb) 正是为此设计的完整工作流:它规定了一条从"判断项目里哪些视觉事实已经成立",到"向用户提问"、"选择创意幅度"、

gitblog_01151的博客 1026

软件工程实验报告--用Visio绘制数据流图、ER图、状态图、软件结构图、程序流程图、系统流程图

用Visio绘制数据流图、ER图、状态图、软件结构图、程序流程图、系统流程图

m0_73814332的博客 4170

统信UOS服务器上,达梦DM8数据库安装避坑全记录(附大小写敏感设置)

本文详细介绍了在统信UOS服务器版上部署达梦DM8数据库的全过程,包括环境准备、安装流程、数据库实例初始化及关键参数配置,特别是大小写敏感设置的注意事项。提供了从系统配置到性能优化的完整指南,帮助用户避免常见问题,确保数据库稳定运行。

weixin_30647423的博客 333

Agent 接入企业微信/钉钉:渠道对接实

本文详解AI Agent接入企业微信与钉钉的实战方案,聚焦渠道对接核心挑战:回调超时、消息重复、加密解密、跨平台差异。提出“七步接入流程”与“六段可复用代码”,构建统一适配层,实现验签解密、幂等去重、异步处理、能力降级与主动推送。通过消息队列解耦、Token提前刷新、统一中间模型等策略,突破5秒时限瓶颈,确保在复杂企业场景下稳定服务。附赠两平台能力对照表,助力高效落地。

七夜zippoe的博客 1018

CloudCompare 二次开发(36)——非均匀体素降采样

使用CloudCompare与PCL编程实现的非均匀体素降采样。

点云侠的博客 746

Muse桌面AI Agent:边缘智能硬件范式与DDL抽象层实践

AI Agent不再只是云端服务或手机应用,而是可部署于ESP32、树莓派等异构硬件的本地化智能体。其核心在于边缘智能调度能力与跨平台硬件抽象层(DDL)——通过设备能力契约统一传感器、执行器与计算单元的语义接口,实现同一份Agent逻辑在MCU与Linux设备间的无缝迁移。这种设计显著降低嵌入式AI落地门槛,支撑离线邮件解析、行程规划、智能家居控制等真实场景。尤其适合需要低延迟、高可靠、强隐私保护的桌面级自动化工作流,如实验室数据采集、家庭健康监护与会议纪要生成。

weixin_34332905的博客 332

手把手教你学Simulink——整流器场景:基于PWM控制的单相全桥整流器设计

摘要:本文详细介绍了使用Simulink搭建基于PWM控制的单相全桥整流器的完整设计流程。主要内容包括:系统结构设计(含交流电源、全桥整流器、滤波电路等模块)、分步骤建模过程(从创建项目到添加各功能模块)、双闭环控制系统设计(电压外环和电流内环PI控制)、参数设置建议及仿真分析。通过仿真验证,该整流器可实现单位功率因数运行和稳定输出电压,并提供了数字锁相环等优化方向。文章为电力电子系统设计提供了实用的Simulink建模指导。(149字)

MHD0815的博客 325

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Nexent SDK 工具开发规范:从零实现一个符合平台标准的高质量 Tool

> 本文是 Nexent SDK 官方工具开发规范([sdk/nexent/core/tools/README_EN.md](https://link.gitcode.com/i/fcea5a4246a28a688d602e515bdec275) 及其中文版 [sdk/nexent/core/tools/README.md](https://link.gitcode.com/i/47e012180

gitblog_00992的博客 864

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Agent Runtime 层的塌缩:从独立技术栈到云基础设施

Agent runtime 是支撑智能体(Agent)执行、状态管理与安全沙箱的核心中间层,其本质是解耦模型推理与业务逻辑的运行时环境。随着 AWS Bedrock AgentCore、Google Vertex AI Agent Builder 等云原生方案全面 GA,runtime 正快速退化为默认能力——不再需单独选型、部署或付费,而是像虚拟化之于 EC2 一样‘不可见’。这一演进源于架构解耦(如会话即事件日志)、凭证隔离、无状态执行等工程共识的成熟,也倒逼技术价值向上迁移至 Trace Store、

congli3478的博客 543

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

上一篇: 不懂AI技术的产品经理,都快要被淘汰了!年薪96w!产品经理新赛道,我决定入局!
下一篇: 大模型优质书籍推荐!(免费分享PDF)《AI大语言模型的基础与前沿》,程序员都在看的大模型书!!!
少喝冰美式
博客等级 码龄3年 6847粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值