Meta Llama 3中文微调教程

meta-llama/Meta-Llama-3-8B Meta开发并发布了Meta Llama 3家族大型语言模型(LLM),这是一组预训练和指令微调的生成性文本模型,大小为8B和70B参数。Llama 3指令微调模型针对对话用例进行了优化,在常见的行业基准测试中表现优于许多可用的开源聊天模型。此外,在开发这些模型时,我们非常谨慎地优化了有用性和安全性。我们直接通过Meta的可持续发展计划抵消了100%的排放,并且由于我们公开发布了这些模型,其他人无需承担预训练成本。数据新鲜度 8B模型的预训练数据截止日期为2023年3月,70B模型为2023年12月。 阅读详情

一、搭建Llama 3推理环境

创建pytorch实例,选择2张GPU。拉取meta llama3 8B 模型 (也可以启动llama factory后让llama factory 自动拉取)

先给数据盘扩容50GB到100GB

img

img

cd /root/onethingai-tmp/
mkdir llama3
cd llama3
apt update
apt install git-lfs
git lfs install
git clone https://www.modelscope.cn/LLM-Research/Meta-Llama-3-8B.git  # 等待下载完成,这步耗时较长
pip install flash-attn>=2.0.0.post1 --no-build-isolation
pip install deepspeed

代码第7步耗时较长,且git 没有反馈,容易误以为卡死了。可以另开一个terminal,通过ls查看/root/onethingai-tmp/llama3/Meta-Llama-3-8B 是不是有文件就耐心等待即可

img

img

二、安装llama-factory

git clone https://github.com/hiyouga/LlaMA-Factory.git
cd LlaMA-Factory
pip install -e .  # 等待安装完成

img

img

三、启动llama-factory webui

cd src
python webui.py

img

四、配置公网访问llamafactory 的管理页面

服务端口处填7860 (怎么找到这个页面可参考如何通过Ollama快速搭建Llama 3推理环境)

img

五、配置llama3 8B的中文微调

通过第四步生成的地址打开网页,根据以下2张图进行配置微调llama3(担心磁盘不够参看第八步)

/root/onethingai-tmp/llama3/Meta-Llama-3-8B   # 下图第3步用
/root/onethingai-tmp/llama3/LlaMA-Factory/data # 下图第7步用

img

img

下完数据集就开始训练了,需要等待一段时间。训练开始后可以看到页面最下方如下的信息

img

Jupyter后台可见如下日志:

img

八、选填(其他参数里的保存间隔)

img

九、训练结果查看

使用Jupyter进行查看

img

img

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
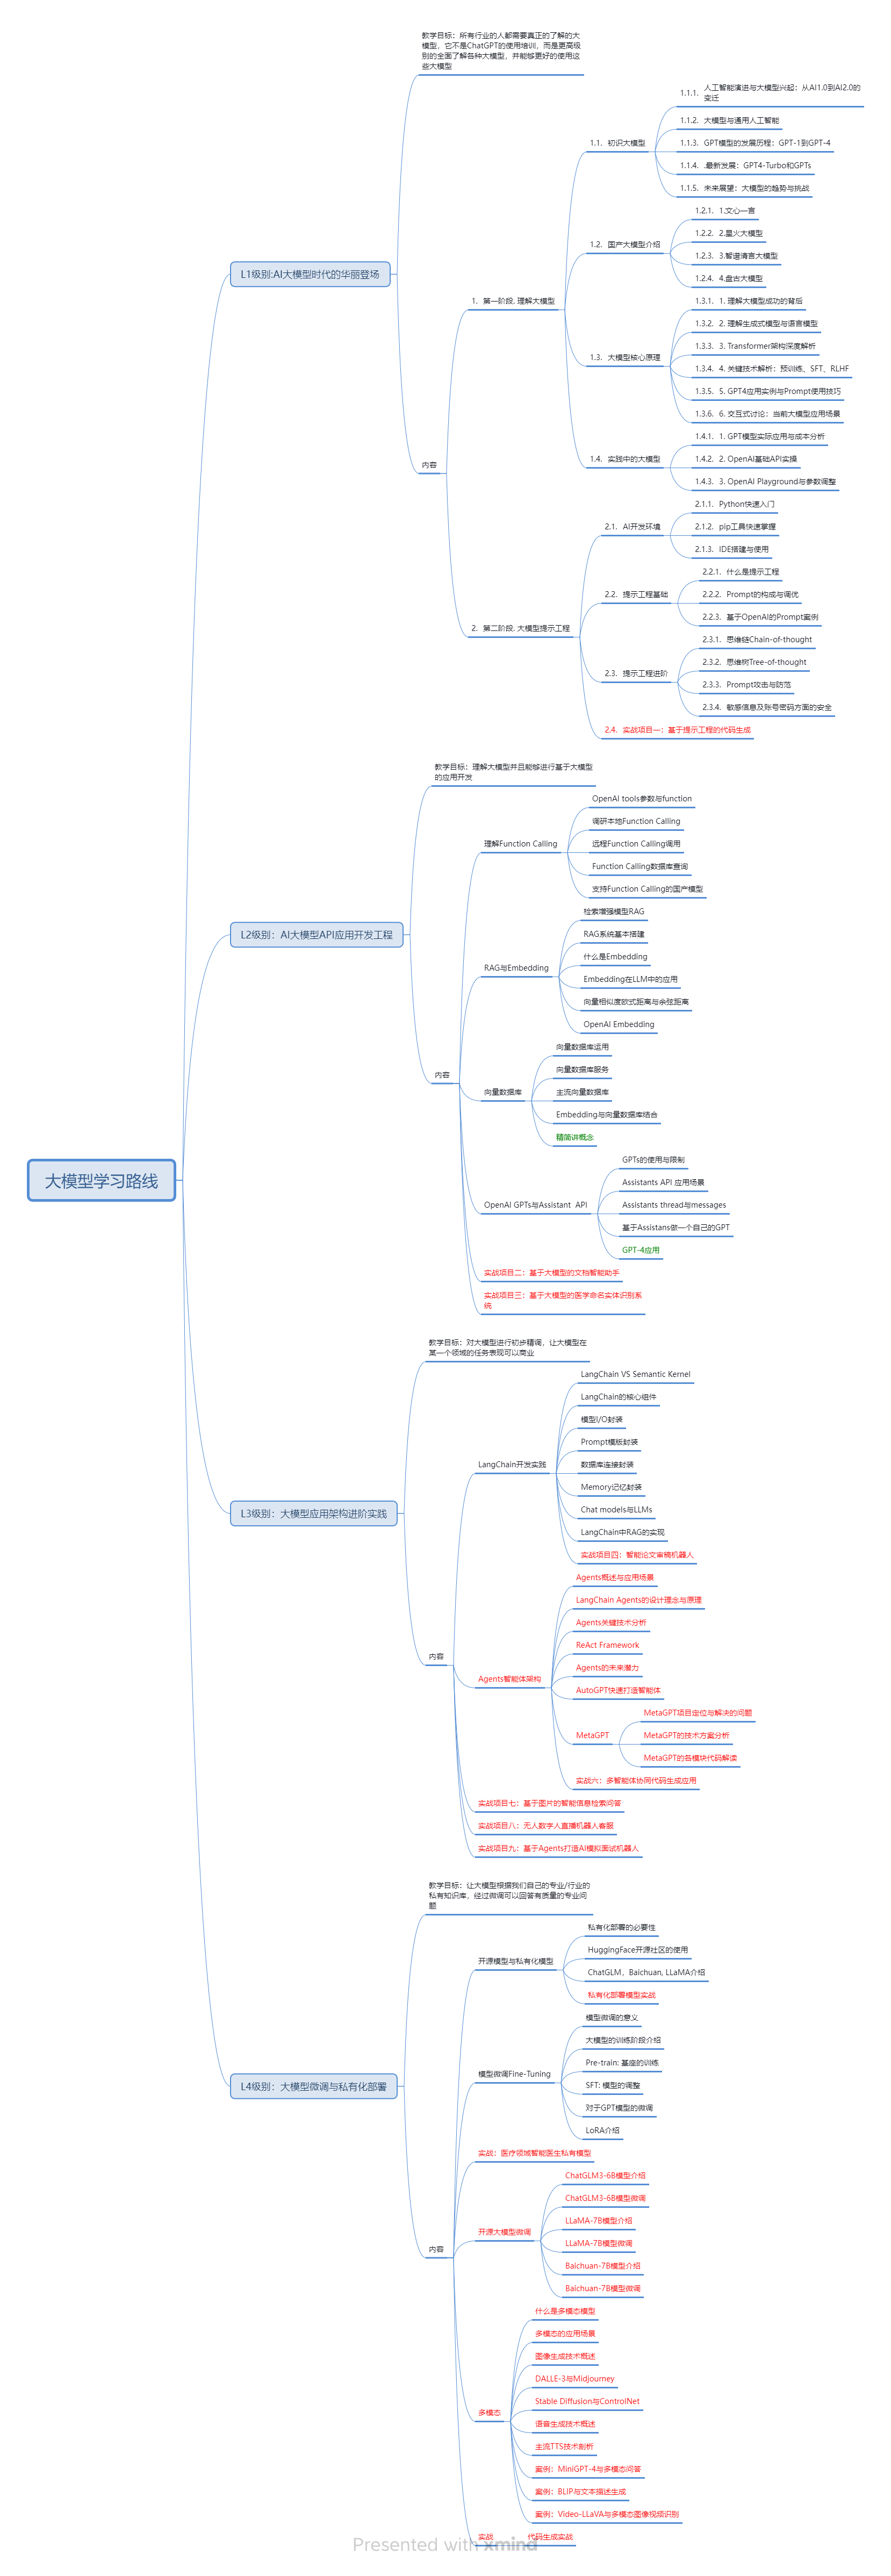
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

本地部署 Meta Llama3-8b 和 Llama3-70b 阅读详情

相关推荐

Llama3本地部署与高效微调入门

为了保持公司在AI(人工智能)开源大模型领域的地位,社交巨头Meta推出了旗下最新开源模型。当地时间4月18日,Meta在官网上宣布公布了旗下最新大模型Llama 3。目前,Llama 3已经开放了80亿(8B)和700亿(70B)两个小参数版本,上下文窗口为8k。Meta表示,通过使用更高质量的训练数据和指令微调,Llama 3比前代Llama 2有了“显著提升”。未来,Meta将推出Llama 3的更大参数版本,其将拥有超过4000亿参数。

水工鸟的专栏 6171

微调llama 3 — PEFT微调和全量微调

高效微调llama3

xiaoxiaoyu290的博客 1万+

【AI大模型】LLaMa羊驼大模型详解

LLaMa模型结构:前面的词预测后面的词,经典的解码结构。位置编码用的是旋转自编码。大语言模型为什么取名为LLaMa(美洲鸵)?LLM发音困难。两个LL跟绕口令一样挑战舌头。大家想给它加点原音,帮助发音。有人加了A,就是LLaMa。3.模型的训练和数据:65B的模型使用2048块A100 80G的GPU,训练21天左右。(训练成本还是比较高的,训练的数据集同GPT一样)LLaMa模型训练的数据集。

weixin_53880910的博客 2810

大模型实战—Llama3-8B 中文微调

2.1.什么是 Llama3?Lllma3 是 META 公司发布的开源语言大模型,与 chatGPT 类似,它可以完成一系列诸如对话,翻译,上下文理解等等复杂任务,你可以把它理解为一个免费,可以部署在你的电脑无须联网就可以使用的 AI 助手。2.2.什么是 Ollama?Ollama 是一个支持在本地运行大语言模型的工具,兼容 Windows 和 MacOS 操作系统。使用 Ollama,您仅需一行命令即可下载并启动模型。

m0_59235699的博客 6865

Llama3-8B+ LLaMA-Factory 中文微调

Llama3是目前开源大模型中最优秀的模型之一,但是原生的Llama3模型训练的中文语料占比非常低,因此在中文的表现方便略微欠佳!本教程就以Llama3-8B-Instruct开源模型为模型基座,通过开源程序LLaMA-Factory来进行中文的微调,提高Llama3的中文能力!

2401_84052244的博客 9998

AI Agent技能评测框架SkillsBench:从黑盒评估到白盒技能拆解

在人工智能领域,模型评估是衡量技术进展的核心环节。传统评测基准如GLUE、MMLU主要关注模型的通用认知能力,但实际工程应用中,AI Agent需要的是在复杂场景中协调多种能力的“职业技能”。SkillsBench创新性地将Agent能力进行原子化拆解,定义了理解规划、工具调用、推理决策、交互安全等技能维度,并通过领域专家构建的评测集确保生态效度。这一框架为Agent开发提供了精准的“度量衡”,使性能优化从经验驱动转向数据驱动,同时为不同模型和框架提供了公平比较的基础,推动了AI Agent生态从“野蛮生长

weixin_30530339的博客 389

【LLM大模型】LLaMA3微调部署真不难!拿走这份教程,轻松掌握LLaMA大模型微调!

今天给大家分享一个爆火的llama3教程,也就是下面这份:这个项目是基于Meta最新发布的新一代开源大模型Llama-3开发的,是Chinese-LLaMA-Alpaca开源大模型相关系列项目的第三期。学完这份教程,你就能掌握LLaMA3的微调部署,该项目我已经帮大家打包好了,需要的可以拿走!

2301_81888214的博客 589

CH340驱动安装全攻略:从Windows到MacOS的避坑指南(2025最新版)

本文提供2025年最新版CH340驱动安装全攻略,涵盖Windows、MacOS和Linux三大操作系统。详细解析了驱动安装的核心原理、标准流程,并针对Windows设备管理器报错、MacOS系统安全限制等常见“坑点”提供了深度排错与解决方案,旨在帮助开发者快速稳定地完成USB转串口通信配置。

earth的博客 430

一分钟部署 Llama3 中文大模型,没别的,就是快

前段时间百度创始人李彦宏信誓旦旦地说开源大模型会越来越落后,闭源模型会持续领先。随后小扎同学就给了他当头一棒,向他展示了什么叫做顶级开源大模型。

pythonhy的博客 969

RK806S PMIC电源管理芯片调试

当点按PWRON按键时,rk806上电开始启动bootloader和uboot,在执行到此处时检测到是由于按键启动的,所以0x5d的值是0x80,0x74的值是0x80,在一般情况下,mode都默认是none的,所以mode值为11,因此就进入了我们的if判断,若是由于按键启动的,则直接调用rk8xx_shutdown函数关掉,进入这个函数会看到实际是通过i2c给0x72寄存器的BIT(0)写1,使其关机。当SoC在12V电源已经接入,且处于关机状态时,使用PWRON按键开机,0x74的值则为0x80。

Y1anoohh的博客 2548

YOLOv8实战教程:从模型训练到改进的全流程指南

回顾这段YOLOv8的实战历程,从最初的模型训练到后来的各种改进尝试,我深刻体会到目标检测技术的魅力与挑战。YOLOv8作为一款优秀的框架,不仅易用性强,而且具备很强的可扩展性,让我能在其基础上不断创新。未来,我计划在以下几个方向继续探索:一是将YOLOv8与多模态技术结合,尝试实现图像与文本的联合目标检测;二是深入研究自监督学习在YOLOv8中的应用,减少对标注数据的依赖;三是探索YOLOv8在更广泛场景的部署,如机器人、自动驾驶等。

LXY_LOVE36的博客 283

没别的,就是快,一分钟即可部署 Llama3 中文大模型

前段时间百度创始人李彦宏信誓旦旦地说开源大模型会越来越落后,闭源模型会持续领先。随后小扎同学就给了他当头一棒,向他展示了什么叫做顶级开源大模型。

DEVELOPERAA的博客 1017

具身智能:原理、算法与系统 第16章 运动控制基础

实时迭代(Real-Time Iteration, RTI)策略在每个采样时刻执行有限次迭代(通常一次),利用相邻时刻解的连续性,在严格时间限制内获得可行解。比例-积分-微分(Proportional-Integral-Derivative, PID)控制是工业界最广泛应用的控制策略,其原理基于误差的当前值(比例)、累积值(积分)与变化率(微分)的线性组合。力-位置混合控制(Hybrid Force/Position Control)将任务空间分解为力控制子空间与位置控制子空间,分别控制。

VectorShift的博客 147

Llama3-8B微调教程:Llama-Factory一键启动LoRA实战

本文介绍了如何在星图GPU平台上自动化部署Meta-Llama-3-8B-Instruct镜像,结合Llama-Factory实现LoRA微调,快速构建领域专属对话模型。该方案适用于智能客服、电商问答等文本生成场景,显著降低大模型定制门槛,提升AI应用开发效率。

weixin_35459464的博客 429

YOLOv8改进策略【卷积层】| GnConv:一种通过门控卷积和递归设计来实现高效、可扩展、平移等变的高阶空间交互操作

HorNet: 利用递归门控卷积实现高效高阶空间交互GnConv(Recursive Gated Convolution,递归门控卷积)

Limiiiing的博客 326

基于STM32设计的自动追光系统(项目资料ID:2)

基于STM32设计的自动追光系统主要由光敏采集电路、单片机核心板电路和步进电机控制电路构成。通过光敏电阻采集环境光强信息,经 STM32 单片机处理后,控制步进电机转动,实现对光源的自动追踪。该系统具有响应速度快、追踪精度较高等优点,可应用于太阳能发电、智能照明等领域,为相关场景提供高效的光资源利用方案。

以培养嵌入式工程师为己任 1万+

LLaMA3(Meta)微调SFT实战Meta-Llama-3-8B-Instruct

LlaMA3-SFT, Meta-Llama-3-8B/Meta-Llama-3-8B-Instruct微调(transformers)/LORA(peft)/推理。

大漠帝国的博客 7292

C++性能优化:深入理解缓存一致性与伪共享

在现代多核处理器的世界里,理解缓存一致性和伪共享就像理解一个复杂社会系统的运作规则。正如心理学家阿德勒所说:"人的行为总是有目的的",CPU缓存的每一次同步也都有其深层的硬件逻辑。本文将带你深入探索这些看不见的性能杀手,以及如何在实际项目中与它们优雅共处。

探索C++编程的奥秘,分享深入的技术见解和实践,旨在激发读者创造力与解决问题的思维。 936

【AI大模型】羊驼大模型详解_大模型 羊驼

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;国内很多大模型都是学Alpaca模型的玩法,套壳LLaMA模型低成本训练出自己的模型。

Spontaneous_0的博客 872

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Llama-Factory + Ollama 打造属于自己的中文版 Llama3

Meta Llama3发布已经有一小段时间了。和以往的原始 Llama 模型一样,Llama 3 对中文的支持效果欠佳。本文则探讨如何使用 Llama-Factory 对 Llama3 进行中文微调的具体过程,并通过 Ollama 本地部署中文微调的 Llama3 模型,打造属于自己的个性化的 Llama3 LLM 。

hyang1974的博客 1万+

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

一文速览Llama 3及其微调:从如何把长度扩展到100万到如何微调Llama3 8B_llama3 微调 mysql 数据_llama3 代码很短

4.19日凌晨正准备睡觉时,突然审稿项目组的文弱同学说:Meta发布Llama 3系列大语言模型了一查,还真是本文以大模型开发者的视角,基于Meta官方博客的介绍:Introducing Meta Llama 3: The most capable openly available LLM to date,帮你迅速梳理下LLama的关键特征,并对比上一个版本的LLama2,且本文后续,将更新用我司paper-review数据集微调llama3的训练过程。

2401_85280307的博客 2077

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

LlamaFactory 进行大模型 llama3 微调,轻松上手体验学习

节前,我们星球组织了一场算法岗技术&面试讨论会,邀请了一些互联网大厂朋友、参加社招和校招面试的同学,针对算法岗技术趋势、大模型落地项目经验分享、新手如何入门算法岗、该如何准备、面试常考点分享等热门话题进行了深入的讨论。

2401_84033492的博客 2357

教程:利用LLaMA_Factory微调llama3:8b大模型

在存放模型空白处右键,点击git bash here,下载llama3模型至本地由于文件较大,因此该过程比较久,保持下载窗口打开,知道出现下一命令行表示下载完成。

m0_60683691的博客 5307
上一篇: 大语言模型在序列推荐中的应用
下一篇: 【文档智能 & RAG】RAG增强之路:增强PDF解析并结构化技术路线方案及思路
少喝冰美式
博客等级 码龄3年 6847粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值