用伪代码Prompt让LLM进行图推理,生成更精准内容

vLLM-prefix浅析(System Prompt,大模型推理加速) 本文浅析了在大模型推理加速方面一个非常优秀的项目 vLLM 的一个新特性 Prefix。在 Prompt 中有相同前缀时可以提高吞吐量降低延迟,换句话说可以省去这部分相同前缀在自注意力阶段的重复计算。更新 2024.1.18:Prefix 已经合并到主分支上了!如果你的 vLLM 不能使用也许是时候升级一下体验下新功能哩! 阅读详情

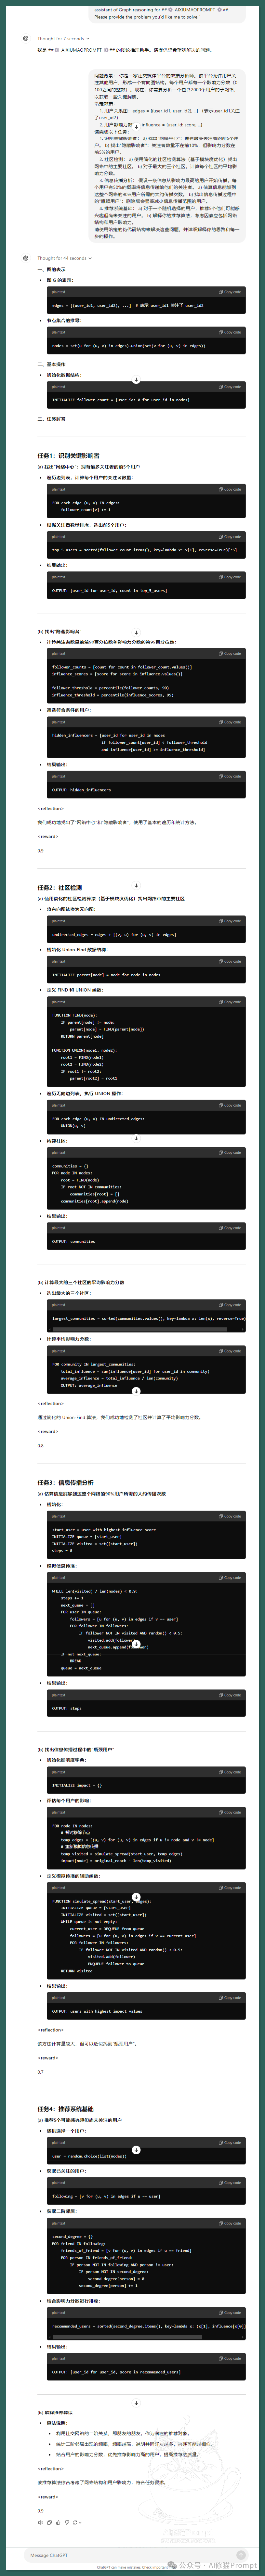
最近有研究发现,当LLM面对结构化数据,特别是图数据时,LLM的表现却不尽如人意。这几天,来自希腊和法国的研究团队提出了一种创新方法——利用伪代码提示来增强LLM的图推理能力。我基于这项研究先写了一个伪代码的SYSYTEM PROMPT运行出了一个社交网络分析的结果,再用这个结果写了一段代码,运行出了下面的图。我的评价只有一句:LLM图推理还是要用Pseudo prompt。

在这里插入图片描述

在这里插入图片描述

01

伪代码提示的力量

尽管LLM在自然语言处理领域取得了显著成就,但在处理图结构数据时仍面临重大挑战。先前的研究表明,LLM在解决某些看似简单的图问题时存在困难。例如,Wang等人(2023a)的研究显示LLM具有初步的图推理能力,而Fatemi等人(2024)的研究则发现LLM在一些基本图任务(如计算图的边数)上表现不佳。这种矛盾的结果凸显了LLM在图推理领域的不稳定性,也促使研究者思考:如何才能有效提升LLM在图推理任务中的表现?

研究团队提出了一种新颖的方法:使用伪代码作为提示来增强LLM的图推理能力。这种方法的核心思想是将算法逻辑以伪代码的形式呈现给LLM,从而引导模型按照结构化、模块化的方式进行问题解决。在这里插入图片描述

  • 图任务:展示了一个简单的图结构。
  • 伪代码:提供了计算边数的算法步骤。
  • 提示:将图任务转化为自然语言问题。
  • 最终提示:结合伪代码和问题,形成完整的提示。
  • 输出:按照伪代码prompt输出

这一方法具有以下几个关键优势:

1. 减少歧义: 相比自然语言,伪代码提供了更清晰、更精确的指令,减少了理解上的歧义。

2. 结构化思维: 伪代码prompt引导LLM按照算法逻辑进行推理,促进了结构化思维。

3. 增强可解释性: 通过提供清晰的步骤,伪代码prompt使得LLM的推理过程更加透明和可解释。

4. 融入领域知识: 伪代码允许研究者将图论和算法设计的专业知识直接注入到prompt中。这一点很重要,可以减轻LLM的先验知识匮乏导致的幻觉。

02

实验设计:全面且系统的评估

为全面评估这种方法的有效性,研究团队设计了一个复杂而系统的实验:

1. 图任务范围:

研究涵盖了10种不同复杂度的图算法问题:

在这里插入图片描述

- 节点计数

- 边计数

- 节点度数计算

- 邻居节点识别

- 连通分量计数

- 循环检测

- 最小生成树

- 最短路径计算

- 二分图检测

- 拓扑排序

2. 图类型和规模:

- 主要使用Erdős–Rényi随机图

- 根据节点数量将图分为三类:

* 小型(5-11个节点)

* 中型(11-21个节点)

* 大型(21-51个节点)

- 特殊任务使用特定图类型:

* 拓扑排序任务使用有向无环图

* 二分图检测任务使用随机二分图和Erdős–Rényi图

3. 数据集规模:

- 总计生成6,600个问题实例

- 对于图级属性任务,每种图大小生成100个问题

- 对于节点级属性任务,每种图大小生成500个问题

- 对于边级属性任务,每种图大小生成500个问题

4. 模型选择:

实验采用了两种代表性的LLM:

- GPT-3.5-Turbo:代表专有模型

- Mixtral 7x8B:代表开源模型

5. 对比方法:

研究比较了多种提示方法:

- 零样本提示(0-SHOT)

- 单样本学习(1-SHOT)

- Build-a-Graph提示(BAG)

- 零样本思维链(0-COT)

- 伪代码提示(PSEUDO)

- 伪代码提示+单样本学习(PSEUDO+1-SHOT)

6. 评估指标**:**

使用准确率(正确答案数/总查询数)作为主要评估指标

这种全面的实验设计确保了研究结果的可靠性和普适性,为后续研究提供了坚实的基础。

03

深入分析伪代码提示的效果

1. 整体性能提升

实验结果显示,伪代码提示方法在多数任务中都带来了性能提升。特别是在LLM原本表现欠佳的任务中,这种提升更为显著。例如:

- 对于GPT-3.5-Turbo,在边计数任务中:

在这里插入图片描述

  • 小型图:PSEUDO方法达到90%准确率,比0-SHOT提高12个百分点

  • 中型图:PSEUDO方法达到34%准确率,比0-SHOT提高18个百分点

  • 大型图:PSEUDO方法达到9%准确率,比0-SHOT提高7个百分点

  • 对于Mixtral 7x8B,在连通分量计数任务中:

  • 小型图:PSEUDO+1-SHOT方法达到75%准确率,比0-SHOT提高40个百分点

  • 中型图:PSEUDO方法达到63%准确率,比0-SHOT提高23个百分点

2. 模型差异化表现

研究发现,伪代码提示对不同模型的影响并不一致。这一发现强调了prompt工程需要针对不同模型进行定制化设计的重要性。例如:

  • 在循环检测任务中:

  • 对GPT-3.5-Turbo,PSEUDO方法显著提升了性能(小型图从43%提升到76%)

  • 对Mixtral 7x8B,PSEUDO方法反而降低了性能(小型图从85%降至33%)

3. 图规模的影响

研究清晰地表明,随着图规模的增大,LLM的性能普遍下降。这一发现对于处理大规模图数据的prompt设计提出了挑战。例如:

在这里插入图片描述

  • 在节点度数计算任务中,GPT-3.5-Turbo的性能随图规模增大而显著下降:

  • 小型图:75%准确率

  • 中型图:24%准确率

  • 大型图:6%准确率

4. 节点计数vs边计数

一个令人惊讶的发现是,LLM在节点计数任务上表现出色,但在边计数任务上却困难重重。这种差异在大型图上尤为明显:

  • GPT-3.5-Turbo在大型图上的表现:

  • 节点计数:100%准确率

  • 边计数:仅2%准确率

5. 单例示范的有效性

研究表明,在使用伪代码提示时,仅需一个示例就能达到良好的效果,有时甚至优于多个示例。例如:

  • 在最小生成树任务中,对于小型图:

  • PSEUDO+1-SHOT方法达到64%准确率

  • 增加更多示例并未带来显著改善

6. 伪代码风格的影响

研究还探讨了不同伪代码风格对LLM性能的影响:

  • 在最小生成树任务中:

  • Python风格伪代码:31%准确率

  • 普通伪代码:24%准确率

  • 复杂伪代码(多函数):29%准确率

这表明,伪代码的具体表达方式也会影响LLM的理解和执行。

04

伪代码提示的优势所在

1. 结构化思维的引导

伪代码提示为LLM提供了一个清晰的问题解决框架,引导模型按照算法逻辑进行推理。这种结构化的思维方式有助于LLM更好地理解和解决图算法问题。例如,在最短路径计算任务中,伪代码明确指出了使用广度优先搜索的步骤,这大大提高了LLM找到正确解决方案的概率。

2. 歧义性的减少

相比自然语言描述,伪代码具有更低的歧义性。这使得LLM能够更准确地理解任务要求,从而生成更精准的答案。例如,在边计数任务中,伪代码清晰地指出了遍历边列表并累加计数的过程,避免了可能的误解。

3. 步骤分解的优势

伪代码提示将复杂的图算法问题分解为一系列简单步骤。这种分解不仅使得问题更容易解决,也提高了推理过程的可解释性。在连通分量计数任务中,伪代码明确列出了初始化、遍历和合并组件的步骤,使LLM能够逐步推理。

4. 领域知识的融入

通过伪代码,研究者可以将图论和算法设计的专业知识直接注入到提示中。这种方式有效地弥补了LLM在特定领域知识上的不足。例如,在最小生成树任务中,伪代码包含了Kruskal算法的核心思想,这对LLM的正确推理起到了关键作用。

05

实践启示

这项研究为prompt工程师们提供了宝贵的实践指导:

1. 领域特化的提示设计

针对特定领域的问题,如图算法,使用该领域的专业语言(如伪代码)可能比一般的自然语言提示更有效。例如,在拓扑排序任务中,使用描述有向无环图特性的伪代码可以显著提高LLM的性能。

2. 模型特化的策略

不同的LLM可能对同一种提示方法有不同的反应。因此,在设计prompt时需要考虑目标模型的特性。研究显示,GPT-3.5-Turbo和Mixtral 7x8B在某些任务上对伪代码提示的反应存在显著差异,这强调了针对特定模型优化prompt的重要性。

3. 问题分解的重要性

将复杂问题分解为简单步骤不仅有助于LLM更好地理解和解决问题,也提高了结果的可解释性。在最短路径计算等复杂任务中,这种分解策略的效果尤为明显。

4. 示例的精简原则

在使用伪代码提示时,往往只需要一个精心设计的示例就能达到良好效果。这一发现有助于简化prompt设计过程,同时也降低了计算成本。

5. 规模适应性的考虑

随着处理对象(如图)规模的增大,LLM的性能可能会下降。在设计prompt时需要考虑这一因素,可能需要为不同规模的问题设计不同的提示策略。例如,对于大型图,可能需要更详细的步骤分解或更多的中间检查点。

6. 伪代码风格的选择

研究表明,不同风格的伪代码(如Python风格、普通伪代码、复杂多函数伪代码)对LLM的性能有不同影响。prompt工程师应该根据具体任务和目标模型选择最合适的伪代码风格。

对于正在开发AI产品的prompt工程师来说,这项研究提供了宝贵的启示:

1. 领域知识的重要性: 在设计prompt时,应考虑如何有效地将领域特定的知识和结构融入其中。

2. 问题分解的艺术: 将复杂任务分解为清晰、可执行的步骤是提高LLM性能的关键。

3. 模型特化的必要性: 不同的LLM可能需要不同的提示策略,需要针对特定模型进行优化。

4. 规模适应性的挑战: 随着问题规模的增大,可能需要调整提示策略以维持性能。

5. 持续实验和优化: prompt工程是一个需要不断实验和调整的过程,以找到最佳的提示方法。

伪代码提示方法为LLM在处理结构化数据和复杂算法问题方面开辟了新的可能性。我也把这项研究应用到实际中,如开篇介绍的那样,解决一个在社交媒体中寻找“隐藏影响者”的问题,实际代码中我将用户改为1000,实际找到46名,显示前5名,并分析说明如何利用这些隐藏影响者来进行营销:

OpenAI o1
图片

图片

上下滑动查看更多

Slide left and right to see more

在这里插入图片描述

隐藏影响者详细信息:  
用户ID: 856, 影响力分数: 981, 关注者数量: 8  
用户ID: 710, 影响力分数: 984, 关注者数量: 8  
用户ID: 387, 影响力分数: 968, 关注者数量: 5  
用户ID: 468, 影响力分数: 967, 关注者数量: 8  
用户ID: 781, 影响力分数: 988, 关注者数量: 8  
  
LLM分析结果:  
在利用这些隐藏影响者进行营销时,我们需要考虑以下几个关键策略:  
  
**### 1. **识别和分析隐藏影响者的特征****  
   - **活跃度与互动性**:隐藏影响者通常在社交网络中具有较高的活跃度和互动性,他们的帖子往往能引起大量用户的关注和讨论。  
   - **内容质量**:这些用户发布的内容通常具有较高的质量和原创性,能够吸引和保持粉丝的关注。  
   - **社区影响力**:他们在特定社区或兴趣群体中具有较高的影响力,能够影响其他用户的观点和行为。  
  
**### 2. **建立自然的关系****   - **自然互动**:通过自然的方式与这些隐藏影响者互动,例如点赞、评论和分享他们的内容,逐步建立信任和关系。  
   - **合作机会**:提供合作机会,如邀请他们参与品牌活动、试用新产品或撰写产品评测,但要确保合作方式自然,避免过于商业化。**### 3. **内容共创****   - **共同创作内容**:邀请隐藏影响者参与品牌内容的创作,例如共同制作视频、撰写博客或发布联合帖子。这种方式不仅能提升内容的质量,还能借助他们的影响力扩大传播范围。  
   - **用户生成内容(UGC)**:鼓励隐藏影响者分享他们使用产品的体验,并将其作为用户生成内容进行推广。这种方式能够增强品牌的真实性和可信度。**### 4. **利用影响力进行推广****   - **口碑营销**:通过隐藏影响者的推荐和分享,提升品牌的口碑和知名度。他们的推荐往往比传统广告更具说服力。  
   - **定向推广**:利用隐藏影响者的影响力,针对特定目标群体进行定向推广,提高营销活动的精准度和效果。**### 5. **监测和优化****   - **数据分析**:通过数据分析工具监测隐藏影响者的表现和营销活动的效果,及时调整策略。  
   - **反馈机制**:建立反馈机制,收集隐藏影响者和用户的反馈,优化产品和营销策略。**### 6. **保持透明和诚信****   - **透明合作**:在合作过程中保持透明,明确告知隐藏影响者合作的目的和方式,避免引起他们的反感。  
   - **诚信营销**:确保所有营销活动真实可信,避免夸大宣传或虚假信息,维护品牌的信誉。  
  
通过以上策略,我们可以有效利用这些隐藏影响者的影响力,提升品牌的社交网络营销效果,同时保持用户的信任和品牌的真实性。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

System Prompt解密:LLM行为控制的核心机制与工程实践 System Prompt不是简单的角色设定指令,而是大语言模型运行时的底层配置系统,直接影响token生成、工具调用、安全拦截与上下文感知等关键行为。其本质是嵌入推理循环的轻量级运行时约束,作用机制类似操作系统内核——管理权限、调度插件、执行断言校验。理解不同厂商(OpenAI、Anthropic、Google)的prompt设计哲学(如模式优先、分层隔离、生态绑定),对LLM应用开发、安全加固与跨平台集成具有决定性价值。本仓库作为首个开源的system prompt白皮书,为开发者提供可验证、可对比、可 阅读详情

相关推荐

LLM推理机制解密:从注意力热力图到logit轨迹的工程化分析

大语言模型的‘推理’并非逻辑推演,而是基于统计规律的条件概率建模。其核心原理在于Transformer架构中注意力机制对关键证据的动态绑定、残差流中logit值的阶段性跃迁,以及位置编码对长程依赖的建模能力。这种机制赋予模型在数学计算、法律适用、多跳问答等任务中复现类人输出的技术价值,但真实推理能力高度依赖输入结构、提示设计与底层架构。工程师需跳出‘是否思考’的哲学陷阱,转而通过attention可视化、logit lens分析和activation patching等可测量手段,定位推理焦点、捕捉决策临界

weixin_34296641的博客 441

prompt 工程案例

而且评判的数据挺重要的,就像我这个需求应该是分类任务对吧,那结果应该有一个,对就对,不对就不对,我调了几版 prompt ,最好的准确率是 39%,就去数据及理由,有些数据光是人去判断都不太好判断,或是有歧义的,更别说模型了,例如。prompt 入门门槛我觉得比较低,网上随便找资料大概都知道编写模版套路,但效果得结合实际业务情况调优好几天,有些还得通过编程进行辅助,比如预处理工具,提取地名啥的,匹配标签啥的,再去输入给大模型。数据,专业描述的文本,还有对应的 label,

木下瞳的博客 2779

Prompt Caching 原理与实战:降低 LLM API 成本的关键技术

Prompt Caching 是一种面向大语言模型推理优化的语义感知缓存机制,其核心原理在于复用 Transformer 中已计算的 Key-Value Cache(KV Cache),跳过 tokenization、embedding 和 attention 前向计算等高开销环节。相比传统字符串哈希缓存,它能识别语义等价 prompt,避免因微小文本扰动导致的缓存失效;相比客户端缓存,它依赖服务端统一 tokenizer 与张量管理,保障 KV 状态一致性。该技术显著提升响应速度、降低 token 消耗与

weixin_30706691的博客 409

大语言模型(LLM) | 5大新研究大幅提升大模型推理能力

近期,多项开创性研究相继发布,为LLM注入了更强大的"思考"能力。从图表思维到迭代思考,从自我纠错到数学编码,这些创新方法正在重塑AI的推理过程。

star_nwe的博客 1693

解耦LLM记忆与推理:构建超越GPT-4o的智能问答系统

在大语言模型(LLM)的应用开发中,检索增强生成(RAG)和智能体(Agent)是解决知识更新与复杂推理的核心技术。其原理在于通过外部知识库与工具调用,将模型的记忆存储与逻辑推理能力进行分离,从而提升回答的准确性与可解释性。这种解耦架构的技术价值在于能够独立优化检索与推理模块,例如结合向量数据库与图数据库(GraphRAG)实现精准记忆检索,并利用思维链(CoT)提示技术强化推理过程。在金融分析、智能客服等需要事实核查与多步计算的场景中,该架构能有效减少幻觉,实现透明、可靠的答案生成。本文探讨的“解耦LLM

weixin_34268169的博客 408

Anthropic无状态推理层:LLM服务架构的确定性革命

大语言模型服务本质上是一个确定性函数 f(prompt) → response,但传统架构长期依赖隐式上下文维持层(如KV Cache),导致延迟抖动、token计费失真与可观测性黑洞。Anthropic推出的无状态推理层通过Prompt即状态、Token级成本隔离与零共享内存模型,将上下文从运行时移至编译时,实现P99延迟下降41%、显存占用降低67%、幻觉错误减少83%。该范式适用于高并发客服、实时代码补全、多租户SaaS等对确定性、可审计性与成本透明度要求严苛的工程场景,标志着LLM基础设施从‘类人会

374

【LLM系列之指令微调】长话短说大模型指令微调的“Prompt”

大家有没有分析过 prompt对模型训练或者推理的影响?之前推理的时候,发现不加训练的时候prompt,直接输入模型性能会变差的,这个倒是可以理解。假如不加prompt直接训练,是不是测试的时候不加prompt也可以?还有一个就是多轮prompt和单轮prompt怎么构造的问题?好多模型训练方式不统一 包括指令数据形式有所不同,选择困难症又来了。。

2401_82469710的博客 1369

Chain of Draft(CoD):用符号化草稿链压缩LLM推理成本

Chain of Draft(CoD)是一种面向工程落地的轻量级推理范式,其核心在于将大语言模型的思维过程从自然语言描述降维为高密度符号序列,如[CALC:20,12,-]或[IF:score>80,APPROVE,REJECT]。它不依赖模型微调或架构变更,而是基于认知科学中‘内部语言优先’原理,通过结构化提示词与领域符号系统,显著抑制语义漂移、提升执行确定性。相比传统Chain of Thought(CoT),CoD在电商风控、实时推荐、API网关等低延迟、高并发场景中可降低token消耗60%~80%

weixin_30727835的博客 328

【DataWhale-LLM】二、如何更好使用Prompt?

如何使用prompt生成效果更好的答案

weixin_43568307的博客 2478

LLM智能体轨迹推理:TRACE框架实现复盘纠偏与自适应优化

在人工智能领域,大型语言模型(LLM)驱动的自主智能体正成为自动化工作流和复杂问题求解的关键技术。其核心原理在于通过多步骤推理与行动循环来完成任务,但传统链式执行模式存在明显局限:一旦中间步骤出现偏差,错误会持续累积且难以回溯修正。为解决这一问题,轨迹推理技术应运而生,它通过构建动态证据图谱,让智能体具备跨步骤的复盘与纠偏能力,从而显著提升任务执行的鲁棒性和成功率。TRACE(Trajectory Reasoning through Adaptive Cross-Step Evidence Aggregat

weixin_34111790的博客 430

F28335 DSP ePWM模块实战:从基础配置到电机控制

本文详细解析了TI TMS320F28335 DSP的ePWM模块,从基础概念、寄存器配置到实战应用。通过代码示例,手把手教你如何配置定时中断、生成PWM波形、实现死区保护与故障联防,并最终完成一个可调速、可换向的直流电机控制项目,是掌握F28335电机控制核心技术的实战指南。

g5h6i的博客 1128

物流文本帧检测的Prompt优化:Auto-CoT+RAG如何提升15%推理准确率

研究构建了一个包含1,500条越南语物流文本消息的数据集。这些文本来自真实的客户或内部员工沟通,具有非正式、高领域特定性的特点。任务是为每条消息标注一个三层层次化帧标签(Three-level Hierarchical Frame Label)层级含义示例问题的主要代理或实体事件的根本原因类别原因的具体实例这套标注体系总共定义了73个独特的帧标签,且分布极度不平衡——许多类别只有1到2个标注实例,形成了典型的**低资源(Low-resource)**学习环境。

2301_80078096的博客 505

保姆级教程:用Cesium的Primitive API实现火箭发射全流程动画(含代码避坑)

本文详细介绍了如何使用Cesium的Primitive API实现火箭发射全流程动画,包括模型控制、关节动画和精细时序管理。通过实战代码示例和性能优化技巧,帮助开发者高效构建高复杂度航天仿真系统,显著提升三维可视化效果与运行效率。

weixin_42565652的博客 213

ReACT LLM Agent:面向生产落地的推理-行动-反馈闭环架构

大语言模型(LLM)在真实业务中常因幻觉、工具调用不可控、结果不可验证而难以规模化应用。ReACT作为一种工程化Agent架构,通过显式的推理-行动-反馈循环(Reasoning-Act-Critique-Tool Feedback),将LLM的文本生成能力与结构化工具执行、强类型契约、多层校验机制深度耦合,显著提升任务可靠性与可调试性。其核心价值在于将‘能说会道’的模型转化为‘能做对事’的系统组件,广泛适用于金融风控、电商监控、政务问答等需多源工具协同与高确定性输出的场景。本文聚焦ReACT在产线中的契约

402

别再找在线API了!用C#调用微信电脑版自带的OCR,本地识别又快又准

本文详细介绍了如何利用C#调用微信电脑版内置的OCR引擎实现本地文字识别,解决传统云端API的隐私和网络依赖问题。微信OCR具备高精度中文识别、完全离线运行和零成本接入三大优势,特别适合企业文档电子化处理。通过实战代码演示了核心交互逻辑、批量处理流水线和表格数据提取等高级应用场景。

weixin_29295541的博客 589

【外挂编程】外挂编程技术揭秘(二)

引言: 经过上一篇文章大家可能对外挂有了一个初步的认识,之前的内容比较简单,应该大家很容易掌握。我写作过程中我发现三个篇幅可能写不完,后续还可能要多加几个篇幅,这篇我们就先以内存挂为主吧。话不多说了,让我们开始吧。 文章中代码github地址: https://github.com/Diamonds-ZhaoYu/hz_example 环境要求: 系统:Windows 语言...

c-rain 4033

模型替换暴露推理痕迹:LLM应用的日志治理与隔离实践

在大语言模型应用开发中,模型替换是常态操作,用于成本优化、延迟优化或稳定性兜底。然而,每次切换都可能暴露出一类被隐藏的数据——推理痕迹。这些由模型在生成最终答案前产生的中间内容,常以独立字段存在于响应体中,虽不直接影响用户界面,却可能随原始日志、缓存或网关透传在系统中留存,成为影子数据。理解模型替换与推理痕迹的碰撞原理,是构建可靠LLM应用的关键。通过日志字段白名单、提示词隔离、模型路由治理和缓存键设计,可以确保模型灵活切换的同时,不让敏感推理内容泄漏到非预期链路。本文提供一套最小可复现的诊断实验,帮助工程

cmff98425的博客 465

基于深度学习的UWB门禁检测

针对基于UWB技术智能门禁管理系统,由于测距误差或非视距原因导致门禁产生不合理动作的现象。分析如何采用基于深度学习的方法,通过对TWR测距数据、TWR监听数据、到达角度差(PDOA)、信道脉冲响应(CIR)等数据维度进行深度学习,利用 TensorFlow建立相应的推导模型,对卡片姿态进行更加精准可靠的检测,从而更好完成闸机开合控制。

tenth_quadrant的博客 2027

AI应用开发核心概念解析:从LLM、Prompt到Agent与MCP的完整工作流

大语言模型(LLM)作为当前人工智能(AI)应用的核心引擎,其本质是基于海量数据训练的概率模型,能够理解和生成自然语言。为了高效利用LLM,需要理解其无状态性、概率输出等特性,并通过Prompt工程进行精确引导。System Prompt用于定义AI角色和行为准则,而Function Calling机制则使LLM能够与外部工具和API安全交互,从而扩展其能力边界。在构建复杂应用时,确定性的Workflow(工作流)和具备自主决策能力的Agent(智能体)成为关键范式。Workflow通过预设的线性流程组织多

weixin_33951761的博客 357

如何程序化的将 Wire 文件转换成 STEP、CATIA、DWG、NX、FBX 等格式

Wire 文件是专有格式,只有 Autodesk Alias 软件能够直接打开和编辑。 虽然可以在 Alias 软件中手动打开文件并导出为 STEP,但在实际工作中,经常会遇到需要转换数十甚至数百个文件的场景。如果每次都手动操作软件进行转换,不仅效率低下,还容易出错,批量场景下会非常麻烦。因此,程序化、自动化的转换方案变得至关重要。

weixin_44211633的博客 450

YOLOv改进 | YOLOv11添加WTConv小波卷积,能够更有效地捕捉局部和全局特征

在计算机视觉目标检测领域,YOLO(You Only Look Once)系列算法凭借“单阶段检测”的高效性(一次前向传播同时完成目标定位与分类),已成为工业界与学术界的主流选择。从YOLOv1到YOLOv11,算法持续迭代优化,在速度与精度之间寻求平衡,广泛应用于自动驾驶、智能安防、工业质检等场景。为解决上述问题,本文提出一种基于,将输入特征图分解为不同频率的子带(低频全局信息与高频局部细节),并分别通过卷积操作提取局部与全局特征,最后融合多尺度特征,从而更有效地捕捉目标的局部细节与全局结构。

走向CTO的路上... 1248

大语言模型(LLM)提示词(Prompt)高阶撰写指南

—结构化思维与工程化实践。

DREAM_xs的博客 2844

目标检测基础

目标检测是计算机视觉的核心任务,需同时对图像中的物体进行定位与识别。传统方法存在速度慢、精度低等问题,而深度学习显著推动了该领域发展,使实时高精度检测成为可能。检测的核心是为每个物体预测边界框坐标和类别标签。为实现高效检测,引入了锚框机制,通过预设多尺度、多宽高比的候选区域,缩小预测偏移量,提升定位精度。训练时,通过计算锚框与真实边界框的交并比 (IoU) 确定正负样本,并基于此生成类别标签和坐标偏移量作为监督信号。该方法提升了检测器对多尺度目标和复杂场景的鲁棒性。

盼小辉丶的博客 2760

基于LLM智能体编排的自动化科研测评生成:从原理到实践

大语言模型(LLM)智能体编排是当前AI工程实践的热点,其核心原理在于通过任务分解与角色化分工,让多个专用智能体协同完成复杂认知任务,从而突破单一模型的能力局限。这一技术的关键价值在于提升任务处理的可靠性、可解释性与专业化水平,在教育测评、知识库构建、自动化内容生成等领域具有广泛应用前景。本文以自动化生成高质量科研多项选择题(MCQ)为具体场景,深入探讨了如何设计包含材料解析、题目生成、内部评审与外部验证的智能体工作流,并详细阐述了基于AutoGen等框架的实现方案、指令工程精髓以及构建自动化评估体系的方法

weixin_30598225的博客 542

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

LLM推理优化与指令对齐:从幻觉抑制到实时服务的工程实践

大语言模型(LLM)正经历从参数规模扩张向推理结构优化与训练信号质量提升的关键范式迁移。其核心原理在于:模型能力瓶颈已由‘有多大’转向‘怎么想’和‘学得准不准’——思维链设计、置信度感知解码、反事实指令微调等技术,显著改善幻觉率、推理延迟与事实一致性。这类方法具备强工程落地性,无需重训大模型,即可在13B级模型上实现TruthfulQA幻觉率下降18个百分点、P99延迟压降62%等技术价值。广泛适用于智能客服、代码辅助、实时API服务等对准确性、时延与成本敏感的业务场景。本文聚焦近期12篇高穿透力论文,解析

GOBY 栏目 478

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

上一篇: 普通人也能看懂的大语言模型入门,不要错过哦
下一篇: 小白入门《大模型应用开发极简入门》学习成为善用 AI 的人!
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


