通过负样本挖掘炼出更强Embedding模型

双塔模型-语义索引策略 [In-batch Negatives] 语义索引(可通俗理解为向量索引)技术是搜索引擎、推荐系统、广告系统在召回阶段的核心技术之一。语义索引模型的目标是:给定输入文本,模型可以从海量候选召回库中快速、准确地召回一批语义相关文本。语义索引模型的效果直接决定了语义相关的物料能否被成功召回进入系统参与上层排序,从基础层面影响整个系统的效果。在召回阶段,最常见的方式是通过双塔模型,学习Document(简写为Doc)的向量表示,对Doc端建立索引,用ANN召回。我们在这种方式的基础上,引入语义索引策略 [In-batch Negatives](https 阅读详情

一句话总结:Conan-Embedding模型,旨在通过利用更多和更高质量的负样本来提升嵌入模型的能力。

论文原文: https://arxiv.org/pdf/2408.15710

研究方法
图片

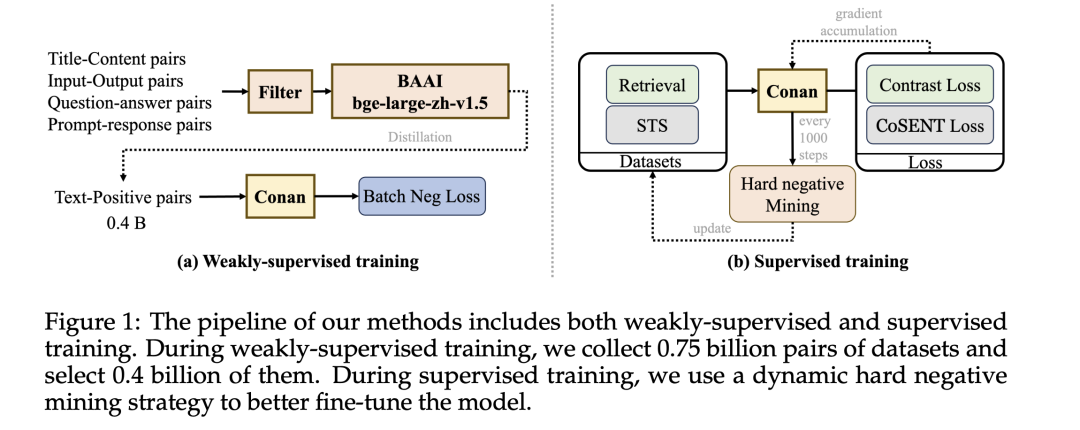
预训练阶段:

  • 使用标准数据过滤方法(参考Internlm2)对数据进行预处理。
  • 使用bge-large-zh-v1.5模型进行评分,丢弃评分低于0.4的数据。
  • 使用InfoNCE损失函数和In-Batch Negative方法进行训练,公式如下:其中,表示正样本的查询,表示正样本的段落,表示同一批次中其他样本的段落,视为负样本。

监督微调阶段:

  • 将任务分为检索和语义文本相似性(STS)两类。

  • 检索任务使用InfoNCE损失函数,公式如下:

    其中,表示查询,表示正样本,表示负样本。

  • STS任务使用CoSENT损失函数,公式如下:

    其中,是温度参数,是余弦相似度函数。

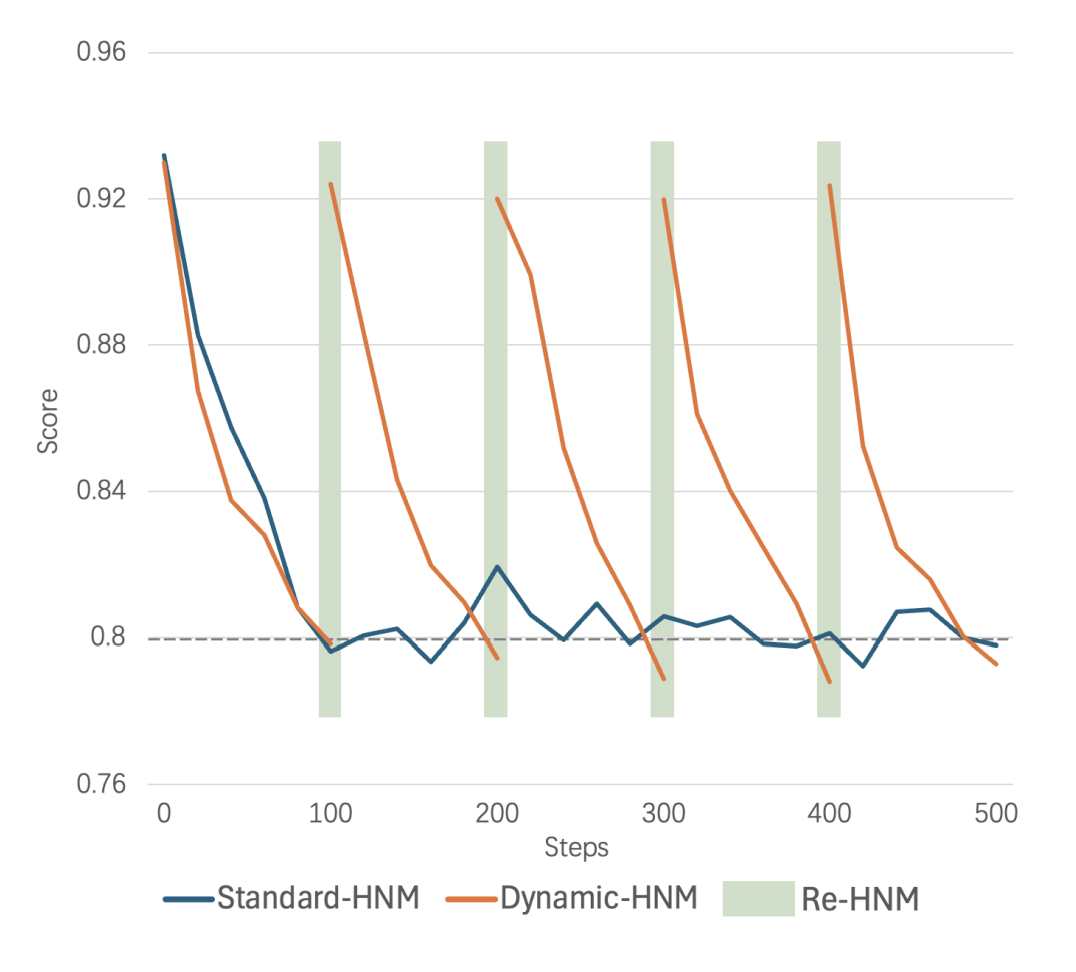
  • 动态硬负样本挖掘:

    • 记录每个数据点的当前平均负样本得分。
    • 每100次迭代后,如果得分乘以1.15小于初始得分且绝对值小于0.8,则认为该负样本不再具有挑战性,并进行新一轮的硬负样本挖掘。
图片

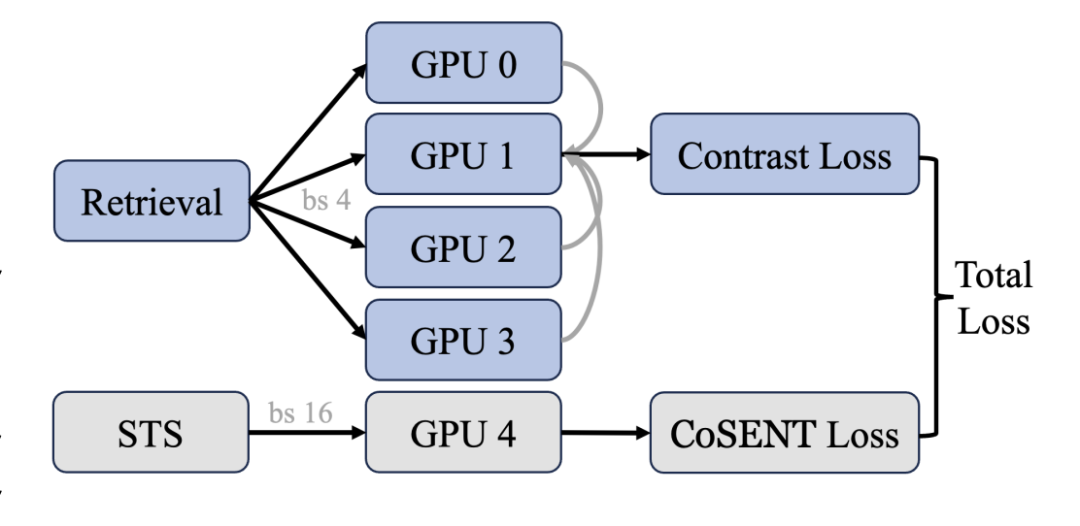
跨GPU平衡损失:

  • 在每个前向-损失-反向-更新周期内,以平衡的方式引入每个任务,以获得稳定的搜索空间并最小化单次模型更新方向与全局最优解之间的差异。
  • 对于检索任务,确保每个GPU有不同的负样本,同时共享相同的查询和正样本;对于STS任务,增加批次大小以包含更多案例进行比较。公式如下:其中,是查询和正文本之间的评分函数,通常定义为余弦相似度,是共享查询和正文本的GPU数量,是温度参数,设置为0.8。
图片

实验设计

数据集:

  • 在预训练阶段,收集了0.75亿对文本数据,分为标题-内容对、输入-输出对和问答对等类别。
  • 在微调阶段,选择了常见的检索、分类和STS任务的数据集。

实现细节:

  • 使用BERT作为基础模型,并通过线性层将维度从1024扩展到1792。
  • 使用AdamW优化器和学习率1e-5进行预训练,批量大小为8,使用64个Ascend 910B GPU进行训练,总时长为138小时。
  • 微调阶段使用相同的优化器参数和学习率,批量大小为4(检索任务)和32(STS任务),使用16个Ascend 910B GPU进行训练,总时长为13小时。

结果与分析

  • CMTEB结果:

    • Conan-Embedding模型在CMTEB基准测试中的平均性能为72.62,超过了之前的最先进模型。
    • 在检索和重排序任务中,Conan-Embedding模型表现出显著的性能提升,表明增加的负样本数量和质量使模型能够看到更具挑战性的负样本,从而增强了其召回能力。
  • 消融研究:

    • 动态硬负样本挖掘和跨GPU平衡损失显著优于直接使用标准InfoNCE损失和CoSENT损失进行微调的方法。
    • Conan-Embedding模型在检索和重排序任务中的表现尤为突出,进一步验证了该方法的有效性。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

语义检索系统【二】:基于无监督训练SimCSE+In-batch Negatives策略有监督训练的语义索引召回 阅读详情

相关推荐

树莓派CSI/DSI二合一接口深度玩法:同时驱动MIPI摄像头和屏幕的配置秘籍

本文详细解析了树莓派5上CSI/DSI二合一接口的深度玩法,提供了同时驱动MIPI摄像头和屏幕的完整配置秘籍。从硬件连接到软件设置,包括config.txt的优化配置,帮助用户充分利用树莓派5的双多功能接口,实现高效的双设备工作模式。

weixin_30687051的博客 573

对比学习中的4种经典训练模式

每天给你送来NLP技术干货!来自:圆圆的算法笔记对比学习是无监督表示学习中一种非常有效的方法,核心思路是训练query和key的Encoder,让这个Encoder对相匹配的query和key生成的编码距离接近,不匹配的编码距离远。想让对比学习效果好,一个核心点是扩大对比样本(负样本)的数量,即每次更新梯度时,query见到的不匹配key的数量。负样本数量越多,越接近对比...

zenRRan的博客 5296

FDTD仿真进阶:液晶偏振调控与双折射效应全解析

本文深入解析了在Lumerical FDTD仿真中如何对液晶材料进行偏振调控与双折射效应建模。通过单轴液晶和螺旋扭曲液晶(TN-LCD)两大实战案例,详细阐述了从各向异性材料参数设置、LC网格属性配置到偏振椭圆分析的全流程,帮助工程师精准模拟液晶的光开关行为,优化如显示器等器件的光学性能。

chair的专栏 745

RecSys 2019:对in-batch负采样进行bias校正的Google双塔模型

文章目录1.总览2.考虑到bias的softmax损失修正3.如何计算batch内item的采样概率?4.其他的一些tricks梳理4.1 Embedding标准化4.2 softmax增强 论文链接:Sampling-Bias-Corrected Neural Modeling for Large Corpus Item Recommendations 1.总览 目前,业界的推荐系统可以分成Retrieval和Ranking两个阶段,Retrieval需要从百万级以上的item库中召回到千级item作

贝壳er的博客 6023

MTK Linux Charger驱动分析(二) - power_supply_core.c

的核心作用可以概括为:提供统一的电源管理框架;管理电源设备注册、属性访问、事件通知;封装sysfs 接口和 uevent 通知,屏蔽硬件细节;驱动开发者只需要实现,不关心底层通知和接口细节。简单来说,它是电源子系统的“大脑和中枢”,具体的电池/充电器只是“信息源”。

iTom1900 1490

Geneformer实战:如何用Hugging Face Transformers快速搭建单细胞转录组分类模型

本文详细介绍了如何使用Geneformer和Hugging Face Transformers快速搭建单细胞转录组分类模型。通过环境准备、数据预处理、模型加载与配置、训练Pipeline构建等步骤,帮助读者掌握基于Transformer架构的单细胞数据分析技术,提升分类准确率和效率。

rl6adventurer的博客 605

京东:个性化语义搜索在电商搜索中的应用

作者|Chilia整理|NewBeeNLP最近笔者在实验室做一些跨语言检索的研究,这是一种「面向相关性」的向量召回方法,然而在实际的搜索应用中,仅仅考虑相关性往往是不够的。...

Kaiyuan_sjtu的博客 2725

HSPICE用户必看:用Sigrity Broadband SPICE解决复杂封装建模的3个技巧

本文为HSPICE用户分享了三个使用Sigrity Broadband SPICE解决复杂封装建模难题的实战技巧。通过将宽频带S参数高效转换为时域SPICE模型,能显著提升仿真速度、保障收敛性,并精准分析谐振、返回路径不连续及超多端口PDN等关键问题,助力实现高效稳定的系统级信号与电源完整性分析。

metal的博客 600

大模型论文 | 通过负样本挖掘炼出更强Embedding模型

在检索和重排序任务中,Conan-Embedding模型表现出显著的性能提升,表明增加的负样本数量和质量使模型能够看到更具挑战性的负样本,从而增强了其召回能力。在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。其中,是查询和正文本之间的评分函数,通常定义为余弦相似度,是共享查询和正文本的GPU数量,是温度参数,设置为0.8。其中,表示正样本的查询,表示正样本的段落,表示同一批次中其他样本的段落,视为负样本。

老皮的博客 1347

避坑指南:SAP CO模块维护成本控制范围的5个常见错误及解决方法

本文深入剖析了SAP CO模块中维护成本控制范围时最易犯的5个常见错误,包括货币参数配置不当、标准层次结构缺失、财政年度变式不一致、功能激活遗漏及集成参数设置错误。重点针对事务码OKKP的配置,提供了详细的排查步骤与实战解决方案,帮助顾问有效规避陷阱,确保成本核算体系稳定运行。

stone的博客 234

手把手教你用Microsoft AEC Challenge数据集训练自己的回声消除模型(附完整代码)

本文详细介绍了如何使用Microsoft AEC Challenge数据集训练专业的回声消除模型,包括环境准备、数据清洗、模型架构设计、训练流程和实际部署注意事项。通过完整的代码示例和实战指南,帮助开发者快速掌握AEC技术,提升语音通信系统的回声消除效果。

weixin_27697385的博客 457

探索更强中文Embedding模型:Conan-Embedding

随着大模型时代的爆发,检索增强生成技术(RAG)在大语言模型中广泛应用。RAG是一种性价比极高的方案,在大语言模型中占据重要地位。Embedding模型作为RAG中检索召回的重要一环,扮演着极其关键的角色。更加准确的Embedding模型在抑制模型幻觉、增强新热知识表现、提升封闭领域回答能力等方面都能发挥优势。

Gaga246的博客 2361

经典的YOLOv3和YOLOV5算法详解及代码复现

yolov3和yolov5算法详解及代码复现

hasakie的博客 771

更强Embedding模型——Conan-Embedding

随着大模型时代的爆发,检索增强生成技术(RAG)在大语言模型中广泛应用。RAG是一种性价比极高的方案,在大语言模型中占据重要地位。Embedding模型作为RAG中检索召回的重要一环,扮演着极其关键的角色。更加准确的Embedding模型在抑制模型幻觉、增强新热知识表现、提升封闭领域回答能力等方面都能发挥优势。 为了提升RAG系统的性能表现,我们近期针对如何训练更强的Embedding模型进行探索,训练得到了目前最强中文Embedding模型「Conan-Embedding」,该模型已在C-MTEB上达到

AI前沿技术的分享! 1607

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

大模型入门到精通!探索更强中文Embedding模型:Conan-Embedding

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 2053

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

【Conan-embedding模型排名第一的embedding中文模型】

详细解释动态难负样本挖掘的工作流程。"""判断是否需要替换负样本""""""获取替换样本的索引范围""""""模拟训练过程"""# 初始化# 初始负样本# 记录训练过程# 模拟训练迭代# 模拟模型逐渐学习负样本的过程# 随着训练进行,得分会降低(模型越来越确信这些是负样本)# 首次记录初始得分# 每隔update_interval次迭代检查是否需要替换# 如果需要替换# 运行模拟并可视化结果。

一休 2091

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

PaddleNLP 对比学习实战:文本 Embedding 模型的数据清洗、硬负样本挖掘、训练与评估全流程

以 PaddleNLP 仓库中 `slm/examples/contrastive_learning` 的对比学习(Contrastive Learning)示例为蓝本,本篇完整走通文本向量模型(Embedding Model)的对比学习闭环:按 `query / pos_passage / neg_passage` 格式组织数据,用多卡推理 + FAISS 完成相似 query 清洗与硬负样本挖

gitblog_00005的博客 441

LLMs之EmbeddingModel:《Conan-embedding: General Text Embedding with More and Better Negative Samples》翻

​ LLMs之EmbeddingModel:《Conan-embedding: General Text Embedding with More and Better Negative Samples》翻译与解读 目录 《Conan-embedding: General Text Embedding with More and Better Negative Samples》翻译与解读 Abstract 1 Introduction 4、Conclus

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 2209

[论文笔记]Conan-embedding: General Text Embedding with More and Better Negative Samples

⭐ 作者提出了Conan-Embedding模型,提出在训练过程中动态挖掘更好的难负样本的方法,取得了SOTA结果。

日积月累,天道酬勤 1752

Embedding模型微调:基于对比学习的训练与优化实践,大模型入门到精通,收藏这篇就足够了!

本文将以一个基于PyTorch的训练脚本为核心,结合对比学习中的InfoNCE损失,详细解析如何实现Embedding模型的微调。

huang9604的博客 1547

腾讯开源Conan-embedding,登顶CMTEB

今天给大家带来一篇腾讯最新开源的向量模型的论文,模型开源,在CMTEB上拿了第一名!嵌入/向量模型是Agent、RAG中很关键的一个组件,所以也是一个卷的很激烈的一个领域。随着RAG(检索增强生成)技术的日益普及,嵌入模型的能力正受到越来越多的关注。嵌入模型主要通过对比学习进行训练,其中负样本是一个关键组件。以往的研究提出了各种硬负样本挖掘策略,但这些策略通常被作为预处理步骤使用。在本文中,我们提出了conan-embedding模型,该模型最大化地利用更多、更高质量的负样本。

m0_59235945的博客 5121
上一篇: 一书讲透LLM大语言模型,《掌握大型语言模型》,看完我都懵了!
下一篇: 普通人也能看懂的大语言模型入门,不要错过哦
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


