vLLM如何提升大模型的推理效率?

【LLM】vLLM部署与int8量化 介绍了vLLM原理并讲解如何支持peft,对不同的decoding methods进行了说明,同时详述了int8量化的过程。 阅读详情
AI摘要

本文介绍了用于自然语言处理的vLLM模型框架,它旨在提高大模型推理性能和效率。先分析了当前大模型推理中KV Cache太大、解码算法复杂、输入输出长度未知等问题,接着阐述了vLLM的PagedAttention算法、KV Cache Manager组件及其他解码场景优化方案,评估显示其能提升吞吐量。

0. 引言

vLLM(Virtualized Language Learning Model)是一种用于自然语言处理(NLP)的模型框架,旨在提高大规模语言模型(如GPT等)推理的性能和效率。

论文看这里:《Efficient Memory Management for Large Language Model Serving with PagedAttention》

代码看这里:https://github.com/vllm-project/vllm

本文结合论文详细介绍下为什么需要 vLLM,以及 vLLM 内部的原理是什么,带来了哪些提升。

1. 现状

在模型推理时, GPU 的内存分配如下:img其中:
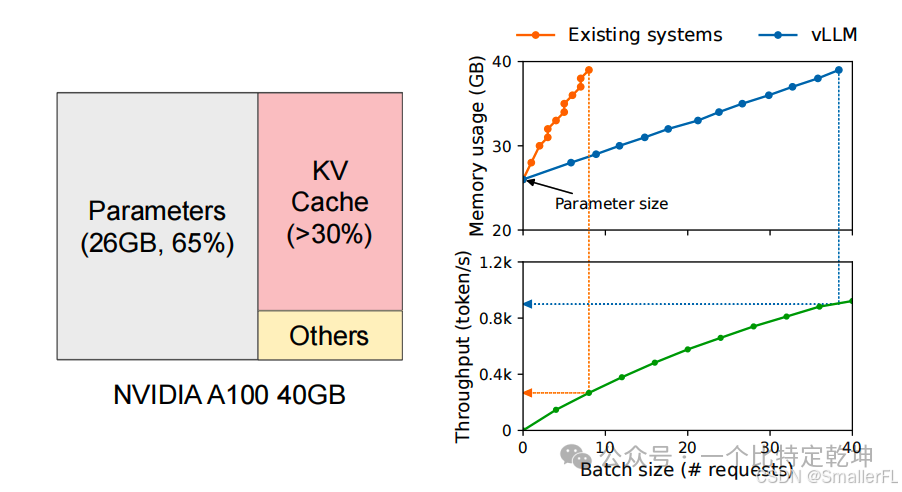
(1)Parameters 保留权重等参数,是静态的,这部分无法优化;

(2)KV Cache 是 Transformer 的 attention 机制引入的中间缓存,这部分下面会详细说明;

(3)Others 是临时激活函数使用,占用比例较小,优化空间不大。

从上面 GPU 的内存分配来看,KV Cache 是影响推理吞吐量的瓶颈,如果 KV Cache 管理不好,导致一次推理输出的数量太少,就会导致推理速度降低。

2. 技术前提

下面介绍 LLM 依赖的技术,了解技术前提才能看清 LLM 推理时会存在哪些问题。

2.1 基于 Transformer

现在的 LLM 基本上都基于 Transformer,如果不是基于Transformer,那么 vLLM 这套机制恐怕不能生效。

简单列出关键公式,注意力机制公式如下:

在这里插入图片描述

其中:

在这里插入图片描述

上面向量的维度情况:

在这里插入图片描述

2.2 自回归生成

大模型一般是基于语言模型,即根据前面的语句预测下一个字的概率:

在这里插入图片描述

在这里插入图片描述

这里的 、 向量涉及到 KV Cache 的核心,缓存的就是这些向量。

3. 存在哪些问题

3.1 KV Cache 太大

LLM 服务需要为每个请求维护一个键值(KV)缓存,用于存储模型在生成文本时的上下文信息。随着请求数量的增加,KV缓存的大小迅速增长,占用大量 GPU 内存。

对于13B 参数的模型,单个请求的 KV Cache 可能就需要数 1.6 GB的内存。这限制了同时处理的请求数量,进而限制了系统的吞吐量。

3.2 复杂的解码算法

LLM 服务通常提供多种解码算法供用户选择,如贪婪解码、采样解码和束搜索(beam search)。这些算法对内存管理的复杂性有不同的影响。

例如,在并行采样中,多个输出可以共享相同的输入提示的 KV 缓存,而在束搜索中,不同候选序列的KV缓存可以部分共享,这要求内存管理系统能够动态调整内存分配。

3.3 未知的输入和输出长度

LLM 服务的输入和输出长度是变化的,这要求内存管理系统能够适应不同长度的提示。随着请求的输出长度在解码过程中增长,所需的 KV 缓存内存也会增加,可能会耗尽用于新请求或现有的内存。

现有的 LLM 服务系统通常采用静态连续内存分配策略,会带来三个方面的内存浪费:img(1)预留浪费(reserved)。为每个请求预留最大可能序列长度的内存,然而实际请求的长度可能远小于最大长度;
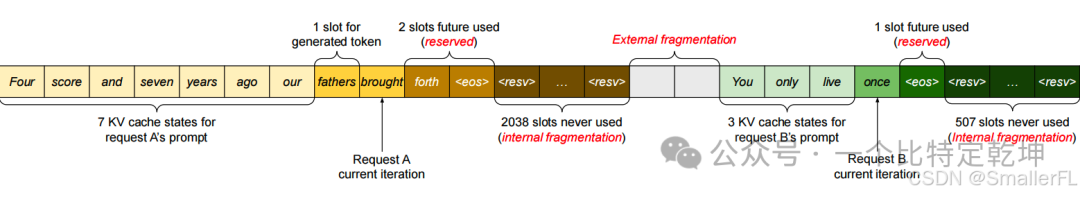
(2)内部碎片(internal fragmentation)。内存分配的低效率还会导致内存碎片,进一步降低内存的可用性;

(3)外部碎片(external fragmentation)。有些内存由于过小,无法使用,这些内存则直接浪费了。

4. vLLM 方案

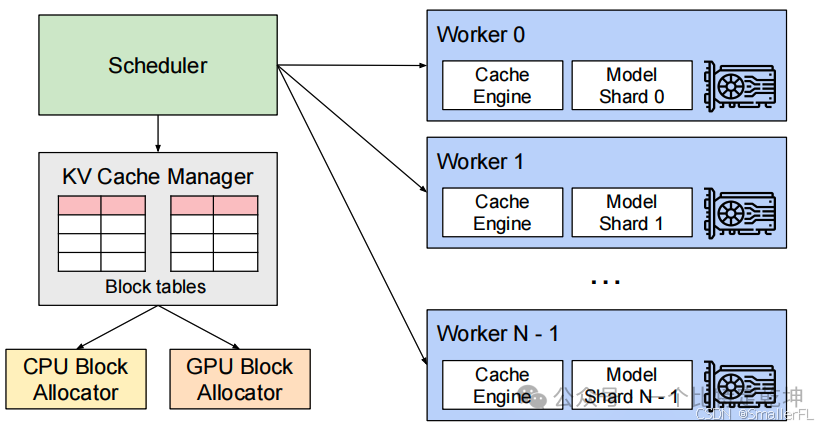
为了解决这些挑战,vLLM 提出了一种新的注意力算法 PagedAttention,并构建了一个高效的内存管理系统:KV Cache Manager,通过分页技术来管理 KV Cache,从而提高内存的利用效率,减少内存浪费,并支持更复杂的解码算法。这种方法允许在非连续的物理内存中存储连续的键和值,使得内存管理更加灵活,能够更有效地处理 LLM 服务中的内存挑战。

下面是 vLLM 的架构:img
4.1 PagedAttention

PagedAttention 是一种受操作系统中虚拟内存和分页技术启发的注意力算法。它允许将连续的 和 向量存储在非连续的内存空间中。这一点与传统的注意力算法不同,后者通常要求 和 向量在内存中连续存储。img
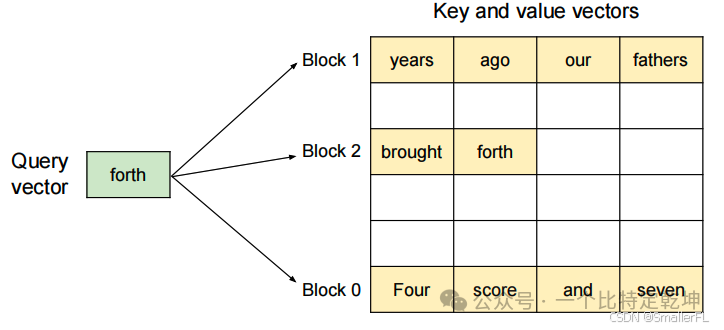
算法原理:(1)KV缓存分块:PagedAttention 将每个序列的 KV Cache 划分为多个 KV 块(KV blocks)。每个块包含了固定数量的 token 的 和 向量。(2)非连续存储:与传统方法不同,PagedAttention 允许这些 KV 块在物理内存中非连续地存储。这种设计使得内存管理更加灵活。(3)按需分配:PagedAttention 按需分配 KV 块,这减少了内存碎片,并允许跨请求或同一请求内不同序列之间的内存共享。

4.2 KV Cache Manager

KV Cache Manager 是 vLLM 系统中的一个核心组件,负责以分页的方式高效管理 KV Cache。这一管理器的设计灵感来源于操作系统中的虚拟内存管理技术,特别是分页机制。

主要功能:

(1)逻辑与物理块映射:它维护一个块表(block table),记录逻辑 KV 块与物理 KV 块之间的映射关系。这种分离允许动态地增长 KV Cache 内存,而无需预先为其所有位置分配内存。

(2)动态内存分配:KV Cache Manager 根据需要动态地分配物理 KV 块,这消除了现有系统中的大部分内存浪费。

(3)内存共享:通过页级内存共享,KV Cache Manager 支持在不同请求之间共享 KV Cache,进一步减少内存使用。

下面是一个例子说明 KV Cache Manager 和 PagedAttention 的工作机制:img(1)一个 Block 最大存储 4 个 token。开始输入Four score and seven years ago our 一共7个token,因此逻辑 KV 块 Block 0 填充前4个,对应于物理 KV 块的 Block 7;剩下3个 token 填充逻辑 KV 块 Block1,对应于物理 KV 块的 Block 1,但是并没有填满,对应的 Block Table 的 #filled 写入3;
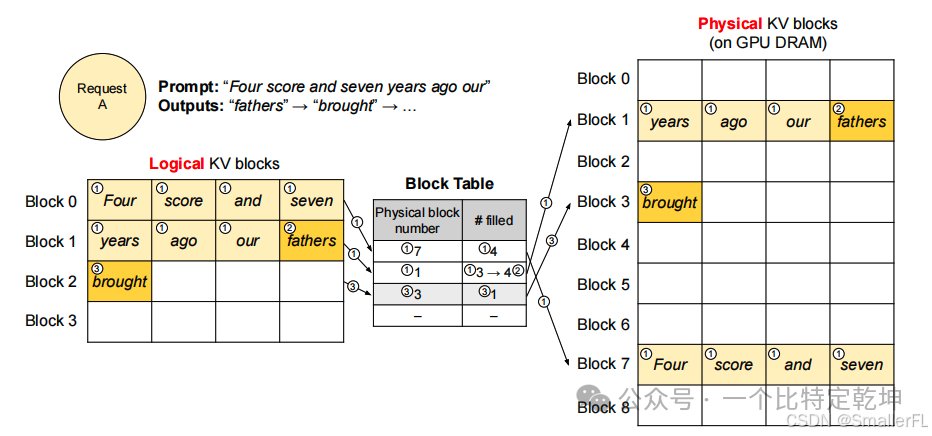
(2)当自回归生成下一个 token fathers 后,物理 KV 块的 Block 1 同时写入,并且对应的 Block Table 的 #filled 由 3 改写成 4;

(3)自回归生成下一个 token brought 后,流程类似,不再赘述。

4.3 其他解码场景

4.3.1 Parallel sampling
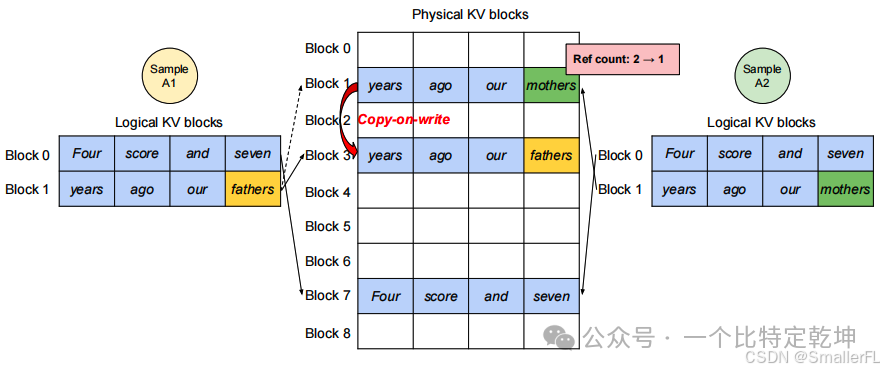
img(1)有 A1 和 A2 并行采样,A1 和 A2 的逻辑 Block 0 的内容一致,实际上在物理 KV 块中只会存一份,对应 Block 7,此时 Block 7的引用计数是 2;

(2)当 A1 和 A2 的 Block 1 都是 years ago our 时,对应于物理 KV 块的 Block 1,此时 Block 1的引用计数是 2;

(3)在生成阶段时,A1、A2 生成下一个字的结果不一样,A1 是 fathers 而 A2 是 mothers,这样 Block 1 会触发写时复制(copy on write),复制一份到 Block 3,同时 Block 1 填入 mothers,Block 3 填入 fathers。Block 1的引用由2计数减1,变成1。

4.3.2 Beam search

与并行解码不同,束搜索(beam search)不仅支持共享初始提示块,还支持不同候选之间的其他块共享,并且随着解码过程的推进,共享模式会动态变化,类似于操作系统中由复合分叉创建的进程树。img
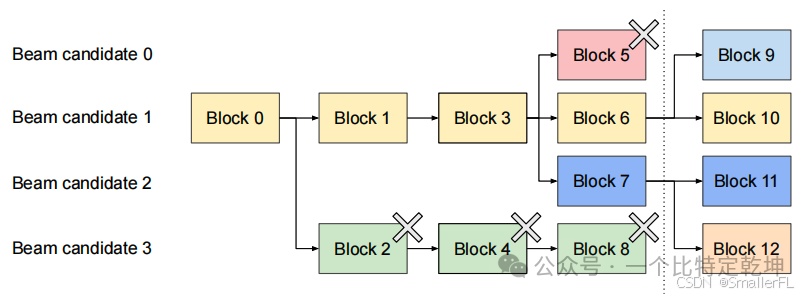
根据上图,介绍 vLLM 如何管理 Beam search 的 KV 块其中束宽 k = 4。

(1)图中,虚线左边是迭代之前,右边是迭代后的结果

(2)在虚线所示的迭代之前,每个候选序列已经使用了4个完整的逻辑块。

Beam candidate 0 是 Block 0 -> Block 1 -> Block 3 -> Block 5

Beam candidate 1 是 Block 0 -> Block 1 -> Block 3 -> Block 6

Beam candidate 2 是 Block 0 -> Block 1 -> Block 3 -> Block 7

Beam candidate 3 是 Block 0 -> Block 2 -> Block 4 -> Block 8

所有束候选共享第一个块,即 Block 0。从第二个块开始,候选3与其他候选不同。候选0-2共享前3个块,并在第4个块处发散。

(3)在虚线所示的迭代之后,所有块(Block9~12)都来自于候选1和2。由于原始候选0和3不再在候选之列,它们的逻辑块被释放,相应物理块的引用计数减少。vLLM 释放所有引用计数达到0的物理块(Block 2、4、5、8)。然后,vLLM 为新候选分配新的物理块(Block 9-12)来存储新的 KV 缓存。

(4)现在,所有候选共享Block 0、1、3;候选0和1共享Block 6,候选2和3进一步共享 Block 7。

4.3.3 共享前缀

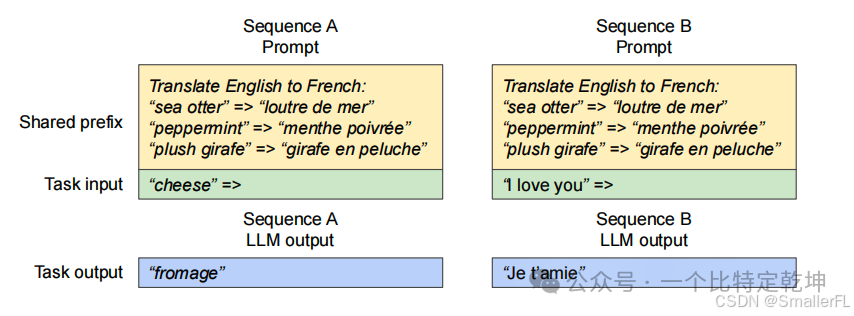
共享前缀是指在多个用户请求中重复出现的文本序列,这些序列通常位于请求的开始部分。在大型语言模型的应用中,如机器翻译或聊天机器人,用户经常提供包含指令和示例输入输出的长描述。这些描述被连接到实际任务输入以形成请求的提示(prompt)。
img在这里插入图片描述

vLLM 系统通过以下方式优化 共享前缀 的处理:

(1)预存储KV缓存:vLLM 可以预先存储共享前缀的 KV Cache,这样在处理包含该前缀的请求时,就不需要重新计算这部分的 KV Cache,从而减少冗余计算。

(2)映射逻辑块到物理块:在用户输入提示包含共享前缀时,vLLM 可以将提示的逻辑块映射到预先缓存的物理块。这样,只有用户特定任务输入的部分需要在模型中进行处理。

(3)提高效率:通过这种方式,vLLM 可以更高效地利用内存和计算资源,因为共享前缀的计算只需进行一次,而不是在每个请求中重复进行。

共享前缀的应用场景包括:

(1) 机器翻译:用户可能会提供一个包含翻译指令和几个示例翻译对的长描述。这些描述的开始部分(即共享前缀)在多个请求中是相同的。

(2)聊天机器人:在聊天应用中,用户与机器人的交互历史可能会被用作上下文,以便生成更准确的响应。这些交互历史的一部分可能会在多个请求中重复出现。

5. 结论
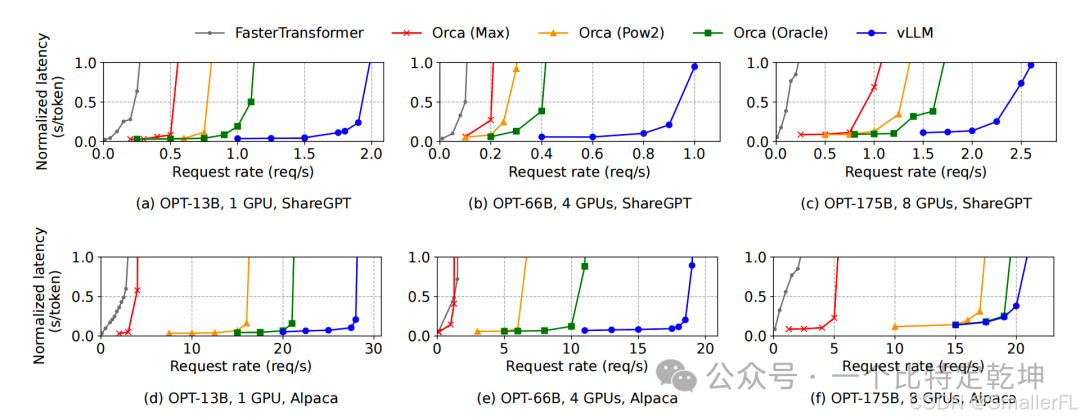
img在这里插入图片描述

评估表明,与 FasterTransformer 和 Orca 等最先进的系统相比,vLLM 在相同的延迟水平下将流行 LLM 的吞吐量提高了2-4倍。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

从部署到调优:手把手教你用vLLM-Ascend后端提升大模型推理效率 本文详细介绍了如何通过vLLM-Ascend后端从基础部署到高级调优,提升大语言模型在昇腾NPU上的推理效率。涵盖环境部署、参数设置、内存优化和计算效率提升等关键步骤,帮助开发者解决内存利用率低和吞吐量不足等挑战,实现高性能推理服务。 阅读详情

相关推荐

vLLM框架:提升大模型推理效率的关键技术解析

在AI模型推理服务中,显存管理和请求调度是影响性能的核心因素。传统方法面临显存碎片化和批处理效率低下的问题,而vLLM框架通过创新的PageAttention机制和Block级内存池技术,显著提升了显存利用率和推理吞吐量。PageAttention借鉴操作系统虚拟内存管理思想,实现Token序列到物理Block的高效映射,配合动态批处理策略,可减少40%以上的内存占用。该技术特别适合处理变长序列的LLM推理场景,在GPT类模型部署中实测QPS提升3-5倍。对于需要高并发、低延迟的大模型服务,vLLM的显存优

weixin_33212799的博客 296

vLLM初探

是一个快速且易于使用的库,用于 LLM 推理和服务,可以和HuggingFace 无缝集成。vLLM利用了全新的注意力算法「PagedAttention」,有效地管理注意力键和值。在吞吐量方面,vLLM的性能比HuggingFace Transformers(HF)高出 24 倍,文本生成推理(TGI)高出3.5倍。是伯克利大学LMSYS组织开源的大语言模型高速推理框架,旨在极大地提升实时场景下的语言模型服务的吞吐与内存使用效率。

邹中凡 7277

vLLM框架:提升大模型推理效率的关键技术与实践

在自然语言处理(NLP)领域,大模型推理面临着显存利用率低和计算效率不足的挑战。通过创新的内存管理技术如PagedAttention,现代推理框架能显著提升硬件资源利用率。vLLM作为开源推理框架的突破性进展,其核心价值在于将显存利用率从传统方法的不足30%提升至80%以上,实现高达20+的并发请求处理能力。该技术特别适用于需要处理长序列的客服对话、内容生成等场景,结合AWQ量化技术可进一步降低显存需求。从工程实践角度看,合理的批处理参数调优和流式输出实现能有效平衡延迟与吞吐量,而生产环境中的多实例部署方案

weixin_31458015的博客 296

一文说清VLLM .VS.Ollama的区别

对比VLLM与Ollama,解析两者在性能、易用性和应用场景的异同,助你选择合适框架。

打造全国最全的AI Agent开发知识领域的博客 5349

vLLM技术解析:提升大模型推理效率的关键方法

大语言模型(LLM)推理效率是当前AI工程化的核心挑战。传统注意力机制存在显存碎片化问题,导致资源利用率低下。vLLM通过创新的PagedAttention技术,将KV缓存分页管理,配合连续批处理等优化手段,显著提升推理性能。该技术在电商客服、金融风控等场景中,能实现毫秒级延迟和高吞吐量,如QPS从120提升至680。对于部署实践,需关注GPU选型、内存利用率参数调优,并可采用AWQ量化等方案进一步压缩模型。vLLM已证明在实时对话、长文本生成等场景具有显著优势,是工业级LLM部署的重要工具。

weixin_29053577的博客 226

LLM 大模型学习必知必会系列(十二):VLLM性能飞跃部署实践:从推理加速到高效部署的全方位优化[更多内容:XInference/FastChat等框架]

LLM 大模型学习必知必会系列(十二):VLLM性能飞跃部署实践:从推理加速到高效部署的全方位优化[更多内容:XInference/FastChat等框架]

丨汀、的博客 6373

ChatTTS与vLLM集成实战:如何提升大模型推理效率

最近在部署大模型服务时,经常被一个问题困扰:模型本身能力很强,但一到实际线上推理,响应速度就慢得让人着急,尤其是在面对突发性并发请求时,延迟飙升,GPU显存吃紧,成本居高不下。经过一番探索和实战,我发现将与集成,是提升推理效率的一剂良药。下面就把我的实践笔记分享给大家,希望能帮你绕过一些坑。

2600_94960238的博客 1017

大模型推理加速框架vllm部署的实战方案

本文主要介绍了大模型推理加速框架vllm部署的实战方案,希望对学习大语言模型的同学们有所帮助。 文章目录 1. 前言 2. 配置环境 2.1 安装虚拟环境 2.2 安装依赖库 3. 运行vllm

herosunly的博客 3万+

【干货收藏】vLLM架构揭秘:让大模型推理效率提升10倍的底层原理

vLLM是一种高性能的大语言模型推理框架,通过引入操作系统的虚拟内存与分页机制解决GPU内存管理效率问题。其核心是三层进程架构:API服务器进程处理请求接入与协议转换;引擎进程作为控制中枢,包含KVCacheManager和调度器;GPU工作进程执行计算。vLLM的PagedAttention内核通过块表实现逻辑地址与物理存储分离,用高效的gather操作替代传统内存访问模式,显著提升了大模型推理的内存利用率和计算效率。

嘴巴吃糖了 1370

电力现货市场出清机制与节点电价计算实战解析

本文深入解析了电力现货市场的出清机制,特别是节点边际电价的计算原理与实战应用。通过一个基于Matlab和IEEE30节点系统的完整案例,详细演示了如何利用最优潮流模型求解市场出清价格,并提取节点电价,揭示了电网阻塞如何影响实时电价的形成。

weixin_29061425的博客 950

Unity资源逆向解析:从APK到AssetStudio的完整实战

本文详细介绍了Unity资源逆向解析的全流程,从APK解包到使用AssetStudio深度解析Unity游戏资源。通过实战案例演示如何提取《植物大战僵尸》等游戏的素材,包括贴图、音频和3D模型,帮助开发者掌握Unity游戏逆向工程的核心技术。

weixin_30664051的博客 475

VLLM大模型推理革命:三大核心技术揭秘,效率提升163%,成本直降75%!

VLLM作为大模型工程化"基础设施",通过三大核心技术显著提升推理效率:Page Attention技术降低75%显存占用,Continuous Batching实现吞吐量提升3.3倍,内存池管理减少90%碎片。实战案例显示,VLLM可将延迟降低68%,GPU利用率提升163%,服务器成本减少75%。文章详解技术原理、实战案例、部署调优及面试要点,是掌握大模型推理优化的必学内容。

2401_85328934的博客 1655

基于开源项目构建 CFS(网络靶场实战演练)平台

摘要:构建CFS网络靶场可使用多个开源组件组合,包括EVE-NG/GNS3或ContainerLab构建网络环境,Kasm提供工作空间,CALDERA+Atomic Red Team实现攻击模拟,DetectionLab建立防御环境,Malcolm/Arkime进行流量监控,CyRIS提供编排框架,Vulhub/DVWA创建漏洞靶标。关键在于通过API深度集成各组件,同时需注重安全隔离、资源规划及维护成本。建议开发统一管理平台,结合Ansible/Terraform实现自动化部署,打造定制化实战演练环境。(

深山技术宅的博客 1846

VLLM vs 传统部署:大模型推理效率提升300%的秘密

在batch size从1到32的梯度测试中,VLLM展现出明显优势。更令人惊喜的是显存管理:相同条件下VLLM可节省约40%的显存占用,这意味着单卡可以承载更大的模型或更高的并发。最近在团队的技术选型中,我们遇到了一个关键问题:如何在大语言模型推理场景中实现最高效的部署方案。我们选择了相同的硬件配置(NVIDIA A100 40GB显卡)和模型(Llama2-7B),确保对比实验的公平性。上做这类性能对比实验特别方便,它的云端环境配置简单,还能一键部署测试服务,省去了搭建本地环境的麻烦。

GoldenleafRaven13的博客 623

2026.2.11:ollama api推理GLM-OCR模型识别图片

本文介绍了使用Ollama API调用GLM-OCR模型进行图片文字识别的过程。首先通过ollama pull glm-ocr:latest命令拉取模型,然后使用Python脚本调用API接口。代码示例展示了如何发送包含图片路径的请求,并处理返回的识别结果,支持文本、公式和表格三种识别模式。运行结果展示了模型对输入图片的识别效果,为开发者提供了便捷的OCR解决方案。

拥抱具身智能,昇腾Ascend C 367

【项目实战】AES实施应符合NIST密码算法验证程序

AES由美国国家标准与技术研究院(NIST)制定。NIST是负责开发和维护美国政府使用的技术标准的机构,包括加密标准。

奶爸的编程之路,也就一周冷个三天 766

vLLM vs 传统部署:大模型推理效率提升300%的秘诀

经过一番调研,我决定用vLLM这个新兴框架来优化部署流程,并通过对比测试验证其实际效果。可以快速体验vLLM的部署效果,其内置的Jupyter环境能直接运行测试脚本,还能一键发布为可访问的API服务。这次测试让我深刻体会到,好的系统设计能释放硬件潜力。vLLM通过内存管理和调度算法的创新,让大模型推理从实验室走向了生产环境。| 显存占用(GB) | 31.2 | 22.5 | 28% || 指标 | 传统方式 | vLLM | 提升幅度 |多租户共享GPU资源。

BlackStone33的博客 919

Qt项目开发实例 (含源码)

qt教程、qt项目、qt下载、qt项目实战、qt多线程。本文通过分析demo源码,QT实战的方式进行学习,学习路线是以实战为目录,全面的使用自己的学习知识,文章中编写一系列的学习游戏demo,与大家一起分享。

啊渊的专栏 14万+

vLLM与PagedAttention:提升大模型推理效率的内存优化方案

在大语言模型推理部署中,内存管理是影响服务吞吐量和并发能力的关键瓶颈。传统方法在处理变长序列时,由于KV缓存分配不灵活,会产生大量内存碎片,导致显存利用率低下。PagedAttention算法借鉴了操作系统虚拟内存的分页管理思想,将注意力计算中的键值缓存进行分块管理,从而显著减少了内存浪费。这项技术使得在同等硬件条件下,能够支持更高的并发请求、处理更长的上下文序列,或者以更少的显存运行更大的模型。vLLM作为基于PagedAttention的高性能推理引擎,提供了开箱即用的生产级解决方案,其OpenAI兼容

weixin_29044157的博客 303

[数学建模][2012年A国赛模拟] 3. 葡萄酒的评价

暑期学校数学建模培训第三次模拟:2012年国赛A题,一道完全统计方面的题目。据老师反映当年有位老师所带领小组取得“全国10佳优秀论文奖”,我们大组搞统计的老师建模能力不行,但其统计理论非常扎实,在此期间给予我们非常大的帮助,十分感谢老师的倾囊相授。我们小组的定位也不在统计方向,主攻物理建模及优化模型,故本次模拟就用SPSS软件简单做了下,还是学到了多元统计的许多知识,达到了本次训练的目的。 ...

Y-puyu 的博客 3万+

openHarmony之AI Engine:万字讲解如何在应用、开发板上接入AI大模型调用

本文章介绍如何在 OpenHarmony 开发板上集成和部署各类 AI 大模型,实现终端直接聊天功能,并为语音助手、智能机器人等应用提供 AI 接口支持。

m0_67505153的博客 620

vLLM+SGLang双引擎加速!让大模型推理效率提升300%

vLLM通过PagedAttention显著提升显存利用率和吞吐性能,SGLang支持结构化输出与控制流,二者在ms-swift框架中智能协同,实测推理效率提升达300%,实现高并发下稳定、低成本的大模型服务部署。

weixin_42513928的博客 783

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

vLLM:提升大模型推理效率的连续批处理与页式注意力技术

大模型推理优化是当前生成式AI落地的关键技术挑战,其核心在于提高计算资源利用率和降低延迟。连续批处理(Continuous Batching)技术通过动态调度算法实现请求的即时插入和优先级管理,显著提升吞吐量并降低延迟。页式注意力(PagedAttention)则借鉴操作系统内存管理思想,将KV缓存划分为固定大小的页,实现非连续存储和动态分配,大幅提高显存利用率。这些技术使vLLM框架在LLM推理中展现出卓越性能,特别适用于高并发场景如客服系统和多轮对话应用。结合Python原生API设计,vLLM为从实验

weixin_31742871的博客 202

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

vLLM并行批量推理实战:提升大模型生成效率的关键技巧

本文详细介绍了如何利用vLLM框架的并行批量推理能力,显著提升大语言模型的生成效率。通过实战代码演示了从环境搭建、核心API使用到高级调优(如量化与参数优化)的全过程,并分享了构建健壮批量推理服务的关键技巧,帮助开发者在有限硬件资源下实现吞吐量倍增。

weixin_29065791的博客 274

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Qwen2.5-7B大模型推理优化|vLLM提升CPU效率

本文系统阐述了如何在无 GPU 环境下使用 vLLM 高效运行 Qwen2.5-7B-Instruct 模型,并通过实际代码演示了批量生成与结构化对话两种典型应用场景。维度实践结论可行性Qwen2.5-7B 可在 CPU 上稳定运行,适合离线批处理性能表现输出速度可达 6–9 tokens/s,满足多数非实时需求关键技术vLLM 的 PagedAttention + CPU offload 是关键支撑成本效益相比 GPU 实例,长期运行成本下降 70%+

weixin_34268462的博客 1199
上一篇: 真不夸张!这是我读过最通透的大模型神书!《​基于LangChain进行生成式AI开发》
下一篇: 一书直接讲透自然语言处理《Getting Started with Google BERT_ Build and train》
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


