


文章目录
前言
记得我刚学python-requests库的时候总会有点晕,于是我做了以下关于requests库的知识点整理,方便初学者可以更好的了解requests库。如果有补充或错误,或者不懂的地方,可以评论区留言。

1、Requests介绍
Requests是Python一个很实用的HTTP客户端,完全满足如今网络爬虫的需求
urllib库和requests库功能类似,但requests库功能更多更实用
2、requests库的安装
pip命令安装(方法一)
- windows操作系统:pip install requests
- Mac操作系统:pip3 install requests
- Linux操作系统:sodo pip install requests
源码安装(方法二)
- 下载 requests源码 http://mirrors.aliyun.com/pypi/simple/ requests/
- 下载文件到本地之后,解压到Python安装目录,之后打开解压文
- 运行命令行输入python setup.py install 即可安装
测试
- import requests
- 如果没提示错误,那说明已经安装成功了!
3、requests库常用的方法
序号 | 方法 | 描述 |
1 | requests.request(url) | 构造一个请求,支持以下各种方法 |
2 | requests.get() | 发送一个Get请求 |
3 | requests.post() | 发送一个Post请求 |
4 | requests.head() | 获取HTML的头部信息 |
5 | requests.put() | 发送Put请求 |
6 | requests.patch() | 提交局部修改的请求 |
7 | requests.delete() | 提交删除请求 |
最常用的方法为get()和post()分别用于发送Get请求和Post请求
4、response对象的常用属性
序号 | 属性或方法 | 描述 |
1 | response.status_code | 响应状态码 |
2 | response.content | 把response对象转换为二进制数据 |
3 | response.text | 把response对象转换为字符串数据 |
4 | response.encoding | 定义response对象的编码 |
5 | response.cookie | 获取请求后的cookie |
6 | response.url | 获取请求网址 |
7 | response.json() | 内置的JSON解码器 |
8 | Response.headers | 以字典对象存储服务器响应头,字典键不区分大小写 |
5、使用requests发送get请求
- 不带参数的get请求
- 案例:爬取百度主页
- 带参数的get请求
- 案例:贴吧
- 获取JSON数据
- 案例:百度美女图片
- 获取二进制数据
- 案例:下载百度logo
5.1 不带参数的get请求
\# 不带参数的get请求

import requests
url='http://www.baidu.com'
resp = requests.get(url)
# 设置响应的经编码格式
resp.encoding='utf-8'
cookie=resp.cookies    # 获取请求后的cookie信息
headers=resp.headers
print('响应状态码:', resp.status\_code)
print('请求后的cookie:', cookie)
print('获取请求的网址:', resp.url)
print('响应头:', headers)
print('响应内容', resp.text)
----------------------------------以下为输出结果----------------------------------
'''
响应状态码: 200
请求后的cookie: <RequestsCookieJar\[<Cookie BDORZ=27315 for .baidu.com/>\]>
获取请求的网址: http://www.baidu.com/
响应头: {'Cache-Control': 'private, no-cache, no-store, proxy-revalidate, no-transform', 'Connection': 'keep-alive', 'Content-Encoding': 'gzip', 'Content-Type': 'text/html', 'Date': 'Fri, 23 Apr 2021 00:10:35 GMT', 'Last-Modified': 'Mon, 23 Jan 2017 13:28:16 GMT', 'Pragma': 'no-cache', 'Server': 'bfe/1.0.8.18', 'Set-Cookie': 'BDORZ=27315; max-age=86400; domain=.baidu.com; path=/', 'Transfer-Encoding': 'chunked'}
响应内容 <!DOCTYPE html>
<!--STATUS OK--><html> <head><meta http-equiv=content-type.........
'''
5.2 带参数的get请求
5.2.1 查询参数params
- params,数据类型为字典
- 作用:对URL地址中的查询参数自动进行编码拼接
- 使用示例:resp = requests.get(url=baseurl, params=params, headers=headers)
\# 带参数的get请求

import requests
url = 'https://tieba.baidu.com/f?'
params = {'kw':'大学吧', 'pn':'3'}
headers = {'User-Agent' : 'Mozilla/5.0 (Windows NT 6.1; WOW64)'}
# 开始请求
html = requests.get(url=url, params=params, headers=headers).text
print(html)
5.2.2 SSL证书认证参数 verify
- 参数值:True(默认)| False
- 适用网站:https类型网站但是没有经过 证书认证机构 认证的网站
- 适用场景:当程序中抛出SSLError异常则考虑使用此参数
- 使用示例:requests.get(url=url,headers=headers,verify=False)
- 当verify参数设置为False时,则不会再对网站进行SSL证书认证
5.2.3 设置超时时间 timeout
我们可以通过timeout属性设置超时时间,一旦超过这个时间还没获得响应内容,就会提示错误。
import requests
requests.get('http://github.com', timeout=0.001)

---------------------以下为输出结果(报错)---------------------
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
requests.exceptions.Timeout: HTTPConnectionPool(host='github.com', port=80): Request timed out. (timeout=0.001)
5.2.4 代理IP参数 proxies
5.2.4.1 免费代理IP
- 语法格式:proxies = { ‘协议’:‘协议://IP:端口号’}
- 示例:
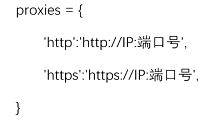
- 当我们抓取的地址为http时,则会选择proxies中http的代理,反之为https
import requests

url = 'http://httpbin.org/get'
headers = {'User-Agent':'Mozilla/5.0'}
# 定义代理,再代理IP网站中查找免费代理IP
proxies = {
    'http':'http://112.85.164.220:9999',
    'https':'https://112.85.164.220:9999'
}
html = requests.get(url=url,proxies=proxies,headers=headers,timeout=5).text
print(html)
5.2.4.1 私密代理和独享代理
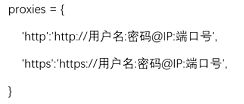
语法格式:proxies = { ‘协议’:‘协议://用户名:密码@IP:端口号’}
示例:
5.3 获取JSON数据
\# 获取json数据
# 案例:百度获取宫崎骏动漫图片
# 滑动页面,URL没变化,F12中的文件越来越多,说明这是动态网页
# 选择XHR中的一个,复制其Request URL,粘贴给url
import requests
url='https://image.baidu.com/search/acjson?tn=resultjson\_com&logid=10167214135414424439&ipn=rj&ct=201326592&is=&fp=result&queryWord=%E5%AE%AB%E5%B4%8E%E9%AA%8F%E5%8A%A8%E6%BC%AB%E5%9B%BE%E7%89%87&cl=2&lm=-1&ie=utf-8&oe=utf-8&adpicid=&st=&z=&ic=&hd=&latest=©right=&word=%E5%AE%AB%E5%B4%8E%E9%AA%8F%E5%8A%A8%E6%BC%AB%E5%9B%BE%E7%89%87&s=&se=&tab=&width=&height=&face=&istype=&qc=&nc=&fr=&expermode=&force=&pn=30&rn=30&gsm=1e&1619134335166='
resp=requests.get(url)
json\_data=resp.json()
print(json\_data)
5.4 获取二进制数据
一般来说,对于非文本请求,可以以字节形式访问响应正文。
\# 获取二进制数据

# 案例:保存百度图片
import requests
url='https://www.baidu.com/img/bd\_logo1.png'
resp=requests.get(url)
# 存储
with open('logo.png','wb') as file:
    # resp.content:把response对象转换为二进制数据
    file.write(resp.content)
6、使用requests发送post请求
- 语法结构
- requests.post(url, data=None, json=None)
- 参数说明
- url:需要爬取的网站的网址
- data:请求数据
- json:json格式的数据
- 案例:登录小说楼
- https://www.xslou.com/login.php
import requests
url='https://www.xslou.com/login.php'
data={'username':'18600605736', 'password':'57365736', 'action':'login'}
resp = requests.post(url,data)
resp.encoding='gb2312'
print('响应状态码:', resp.status\_code)   # 200
print('响应内容', resp.text)        # <html>......</html>
7、使用requests的session发送请求
import requests
url='https://www.xslou.com/login.php'
data={'username':'18600605736', 'password':'57365736', 'action':'login'}

# 使用session发送请求
session = requests.session()
resp=session.post(url,data=data)    # 使用session发送post请求
resp.encoding='gb2312'
# print( resp.text)        # <html>..<title>登录成功</title>....</html>
关于Python技术储备
学好 Python 不论是就业还是做副业赚钱都不错,但要学会 Python 还是要有一个学习规划。最后给大家分享一份全套的 Python 学习资料,希望提供给那些想学习 Python 的小伙伴们一点帮助!
保存图片微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、Python所有方向的学习路线
Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

二、Python基础学习视频
② 路线对应学习视频
还有很多适合0基础入门的学习视频,有了这些视频,轻轻松松上手Python~在这里插入图片描述

③练习题
每节视频课后,都有对应的练习题哦,可以检验学习成果哈哈!

因篇幅有限,仅展示部分资料
三、精品Python学习书籍
当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。

四、Python工具包+项目源码合集
①Python工具包
学习Python常用的开发软件都在这里了!每个都有详细的安装教程,保证你可以安装成功哦!

②Python实战案例
光学理论是没用的,要学会跟着一起敲代码,动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。100+实战案例源码等你来拿!

③Python小游戏源码
如果觉得上面的实战案例有点枯燥,可以试试自己用Python编写小游戏,让你的学习过程中增添一点趣味!

五、面试资料
我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。


六、Python兼职渠道
而且学会Python以后,还可以在各大兼职平台接单赚钱,各种兼职渠道+兼职注意事项+如何和客户沟通,我都整理成文档了。


这份完整版的Python全套学习资料已经上传优快云,朋友们如果需要可以保存图片微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 3746


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


