


Structured Streaming
什么是Structured Streaming
泛指使用SQL操作Spark的流处理。Structured Streaming是一个scalable 和 fault-tolerant 流处理引擎,该引擎是构建Spark SQL之上。可以使得用户以静态批处理的方式去计算流处理。Structured Streaming底层毁掉用SparkSQL 引擎对流数据做增量和持续的更新计算并且输出最终结果。用户可以使用 Dataset/DataFrame API完成流处理中的常见问题:aggregations-聚合统计、event-time window-事件窗口、stream-to-batch/stream-to-stream join连接等功能。Structured Streaming可以通过 checkpointing (检查点)和 Write-Ahead Logs(写前日志)机制实现end-to-end(端到端)、exactly-once(进准一次)语义容错机制。总之Structured Streaming提供了 快速、可扩展、容错、端到端的精准一次的流处理,无需用户过多的干预。
Structured Streaming底层计算引擎默认采取的是micro-batch处理引擎(DStream一致的),除此之外Spark还提供了其它的处理模型可供选择:micro-batch-100ms、Fixed interval micro-batches、One-time micro-batch、Continuous Processing-1ms(实验)
快速入门
- pom
<properties>
    <spark.version>2.4.3</spark.version>
    <scala.version>2.11</scala.version>
</properties>
<dependencies>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-sql_${scala.version}</artifactId>
        <version>${spark.version}</version>
    </dependency>
</dependencies>
- Driver 程序
//1.创建sparksession
val spark = SparkSession
.builder
.appName("StructuredNetworkWordCount")
.master("local[5]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

//2.通过流的方式创建Dataframe - 细化
val lines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()

//3.执行SQL操作 API    - 细化 窗口等
val wordCounts = lines.as[String].flatMap(_.split(" "))
.groupBy("value").count()


//4.构建StreamQuery 将结果写出去 - 细化
val query = wordCounts.writeStream
.outputMode("complete") //表示全量输出,等价于 updateStateByKey
.format("console")
.start()

//5.关闭流
query.awaitTermination()
常规概念
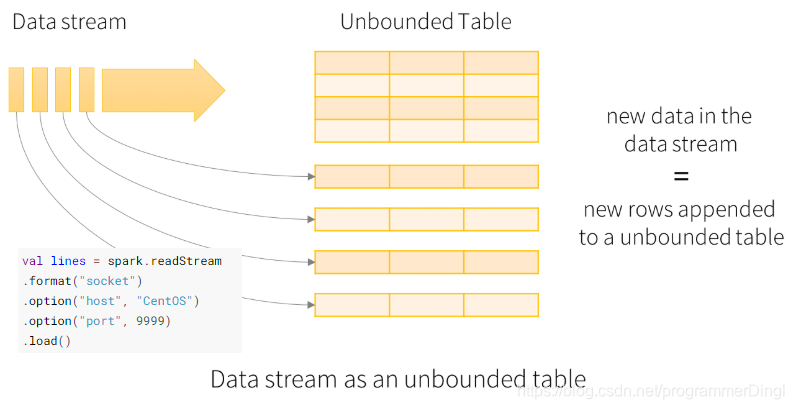
结构化流处理中的关键思想是将实时数据流视为被连续追加的表。将输入数据流视为“Input Table”。流上到达的每个数据项都像是将新行附加到Input Table中。
对Input Table的查询将生成“Result Table”。每个触发间隔(例如,每1秒钟),新行将附加到Input Table中,最终更新Result Table。无论何时更新Result Table,我们都希望将更改后的结果行写入外部接收器(sink)。
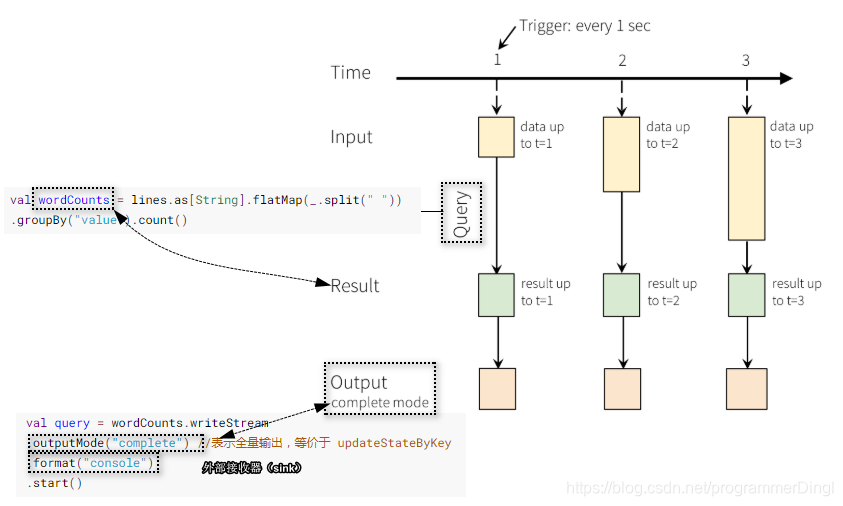
“输出”定义为写到外部存储器的内容。输出支持一下模式的输出:
- Complete Mode(状态) - 整个更新的结果表将被写入外部存储器。由存储连接器决定如何处理整个表的写入。
- Update Mode(状态) - 自上次触发以来,仅结果表中已更新的行将被写入外部存储(Spark 2.1.1),如果没有聚合该策略等价于Append Mode
- Append Mode(无状态) - 自上次触发以来,仅追加到结果表中的新行将被写入外部存储。这仅适用于结果表中现有行预计不会更改的查询。(Append也可以用在含有聚合的查询中,但是仅仅限制在窗口计算-后续讨论)
注意:
- Spark 并不会存储 Input Table 的数据,一旦处理完数据之后,就将接收的数据丢弃。Spark仅仅维护的是计算的中间结果(状态)
2)Structured Stream好处在于用户无需维护 计算状态(相比较于Storm流处理),Spark就可以实现end-to-end(端到端)、exactly-once(进准一次)语义容错机制。
输入和输出
输入
√Kafka source
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-sql-kafka-0-10_${scala.version}</artifactId>
    <version>${spark.version}</version>
</dependency>
//1.创建sparksession
val spark = SparkSession
.builder
.appName("StructuredNetworkWordCount")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

//2.通过流的方式创建Dataframe
val df = spark.readStream
    .format("kafka")
    .option("kafka.bootstrap.servers", "CentOS:9092")
    .option("subscribe", "topic01")
    .load()

//3.执行SQL操作 API
import org.apache.spark.sql.functions._

val wordCounts = df.selectExpr("CAST(key AS STRING)", "CAST(value AS STRING)", "partition", "offset", "CAST(timestamp AS LONG)")
    .flatMap(row => row.getAs[String]("value").split("\\s+"))
    .map((_, 1))
    .toDF("word", "num")
    .groupBy($"word")
    .agg(sum($"num"))

//4.构建StreamQuery 将结果写出去
val query = wordCounts.writeStream
    .outputMode(OutputMode.Update())
    .format("console")
    .start()

//5.关闭流
query.awaitTermination()
FileSource(了解)
//1.创建sparksession
    val spark = SparkSession
      .builder
      .appName("StructuredNetworkWordCount")
      .master("local[6]")
      .getOrCreate()
    import spark.implicits._
    spark.sparkContext.setLogLevel("FATAL")

    //2.通过流的方式创建Dataframe - 细化
    val schema = new StructType()
                    .add("id",IntegerType)
                    .add("name",StringType)
                    .add("age",IntegerType)
                    .add("dept",IntegerType)

    val df = spark.readStream
        .schema(schema)
        .format("json")
        .load("file:///D:/demo/json")

    //3 。SQL操作
    // 略
    //4.构建StreamQuery 将结果写出去
    val query = df.writeStream
      .outputMode(OutputMode.Update())
      .format("console")
      .start()
     //5.关闭流
     query.awaitTermination()
输出
File sink(了解)
val spark = SparkSession
.builder
.appName("filesink")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

val lines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()

val wordCounts=lines.as[String].flatMap(_.split("\\s+"))
.map((_,1))
.toDF("word","num")

val query = wordCounts.writeStream
.outputMode(OutputMode.Append())
.option("path", "file:///D:/write/json")
.option("checkpointLocation", "file:///D:/checkpoints") //需要指定检查点
.format("json")
.start()

query.awaitTermination()
仅仅只支持Append Mode,所以一般用作数据的清洗,不能做为数据分析(聚合)输出。
√Kafka Sink
val spark = SparkSession
.builder
.appName("filesink")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

val lines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()

//import org.apache.spark.sql.functions._
//001 zhangsan iphonex 15000
val userCost=lines.as[String].map(_.split("\\s+"))
.map(ts=>(ts(0),ts(1),ts(3).toDouble))
.toDF("id","name","cost")
.groupBy("id","name")
.sum("cost")
.as[(String,String,Double)]
.map(t=>(t._1,t._2+"\t"+t._3))
.toDF("key","value") //输出字段中必须有value string类型

val query = userCost.writeStream
    .outputMode(OutputMode.Update())
    .format("kafka")
    .option("topic","topic02")
    .option("kafka.bootstrap.servers","CentOS:9092")
    .option("checkpointLocation","file:///D:/checkpoints01")//设置程序的检查点
    .start()
//5.关闭流
query.awaitTermination()
支持 Append, Update, Complete输出模式
√Foreach sink
使用foreach和foreachBatch操作,您可以在流查询的输出上应用任意操作并编写逻辑。它们的用例略有不同-尽管foreach允许在每行上使用自定义写逻辑,而foreachBatch允许在每个微批处理的输出上进行任意操作和自定义逻辑。
ForeachBatch
foreachBatch(…)允许您指定在流查询的每个微批处理的输出数据上执行的函数。从Spark 2.4开始,Scala,Java和Python支持此功能。它具有两个参数:具有微批处理的输出数据的DataFrame或Dataset和微批处理的唯一ID。
val lines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()

//001 zhangsan iphonex 15000
val userCost=lines.as[String].map(_.split("\\s+"))
    .map(ts=>(ts(0),ts(1),ts(3).toDouble))
    .toDF("id","name","cost")
    .groupBy("id","name")
    .sum("cost")
    .as[(String,String,Double)]
    .map(t=>(t._1,t._2+"\t"+t._3))
    .toDF("key","value") //输出字段中必须有value string类型

userCost.printSchema()
val query = userCost.writeStream
.outputMode(OutputMode.Update())
.foreachBatch((ds:Dataset[Row],bacthId)=>{
    ds.show()
})
.start()
//5.关闭流
query.awaitTermination()
使用foreachBatch,可以执行以下操作。
- 使用现有的批处理当中的writer或者是Sink将数据写出到外围系统
- 可以讲数据集合写到多个地方
streamingDF.writeStream.foreachBatch { (batchDF: DataFrame, batchId: Long) =>
  batchDF.persist() //缓存
  batchDF.write.format(...).save(...)  // location 1
  batchDF.write.format(...).save(...)  // location 2
  batchDF.unpersist()//释放缓存
}
- 可以拿到dataset或者Dataframe执行额外的SQL操作。
Foreach
如果不使用foreachBatch,则可以使用foreach表达自定义writer将数据写到外围系统。具体来说,您可以通过自定Writer将数据写到外围系统:open,process和close。从Spark 2.4开始,foreach在Scala,Java和Python中可用。
val spark = SparkSession
.builder
.appName("filesink")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

val lines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()
import org.apache.spark.sql.functions._
//001 zhangsan iphonex 15000
val userCost=lines.as[String].map(_.split("\\s+"))
.map(ts=>(ts(0),ts(1),ts(3).toDouble))
.toDF("id","name","cost")
.groupBy("id","name")
.agg(sum("cost") as "cost")

val query = userCost.writeStream
.outputMode(OutputMode.Update())
.foreach(new ForeachWriter[Row] {
    override def open(partitionId: Long, epochId: Long): Boolean = {//开启事务
        // println(s"open:${partitionId},${epochId}")
        return true //返回true,系统调用 process ,然后调用 close
    }
    override def process(value: Row): Unit = {
        val id=value.getAs[String]("id")
        val name=value.getAs[String]("name")
        val cost=value.getAs[Double]("cost")
        println(s"${id},${name},${cost}") //提交事务
    }
    override def close(errorOrNull: Throwable): Unit = {
        //println("close:"+errorOrNull) //errorOrNull!=nul 回滚事务
    }
})
.start()
//5.关闭流
query.awaitTermination()
窗口计算(前闭后开时间区间)
快速入门
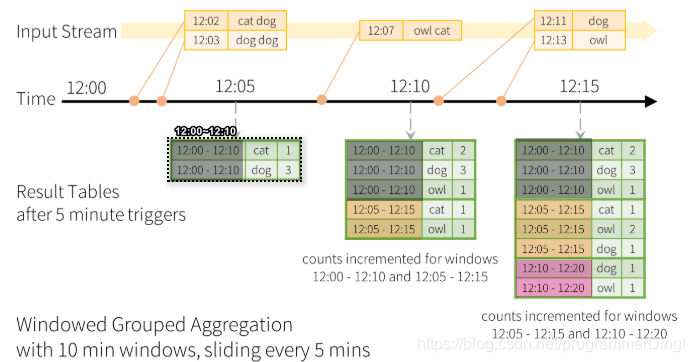
滑动事件时间窗口上的聚合对于结构化流而言非常简单,并且与分组聚合非常相似。时间是嵌入在数据当中
//1.创建sparksession
val spark = SparkSession
.builder
.appName("windowWordcount")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

//2.通过流的方式创建Dataframe - 细化
val lines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()

//3.执行SQL操作 API
// a 时间戳Long
import org.apache.spark.sql.functions._
val wordCounts = lines.as[String].map(_.split("\\s+"))
.map(ts => (ts(0), new Timestamp(ts(1).toLong), 1))
.toDF("word", "timestamp", "num")
.groupBy(
    window($"timestamp", "4 seconds", "2 seconds"),
    $"word")
.agg(sum("num") as "sum")
.map(row=> {
    val start = row.getAs[Row]("window").getAs[Timestamp]("start")
    val end = row.getAs[Row]("window").getAs[Timestamp]("end")
    val word = row.getAs[String]("word")
    val sum = row.getAs[Long]("sum")
    (start,end,word,sum)
}).toDF("start","end","word","sum")

wordCounts.printSchema()

//4.构建StreamQuery 将结果写出去
val query = wordCounts.writeStream
.outputMode(OutputMode.Complete())
.format("console")
.start()

//5.关闭流
query.awaitTermination()
Late Data & Watermarking
在窗口流处理当中,由于网络传输的问题,数据有可能出现乱序,比如说 计算节点以及读到12:11的数据已经完成计算了,也就意味着12:00~12:10的窗口已经触发过了,后续抵达的数据的时间正常来说一定12:11以后的数据,但实际的使用场景中由于网络延迟或者故障导致出现乱序的数据,例如在12:11,接受到了12:04数据,此时Spark需要将12:04添加到12:00 ~ 12:10窗口中,也就意味着Spark一直存储12:00 ~ 12:10窗口的计算状态,因此默认Spark会一直留存窗口的计算状态,来保证乱序可以正常加入到窗口计算中。
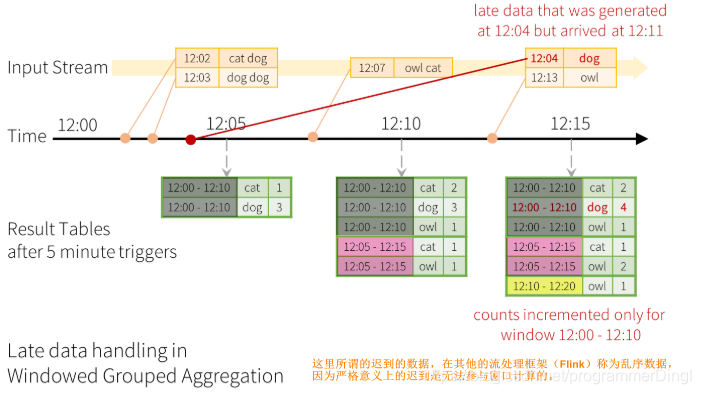
由于流计算不同于批处理,需要24*7小时不间断的工作,因此对于流处理而言长时间存储的计算状态不太切合实际,因此我们需要告诉引擎什么时候可以丢弃计算中间状态。Spark2.1提出Watermarking机制,可以让引擎知道什么时候丢弃窗口的计算状态。watermarker计算公式max event time seen by the engine - late threshold,当窗口的endtime T值 < watermarker,这个时候Spark就可以丢弃该窗口的计算状态。如果后续还有数据落入到了 已经被淹没的窗口中,称为该数据为late data。由于窗口被淹没,因此窗口的状态就没法保证一定存在(Spark会尝试清理那些 已经被淹没窗口状态),迟到越久的数据被处理的几率越低。
一般情况下,窗口触发条件是:Watermarking >= 窗口 end time ,窗口输出的结果一般是FinalResult,但是在Structured Streaming中Watermarking 仅仅控制的是引擎什么时候删除窗口计算状态。如果用户想输出的FinalResult,也就意味着只用当Watermarking >= 窗口 end time的时候才输出结果,用户必须配合Append输出模式.
在使用水位线机制的时候用户不能使用
Complete 输出模式。
update输出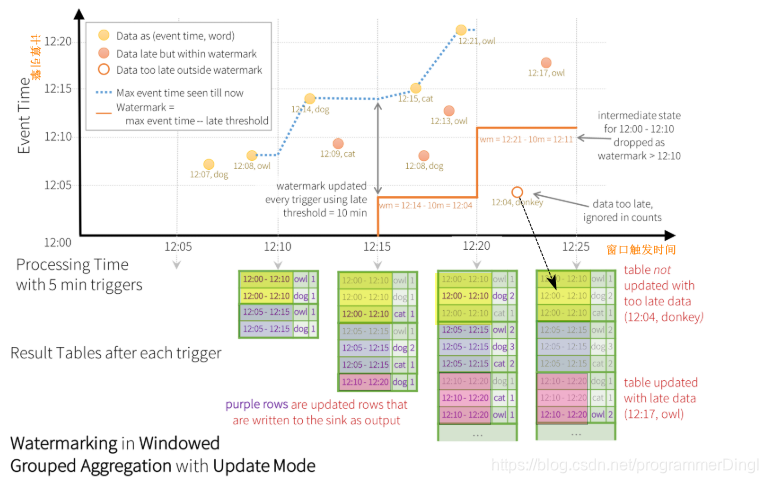
输出条件:
- 有数据落入到窗口
- 水位线没有没过
窗口可能会多次触发,但是一旦水位线没过窗口endtime,有可能数据就会被丢弃
//1.创建sparksession
val spark = SparkSession
.builder
.appName("windowWordcount")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

//2.通过流的方式创建Dataframe - 细化
val lines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()

//3.执行SQL操作 API
// a 时间戳Long
import org.apache.spark.sql.functions._
val wordCounts = lines.as[String].map(_.split("\\s+"))
.map(ts => (ts(0), new Timestamp(ts(1).toLong), 1))
.toDF("word", "timestamp", "num")
.withWatermark("timestamp", "1 second")
.groupBy(
    window($"timestamp", "4 seconds", "2 seconds"),
    $"word")
.agg(sum("num") as "sum")
.map(row=> {
    val start = row.getAs[Row]("window").getAs[Timestamp]("start")
    val end = row.getAs[Row]("window").getAs[Timestamp]("end")
    val word = row.getAs[String]("word")
    val sum = row.getAs[Long]("sum")
    (start,end,word,sum)
}).toDF("start","end","word","sum")

wordCounts.printSchema()

//4.构建StreamQuery 将结果写出去
val query = wordCounts.writeStream
.outputMode(OutputMode.Update())
.format("console")
.start()

//5.关闭流
query.awaitTermination()
Append
[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-fbNynYaA-1570946472890)(assets/1570783542673.png)]
输出前提:必须是水位线 >= 窗口的end time
//1.创建sparksession
val spark = SparkSession
.builder
.appName("windowWordcount")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

//2.通过流的方式创建Dataframe - 细化
val lines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()

//3.执行SQL操作 API
// a 时间戳Long
import org.apache.spark.sql.functions._
val wordCounts = lines.as[String].map(_.split("\\s+"))
.map(ts => (ts(0), new Timestamp(ts(1).toLong), 1))
.toDF("word", "timestamp", "num")
.withWatermark("timestamp", "1 second")
.groupBy(
    window($"timestamp", "4 seconds", "2 seconds"),
    $"word")
.agg(sum("num") as "sum")
.map(row=> {
    val start = row.getAs[Row]("window").getAs[Timestamp]("start")
    val end = row.getAs[Row]("window").getAs[Timestamp]("end")
    val word = row.getAs[String]("word")
    val sum = row.getAs[Long]("sum")
    (start,end,word,sum)
}).toDF("start","end","word","sum")

wordCounts.printSchema()

//4.构建StreamQuery 将结果写出去
val query = wordCounts.writeStream
.outputMode(OutputMode.Append())
.format("console")
.start()

//5.关闭流
query.awaitTermination()
严格意义上说Spark并没有提供对 too late数据(在其他的流处理框架称为迟到,所谓late数据称为乱序)的处理机制,默认策略是丢弃。Storm和Flink都提供了对too late数据的处理方案,这一点Spark有待提高。
Join 操作
Structured Streaming 不仅仅支持和static的dataset/dataframe还支持流中dataset/dataframe。
Stream-static Joins
val spark = SparkSession
.builder
.appName("windowWordcount")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

//001 apple 2 4.5
val orderLines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()


import org.apache.spark.sql.functions._
val orderDF = orderLines.as[String].map(_.split("\\s+"))
.map(ts => (ts(0), ts(1), ts(2).toInt, ts(3).toDouble))
.toDF("id", "name", "count", "price")
val userDF = List(("001","zhangsan"),("002","lisi"),("003","wangwu")).toDF("uid","name")
//等价 userDF.join(orderDF,expr("id=uid"),"right_outer")
val result = userDF.join(orderDF,$"id" ===$"uid","right_outer")

//4.构建StreamQuery 将结果写出去
val query = result.writeStream
.outputMode(OutputMode.Append())
.format("console")
.start()

//5.关闭流
query.awaitTermination()
stream-static支持 inner、left_outer | static-stream支持 inner、right_outer
Stream-stream Joins
在Spark 2.3中,我们添加了对流流连接的支持,即您可以连接两个流Dataset/ DataFrame。流流的join最大挑战是系统需要缓存流的信息,让后和后续的输入的数据进行join,也就意味Spark需要缓存流的状态,这就会给框架的内存带来很大的压力。因此在Structured Stream中引入watermarker的概念,作用为了限制state的存活时间,告知spark什么时候可以释放的流中状态。
内连接可以使用任意一些column作为连接条件,然而在stream计算开始运行的时候 ,流计算的状态会持续的增长,因为必须存储所有传递过来的状态数据,然后和后续的新接收的数据做匹配。为了避免无限制的状态存储。一般需要定义额外的join的条件。例如限制一些old数据如果和新数据时间间隔大于某个阈值就不能匹配。因此可以删除这些陈旧的状态。简单来说需要做以下步骤:
- 两边流计算需要定义watermarker延迟,这样系统可以知道两个流的时间差值。
- 定制一下event time的限制条件,这样引擎可以计算出哪些数据old的不再需要了。可以使用一下两种方式定制
时间范围界定例如:
- JOIN ON leftTime BETWEEN rightTime AND rightTime + INTERVAL 1 HOUR (Range join)
- 基于Event-time Window 例如:JOIN ON leftTimeWindow = rightTimeWindow (window join)
range
val spark = SparkSession
.builder
.appName("windowWordcount")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

//001 apple 2 4.5 1566113400000 2019-08-18 15:30:00
val orderLines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()
//001 zhangsan 1566113400000 2019-08-18 15:30:00
val userLogin = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 8888)
.load()


import org.apache.spark.sql.functions._

val userDF = userLogin.as[String].map(_.split("\\s+"))
.map(ts => (ts(0), ts(1),new Timestamp(ts(2).toLong)))
.toDF("uid","uname","tlogin")
.withWatermark("tlogin","1 seconds")

val orderDF = orderLines.as[String].map(_.split("\\s+"))
.map(ts => (ts(0), ts(1), ts(2).toInt, ts(3).toDouble,new Timestamp(ts(4).toLong)))
.toDF("id", "name", "count", "price","torder")
.withWatermark("torder","1 second")
val joinExpr=
"""
        id=uid AND
        torder >=  tlogin AND
        torder <=  tlogin +  interval 2 seconds
      """
val result=userDF.join(orderDF, expr(joinExpr),"left_outer")
//4.构建StreamQuery 将结果写出去
val query = result.writeStream
.outputMode(OutputMode.Append())
.format("console")
.start()

//5.关闭流
query.awaitTermination()
window
val spark = SparkSession
.builder
.appName("windowWordcount")
.master("local[6]")
.getOrCreate()
import spark.implicits._
spark.sparkContext.setLogLevel("FATAL")

//001 apple 2 4.5 1566113400000 2019-08-18 15:30:00
val orderLines = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 9999)
.load()
//001 zhangsan 1566113400000 2019-08-18 15:30:00
val userLogin = spark.readStream
.format("socket")
.option("host", "CentOS")
.option("port", 8888)
.load()


import org.apache.spark.sql.functions._

val userDF = userLogin.as[String].map(_.split("\\s+"))
.map(ts => (ts(0), ts(1),new Timestamp(ts(2).toLong)))
.toDF("uid","uname","tlogin")
.withWatermark("tlogin","1 seconds")
.withColumn("leftWindow",window($"tlogin","10 seconds","5 seconds"))

val orderDF = orderLines.as[String].map(_.split("\\s+"))
.map(ts => (ts(0), ts(1), ts(2).toInt, ts(3).toDouble,new Timestamp(ts(4).toLong)))
.toDF("id", "name", "count", "price","torder")
.withWatermark("torder","1 second")
.withColumn("rightWindow",window($"torder","10 seconds","5 seconds"))

val joinExpr=
"""
        id=uid AND leftWindow = rightWindow
      """
val result=userDF.join(orderDF, expr(joinExpr))
//4.构建StreamQuery 将结果写出去
val query = result.writeStream
.outputMode(OutputMode.Append())
.format("console")
.start()

//5.关闭流
query.awaitTermination()
将任务打包递交给集群
id name 数量 价格 时间 类目
1 zhangsan 2 3.5  2019-10-10 10:10:00 水果
1 zhangsan 1 1500  2019-10-10 10:10:00 手机
...
统计出年度用户总消费  - kafka
1 zhangsan 水果  50000
1 zhangsan 手机  xxx
import java.util.regex.Pattern

import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.streaming.OutputMode

object UserOrderAnalyzer {
  def main(args: Array[String]): Unit = {
    val spark = SparkSession.builder()
      .appName("UserOrderAnalyzer")
      .master("spark://CentOS:7077")
      .getOrCreate()
    import  spark.implicits._
    spark.sparkContext.setLogLevel("FATAL")
    //1 zhangsan 2 3.5 2019-10-10 10:10:00 水果
    val userOrderLog = spark.readStream
      .format("kafka")
      .option("kafka.bootstrap.servers", "CentOS:9092")
      .option("subscribe", "topic01")
      .load().selectExpr("CAST(value AS STRING)")

    spark.udf.register("order_cost",(count:Int,price:Double)=>{
      count*price
    })

    import org.apache.spark.sql.functions._
    val userOrderDF = userOrderLog.as[String]
      .filter(isLegal(_))
      .map(parse(_))
      .toDF("id", "name", "count", "price", "year", "channel")
      .selectExpr("id","name","order_cost(count,price) as cost","year","channel")
      .groupBy($"id", $"name", $"year")
      .agg(sum("cost") as "cost")
      .as[(Int,String,String,Double)]
      .map(t=>(t._1+":"+t._2,t._3+"\t"+t._4))
      .toDF("key","value")

   val query= userOrderDF.writeStream
             .outputMode(OutputMode.Update())
             .option("kafka.bootstrap.servers", "CentOS:9092")
             .option("topic", "topic02")
             .option("checkpointLocation","hdfs:///checkpoints-UserOrderAnalyzer")
             .format("kafka")
     .start()

    query.awaitTermination()
  }
  def isLegal(log:String):Boolean={
    val regex="(\\d+)\\s(.*)\\s(\\d+)\\s(\\d+\\.\\d+)\\s(\\d{4}).*\\d{2}\\s(.*)"
    val pattern = Pattern.compile(regex)
    val matcher = pattern.matcher(log)
    matcher.matches()
  }
  def parse(log:String):(Int,String,Int,Double,String,String) ={
    val regex="(\\d+)\\s(.*)\\s(\\d+)\\s(\\d+\\.\\d+)\\s(\\d{4}).*\\d{2}\\s(.*)"
    val pattern = Pattern.compile(regex)
    val matcher = pattern.matcher(log)
    matcher.matches()
    (matcher.group(1).toInt,matcher.group(2),matcher.group(3).toInt,matcher.group(4).toDouble,matcher.group(5),matcher.group(6))
  }
}
- 在项目中修改依赖pom
<properties>
    <spark.version>2.4.3</spark.version>
    <scala.version>2.11</scala.version>
</properties>
<dependencies>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-sql_${scala.version}</artifactId>
        <version>${spark.version}</version>
        <scope>provided</scope>
    </dependency>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-sql-kafka-0-10_${scala.version}</artifactId>
        <version>${spark.version}</version>
    </dependency>
</dependencies>
<build>
    <plugins>
        <!--在执行package时候,将scala源码编译进jar-->
        <plugin>
            <groupId>net.alchim31.maven</groupId>
            <artifactId>scala-maven-plugin</artifactId>
            <version>4.0.1</version>
            <executions>
                <execution>
                    <id>scala-compile-first</id>
                    <phase>process-resources</phase>
                    <goals>
                        <goal>add-source</goal>
                        <goal>compile</goal>
                    </goals>
                </execution>
            </executions>
        </plugin>
        <!--将依赖jar打入到jar中-->
        <plugin>
            <groupId>org.apache.maven.plugins</groupId>
            <artifactId>maven-shade-plugin</artifactId>
            <version>2.4.3</version>
            <executions>
                <execution>
                    <phase>package</phase>
                    <goals>
                        <goal>shade</goal>
                    </goals>
                    <configuration>
                        <filters>
                            <filter>
                                <artifact>*:*</artifact>
                                <excludes>
                                    <exclude>META-INF/*.SF</exclude>
                                    <exclude>META-INF/*.DSA</exclude>
                                    <exclude>META-INF/*.RSA</exclude>
                                </excludes>
                            </filter>
                        </filters>
                    </configuration>
                </execution>
            </executions>
        </plugin>
    </plugins>
</build>
- 任务提交(fatjar)
[root@CentOS spark-2.4.3]# ./bin/spark-submit --master spark://CentOS:7077
											  --deploy-mode cluster
											  --class com.baizhi.demo.UserOrderAnalyzer
											  --total-executor-cores 6
											  /root/finalspark-1.0-SNAPSHOT.jar
- 远程jar下载(网络-不推荐)
[root@CentOS spark-2.4.3]# ./bin/spark-submit --master spark://CentOS:7077
											  --deploy-mode cluster
											  --class com.baizhi.demo.UserOrderAnalyzer
											  --total-executor-cores 6
											  --packages org.apache.spark:spark-sql-kafka-0-10_2.11:2.4.3
											  /root/original-finalspark-1.0-SNAPSHOT.jar
                  </filters>
                </configuration>
            </execution>
        </executions>
    </plugin>
</plugins>
- 任务提交(fatjar)
[root@CentOS spark-2.4.3]# ./bin/spark-submit --master spark://CentOS:7077
											  --deploy-mode cluster
											  --class com.baizhi.demo.UserOrderAnalyzer
											  --total-executor-cores 6
											  /root/finalspark-1.0-SNAPSHOT.jar
- 远程jar下载(网络-不推荐)
[root@CentOS spark-2.4.3]# ./bin/spark-submit --master spark://CentOS:7077
											  --deploy-mode cluster
											  --class com.baizhi.demo.UserOrderAnalyzer
											  --total-executor-cores 6
											  --packages org.apache.spark:spark-sql-kafka-0-10_2.11:2.4.3
											  /root/original-finalspark-1.0-SNAPSHOT.jar
一般企业内网服务器不会连接外网


 1375


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


