股票数据定向爬取

嵩天《Python网络爬虫与信息提取》实例4:股票数据定向爬虫 爬取目标:通过东方财富网获取股票列表,借此构造链接从富途牛牛网获取个股信息并保存到本地列表中;相关库名:requests/re/json/csv 阅读详情
import requests#获取数据
from bs4 import BeautifulSoup
import traceback#我本来还下载了一下,后来才发现这个是python基本库
import re

def getHTMLText(url):
    try:
        r = requests.get(url)
        r.raise_for_status()#这是对获取网页内容过程中做的一个判断,如果有误则报错,如果无误,顺利运行,一般不用管它
        r.encoding = r.apparent_encoding
        return r.text
    except:
        print("getHTMLText函数出错")#这部分代码常常被复用,基本上获取页面信息都用这部分代码

def getStockList(lst, stockURL):#获取股票信息列表,lst是列表保存的列表类型,存储了所有股票的信息,stockURL是获取股票列表的URL网站
    
    html = getHTMLText(stockURL)
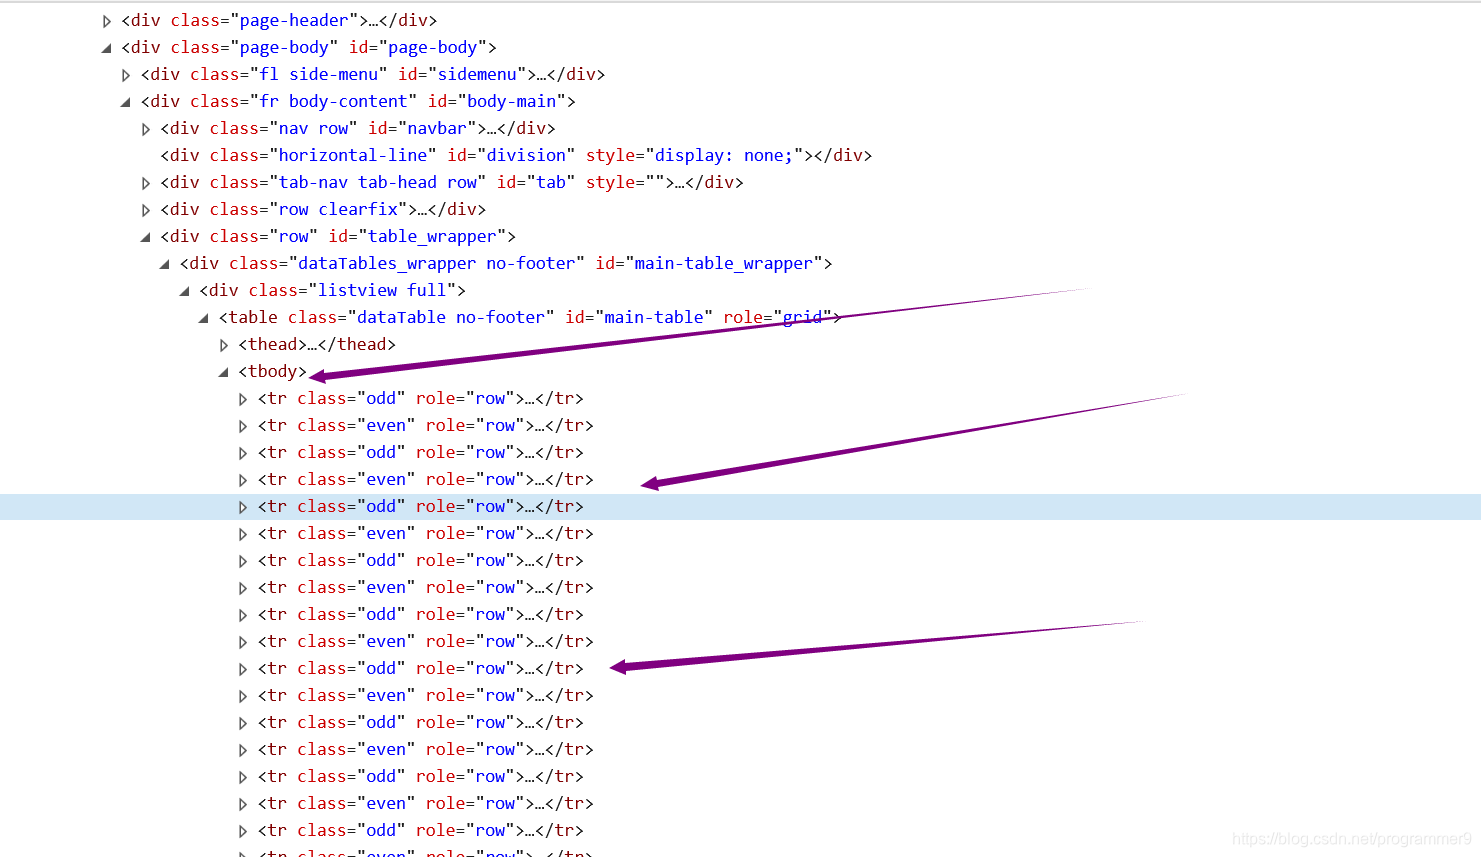
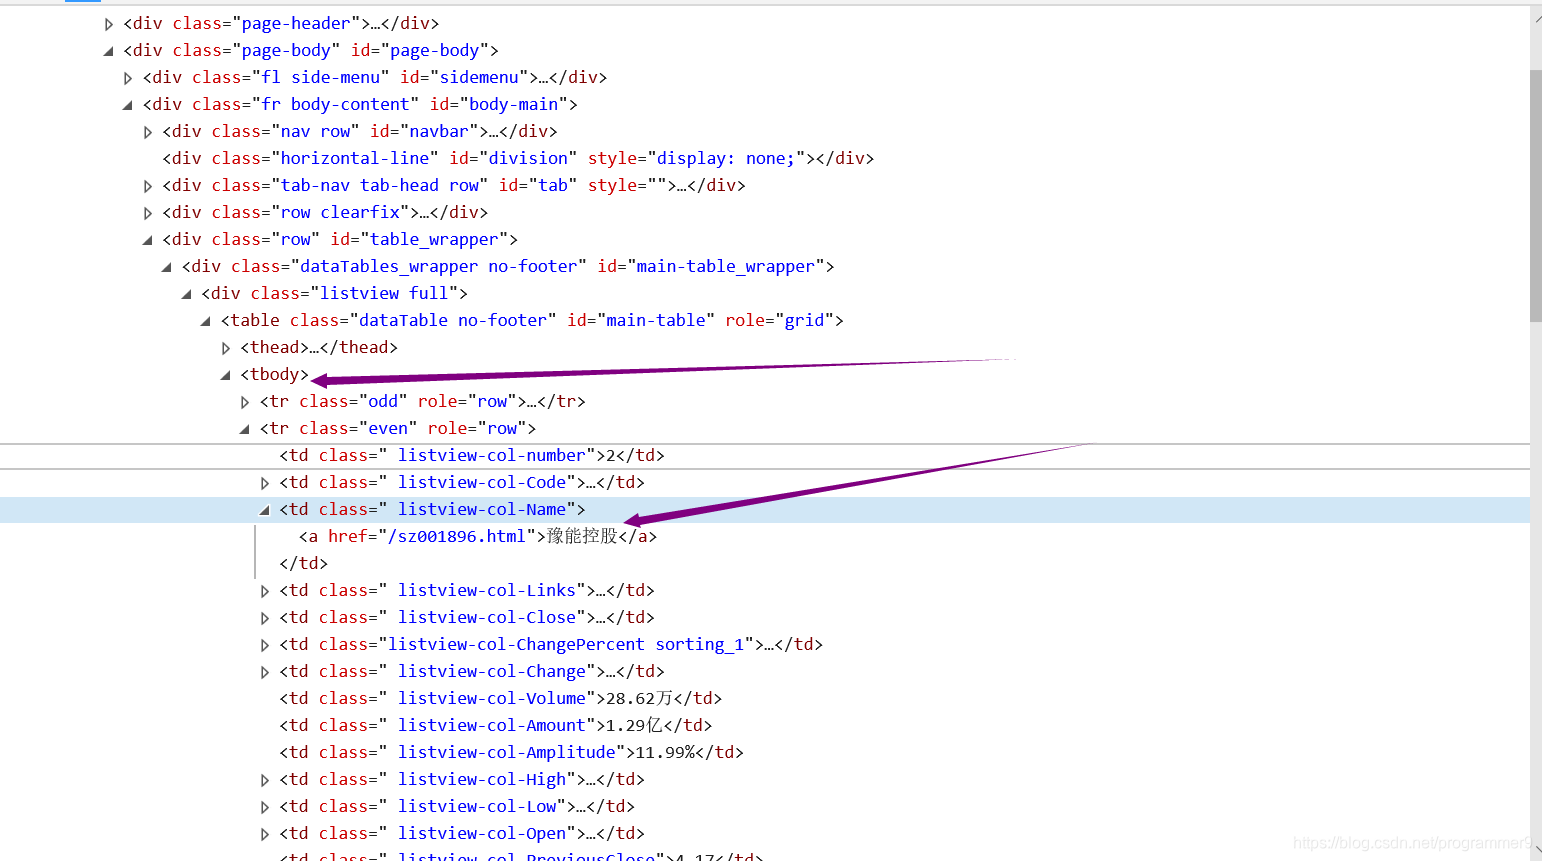
    soup = BeautifulSoup(html, "html.parser")#<a href="/sh600448.html">华纺股份</a>这就是从网页源码中提取出的包含股票名称的部分
    a = soup.find_all("a")#使用find_all方法找到a标签
    for i in a:#遍历
        try:
            herf = i.attrs["href"]
            lst.append(re.findall(r"[s][hz]\d{6}",herf)[0])#上海交易所的代码是以sh开头,深圳交易所的代码则是以sz开头,因此可以用正则表达式
            #来从herf中获取股票的信息股票后面的数字是6位
        except:
            continue#可能会有异常,让程序继续运行就可以了
   

def getStockInfo(lst, stockURL, fpath):#获得每只股票的信息,并将之存到一个数据结构
    #lst是保存所有股票的信息列表,stockURL是获得股票信息的url网站,储存的本地文件路径
    
    for stock in lst:#stock是列表lst里面的内容,
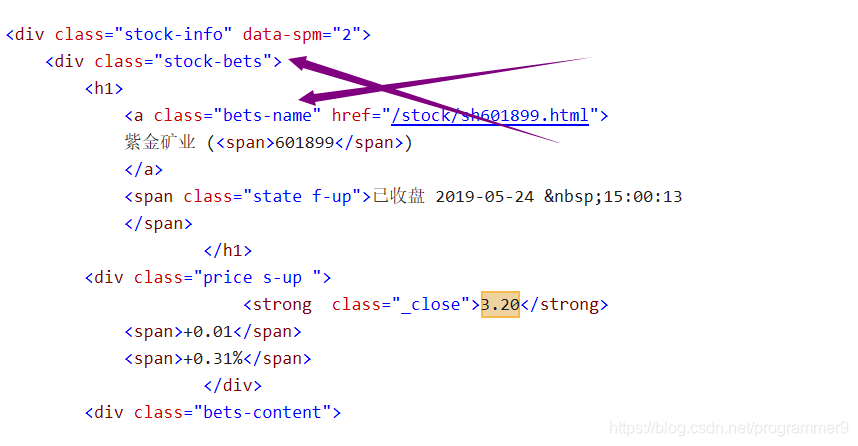
        url = stockURL + stock +".html"#https://gupiao.baidu.com/stock/sh601899.html这是紫金矿业的url,我们可以看到,sh代表上海,
        #后面六位数则是编号
        html = getHTMLText(url)
        try:
            if html == "":
                continue#continue的用处很大嘛
            infoDict = {}#我们定义了一个字典,里面存放所有个股信息
            soup = BeautifulSoup(html, "html.parser")
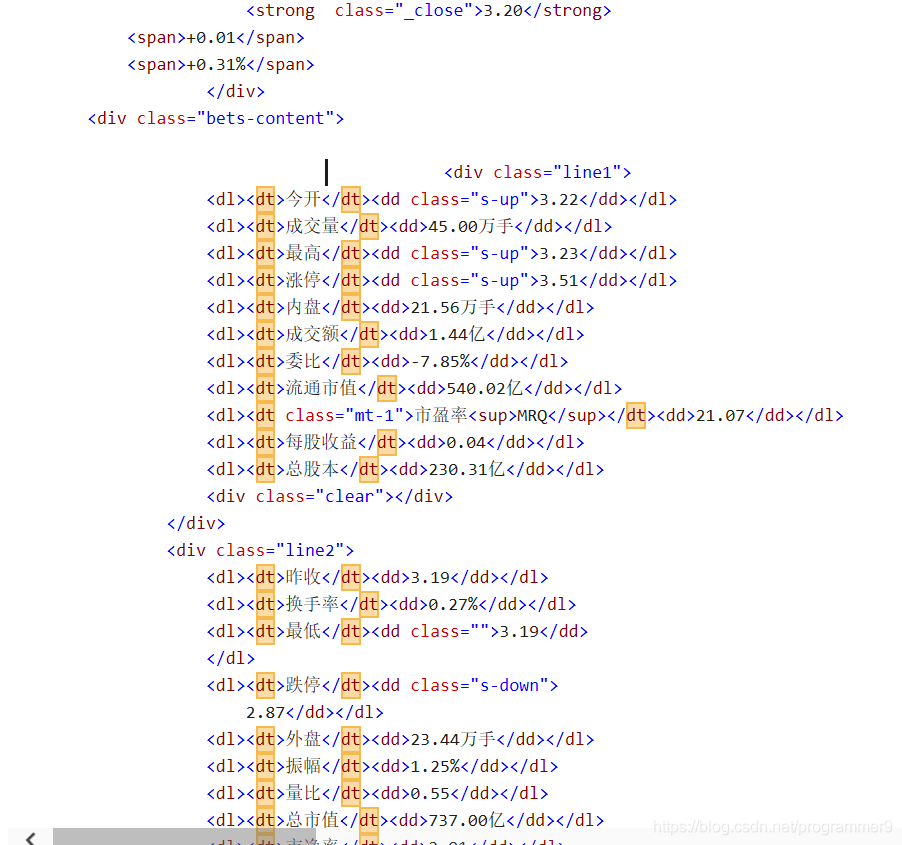
            stockInfo = soup.find("div",attrs={"class":"stock-bets"})
            name = stockInfo.find_all(attrs={"class":"bets-name"})[0]
            infoDict.update({"股票名称":name.text.split()[0]})#真是奇怪,我总是把split写成spilt,怪不得会出现错误显示没有这个定义
#我们在此处获取的是第一部分,其余部分暂时舍弃
            keyList = stockInfo.find_all("dt")#股票信息的键的域
            valueList = stockInfo.find_all("dd")#股票信息的值的域
            for i in range(len(keyList)):
                key = keyList[i].text
                val = valueList[i].text
                infoDict[key] = val#赋值并将键值对存放到字典中,使用 key = value的办法
            with open(fpath, "a", encoding = "utf-8") as f:
                f.write( str(infoDict) + "\n")
        except:
            traceback.print_exc()
            continue
                        

def main():
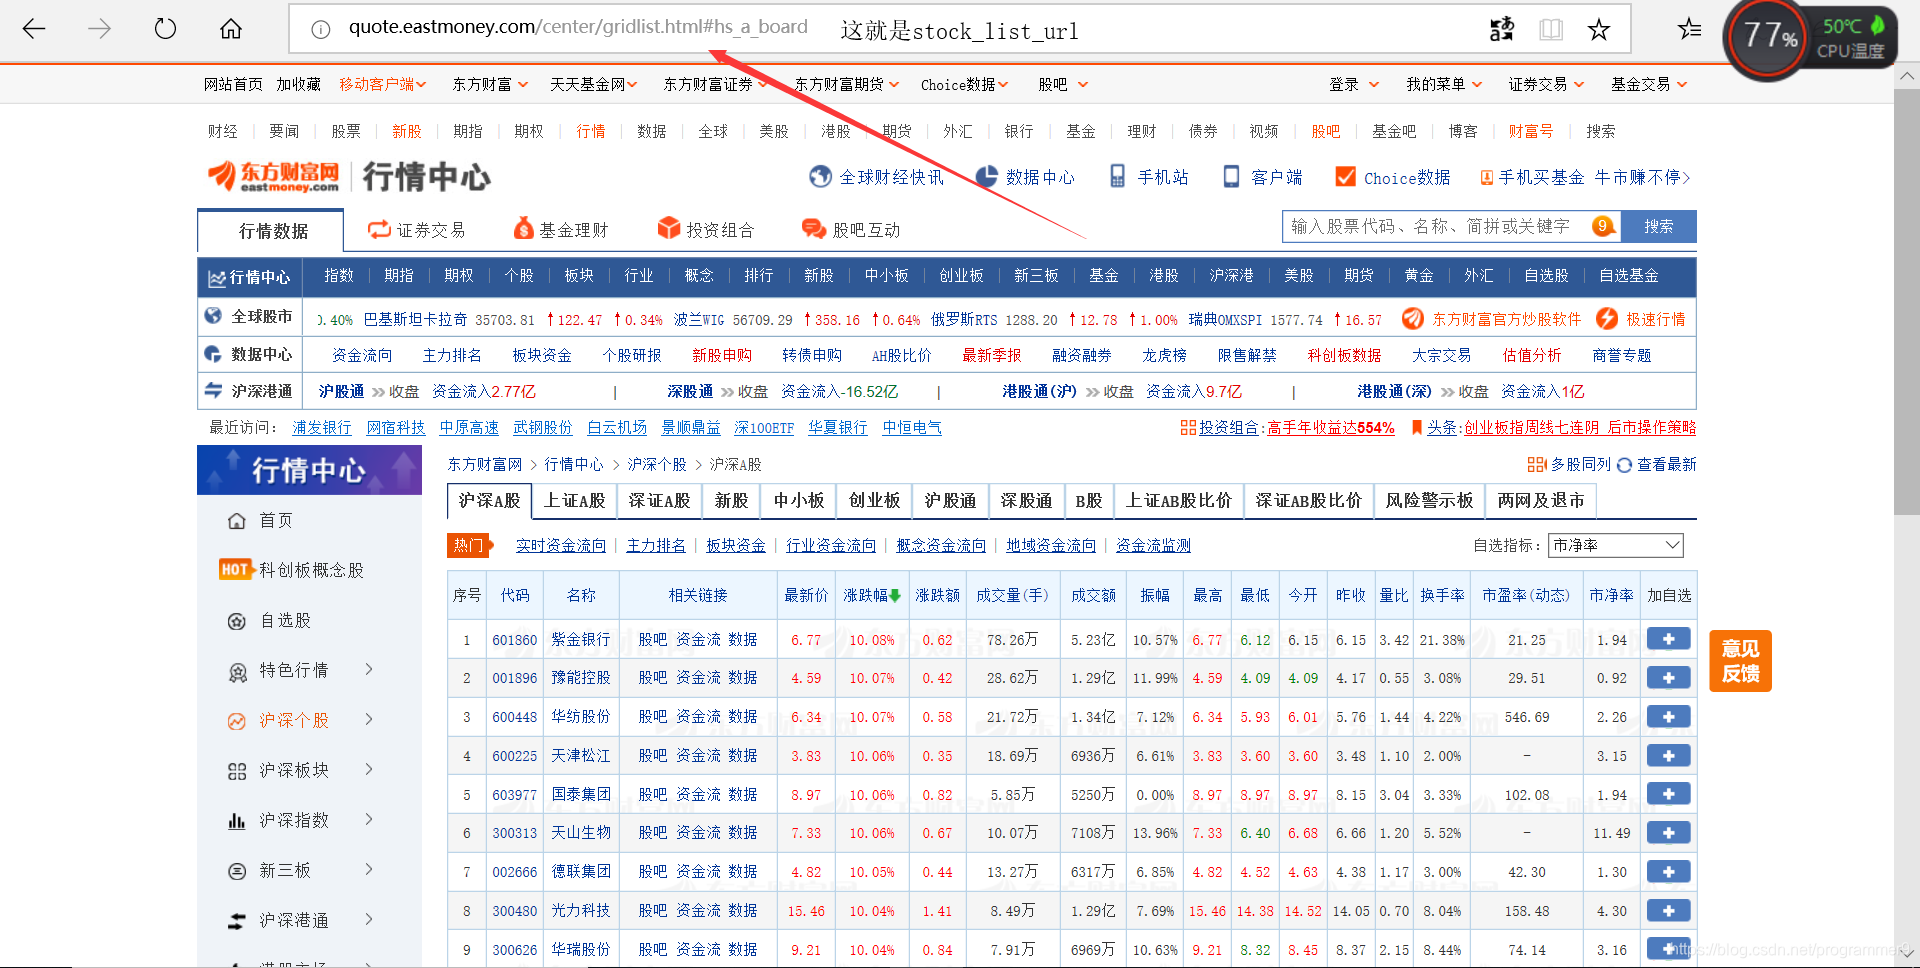
    stock_list_url = "http://quote.eastmoney.com/stocklist.html"#东方财富网,获取股票列表
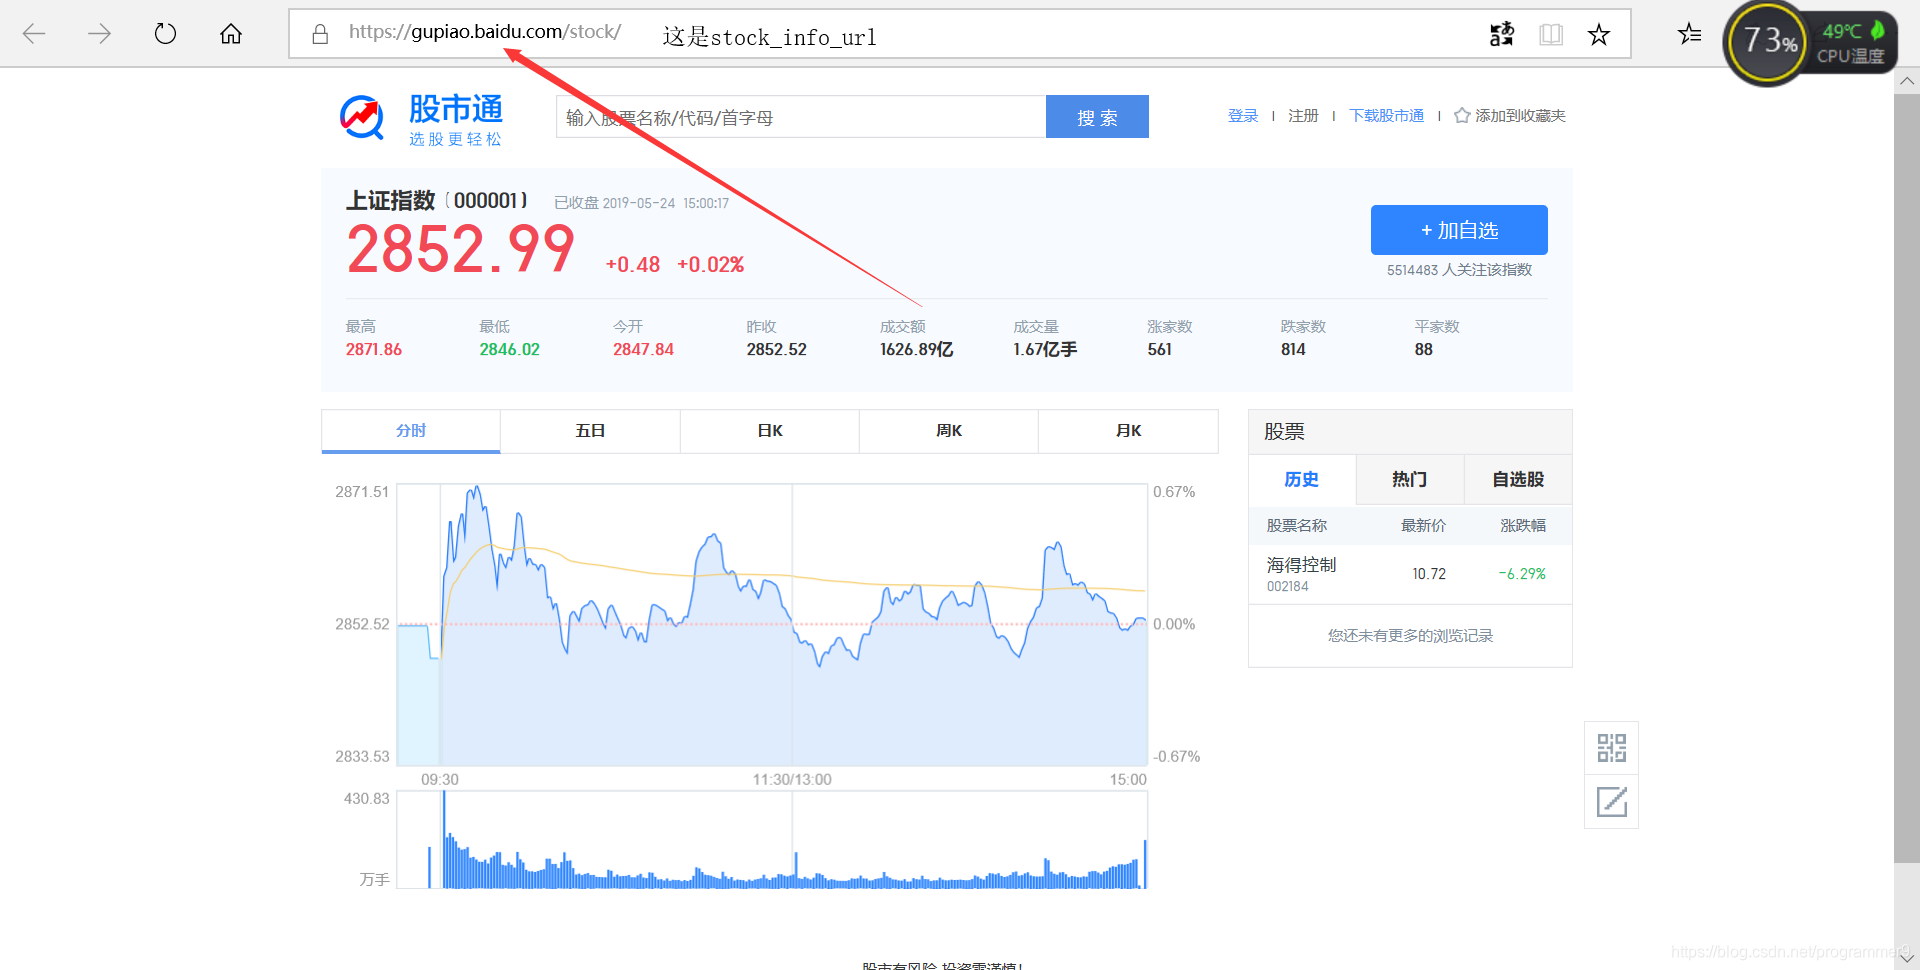
    stock_info_url = "http://gupiao.baidu.com/stock/"#百度股票,获得每只股票的具体信息
    output_file = "F://股票数据定向爬取//股票数据.txt"#经过测试,如果没有这个txt文件,那么会新建一个写进去,如果有,则在该文件上写
    slist = []#这个列表里面存储的是股票的信息
    getStockList(slist, stock_list_url)
    getStockInfo(slist, stock_info_url, output_file)

main()
#我居然只爬了一个股票的信息,为什么不是所有的呢?
print("函数整体可以运行")
 

python网络爬虫:股票数据定向爬取 百度股票(https://gupiao.baidu.com/stock/)属于静态网页数据,适合定向数据爬取;新浪股票(http://finance.sina.com.cn/stock/)数据存取在js文件中,属于动态数据,不适合定向爬取,所以选择百度股票(https://gupiao.baidu.com/stock/)作为爬取对象。PS:Robots协议没有禁止网络爬虫 步骤说明 步骤1: ... 阅读详情

相关推荐

Python爬虫入门实例八之股票数据定向爬取并保存(优化版)

本文采取requests+re+bs4的技术路线,定向爬取静态网站的股票信息并保存在文件中。内含完整代码,并对代码做了详细注释,能够很好的帮助初学者填坑并掌握,希望能够帮助到你~

Mr.Q_LuLu的博客 1万+

Python爬虫实战:股票数据定向爬虫

股票信息静态存在于html页面中,非js代码生成,没有Robbts协议限制,打开网页,查看源代码,搜索网页的股票价格数据是否存在于源代码中。如打开新浪股票网址:链接描述(http://finance.sina.com.cn/realstock/company/sz000877/nc.shtml),如下图所示:上图中左边为网页的界面,显示了天山股份的股票价格是13.06。右边为该网页的源代码,在源代码中查询13.06发现没有找到。所以判断该网页的数据使用js生成的,不适合本项目。因此换一个网页。

m0_59162248的博客 6147

大模型选型实战指南|教育行业:108个模型「闭卷考试」实测,这3类应用场景直接抄作业!

教育行业大模型选型必读 1.闭卷考试!独家评测集:用最新K12真题(小学-高中全学科)构建“闭卷考场”,108个模型同台竞技,数据污染率<5%(传统评测集污染率超60%) 2.价格透明对比:40元/M tokens的阿里系模型VS 2元/M tokens的字节系、腾讯系模型,谁更值? 3.四大选型禁区:>60元但得分<75的模型被列入不推荐名单(附避坑清单) 4.核心结论直出:教学核心环节必须用专用模型,90%场景用通用模型可降本50%+

easyllm的博客 1524

Python爬虫实战:爬取股票信息

本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取本次选题是先写好代码再写的文章,绝对可以用到页面元素解析,并且还需要对网站的数据加载有一定的分析,才能得到最终的数据,并且小编找的这两个数据源无 ip 访问限制,质量有保证,绝对是小白练手的绝佳之选。郑重声明: 本文仅用于学习等目的。① Python所有方向的学习路线图,清楚各个方向要学什么东西。

2301_76161259的博客 7846

从UC3842的FB脚到COMP脚:一次讲透反激电源两种光耦反馈接法的选择与实战

本文深入探讨了UC3842 PWM控制器在反激式开关电源设计中的两种光耦反馈接法:FB脚与COMP脚方案。通过分析信号极性差异、稳定性特点及动态响应性能,提供场景化选型指南和可靠性设计要点,帮助工程师优化反馈环路设计,提升系统稳定性与效率。特别针对TL431和PC817等关键元件在温度漂移、老化衰减等实际问题给出解决方案。

weixin_28717683的博客 711

FPGA SPI驱动ADC避坑指南:以ADC128S022为例,详解时序设计与代码调试

本文以ADC128S022为例,详细解析FPGA通过SPI驱动ADC的时序设计与代码调试中的常见问题。从时钟分频计算、SPI模式选择到状态机实现,提供避坑指南和实战技巧,帮助工程师解决数据采集系统中的时序匹配难题。特别针对FPGA与ADC通信中的微妙差异,给出精确的Verilog代码示例和ModelSim仿真验证方法。

weixin_42522374的博客 460

Python爬虫 | 基于request-bs4-re的股票数据定向爬虫

Python版本:Python3.5 ; 技术路线:requests-bs4-re 。 1 功能描述 股票数据是进行量化数据的基础型数据,爬虫也能为量化交易提供获得基础数据的方法。 所有功能需求如下: 目标:获得上交所和深交所所有股票的名称和交易信息 输出:保存到文件中 2 候选数据网站选择 数据源网站:为了获取股票数据,我们要找一些能够寻获得股票数据的网站,这里边选取两个候选网站:...

weixin_34199405的博客 684

英飞凌TC3xx的GTM模块到底有多强?从PWM生成到电机驱动,一篇讲透车载定时器核心

本文深入解析英飞凌TC3xx系列中的GTM模块在汽车电子领域的强大功能,从PWM生成到电机驱动的全链路设计。通过模块化架构和硬件级解决方案,GTM显著提升系统精度和响应速度,适用于电机控制、电源管理等复杂场景。文章结合实战经验,详细拆解GTM的技术实现和性能优势。

weixin_27741699的博客 204

定向爬取股票数据——记录一次爬虫实战

今天是八月2号,自学python爬虫已经一整个月了。不学不理解,真正学了才发现,python不愧是一门博大精深的高级编程语言,我学到现在也才只见识到它冰山一脚,python应用的范围即便相比于c、c++、java等老牌语言也不逞多让;爬虫只是它庞大功能体系的一种,而我一个月来的学习单论爬虫这一块来说也只能说堪堪入门,距离熟练使用再到掌握还有很遥远的路程。 虽然爬虫的路途依旧遥远,但一个月的努力也不可能白费,想起来还没有尝试过股票数据的抓取,为了检测进度,也算打磨打磨暑期时间,just do it! 既然要爬

weixin_43997544的博客 1340

C语言使用开源库libusb进行USB设备操作

https://libusb.info/libusb is a C library that provides generic access to USB devices. It is intended to be used by developers to facilitate the production of applications that communicate with USB hardware. It is portable: Using a single cross-platform AP

m0_60352504的博客 1556

自适应控制 (Adaptive Control) 算法详解及案例分析

自适应控制是一种能够在线调整控制器参数以适应系统动态变化的控制方法。其核心思想是通过实时估计系统参数或调整控制器参数,使系统在不确定性或动态变化的环境中仍能保持稳定性和性能。

闲人编程的博客 4085

python爬虫之股票数据定向爬取

python爬虫之股票数据定向爬取 功能描述 目标:获取上交所和深交所所有股票的名称和交易的信息 输出:保存到文件中 技术路线:requests-bs4-re 前期分析 选取原则:股票的信息静态存在HTML页面中,非js代码生成,没有robots协议限制 选取方法:查看网页原码不纠结于某个网站,多找信息源尝试 没有成功,价格没有搜索到 在源码中搜索价格,不存在 搜索价格没有 没有找到相关的价格信息 没有找到相关价格信息 没有找到相关的价格信息 多此尝试之后,发现基本上都没有找到,于是找教

Blackoutdragon的博客 2292

华为OD技术面八股_C++_05

汇总华为OD技术面C++方向技术面八股文,提供详细解答。

qq_45776114的博客 413

php 爬取股票数据库,【实例】--股票数据定向爬取

从股票列表网页获取股票代码根据股票代码去股票详情页面获取股票详细信息1、 股票列表页面凤凰网财经—股票信息http://app.finance.ifeng.com/list/stock.php?t=ha&f=chg_pct&o=desc&p=12、 股票详细信息老虎社区—股票详情股票数据定向爬取思路1、 查看网站robots协议,查看网站是否可以爬取2、 查看网页源代码,查...

weixin_31349647的博客 750

基于Simulink的电机轴电压与轴电流抑制仿真

本文带你完成了电机轴电压与轴电流抑制的Simulink仿真,实现了:✅ 揭示了共模电压 → 寄生电容 → 轴电压 → 轴承电蚀的完整链路✅ 搭建了含寄生参数的高频电机等效模型共模电压最小化PWM(源头抑制)dv/dt滤波器(路径阻断)轴接地(终端泄放) ✅ 通过仿真验证了轴电压从68 V降至<3 V的显著效果 ✅ 为高可靠性电机系统提供低成本、高效益的轴承保护方案。

amy_mhd的博客 163

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

python-股票数据定向爬取

re.findall soup.find_all ---------Q---- for i in ***: ***可以是什么类型,主要是关心什么类型的不可以 ------------trackback用法------------ >>> >>> import traceback>>> try:... 1/0... ...

weixin_30952103的博客 252

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

python爬取股票大单历史记录_定向爬取股票数据——记录一次爬虫实战

今天是八月2号,自学python爬虫已经一整个月了。不学不理解,真正学了才发现,python不愧是一门博大精深的高级编程语言,我学到现在也才只见识到它冰山一脚,python应用的范围即便相比于c、c++、java等老牌语言也不逞多让;爬虫只是它庞大功能体系的一种,而我一个月来的学习单论爬虫这一块来说也只能说堪堪入门,距离熟练使用再到掌握还有很遥远的路程。虽然爬虫的路途依旧遥远,但一个月的努力也不可...

weixin_32467421的博客 1436

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Python网络爬虫之制作股票数据定向爬虫 以及爬取的优化 可以显示进度条!

候选网站: 新浪股票:http://finance.sina.com.cn/stock/ 百度股票:https://gupiao.baidu.com/stock/ 选取原则: 无robots协议 非js网页 数据在HTMLK页面中的 F12,查看源代码,即可查看。 新浪股票,使用JS制作。脚本生成的数据。 百度股票可以在HTML中查询到! http://quote.eastmoney.com/...

HWP 2405

python界面显示爬取进度_Python网络爬虫之制作股票数据定向爬虫 以及爬取的优化 可以显示进度条!...

候选网站:新浪股票:http://finance.sina.com.cn/stock/百度股票:https://gupiao.baidu.com/stock/选取原则:无robots协议非js网页数据在HTMLK页面中的F12,查看源代码,即可查看。新浪股票,使用JS制作。脚本生成的数据。百度股票可以在HTML中查询到!http://quote.eastmoney.com/stocklist.ht...

weixin_39620370的博客 374

【Python爬虫学习】八、股票数据定向爬虫(2020年1月31日成功爬取中财网,百度股市通web版404了)

功能描述: 目标:获取股票的名称和交易信息 输出:保存到文件中 程序结构设计: 步骤1:从中财网http://quote.cfi.cn/stockList.aspx获取股票列表 步骤2:根据股票列表获取股票的url,通过每个url获取股票信息 步骤3:将结果保存到文件中 代码实现: #股票数据定向爬虫 import re import requests from ...

Guanhai1617的博客 2701

股票数据定向爬取(可运行) Python网络爬虫与信息提取(北京理工大学—嵩天)

注意:由于东方财富网与百度股票网站发生变动,所以选择了与原先百度股票类似的股城网作为信息爬取的目标网站。(感谢文章:(4条消息) Python爬虫入门实例八之股票数据定向爬取并保存(优化版)_Mr.Q_LuLu的博客-优快云博客) 先贴代码: import requests from bs4 import BeautifulSoup import traceback import re def getHTMLText(url): try: kv = {'user-agen

weixin_50437588的博客 1951

python数据分析之爬虫五:实例

实例一:淘宝商品比价定向爬虫 打开淘宝,输入衬衫,链接为: https://s.taobao.com/searchq=%E8%A1%AC%E8%A1%AB&amp;imgfile=&amp;js=1&amp;stats_click=search_radio_all%3A1&amp;initiative_id=staobaoz_20180812&amp;ie=utf8&amp;bcoffset=...

qq_40123329的博客 9011

【爬虫实战】8基础Python网络爬虫——股票数据定向爬虫(MOOC学习笔记)

股票数据定向爬虫1、股票数据定向爬虫”实例介绍(1)功能描述:(2)理解网站的选取过程(3) 程序的结构设计2、股票数据定向爬虫”实例编写 1、股票数据定向爬虫”实例介绍 (1)功能描述: 目标:获取上交所和深交所所有股票的名称和交易信息 输出:保存到文件中 技术路线:requests‐bs4‐re 候选数据网站的选择: 新浪股票:http://finance.sina.com.cn/stock/ 百度股票:https://gupiao.baidu.com/stock/ (2)理解网站的选取过程 选

YoungSeng's Blog 1296

股票数据的定向爬虫——嵩天老师网课学习

#------------------------------------------------------------------------------- #任务:定向爬取股票数据 #技术路线:requests-BeautifulSoup-re #股票列表获取:东方财富网 #股票信息获取:雪球网 #因为雪球网与百度股票的html是不一样的,因此只能通过搜索一个个属性中的数值来爬取 #在这里仅...

qq_38290594的博客 1578
上一篇: 正则表达式库re
下一篇: 基于层次分析模型的工作选择问题的研究
人生无根蒂,飘如陌上尘
博客等级 码龄9年 224粉丝 228原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值