IEEE GRSM 2025:Vision-Language Modeling Meets Remote Sensing Models, datasets, and perspectives

论文阅读——RSGPT 阅读详情

视觉语言建模(VLM)致力于弥合图像与自然语言之间的信息鸿沟。通过"先在海量图文对上预训练,再针对特定任务微调"的新范式,遥感(RS)领域的VLM取得了显著进展。该范式使模型能够吸收海量通用知识,在多种遥感数据分析任务中展现出色性能,并具备以对话方式与用户交互的能力。本文旨在为遥感学界提供关于两阶段范式VLM发展的及时全面综述:首先建立遥感VLM的技术体系——对比学习、视觉指令微调与文本条件图像生成三大方向,逐类详解常用网络架构与预训练目标;其次系统评述现有工作,包括基于对比的VLM中的基础模型与任务适配方法、基于指令的VLM中的架构升级与训练策略、生成式基础模型及其典型应用;进而汇总VLM预训练、微调与评估数据集,分析其构建方法(如图像来源与标注生成)和规模、任务适应性等关键特性;最后提出未来研究方向:跨模态表征对齐、模糊需求理解、解释驱动的模型可靠性、持续可扩展能力,以及涵盖更丰富模态与更大挑战的大规模数据集。
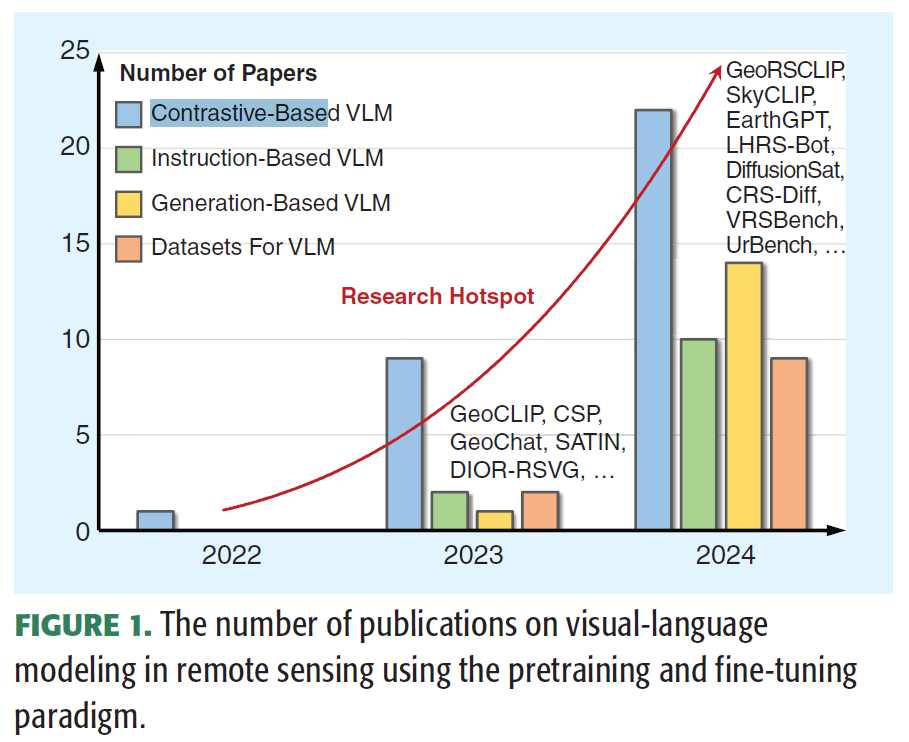
在这里插入图片描述

现有VLM诞生的新范式:先预训练,后微调,a new paradigm of pretraining followed by fine-tuning

To date, significant progress has been achieved, as illustrated in Figure 1. This includes works based on the following:

1)对比学习 such as GeoRSCLIP [15], SkyCLIP [16], and RemoteCLIP [20], which have driven substantial advancements in various cross-modal tasks and、zero-shot image understanding tasks;(称之为 Contrastive-Based VLM)

2)从文本prompts生成图像,学习图像和文本的implicit的联合分布:like RS-SD [15], DiffusionSat [21], and CRSDiff [22] (称之为Generation-Based VLM)

3) 视觉指令微调,such as GeoChat [18], LHRS-Bot [24], and SkySenseGPT [25](称之为Instruction-Based VLM)

本文的贡献 focus on VLM based on the pretraining and fine-tuning paradigm in the field of remote sensing.

1. 遥感视觉语言模型(VLM)的技术体系分类,逐类详解常用网络架构与预训练目标;
2. 对比式、指令式与生成式三类遥感VLM的最新进展,重点阐释其关键设计与下游应用;
3. VLM预训练、微调及评估数据集的建设进展;
4. 当前技术挑战与潜在研究方向

遥感VLM的分类:对比学习,视觉指令微调,文本引导的图像生成
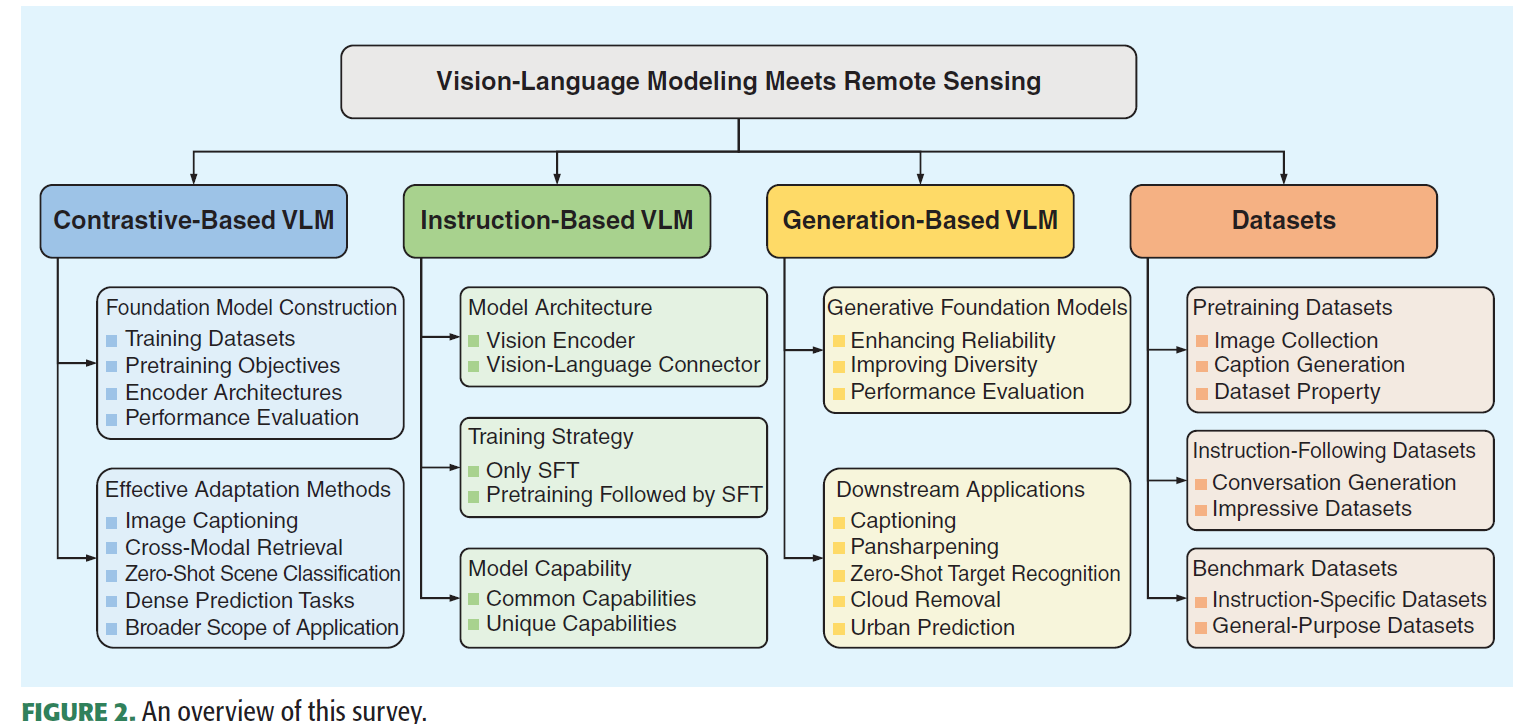
在这里插入图片描述

contrastive learning

对比学习的出发点是将文本与图像建模在一个统一共享的特征空间,让同一文本对的特征尽可能相似,而让不同文本对的特征尽可能不同。最先的工作是CLIP,使用对比学习InfoNCE loss最大化同一个图像文本对的cosine similarity,最小化不同图像文本对的cosine similarity
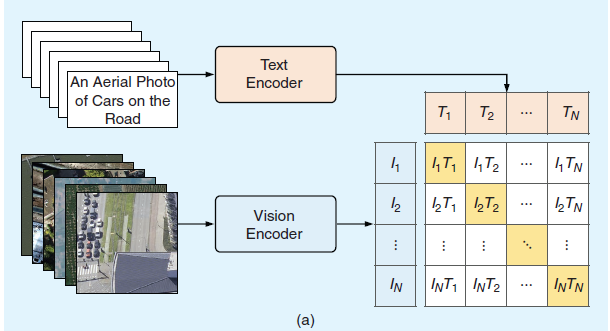
在这里插入图片描述
CLIP这些突破性进展激发了学界拓展其能力以推进遥感视觉语言模型(VLM)发展的研究兴趣。目前主要存在两条技术路线:其一遵循CLIP学习范式,专注于预训练任务无关但专门适配遥感领域的基础模型,包括构建大规模图文数据集[15][16]及开发新型预训练目标[33][34];其二探索预训练CLIP模型在多类下游任务中的高效适配,涵盖图像描述生成[35][36]、零样本场景分类[37][38]、图文检索[39][40]等方向。

Visual Instruction Tuning

由于需要海量数据与算力支撑,从头开始优化图像-文本对齐模型的成本极高。值得庆幸的是,当前已有大量预训练视觉编码器与语言模型发布:预训练视觉编码器能提供高质量视觉表征,而预训练语言模型(尤其是大语言模型LLMs)展现出卓越的语言理解能力。因此,越来越多的研究开始借鉴LLaVA[23]和MiniGPT-4[41]提出的视觉指令微调方法,利用这些现成模型实现图像-文本对齐。图3(b)展示了此类工作的典型网络架构,包含三个核心组件:预训练视觉编码器、连接器与LLM。具体而言,视觉编码器将遥感图像压缩为紧凑的视觉表征,连接器将图像嵌入映射至LLM的词嵌入空间,LLM则同步接收视觉信息与语言指令以执行推理任务。与CLIP直接输入图像-文本对不同,该方法将图文对预处理为指令跟随数据——每张图像配有问题或语言指令,要求LLM描述图像内容,而对应文本则作为LLM预测的真值标签。
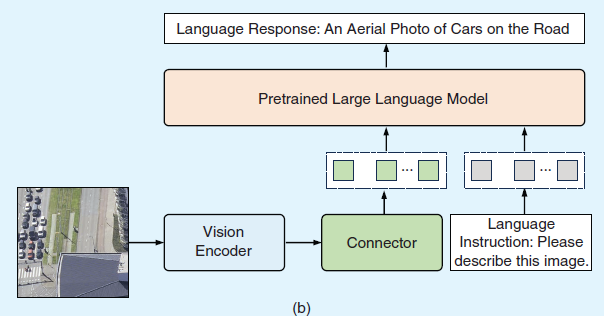
在这里插入图片描述
在预训练阶段,视觉编码器与大语言模型(LLM)通常保持冻结状态,仅对连接器参数进行训练。LLaVA[23]与MiniGPT-4[41]的研究表明,视觉指令微调预训练能在保持广泛知识的前提下实现视觉-语言表征的对齐。此后,研究者通过改进网络架构[24][42]和构建高质量预训练数据集持续推进该领域发展。除提升对齐效果外,另一研究方向聚焦于有监督微调(SFT),旨在使模型能执行多样化遥感图像分析任务并以对话方式与用户交互,具体包括:生成任务特定的指令跟随数据[18][25][43]、设计新型训练策略[42][44]以及集成前沿视觉编码器[44]。

Text-conditioned Image Generation
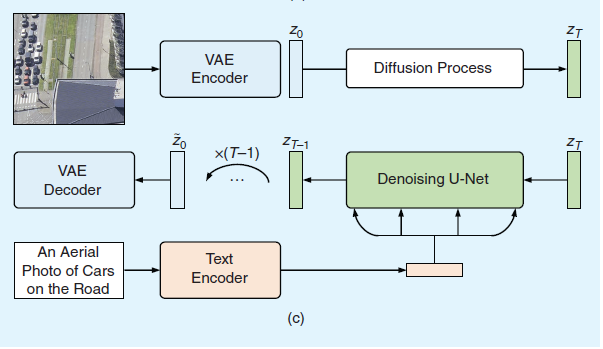
在这里插入图片描述
鉴于本文聚焦于采用扩散模型的视觉语言建模(VLM)研究,我们未试图涵盖其在遥感任务中的所有应用实例,而是重点探讨将文本条件与扩散模型相融合的代表性工作。关于扩散模型在遥感领域进展的更全面综述,请参阅文献[46]。

基于前述基本原理,当前形成两大研究方向:其一致力于开发面向多类遥感图像的生成式基础模型,涵盖卫星图像[21]、航空影像[47]、高光谱图像[48]及多分辨率图像[49];其二则将文本条件扩散模型拓展至特定遥感任务,如图像描述与变化描述生成[50][51]、全色锐化[52]以及零样本目标识别[53]等。

Contrastive-Based VLM

当前大多数视觉语言模型(VLM)研究集中于对比学习方向。如前所述,该领域主要存在两个重点研究方向:基础模型构建与高效任务适配。具体而言,基础模型构建致力于解决自然图像与遥感图像间的巨大域差异,其目标是学习蕴含丰富遥感场景语义、且与文本表征精确对齐的视觉表征;而高效适配则探索如何将预训练CLIP模型有效应用于特定遥感任务。后续章节将分别从这两个方向对现有研究进行系统性分析。

基础模型构建

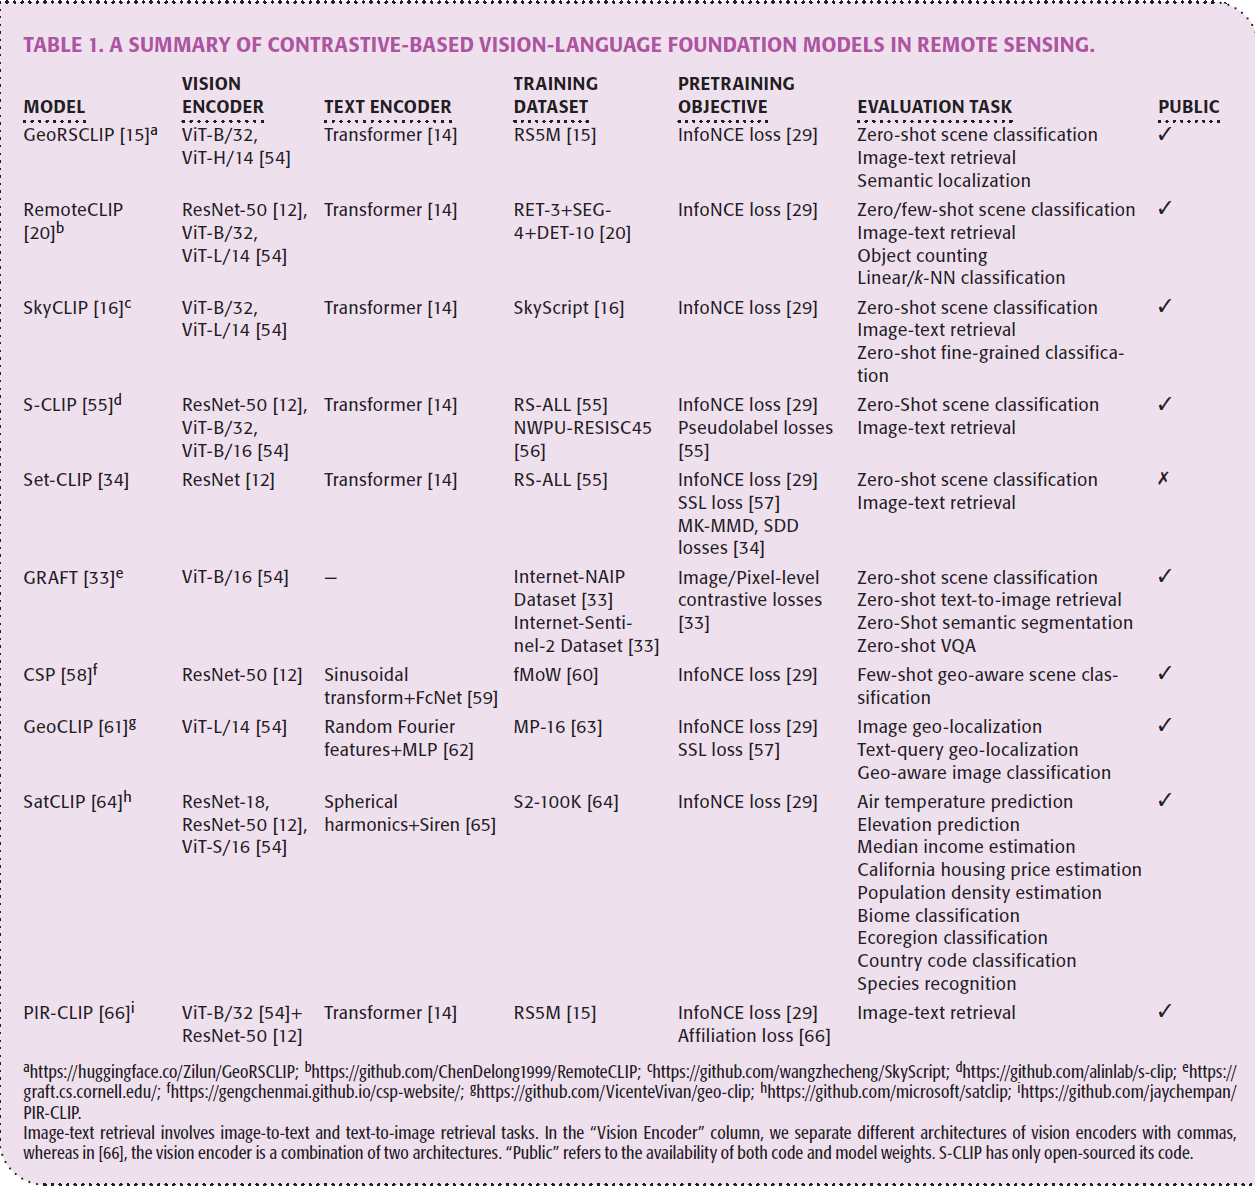
表格1总结了基于对比学习的遥感VLM。为了构建基础模型,三个核心部件需要精心设计,训练数据集,预训练目标,和编码器结构。
在这里插入图片描述

Training Datasets 训练数据集

大规模图文数据集是构建基础模型的基石。现有遥感领域的现成图文数据集(如UCM-captions和Sydney-captions)存在数据量有限与图像多样性不足的缺陷,难以支撑预训练模型获取领域通用知识。鉴于众多遥感图像数据集的可获得性,文献[15]与[20]采用开源数据集作为图像源,并开发图像描述生成方法以产生对应文本标注。值得注意的是,[15]通过遥感相关关键词筛选11个常用图文数据集,并借助调优后的BLIP2模型[69]对Million-AID[67]、fMoW[60]和BigEarthNet[68]三大遥感图像数据集进行标注,最终构建包含超500万图文对的RS5M数据集。现成的视觉语言模型虽因其可用性与易用性成为构建大规模图文数据的强大工具,但确保标注准确性仍是重大挑战。为此,[20]提出基于规则的掩码转边界框(M2B)与边界框转描述(B2C)方法,将像素级或边界框标注转化为自然语言描述。

另一关键问题在于生成描述的语义多样性受限于开源遥感数据集中预定义类别的有限性。鉴于此,Wang等学者[16]尝试利用OpenStreetMap(OSM)蕴含的丰富语义信息,使文本描述不仅能涵盖多样化的对象类别,还可包含细粒度子类别与对象属性。与[20]类似,该方法遵循预定义规则从对象标签中组合生成描述。

Pretraining Objectives 预训练目标

表格1中总结了不同的预训练损失函数,除了最经典的对比InfoNCE loss之外,一些研究人员还提出了新的预训练损失。例如S-CLIP [55] introduces caption-level and keyword-level pseudolabels to fine-tune the original CLIP model on massive unpaired remote sensing images alongside a few image-text pairs.
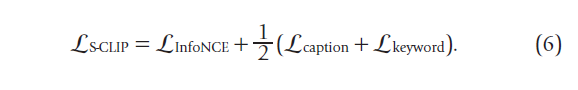
在这里插入图片描述

Set-CLIP [34] transforms the representation alignment between images and texts into a manifold matching problem,提出了Multikernel Maximum Mean Discrepancy Loss (L_MK-MMD) 和 semantic density distribution loss (L_SDD),此外,还引入了通过增强手段的自监督损失L_SSL.
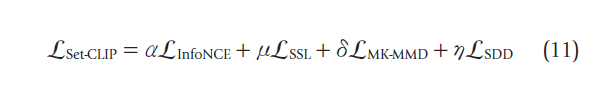
在这里插入图片描述
即便小规模图文数据集的构建也需要专业知识来生成文本描述。为彻底避免文本标注工作,GRAFT [33] 提出利用共位地面图像作为卫星影像与自然语言之间的桥梁。通过这种方法,研究团队收集了包含200万组地面对卫星图像配对的数据集,基于此,研究者设计了一个特征提取器,将卫星影像映射至CLIP模型的表征空间,由于单张卫星影像xi可能覆盖较大地面区域,因而可与多张地面图像gij建立关联,并构建了L_GRAFT损失。

Encoder Architectures 编码器架构

与自然图像通常由文本描述内容不同,遥感图像的文本信息可通过地理坐标(经度与纬度)表征,这种表征对场景分类和目标识别等任务具有显著价值[60]。因此,部分研究提出将遥感图像与其地理坐标的表征进行对齐,并特别关注位置编码器的选择[58][61][64]。位置编码器通常由非参数函数式位置编码与小型神经网络构成:CSP[58]采用现有二维位置编码器——即文献[59]提出的Space2Vec网格编码,该编码器通过正弦变换将图像坐标映射为高维表征,再经全连接ReLU层处理;GeoCLIP[61]则先对图像坐标施加等距地球投影以降低标准地理坐标系的固有畸变,继而采用随机傅里叶特征[62]捕捉高频细节,通过频率变化构建分层表征,这些分层表征经独立的多层感知机(MLP)处理后再进行元素加操作,最终生成联合表征,该设计使位置编码器能有效捕捉多尺度下的地理位置特征;SatCLIP[64]采用结合球谐基函数与正弦表示网络的位置编码器,将地理坐标映射为潜在表征[65]。

除适配不同类型文本信息外,编码器调整的另一目的在于提升视觉概念的表征质量。遥感图像通常覆盖广阔视场且包含多样地物,但其文本描述往往聚焦于特定目标及其空间关系。图像中的语义噪声(如无关物体与背景干扰)会阻碍关键内容的表征,从而破坏图文表征的对齐。文献[66]通过引入遥感场景先验知识指导预训练模型,在计算图文嵌入相似度前滤除语义噪声:具体通过在视觉编码器顶端增置指令编码器与Transformer编码层实现——指令编码器在场景分类数据集AID[70]上预训练后生成指令嵌入,通过软置信策略过滤图像嵌入;经滤波的嵌入再通过Transformer编码层结合指令信息激活,最终生成用于后续对齐的相关图像嵌入。

Performance Evaluation 性能评估

零样本场景分类,图像文本跨模态检索 是评估遥感VLM的广泛使用的任务。Zero-shot scene classification and image-text retrieval

Effective Adaptation Methods 有效适应方法

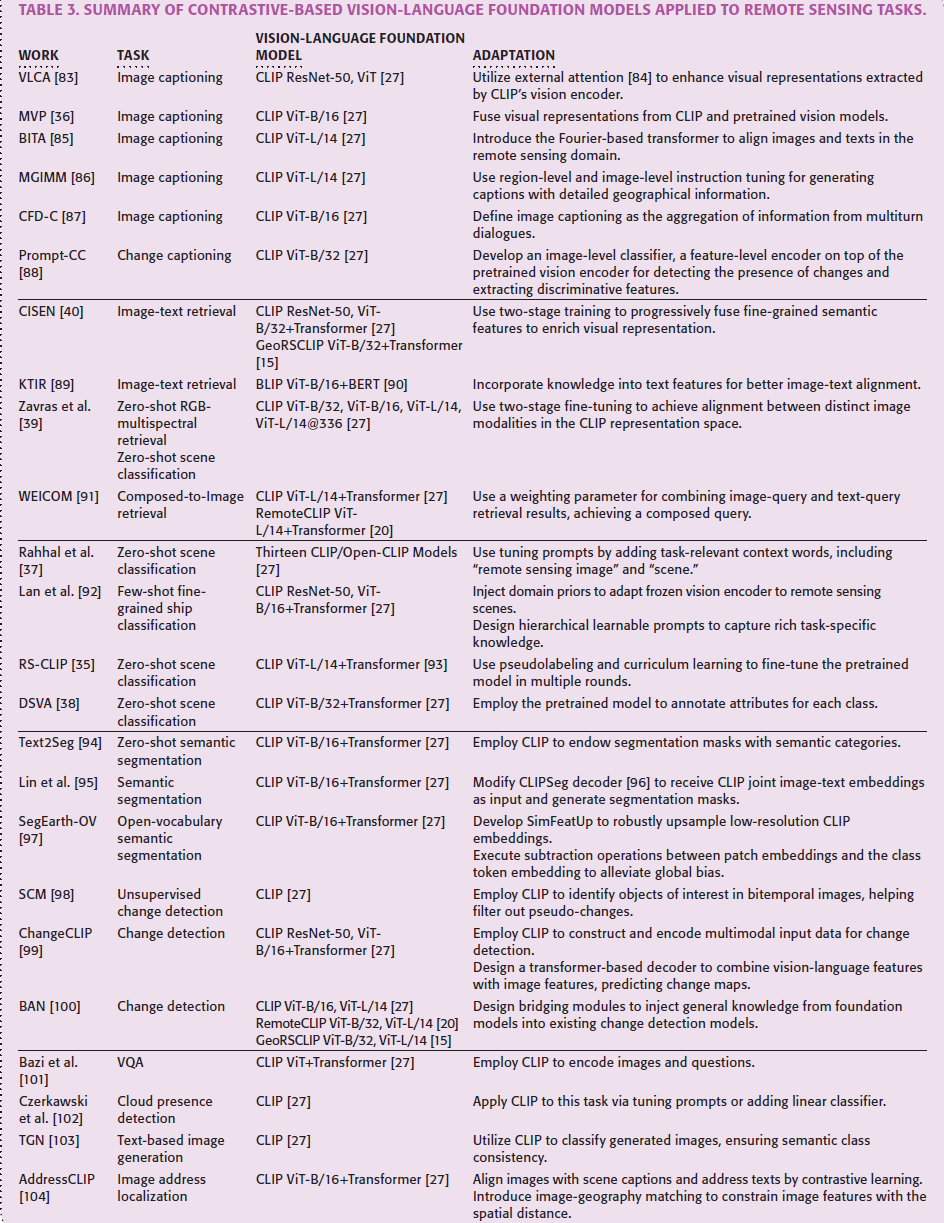
受基础模型卓越性能的启发,研究者已开发出多种方法将预训练模型有效适配于特定遥感任务,包括图像描述生成、跨模态检索、零样本分类、密集预测等。本节将结合表3的总结,系统阐述不同下游任务背景下适配方法的发展进展。
在这里插入图片描述

image captioning

图像描述生成旨在通过自然语言描述给定图像的内容。视觉-语言基础模型因其能对齐图文表征而特别适合此项任务:研究者可利用模型的视觉编码器提取图像内容表征,为语言模型生成描述提供输入准备[36][83][85]。当前遥感图像描述任务中,视觉编码器多采用CLIP架构,而语言模型则涵盖GPT-2[105]、BERT[106]与OPT[107]等。为提升描述准确性,部分研究致力于增强模型的视觉表征能力或进一步促进图文对齐。

以表征增强为例,VLCA[83]引入外部注意力机制[84]以捕捉不同图像间的潜在关联,从而提升视觉表征质量;MVP[36]通过堆叠Transformer编码器融合来自预训练视觉-语言模型与预训练视觉模型的视觉表征,并利用CLIP视觉编码器配合自适应平均池化层生成视觉前缀(visual prefixes),将其与词元嵌入进行拼接后,开发基于BERT的描述生成器来结合融合视觉表征与拼接嵌入,最终实现准确描述生成。与之相反,BITA[85]专注于通过交互式傅里叶变换器提升遥感领域图文对齐效果:该架构将可学习视觉提示输入傅里叶层,与预训练视觉编码器的图像嵌入进行交互,从而捕捉最相关的视觉表征;通过对比学习使这些视觉表征与同样由傅里叶变换器提取的文本表征对齐;最终该交互式傅里叶变换器连接冻结的视觉编码器与语言模型,充分发挥语言模型的生成与推理能力。

除提升描述准确性外,生成精细化描述也成为研究重点[86][87]。文献[86]提出两阶段指令微调方法优化视觉-语言映射层,以生成地理细节丰富的描述:第一阶段以指令"[region]基于遥感图像指定区域,描述该区域内主要对象的基本属性"为指导,实现地理对象区域与其属性描述的对齐;第二阶段通过指令"[image]请提供该图像的详细描述"聚焦地理对象空间分布的理解。文献[87]将图像描述定义为多轮对话信息聚合任务,每轮对话用于查询图像内容:CLIP视觉编码器逐轮提取图像特征,与历史问答对及当前问题共同输入自回归语言模型[105]生成应答;经多轮对话后,由GPT-3[108]汇总对话信息生成增强型文本描述。

与单图像描述不同,Prompt-CC[88]利用预训练模型描述双时相影像间的差异(即变化描述任务):基于CLIP提取的双时相视觉表征,引入图像级分类器检测变化存在性,并通过特征级编码器提取识别具体变化的判别性特征。

cross-modal retrieval

跨模态检索旨在通过一种模态的查询数据检索另一种模态的内容。基于视觉-语言基础模型,当前研究既探索图像与文本间的相互检索[40][89][91],也研究不同成像参数图像间的检索[39]。图文检索面临双重挑战:根据图像查询匹配对应文本描述,或根据文本查询匹配对应图像。现有工作利用预训练编码器分别编码图像与文本,将其映射至共享表征空间进行相似度度量:CISEN[


(AAAI,2025)GSNet:面向开放词汇的遥感图像语义分割 我们提出了开放词汇表遥感图像语义分割,并提出了一个名为LandDiscover50K的定制数据集。我们提出了一个名为GSNet的新型框架,用于OVRSISS,首先通过DSIE提取通用和特定领域的特征,然后通过QGFF进行多源特征融合,最后通过RIPD进行信息保留和细节细化。我们进行了广泛的实验,以证明我们的GSNet大幅优于其他最先进的OVNISS方法,并且我们的LandDiscover50K显著提高了OVRSISS方法的性能。 阅读详情

相关推荐

论文阅读|arxiv|综述|Remote Sensing Spatio-Temporal Vision-Language Models: A Comprehensive Survey

本文系统综述了遥感时空视觉语言模型(RS-STVLMs)的研究进展,涵盖模型架构、核心任务、关键技术及未来方向。传统遥感分析局限于单时相图像或二值变化检测,缺乏语义理解与自然语言交互能力。RS-STVLMs通过融合视觉与语言模态,支持变化描述生成、问答、定位等任务,实现了更高层次的动态场景解析。文章梳理了从任务特定模型到通用基础模型的演进路径,分析了视觉编码、时空融合、多模态交互等关键技术,总结了典型数据集与评估指标,并探讨了大规模预训练、时空泛化等未来挑战。本综述为遥感智能解译与多模态交互提供了系统参考。

2401_89384928的博客 1009

【Image captioning】UCM遥感图像字幕数据集生成Resnet特征

UCM-Captions数据集包含21个类别,包括飞机、海滩、高架桥和体育场等,总共有2100张遥感图像。文件,以供数据加载器使用。在此过程中,它将对图像的标注信息进行一些基本预处理(例如,转为小写、添加 UNK 标记等),创建一个特殊的 UNK 标记,并将所有标注信息编码为数组形式。最终生成的 HDF5 文件包含了多个字段,包括所有标注信息的编码数组以及每张图像标注信息的起始和终止指针;是一个 UCM-Captions数据集的注释文件,其中包含了每个图像的标注信息,如图像的路径、ID、宽高、类别等。

安静到无声 1657

【Image captioning】基于检测模型网格特征提取——以Sydeny为例

今天,我们将重点探讨如何利用Faster R-CNN检测模型来提取Sydeny数据集的网格特征。具体而言,这一过程涉及通过Faster R-CNN模型对图像进行分析,进而抽取出关键区域的特征信息,这些特征在网格结构中被系统地组织和表示。下面,我将引导大家深入了解这一特征提取流程。

安静到无声 469

Sydney Urban Objects Dataset悉尼城市物体数据集-数据集

Sydney Urban Objects Dataset is provided by the University of Sydney.本数据集由悉尼大学提供。 sydney-urban-objects-dataset.tar.gz

论文理解【LLM-OR】——【OptMATH】A Scalable Bidirectional Data Synthesis Framework for Optimization Modeling

本文提出 LLM-OR 领域的双向数据合成框架 OptMATH,从已有 MF/PD 出发反向生成 NL,再使用 AutoFormulator 进行正向建模,通过最优值匹配 rejection sampling 确保语义一致性。实现了难度可控的语义一致数据合成

佚失的诗篇 502

FPGA资料分享——FPGA开发板入手指南

FPGA学习,开发板怎么选,看这里,就一个通透

weixin_51627076的博客 7301

基于STM32与CAN总线的多电机协同控制系统设计与实现

本文详细介绍了基于STM32与CAN总线的多电机协同控制系统设计与实现。该系统采用分布式架构,通过CAN总线实现多节点通信,结合梯形加减速算法和同步控制策略,有效解决了工业自动化中多电机同步性差的问题。文章涵盖硬件设计、通信协议、抗干扰措施及实战调试经验,为工业应用提供高可靠性解决方案。

tech5的博客 972

creo二次开发使用映射

在creo进行二次开发时,一些无法直接通过访问底层代码来对特征进行操作,比如“镜像装配”,这个时候就可以使用映射(Mapkey)来完成一键镜像。 注:这是镜像装配的代码 ProError status; ProMacro macro; wstring Macro; strMacro = L"mapkey(continued) ~ Command ProCmdMirrorAssem ; mapkey(continued) ~ Activate mirror_component_dialog Sy

qq_49328512的博客 1671

告别WSL:Ollama Windows原生部署与GPU加速实战

本文详细介绍了Ollama在Windows系统上的原生部署与GPU加速实战指南。告别WSL,通过官方原生应用直接调用NVIDIA和AMD显卡,实现更高效的本地大模型运行。文章涵盖系统准备、三步安装、模型拉取运行、GPU性能优化及高级配置,为Windows AI开发者提供一站式解决方案。

prometheus9mon的博客 537

基于 AUTOSAR 的域控产品软件开发进阶探索

本文深入探讨了AUTOSAR架构在汽车域控产品开发中的进阶应用。首先从系统设计角度分析了AUTOSAR分层架构原理及其在域控产品中的优化部署策略;其次详细介绍了Davinci和EBTresos等主流工具链的特点与协同使用方法;然后重点阐述了ASPICE流程与功能安全/信息安全标准的实施要点;最后分享了多核车载芯片(如NXP S32G)的适配经验与优化实践。通过架构设计、工具运用、标准遵循和芯片适配四个维度的专业解析,为域控产品的AUTOSAR开发提供了系统性指导。

SiArch的博客 1202

《第二十二篇》Cross-Attention:注意力机制详解-代码实现和公式详解《二》

本文详细介绍了Cross-Attention的原理、公式和实现。Cross-Attention用于Transformer解码器和Encoder-Decoder结构,通过查询向量(Q)与键、值向量(K、V)的交互实现序列对齐。核心公式为softmax(QK^T/√d_k)V,其中Q来自Decoder,K、V来自Encoder。文章还给出了多头注意力机制公式和PyTorch实现代码,包括投影计算、注意力分数计算和输出处理。代码示例展示了如何构建一个完整的Cross-Attention模块,并演示了其在解码器查询

guoguozgw的博客 2214

Halcon算子知识:optical_flow_mg

光流(Optical Flow)是一种研究图像对齐的算法,一般包括两大类:稀疏光流和稠密光流。稀疏光流就是研究图像中稀疏点的光流,这些点一般是角点;稠密光流则是研究图像中所有点的偏移量。以下介绍halcon的基本光流算子optical_flow_mg的原理方法。该算子计算两个图片的光流法。 二、算子说明 optical_flow_mg(ImageT1, ImageT2 : VectorField : Algorithm, SmoothingSigma, Integration

gongdiwudu的专栏 1万+

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

上一篇: IEEE GRSM 2025:Vision Foundation Models in Remote Sensing
下一篇: IEEE GRSM 2025:Foundation Models for Remote Sensing and Earth Observation A Survey
practical_sharp
博客等级 码龄8年 500粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值