典型常见的知识蒸馏方法总结二

[论文阅读]CWD——基于稠密预测的通道式知识蒸馏 CWD论文解读 阅读详情

来源:https://github.com/open-mmlab/MMRazor收录的方法

ICCV 2021:Channel-Wise Knowledge Distillation for Dense Prediction
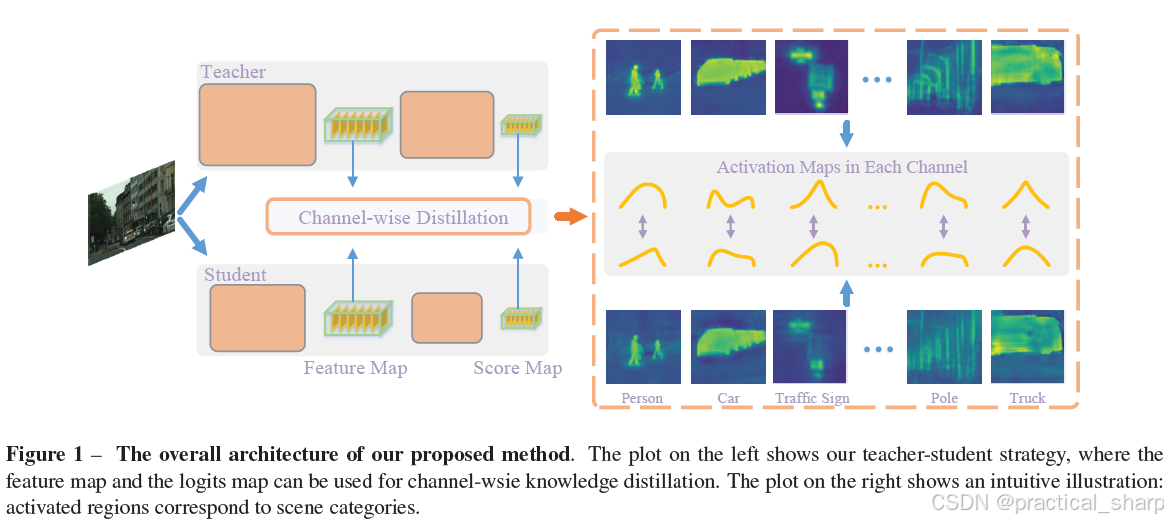
在这里插入图片描述

首先,使用1x1卷积将教师模型与学生模型的中间层特征的通道维度进行对齐。

A 1x1 convolution layer is employed to upsample the number of channels for the student network if the number of channels mismatches between the teacher and the student.

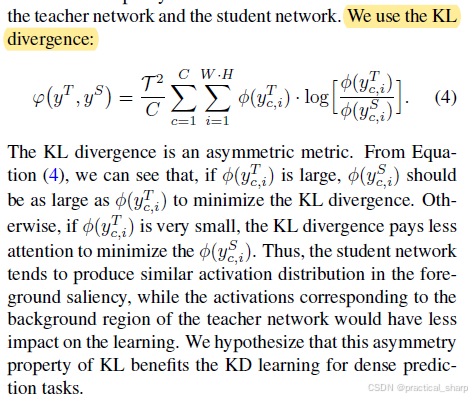
然后,对每个通道的WxH的特征进行softmax归一化。
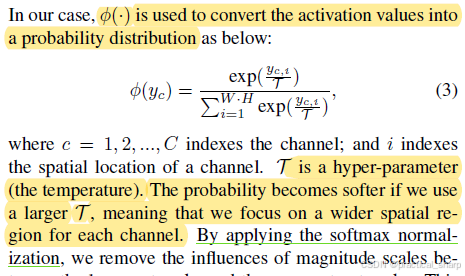
在这里插入图片描述

最后,使用KL散度损失来最小化学生特征与教师特征之间的距离

在这里插入图片描述

ICLR 2018 Workshop:Training Shallow and Thin Networks for Acceleration via Knowledge Distillation with Conditional Adversarial Networks

Adversarial learning for knowledge distillation can be first found in (Ref. ICLR 2018 Training Shallow and Thin Networks for Acceleration via Knowledge Distillation with Conditional Adversarial Networks).
Liu et al. (Ref. CVPR 2019:Structured Knowledge Distillation for Semantic Segmentation) shares the similar idea for semantic segmentation, named holistic distillation. We also leverage the adversarial learning performed in the output space.

Main idea: We propose to use conditional adversarial networks to learn the loss function to transfer knowledge from teacher to student.
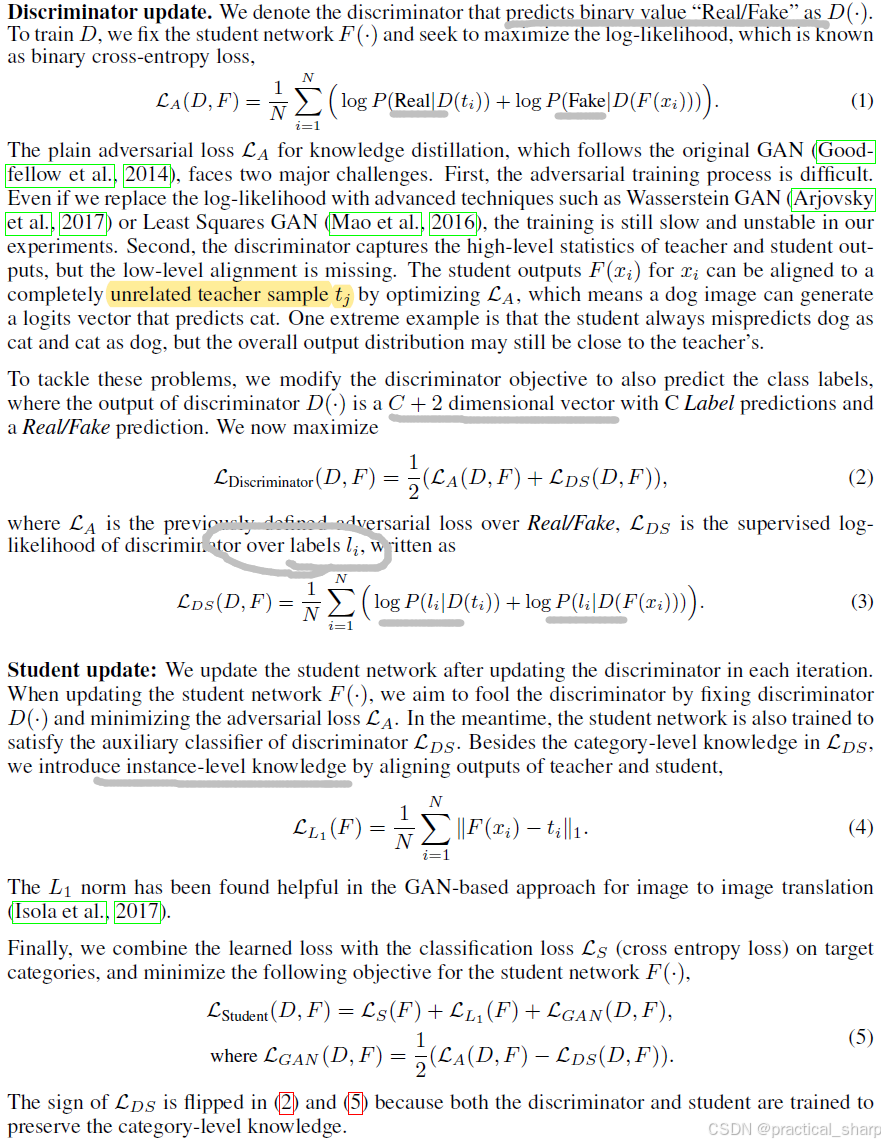
在这里插入图片描述

CVPR 2019:Structured Knowledge Distillation for Semantic Segmentation

提出从大网络中蒸馏结构化知识到小网络中,structure knowledge
调研了两种结构化知识 (1)pair-wise similarity (2) GAN-based holistic distillation
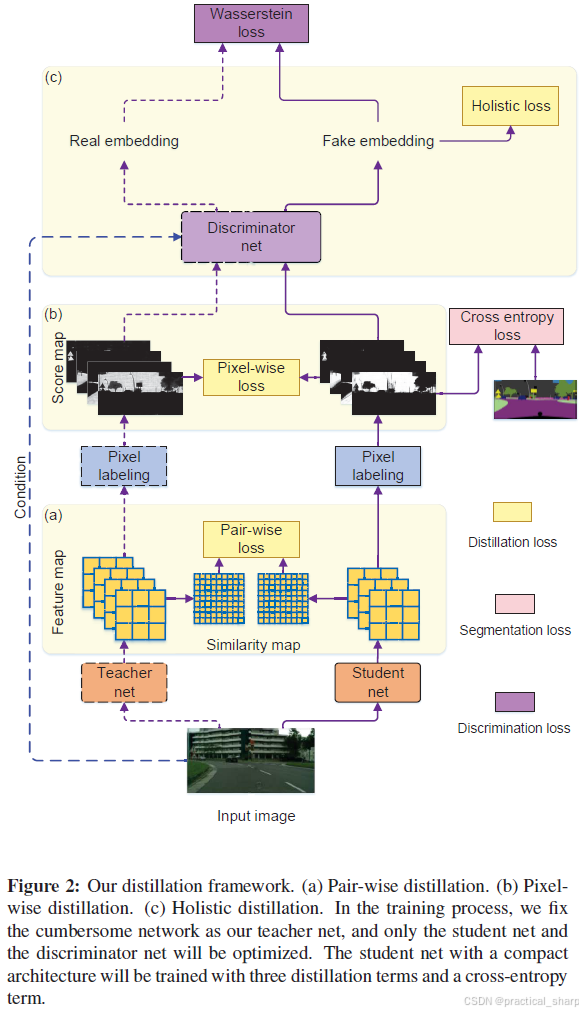
在这里插入图片描述

Pixel-wise distillation:使用语义分割预测的每个类别的类别概率logits,KL散度

在这里插入图片描述

Pair-wise distillation:使用余弦相似性计算的相似性矩阵,MSE loss

在这里插入图片描述

Holistic distillation:采用 conditional generative adversarial learning

在这里插入图片描述

总的损失函数:multi-class cross-entropy loss ℓmc(S)为学生预测与真实标签的多分类交叉熵

在这里插入图片描述

CVPR 2019:Knowledge Adaptation for Efficient Semantic Segmentation

在这里插入图片描述

(1) The first part is designed for translating the knowledge from the teacher network to a compressed space that is more informative. The translator is achieved by training an autoencoder to compress the knowledge to a compact format that is easier to be learned by the student network, otherwise much harder due to the inherent structure differences.

第一部分旨在将来自教师网络的知识转换到一个信息量更丰富的压缩空间中。通过训练一个自动编码器来实现这种转换,该自动编码器能将知识压缩成一种更紧凑的格式,这样的格式更便于学生网络学习,否则,由于内在结构差异,学生网络学习起来会困难得多。

(2) The second part is designed to capture long-range dependencies from the teacher network, which is difficult to be learned for small models due to the limited receptive field and abstracting capability.

第二部分旨在从教师网络中捕捉长距离依赖关系,由于小型模型的感受野有限且抽象能力不足,这种长距离依赖关系对它们来说是很难学习到的。
在这里插入图片描述

训练步骤:第一步:训练教师网络和教师网络的auto-encoder;

在这里插入图片描述

训练步骤:第二步,训练学生网络
feature adapter loss

在这里插入图片描述
Cf指的是学生网络adapter的特征,E指的是教师模型auto-encoder的encoder输出的特征

affinity loss:作者声称affinity能捕获capture long-range dependencies

在这里插入图片描述

arXiv 2020:Channel Distillation:Channel-wise attention for knowledge distillation

在这里插入图片描述

核心思想是两点。The first transfer strategy is based on channel-wise attention, called Channel Distillation (CD).
计算每个Channel的权重

在这里插入图片描述

对n个阶段的C通道的权重进行平方损失

在这里插入图片描述

The second is Guided Knowledge Distillation (GKD). GKD only enables the student to mimic the correct output of the teacher
传统的基于logits的KL散度蒸馏损失

在这里插入图片描述

判别教师预测与真值标签的二值概率作为蒸馏损失权重来优化传统的基于logits的KL散度蒸馏损失

在这里插入图片描述

ICLR 2021:Rethinking Soft Labels for Knowledge Distillation: A Bias-Variance Tradeoff Perspective

从统计学习的角度来看,正则化旨在降低方差,然而在使用软标签进行训练时,偏差和方差如何变化并不明确。在本文中,我们对使用软标签进行蒸馏所带来的偏差 - 方差权衡问题进行了研究。具体而言,我们观察到在训练过程中,偏差 - 方差权衡会因样本不同而有所变化。此外,在相同的蒸馏温度设置下,我们观察到蒸馏性能与某些特定样本的数量呈负相关,这些样本被称为正则化样本,因为它们会导致偏差增大、方差减小。不过,我们通过实验发现,完全剔除正则化样本也会使蒸馏性能变差。
我们的这些发现启发我们提出了一种新颖的加权软标签,以帮助网络自适应地处理基于样本的偏差 - 方差权衡问题。在标准评估基准上进行的实验验证了我们方法的有效性。

提出了 weighted soft labels,对每一个instance只加了一个权重,来修正标准的基于logits的知识蒸馏过程

在这里插入图片描述

ICCV 2019:Be Your Own Teacher: Improve the Performance of Convolutional Neural Networks via Self Distillation

提出了自蒸馏的方法

在这里插入图片描述

Loss Source 1: Cross entropy loss from labels to not only the deepest classifier, but also all the shallow classifiers. 类似于语义分割中的深监督,每一层的预测都与ground truth进行监督

在这里插入图片描述

Loss Source 2: KL (Kullback-Leibler) divergence loss under teacher’s guidance. The KL divergence is computed using softmax outputs between students and teachers, and introduced to the softmax layer of each shallow classifier 最深层的softmax logits作为教师,与浅层特征输出的softmax的logits进行KL散度损失

在这里插入图片描述

Loss Source 3: L2 loss from hints. It can be obtained through computation of the L2 loss between features maps of the deepest classifier and each shallow classifier. 最深层的特征作为教师,与浅层特征进行L2损失。

在这里插入图片描述

一些Data-Free的知识蒸馏方法,这里先跳过

arXiv 2019: Data-Free Adversarial Distillation
ICCV 2019: Data-Free Learning of Student Networks
CVPR 2021: Learning Student Networks in the Wild

ICCV 2019: A Comprehensive Overhaul of Feature Distillation

我们对实现网络压缩的特征蒸馏方法的设计层面进行了研究,并提出了一种新颖的特征蒸馏方法。
在该方法中,蒸馏损失的设计旨在使以下各个方面产生协同作用:教师变换、学生变换、蒸馏特征位置以及距离函数。 teacher transform Tt, student transform Ts and distance d
我们所提出的蒸馏损失包含一种带有新设计的边缘修正线性单元(margin ReLU)的特征变换、一个新的蒸馏特征位置,以及一个能够跳过对学生模型压缩产生不利影响的冗余信息的部分 L2 距离函数。

在这里插入图片描述

teacher transform Tt, student transform Ts, and distance d,不同方法的对比

在这里插入图片描述

Transform的使用会压缩特征从而导致信息的丢失,蒸馏的位置放在激活函数之后会过滤掉错误信息从而导致信息丢失,L2会引起错误信息,所以提出partial L2跳过对负区域信息的蒸馏。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述

ICLR 2021:Improve Object Detection with Feature-based Knowledge Distillation: Towards Accurate and Efficient Detectors

propose the attention-guided distillation, which emphasizes students’ learning on the foreground objects and suppresses students’ learning on the background pixels. 提出一种注意力的蒸馏,强调学生对前景目标的学习,压制学生对背景像素的学习
propose the non-local distillation, which enables the students to learn not only the information of the individual pixel but also the relation between different pixels from teachers. 提出一种非局部的蒸馏,允许学生能够不仅学习独立的像素,并且探索不同像素之间的关联性

在这里插入图片描述

Attention-Based Loss

在这里插入图片描述

Non-Local Distillation Loss:对特征进行non-local模块的处理之后得到的r进行L2距离约束

在这里插入图片描述

总的蒸馏损失

在这里插入图片描述

典型常见的基于知识蒸馏的目标检测方法总结三 开放词汇目标检测旨在使在固定对象类别集上训练的目标检测器具备检测由任意文本查询描述的对象的泛化能力。先前的方法采用知识蒸馏从预训练的视觉语言模型(PVLM)中提取知识并将其转移到检测器中。然而,由于非自适应的提议裁剪和单层级特征模仿过程,它们在知识提取过程中存在信息破坏问题,并且知识转移效率低下。为了弥补这些局限性,我们提出了一个对象感知蒸馏金字塔(Object-Aware Distillation Pyramid,OADP)框架,包括一个。 阅读详情

相关推荐

典型常见的知识蒸馏方法总结三

经典的蒸馏方法通过匹配输出激活值,将表征从 “教师” 神经网络转移到 “学生” 网络。近期的方法还会匹配它们的Jacobian矩阵,或者输出激活值相对于输入的梯度。见之前的博文典型常见的知识蒸馏方法总结一。

practical_sharp的博客 1475

Channel-wise Knowledge Distillation for Dense Prediction(ICCV 2021)原理与代码解析

之前大多数用于密集预测dense prediction任务的蒸馏方法在空间域spatial domain中将教师和学生网络的激活图进行对齐,通过标准化normalize每个空间位置的激活值,并减小point-wise and/or pair-wise之间的差异来实现知识的传递。 和之前的方法不同,本文提出对每个通道的激活图进行标准化从而得到一个soft probabality map,通过减小两个网络channel-wise概率图之间的KL散度,使蒸馏过程更关注每个通道最显著的区域,这对密集预测任务非常有

00000cj的博客 1905

典型常见的基于知识蒸馏的目标检测方法总结一

使用feature propagation layer [29]将voxel特征转换为point feature。

practical_sharp的博客 2077

【知识蒸馏】Channel-wise Knowledge Distillation for Dense Prediction

论文链接:https://arxiv.org/pdf/2011.13256.pdf 代码链接:https://github.com/irfanICMLL/TorchDistiller MMDetection:https://github.com/pppppM/mmdetection-distiller MMSegmentation:https://github.com/pppppM/mmsegmentation-distiller 一、背景 密集预测是计算机视觉的一个重要基础,如语义分割和目标检测,这些任.

呆呆的猫的博客 9512

知识蒸馏 综述 Knowledge Distillation: A Survey

Knowledge Distillation: A Survey 本文译自Knowledge Distillation: A Survey,论文地址:https://arxiv.org/abs/2006.05525 (有翻译不周之处,敬请指正) 1. Introduction 深度学习取得了巨大进步,但是受限于庞大的计算量和参数量很难实际应用与资源受限设备上。 为了使深度模型更加高效,主要有以下两个方向的研究: 高效的网络模块构建:如MobileNets, ShuffeNets .

doctor_strange**** 1万+

什么是特征蒸馏?什么是知识蒸馏?

​​特征蒸馏是一种知识迁移方法,它将教师模型在中间层学到的特征表示(如语义、结构、上下文信息)迁移到学生模型中,让学生模型不仅学会“做什么”(输出),还学会“怎么看”(特征),从而提升整体性能。​​。

m0_74027860的博客 2430

Channel-wise Knowledge Distillation for Dense Prediction

知识蒸馏已被证明是训练密集目标检测模型的一种简单而有效的工具。轻量级的学生网络通过从大型教师网络转移来的额外监督进行训练。用于密集检测任务的大多数先前KD变体在空间域上对齐来自学生和教师网络的激活图,通常通过对每个空间位置上的激活值进行归一化并最小化逐点和/或逐对差异。与以前的方法不同,这里我们建议对每个通道的激活图进行归一化,以获得soft 概率图。通过简单地最小化两个网络的通道概率图之间的KL散度 ,蒸馏过程更加关注每个通道的最显著区域,这对密集检测任务很有价值。

weixin_43238909的博客 1447

大模型知识蒸馏技术(4)——离线蒸馏

离线蒸馏是知识蒸馏中最早被提出且最为常见的实现方式,其核心在于教师模型和学生模型的训练是分阶段进行的。具体而言,教师模型首先在训练集上进行充分训练,直至收敛,然后利用教师模型的输出(通常是软目标)来指导学生模型的训练。

谷哥的小弟 2454

典型常见的基于知识蒸馏的目标检测方法总结二

pc是每个像素点的预测分类概率值最大的概率pr是每个像素点预测的bounding box与GT bounding box的最大IoU得分。然后作者定义了HS得分,用于平衡两个子任务的预测得分:并在此基础上,定义了基于Harmonious的Distillation loss:此外,作者更进一步引入了一种动态变化因子dynamic modulation factor,用于为每个空间像素点施加不同的损失权重作者发现直接模仿教师模型的预测会面临目标冲突问题,这阻碍了预测模仿取得良好的性能。

practical_sharp的博客 2553

联邦学习——用data-free知识蒸馏处理Non-IID

《Data-Free Knowledge Distillation for Heterogeneous Federated Learning》 最近出现了利用知识蒸馏来解决FL中的用户异构性问题的想法,具体是通过使用来自异构用户的聚合知识来优化全局模型,而不是直接聚合用户的模型参数。然而,这种方法依赖于proxy dataset,如果没有这proxy dataset,该方法便是不切实际的。此外,集成知识没有被充分利用来指导局部模型的训练,这可能反过来影响聚集模型的性能。 基于上述挑战,这篇文章提出了一种da

联邦学习小白 6509

用于密集预测任务的通道知识蒸馏——关键字:蒸馏

知识蒸馏(KD)已被证明是训练紧凑密集预测模型的简单有效工具。通过从大型教师网络转移而来的额外监督来训练轻量级学生网络。大多数先前的针对密集预测任务的KD变体都在空间域中对学生网络和教师网络的激活图进行对齐,通常是通过在每个空间位置标准化激活值并最小化逐点和/或成对差异来实现的。与先前的方法不同,我们提出对每个通道的激活图进行标准化以获得软概率图。

m0_47867638的博客 1273

典型常见的知识蒸馏方法总结一

知识蒸馏开山之作,从logits中蒸馏知识,KL散度损失A hint is defined as the output of a teacher’s hidden layer responsible for guiding the student’s learning process,we choose a hidden layer of the student, the guided layer, to learn from the teacher’s hint layerSimilarly, we ch

practical_sharp的博客 1352

关于知识蒸馏的概念原理以及常见方法

借助知识蒸馏,可以在资源受限或大规模在线服务场景中,让深度学习模型变得更轻便、更高效,依然能在性能上与大模型相差无几,甚至更具优势。随着AI应用范围的不断扩大,知识蒸馏也在不断衍生出新的方法与思路,成为深度学习模型部署与优化不可或缺的一环。祝你在知识蒸馏领域取得更多实践成果和创新突破!的一种思路(在不改变任务的情况下把“大模型的知识”迁移到“小模型”)。以下提供关键要点和最佳实践。的一种主要手段,也可视作。

形上得其象,形下合于数;阴阳自济,玄理自明。 729

万字综述 | 一文读懂知识蒸馏

知识蒸馏综述摘要知识蒸馏简介知识Response-Based KnowledgeFeature-Based KnowledgeRelation-Based Knowledge蒸馏离线蒸馏(Offline Distillation)在线蒸馏(Online Distillation)自我蒸馏(Self-Distillation)师生架构蒸馏算法对抗蒸馏(Adversarial Distillation)多教师蒸馏(Multi-Teacher Distillation)跨模态蒸馏(Cross-Modal Dist

u012347027的博客 1万+

Halcon-AOI外观缺陷检测系列

Halcon-AOI外观缺陷检测系列

Jumy_S的博客 1669

Vivado 2018.3 SDK烧写bin文件避坑指南:如何解决QSPI模式下的常见错误

本文深入解析了在Vivado 2018.3 SDK中为Zynq FPGA烧写QSPI Flash时遇到的常见问题,特别是启动模式为QSPI时出现的警告与失败。文章从Zynq启动机制入手,提供了修改FSBL代码以强制使用JTAG模式、调整硬件配置等核心解决方案,并分享了实战案例与最佳实践,帮助开发者高效避坑,确保bin文件烧写成功。

arduino9maker的博客 390

【学习总结+论文复现】知识蒸馏Knowledge Distillation学习一条龙(完结)

本文章以2020年《Contrastive Representation Distillation》的知识蒸馏技术为学习基础来学习知识蒸馏技术。此外还涉及了最新的知识蒸馏方法。例如,DKD,KD++,Review KD,多出口网络+集成学习KD,DisWOT,MSFF,CMKD,CTKD,MGD,PEFD,SimKD,Logits标准化KD,SDD。

qq_739988982的博客 2万+

从Wi-Fi到蓝牙:手把手教你用Cadence Virtuoso搭建一个2.4GHz锁相环频率综合器(含PFD/CP/VCO模块设计)

本文详细介绍了如何在Cadence Virtuoso中设计一个2.4GHz锁相环频率综合器(PLL),涵盖从系统架构到模块级设计的全流程。重点解析了PFD、CP和VCO等核心模块的设计技巧与仿真验证方法,帮助模拟集成电路设计师掌握高频PLL的实现要点,满足Wi-Fi和蓝牙等无线通信标准的要求。

weixin_30315723的博客 419

简单带你了解大模型时代的知识蒸馏方法

知识蒸馏作为一种高效的模型压缩和知识转移技术,能够在保持模型性能的前提下,大幅降低计算成本和资源需求。无论是在边缘计算、移动设备,还是在大规模机器学习任务中,知识蒸馏都将发挥越来越重要的作用。通过不断的研究与实践,知识蒸馏有望为AI的发展带来更多的创新与突破。

IT枫斗者的博客 4008

cmw500 lte非信令测试_WiFi信令测试在研发过程中的作用

  1、关于信令测试的故事  2016年的某天,某著名网络产品公司技术负责人致电寻求技术支持:我们的无线路由器遇到了一个困惑:我们某款路由器应用于实际WiFi网络中时,WiFi终端接入非常困难。但是我们使用测试工具检测此路由器,它的所有物理射频指标都非常优异。不知道是为什么?  我来到了测试现场看到:WiFi路由器受控于芯片公司的测试工具,其WiFi发射机指标在非信令测试仪上显示:无论功率、EVM...

weixin_39662263的博客 3928

tewa-707e光猫超级密码获取方法

这款光猫很魔性,没有WIFI,没有USB接口,没有Telnet,试了很多方法去获取超级密码都不行。解密时可能会报错,可能是文件后面部分不晓得是咋拼接过来的,用AES解密时分组数据有问题。3、这个文件是用AES加密了的,直接打开是乱码,所以得用AES解密,key为16个字节的 x00。打开解出来的文件,然后搜索 telecomadmin,就可以发现超级密码了。参考资料里面的光猫不是同一款,但解密的方法基本相同的。

shaowl111的专栏 1万+

知识蒸馏:原理、算法与应用

知识蒸馏:原理、算法与应用

a131529的博客 2852

Python爬虫实战:东方财富股吧与雪球舆情数据实时爬取与情绪指标挖掘

本文详细介绍如何使用Python爬虫技术实时爬取东方财富股吧和雪球平台的讨论数据,结合股价波动构建情绪分析指标。我们将使用最新的异步爬虫技术、自然语言处理方法和可视化工具,为量化交易提供数据支持。文章包含完整的代码实现和技术细节,适合有一定Python基础的读者学习。

2201_76125261的博客 1225

知识蒸馏--教师与学生模型原理及代码详解

知识蒸馏是一种模型压缩技术,通过高性能教师模型指导轻量级学生模型训练,实现小模型性能逼近大模型的目标。其核心价值在于模型压缩部署、提升小模型精度以及跨域知识迁移。典型方法包括软标签蒸馏、特征匹配、注意力蒸馏和关系蒸馏,采用教师-学生框架进行两阶段训练。流程包含教师模型推理生成软标签、学生模型联合优化真实标签与软标签损失、参数更新等步骤。该技术广泛应用于计算机视觉、自然语言处理等领域,有效解决大模型部署难题。

m0_53414416的博客 4089

正点原子stm32f103RChal库制作数字秒表:如用keil5和正点原子STM32F1开发板实现?

🏆本文收录于 《全栈Bug调优(实战版)》 专栏,该专栏专注于分享我在真实项目开发中遇到的各类疑难Bug及其深层成因,并系统提供高效、可复现的解决思路和实操方案。无论你是刚入行的新手开发者,还是拥有多年项目经验的资深工程师,本专栏都将为你提供一条系统化、高质量的问题排查与优化路径,助力你加速成长,攻克技术壁垒,迈向技术价值最大化与职业发展的更高峰🚀!    📌 特别说明: 文中部分技术问题来源于真实生产环境及网络公开案例,均经过精挑细选与系统化整理,并结合多位一线资深架构师和工程师多年实战经验沉淀,提

**My Coding Family** 1267

基于STM32L4XX 、HAL库的TMP144YFFR数字温度传感器驱动应用C语言程序设计

define TMP144_ADDRESS 0x00 // 默认为全局地址,用于单器件或MDA命令。#define TMP144_CMD_READ_TEMP 0x00 // 读取温度寄存器命令。if (temp_raw & 0x800) { // 判断第11位(符号位)

PP_Cottage的博客 92
上一篇: 典型常见的知识蒸馏方法总结一
下一篇: 典型常见的知识蒸馏方法总结三
practical_sharp
博客等级 码龄8年 500粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值