基于 RK3588 的 YOLO 多线程推理多级硬件加速引擎框架设计(项目总览和加速效果)

保姆级教程:RK3588部署yolo目标检测模型 RK3588部署yolo目标检测模型非常详细的保姆级教程 阅读详情
AI摘要

本文介绍基于RK3588平台的YOLO多线程推理加速框架,结合RKMPP硬件解码、RGA图像处理加速与多线程技术,系统评估四种加速方案。实验显示,独立启用硬件解码或RGA均可提升帧率,但二者协同时存在性能瓶颈,有待进一步优化,整体显著降低CPU与NPU负载。

一、前言

        该推理框架的 baseline 和灵感,源于 Github 上的一个项目:

leafqycc/rknn-cpp-Multithreading: A simple demo of yolov5s running on rk3588/3588s using c++ (about 142 frames). / 一个使用c++在rk3588/3588s上运行的yolov5s简单demo(142帧/s)。https://github.com/leafqycc/rknn-cpp-Multithreading        该项目描述清晰,代码整洁。我在部署过程中,遇到了一些编译错误和环境问题,不过这都是常规流程,在攻克了两天后,实现了本地的部署,并达到了作者的最高帧数:141帧(C++),python版本也做了一个快速部署,达到了最高 50 帧。

        作者的目的是实现一个 demo,为更多开发者可以快速部署到自己的项目和工程中。我本人也一直在学习作者的编程逻辑以及各个部分的实现方式,尽可能的掌握每一个细节,当然线程池除外,现在看起来还是头大,哈哈哈。

        我准备分两部分来讲解项目的设计框架,本篇为第一部分,主要介绍项目总览和加速效果,下一篇主要介绍代码的框架和实现细节。

第二部分:

基于 RK3588 的 YOLO 多线程推理多级硬件加速引擎框架设计(代码框架和实现细节)-优快云博客https://blog.youkuaiyun.com/plmm__/article/details/146556955?spm=1001.2014.3001.5501

二、项目贡献

        从接触这个项目到完成现在的推理加速框架,断断续续也花了半年的时间。期间也一直在持续优化代码逻辑,并思考如何继续加速 YOLO 的推理速度,因此我的项目也主要在下面这几点做了改进:

        1、完善代码框架,增加命令行参数解析、视频解码器的多态实现、OpenCL 可选、RGA 可选、软硬件加速可选以及一些内存管理的优化等。

        2、添加硬件加速,使用 RKmpp 实现硬件视频解码、使用 RGA 接口实现 2D 图像缩放和颜色空间转换的硬件加速。

        3、(2025年9月新增)将图像数据的传输方式从 CPU 搬运优化为 DMA(直接内存访问)传输。

        其中 RKmpp 使用 FFmpeg 接口实现,隐藏了 RKmpp 的接口,这样也可以提高项目的可复用性,例如有其他解码器的需求;RGA 则是在反复翻看官方手册和 librga 库的 demo 后,自己总结并编写的即插即用接口,不过目前主要以 OpenCV 的 cv::Mat 对象进行数据传输,RGA 也可以通过 FFmpeg 的过滤器实现,不过我个人觉得直接使用 RGA 接口更方便,效率也更高。

        一些小项我也分别写了对应的文章,链接:

编译支持 RKmpp 和 RGA 的 ffmpeg 源码_rk3588 ffmpeg mpp-优快云博客https://blog.youkuaiyun.com/plmm__/article/details/146188927?spm=1001.2014.3001.5501C和C++语言应用程序解析命令行参数-优快云博客https://blog.youkuaiyun.com/plmm__/article/details/146254801?spm=1001.2014.3001.5501香橙派5Plus使用rkmpp硬件解码的速度优化与输出格式更改-优快云博客https://blog.youkuaiyun.com/plmm__/article/details/146524675?spm=1001.2014.3001.5501

RK3588 使用 FFmpeg 硬件解码输出到 DRM Prime (DMA Buf) 加速数据传输_ffmpeg rk3588-优快云博客https://blog.youkuaiyun.com/plmm__/article/details/152009834?spm=1001.2014.3001.5502         我在 Github 上也在源项目中提了一个 Issue,既是一封感谢信,也是一份引用通知,希望能为开源社区做贡献。

三、加速效果

        这里的所有实验效果都是没有优化模型的输入尺寸和网络结构本身,和原作者使用相同的 rknn 模型文件和图像输入参数,这样方便观察硬件加速的效果。

方案1:开启多线程

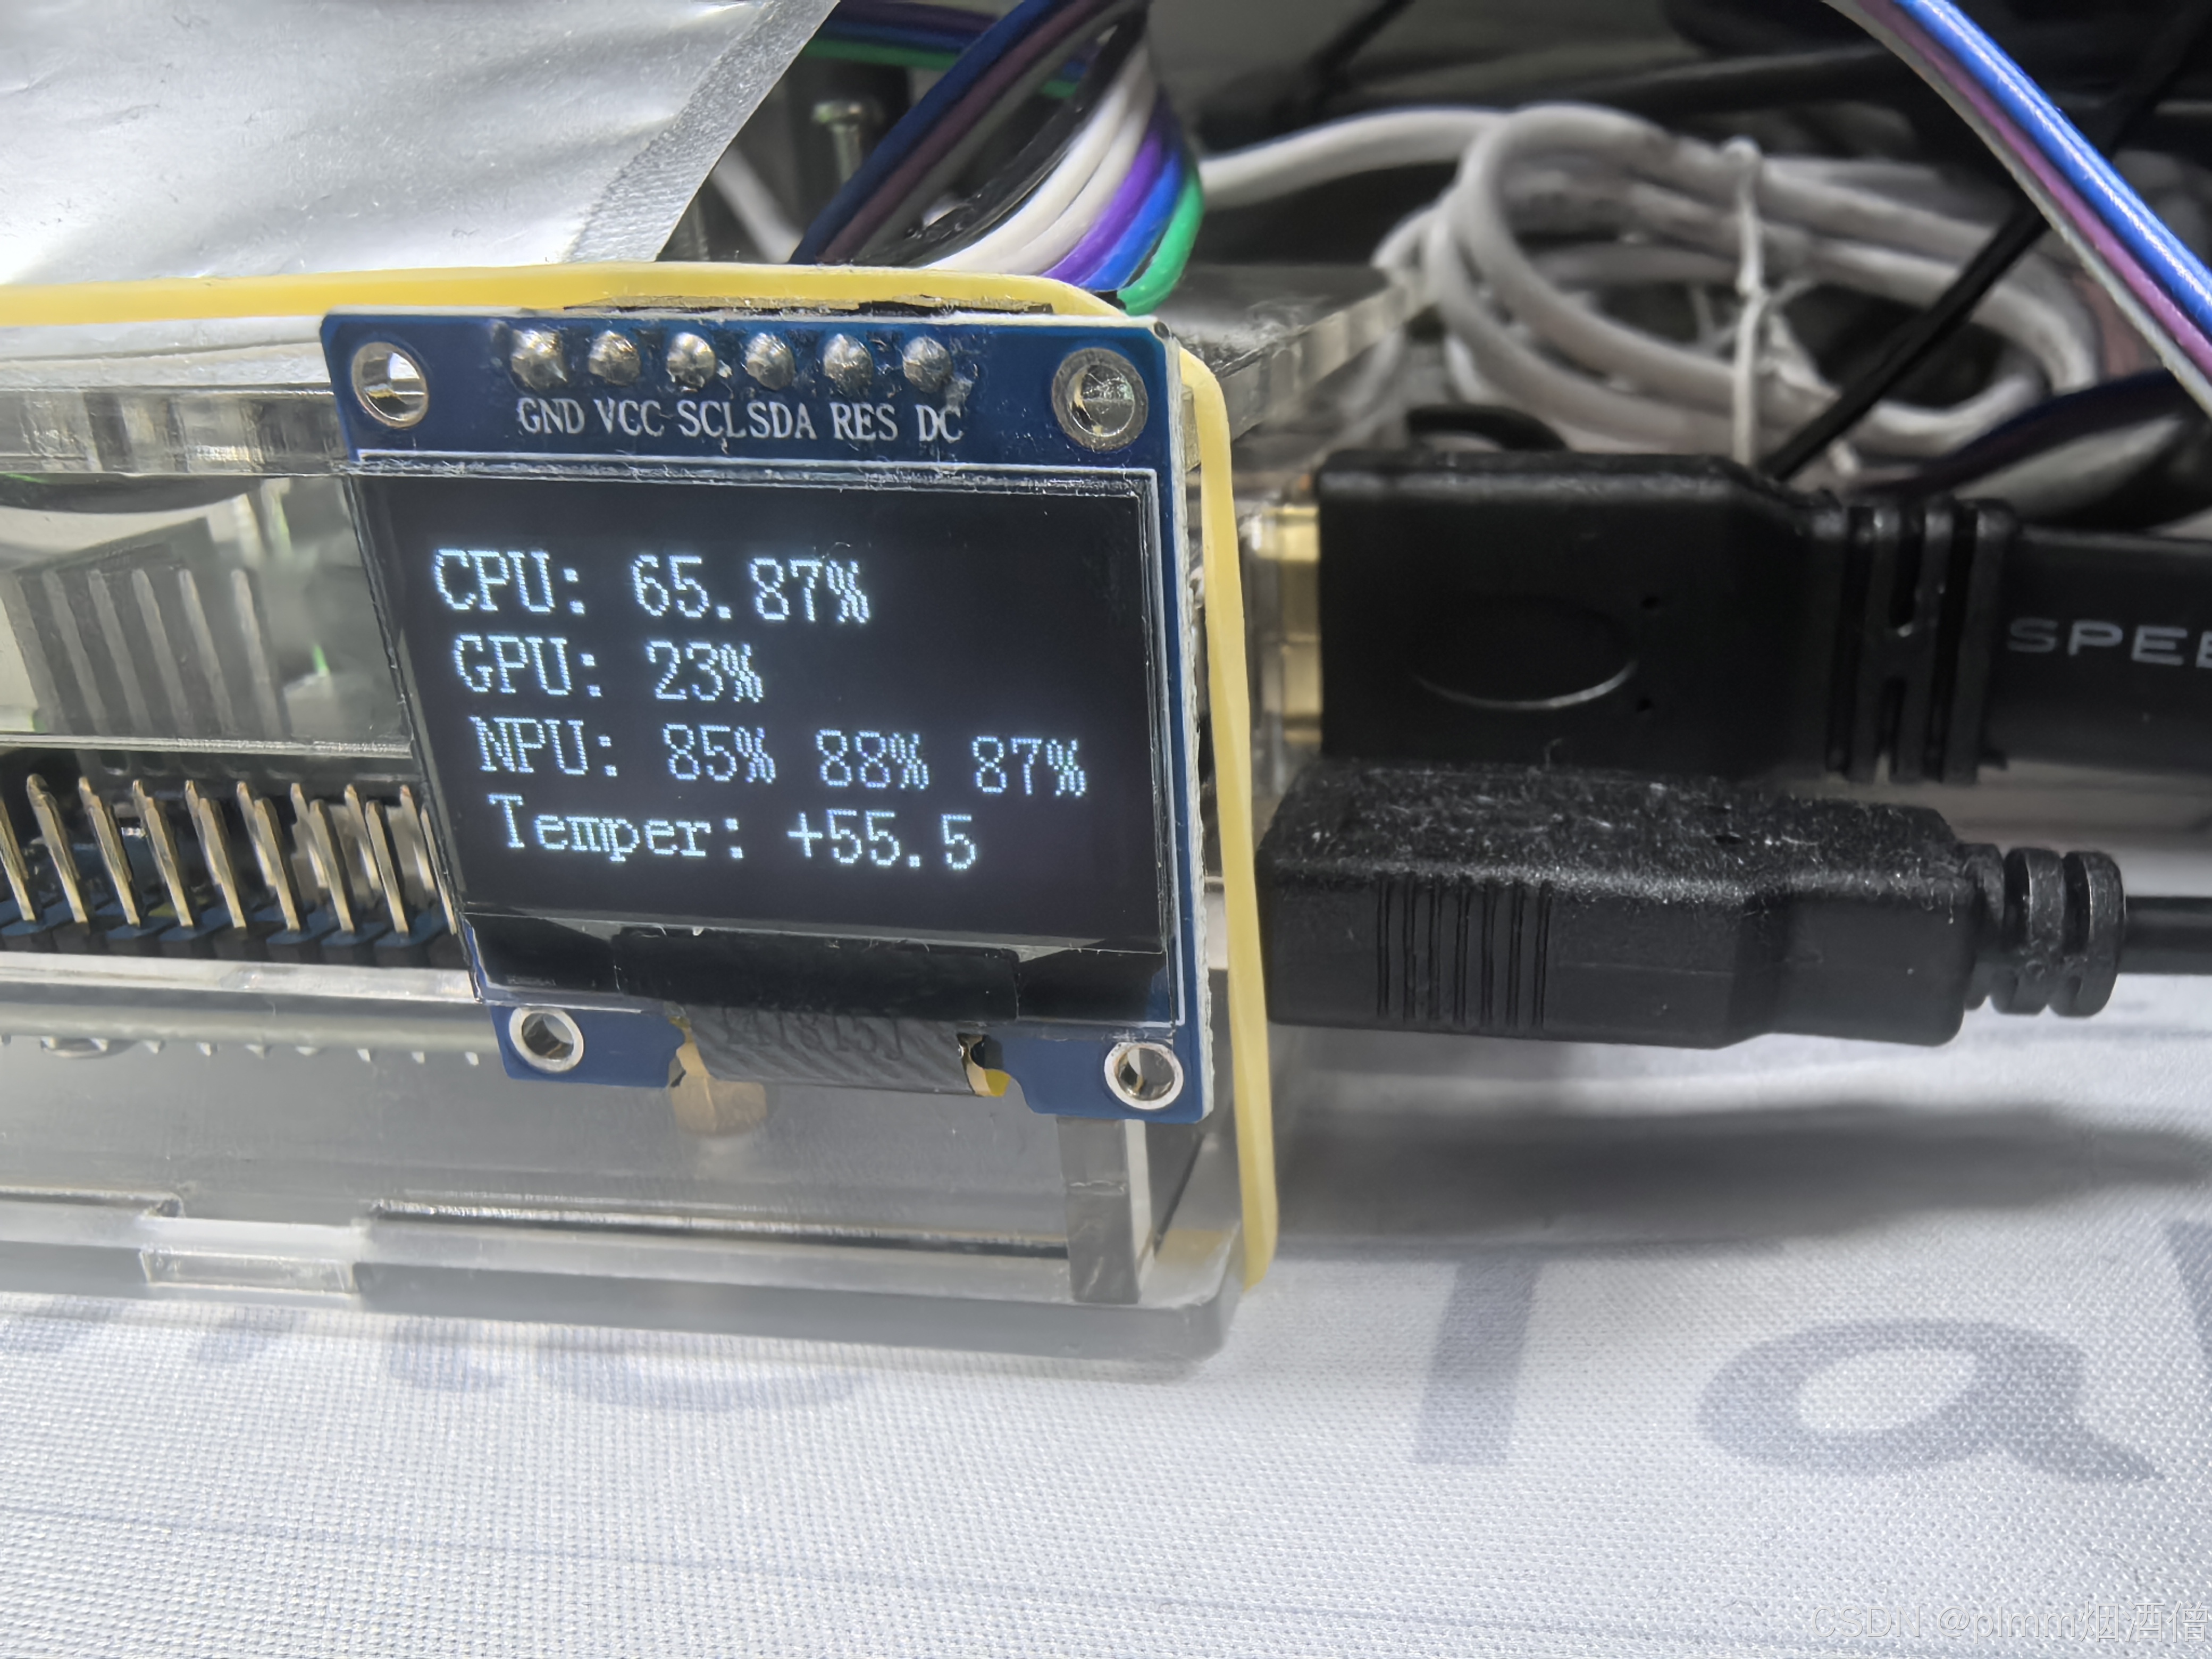
        下面是使用 OpenCV 读取视频,软件 OpenCV 进行图像变换的实拍,以及 CPU、GPU 和 NPU 的占用率:
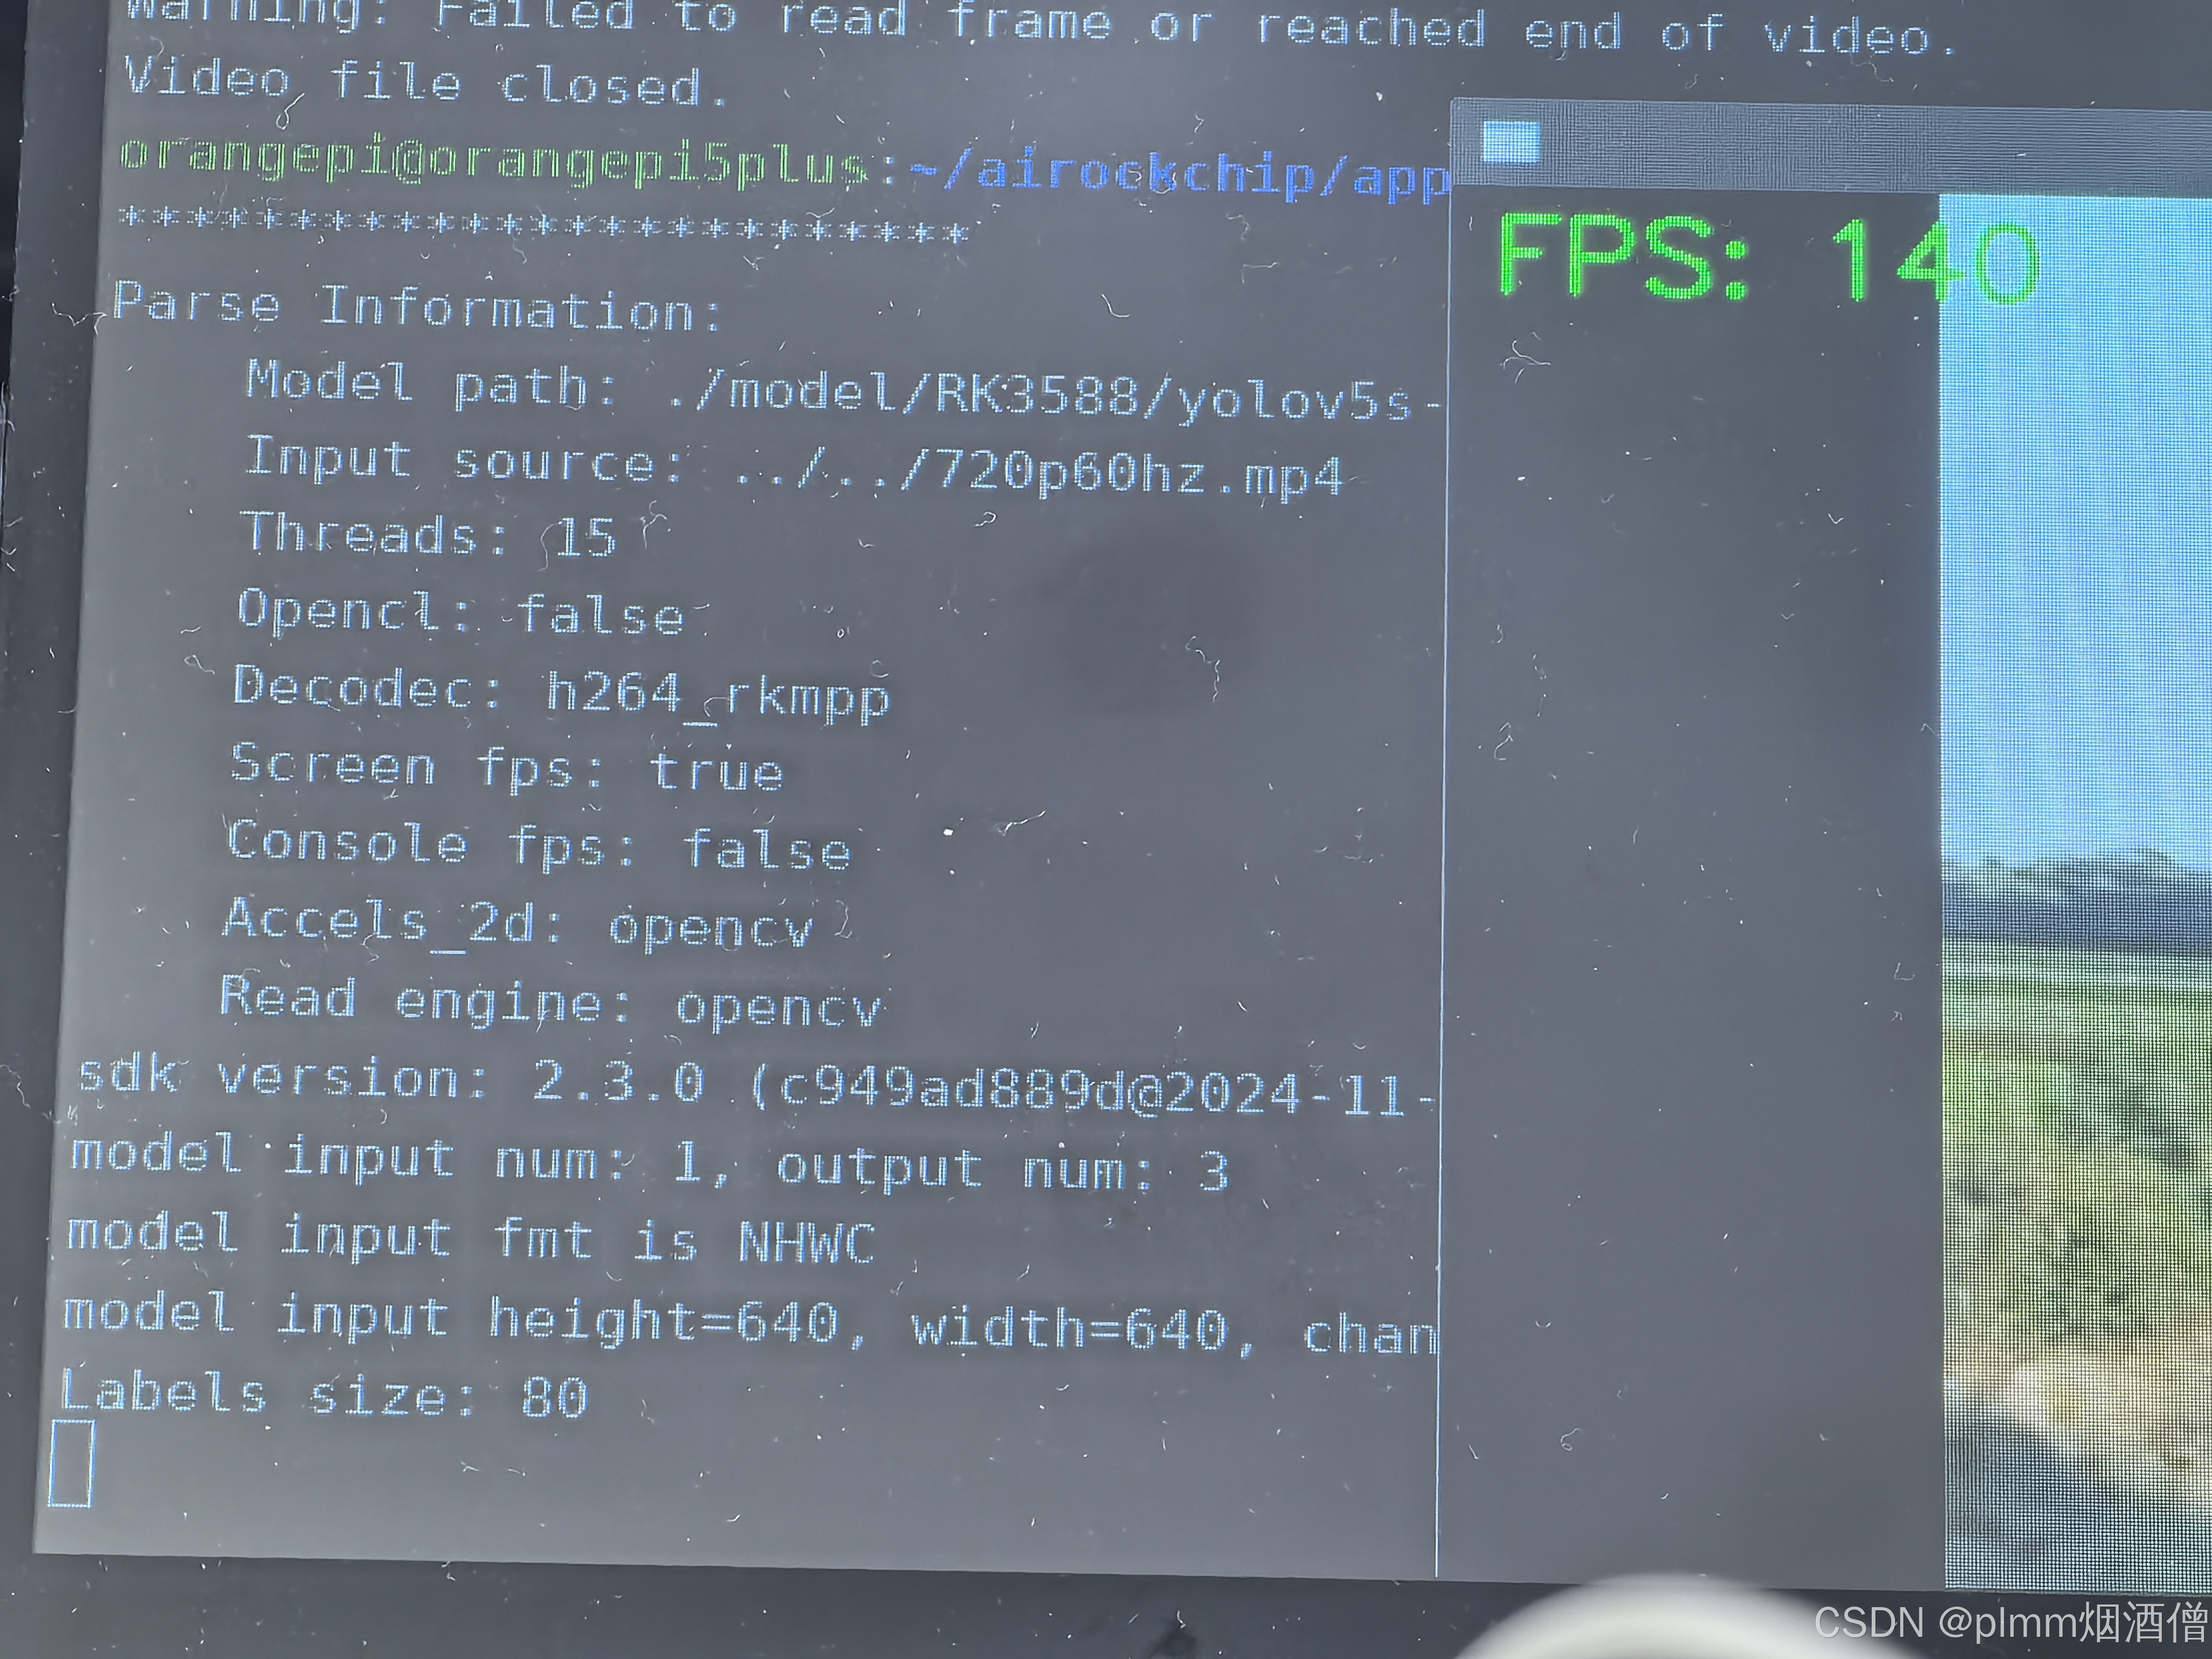
        该情况就是原作者的多线程加速方案,约 141 帧。虽然我的截图中,解码器为 h264_rkmpp,但只要读取视频的方式改为 Opencv,就不会使用到 h264_rkmpp 硬件解码。

        使用 15 个推理线程(继续增加没有明显变化),CPU 利用率 65,NPU 三核占用率 85-88 。另外,开关 OpenCL 对帧率的影响不大,这个在后期wo想深入研究一下 OpenCV 是如何调用 OpenCL 的。

方案2:开启 RKmpp 硬件解码和多线程

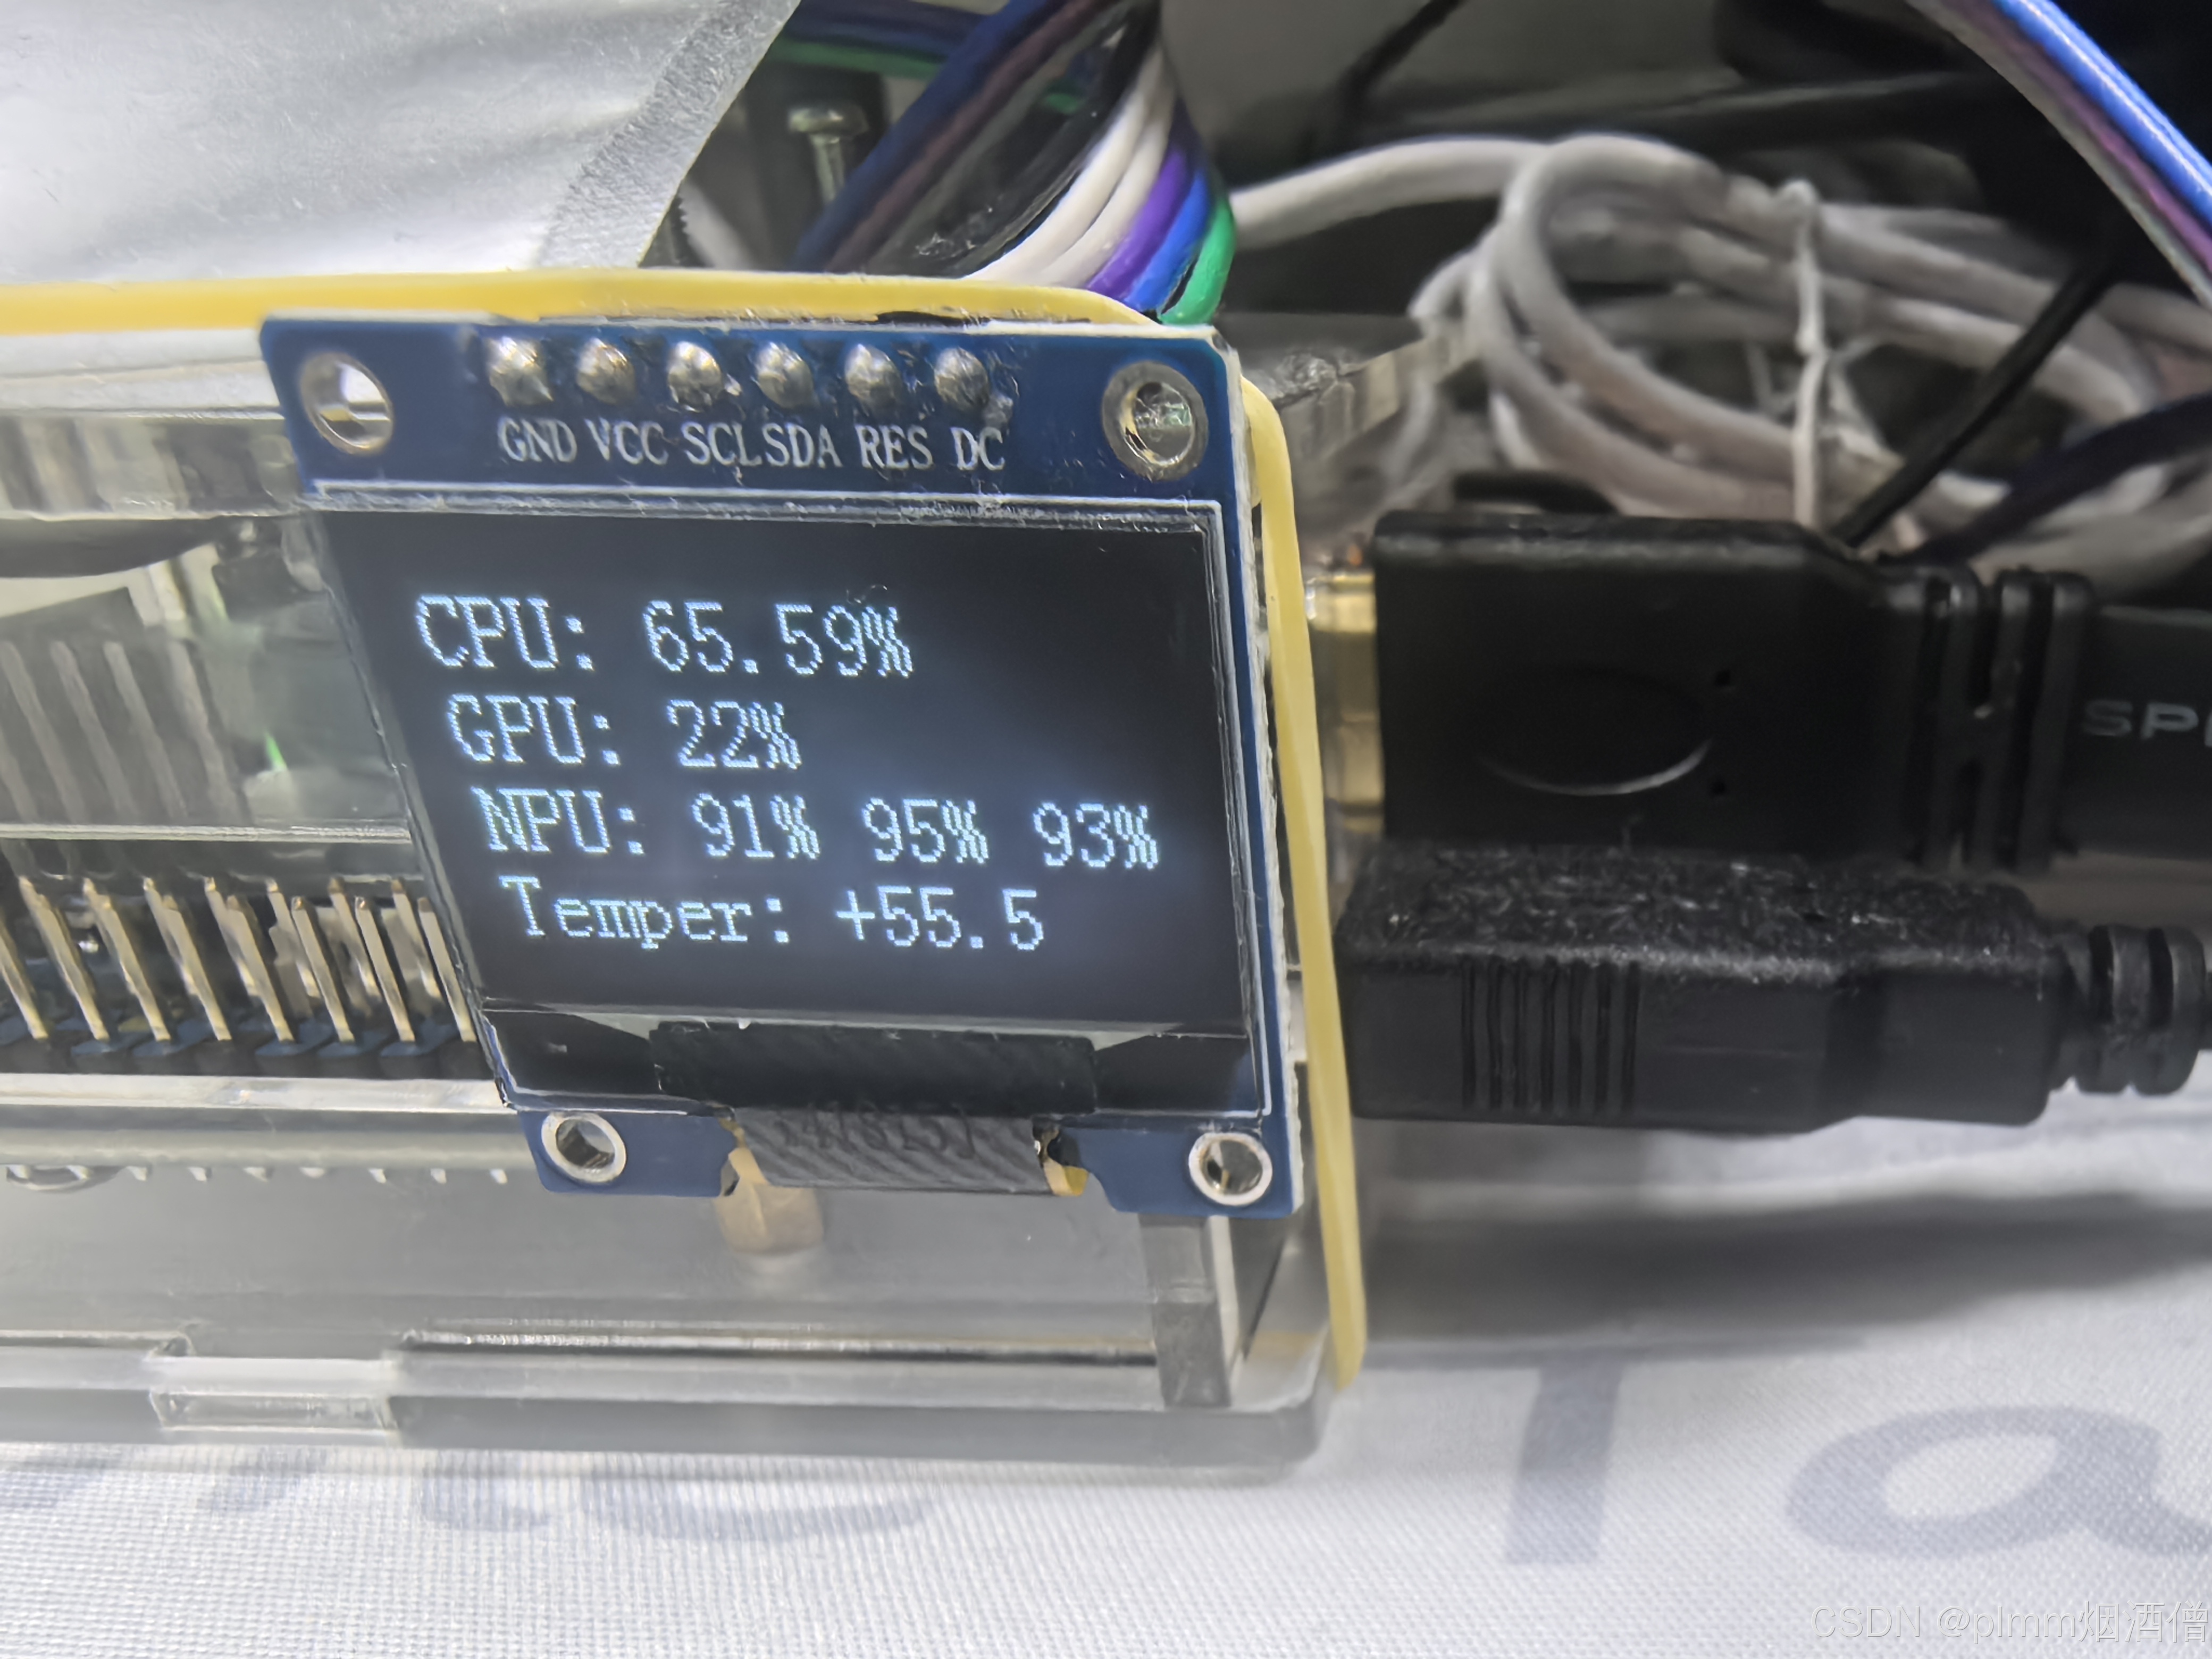
        下面是将 OpenCV 读取视频,更换为 FFmpeg 调用 RKmpp 接口调用 VPU 硬件进行解码的实拍,以及 CPU、GPU 和 NPU 的占用率:
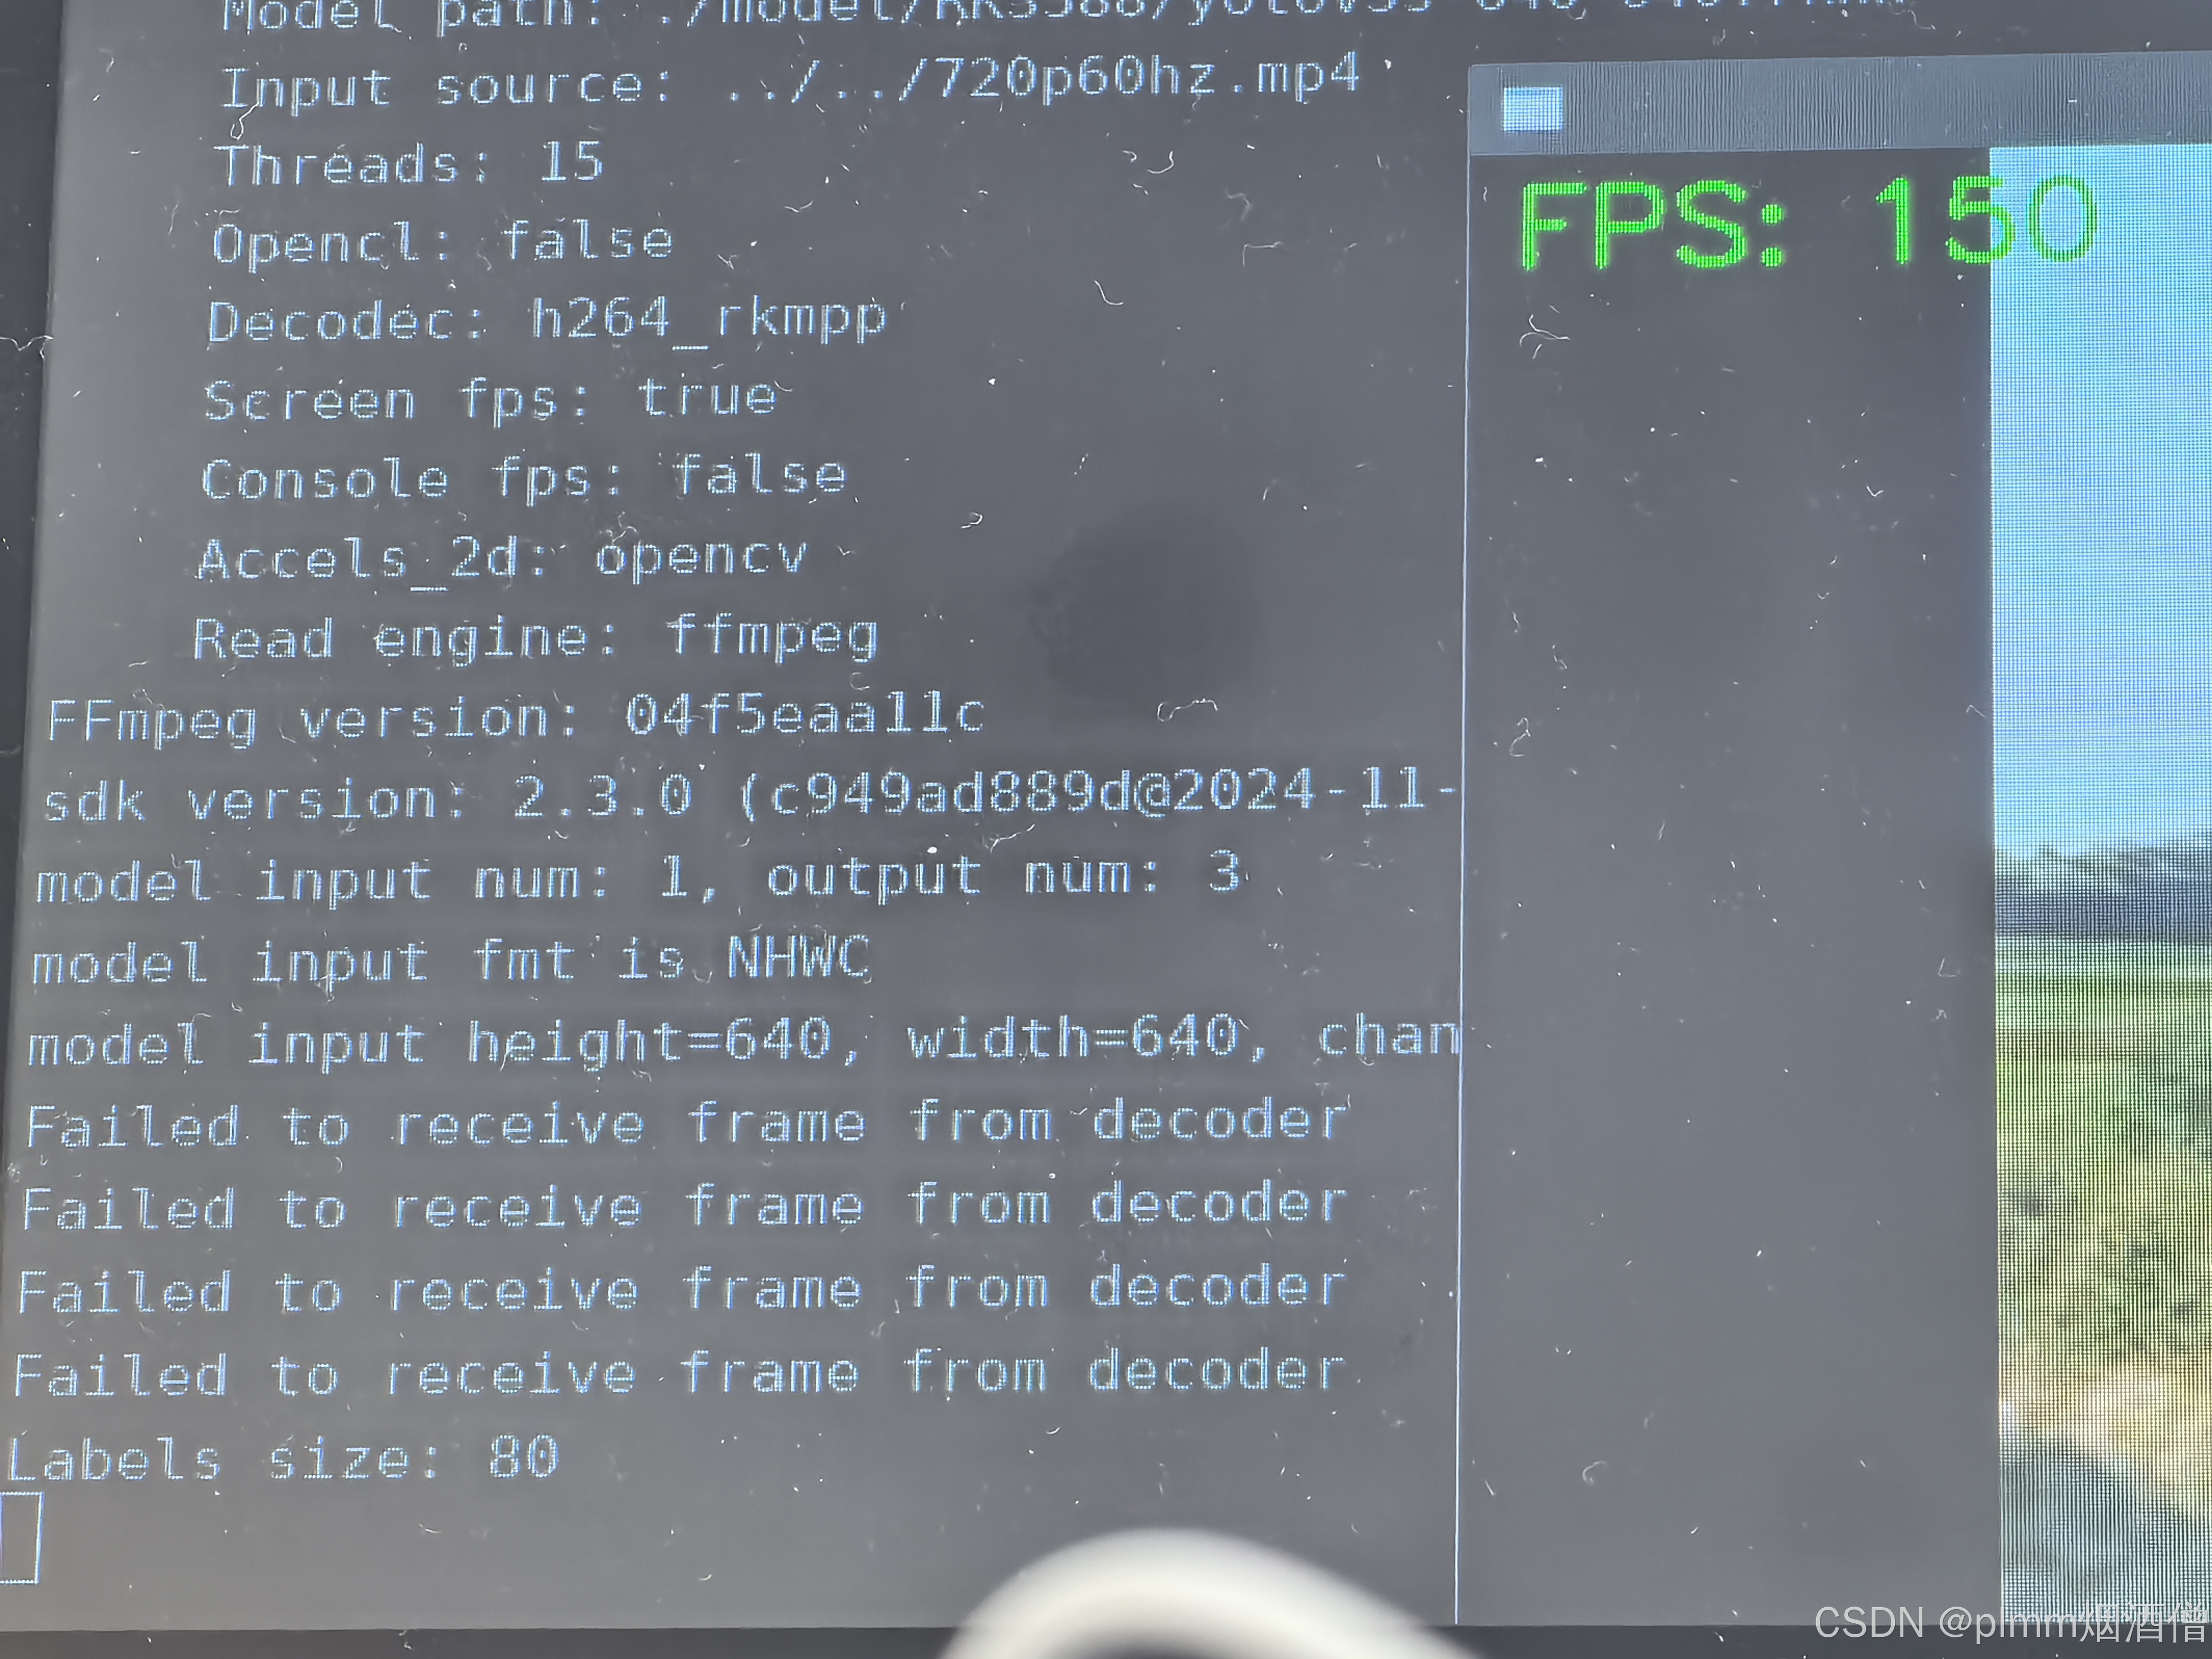
        帧率稳定在 150 帧左右,相比第一个方案提高了 10 帧。

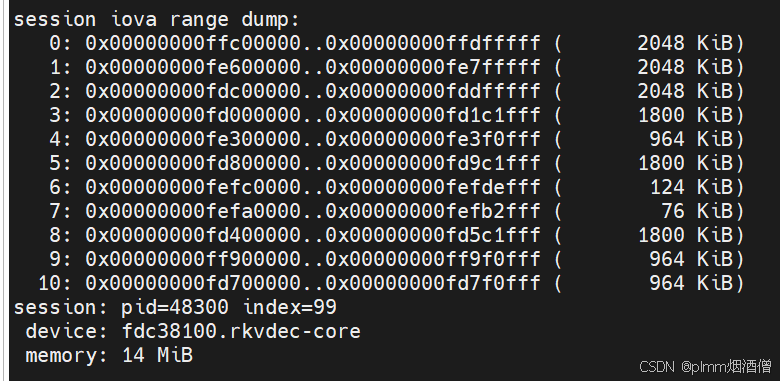
        使用 15 个推理线程(继续增加没有明显变化),CPU 利用率 65,NPU 三核均到 90 以上。VPU 的服务也有 10 个,说明硬件解码正常并且是多线程:
方案3:开启 RGA 加速和多线程

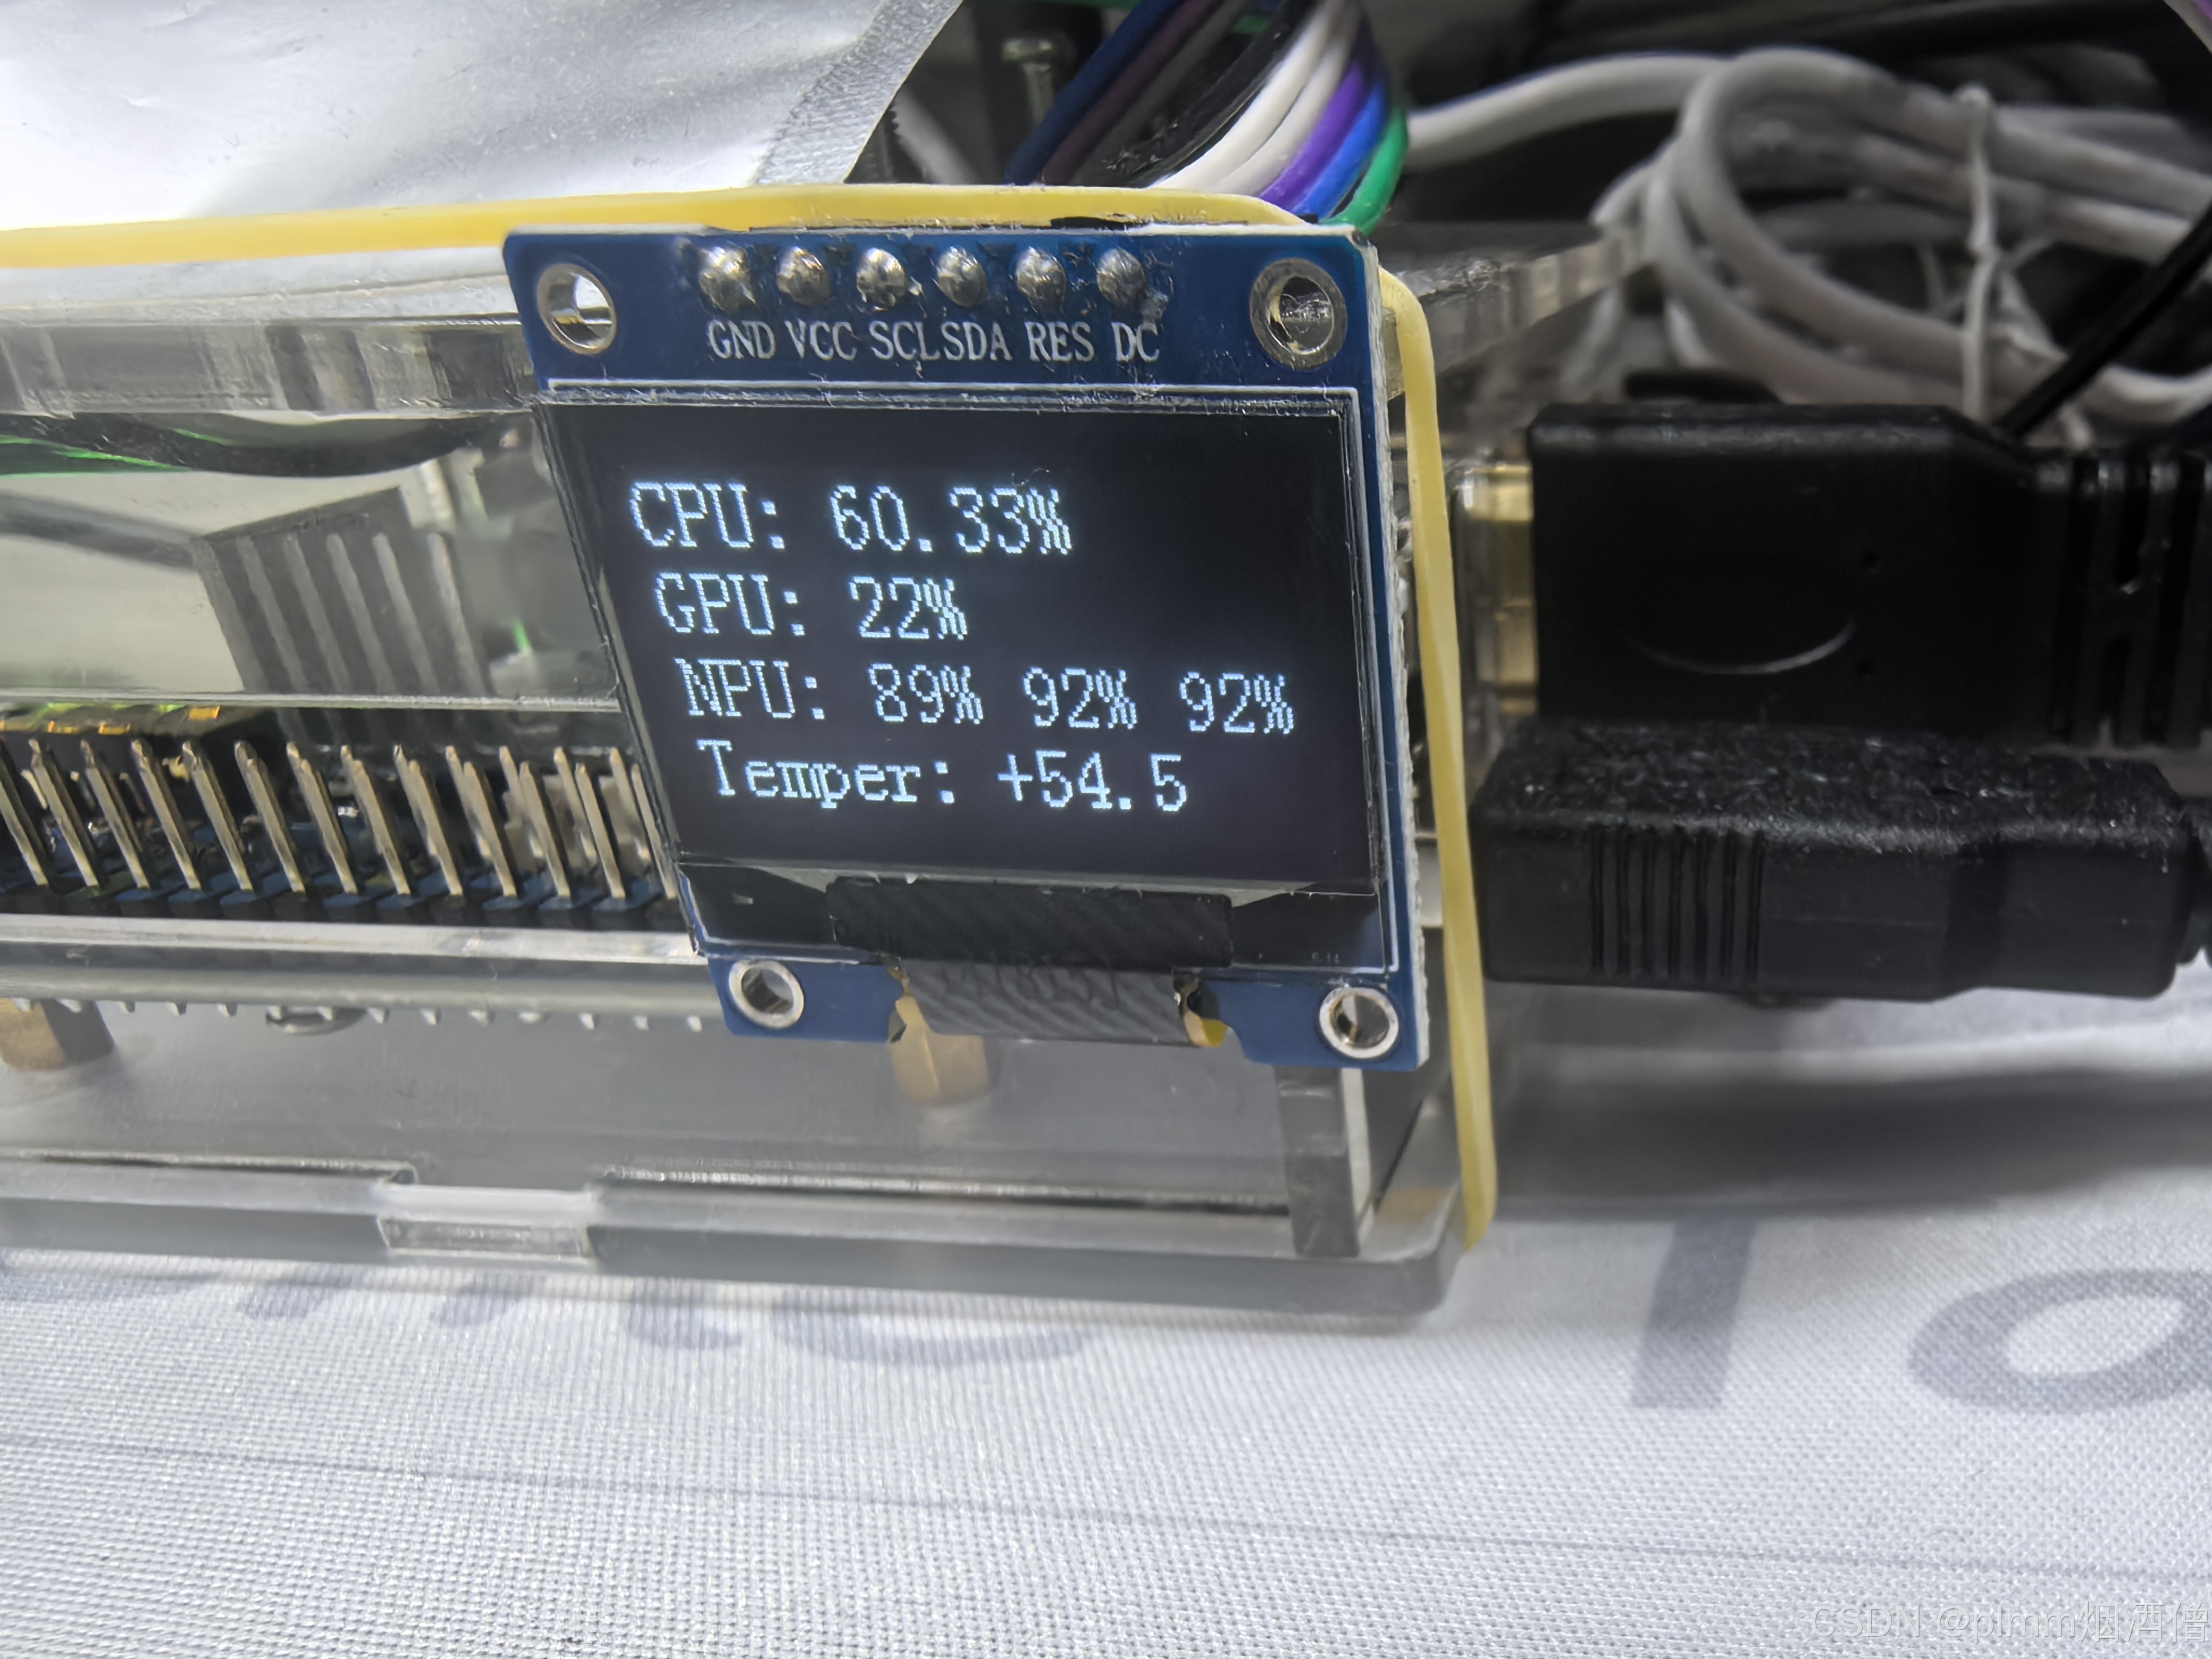
        下面是使用 OpenCV 读取视频,并将图像的格式转换、缩放等图像操作从 OpenCV 更换为 RGA 接口的实拍,以及 CPU、GPU 和 NPU 的占用率:
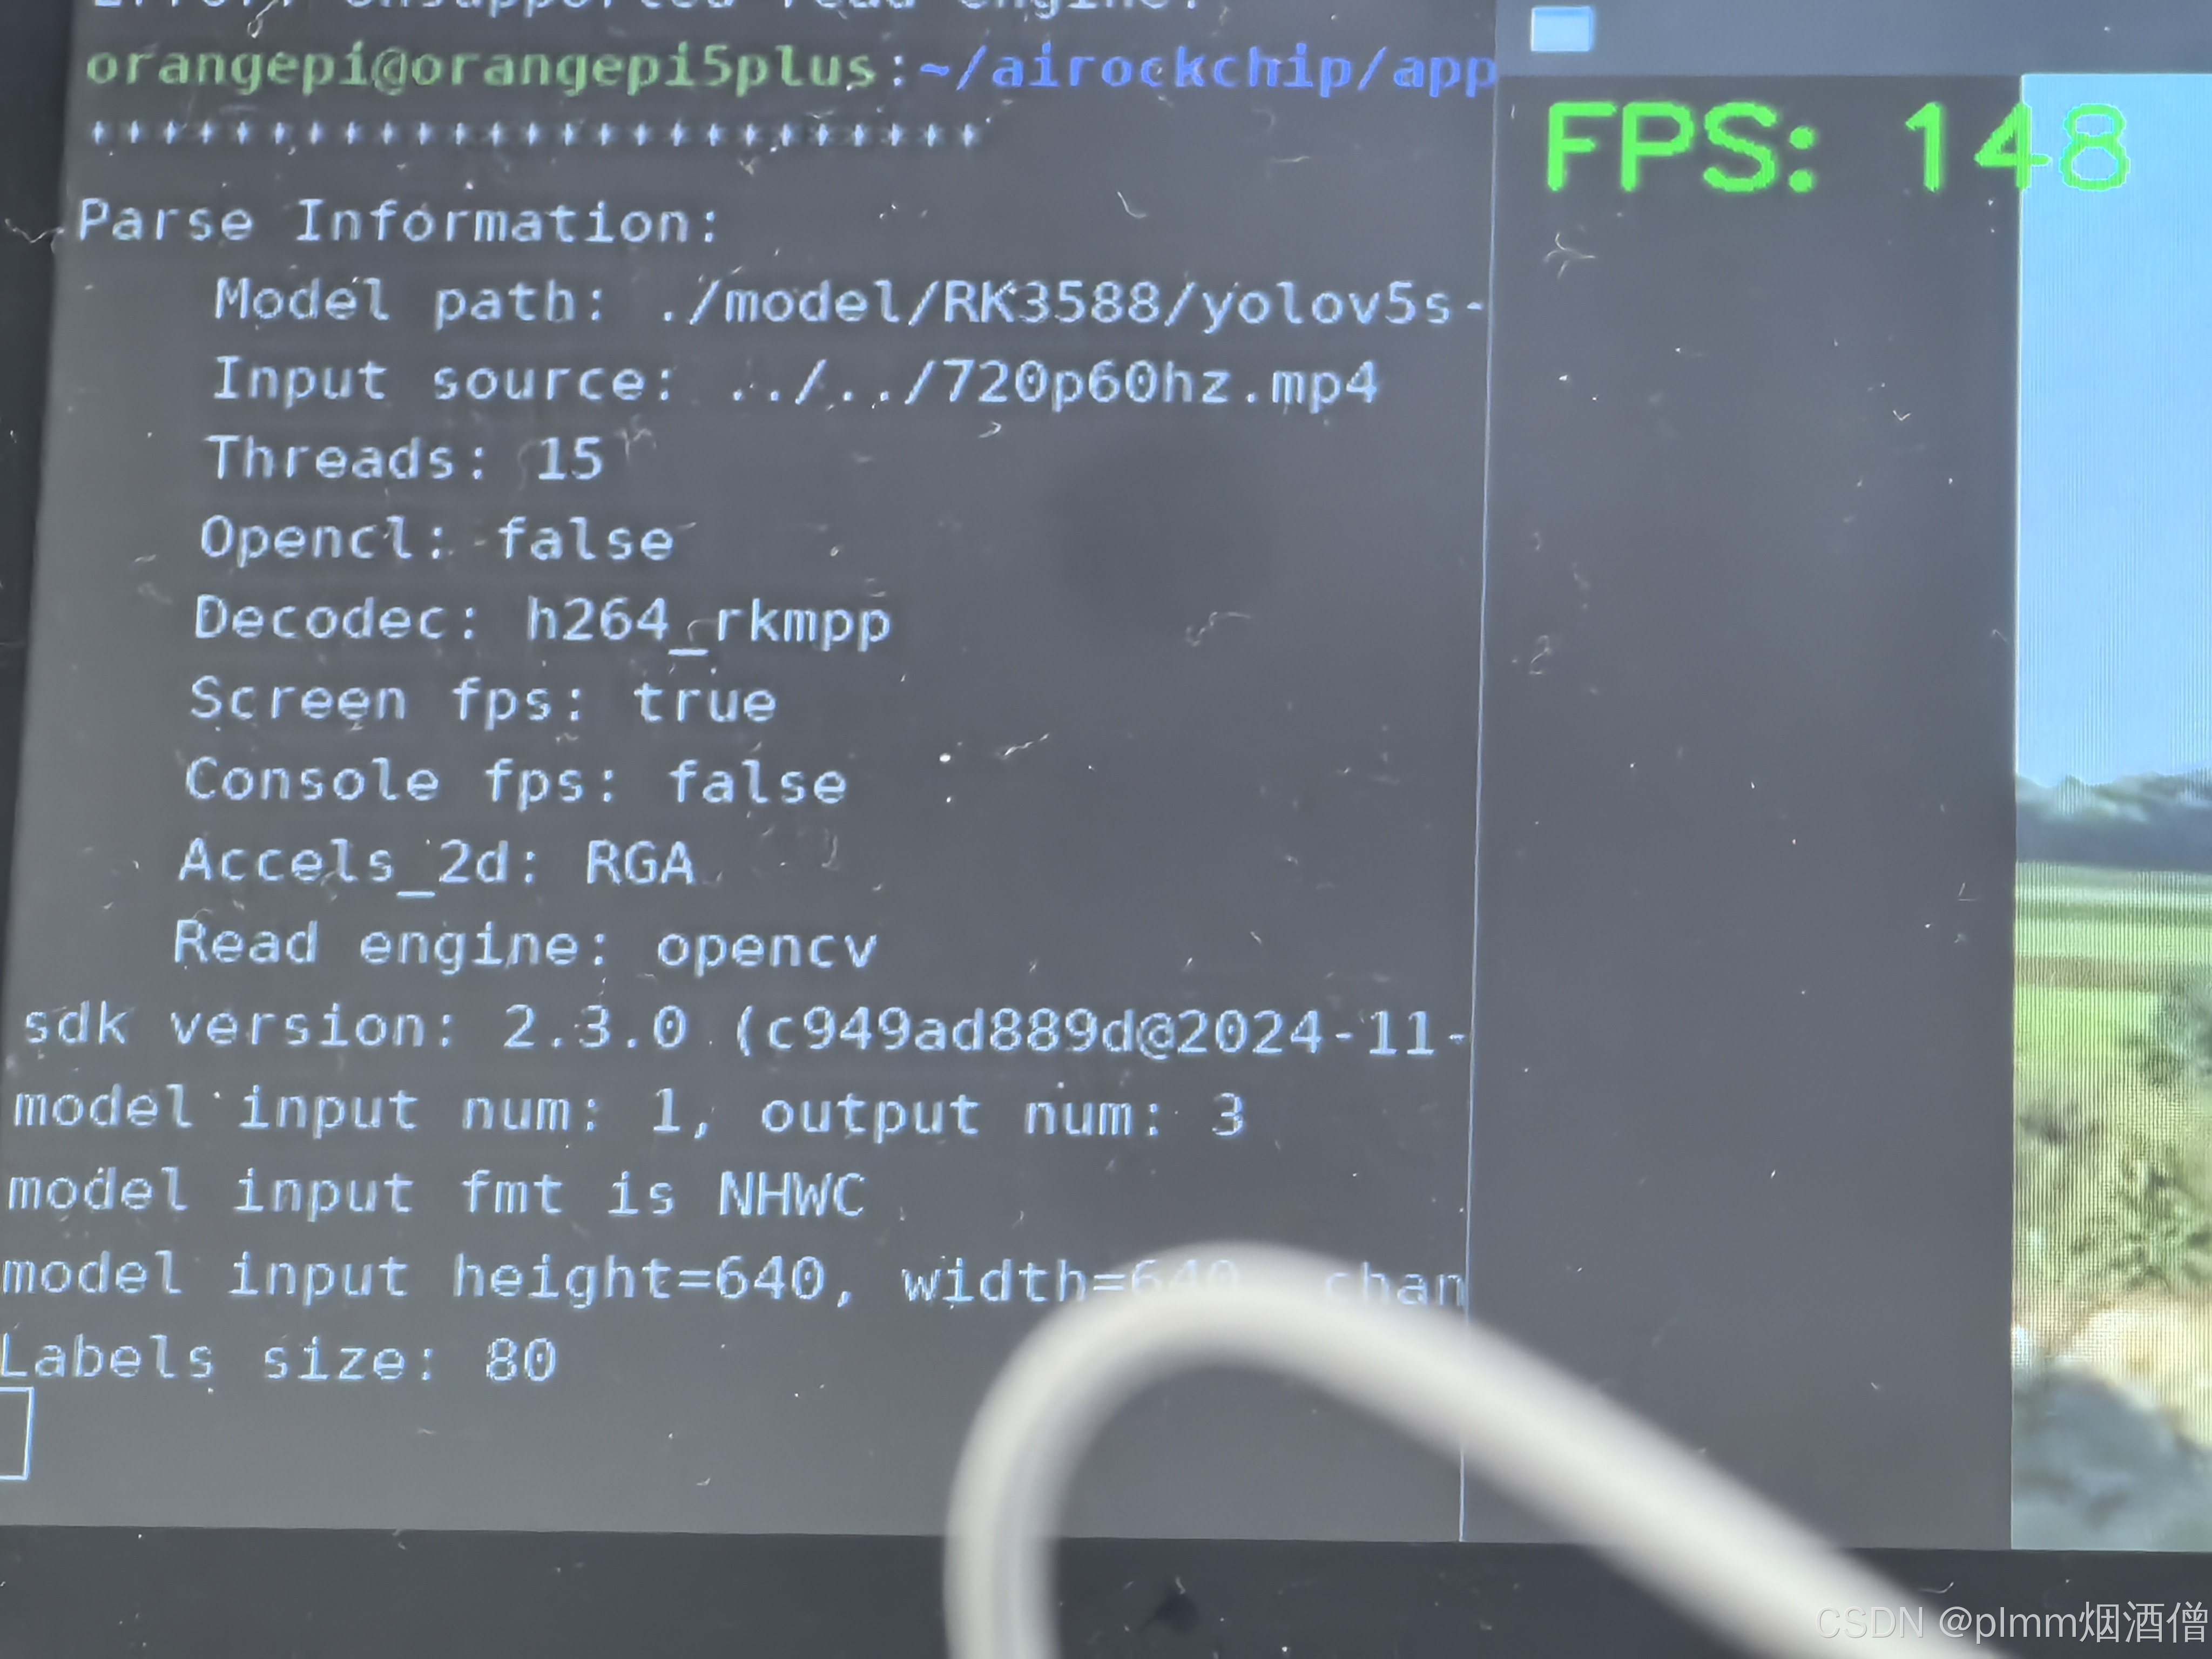
        帧率稳定在 147 帧,最高 148 帧,相比第一个方案提高了 7 帧。

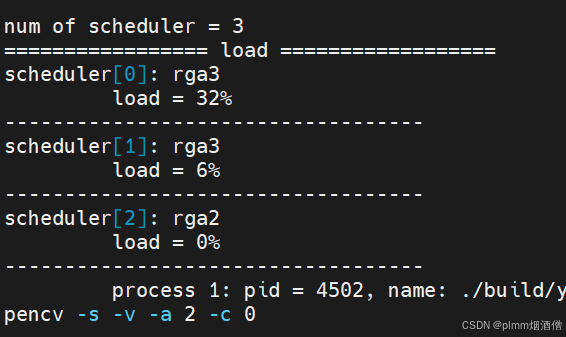
        使用 15 个推理线程(继续增加没有明显变化),CPU 利用率 60,NPU 三核在 90 上下浮动。下面是 RGA 的使用情况:
方案4:开启硬件解码, RGA 加速和多线程

        这个组合方式本应该是最快的方案,但是同时开启硬件解码和 RGA 加速,帧率就下降:

        使用 15 个推理线程(继续增加没有明显变化),帧数稳定在 139 帧左右,反倒是等于没有使用硬件加速,与第一种方案的结果相近。

        不过好消息是,相比于第一个方案,CPU 和 NPU 的占用率都有下降,CPU 占用率下降了约 21 个百分点,NPU 下降约 8 个百分点,这说明方案4的上限还没到,还有优化的空间。下面是 RGA 的使用情况,使用率与之前保持相同:

        第四个实验的具体分析,我准备单独写一篇文章,详细分析我做的对比实验,并讲解设计理念,其中涉及到 RGA 接口的不同实现方式。

在 RK3588 多线程推理 YOLO 时,同时开启硬件解码和 RGA 加速的性能分析-优快云博客https://blog.youkuaiyun.com/plmm__/article/details/146569195?spm=1001.2014.3001.5501

四、结果分析

        前三个实验结果表明,使用硬件加速均能提高 YOLO 在推理过程中的速度。分别使用 RKmpp 和 RGA 在视频读取和前处理时进行硬件加速,比 OpenCV 的软件解码和软件图像操作均有提高。

        希望本项目可以帮助有需要的读者,可以参考并与我讨论,持续优化项目的加速方案。

Gitee链接:

YOLO_RKNN_Acceleration_Program: YOLO multi-threaded and hardware-accelerated inference framework based on RKNNhttps://gitee.com/lrf1125962926/yolo_rknn_acceleration_program

GitCode:

项目首页 - YOLO_RKNN_Acceleration_Program:YOLO multi-threaded and hardware-accelerated inference framework based on RKNN - GitCodehttps://gitcode.com/plmm__/YOLO_RKNN_Acceleration_ProgramGithub链接:

1125962926/YOLO_multi_thread: YOLO multi-threaded hardware-accelerated inference frameworkhttps://github.com/1125962926/YOLO_multi_thread

基于YOLOv5算法实现人数统计和人脸识别并部署于开发板rk3588 YOLO算法在开办板rk3588上部署 阅读详情

相关推荐

香橙派5使用RK3588S内置NPU加速yolov5推理,实时识别数字达到50fps

香橙派5采用了RK3588S,内置的NPU达到了6Tops的算力,博主这里记录一下自己的踩坑过程,好不容易做出来的不能以后忘记了(手动狗头)。这里博主还在B站上发布了效果视频,大家感兴趣的话可以看一下。其中解决了先验框标注位置不对,或者出现非常多的框的问题

weixin_51651698的博客 2万+

rk3588部署yolov5

YOLOv5 训练得到pt文件,pt-->onnx-->rknn进行推理。

qq_59164231的博客 9115

rk3588对npu的再探索,yolov5使用rknn模型推理教程

博主在瑞芯微ITX-3588J-8K的开发板上跑了yolov5目标检测算法,调用了外置相机获取rtsp视频流,但是每帧处理需要833ms左右,和放PPT一样。本来想使用tensorrt进行加速推理,但是前提需要cuda,rk的板子上都是arm的手机gpu,没有nvidia的cuda,所以不能这样适配。那么转过来,使用开发板自带的NPU进行加速推理,岂不是最佳方案,因为它本身就是人工智能开发板,不用NPU相当于没有发挥它的全部能力。.........

振华OPPO的博客世界 2万+

香橙派5 RK3588 yolov5模型转换rknn及部署踩坑全记录 orangepi 5

注意注意!opset一定要为12,不然后面onnx转rknn会报错。weights自己选你训练完成的best.pt,data选你自己设置的,我这里只是做一个最简单情况的演示。

m0_55217834的博客 3万+

在RK3588上实现YOLOv8n高效推理:从模型优化到GPU加速后处理全解析

本文将详细介绍如何通过模型优化、量化压缩和GPU加速后处理等技术,在RK3588上实现YOLOv8n的高效部署。

Hi20240217的博客 3096

YOLO26在RK3588上的RKNN部署实战:从模型优化到板端推理加速

本文详细介绍了YOLO26模型在RK3588芯片上的RKNN部署实战,涵盖环境配置、模型优化转换、板端推理加速等关键步骤。通过量化策略优化和NPU多核并行技术,显著提升模型推理速度,为边缘计算设备提供高效的AI部署解决方案。

melon的博客 1348

基于 RK3588 的 YOLO 多线程推理多级硬件加速引擎框架设计(代码框架和实现细节)

基于 RK3588 的 YOLO 多线程推理多级硬件加速引擎框架设计(代码框架和实现细节)

努力写BUG的博客 2389

在RK3588平台上部署YOLOv5:一步步实现目标检测

rk3588,yolov5

uck2010的博客 1578

在 RK3588 多线程推理 YOLO 时,同时开启硬件解码和 RGA 加速的性能分析

在 RK3588 多线程推理 YOLO 时,同时开启硬件解码和 RGA 加速的性能分析

努力写BUG的博客 4308

瑞芯微RK3588实战:YOLO11模型从零部署到实时推理优化

本文详细介绍了如何在瑞芯微RK3588开发板上从零部署YOLO11模型并进行实时推理优化。通过硬件配置、模型转换、多线程设计、内存优化等关键技术,实现了27FPS的高效推理,适用于边缘计算和智能视觉应用场景。

weixin_29254673的博客 519

瑞芯微RK3588 NPU实战:YOLO11模型端侧部署与实时推理优化

本文详细介绍了如何在瑞芯微RK3588 NPU上部署和优化YOLO11模型,实现实时目标检测。从基础环境搭建、视频流处理到多线程流水线设计,提供了完整的实战指南。通过内存优化、计算加速和系统调优,最终将推理速度提升至38FPS,充分释放RK3588 NPU的6TOPS算力潜力。

weixin_28692817的博客 428

【亲测免费】 RK3588上的Yolo多线程推理演示教程

RK3588上的Yolo多线程推理演示教程 项目介绍 本项目是基于RK3588平台的Yolov8多线程推理演示,由kaylorchen维护。它特别适配于读取视频文件及摄像头输入流,采用轻量级的Yolov8n模型进行文件推理。在理想的条件下,能够实现最高达每秒100帧的推理速度。此项目对于想要在高性能硬件上实施快速目标检测的开发者来说,是个不错的选择。 项目快速启动 步骤一:环境准备 确保你的开发环...

gitblog_01171的博客 1645

RK3588部署YOLO模型 包含模型量化+npu轻量化+ubuntu+RGA图像加速和多线程模型加速 包源码

本专栏为深度学习部署全栈学习体系,包含68篇由浅入深的教程,专为零基础学习者设计。内容涵盖TensorRT与RK3588平台部署技术,包含Jetson系列和RK系列硬件部署实战,采用"理论+源码+实战"三位一体的教学模式。学习路径从基础环境搭建到模型优化、容器化部署、多硬件平台适配,最终掌握工业级AI部署能力。特色包括C++基础教学、Docker容器化、INT8量化、多线程优化等核心技术,并附带YOLOv5、人脸检测、车牌识别等多个实战项目源码。适合算法工程师转部署方向、嵌入式开发者及对

FJN110的博客 3732

【图像算法 - 05】RK3588 部署实战:YOLO11/YOLOv8(det/seg/pose/obb) 毫秒级推理入门(理论精讲 + 代码落地,新手零门槛上手)

RK3588 作为国产化芯片中的佼佼者,在边缘计算和嵌入式设备领域展现出强劲实力。其搭载的四核 Cortex - A76 和四核 Cortex - A55 处理器架构,为深度学习模型的运行提供了坚实的算力支撑。同时,集成的专用 NPU 单元,针对神经网络运算进行了深度优化,能够高效处理 YOLO 系列模型的推理任务,满足实时性要求较高的场景需求。YOLO 系列模型一直是目标检测领域的热门选择, YOLOv11 更是在精度和速度上达到高峰。在国产化芯片 RK3588 上部署这些模型,既能发挥模型的高效检测能力

qq_42910179的博客 4760

RK3588上YOLO系列模型:量化与推理加速的深度探索

本文探讨了瑞芯微RK3588芯片在边缘计算场景下对YOLO系列模型的量化与推理加速优化。通过分析RK3588的硬件特性(8nm制程、四核Cortex-A76/A55 CPU、Mali-G610 GPU和6TOPS NPU)与YOLO模型架构演进,详细介绍了INT8量化原理及使用rknn-toolkit2工具的实现过程。研究提出硬件加速(NPU/GPU协同)与软件优化(模型剪枝、知识蒸馏、多线程调度)相结合的方案,实验表明优化后的YOLOv8s模型帧率提升120%至220FPS,推理时间缩短55%至4.5ms

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 588

RK3588实战:YOLOv8多线程推理框架高效部署之路

边缘计算环境下,AI模型的高效推理依赖于硬件算力与软件框架的协同优化。RK3588作为高性能边缘SoC,集成6 TOPS NPU,为轻量级目标检测模型提供充足算力。在多线程推理架构中,通过生产者-消费者模型将视频采集、预处理、推理与后处理流水线化,可有效避免数据阻塞。针对YOLOv8模型,利用RKNN工具链完成量化转换,并结合RGA硬件加速预处理、INT8输出与零拷贝技术,显著降低CPU负载,将单路视频检测帧率提升至100帧。该方案适用于视频文件与摄像头输入,为边缘AI应用提供可复用的工程参考。

weixin_29055699的博客 288

【RK3588部署yolo】优化加速+推拉流篇

如何在RK3588部署yolo优化加速,看这一篇就够了!!

qq_51568251的博客 3431

分子动力学模拟学习1-采用AmberTools21的MCPB.py构建金属蛋白的top文件

分子动力学模拟学习1-采用AmberTools21的MCPB.py构建金属蛋白的top文件

weixin_45011386的博客 3827

[RT-DETR边缘部署(4)]RK3588上的前后处理与多线程推理

本文探讨了RT-DETR模型在RK3588嵌入式设备上的高效部署方案。重点分析了前后处理的关键技术:前处理需严格对齐量化参数,建议采用RGA硬件加速;后处理方面,RT-DETR采用匈牙利算法替代传统NMS,输出300个最优预测框,显著提升密集目标检测性能。针对NPU利用率低的痛点,提出多线程异步推理框架,通过流水线并行将CPU预处理与NPU推理重叠执行。实验表明,该方案在保持精度的同时,显著提升了嵌入式设备的实时检测性能。

weixin_65585850的博客 846

学习STM32的流体水位传感器

引言: 流体水位传感器是一种常用于测量液体水位的设备,广泛应用于水位监测、液位控制和流量计量等领域。STM32是一款功能强大的单片机,具有丰富的外设和灵活的编程能力,非常适合用于流体水位传感器的开发。本文将介绍如何使用STM32开发板与流体水位传感器进行连接和通信,并通过编写代码实现水位的测量和显示。五、总结: 通过以上的代码示例,我们可以实现使用STM32开发板与流体水位传感器进行连接和通信的功能。三、编写代码: 以下是使用STM32CubeIDE编写的示例代码,实现了读取流体水位传感器的功能。

xiaoalla的博客 740

双目视觉三维重构(一)————简介

优快云中关于立三维重构的介绍层出不穷,CNKI中也有各类综述对三维重构进行总结,撰写这篇博客仅作为本人对该类博客、论文的总结学习,加深自身学习的印象、作为学习的笔记。如有错误的地方,欢迎指正。   1、三维重构 1.1、三维重构到底是什么?   首先要了解立体匹配算法,首先要知道立体匹配算法主要具体应用于什么方向。 三维重构又被称为三维重建,百度百科中对它的定义为:指对三维物体建立适合...

qq_39634612的博客 1万+
上一篇: 瑞芯微 RKrga接口 wrapbuffer_virtualaddr 使用笔记
下一篇: 基于 RK3588 的 YOLO 多线程推理多级硬件加速引擎框架设计(代码框架和实现细节)
plmm烟酒僧
博客等级 码龄6年 611粉丝 115原创
评论 33
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

plmm烟酒僧

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值