2000-2025年地级市国家信息消费试点政策DID

地级市-环境保护31个指标(2000-2024年) 摘要:该研究整合了2000-2024年中国297个地级市的环境保护数据(7426条记录),涵盖29个核心指标,包括空气质量、工业三废排放、绿色专利、碳交易等六大维度。数据来源于官方统计年鉴、空气质量监测点和国际数据库,提供原始数据、线性插值和回归填补三个版本。这套系统化的数据集支持城市环境演变分析、环保政策评估和区域差异研究,为"双碳"目标下的环境治理决策提供科学依据,适用于学术研究、政策制定和企业绿色转型等多个领域。 阅读详情

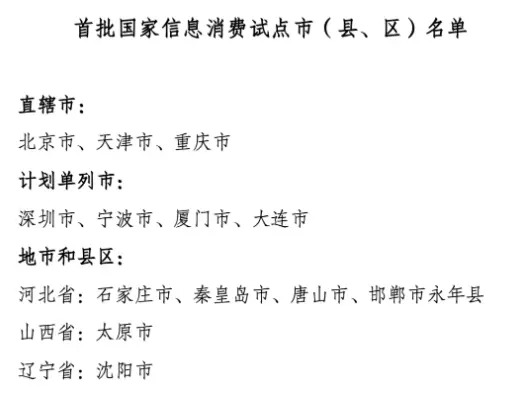
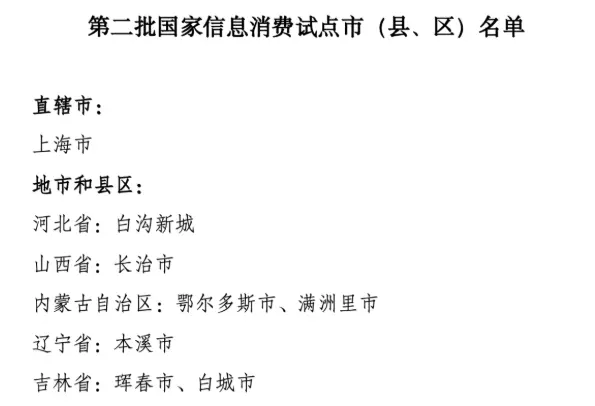
2013年,国务院印发《关于促进信息消费扩大内需的若干意见》,将推动信息消费、有效拉动需求、催生新的经济增长点提上日程。为落实这一部署,工业和信息化部按照"先试点、后示范"的原则启动了国家信息消费试点城市建设,并于2013年、2015年分两批共遴选出104个试点市(县、区):首批68个(北京市等,2013年确定),第二批36个(上海市等,2015年确定)。

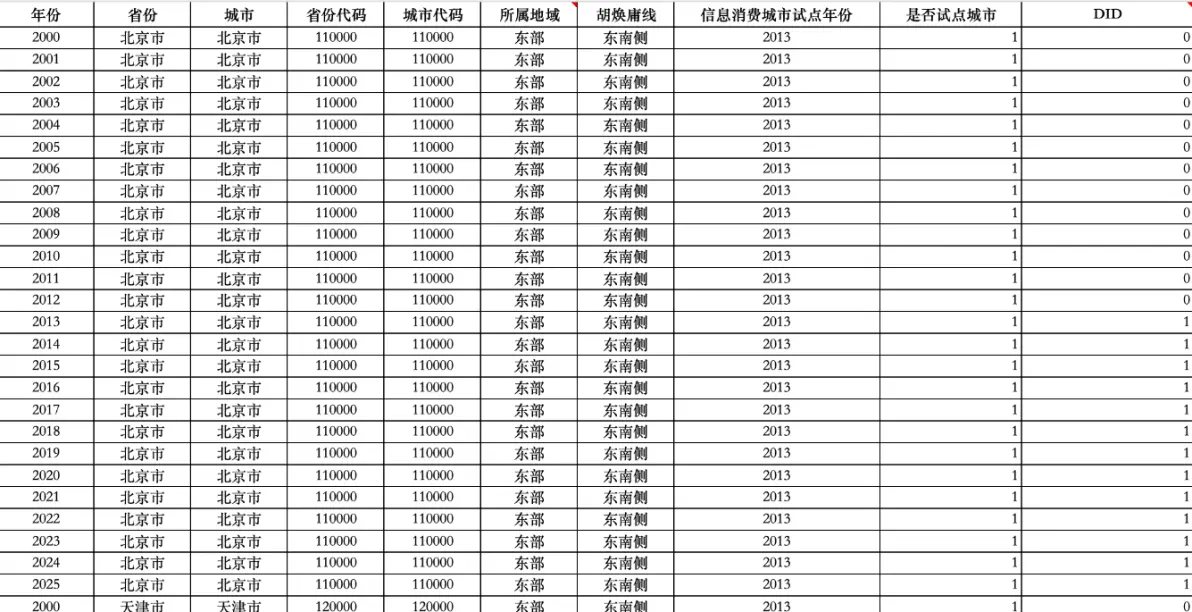
由于试点名单的确定时点外生于单个城市的经济表现,这场分批推进的试点为研究数字消费政策的因果效应提供了理想的准自然实验场景。这套数据将两批试点名单映射到城市面板上,生成了2000—2025年、覆盖297个地级以上城市的信息消费试点政策DID处理变量,共7722条观测(恰为297城 × 26年)。

政策变量与配套控制变量

政策处理变量(DID):若某城市在某年被确定为信息消费试点城市,则该城市自当年起各年份均赋值为1,否则为0。在引用该设计的文献中,这一核心解释变量也被记作 didsx——本质上是一个虚拟变量,识别变异完全来自"是否入选试点 × 入选前后"的组间—时序差异。

已有基于该准自然实验的实证研究通常配套如下城市层面控制变量,可供复现参考:
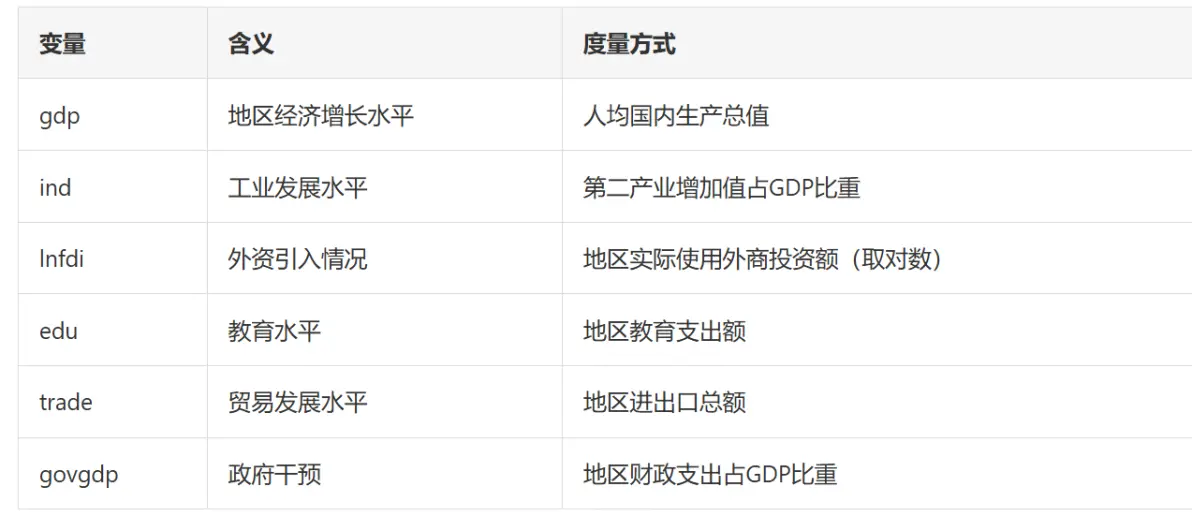
数据参数一览
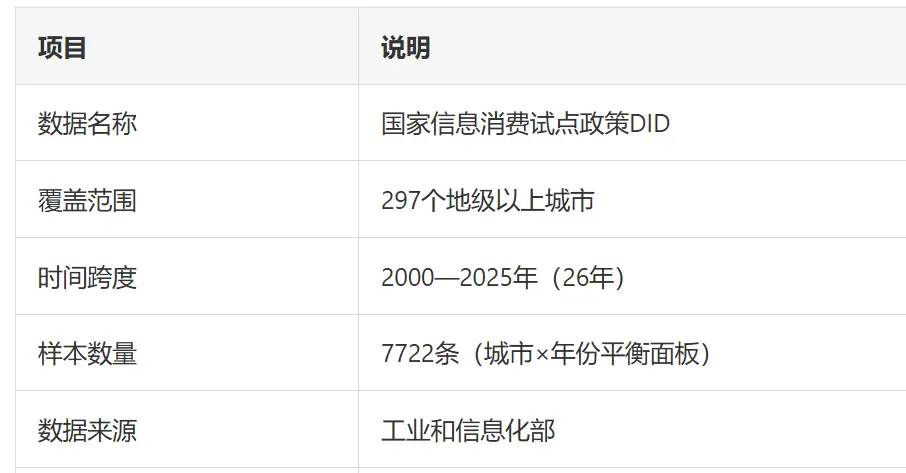
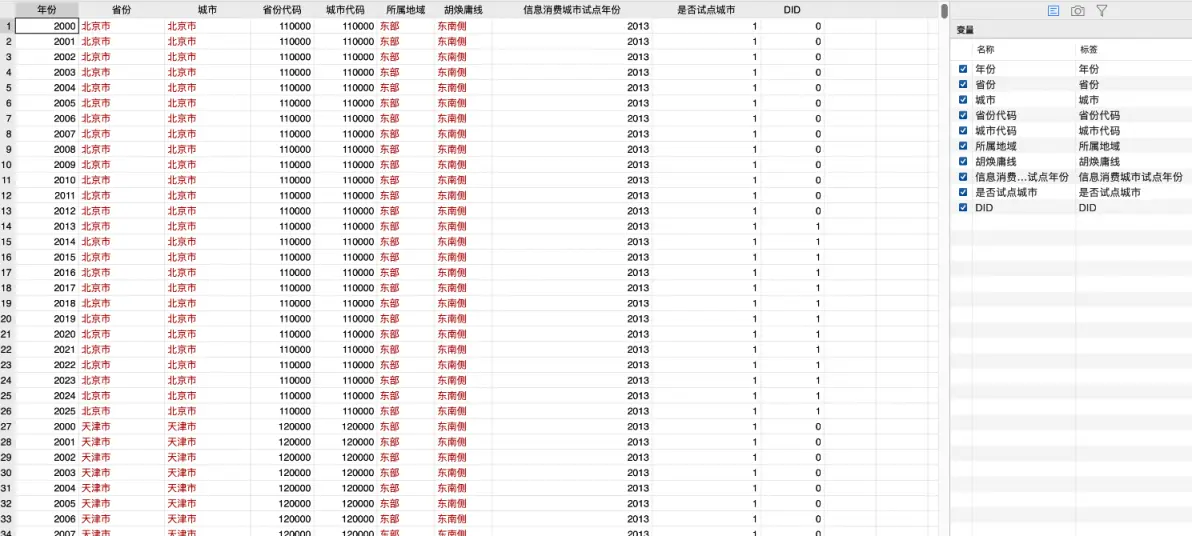
字段共10个:年份、省份、城市、省份代码、城市代码、所属地域、胡焕庸线、信息消费城市试点年份、是否试点城市、DID。其中"所属地域"区分东、中、西部,"胡焕庸线"标注城市位于该线东南侧或西北侧,两者均为常用的异质性分析分组维度。

1.首批国家信息消费试点市(县、区)名单
2.第二批国家信息消费试点市(县、区)名单
3.国家信息消费试点政策DID-Excel格式
4.国家信息消费试点政策DID-Stata格式

数据来源:工业和信息化部(试点名单公开文件)

引用格式:茹慧超, 邓峰. 数字消费的经济增长效应:机制探索与中国经验——来自国家信息消费试点的准自然实验[J]. 中国流通经济, 2023, 37(11): 61-75.

顶部专栏分享更多内容

专栏合集:经管社科数据集合与整理

来源: Paper 数据分析

SpringBoot+Vue+MySQL 高校学科竞赛平台 完整可运行版(源码+文档) 本项目基于SpringBoot+Vue+MySQL构建高校学科竞赛管理平台,覆盖学生、教师、领队教师、管理员四大角色,实现竞赛发布、报名、刷题、评分、公示等全流程闭环管理。系统架构清晰,技术主流,配套完整源码、数据库脚本、万字论文、开题报告、答辩PPT及部署文档,支持一键运行,适用于毕业设计、课程设计及院系二次开发,真正实现“开箱即用”。 阅读详情

相关推荐

机器学习 线性回归 头歌实训

第1关:简单线性回归与多元线性回归 第2关:线性回归的正规方程解 第3关:衡量线性回归的性能指标 第4关:scikit-learn线性回归实践 - 波斯顿房价预测

weixin_57270536的博客 1万+

2000-2024年地级市信息消费试点政策数据DID

工信部于2013年、2015年分两批次遴选出104个信息消费试点城市:2013 年确定北京市等68个城市为首批国家信息消费试点市(县、区);2015年确定上海市等36个城市为第二批国家信息消费试点市(县、区)并于2016年印发了《2016年国家信息消费示范城市建设指南》,将北京、上海、大连等25个城市作为信息消费示范城市。[4]刘毛桃,方徐兵,应望江.数字化消费与新质生产力发展:来自国家信息消费试点政策的证据[J].当代财经,2025,(01):111-125.数据名称:信息消费试点政策DID。

paperdata666的博客 607

Vscode搭配Keil Assistant插件,头文件红色波浪线终极修复指南

本文详细解析了Vscode搭配Keil Assistant插件时出现头文件红色波浪线问题的根源,即ARMCC与ARMCLANG编译器的兼容性问题,并提供了三种实用解决方案:复制文件夹、创建符号链接和手动配置includePath,帮助开发者彻底修复错误,恢复代码跳转和自动补全功能。

q1w3e5r7t9y的博客 352

银发经济,超热!中国县域人口高龄化系数数据!

国家信息中心(2024)从政策支持、财富储备、服务体系、社会环境及银发经济五个维度构建包含53项指标的评价体系,证实城市能力指数与经济发展水平正相关,并识别青岛、北京等城市在服务体系建设中的示范效应。此外,该数据集还能为企业和投资者提供参考,辅助银发经济产业布局、适老化产品开发及长期护理保险等领域的战略规划,同时助力政府前瞻性应对人口结构转型带来的社会挑战。涵盖上市公司、省份、地级市、专精特新等研究对象,涵盖经济、法律、金融、政策、科技、文化、健康、环保、人口等各类热点数据。数据格式为Excel形式。

ppmandata的博客 867

VC中基于TWAIN协议控制扫描仪-----初级版

PS:本人是C++小白一枚,在研究此功能时不知走了多少弯路

a1101000099的专栏 8789

银河麒麟arm64 V10 SP1桌面系统高效部署onnxruntime推理环境实战

本文详细介绍了在银河麒麟arm64 V10 SP1桌面系统上高效部署onnxruntime推理环境的完整实战流程。从系统环境准备、关键依赖安装,到onnxruntime的安装验证,并以YOLOv5模型部署为例进行性能对比分析,提供了在国产化飞腾D2000平台上进行AI边缘推理的实用指南和避坑技巧。

ss78901的博客 636

中国人口高龄化系数(2000,2010,2020)

中国人口高龄化系数数据集(2000-2020)摘要 该数据集完整收录了2000、2010、2020年三次人口普查中全国各区县65岁及以上、80岁及以上人口数据,并计算得出高龄化系数(80+/65+比值)。采用标准化矩阵面板格式,涵盖省份、城市、年份等核心指标。数据来源可靠,经人工校验,适用于老龄化趋势研究、公共政策制定及银发经济分析。现有研究显示,中国老龄化呈现"东高西低"特征,青年人口迁移、社区服务设施等因素显著影响区域差异。该数据为量化分析政策效应(如智慧养老试点提升服务匹配度12.

2501_91959248的博客 525

目标检测 RT-DETR(2023)详细解读

在使用了这个技巧后,显然训练过程中,类别的标签不再是此前的0和1离散值,而是0~1的连续值。关于 Query Selection(查询向量选择),大家应该并不陌生,这个方法可谓在DETR领域大杀四方,如DAB-DETR对查询向量进行重构理解,将其解释为Anchor,DN-DETR通过查询降噪来应对匈牙利匹配的二义性所导致的训练时间长的问题,DINO提出从Encoder中选择Top-k特征进行学习等一系列方法,这都无疑向我们证明,查询向量很重要,选择好的Query能够让我们事半功倍。在RT-DETR中,

qq_51352130的博客 5869

Java EE 进阶:8.MyBatis 操作数据库(入门)(第一弹)

Java EE 进阶:8.MyBatis 操作数据库(入门)(第一弹)

要努力去发光,而不是被照亮~ 140

4、海洋哺乳动物运动能量学:潜水与生存的奥秘

本文深入探讨了海洋哺乳动物在潜水与运动中的能量消耗机制,涵盖其生理反应、代谢成本、节能行为策略及测量方法。通过分析不同物种的能量利用特点,揭示了它们如何在极端水下环境中维持能量平衡,并讨论了该研究在保护生物学、生态系统动态和动物健康管理中的实际意义。文章还展望了未来多学科交叉、长期监测及应对环境变化的研究方向,为理解海洋哺乳动物的生存奥秘提供了系统性视角。

p5l2m9n4o6q的博客 116

SAP SEGW 事物码里的 Function Import

开放数据协议(OData)包括标准的 CRUD (创建、检索、更新和删除)操作,这些操作映射到 HTTP 方法的 POST、GET、PUT/MERGE 和 Delete 几类。此外,OData还支持进一步的服务操作:,这些操作可以由HTTP方法GET或POST调用,用于处理不能映射到标准 CRUD 操作的任何内容。通过在数据模型中创建 ,可以在 service Builder 中实现此类额外的服务操作。例如,您可以为以下自定义操作创建函数导入:Work Item confirmation检查航班的可用性虽然

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 995

Spring Boot 数据源与 MyBatis(-Plus) 自定义配置详解

本文详解 Spring Boot 中单数据源环境下 HikariCP 与 MyBatis-Plus 的自定义配置。通过手动声明 SqlSessionFactory,实现下划线转驼峰、日志输出、一级缓存策略等精细化控制。结合 HikariCP 核心参数调优(如最大连接数、连接生命周期),确保高性能与稳定性。适用于仅需访问单一数据库的场景,避免多数据源复杂性,兼顾性能与可维护性。

BADAO_LIUMANG_QIZHI的博客 205

DeepSeek R1-32B医疗大模型的完整微调实战分析(全码版)

【代码】DeepSeek R1-32B医疗大模型的完整微调实战指南(全码版)

AllenLV的博客 5103

Docker Compose:搭建本地多服务开发环境

从一个 Java API、PostgreSQL 和 Redis 开始,配置服务名、端口、环境变量、健康检查、数据卷和依赖关系。理解 Compose 文件如何被解析、项目如何隔离,以及哪些数据不能依赖“重建容器”保留,能够把个人开发环境整理成团队可复用的启动入口。

m0_62221377的博客 462

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 419

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

数据库主键选型指南:BIGINT vs VARCHAR

主键选型关乎数据库性能与架构演进。BIGINT(如雪花算法)在顺序写入、二级索引开销和分布式生成上优势显著,适合高并发核心链路;而传统 VARCHAR UUIDv4 因随机性导致频繁页分裂、存储膨胀,性能堪忧。UUIDv7 通过时间戳有序性实现高效追加写入,结合 BINARY(16) 存储可兼顾性能与安全,成为现代微服务新选择。关键在于:主键应稳定、无业务含义,优先选用趋势递增的紧凑类型,并根据场景合理采用双主键模式或 ULID 等替代方案。

小李同学的博客 305

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

【基于 WebSocket 的多用户网页五子棋】—— 数据管理模块

但行好事,莫问前程

qq_42996461的博客 218

自动化运维选型:四条技术路线的能力边界,以及它们为什么不能互相替代

自动化运维怎么选型?拆解配置管理、基础设施即代码、作业调度与场景化编排四条技术路线边界,分析账本归属与时间语义差异,给出四种架构组合与判断点,帮企业看清为何不能互相替代。

trainsignalcn的专栏 340

C++算法(七)

C++ stack算法题和一些客观题

2503_94479566的博客 374

不用再为文本搜索单独维护一套系统!全文检索深度解析

为了给商品、客服工单或者企业知识库增加一个搜索框,企业往往需要在业务数据库之外,再部署一套Elasticsearch。数据库保存商品、订单和用户等真实业务数据,搜索引擎保存另一份文本索引;两套系统之间,还需要通过CDC、消息队列或者同步程序持续传输数据。一个看似简单的搜索需求,最后可能变成两套集群、两份数据和一条必须保持稳定的数据链路。由此产生的问题并不少:数据库已经完成更新,搜索结果却可能尚未同步;业务查询同时涉及文本、库存、权限和订单状态时,应用需要在两个系统之间来回组合结果;

TiDB 社区干货传送门 277

IDEA 简介:从零认识 IntelliJ IDEA

IDEA 全称,是由 JetBrains 公司开发的一款主流 Java 集成开发环境(IDE)。它集代码编辑、编译、调试、测试、版本控制、构建管理等功能于一体,被大量 Java 开发者视为日常开发的首选工具。所谓 IDE(Integrated Development Environment,集成开发环境),就是把写代码所需的各类工具整合到同一个界面中。相比只用文本编辑器加命令行编译,IDE 能显著减少重复操作,让开发者把精力集中在业务逻辑上。

ztI10的博客 159

市场调查与统计分析专业大学期间考证怎么安排?

市场调查与统计分析专业的考证规划,适合从一份完整的调查报告倒推:能不能设计问卷、判断样本是否合理、清洗数据,再把分析结果转化为业务建议?围绕这条能力链安排证书,比单纯按“热门程度”报名更有针对性。结合2026年的学习安排,并为2027年的实习、升学和求职预留时间,大学期间可以重点考虑六类证书:全国计算机等级考试证书、大学英语四级或六级成绩报告单、CDA数据分析师、初级统计专业技术资格证书、微软办公软件国际认证中的Excel相关证书,以及软考数据库系统工程师资格证书。

cc572502653的博客 164

Oracle 19c 在线重定义后旧表空间清理及 ASM 存储资源回收 SOP

Oracle 19c 在线重定义后旧表空间清理与 ASM 存储资源回收 SOP

「YYL DBA手记」 数据库 · 架构 · 运维 · 实战 yyldba.blog.youkuaiyun.com 497

大表 ALTER TABLE 怎么做?NineData OnlineDDL 配置与执行实践

介绍NineData OnlineDDL大表变更实践,涵盖执行策略、切表控制、拷贝批次与可视化进度追踪。

dbasenewbie的博客 273

MySQL报Too many open files?句柄耗尽的排查与参数配置

文章讲清 max_connections 与 open_files_limit 两个额度、句柄被谁占走、分区表为什么最容易踩,给出从 error log 到 /proc/pid/limits 的定位顺序与句柄预算算法。

「一个在数据库赛道上边学边分享的学妹」——聚焦国产数据库/信创方向、分享学习笔记、踩坑经验和行业观察。 318

从事件风暴到因果收敛:Mopheus多智能体协同事件触发架构与防循环实践

在构建生产级多智能体协同引擎的过程中,我们总结了三条核心工程准则:1.不可变因果链优于事后关系反查在高度并发且异步的多智能体网络中,因果关系的追溯绝不能依赖事后查库反查关联;将只增的因果祖先链显式封装在事件载荷与任务上下文中,以O(1)的内存检查实现确定性极高的闭环防范。2.生产端纯粹广播与消费端前置极速过滤是高吞吐的基石遵循严格的Pub/Sub模式,让核心业务实体与下游智能体编排解耦;通过调度层内存条件字典求值(conditions),在纳秒级内过滤掉99%的无关事件,保障零业务侵入与极高的系统吞吐。

weixin_54551388的博客 242
上一篇: 2014-2025年各省市大数据管理机构改革DID
下一篇: 2000-2025年上市公司碳排放权交易试点DID面板数据+stata代码
Paper數据分析
博客等级 码龄2年 3477粉丝 1817原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值