Kafka集群的安装与配置(一)

Kafka 集群部署 Kafka_集群部署:搭建ZooKeeper集群、搭建Kafka集群、测试Zookeeper和Kafka集群 阅读详情

apache-zookeeper-3.5.8-bin.tar.gz

jdk-8u391-linux-x64.tar.gz

kafka_2.12-3.0.0.tgz

测试服务器一核2GB

服务器 安全组开放端口9092,3888,2181,2888

一、安装JDK


JDK官网下载地址:https://www.oracle.com/java/technologies/downloads/#java18

1、在usr目录下新建Java目录,然后将下载的JDK拷贝到这个新建的Java目录中1

创建目录命令:mkdir /usr/java

2、进入到Java目录中解压下载的JDK

解压命令:tar -zxvf jdk-18_linux-x64_bin.tar.gz

在1主机上,将安装包分发到其他机器

scp -r  /opt/jdk1.8/ node2:/opt/

3、设置环境变量

设置命令:vim /etc/profile

输入上面的命令后,shift+g快速将光标定位到最后一行,然后按“i”,再输入下面代码

#set java environment
JAVA_HOME=/opt/jdk1.8
CLASSPATH=$JAVA_HOME/lib
PATH=$PATH:$JAVA_HOME/bin
export PHTH JAVA_HOME CLASSPATH

#zookeeper
export ZOOKEEPER_HOME=/opt/zookeeper-3.5.8
export PATH=:$ZOOKEEPER_HOME/bin:$PATH

#KAFKA_HOME
export KAFKA_HOME=/opt/kafka
export PATH=$PATH:$KAFKA_HOME/bin

填写完代码后按ESC键,输入“:wq”保存并退出编辑页面

4、输入下面命令让设置的环境变量生效

生效命令:source /etc/profile

5、验证JDK是否安装成功java

验证命令:Java -version

二、安装Zookeeper


Zookeeper集群搭建指的是ZooKeeper分布式模式安装。通常由2n+1台server组成。这是因为为了保证Leader选举(基于Paxos算法的实现)能过得到多数的支持,所以ZooKeeper集群的数量一般为奇数。

Zookeeper运行需要java环境,所以需要提前安装jdk。对于安装leader+follower模式的集群,大致过程如下:

配置主机名称到IP地址映射配置
修改ZooKeeper配置文件
远程复制分发安装文件
设置myid
启动ZooKeeper集群
如果要想使用Observer模式,可在对应节点的配置文件添加如下配置:

peerType=observer  

其次,必须在配置文件指定哪些节点被指定为Observer,如:

server.1:node1:2181:3181:observer  

其次,必须在配置文件指定哪些节点被指定为 Observer,如:
server.1:localhost:2181:3181:observer

这里,我们安装的是leader+follower模式

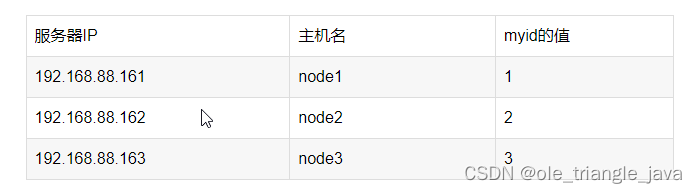
服务器IP

主机名   myid的值
第一步:下载zookeeeper的压缩包,下载网址如下

Index of /dist/zookeeper

我们在这个网址下载我们使用的zk版本为3.5.8

下载完成之后,上传到我们的linux的/opt路径下准备进行安装

第二步:解压

在node1主机上,解压zookeeper的压缩包到/opt路径下去,然后准备进行安装

tar -zxvf zookeeper-3.5.8.tar.gz 

第三步:修改配置文件

在node1主机上,修改配置文件

cd /zookeeper-3.5.8/conf/

cp zoo_sample.cfg zoo.cfg

mkdir /opt/zookeeper-3.5.8/zkdatas

vim  zoo.cfg

修改以下内容

#Zookeeper的数据存放目录

dataDir=/opt/zookeeper-3.5.8/zkdatas

# 保留多少个快照

autopurge.snapRetainCount=3

# 日志多少小时清理一次

autopurge.purgeInterval=1

# 集群中服务器地址

#当前服务器的ip设置为0.0.0.0

server.1=node1:2888:3888

server.2=node2:2888:3888

server.3=node3:2888:3888

第四步:添加myid配置

在node1主机的/opt/zookeeper-3.5.8/data/这个路径下创建一个文件,文件名为myid ,文件内容为1

vim myid 

echo 1 > /opt/zookeeper/data//myid

第五步:安装包分发并修改myid的值

在node1主机上,将安装包分发到其他机器

第一台机器上面执行以下两个命令

scp -r  /opt/zookeeper-3.5.8/ node2:/opt/

scp -r  /opt/zookeeper-3.5.8/ node3:/opt/

第二台机器上修改myid的值为2

修改配置文件中的server ip,当前服务器的ip设置为0.0.0.0

echo 2 > /export/server/zookeeper-3.5.8/data/myid

第三台机器上修改myid的值为3

修改配置文件中的server ip,当前服务器的ip设置为0.0.0.0

echo 3 > /export/server/zookeeper-3.5.8/data/myid

第六步:三台机器启动zookeeper服务

三台机器分别启动zookeeper服务

这个命令三台机器都要执行

/opt/zookeeper-3.5.8/bin/zkServer.sh start

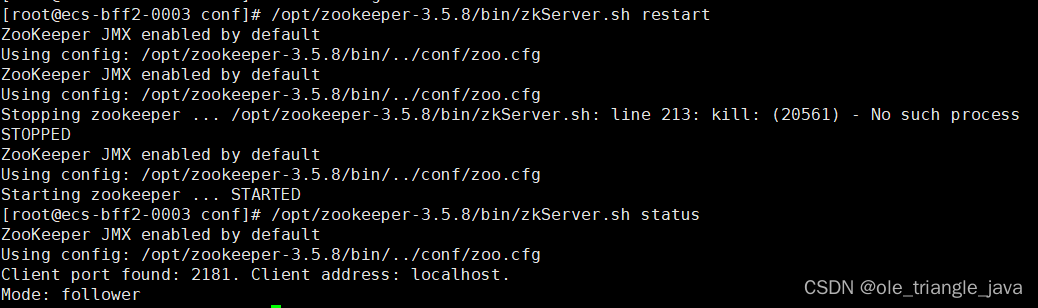
三台主机分别查看启动状态

/opt/zookeeper-3.5.8/bin/zkServer.sh  status
配置Path环境变量

1:分别在三台中,修改/etc/proflie,添加以下内容

export ZOOKEEPER_HOME=/export/server/zookeeper-3.4.6

export PATH=:$ZOOKEEPER_HOME/bin:$PATH

2:分别在三台主机中,source /etc/profile

切记:必须source,不然不生效

# 启动服务
./zkServer.sh start
 
# 查看状态
./zkServer.sh status
 
# 停止服务
./zkServer.sh stop
 
# 重启服务
./zkServer.sh restart

2.1 集群启停脚本
1 )在 /home/bin 目录下创建文件 zk .sh 脚本文件
[atguigu@hadoop102 bin]$ vim zk.sh
脚本如下:

#! /bin/bash
case $1 in
"start"){
     for i in 123.249.80.174 123.249.6.143 120.46.45.204
     do
         echo " --------启动 $i zookeeper-------"
         ssh $i "source /etc/profile && /opt/zookeeper-3.5.8/bin/zkServer.sh start"
     done
};;
"stop"){
     for i in 123.249.80.174 123.249.6.143 120.46.45.204
     do
         echo " --------停止 $i zookeeper-------"
         ssh $i "source /etc/profile && /opt/zookeeper-3.5.8/bin/zkServer.sh stop"
     done
};;
"status"){
     for i in 123.249.80.174 123.249.6.143 120.46.45.204
     do
         echo " --------查看 $i zookeeper-------"
         ssh $i "source /etc/profile && /opt/zookeeper-3.5.8/bin/zkServer.sh status"
     done
};;
esac
2 )添加执行权限
[atguigu@hadoop102 bin]$ chmod +x kf.sh
3 )启动集群命令
[atguigu@hadoop102 ~]$ kf.sh start
4 )停止集群命令
[atguigu@hadoop102 ~]$ kf.sh stop
注意:因为没有配置节点之间ssh的免登陆,所以在启动一个个节点时候,还需要手动输入密码。

三、安装Kafka


官方下载地址: http://kafka.apache.org/downloads.html
1 ) 解压安装包
[atguigu@hadoop102 software]$ tar -zxvf kafka_2.12-3.0.0.tgz -C /opt/module/
2 ) 修改解压后的文件名称
[atguigu@hadoop102 module]$ mv kafka_2.12-3.0.0/ kafka
3 ) 进入到 /opt/module/kafka 目录,修改配置文件
[atguigu@hadoop102 kafka]$ cd config/
[atguigu@hadoop102 config]$ vim server.properties
输入以下内容:
#broker 的全局唯一编号,不能重复,只能是数字。
broker.id=0

#例:假如服务器对外访问的ip为123.44.55.66 内网地址为10.20.30.153

listeners=PLAINTEXT://10.20.30.153:9092
advertised.listeners=PLAINTEXT://123.44.55.66:9092
原文链接:https://blog.youkuaiyun.com/weixin_44943959/article/details/123236738

# 处理网络请求的线程数量
num.network.threads=3
# 用来处理磁盘 IO 的线程数量
num.io.threads=8
# 发送套接字的缓冲区大小
socket.send.buffer.bytes=102400
# 接收套接字的缓冲区大小
socket.receive.buffer.bytes=102400
# 请求套接字的缓冲区大小
socket.request.max.bytes=104857600
#kafka 运行日志 ( 数据 ) 存放的路径,路径不需要提前创建, kafka 自动帮你创建,可以
配置多个磁盘路径,路径与路径之间可以用 " , " 分隔
log.dirs=/opt/module/kafka/datas
#topic 在当前 broker 上的分区个数
num.partitions=1
# 用来恢复和清理 data 下数据的线程数量
num.recovery.threads.per.data.dir=1
# 每个 topic 创建时的副本数,默认时 1 个副本
offsets.topic.replication.factor=1
#segment 文件保留的最长时间,超时将被删除
log.retention.hours=168
# 每个 segment 文件的大小,默认最大 1G
log.segment.bytes=1073741824
# 检查过期数据的时间,默认 5 分钟检查一次是否数据过期
log.retention.check.interval.ms=300000
# 配置连接 Zookeeper 集群地址(在 zk 根目录下创建 /kafka ,方便管理)
zookeeper.connect=hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka
4 ) 分发安装包
[atguigu@hadoop102 module]$ scp -r  /opt/zookeeper-3.5.8/ node2:/opt/
5 ) 分别在 hadoop103 和 hadoop104 上修改配置文件 /opt/module/kafka/config/server.properties
中的 broker.id=1 、 broker.id=2
注: broker.id 不得重复,整个集群中唯一。
[atguigu@hadoop103 module]$ vim kafka/config/server.properties
修改 :
# The id of the broker. This must be set to a unique integer for
each broker.
broker.id=1
[atguigu@hadoop104 module]$ vim kafka/config/server.properties
修改 :
# The id of the broker. This must be set to a unique integer for
each broker.
broker.id=2
6 ) 配置环境变量
( 1 )在 /etc/profile.d/my_env.sh 文件中增加 kafka 环境变量配置
[atguigu@hadoop102 module]$ sudo vim /etc/profile
增加如下内容:
#KAFKA_HOME
export KAFKA_HOME=/opt/module/kafka
export PATH=$PATH:$KAFKA_HOME/bin
( 2 )刷新一下环境变量。
[atguigu@hadoop102 module]$ source /etc/profile
( 3 )分发环境变量文件到其他节点,并 source 。
[atguigu@hadoop102 module]$ sudo /home/atguigu/bin/xsync /etc/profile.d/my_env.sh
[atguigu@hadoop103 module]$ source /etc/profile
[atguigu@hadoop104 module]$ source /etc/profile
7 ) 启动集群
( 1 )先启动 Zookeeper 集群,然后启动 Kafka 。
[atguigu@hadoop102 kafka]$ zk.sh start
( 2 )依次在 hadoop102 、 hadoop103 、 hadoop104 节点上启动 Kafka 。
[atguigu@hadoop102 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
[atguigu@hadoop103 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
[atguigu@hadoop104 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
注意:配置文件的路径要能够到 server.properties 。
8 ) 关闭集群
[atguigu@hadoop102 kafka]$ bin/kafka-server-stop.sh
[atguigu@hadoop103 kafka]$ bin/kafka-server-stop.sh
[atguigu@hadoop104 kafka]$ bin/kafka-server-stop.sh

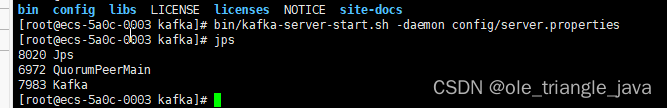
通过jps命令查看运行的情况

您可以使用以下步骤重启kafka:

1. 停止kafka服务:使用以下命令停止kafka服务:


bin/kafka-server-stop.sh

2. 如果kafka服务没有停止,则使用以下命令终止进程:


kill -9 `ps ax | grep -i 'kafka' | grep -v grep | awk '{print $1}'`

3. 启动kafka服务:使用以下命令启动kafka服务:

四。主题命令行操作
查看当前服务器中的所有 topic

bin/kafka-topics.sh --bootstrap-server 123.44.55.66:9092 --list

创建 first topic
bin/kafka-topics.sh --bootstrap-server 123.44.55.66:9092 --create --partitions 1 --replication-factor 3 --topic first

查看 first 主题的详情

bin/kafka-topics.sh --bootstrap-server 123.44.55.66:9092 --describe --topic first

修改分区数(注意:分区数只能增加,不能减少)
bin/kafka-topics.sh --bootstrap-server 123.44.55.66:9092 --alter --topic first --partitions 3

再次查看 first 主题的详情

bin/kafka-console-producer.sh --bootstrap-server 123.44.55.66:9092 --topic first

Kafka集群版安装部署 本文介绍了如何搭建Kafka集群,包括单节点多Broker部署和多节点多Broker部署。Kafka集群由Broker节点、Controller节点和混合节点构成,Broker负责消息存储和处理,Controller负责集群元数据管理。Kafka依赖ZooKeeper进行集群管理,本文详细描述了在CentOS 8.4、JDK 17、ZooKeeper 3.8.4环境下部署Kafka 2.7.2的步骤,包括ZooKeeper集群部署、Kafka安装、配置文件修改及服务启动。 阅读详情

相关推荐

springboot 连接 kafka集群(kafka版本 2.13-3.4.0)

消息的接受有多种方式,我们这里选择的是使用 @KafkaListener 注解来进行消息接收。实现该接口的方法,我们可以获取包含发送结果(成功或失败)的异步回调,也就是可以在这个接口的实现中获取发送结果。写一个controller类来测试我们构建的发布者类,这个类中打印接收到的消息,来确保信息接收不出问题。继续使用postman调用我们写好的发布者发布消息,观察控制台的消费者类是否有相关日志出现。我们简单的实现构建一个发布者类,接收主题和发布消息参数,并打印发布结果。配置好后,我们就可以使用这个注解了。

一起学习一起进步~ 1万+

kafkak集群的安装部署

1. 三台主机都需要安装好jdk 2. 三台主机都要配置好zookeeper 3. 准备好kafka压缩包 二、kafka集群的安装 1. 上传压缩包 2. 解压 3. 创建消息目录 4.修改server.properties文件 5. 分发 kafka安装目录 6. 修改HadoopSlave01,HadoopSlave02下的kafka配置文件server.properties 7. 配置环境变量 7. 启动kafka集群

m0_61232019的博客 4120

kafka学习 (一)集群安装配置

安装java 安装zookeeper 1 部署配置 2 配置说明 21 myid文件和servermyid 22 zoocfg 23 log4jproperties 24 zkEnvsh和zkServersh文件 3 参数说明 4 启动测试 安装KAFKA 1 部署配置 2 启动服务器 3 kafka测试 3 日志说明 supervisor管理 1 管理zookeeper 2 管理kafka 开发

bluetom520的博客 1252

Kafka集群部署(手把手部署图文详细版)

在node02上执行以下命令,拷贝kafka_2.11-0.10.1.1到node03、4的“/usr/local”目录下。在node02、3、4上执行以下命令,都可以查看到上一步骤创建的topic主题。添加完成后,执行命令source /etc/profile,使环境变量生效。添加完成后,执行命令source /etc/profile,使环境变量生效。该命令执行后,就会消费topic数据,此窗口不要再做其他操作,不要关闭。在node03或node04上执行命令,创建消费者,模拟目标系统。

CloudJourney的博客 7873

Kafka 安装与配置

本节详细介绍 Kafka 运行环境的搭建,为了节省篇幅,本节的内容以 Linux CentOS 作为安装演示的操作系统,其他 Linux 系列的操作系统也可以参考本节的内容。具体的操作系统的信息如下: [root@node1 ~]# uname -a Linux node1 2.6.32-504.23.4.el6.x86_64 #1 SMP Tue Jun 9 20:57:37 UTC 2015 x86_64 x86_64 x86_64 GNU/Linux [root@node1 ~]# cat /et

码农架构 1万+

Kafka 在 Linux 下的集群配置和安装

本文详细介绍了在 Linux 环境中配置和安装 Kafka 集群的过程,包括每个配置项的说明和常见故障的排查方法。通过这些步骤,您可以轻松地构建一个可靠的 Kafka 集群,支持大规模数据流处理和实时数据传输。希望这篇文章能够帮助您顺利搭建和管理 Kafka 集群。

J老熊 2686

kafka集群安装Raft 协议

​使用消息中间件,可以实现系统与系统之间的异步通信和无缝对接,也可用在模块之间的的异步通信,有效避免了同步阻塞IO。作为一个高吞吐量、可扩展、高可靠性的分布式消息系统,Kafka 能够胜任从简单的消息队列到复杂的流处理平台的多种角色。MQTT消息系统和kafka是当前最常用的消息中间件。

人无再少年 1291

Kafka【三】Windows下安装Kafka集群

如果启动过程报错,主要是因为zookeeper和kafka的同步问题,请先执行cluster-clear.cmd文件,再执行cluster.cmd文件即可。集群启动命令后,会打开多个黑窗口,每一个窗口都是一个kafka服务,请不要关闭,一旦关闭,对应的kafka服务就停止了。因为kafka内置了ZooKeeper软件,所以此处将解压缩的文件作为ZooKeeper软件使用。将kafka1文件夹复制两份,改名为kafka2,kafka3。修改文件夹名为kafkazookeeper。

小小默:进无止境 3140

kafka 集群_kafka简述与集群配置(A)

一、kafka简述 1、简介kafka是一个高吞吐的分布式消息队列系统。特点是生产者消费者模式,先进先出(FIFO)保证顺序,自己不丢数据,默认每隔7天清理数据。消息列队常见场景:系统之间解耦合、峰值压力缓冲、异步通信。2、集群介绍(1)Kafka架构是由producer(消息生产者)、consumer(消息消费者)、borker(kafka集群的server,负责处理消息读、写请求,存储消息,在...

weixin_39959505的博客 473

Spark——Linux环境下 Kafka集群的安装与配置

1. 下载 解压 安装 Kafka安装包 下载地址: Apache Kafka 在hadoop01中 输入:cd /export/software/ 输入:rz -E 选择Kafka安装包 打开并上传,输入ls查看,第一行第二个是Kafka 解压安装包到 /export/servers 输入:tar -zxvf kafka_2.11-2.0.0.tgz -C /export/servers/ 验证安装 输入:cd /export/servers/ 输入:ls ..

weixin_54348877的博客 2716

视觉SLAM十四讲习题答案

阅读《视觉SLAM十四讲》中遇到的问题及习题资源整理,或为原创,或来自网络,如有问题请与我联系,会在第一时间加以修正。 后来自己写完看到另一位写的博客,相形见绌,大家可以互相结合的看。 第一讲 1.线性方程的解:转载自宋洋鹏(youngpan1101),了解线性代数可关注B站3Blue1Brown,以及线性代数,知乎上有其精细笔记。 2.高斯分布参考这位博主Johnny-Cuii的文章,具体...

INFINITE POSSIBILITIES 1万+

kafka:linux 安装 kafka集群

启动:sh /opt/kafka/kafka_2.11-2.4.0/bin/kafka-server-start.sh -daemon /opt/kafka/kafka_2.11-2.4.0/config/server.properties。若要关闭efak,则运行命令:sh/opt/kafka-eagle/kafka-eagle-bin-2.1.0/efak-web-2.1.0/bin/ke.sh stop。下载linux版本的jdk包,比如:jdk-8u192-linux-x64.tar.gz。

积水成多,水到渠成 1821

从零搭建Python接口自动化测试框架:pytest+requests+Allure实战指南

接口自动化测试是现代软件工程中保障交付质量、提升测试效率的核心实践。其基本原理是通过脚本模拟客户端请求,对服务端接口进行自动化的功能验证、性能探测与回归测试,从而替代重复的手工操作。在技术实现上,Python凭借其简洁语法和丰富的生态,成为构建此类框架的主流选择,其中pytest测试框架、requests HTTP库和Allure报告工具构成了技术栈的黄金组合。这套技术方案的价值在于,它能将测试用例数据(如YAML文件)与执行逻辑分离,实现数据驱动测试,并通过持续集成(如Jenkins)无缝融入DevOps

weixin_31822733的博客 378

Kafka单服务器配置伪集群

一 简介 Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据,其主要特性如下: 通过O(1)的磁盘数据结构提供消息的持久化,这种结构对于即使数以TB的消息存储也能够保持长时间的稳定性。 高吞吐量:即使是非常普通的硬件,Kafka也可以支持每秒数百万的消息。 支持通过Kafka服务器和消费机集群来分区消息。 支持Hadoop并行数据加载。 Kaf...

qq_38787653的博客 484

避开RK3588开发板SDIO配置的坑:O9201SB WiFi模组接入实战指南

本文为嵌入式开发者提供了在RK3588开发板上,利用TF卡槽接入O9201SB WiFi6模组的实战指南。文章深度剖析了SDIO配置中常见的电源管理序列冲突问题,并给出了从设备树节点修改、内核编译到系统验证的完整解决方案,帮助开发者避开配置陷阱,成功实现高性能无线连接。

sprite的博客 954

安装破解IAR EWARM 8.2,提供注册机

IAR Embedded Workbench for ARM(IAR for ARM)是一款微处理器的集成开发环境软件,该集成开发环境中包含了IAR的C/C++编译器、 汇编工具、链接器、库管理器、文本编辑器、工程管理器和C-SPY调试器,支持ARM,AVR,MSP430等芯片。   一、安装 双击运行安装程序,点击Install IAR Embedded Workbench for ARM...

睿思派克 4万+

kafka安装与集群配置

kafka简介 Kafka 是一款分布式消息发布和订阅系统,具有高性能、高吞吐量的特点而被广泛应用与大数据传输场景。使用Scala语言进行编写,提供了与JMS规范类似的特性,但是编写上并不是jms实现。kafka中只有topic的概念,没有队列。 kafka的应用场景 kafka 具有高吞吐量、具有分区特性、副本机制及容错性的优点(kafka 每秒可以处理几十万消息),让 kafka 成为了...

嘎嘎的博客 708

软件工程期末知识点总结【超详细】

生命周期模型(过程模型):瀑布模型、快速原型模型、增量模型、螺旋模型、喷泉模型。2、实体联系图:1、数据对象2、属性3、联系(1:1、1:N、M:N)3、语句覆盖 就是设计足够的调试用例,使得程序中的每个语句至少执行一次。 5、判定覆盖就是设计足够的测试用例,使得程序中每个判定的取“真”分支和取“假”分支至少都执行一次,判定覆盖又称分支覆盖 6、条件覆盖就是设计足够的测试用例,使得程序判定中的每个条件能获得各种可能的结果。7、软件开发时期通常分成4个阶段:总体设计、详细设计、编码和单元测试、综合测试。

这个人好有趣....hh 1万+

Kafka集群搭建与使用

Kafka简介 Kafka是一种高吞吐量的分布式发布订阅消息系统,使用Scala编写。 对于熟悉JMS(Java Message Service)规范的同学来说,消息系统已经不是什么新概念了(例如ActiveMQ,RabbitMQ等)。 Kafka拥有作为一个消息系统应该具备的功能,但是确有着独特的设计。可以这样来说,Kafka借鉴了JMS规范的思想,但是确并没有完全遵循JMS规范。 kafka是一个分布式的,分区的消息(官方称之为commit log)服务。它提供一个消息系统应该具备的功能,但是确有着独特

纯洁的明依 495

01-嵌入式入门-如何看原理图

最近由于找到的工作是偏于嵌入式方向,因此又重新开始学习已经丢弃两年的知识。新手学习知识感觉有一个通病:喜欢收集各种各样的视频、资料,网盘里收藏一大堆,但是却从没有打开看过,到头来还是个小白,只听说过几个概念,而实际却是不知所云,这就是所谓的"学习综合征"。而我也是其中的一员,最近痛定思痛,就准备根据一套资料沉下心学习下去,不再进入收集资料的大军。...

weixin_34010566的博客 4492

《QGIS快速入门与应用基础》191:渐变区间设置(等间隔/分位数)

深入解析QGIS中渐变符号化的核心环节——渐变区间设置,重点对比等间隔与分位数两种主流模式的原理与应用。作者指出,90%的渐变效果问题源于区间设置不当,强调必须先分析数据分布特征(通过统计面板查看直方图、极值等)再选择匹配模式。等间隔模式适用于均匀分布数据(如海拔、温度),将数值范围均等划分;分位数模式则针对偏态数据(如GDP、人口),保证每个区间要素数量相等。文章通过界面示意图、效果对比图和操作步骤详解,指导读者根据数据类型选择合适区间模式,并提醒常见避坑要点:社会经济数据禁用等间隔、分类数不超过8类。

LuckyHanMo的博客 320

Kafka 集群安装与配置指南

本文详细介绍了生产级Kafka集群的安装与配置要点。首先从硬件规划、软件环境和节点准备等方面阐述安装前的准备工作;然后具体说明下载安装、配置文件修改和集群启动的操作步骤;进而提出通过副本机制、监控告警和数据备份来保障集群可用性;同时介绍了使用自动化工具提升部署效率的方法;最后重点讲解了SSL/TLS认证和ACL权限控制等安全性配置。全文系统性地指导了如何搭建一个高可用、可靠且安全的Kafka集群,为生产环境部署提供了实用参考方案。

shangjg3的博客 1215

孔雀优化算法(POA)详解:从孔雀智能到优化引擎

孔雀优化算法(POA)是一种新型元启发式优化算法,灵感来源于孔雀的社会行为和智能狩猎策略。该算法将孔雀群体分为雄孔雀、雌孔雀和幼孔雀三个阶层,分别对应全局探索、平衡搜索和局部开发三种搜索策略。通过模拟孔雀的求偶展示、自适应接近和Levy飞行等行为,POA实现了探索与开发的动态平衡。算法采用角色分配机制和位置更新方程,结合参数自适应调整,展现出优于传统算法的全局搜索能力和收敛性能。POA已成功应用于多个优化问题,其生物启发机制为解决复杂优化问题提供了新思路。

qq_42212808的博客 137

Kafka集群安装

kafka的管理需要借助zookeeper完成,所以要先安装好zookeeper集群。

lIujunXHU的博客 1894

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

【Kafka】基于zookeeper的Kafka集群的安装与配置

备注:无论是ZK,还是Kafka,都需要用到JDK,我上面给出的ZK和Kafka版本,都已经支持JDK11。到此为止,三节点的Kafka集群就已经部署完毕,可能部分参数还有待调优,这里就不做详细说明了,生产环境上的配置,以本地的配置为准。最后依次启动三台服务器上的zookeeper即可,并检查当前节点的状态,三个节点中,2个为follower,1个为leader。首先,我们将zk的安装包使用rz命令上传到app用户目录下,然后解压,按照下面的配置编辑配置文件即可。然后将下面的内容黏贴到文件中,并保存退出。

cnskylee的博客 7255

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

kafka集群安装配置,外置zookeeper

一:准备工作: 1、集群划分: 2、安装包下载: Kafka安装包下载: Apache Kafka 将安装包放在:/home/KYJ/soft文件下面 Zookeeper安装包下载: http://zookeeper.apache.org 将安装包放在:/home/KYJ/soft文件下面 二:解压安装包 使用命令: tar -zxvf kafka_2.12-3.0.0.tgz tar -zxvf apache-zookeeper-3.7....

kyj3518861703的博客 3221
上一篇: java图片转pdf ,pdf 导出,pdf转图片
下一篇: Kafka集群的安装与配置(二)
ole_triangle_java
博客等级 码龄10年 82粉丝 83原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值