


AI 编译优化与 WebAssembly:模型推理的编译加速,从解释执行到原生性能
一、AI 推理的性能瓶颈:解释执行的代价
AI 模型的推理过程本质上是大量的矩阵运算。以一个 7B 参数的语言模型为例,一次前向传播需要约 14GFLOPS 的计算量。如果用纯 Python 解释执行,每秒只能完成约 100MFLOPS,一次推理需要 140 秒。这个速度完全不可用。
实际生产中,AI 推理依赖编译优化技术将模型转化为高效的机器码。PyTorch 的 TorchScript、TensorFlow 的 XLA、ONNX Runtime 的图优化,都是编译优化的具体实现。
WebAssembly 作为 AI 推理的部署目标,同样面临编译优化的问题。WASM 代码在浏览器中通过 JIT 编译执行,性能约为原生代码的 50-80%。对于计算密集型的 AI 推理,这个性能差距仍然显著。
本文将探讨 AI 模型推理的编译优化技术,以及如何将这些优化应用到 WebAssembly 部署场景中。
二、AI 推理编译优化的技术栈
2.1 从模型到机器码的编译链路
AI 模型的编译优化涉及多个层次,每个层次都有不同的优化空间:
flowchart TD
    A[训练框架模型<br/>PyTorch/TensorFlow] --> B[计算图导出<br/>ONNX/TorchScript]
    B --> C[图级优化<br/>算子融合/常量折叠/死代码消除]
    C --> D[算子级优化<br/>向量化/循环展开/内存布局优化]
    D --> E{目标平台}
    E -->|CPU| F[x86/ARM 机器码<br/>通过 LLVM]
    E -->|GPU| G[CUDA/OpenCL 内核]
    E -->|WASM| H[WASM 字节码<br/>通过 wasmtime/wasmer]
    F --> I[原生执行]
    G --> I
    H --> J[JIT 编译执行<br/>性能约原生 50-80%]
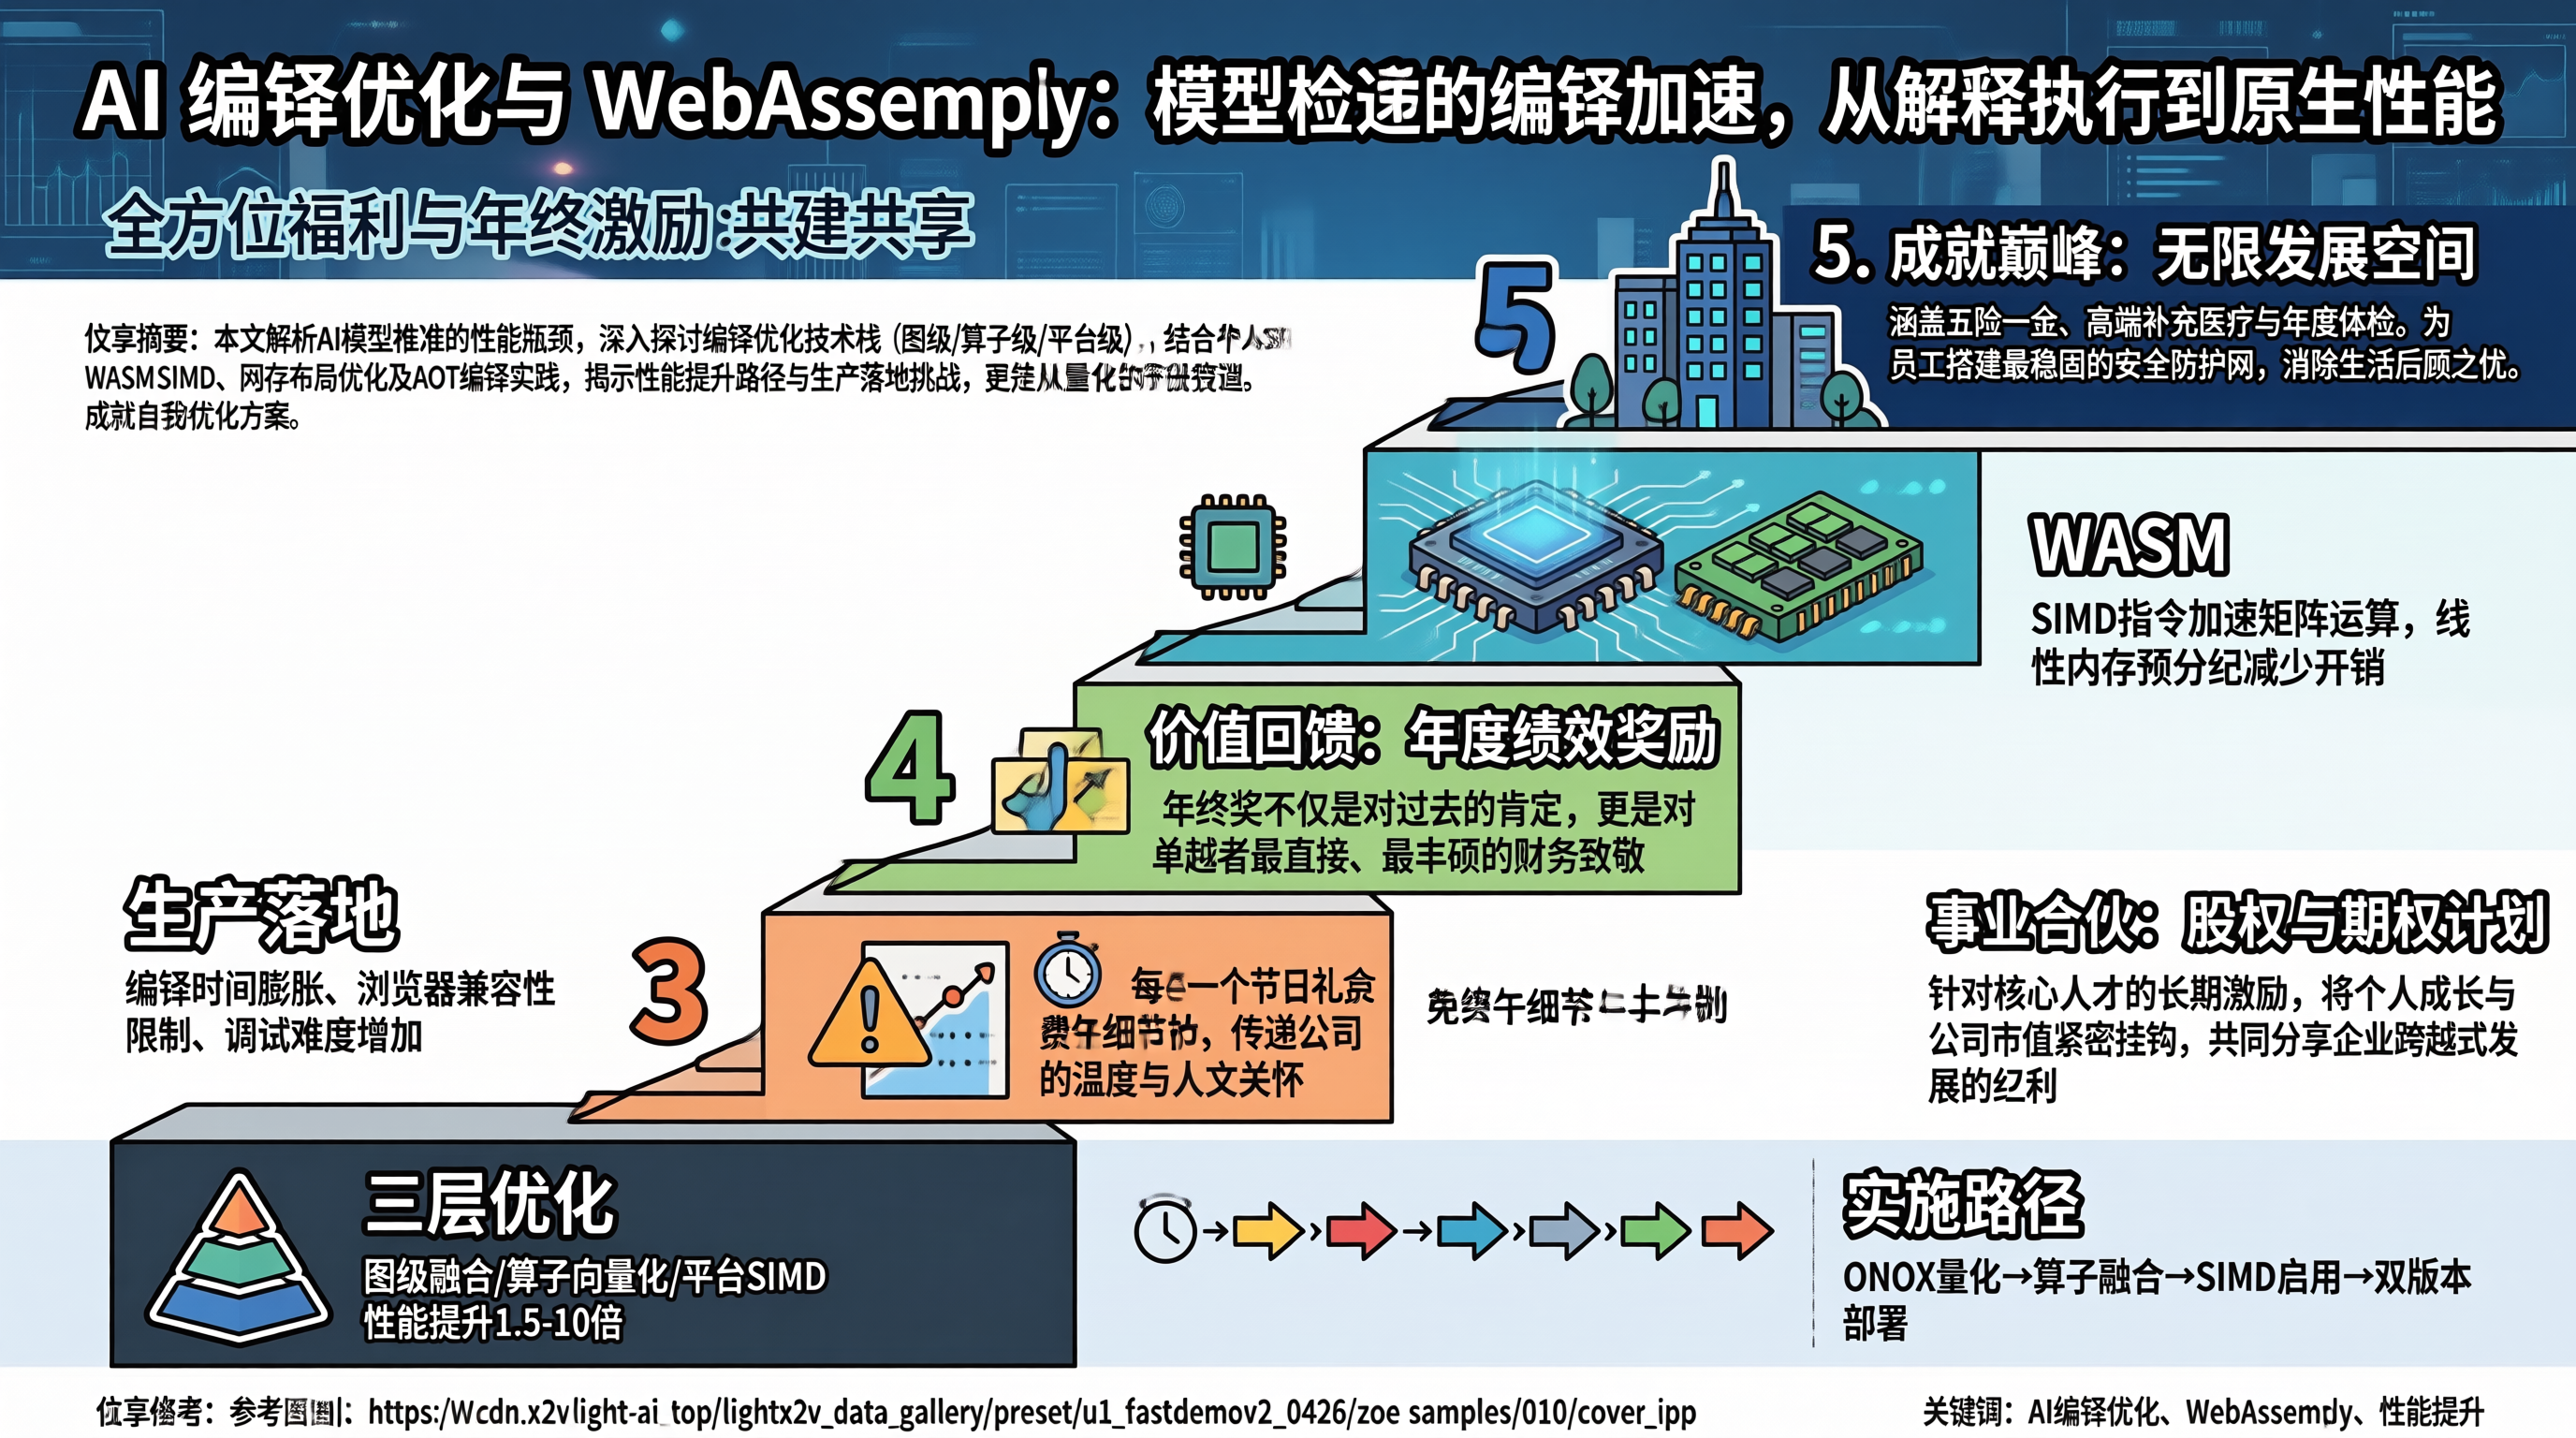
2.2 三层优化策略
| 优化层次 | 优化内容 | 性能提升 | 复杂度 |
|---|---|---|---|
| 图级优化 | 算子融合、常量折叠 | 1.5-3x | 低 |
| 算子级优化 | 向量化、循环展开 | 2-5x | 中 |
| 平台级优化 | SIMD、多线程、缓存友好 | 2-10x | 高 |
2.3 WASM 特有的优化空间
WebAssembly 有几个特有的优化方向:
- SIMD 指令:WASM SIMD 128 允许一次处理 4 个 float32,矩阵运算速度可提升 2-4 倍
- 线性内存优化:WASM 的线性内存模型适合预分配大块内存,减少动态分配开销
- AOT 编译:将 WASM 预编译为机器码,消除 JIT 预热开销
三、生产级代码:WASM AI 推理的编译优化实践
3.1 矩阵运算的 SIMD 优化
// 使用 WASM SIMD 加速矩阵乘法
// 编译目标:wasm32-unknown-unknown,需启用 simd128 feature

#[cfg(target_arch = "wasm32")]
use core::arch::wasm32::*;

/// 普通矩阵乘法:三重循环,无优化
fn matmul_naive(a: &[f32], b: &[f32], c: &mut [f32], m: usize, n: usize, k: usize) {
    for i in 0..m {
        for j in 0..n {
            let mut sum = 0.0f32;
            for l in 0..k {
                sum += a[i * k + l] * b[l * n + j];
            }
            c[i * n + j] = sum;
        }
    }
}

/// WASM SIMD 优化的矩阵乘法:一次计算 4 个元素
#[cfg(target_arch = "wasm32")]
fn matmul_simd(a: &[f32], b: &[f32], c: &mut [f32], m: usize, n: usize, k: usize) {
    // 确保列数是 4 的倍数,便于 SIMD 处理
    assert!(n % 4 == 0, "列数必须是 4 的倍数");

    for i in 0..m {
        for j in (0..n).step_by(4) {
            // 用 v128 类型一次累加 4 个结果
            let mut sum = f32x4_splat(0.0);

            for l in 0..k {
                // 从矩阵 a 读取标量,广播到 4 个通道
                let a_val = f32x4_splat(a[i * k + l]);
                // 从矩阵 b 读取 4 个连续值
                let b_vals = v128_load(&b[l * n + j]);
                // 乘加运算:sum += a_val * b_vals
                sum = f32x4_add(sum, f32x4_mul(a_val, b_vals));
            }

            // 将 4 个结果写回矩阵 c
            v128_store(&mut c[i * n + j], sum);
        }
    }
}

#[cfg(target_arch = "wasm32")]
fn f32x4_splat(val: f32) -> v128 {
    unsafe { f32x4(val, val, val, val) }
}

#[cfg(target_arch = "wasm32")]
fn f32x4_add(a: v128, b: v128) -> v128 {
    unsafe { f32x4_add(a, b) }
}

#[cfg(target_arch = "wasm32")]
fn f32x4_mul(a: v128, b: v128) -> v128 {
    unsafe { f32x4_mul(a, b) }
}

#[cfg(target_arch = "wasm32")]
fn v128_load(ptr: &f32) -> v128 {
    unsafe { v128_load(ptr as *const f32 as *const v128) }
}

#[cfg(target_arch = "wasm32")]
fn v128_store(ptr: &mut f32, val: v128) {
    unsafe { v128_store(ptr as *mut f32 as *mut v128, val) }
}
3.2 内存布局优化:从行主序到分块矩阵
/// 分块矩阵乘法:提高缓存命中率
/// 原理:将大矩阵分成小块,每块适合 L1 缓存
fn matmul_tiled(
    a: &[f32], b: &[f32], c: &mut [f32],
    m: usize, n: usize, k: usize,
    block_size: usize,
) {
    // 初始化输出矩阵
    for val in c.iter_mut() {
        *val = 0.0;
    }

    // 分块遍历:外层按块迭代,内层按元素迭代
    for ii in (0..m).step_by(block_size) {
        for jj in (0..n).step_by(block_size) {
            for ll in (0..k).step_by(block_size) {
                // 当前块的边界
                let i_end = (ii + block_size).min(m);
                let j_end = (jj + block_size).min(n);
                let l_end = (ll + block_size).min(k);

                // 在块内执行矩阵乘法
                for i in ii..i_end {
                    for l in ll..l_end {
                        let a_val = a[i * k + l];
                        for j in jj..j_end {
                            c[i * n + j] += a_val * b[l * n + j];
                        }
                    }
                }
            }
        }
    }
}
3.3 ONNX 模型的 WASM 编译流程
use serde::{Deserialize, Serialize};

/// ONNX 算子定义:模型中的计算节点
#[derive(Serialize, Deserialize, Debug)]
struct OnnxNode {
    op_type: String,
    inputs: Vec<String>,
    outputs: Vec<String>,
    attributes: serde_json::Value,
}

/// 算子融合规则:将多个算子合并为一个,减少内存访问
struct FusionRule {
    /// 匹配的算子序列模式
    pattern: Vec<String>,
    /// 融合后的算子类型
    fused_op: String,
}

impl FusionRule {
    fn new(pattern: Vec<&str>, fused_op: &str) -> Self {
        FusionRule {
            pattern: pattern.iter().map(|s| s.to_string()).collect(),
            fused_op: fused_op.to_string(),
        }
    }

    /// 检查节点序列是否匹配融合规则
    fn matches(&self, nodes: &[OnnxNode], start: usize) -> bool {
        if start + self.pattern.len() > nodes.len() {
            return false;
        }
        for (i, expected_op) in self.pattern.iter().enumerate() {
            if nodes[start + i].op_type != *expected_op {
                return false;
            }
        }
        true
    }
}

/// 图优化器:应用算子融合等优化规则
struct GraphOptimizer {
    rules: Vec<FusionRule>,
}

impl GraphOptimizer {
    fn new() -> Self {
        let mut rules = Vec::new();

        // 规则1:Conv + BatchNorm + Relu 融合
        rules.push(FusionRule::new(
            vec!["Conv", "BatchNormalization", "Relu"],
            "FusedConvBnRelu",
        ));

        // 规则2:MatMul + Add 融合(带偏置的矩阵乘法)
        rules.push(FusionRule::new(
            vec!["MatMul", "Add"],
            "FusedMatMulAdd",
        ));

        // 规则3:Gemm + Relu 融合
        rules.push(FusionRule::new(
            vec!["Gemm", "Relu"],
            "FusedGemmRelu",
        ));

        GraphOptimizer { rules }
    }

    /// 对计算图应用优化规则:返回优化后的节点列表
    fn optimize(&self, nodes: &[OnnxNode]) -> Vec<OnnxNode> {
        let mut optimized = Vec::new();
        let mut i = 0;

        while i < nodes.len() {
            let mut fused = false;

            for rule in &self.rules {
                if rule.matches(nodes, i) {
                    // 创建融合节点:合并输入输出
                    let fused_node = OnnxNode {
                        op_type: rule.fused_op.clone(),
                        inputs: nodes[i].inputs.clone(),
                        outputs: nodes[i + rule.pattern.len() - 1].outputs.clone(),
                        attributes: serde_json::json!({
                            "fused_from": rule.pattern,
                        }),
                    };
                    optimized.push(fused_node);
                    i += rule.pattern.len();
                    fused = true;
                    break;
                }
            }

            if !fused {
                optimized.push(nodes[i].clone());
                i += 1;
            }
        }

        optimized
    }
}
3.4 WASM 模块的 AOT 预编译
use wasm_bindgen::prelude::*;

/// AOT 编译配置:控制 WASM 到机器码的编译策略
#[wasm_bindgen]
pub struct CompileConfig {
    /// 是否启用 SIMD 优化
    pub enable_simd: bool,
    /// 是否启用多线程(SharedArrayBuffer)
    pub enable_threads: bool,
    /// 优化级别:0=无优化,1=基本优化,2=积极优化,3=最大优化
    pub opt_level: u8,
}

#[wasm_bindgen]
impl CompileConfig {
    #[wasm_bindgen(constructor)]
    pub fn new() -> Self {
        CompileConfig {
            enable_simd: true,
            enable_threads: false,
            opt_level: 2,
        }
    }

    /// 创建适合 AI 推理的配置:启用所有性能优化
    pub fn for_inference() -> Self {
        CompileConfig {
            enable_simd: true,
            enable_threads: true,
            opt_level: 3,
        }
    }
}

/// 模型编译器:将 ONNX 模型编译为优化的 WASM 模块
#[wasm_bindgen]
pub struct ModelCompiler {
    config: CompileConfig,
}

#[wasm_bindgen]
impl ModelCompiler {
    #[wasm_bindgen(constructor)]
    pub fn new(config: CompileConfig) -> Self {
        ModelCompiler { config }
    }

    /// 编译模型:应用图优化 + 算子优化 + 平台优化
    pub fn compile(&self, model_json: &str) -> Result<String, JsValue> {
        // 第一步:解析模型
        let nodes: Vec<OnnxNode> = serde_json::from_str(model_json)
            .map_err(|e| JsValue::from_str(&format!("模型解析失败: {}", e)))?;

        // 第二步:图级优化(算子融合)
        let optimizer = GraphOptimizer::new();
        let optimized_nodes = optimizer.optimize(&nodes);

        // 第三步:生成优化后的模型描述
        let result = serde_json::to_string(&serde_json::json!({
            "original_nodes": nodes.len(),
            "optimized_nodes": optimized_nodes.len(),
            "fusion_count": nodes.len() - optimized_nodes.len(),
            "simd_enabled": self.config.enable_simd,
            "threads_enabled": self.config.enable_threads,
            "opt_level": self.config.opt_level,
        }))
        .map_err(|e| JsValue::from_str(&format!("结果序列化失败: {}", e)))?;

        Ok(result)
    }
}
四、编译优化的代价:编译时间、兼容性与可调试性
4.1 编译时间膨胀
编译优化的级别越高,编译时间越长。opt-level=3 的编译时间可能是 opt-level=0 的 5-10 倍。对于大型模型,完整编译可能需要数分钟。
建议:开发阶段用 opt-level=1,发布阶段用 opt-level=3。使用增量编译减少重复编译时间。
4.2 SIMD 的兼容性问题
WASM SIMD 不是所有浏览器都支持。Safari 16.4+ 才支持,一些旧版浏览器完全不支持。如果用户浏览器不支持 WASM SIMD,代码会直接报错。
建议:提供 SIMD 和非 SIMD 两个版本的 WASM 模块,运行时检测浏览器支持情况后选择加载。
4.3 多线程的 SharedArrayBuffer 限制
WASM 多线程依赖 SharedArrayBuffer,而 SharedArrayBuffer 要求页面设置特定的 HTTP 头(Cross-Origin-Opener-Policy 和 Cross-Origin-Embedder-Policy)。很多 CDN 和托管服务默认不设置这些头。
建议:如果无法控制 HTTP 头,放弃多线程优化,改用单线程 + SIMD 的方案。
4.4 可调试性退化
编译优化后的代码,变量可能被内联、循环可能被展开、函数可能被合并。调试时看到的代码和源码差异很大,断点和变量查看都可能失效。
建议:保留一份未优化的 debug 版本,用于开发调试。发布时使用优化版本。
五、总结
AI 推理的编译优化是提升 WASM 推理性能的关键手段。图级优化(算子融合)可以减少内存访问,算子级优化(SIMD、循环展开)可以提升计算密度,平台级优化(多线程、缓存友好)可以充分利用硬件。
落地路线建议:
- 先用 ONNX Runtime Web 跑通推理流程,确认模型可用
- 对模型进行 INT8 量化,减少计算量和内存占用
- 应用算子融合等图级优化,减少内存访问次数
- 启用 WASM SIMD,矩阵运算速度提升 2-4 倍
- 提供 SIMD/非 SIMD 双版本,兼容不同浏览器
编译优化不是一步到位的。先跑通,再优化,每一步都用量化数据验证效果。性能优化的前提是正确性,不要为了快而牺牲正确。

 8840


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


