


AI 模型编译与跨语言互操作:WebAssembly 前沿技术解析
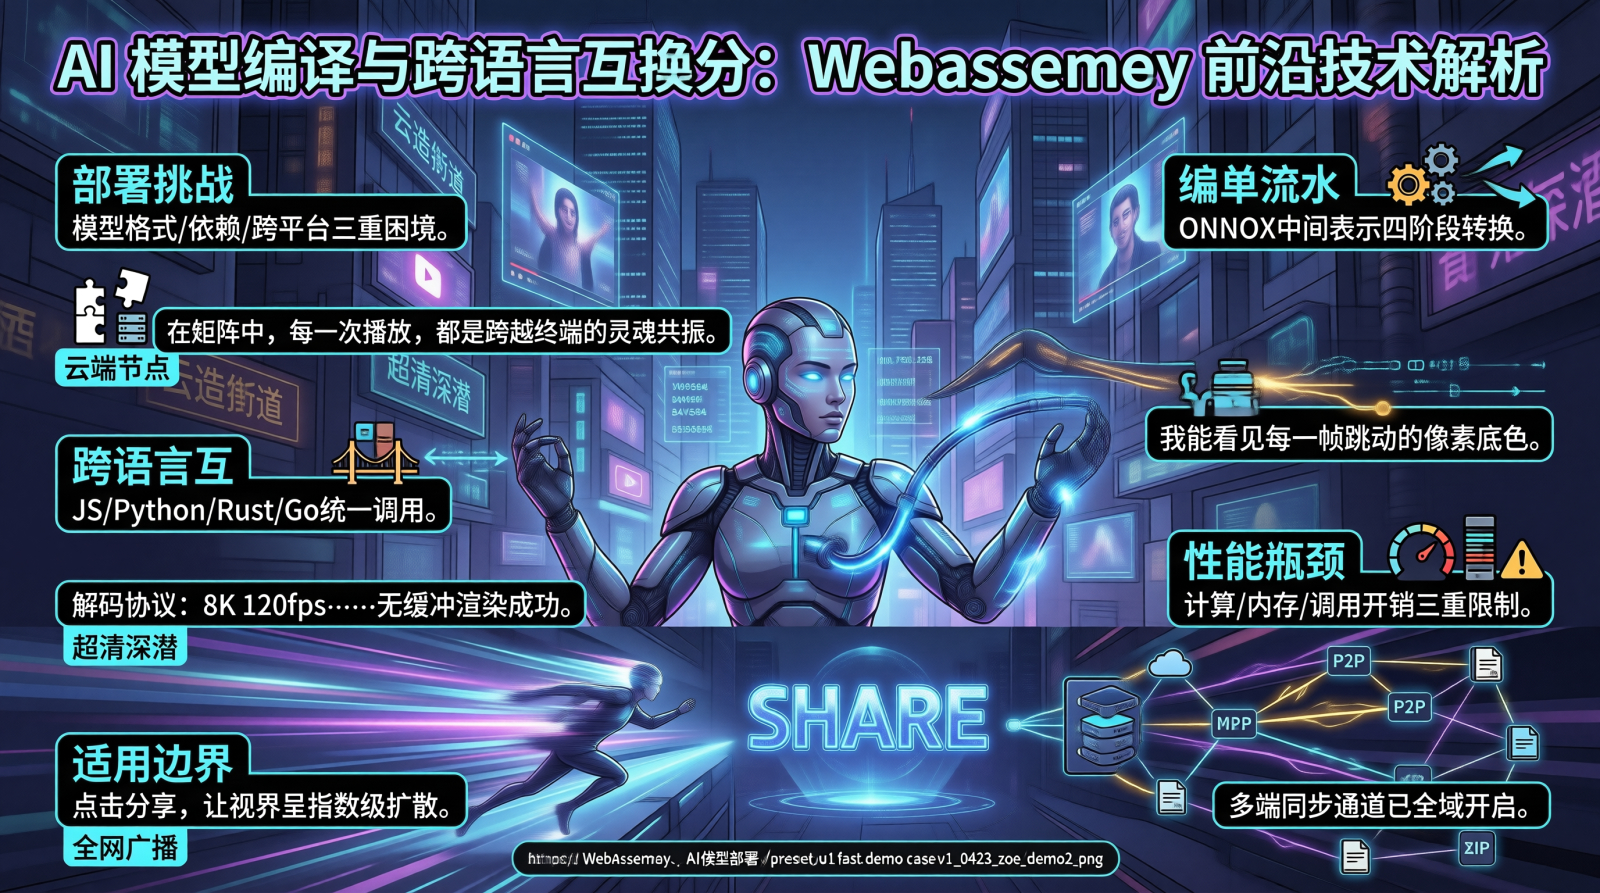
一、AI 模型的部署困境:从训练到推理的最后一公里
AI 模型在训练环境中表现优异,但部署到生产环境时面临一系列工程挑战:模型文件格式不统一(PyTorch .pt、ONNX .onnx、TensorFlow .pb)、运行时依赖复杂(CUDA、cuDNN 版本兼容性)、跨平台部署困难(服务器 GPU 与边缘设备 CPU 的指令集差异)。这些问题统称为"AI 模型的最后一公里"。
WebAssembly 作为一种可移植的字节码格式,为解决这些问题提供了新思路。将 AI 模型编译为 WASM 模块,可以在任何支持 WASM 的运行时中执行推理,无需关心底层硬件和操作系统差异。但这条路径的技术挑战不容忽视:WASM 的计算性能远低于原生代码,WASM 的内存模型与 AI 模型的张量计算需求存在冲突,跨语言互操作的接口设计需要精心规划。
二、AI 模型到 WASM 的编译流水线与跨语言调用架构
将 AI 模型编译为 WASM 模块,需要经过四个阶段的转换:模型导出、计算图优化、WASM 代码生成和运行时绑定。
flowchart LR
    A[PyTorch 模型<br/>.pt] -->|torch.onnx.export| B[ONNX 模型<br/>.onnx]
    B -->|onnx-optimizer| C[优化后的 ONNX<br/>算子融合 + 常量折叠]
    C -->|onnxruntime-wasm| D[WASM 模块<br/>.wasm]
    D --> E[WASM 运行时<br/>浏览器 / WASI / Wasmtime]

    F[C++ 推理代码] -->|Emscripten| D
    G[Rust 推理代码] -->|wasm-pack| D

    subgraph 跨语言互操作层
        H[JavaScript<br/>浏览器端调用]
        I[Python<br/>通过 wasmtime-py]
        J[Rust<br/>通过 wasmtime]
        K[Go<br/>通过 wazero]
    end

    E --> H
    E --> I
    E --> J
    E --> K
编译流水线的核心是 ONNX 作为中间表示。PyTorch、TensorFlow、JAX 等框架都可以导出 ONNX 格式,ONNX Runtime 提供了 WASM 后端,可以直接将 ONNX 模型编译为 WASM 模块。这条路径的优势是工具链成熟,劣势是 ONNX 的算子覆盖不完整——某些自定义算子需要手动实现 WASM 版本。
跨语言互操作层是 WASM 的核心价值所在。同一个 .wasm 文件可以被 JavaScript、Python、Rust、Go 等多种语言调用,无需为每种语言重新编译模型。这种"编译一次,到处运行"的特性,是 WASM 在 AI 部署领域最大的竞争优势。
三、Rust + WASM 的 AI 推理模块与多语言调用实战
以下是一个用 Rust 编写、编译为 WASM 的 AI 推理模块,以及它在不同语言中的调用方式:
Rust 推理模块 src/lib.rs:
use wasm_bindgen::prelude::*;

/// 矩阵运算工具——WASM 导出版本
/// 使用 f32 精度,兼顾精度与 WASM 性能
#[wasm_bindgen]
pub struct WasmInference {
    weights: Vec<f32>,
    biases: Vec<f32>,
    input_size: usize,
    output_size: usize,
}

#[wasm_bindgen]
impl WasmInference {
    /// 创建推理实例
    /// weights 和 biases 以一维数组形式传入,按行优先排列
    #[wasm_bindgen(constructor)]
    pub fn new(
        weights: &[f32],
        biases: &[f32],
        input_size: usize,
        output_size: usize,
    ) -> Result<WasmInference, JsValue> {
        let expected_weight_len = input_size * output_size;
        if weights.len() != expected_weight_len {
            return Err(JsValue::from_str(&format!(
                "权重长度不匹配: 期望 {}, 实际 {}",
                expected_weight_len,
                weights.len()
            )));
        }
        if biases.len() != output_size {
            return Err(JsValue::from_str(&format!(
                "偏置长度不匹配: 期望 {}, 实际 {}",
                output_size,
                biases.len()
            )));
        }

        Ok(WasmInference {
            weights: weights.to_vec(),
            biases: biases.to_vec(),
            input_size,
            output_size,
        })
    }

    /// 执行前向推理:线性变换 + ReLU 激活
    /// 返回输出数组的指针和长度,避免 JSON 序列化开销
    pub fn forward(&self, input: &[f32]) -> Vec<f32> {
        if input.len() != self.input_size {
            // WASM 中无法使用 Result,返回零向量表示错误
            return vec![0.0; self.output_size];
        }

        let mut output = vec![0.0f32; self.output_size];

        for i in 0..self.output_size {
            let mut sum = self.biases[i];
            for j in 0..self.input_size {
                sum += self.weights[i * self.input_size + j] * input[j];
            }
            // ReLU 激活
            output[i] = if sum > 0.0 { sum } else { 0.0 };
        }

        output
    }

    /// 批量推理——一次处理多个输入
    /// 减少跨语言调用次数,降低桥接开销
    pub fn forward_batch(&self, inputs: &[f32], batch_size: usize) -> Vec<f32> {
        let mut results = Vec::with_capacity(batch_size * self.output_size);

        for b in 0..batch_size {
            let offset = b * self.input_size;
            if offset + self.input_size > inputs.len() {
                break;
            }
            let input = &inputs[offset..offset + self.input_size];
            results.extend_from_slice(&self.forward(input));
        }

        results
    }

    /// 获取模型元信息
    pub fn model_info(&self) -> String {
        format!(
            "input_size={}, output_size={}, weights_len={}, biases_len={}",
            self.input_size,
            self.output_size,
            self.weights.len(),
            self.biases.len()
        )
    }
}
JavaScript 调用方式(浏览器端):
import init, { WasmInference } from './pkg/wasm_inference.js';

async function runInference() {
    await init();

    // 2x3 矩阵:2个输出,3个输入
    const weights = new Float32Array([
        0.5, -0.3, 0.8,   // 输出神经元 1
        -0.2, 0.6, 0.1,   // 输出神经元 2
    ]);
    const biases = new Float32Array([0.1, -0.1]);

    const model = new WasmInference(weights, biases, 3, 2);

    const input = new Float32Array([1.0, 2.0, 3.0]);
    const output = model.forward(input);
    console.log('推理结果:', output); // Float32Array

    // 批量推理——减少调用次数
    const batchInput = new Float32Array([1.0, 2.0, 3.0, 4.0, 5.0, 6.0]);
    const batchOutput = model.forward_batch(batchInput, 2);
    console.log('批量结果:', batchOutput);
}
Rust 调用方式(通过 Wasmtime):
use wasmtime::*;

fn call_wasm_model() -> Result<(), Box<dyn std::error::Error>> {
    let engine = Engine::default();
    let module = Module::from_file(&engine, "wasm_inference.wasm")?;
    let mut store = Store::new(&engine, ());

    let instance = Instance::new(&mut store, &module, &[])?;

    // 获取导出函数
    let new_fn = instance.get_typed_func::<(u32, u32, u32, u32), u32>(&mut store, "new")?;
    let forward_fn = instance.get_typed_func::<(u32, u32), u32>(&mut store, "forward")?;

    // 分配 WASM 线性内存中的空间并写入数据
    let memory = instance.get_memory(&mut store, "memory")
        .expect("WASM 模块必须导出 memory");

    // 写入权重数据到 WASM 内存
    let weights = [0.5f32, -0.3, 0.8, -0.2, 0.6, 0.1];
    let weights_ptr = 0;
    memory.data_mut(&mut store)[weights_ptr..weights_ptr + weights.len() * 4]
        .copy_from_slice(bytemuck::cast_slice(&weights));

    // 调用推理函数...
    // 此处省略完整的内存管理代码

    Ok(())
}
踩坑记录:WASM 的线性内存是共享的,多个调用之间需要手动管理内存偏移量。在生产环境中,应实现一个简单的内存分配器,避免手动计算偏移量导致的越界错误。另外,wasm-bindgen 生成的 JS 桥接代码会自动处理内存管理,但 Wasmtime 的手动调用需要自己管理 Float32Array 的生命周期。
四、WASM AI 编译的性能瓶颈与跨语言互操作的工程代价
WASM AI 编译的性能瓶颈主要在三个方面:计算性能、内存模型和调用开销。
计算性能方面,WASM 目前缺乏对 SIMD 矩阵运算的完整支持。WASM SIMD 128 提供了基本的向量运算指令,但与 AVX-512 或 CUDA 的矩阵运算能力相比差距巨大。基准测试数据显示,同样的矩阵乘法,WASM SIMD 的速度约为原生 AVX2 的 30%-40%。对于大规模模型推理,这个性能差距是不可接受的。
内存模型方面,WASM 的线性内存是连续的字节数组,最大 4GB(32 位 WASM)。AI 模型的张量数据通常需要非连续的内存布局(如 strides、padding),在 WASM 中需要手动实现这些布局转换。WASM GC 提案虽然引入了垃圾回收支持,但目前浏览器支持不完整,无法用于生产环境。
调用开销方面,每次跨语言调用(JS 到 WASM、Python 到 WASM)都有固定的桥接成本。单次调用的开销约 100-500ns,对于单次推理(耗时 10ms-100ms)来说可以忽略。但如果将推理拆分为大量细粒度的 WASM 调用(如逐层推理),桥接开销就会成为瓶颈。forward_batch 方法的设计正是为了减少调用次数,将多次推理合并为一次调用。
跨语言互操作的工程代价体现在接口设计上。WASM 只支持基本数值类型(i32、i64、f32、f64)和线性内存,不支持直接传递字符串、结构体或对象。wasm-bindgen 通过生成桥接代码解决了这个问题,但只适用于 JavaScript 调用方。其他语言(Python、Go、Rust)需要通过 Wasmtime 等运行时手动管理内存和类型转换,代码复杂度显著增加。
适用边界:WASM AI 编译适合模型规模小(100M 参数以下)、推理频率低(QPS < 100)、跨平台部署需求强的场景。对于大规模模型(1B 参数以上)或高吞吐推理(QPS > 1000),原生部署(CUDA + TensorRT)仍然是唯一可行的方案。
五、总结
WebAssembly 为 AI 模型的跨平台部署提供了一种可移植的编译目标。通过 ONNX 中间表示和 WASM 后端,可以将训练好的模型编译为可在浏览器、服务器和边缘设备上运行的字节码。Rust + wasm-bindgen 的工具链使得推理模块的开发和导出相对便捷。但 WASM AI 编译的性能瓶颈是客观存在的——计算速度约为原生的 30%-40%,内存限制在 4GB 以内,跨语言调用有固定开销。在实际项目中,WASM AI 编译应定位为轻量级模型的跨平台部署方案,而非高性能推理的替代品。对于大规模模型和高吞吐场景,原生部署配合模型服务化是更可靠的架构选择。

 359


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


