腾讯混元OCR:10亿参数轻量化模型,刷新多场景图文解析天花板

实战指南:Hunyuan OCR HunyuanOCR是一款基于混元多模态架构的轻量级端到端OCR模型,仅1B参数即可实现行业领先性能,该模型支持多语言文档解析、文本识别、信息提取等多种任务。 阅读详情

在日常工作中,你是否遇到过这些困扰?扫描的PDF文档无法复制文字,手写笔记整理成电子档要逐字录入,多语言合同里的表格数据提取耗时又易错……现在,腾讯推出的HunyuanOCR模型,正以“轻量化+强性能”的组合,重新定义图文解析的效率与精度。

一、什么是混元OCR?用10亿参数实现“小模型大能力”

作为腾讯混元多模态体系下的专注OCR(光学字符识别)模型,HunyuanOCR最亮眼的标签是“轻量却能打”:仅10亿参数规模,却在行业权威 benchmark 中表现突出——在OmniDocBench文档解析任务中,以94.10的综合得分超越百度OCR、PaddleOCR-VL等主流模型,成为轻量化OCR领域的“性能黑马”。
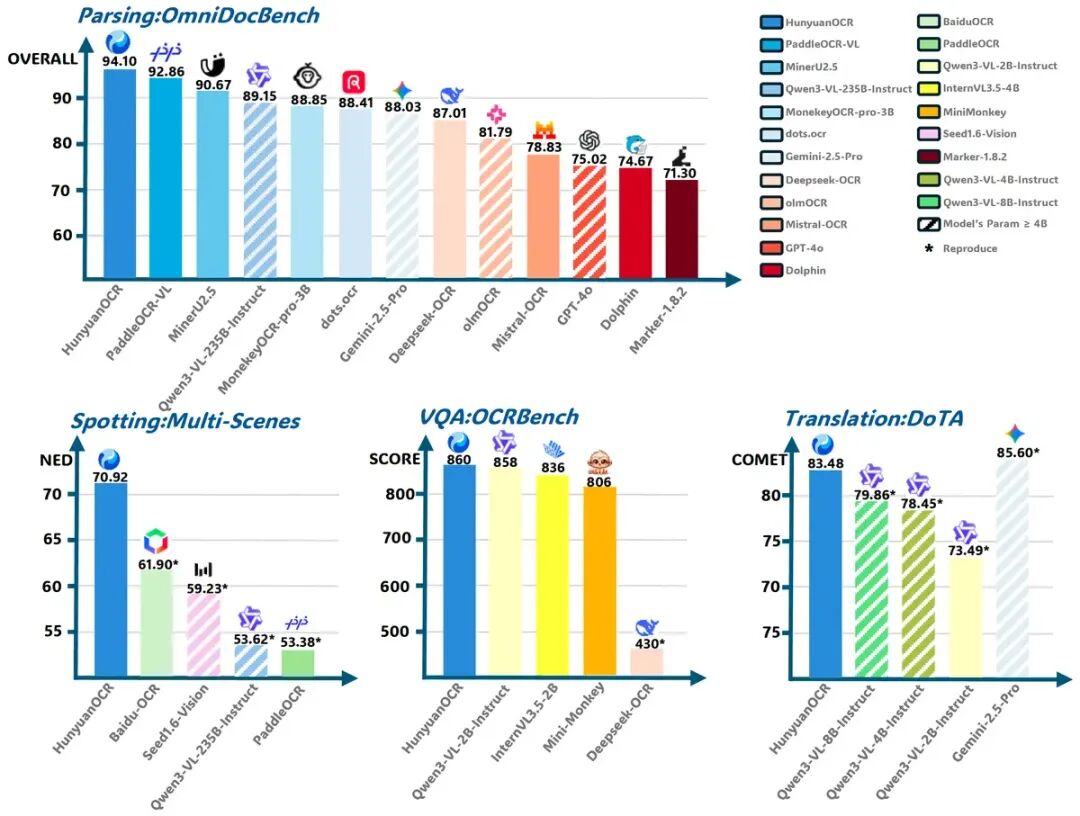
image.png
image.png

它并非传统单一功能的OCR工具,而是具备“端到端图文理解” 能力的多模态模型:能同时处理图片中的文字、表格、公式、图表,甚至理解文档的排版逻辑,就像给计算机装上了“看懂图文的眼睛”。

二、5大核心能力,覆盖从日常到专业的全场景需求

无论是职场人的文档处理,还是开发者的技术集成,HunyuanOCR都能精准匹配需求,核心能力可概括为“5能”:

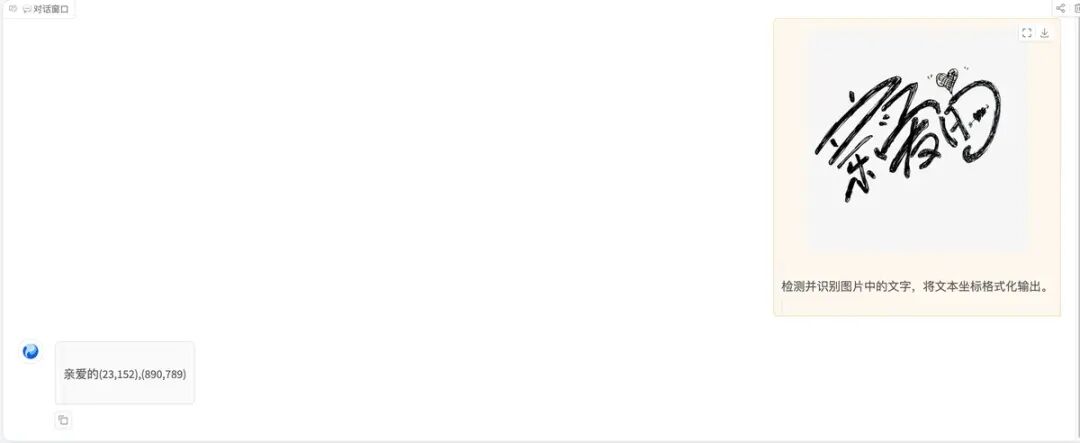
1. 文字检测和识别

HunyuanOCR 可以轻松实现对艺术字、街拍广告牌、截屏、广告、手写、票据中的文字完成识别,而且效果很好,如下图:image.png
2. 复杂元素“智能拆解”
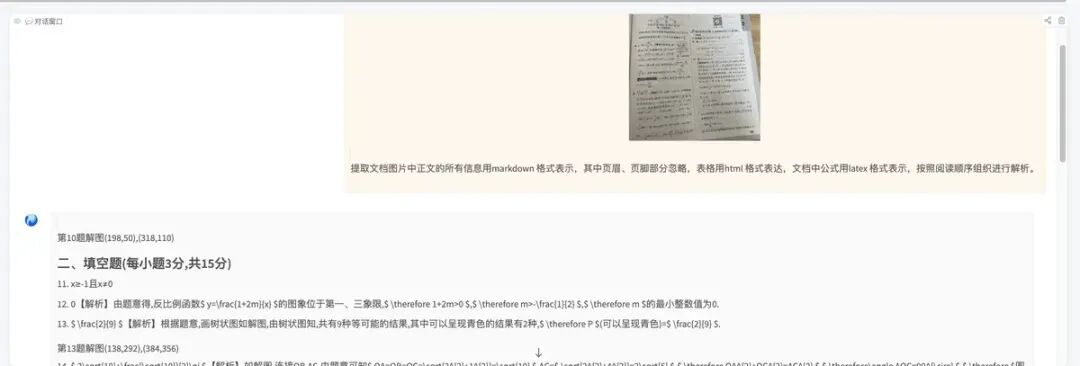
  • 表格秒变可编辑格式:扫描件里的财务报表、实验数据表格,能直接解析为HTML格式,复制到Excel中无需二次调整;

  • 公式精准转LaTeX:学术论文里的复杂公式,识别后自动生成LaTeX代码,插入论文文档时格式零误差;

  • 图表逻辑“可视化还原”:流程图用Mermaid格式重现,折线图、柱状图用Markdown清晰呈现,省去重新绘图的麻烦。

这一点如果我们用编程方法,不借助AI来出来,会非常难的,很难兼顾多种情况,没想到HunyuanOCR也能处理的很好,如下图:image.png
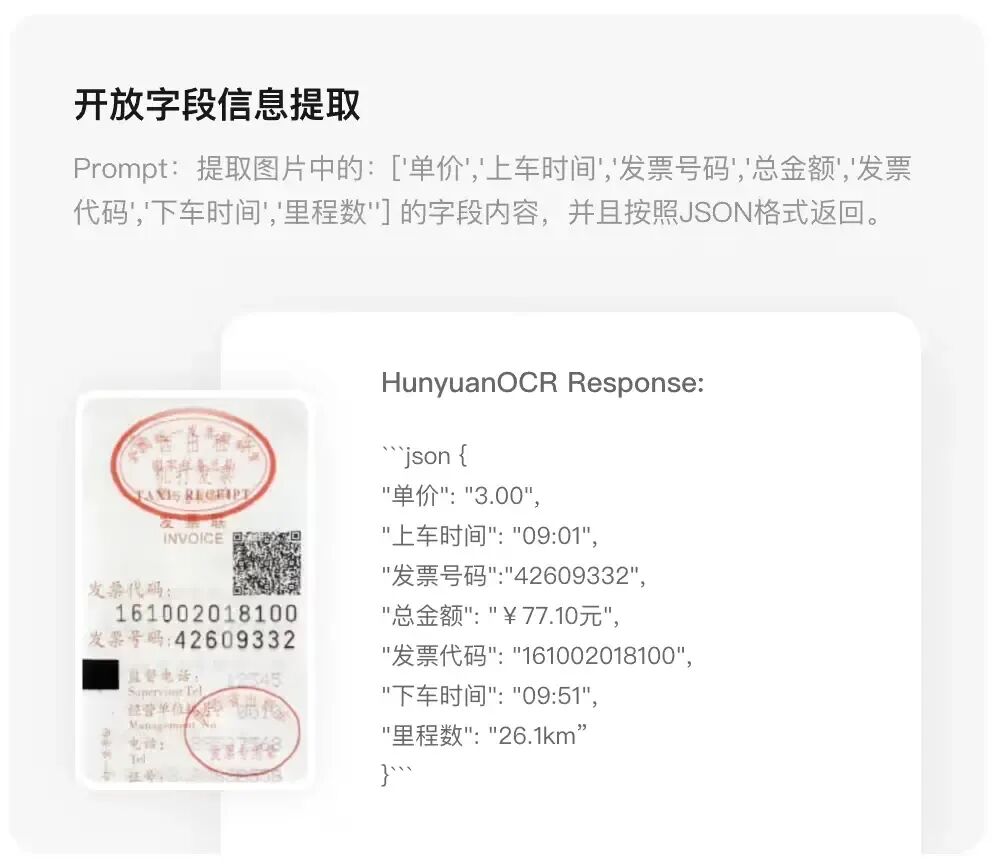
3. 发票信息抽取

大家工作中,一般出来回来,免不了要报销发票,那么发票的填写就是件头疼的事情,要一点点核对。害怕万一填写错了信息,又被财务打回来,来回折腾,大家都费事费力,通过HunyuanOCR,我们可以方便提取发票上信息,如下图:
图来自互联网,额度不够用了
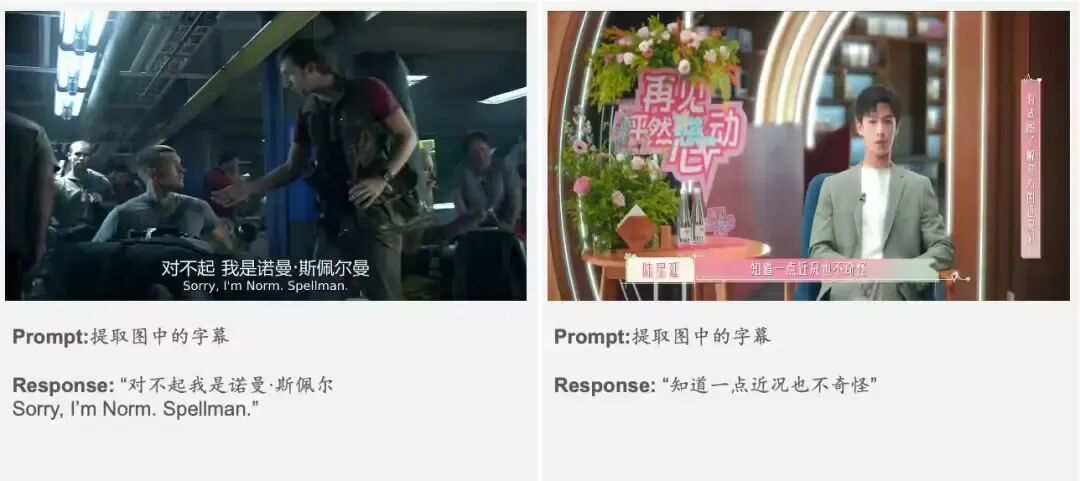
4. 视频字幕“实时抓取”

刷海外教程、看多语言纪录片时,能提取视频帧中的字幕文本,还支持直接翻译为中文,兼顾“看视频”与“记笔记”双重需求。
图来自互联网,额度不够用了
5. 轻量化部署“灵活高效”

10亿参数的小巧体型,让它既能在云端提供高并发服务,也能适配边缘设备部署,开发者无需复杂配置,就能快速集成到APP、小程序或办公软件中。

三、2分钟上手!两种便捷使用方式

普通用户和开发者都能轻松玩转混元OCR,官方提供两种快速启动方案:

方案1:用Transformers快速调用

只需3步,就能实现文档信息提取:

  1. 安装依赖:pip install git+https://github.com/huggingface/transformers@82a06db03535c49aa987719ed0746a76093b1ec4

  2. 编写代码,上传图片并写指令,比如“提取文档正文,表格用HTML、公式用LaTeX表示”;

from transformers import AutoProcessor
from transformers import HunYuanVLForConditionalGeneration
from PIL import Image
import torch

def clean_repeated_substrings(text):
    """Clean repeated substrings in text"""
    n = len(text)
    if n<8000:
        return text
    for length in range(2, n // 10 + 1):
        candidate = text[-length:] 
        count = 0
        i = n - length
        
        while i >= 0 and text[i:i + length] == candidate:
            count += 1
            i -= length

        if count >= 10:
            return text[:n - length * (count - 1)]  

    return text

model_name_or_path = "tencent/HunyuanOCR"
processor = AutoProcessor.from_pretrained(model_name_or_path, use_fast=False)
img_path = "path/to/your/image.jpg"
image_inputs = Image.open(img_path)
messages1 = [
    {"role": "system", "content": ""},
    {
        "role": "user",
        "content": [
            {"type": "image", "image": img_path},
            {"type": "text", "text": (
                "检测并识别图片中的文字,将文本坐标格式化输出。"
            )},
        ],
    }
]
messages = [messages1]
texts = [
    processor.apply_chat_template(msg, tokenize=False, add_generation_prompt=True)
    for msg in messages
]
inputs = processor(
    text=texts,
    images=image_inputs,
    padding=True,
    return_tensors="pt",
)
model = HunYuanVLForConditionalGeneration.from_pretrained(
    model_name_or_path,
    attn_implementation="eager",
    dtype=torch.bfloat16,
    device_map="auto"
)
with torch.no_grad():
    device = next(model.parameters()).device
    inputs = inputs.to(device)
    generated_ids = model.generate(**inputs, max_new_tokens=16384, do_sample=False)
if "input_ids" in inputs:
    input_ids = inputs.input_ids
else:
    print("inputs: # fallback", inputs)
    input_ids = inputs.inputs
generated_ids_trimmed = [
    out_ids[len(in_ids):] for in_ids, out_ids in zip(input_ids, generated_ids)
]
output_texts = clean_repeated_substrings(processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
))
print(output_texts)
  1. 运行代码,秒级得到结构化输出,还能自动清理重复文本,避免冗余。

方案2:用vLLM提速推理

如果需要处理大量图片,可通过vLLM实现高效推理: 安装vLLM后,配置采样参数(如temperature=0确保输出稳定),单次可处理多帧图片,适合视频字幕提取、批量文档解析等场景。

  1. 安装

uv venv hunyuanocr
source hunyuanocr/bin/activate

uv pip install -U vllm --pre --extra-index-url https://wheels.vllm.ai/nightly
  1. 部署模型

vllm serve tencent/HunyuanOCR \
    --no-enable-prefix-caching \
    --mm-processor-cache-gb 0 \
    --gpu-memory-utilization 0.2
  1. 代码测试

from vllm import LLM, SamplingParams
from PIL import Image
from transformers import AutoProcessor

def clean_repeated_substrings(text):
    """Clean repeated substrings in text"""
    n = len(text)
    if n<8000:
        return text
    for length in range(2, n // 10 + 1):
        candidate = text[-length:] 
        count = 0
        i = n - length
        
        while i >= 0 and text[i:i + length] == candidate:
            count += 1
            i -= length

        if count >= 10:
            return text[:n - length * (count - 1)]  

    return text

model_path = "tencent/HunyuanOCR"
llm = LLM(model=model_path, trust_remote_code=True)
processor = AutoProcessor.from_pretrained(model_path)
sampling_params = SamplingParams(temperature=0, max_tokens=16384)

img_path = "/path/to/image.jpg"
img = Image.open(img_path)
messages = [
    {"role": "system", "content": ""},
    {"role": "user", "content": [
        {"type": "image", "image": img_path},
        {"type": "text", "text": "检测并识别图片中的文字,将文本坐标格式化输出。"}
    ]}
]
prompt = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
inputs = {"prompt": prompt, "multi_modal_data": {"image": [img]}}
output = llm.generate([inputs], sampling_params)[0]
print(clean_repeated_substrings(output.outputs[0].text))

四、为什么选混元OCR?3个核心优势脱颖而出

在众多OCR工具中,混元OCR的竞争力主要来自三点:

  • 性能与效率平衡:比同参数模型精度更高,比高精度大模型(如Qwen3-VL-235B)部署成本更低;

  • 场景适配性强:从日常的身份证、发票识别,到专业的学术论文、工程图纸解析,都能应对;

  • 开发者友好:开源在Hugging Face平台,提供完整的调用代码、应用场景Prompt模板(如文字定位、信息提取、翻译等),降低开发门槛。

目前,混元OCR已在腾讯内部多个业务场景落地,并通过Hugging Face向全球开发者开放。无论是想提升个人办公效率,还是为产品添加图文解析功能,都可以直接访问模型官网获取资源。

未来,随着多模态技术的发展,OCR或许会从“提取信息”升级为“理解意图”——比如自动根据合同条款生成风险提示,根据报表数据生成分析结论。而混元OCR,已经走在了这条探索的前列。

涉及链接:

模型地址:https://huggingface.co/tencent/HunyuanOCR

vllm部署混元OCR指南:https://docs.vllm.ai/projects/recipes/en/latest/Tencent-Hunyuan/HunyuanOCR.html#installing-vllm

直接体验地址:https://huggingface.co/spaces/tencent/HunyuanOCR

实用电路精讲系列---双级运放放大电路(差分放大+跟随缓冲) 本文分析了双极运放放大电路的工作原理及其典型应用。该电路结合差分放大器和跟随缓冲器,实现高精度信号放大与阻抗匹配。差分放大器通过放大差模信号并抑制共模噪声提升信噪比;跟随缓冲器则提供阻抗变换,确保信号稳定传输。两者协同工作可优化输入阻抗、增强噪声抑制并提高设计灵活性。文章还列举了10个典型应用案例,包括医疗设备、工业传感器和新能源系统等,展示了该电路在精密电子系统中的关键作用。最后通过实用电路分析,详细说明了各模块功能及设计注意事项。 阅读详情

相关推荐

OpenHarmony系统参数权限配置避坑指南:从param get/set失败到SELinux标签实战

本文深入解析OpenHarmony系统参数权限配置的常见问题与解决方案,涵盖DAC和SELinux双重权限控制机制。通过实战案例演示如何配置`param get/set`权限,解决'Permission denied'错误,并提供三方应用访问参数的安全方案,帮助开发者高效完成系统调试与优化。

weixin_27013291的博客 449

【AI大模型前沿】HunyuanOCR:腾讯混元推出的高效端到端OCR视觉语言模型

HunyuanOCR 是腾讯混元团队推出的一款开源端到端OCR视觉语言模型,专为高效处理复杂文档和多语言文本设计。它依托混元原生多模态架构,仅用1B参数量就实现了多项OCR任务的SOTA性能。HunyuanOCR 支持文本检测与识别、复杂文档解析、开放字段信息抽取、视频字幕抽取以及图像文本翻译等功能,覆盖了经典OCR任务的全场景应用。其轻量化设计和强大的多语言支持能力,使其在实际应用中表现出色,广泛适用于文档处理、票据解析、视频内容创作等多个领域。

寻道AI,探索AI无限可能! 1999

不只是安装:用OrbbecSDK_ROS2玩转深度相机点云、滤波与DDS调优

本文深入探讨了如何通过OrbbecSDK_ROS2实现深度相机的高级应用,包括点云处理、深度图优化和DDS调优。详细介绍了点云采集与可视化技巧、多种滤波算法的配置与组合策略,以及针对高带宽数据传输的DDS高级调优方法,帮助开发者在机器人导航和三维重建等场景中提升性能。

weixin_29246195的博客 784

腾讯混元开源HunyuanOCR轻量模型:10亿参数如何颠覆传统OCR

长期以来,OCR(光学字符识别)系统如同一个复杂的工厂流水线,环节繁多且极易出错。腾讯开源的HunyuanOCR模型,以其仅10亿参数的轻量级身躯,彻底颠覆了这一传统范式。它并非简单地优化某个环节,而是通过纯粹的端到端视觉语言模型架构,进行了一场深刻的“减法艺术”。本文将深入剖析其背后的三大支柱:极简而强大的架构设计、构筑护城河的数据工程,以及创新的强化学习策略,揭示其如何用更小的代价,实现超越许多巨型模型的商业级性能。

攻城狮7号的博客 1400

保姆级教程:用Cesium的Primitive API实现火箭发射全流程动画(含代码避坑)

本文详细介绍了如何使用Cesium的Primitive API实现火箭发射全流程动画,包括模型控制、关节动画和精细时序管理。通过实战代码示例和性能优化技巧,帮助开发者高效构建高复杂度航天仿真系统,显著提升三维可视化效果与运行效率。

weixin_42565652的博客 213

智能网联汽车云控系统核心解析:车云数据交互协议设计与实践

本文深入解析了智能网联汽车云控系统的核心——车云数据交互协议的设计与实践。文章围绕“说什么”、“怎么说”及异常处理三大核心问题,详细阐述了二进制与结构体数据类型定义、TCP/UDP双通道传输机制、通用报文格式以及典型交互流程(如GLOSA车速引导),并分享了时间同步、坐标系定义等关键实战经验与避坑指南,为构建高效、可靠、安全的车云“神经系统”提供专业指导。

alice7model的博客 121

腾讯混元开源 HunyuanOCR:仅 1B 参数碾压 235B 大模型,四大基准 SOTA,端到端搞定文字检测/文档解析/信息抽取/视频字幕/拍照翻译!

HunyuanOCR = 腾讯混元出品端到端 OCR 专家 VLM= 仅 1B 参数,四大基准全线 SOTA= 1 个模型搞定 6 大任务= 文字检测 + 文档解析 + 信息抽取 + 视频字幕 + 拍照翻译 + 文档 QA= 20GB 显存部署,vLLM 一行启动= 支持 100+ 语言,单语/混语均出色= CVPR 2026 主会论文 × 2= ICDAR2025 翻译赛小模型赛道冠军= 端到端 vs 传统级联方案,一步到位维度评分说明性能⭐⭐⭐⭐⭐。

guopeiAI 786

异步处理优化:多线程线程池与消息队列的选择与应用

本文讨论了两种常见的异步处理方式:多线程线程池和消息队列(MQ)。通过将非核心逻辑异步化,可以提升系统的性能和响应速度。多线程线程池适用于本地并发任务,适合需要快速响应的场景,但无法处理跨服务任务。消息队列则适用于分布式系统,能够解耦服务并保证任务的可靠性和顺序性,适合处理高并发和高可靠性要求的任务。文章提供了实际代码示例,帮助开发者根据业务需求选择合适的异步处理方式。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 170万+

OCR性能对比测试:腾讯混元OCR与PaddleOCR谁更快更准?

腾讯HunyuanOCR凭借端到端架构在速度和精度上超越传统级联方案,实测显示其处理效率接近PaddleOCR的两倍,结构化输出与多语言识别表现更优,部署简洁适合快速落地,而PaddleOCR仍保留在定制化场景中的灵活性优势。

weixin_42581003的博客 735

9.16华为OD机试真题 新系统 - 矩阵螺旋遍历 (Java/Py/C/C++/Js/Go)

9.16华为OD机试真题 新系统 - 矩阵螺旋遍历 (Java/Py/C/C++/Js/Go)

算法大师! 651

最新Python爬虫实战(入门爬虫篇)——案例13:某乎热榜数据采集(详细爬虫思路截图+抓包动图演示+完整爬虫代码+详细注释)

本次案例通过Python爬虫技术,成功实现了基于Cookies认证的某乎热榜数据爬取与Excel保存。代码采用模块化设计,包含Cookies解析、HTML请求、结构化解析、Excel持久化等完整流程;通过配置浏览器请求头+Cookies认证,有效突破某乎基础反爬策略,保证请求稳定性。整个爬虫逻辑遵循“Cookies认证 → 页面请求 → HTML解析 → 数据清洗 → 保存到Excel”的标准流程,与需要会话验证的网站爬取范式高度一致。Cookies解析与认证。

努力让自己发光,对的人才能迎着光而来 33万+

1B参数实现多项SOTA:腾讯混元OCR开源模型体验

腾讯混元实验室开源的HunyuanOCR模型以仅1B参数量实现SOTA性能,在多项OCR测评中表现优异。

围炉漫谈间,一起深聊人工智能、大数据这类前沿科技领域的新动态,在这里为你拆解前沿技术百货的多样精彩。 1742

educoder中Hive综合应用案例 — 用户搜索日志分析

Hive综合应用案例 — 用户搜索日志分析

weixin_46026136的博客 4790

腾讯混元OCR震撼开源:10亿参数打造端到端文档智能新范式

近日,腾讯混元大模型团队正式对外发布并开源HunyuanOCR模型,这款参数规模仅10亿级的专用视觉语言模型,凭借"商业级精度+轻量级部署"的双重优势引发行业广泛关注。作为当前开源领域首个实现真端到端训推一体的OCR解决方案,该模型不仅在文本检测识别、复杂文档解析等基础任务上全面超越现有公开方案,更在信息抽取、图像翻译等语义理解场景展现卓越性能,一举斩获ICDAR 2025 DIMT挑战赛小模型赛

gitblog_00197的博客 903

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Hunyuan OCR & Z-Image-Turbo 正式上线!两大模型在 NPU 加速平台完成部署,开启 AI 识图新时代!

作为领先的 OCR 模型,擅长复杂场景、低质量图像识别,提供高精度、强泛化能力的智能文本识别能力。则以极速、高质、可控的生成能力,让图像创作更高效、更真实、更专业。依托开源生态与强大技术实力,两款模型的上线将大幅降低 AI 视觉技术的门槛,加速智能识别与创作在各行业的落地应用。

白天写代码,晚上追AI大模型,偶尔搞点八卦 开源动态|技术干货|实习机会|生态活动 我负责分享,你负责变强 2156

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

【腾讯拥抱开源】比paddleocr和DeepSeekOCR更强的混元OCR已经开源了

腾讯推出的HunyuanOCR是基于混元多模态架构的轻量级端到端OCR模型(10亿参数),在复杂多语言文档解析、文字定位、信息抽取等任务中表现卓越。支持通过Transformers或vLLM快速部署,提供文档结构化输出(Markdown/HTML/LaTeX)、表格识别、公式解析等功能。用户可通过Hugging Face获取模型,或参考技术报告与GitHub项目深入了解其多模态处理能力与应用场景。模型特别优化了长文本重复子串清理,支持16384 tokens的长上下文处理。

weixin_41446370的博客 1383

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

5 分钟搞定!腾讯混元 OCR API 部署全攻略

文章标签:#HunyuanOCR #OCR 识别 #多语种识别 #文档解析 #图片翻译 #vLLM 部署 #API 服务最近腾讯开源的混元 OCR(HunyuanOCR)凭借 1B 轻量化参数却斩获多项业界 SOTA 的表现火出圈了!作为混元原生多模态端到端 OCR 专家模型,它不仅支持文字检测识别、复杂文档解析,还能实现卡证票据信息抽取、视频字幕识别、拍照翻译等全场景功能。

1703

腾讯发布“读图神器“HunyuanOCR,只用1%的参数就打败了行业巨头?

腾讯发布"读图神器"HunyuanOCR,只用1%的参数就打败了行业巨头?

至顶AI实验室 612

解决报错:ImportError: cannot import name ‘Qwen2_5_VLForConditionalGeneration‘ from ‘transformers‘

【代码】解决报错:ImportError: cannot import name ‘Qwen2_5_VLForConditionalGeneration‘ from ‘transformers‘

muli 714

腾讯混元OCR部署教程:4090D单卡即可运行的OCR神器

腾讯混元OCR基于端到端多模态大模型,仅用RTX 4090D即可本地部署,支持指令驱动、结构化输出与高精度中文识别,兼顾性能、安全与成本,为个人与企业带来开箱即用的文档自动化体验。

weixin_33582089的博客 515

HunyuanOCR网页界面使用教程:上传图片到结果解析全过程

本文介绍了如何在星图GPU平台上自动化部署Hunyuan-OCR-WEBUI镜像,快速搭建一个强大的OCR识别服务。通过直观的网页界面,用户可轻松上传图片,实现一键式的通用文字识别,高效完成纸质文档电子化、截图文字提取等日常任务,大幅提升信息处理效率。

weixin_42433737的博客 482

无需级联方案!腾讯混元OCR端到端实现文字检测与识别一体化

腾讯推出的HunyuanOCR采用视觉-语言联合建模,实现文字检测与识别一体化,仅用10亿参数即完成传统双模型任务,显著提升效率并降低部署成本。模型支持多语言、多任务灵活切换,已在票据处理、跨境翻译等场景落地验证。

weixin_42610010的博客 787

混元OCR 1.5 1B模型实测:0.7页/秒的吞吐真相与选型指南

OCR(光学字符识别)是文档数字化的基础技术,但在复杂版式和批量识别场景中,传统开源框架往往在准确率与效率间顾此失彼。视觉语言模型(VLM)将整页图像直接映射为文本输出,成为新一代OCR引擎的重要方向,1B级参数量则在显存占用与推理成本上带来数量级优势。实测中,借助int4量化与vLLM连续批处理,单卡可达到接近0.7页/秒的池化吞吐,但这一数字与单页延迟并非同一口径,榜单成绩需要先甄别并发路数、解码长度等前提条件。从性能账本估算、本地复现步骤、榜单水分分析到主流方案选型,这里系统拆解了从模型部署到稳定运维

weixin_32181267的博客 14

腾讯混元OCR保姆级教程:从部署到识别艺术字,手把手教学

本文介绍了如何在星图GPU平台上自动化部署Hunyuan-OCR-WEBUI镜像,实现高效的艺术字体识别。该OCR工具基于腾讯混元大模型,特别优化了复杂场景下的文字识别能力,适用于海报设计、创意文案等场景,用户可通过简单的Web界面快速提取图片中的艺术文字内容。

weixin_27645199的博客 339

腾讯混元OCR小白友好备份教程:脚本+监控+演练,一文学会

本文介绍了如何在星图GPU平台上自动化部署Hunyuan-OCR-WEBUI镜像,实现高效OCR文字识别功能。该平台简化了部署流程,用户可快速搭建OCR处理环境,适用于合同文档识别、图片文字提取等场景,显著提升办公自动化效率。

weixin_42576804的博客 334

腾讯混元OCR模型上线!支持100+语言的多语种文档解析神器

腾讯推出的HunyuanOCR基于混元大模型,实现端到端多语种文档理解,支持100+语言,仅需一条指令即可完成文字识别、结构化提取与翻译。参数量仅1B,可在单卡上高效运行,广泛适用于跨境客服、证件核验等场景。

weixin_36288992的博客 1047
上一篇: 霸屏的Gemini 3.0 到底怎么样
下一篇: 用AI给古诗词“贴标签”:本地小模型与大模型API实战对比
微信号尧字节请关注谢谢
博客等级 码龄22年 643粉丝 359原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值