使用模拟方法玩转统计推断

统计功效(power) 定义 & 描述 别名 敏感度(sensitivity) 目的:反映一个检验检测出指定大小效应的能力 定义 在假设检验中, 拒绝原假设后, 接受正确的替换假设的概率 假设检验拒绝的漏报率:用同样的检验方法,对样本重采样/重复实验后计算检验值,统计检验值 > 0.05(显著阈值)的占比 假设检验的“正确通过率”,1 - 漏报率 不犯第二类错误的概率 当AB两组差异真的存在时,我们能正确判断的概率 计算:1−β=Φ(z−z1−α/2)+Φ(−z−z1−α/2)1 - \beta = \Phi 阅读详情

原文链接:使用模拟方法玩转统计推断icon-default.png?t=N7T8https://mp.weixin.qq.com/s/bUSE2JY4M9knTMCjJwXNWw

统计推断主要涉及四个指标[1]。简单来说,它们是α、1-β(统计功效)、效应量和样本量,其中统计功效和效应量相对比较抽象。

本文将继续深入学习上一篇文章中所讲的模拟方法,通过R语言编程的方式,阐释统计功效和效应量的具象含义。

统计功效又名统计检验力。假设某种处理能够产生某种效应,那么通过一次抽样操作能够检测到这种效应的概率就是其含义了。

统计功效还有一个名称,叫“真阳性率”。当零假设H0为假时,只要样本的数量无限接近总体的数量,那么肯定的一个结果是H0会被拒绝。

然而,实际情况是,抽样的数量很有限,而且抽样难免会产生误差,因此抽样结果有时会正确拒绝H0,有时又会落入误区(下图蓝色β区域)[2]。
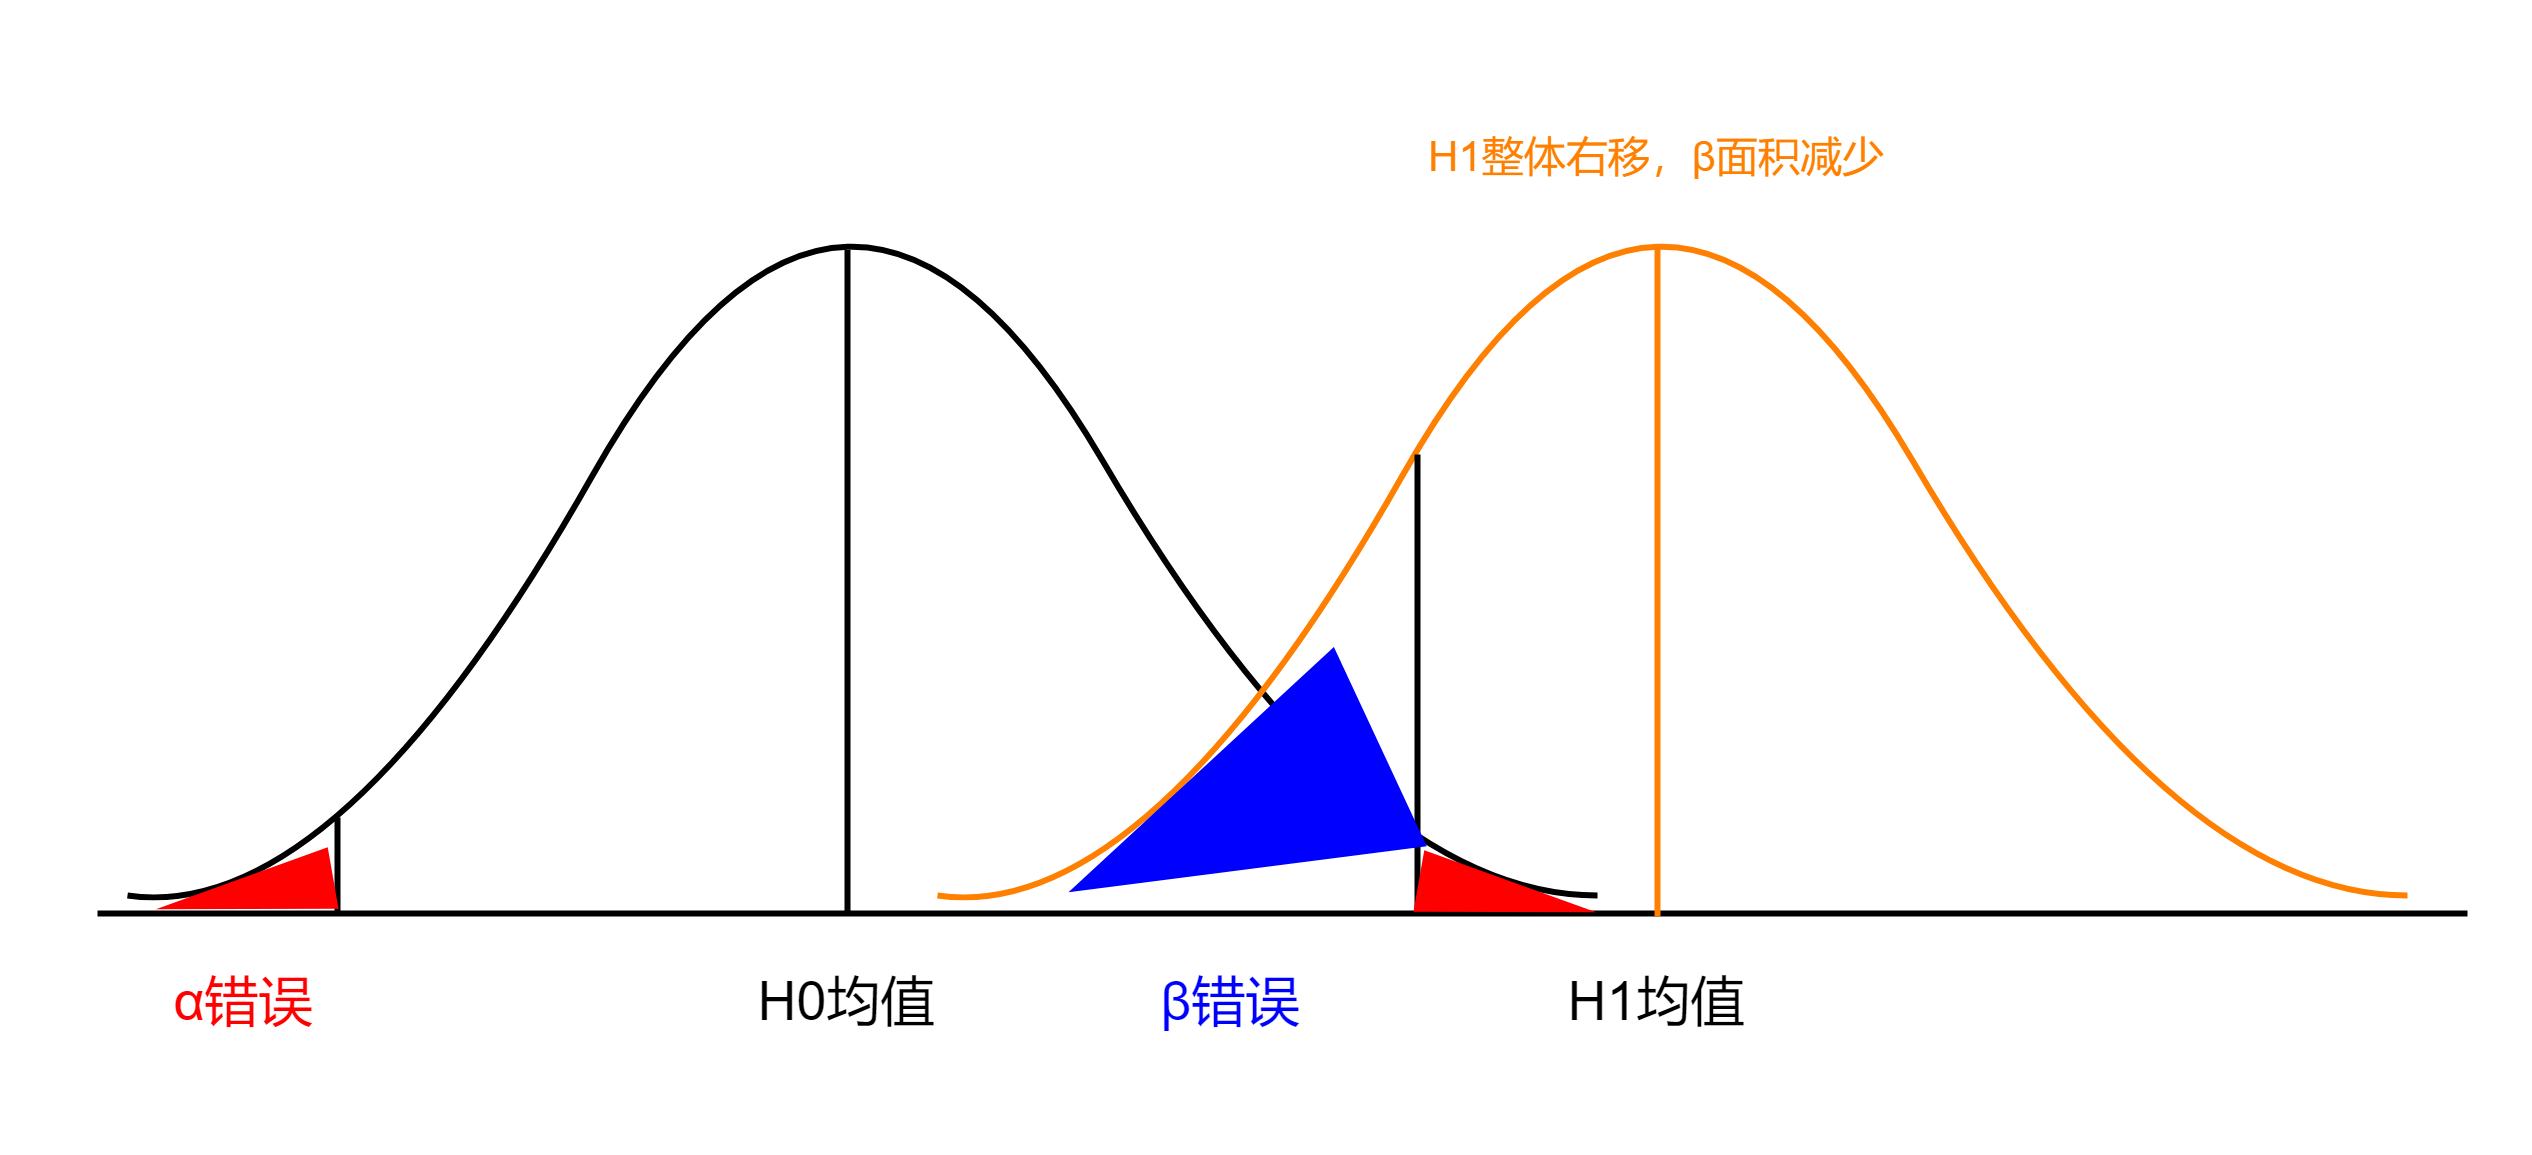
在所有的抽样次数中,正确拒绝H0的次数所占的比例即是真阳性率。如果能够在80%的情况下拒绝错误的零假设,意思是说它的统计功效是80%。

心理学研究经常使用G*Power来进行功效分析和样本量计算。不过,说是功效分析通常通过模拟来完成,特别是对于非实验研究[3]。

这让人想到通过计算机模拟打点计算圆周率的方法。边长为1的正方形有一内切圆,按随机打点位置在四分之一圆弧内还是外,通过面积比例计算得到π的估计值。

功效分析会遇到一些现实困难。除了小效应外,还有自变量本身变异不大、因变量噪声太多(受其它因素影响)以至于信号难以提取,以及追求苛刻的估计效应值的标准误。

好在这几个问题能够通过增加足够的样本量来解决。至于到底需要多少的样本量,是可以通过所设定的统计功效和效应量计算出来的。

效应量即真实效应值,例如回归分析中的预测因子系数。

为了更加具体地了解概念,还得结合例子进行说明。假设我们想研究阅读训练计划(X)对儿童阅读成绩(Y)的影响,还关心该效应是否会因性别(M)而异[3]。

我们先从上帝的视角来展示下“真实数据”:X的回归系数为3.6,M的回归系数为0.6,X和M交互作用的回归系数为1.2,Y的标准差为8。

对于其它一堆可能会影响测试分数的因素,我们统一打包到一个控制变量S里。并且设定S每增加一个标准差,相应地Y会平均增加5个单位。

而且S也会对自变量X产生影响:S每增加一个标准差,接受训练的可能性则会减少11%。

要是用回归方程来表示以上设定,那就是Y = β0 + 3.6*X + 0.6M + 5*S + 1.2*M*X + rnorm(N, sd = 8),其中rnorm()函数用于在模拟数据过程中生成误差项。

--逐步编程--

上图是根据前面一篇文章[4],对模拟方法的使用流程作了梳理。以下的例子演示与这个流程基本相同,只是最后一步检验的是效应量和样本量。

在模拟中要如何提取功效值呢?从操作定义的角度看,统计功效等于是抽样结果中具有统计显著性的比例。

因此在编程中要增加一个二进制变量,用于存储效应是否显著的结果。这里的是否显著指的是非零检验的结果,即参数估计值的置信区间是否包含零。

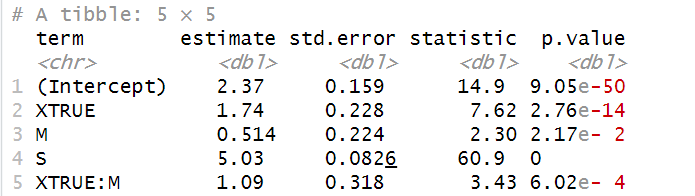
就本文的例子来说,指的是X和M两者交互效应的系数估计值是否显著。其是否显著的结果要从模型拟合结果中读取,上篇文章已讲到可以使用broom包的tidy()函数。

tidy()函数能够从模型信息中提取出整洁的结果,其输出为tibble类型,方便访问具体的结果值(见下图)。
其实到目前为止,前期的准备工作已完成。接下来可以参照上一篇文章的内容,完成自定义函数的编写,用于模拟生成一份样本数据(代码如下)。

##模拟采样函数##
#参数B4指交互效应系数
d_sample <- function(N, B4) {
S = rnorm(N)	#混杂因素
M= sample(0:1, N, replace = TRUE)	#性别
d_temp <- tibble(S, M) %>%
        #根据S对X的影响关系生成数据
        #接受阅读训练的比例不到一半
        mutate(X = runif(N) + .11*S < .5) %>%
        #假设截距值为2.3
        mutate(Y = 2.3 + 3.6*X + 0.6*M + 5*S + B4*M*X + rnorm(N, sd = 8))
    
    return(d_temp)
}

上面自定义函数有一个B4参数,它是指交互作用的效应量。虽然前面已设定其真实值为1.2,不过后面我们要对它进行操纵试验,此处用参数能够保留调整的灵活性。

下一步是根据生成的样本数据,通过线性拟合方法估计模型参数,同时获得显著性结果。这里我们只关心交互效应是否显著,最终用于计算真阳性率(即统计功效)。

##返回交互效应是否显著##
r_sig <- function(N, B4) {
    d_onetime <- d_sample(N, B4)
#第一个参数formula默认带常数项β0
# X*M等价于X+M+X:M(冒号表示交互项)
m_fitted <- lm(Y~X*M + S, data = d_onetime)
    #模型转tibble
    m_tidied <- tidy(m_fitted)

    #第五行对应B4系数
    r_temp <- m_tidied$p.value[5] < .05
    
    return(r_temp)
}

一切准备就绪,现在可以用上火力了——通过迭代方法生成任意数量的样本。例如生成1000份样本,每个样本的大小为2000,分别对应下边r_iterate()函数的count参数和N参数。

##迭代调用##
r_iterate <- function(N, B4, count) {
r_temp <- 1:count %>%
#参数x表示当前迭代
map_dbl(function(x) {
        #输出进度
        if (x %% 100 == 0) { print(percent(x/count)) }

        #返回是否显著结果
        return(r_sig(N, B4))
    })
    
    #均值即功效值
    return(mean(r_temp))
}

r_iterate()函数会计算1000份样本中,交互效应结果显著的比例。

要是保持B4和count参数不变,仅去调整N,就可以获得不同的功效值。反过来说,假设我们对功效的期望值是80%,那么只需通过反复多次试验就能找到最小的N值。

##寻找最小样本量##
r_effect <- tibble(N = c(2000, 4000, 6000))
#创建power列,存储不同样本量下的效应值
r_effect$power <- c(2000, 4000, 6000) %>%
    #第一个参数N由前面的向量逐个传递进来
    map_dbl(r_iterate, B4 = 1.2, count = 1000)
r_effect
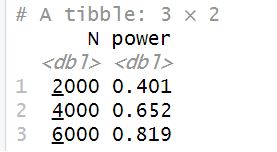
上图显示,6000份样本时,效应量已接近82%。

还有最后一个问题就留给各位自己做试验啦~

当样本数量和样本大小保持不变,如何通过前面预留的B4参数,去获得不同交互效应下不同的统计功效呢?

参考文章:

  1. 到底需要多少样本量
    https://mp.weixin.qq.com/s/Ate4y3GiwOw_KQWIq8DV7A
  2. 从样本量计算到元分析——有效应量、有随机效应模型
    https://mp.weixin.qq.com/s/UlXDAoQtT7oczY6pJwm9YQ
  3. The Effect: An Introduction to Research Design and Causality
    https://theeffectbook.net/index.html
  4. 模拟生成因果关系数据
    https://mp.weixin.qq.com/s/YL3_kuEsNdhAjhxFAguC1g

统计 | 统计功效 | R语言 在假设检验中,为了保证将真的判为假的概率很低,设置犯第一类错误的概率为α\alpha,通常情况下,α\alpha等于0.05或0.01。在现行的大学教科书中,根本没有提及将假的判为真的概率计算公式,下面来介绍如何计算统计功效,并介绍它的含义。这里http://blog.youkuaiyun.com/xxzhangx/article/details/72811527 介绍了p值的计算,我们就接着它来完善统计功效的 阅读详情

相关推荐

【数据攻略】 假设检验 | 统计功效 | 最小样本量

转载:概率论系列考点 — 统计功效 | 最小样本量 统计功效及最小样本量是假设检验的进阶知识点 也是AB实验中非常常用的两个基本概念 因此,是各大厂面试官考察应聘者对假设检验的真实掌握情况 考点举例: ▶第一类错误的定义? ▶统计功效的定义,以及应用场景? ▶统计功效较低的影响是什么? ▶最小样本量计算公式是什么? ▶计算最小样本量的业务指导意义? 以下文章涉及相关推导,有些同学可能看着吃力些 不要担心 只要了解 假设检验 |统计功效 |最小样本量的定义...

qq_40002713的博客 6650

统计功效Statistical Power

统计功效,简单来说,就是在假设检验框架下,当研究假设中的真实效应存在时,我们能够正确拒绝虚无假设的概率。数学上,它等于1减去第二类错误(Type II Error)的概率,即 (Power = 1 - \beta)。提高统计功效,意味着减少错过真实效应(假阴性)的几率,保证研究的可靠性和有效性。

m0_53623159的博客 3397

【统计学】推断统计分析——根据样本统计量推断总体参数

推断统计研究的是如何根据样本数据去推测总体特征的方法。进行推断的原因是在实际生产中,获取总体数据通常比较困难,甚至不可能完成,因此需要对总体进行抽样,通过样本统计量去估计总体参数。

WANG_hl的博客 1万+

一文读懂统计功效,样本量计算

设从均值u,方差s的任意总体中抽取样本量为n的样本,当n非常大时,样本均值服从于均值u,方差s/n的正态分布。:1 - 纳伪错误,即原假设是错误的,拒绝错误假设的概率。

weixin_43336108的博客 1818

Python金融大数据分析——第10章 推断统计学 笔记1

第10章 推断统计学 10.1 随机数 10.2 模拟 10.2.1 随机变量 10.2.2 随机过程 10.2.3 方差缩减 10.3 估值 10.3.1 欧式期权 10.3.2 美式期权 10.4 风险测度 10.4.1 风险价值 10.4.2 信用价值调整 第10章 推断统计学 10.1 随机数 import numpy as np import n...

RealEmperor 博客 5669

【机器学习概率统计】11 贝叶斯统计推断:最大后验

这一节,我们来介绍另外一种统计推断方法:贝叶斯统计推断方法。 1.回顾贝叶斯定理 首先,我们先来复习一下贝叶斯定理: p(Θ∣X)=p(X∣Θ)p(Θ)p(X)p(\Theta|X)=\frac{p(X|\Theta)p(\Theta)}{p(X)}p(Θ∣X)=p(X)p(X∣Θ)p(Θ)​ 在这个简简单单的式子当中,蕴含了我们要掌握的很多重要内容: 贝叶斯定理当中的四个概率表达式,他们都非常重要,在这一节的内容中将反复出现,我们来一一解析一下: p(Θ)p(\Theta)p(Θ):先验分布。 反映的是在

机器学习数学基础系列专栏 3269

计算统计-Chap6 推断统计的蒙特卡罗方法 (3)蒙特卡罗方法

很多时候,我们不清楚统计量的分布,或不确定对它所作的假设是否合理。蒙特卡罗模拟可以处理这些情况,它的应用包括: 1)当待检测统计量(the test statistics)从未知时,进行推断 2)当参数假设(parametric assumptions),评估推断方法的性能 3)在各种情况下进行假设检验 4)比较不同检测子(estimator)的质量 1.基本蒙特卡罗过程 ...

weixin_30349597的博客 1777

9、统计推断与梯度下降:原理、方法及应用

本文详细介绍了统计推断和梯度下降的基本原理、方法及其在数据科学中的应用。统计推断部分涵盖假设检验、p值计算、置信区间构建、A/B测试等内容,并探讨了p-Hacking问题和贝叶斯推断的不同思路。梯度下降部分解释了其基本思想和操作流程,分析了优缺点及适用场景。文章旨在帮助读者理解并应用这些核心方法解决实际问题。

fern8的博客 54

基于R语言的统计模拟——假设检验

​ 一、模拟目的 在统计学的广阔领域中,参数估计与假设检验构成了分析数据、验证假设的核心工具,其中,参数估计进一步细化为点估计与置信区间估计,为我们提供了参数值及其不确定性的量化视角。然而,值得注意的是,尽管这些方法在大样本情形下展现了强大的稳健性和有效性,但在处理小样本(通常定义为样本量显著小于50)数据时,其性能与可靠性可能面临挑战。这是因为小样本数据往往难以充分反映总体的真实分布特性,特别是当涉及到复杂统计量或假设检验时,大数定律和中心极限定理的渐近性质可能尚未充分显现。

月遇从云的博客 2307

概率论与推断统计的奥秘

本文将深入探讨概率论中的随机性与独立事件的概念,以及推断统计在估计概率时的应用。我们将通过具体的例子和实验来理解大数定律,并探讨回归平均值的概念。通过分析投掷骰子和抛硬币的结果,我们将学会如何运用概率理论来预测未来事件发生的可能性,并识别赌徒谬误和回归平均值之间的区别。

weixin_35899324的博客 424

Proteus仿真实战:ADC0832时序解析与51单片机精准电压采集

本文详细解析了ADC0832模数转换芯片在Proteus仿真环境中的时序控制与51单片机驱动实现。通过实战代码示例和精度优化技巧,帮助开发者掌握电压采集的关键技术,包括时序配置、数据校验和噪声抑制等核心要点,提升嵌入式系统设计的精准度与可靠性。

weixin_29172963的博客 873

Python推断统计分析

本文系统介绍了Python在推断统计分析中的应用框架,涵盖从假设检验到预测建模的全流程技能。首先,文章阐述了推断统计的核心方法论,包括参数估计和假设检验,并通过代码示例展示了如何计算置信区间和进行t检验。接着,文章详细介绍了Python工具链中的核心库,如Pandas、NumPy、SciPy等,并提供了奶茶店服务优化的实战案例,演示了从数据收集、预处理到假设检验的完整流程。最后,文章探讨了统计建模与机器学习的融合,并推荐了相关学习资源。通过掌握这些方法和工具,读者将能够从数据中提取深刻洞见,优化商业决策和驱

得塔云的博客 963

基于SpringBoot+SpringCloud+Vue前后端分离项目实战 --开篇

如何高效学习Java? 毕业设计项目应该怎么做?入门实战项目应该怎么做? 做Java开发都应该学习哪些框架技术? 我想来跟你聊聊为什么要学习此专栏?我们经常说,看一个事儿千万不要直接陷入细节里,你应该先鸟瞰其全貌,这样能够帮助你从高维度理解问题。同样,当你迷茫想努力没有方向时,最事半功倍的方法是:找人带你! 因为过来人,更懂得如何学、如何做、如何少走弯路! 那今天就给大家带来一门专栏课程,由 天罡gg 和 经海路大白狗 两位实力大牛合力打造的一款专栏,可以让你从0到1快速拥有企业级规范的项目实战经验!

天罡gg的专栏 2万+

新思路!用因果推断方法—G公式模拟干预的统计学过程

NHANES数据挖掘、CHARLS等老年库数据挖掘、MIMIC数据挖掘,多变量孟德尔随机化MR、中介MR、肠道菌群MR、药靶MR、网络药理学结合MR、单细胞RNA测序分析结合MR。缺失数据下的预测模型;值得注意的是,我们为每种空气污染物构建了单独的协变量模型,同时将所有六种污染物纳入单一结果模型,以评估其混合暴露效应。在这项研究中,“事实”指的是所有观察到的数据,包括空气污染暴露、饮食模式依从性、混杂因素和健康结果。对每个时变协变量(如污染物浓度、饮食评分、收入、教育、吸烟等)分别建立线性回归模型。

郑老师统计 835

在虚拟机中对阿克曼转向车进行导航及避障的仿真测试

一、    在我使用rosdep install teb_local_planner去安装teb_local_planner的时候,报错:Command ‘rosdep’ not found, but can be installed with:sudo apt install python3-rosdep2    我花大半个月好不容易建立起的一系列ROS环境,被python3-rosdep2这条万恶的语句连同ROS一起给我删了。。。悲伤来的那么猝不及防    随着ROS版本的迭代,相关资料很多都不再适用

慕羽★的博客 3805

MyBatis-Plus 实战:敏感字段自动加解密支持模糊查询

本文基于MyBatis-Plus框架提出了一种全链路敏感字段加密方案。通过自定义TypeHandler实现数据入库自动加密和查询自动解密,结合重写LambdaQueryWrapper处理查询条件加密,并适配多种查询方式。方案核心包括:1)AESUtil工具类提供加解密基础能力;2)EncryptTypeHandler实现字段类型转换;3)实体类通过注解配置加密字段。该方案在保证数据安全的同时,对业务代码侵入性小,支持姓名、手机号等敏感信息的全流程加密处理,满足系统开发的安全需求。

蔡定努 595

假设检验和统计推断:从样本到总体

统计学中的假设检验和统计推断是从样本数据中对总体进行推断和判断的关键工具。本文将深入探讨假设检验的类型,并结合具体的场景和例子,展示不同类型假设检验的应用。

theskylife的博客 2291

汇川Easy系列PLC系统PID指令编程应用(增量型)

增量式PIDS7-1200/1500增量式PID(输出归一化、支持PWM输出)_西门子1200pid算法公式-优快云博客文章浏览阅读1k次。本文介绍了S7-1200/1500 PLC中增量式PID算法的应用,包括输出归一化和PWM输出。通过详细解析,阐述了PID输出如何限制在0.0-1.0之间,并且如何将PID输出与PWM占空比关联,适用于温度等控制场景。

RXXW_Dor的博客 1422

数据科学 IPython 笔记本 六、SciPy 统计推断

六、SciPy 统计推断 原文:statistical-inference-scipy 译者:飞龙 协议:CC BY-NC-SA 4.0 6.1 效应量 署名:派生于 Allen Downey 的 CompStats。协议:Creative Commons Attribution 4.0 International。 from __future__ import print_functio...

龙哥盟 3万+

PyTorch实战(13)——图卷积网络(Graph Convolutional Network,GCN)

图卷积网络 (Graph Convolutional Network, GCN) 模型能够同时结合节点级特征和图级(邻域)信息进行分类,显著提升了图数据建模能力,适用于节点分类、图分类等多种任务。本节中,我们通过 PyTorch Geometric 库在 CiteSeer 图数据集上构建模型,们首先用前馈神经网络作为基线模型完成节点分类任务,随后用 GCN 模型替代前馈网络显著提升了分类准确率。

盼小辉丶的博客 3238

【RK3399 Ubuntu】基于rk3399的lxde的lubuntu桌面移植适配记录之第二步:最基本Ubuntu根文件系统的相关常用工具完善

文章目录1.使能系统网络管理服务1.1 安装驱动modules管理工具1.2 使能网络服务2.终端自动补全命令功能3.安装ssh服务4.安装系统信息查看工具5.安装resize工具6.安装lrzsz工具7.使能rc.local服务7.1 修改服务Install块7.2 使能rc.local.service服务7.3 添加执行脚本且赋予执行权限 续接上文,本文主要完善前面已经制作好的rootfs 1.使能系统网络管理服务 1.1 安装驱动modules管理工具 apt-get install kmod 1.

wang 恒 的博客 1385

蒙特卡洛方法资源文件简介:一种强大的统计模拟工具

蒙特卡洛方法资源文件简介:一种强大的统计模拟工具 去发现同类优质开源项目:https://gitcode.com/ 项目介绍 蒙特卡洛方法(Monte Carlo method)作为一种基于重复随机抽样的统计模拟方法,其广泛的应用领域和卓越的问题解决能力,使之成为了计算物理、数学、工程、金融等多个行业的重要工具。该方法利用随机抽样来近似求解复杂问题,尤其适用于那些传统方法难以处理或成本高昂的问题。...

gitblog_06748的博客 752

【系统架构设计师-2025上半年真题】综合知识-参考答案及详解(75题完全回忆版)

【系统架构设计师-2025上半年真题】案例分析-参考答案及部分详解

数据知道的博客 1万+

常见推断方法一览:极大似然估计、最大后验估计、期望最大化、贝叶斯推断、马尔科夫链蒙特卡洛方法、变分推断

如果这个最大的概率发生在70%,那你就会说根据目前的数据,最有可能的情况是硬币正面朝上的概率是70%,参数就是这个。MLE 的目标是找到这些参数的最佳值,使得这些参数下观察到的数据出现的概率最大,确保模型尽可能地反映出现实世界中的情况。在这一步,你根据目前所知的信息,对故事中缺失的部分做出最佳猜测。:在同样的猫狗识别模型中,如果你已经知道猫的图片通常比狗的图片多(或者相反),MAP会利用这个先验知识来调整参数估计。这时,你就找到了最合适的版本来填补缺失部分,也就是说,你找到了模型参数的最优估计。

Debroon 1959

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

计算统计-Chap6 推断统计的蒙特卡罗方法 (1)引言

推断统计(inferential statistics)用于形成关于总体(population)的结论,并且利用随机样本对这些结论的可信度进行评价,相关技术包括:利用点估计来估计总体参数,估计参数的置信区间,假设建议和建模(回归、密度估计等)。要估计推断的可信度,必须要了解分析过程涉及的统计量的分布。当使用的是已经重复理解的统计量(如样本均值)时,很容易开展相关分析。那么,在处理复杂问题时该怎么办...

weixin_30443813的博客 338

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

【stat】概率统计、统计推断、统计决策理论

一、概率统计 概率vs. 统计 概率:研究随机事件出现的可能性的数学分支,描述非确定性(Uncertainty)的正式语言,是统计推断的基础  概率: 一个事件或事件集合出现的可能性  基本问题:给定以一个数据产生过程,则输出的性质是什么 统计推断:处理数据分析和概率理论的数学分支,与数据挖掘和机器学习是近亲  统计量:一个用以描述样本或总体性质的数值,如均值或方差  基本问题:给定输出数据...

weixin_34116110的博客 431
下一篇: 中介变量和调节变量分析
miniprogram
博客等级 码龄6年 20粉丝 9原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值